📖 第 9.2 章:字符串匹配:前缀函数与 KMP
🎯 学习目标
学完本章后,你将能够:
- 理解字符串匹配的朴素算法并分析其效率瓶颈
- 掌握 KMP 算法的核心思想——「前缀函数」的构建
- 用 KMP 在 O(N + M) 时间内解决字符串匹配问题
- 利用前缀函数求解最短周期、前缀计数等进阶问题
9.2.0 问题引入
给定一段文本(长度 N)和一个模式串(长度 M),请找出模式串在文本中所有出现的位置。
文本:  "ababcabcabababd"
模式:  "abab"
结果:  位置 0, 8, 10
这是字符串匹配问题,也是竞赛中最常见的字符串题型之一。它看似简单——两个循环逐字符比较就能写出来——但当 N、M 达到 10⁵ 甚至 10⁶ 时,朴素做法的 O(N × M) 会彻底超时。本章的主角 KMP 算法把它降到了线性时间,其核心思想「失配时利用已匹配部分跳转」还会在第 9.5 章的 AC 自动机中原样复现。
9.2.1 为什么需要专门的字符串算法?
朴素算法的问题
最直觉的做法——枚举文本的每个起始位置,逐字符比较:
// 朴素字符串匹配 — O(N * M)
vector<int> naive_search(string text, string pattern) {
    int n = text.size(), m = pattern.size();
    vector<int> result;
    for (int i = 0; i <= n - m; i++) {
        bool match = true;
        for (int j = 0; j < m; j++) {
            if (text[i + j] != pattern[j]) {
                match = false;
                break;
            }
        }
        if (match) result.push_back(i);
    }
    return result;
}
最坏情况举例:
文本:  "aaaaaa...a"(N 个 a)
模式:  "aaa...ab"(M-1 个 a + 1 个 b)
每次匹配都要比较 M 次才发现不匹配
总操作数:N * M
当 N = M = 10^5 时,这就是 10^10 次操作,根本无法通过竞赛题目。
KMP 的核心洞察
朴素算法的浪费在于:每次失配后,从头重新开始匹配,丢弃了已经比较过的信息。
KMP 的思想是:失配时,利用已经匹配的部分跳回到合适位置,而不是从头开始。
9.2.2 前缀函数(π 数组)
KMP 的核心是「前缀函数」,也叫「next 数组」或「失配函数」。
定义
对于字符串 s,前缀函数 π[i] 定义为:
子串
s[0..i]中,最长的相等真前缀与真后缀的长度。
「真前缀」:不包含整个字符串的前缀。
「真后缀」:不包含整个字符串的后缀。
直觉理解
字符串:  a  b  c  a  b  c  d
下标:    0  1  2  3  4  5  6
π 值:    0  0  0  1  2  3  0
逐个分析:
π[0] = 0:单个字符 "a",无真前后缀,规定为 0π[1] = 0:字符串 "ab",前缀 {a},后缀 {b},没有相等的,π = 0π[2] = 0:字符串 "abc",前缀 {a, ab},后缀 {c, bc},没有相等的,π = 0π[3] = 1:字符串 "abca",前缀 {a, ab, abc},后缀 {a, ca, bca},相等的最长为 "a",π = 1π[4] = 2:字符串 "abcab",最长相等真前后缀为 "ab",π = 2π[5] = 3:字符串 "abcabc",最长相等真前后缀为 "abc",π = 3π[6] = 0:字符串 "abcabcd",末尾 d 打破了规律,π = 0
π 值的用途
π[i] = k 意味着:如果当前字符(位置 i+1)不匹配,
我们可以安全地退回到模式串的第 k 个位置继续尝试,
因为前 k 个字符肯定已经匹配了(它们是当前已匹配部分的前缀 = 后缀)。
9.2.3 前缀函数的高效构建
朴素方法:O(N²) 或 O(N³)
对每个位置枚举所有可能的长度,逐字符比较,效率很低。
KMP 的关键观察
观察 1:相邻的 π 值最多增加 1。
即 π[i+1] ≤ π[i] + 1。
为什么?若 π[i+1] > π[i] + 1,说明存在更长的相等前后缀,那 π[i] 就不是最大的了,矛盾。
观察 2:失配时如何跳转?
若 s[π[i]] == s[i+1],则 π[i+1] = π[i] + 1(前缀直接延长)。
若不等,利用 π[π[i]-1] 跳转(尝试更短的前缀),直到找到匹配或退到 0。
图解失配跳转
模式串:  a b c a b d
           ↑     ↑
           已匹配到位置4("abcab"),π[4]=2
           现在第5个字符 d ≠ c(s[2])

           跳转:j = π[4] = 2,尝试 s[2]='c' vs 'd' → 还是不匹配
           跳转:j = π[1] = 0,尝试 s[0]='a' vs 'd' → 还是不匹配
           j = 0 且失配,π[5] = 0
最终算法实现
#include <bits/stdc++.h>
using namespace std;

// 构建前缀函数(KMP 的核心)
// 时间复杂度:O(N)
vector<int> prefix_function(const string& s) {
    int n = (int)s.length();
    vector<int> pi(n, 0);   // pi[0] = 0 是规定

    for (int i = 1; i < n; i++) {
        // j 从上一个 π 值开始尝试
        int j = pi[i - 1];

        // 失配时,利用已算出的 π 值回退(关键步骤!)
        while (j > 0 && s[i] != s[j])
            j = pi[j - 1];     // 跳到下一个候选长度

        // 匹配则长度加一
        if (s[i] == s[j])
            j++;

        pi[i] = j;
    }
    return pi;
}

int main() {
    auto pi = prefix_function("abcabcd");
    for (int x : pi) cout << x << " ";  // 输出:0 0 0 1 2 3 0
    cout << endl;
    return 0;
}
为什么时间复杂度是 O(N)?
关键在于 j 的变化:
j每次最多加 1(通过j++)j每次至少减 1(通过j = pi[j-1])j的总增加量 ≤ N,所以总减少量也 ≤ N- while 循环的总执行次数 ≤ N
整个循环的总操作数是 O(N)!
9.2.4 KMP 字符串匹配
核心技巧:拼接字符串
将 pattern + '#' + text 拼在一起,计算整体的前缀函数:
pattern = "abab",长度 4
text    = "ababcababd",长度 9

拼接后:  a b a b # a b a b c a b a b d
下标:    0 1 2 3 4 5 6 7 8 9 0 1 2 3 4
                              ↑ 1 ↑ 1 ↑ 1
π 值:    0 0 1 2 0 1 2 3 4 0 1 2 3 4 0
                              ↑         ↑
         当 π[i] = 4(= len(pattern)),说明找到匹配!
分隔符 # 的作用是防止模式串的后缀与文本的前缀在拼接处意外匹配。
完整实现
#include <bits/stdc++.h>
using namespace std;

// 前缀函数(上一节的实现,匹配要用)
vector<int> prefix_function(const string& s) {
    int n = (int)s.length();
    vector<int> pi(n, 0);
    for (int i = 1; i < n; i++) {
        int j = pi[i - 1];
        while (j > 0 && s[i] != s[j]) j = pi[j - 1];
        if (s[i] == s[j]) j++;
        pi[i] = j;
    }
    return pi;
}

// KMP 字符串匹配
// 返回 pattern 在 text 中所有匹配的起始下标(0-indexed)
// 时间复杂度:O(N + M),N = len(text),M = len(pattern)
vector<int> kmp_search(const string& text, const string& pattern) {
    if (pattern.empty()) return {};

    // 第一步:拼接,用不在字符集中的分隔符
    string combined = pattern + '#' + text;
    int m = pattern.size(), n = text.size();

    // 第二步:计算整体前缀函数
    vector<int> pi = prefix_function(combined);

    // 第三步:收集匹配位置
    vector<int> result;
    for (int i = m + 1; i <= m + n; i++) {
        if (pi[i] == m) {
            // i 在拼接串中的位置,换算回 text 中的起始位置
            result.push_back(i - 2 * m);
        }
    }
    return result;
}

int main() {
    string text    = "ababcabcabababd";
    string pattern = "abab";

    auto pos = kmp_search(text, pattern);
    cout << "模式串 \"" << pattern << "\" 出现在位置:";
    for (int p : pos) cout << p << " ";
    // 输出:0 8 10
    cout << endl;

    // 验证
    for (int p : pos) {
        cout << "  text[" << p << ".." << p+pattern.size()-1 << "] = "
             << text.substr(p, pattern.size()) << endl;
    }
    return 0;
}
详细追踪示例
📄 查看代码:详细追踪示例
text = "ababcabab", pattern = "abab"(长度4)

拼接串:  a b a b # a b a b c a b a b
π 值:    0 0 1 2 0 1 2 3 4 0 1 2 3 4
                         ↑           ↑
                       i=8          i=13
                    π[8]=4=m ✓    π[13]=4=m ✓

匹配位置(text 中 0-indexed):
  i=8:  8 - 2*4 = 0  → text[0..3] = "abab" ✓
  i=13: 13 - 2*4 = 5 → text[5..8] = "abab" ✓
9.2.5 KMP 的进阶应用
应用 1:求字符串的最短周期
// 若字符串 s 能被前 k 个字符重复构成,则 k 是周期
// 最短周期 = n - π[n-1]
// 条件:n 能被 (n - π[n-1]) 整除

int min_period(const string& s) {
    int n = s.size();
    auto pi = prefix_function(s);
    int period = n - pi[n - 1];
    if (n % period == 0) return period;
    return n;  // 无法压缩,周期为 n
}

// 示例:
// "abcabc" → π[5]=3,period = 6-3 = 3,6%3=0 ✓,最短周期 3
// "abcab"  → π[4]=2,period = 5-2 = 3,5%3≠0,最短周期 5(整串)
应用 2:统计每个前缀的出现次数
// 统计模式串的每个前缀在整个串中出现的次数
vector<int> count_prefixes(const string& s) {
    int n = s.size();
    auto pi = prefix_function(s);
    vector<int> cnt(n + 1, 0);

    for (int i = 0; i < n; i++) cnt[pi[i]]++;    // 每个位置贡献
    for (int i = n - 1; i > 0; i--) cnt[pi[i-1]] += cnt[i]; // 传播
    for (int i = 0; i <= n; i++) cnt[i]++;        // 加上自身

    return cnt;  // cnt[k] = 长度为 k 的前缀在 s 中出现的次数
}
算法对比
| 算法 | 时间复杂度 | 空间复杂度 | 适用场景 |
|---|---|---|---|
| 朴素匹配 | O(N × M) | O(1) | 小数据,代码简单 |
| KMP | O(N + M) | O(M) | 单模式匹配(推荐) |
| Rabin-Karp(字符串哈希,第 3.7 章) | O(N + M) 平均 | O(1) | 多模式或哈希方便的场景 |
| AC 自动机(第 9.5 章) | O(N + ΣM) | O(ΣM) | 多模式同时匹配 |
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| KMP 匹配位置计算错误 | i - 2*m 忘记两个 m(模式串 + 分隔符) | 画图确认拼接串的下标 |
| π[0] 不初始化为 0 | 忘记规定 | vector<int> pi(n, 0) |
| 拼接分隔符出现在原串中 | π 值可能「穿过」模式串与文本的边界 | 选一个字符集中不存在的分隔符(如 '#') |
| 最短周期忘记整除判断 | n - π[n-1] 只有在整除时才是真正的周期 | if (n % period == 0) |
💪 练习题(本章 3 道,全部含完整解答)
🟢 基础练习
题目 1:实现 strStr
在字符串 haystack 中找到 needle 第一次出现的起始位置(若不存在返回 -1)。
要求使用 KMP 实现,时间复杂度 O(N+M)。
示例:
haystack = "hello", needle = "ll"  → 2
haystack = "aaaaa", needle = "bba" → -1
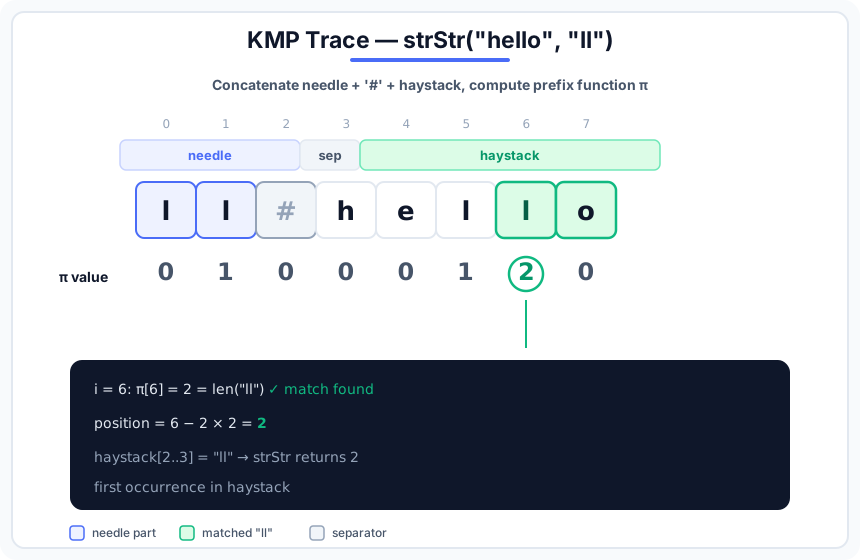
思路: 拼接 needle + '#' + haystack,计算前缀函数,找 π[i] == len(needle) 的位置。
#include <bits/stdc++.h>
using namespace std;

vector<int> prefix_function(const string& s) {
    int n = s.size();
    vector<int> pi(n, 0);
    for (int i = 1; i < n; i++) {
        int j = pi[i - 1];
        while (j > 0 && s[i] != s[j]) j = pi[j - 1];
        if (s[i] == s[j]) j++;
        pi[i] = j;
    }
    return pi;
}

int strStr(string haystack, string needle) {
    if (needle.empty()) return 0;
    int m = needle.size(), n = haystack.size();
    auto pi = prefix_function(needle + '#' + haystack);
    for (int i = m + 1; i <= m + n; i++)
        if (pi[i] == m) return i - 2 * m;
    return -1;
}

int main() {
    cout << strStr("hello",  "ll")  << "\n";  // 2
    cout << strStr("aaaaa",  "bba") << "\n";  // -1
    cout << strStr("sadbutsad", "sad") << "\n";  // 0(第一次出现)
    return 0;
}
追踪(haystack="hello", needle="ll"): 下图展示拼接串 ll#hello 的前缀函数计算过程——当 π[6] = 2 = len("ll") 时找到匹配,位置 = 6 − 2×2 = 2。
🟡 进阶练习
题目 2:字符串最小周期
给定字符串 s,求其最短重复周期的长度 T。
即找最小的 T,使得 s 可以由 s[0..T-1] 重复若干次(或截断)构成。
示例:
"abcabc"  → T = 3("abc" 重复 2 次)
"abababab" → T = 2("ab" 重复 4 次)
"abcd"    → T = 4(整串本身)
核心公式: T = n - π[n-1],当 n % T == 0 时字符串可被整除,否则最小周期为 n。
#include <bits/stdc++.h>
using namespace std;

vector<int> prefix_function(const string& s) {
    int n = s.size();
    vector<int> pi(n, 0);
    for (int i = 1; i < n; i++) {
        int j = pi[i - 1];
        while (j > 0 && s[i] != s[j]) j = pi[j - 1];
        if (s[i] == s[j]) j++;
        pi[i] = j;
    }
    return pi;
}

int min_period(const string& s) {
    int n = s.size();
    auto pi = prefix_function(s);
    int T = n - pi[n - 1];
    return (n % T == 0) ? T : n;
}

int main() {
    cout << min_period("abcabc")   << "\n";  // 3
    cout << min_period("abababab") << "\n";  // 2
    cout << min_period("abcd")     << "\n";  // 4
    cout << min_period("aaaaaa")   << "\n";  // 1
    return 0;
}
原理解释: π[n-1] = k 意味着字符串前 k 个字符 = 后 k 个字符。
若 s 有周期 T,则 π[n-1] ≥ n-T,等价于 T ≤ n - π[n-1]。
n - π[n-1] 正是最小的满足条件的 T。
🔴 挑战练习
题目 3:统计所有出现次数 ≥ 2 的子串数量
给定字符串 s(长度 ≤ 1000),统计在 s 中出现次数 ≥ 2 的不同子串的数量。
提示: 枚举每个可能的子串(起点 i,长度 len),用字符串哈希去重并统计出现次数。
思路: 枚举所有子串,用 set 标记已统计过的,对每个子串用 KMP 统计出现次数。
#include <bits/stdc++.h>
using namespace std;

vector<int> prefix_function(const string& s) {
    int n = s.size();
    vector<int> pi(n, 0);
    for (int i = 1; i < n; i++) {
        int j = pi[i - 1];
        while (j > 0 && s[i] != s[j]) j = pi[j - 1];
        if (s[i] == s[j]) j++;
        pi[i] = j;
    }
    return pi;
}

int count_occurrences(const string& text, const string& pattern) {
    if (pattern.empty()) return 0;
    int m = pattern.size();
    auto pi = prefix_function(pattern + '#' + text);
    int cnt = 0;
    for (int i = m + 1; i < (int)pi.size(); i++)
        if (pi[i] == m) cnt++;
    return cnt;
}

int main() {
    string s; cin >> s;
    int n = s.size();

    set<string> counted;  // 已统计的子串
    int ans = 0;

    for (int i = 0; i < n; i++) {
        for (int len = 1; len <= n - i; len++) {
            string sub = s.substr(i, len);
            if (counted.count(sub)) continue;
            counted.insert(sub);
            if (count_occurrences(s, sub) >= 2) ans++;
        }
    }

    cout << ans << "\n";
}
注: 上面方法对小数据(n ≤ 1000)可行,大数据需用后缀数组或后缀自动机优化至 O(N log N)。
📋 本章总结
- 朴素匹配 O(N × M) 的浪费在于失配后丢弃已匹配信息
- 前缀函数
π[i]= 最长相等真前后缀,是失配跳转的依据 - 「拼接
pattern + '#' + text」一个技巧同时解决匹配、计数、周期 - KMP 的 border 结构是第 9.5 章 AC 自动机 fail 指针的直接原型
💡 章节联系: KMP 解决单模式串匹配;如果要同时匹配成百上千个模式串,请继续学习第 9.5 章:AC 自动机——它的 fail 指针就是把 KMP 的失配跳转搬到了 Trie 上。若只想 O(N+M) 快速判断子串相等,第 3.7 章的字符串哈希也是常用备选。回文与后缀视角的算法见第 9.4 章。