C++ 竞赛编程:USACO 学习指南
🌐 English Version | 📖 当前:中文版


本书是专为参加 USACO(美国计算机奥林匹克竞赛) 的同学编写的 C++ 竞赛编程完整指南,覆盖从 Bronze 到 Platinum 级别所需的核心知识。也可用于 NOIP/CSP 等国内竞赛的算法学习。
📚 本书结构
| 部分 | 内容 | 目标等级 |
|---|---|---|
| C++ 基础 | 语法、控制流、函数、结构体 | 入门 |
| 核心数据结构 | 数组、排序、双指针、哈希 | Bronze/Silver |
| 贪心算法 | 贪心策略与经典应用 | Silver |
| 图论算法 | 图的遍历、最短路、MST、SCC、网络流、树上算法、搜索专题 | Silver/Gold |
| 动态规划 | DP 入门、经典模型、进阶模式、树形 DP | Silver/Gold |
| USACO 竞赛指南 | 竞赛流程、解题策略、Ad Hoc | 全级别 |
| 数学 | 数论、筛法、组合、矩阵快速幂、博弈论 | Silver/Platinum |
| 字符串算法 | 基础操作、KMP、Trie、Manacher、AC 自动机 | Bronze/Platinum |
| 计算几何 | 叉积、凸包、多边形面积 | Gold/Platinum |
| 附录 | 速查手册、题集、技巧、模板、调试指南 | 全级别 |
每章页首徽章标注对应级别:🥉 Bronze / 🥈 Silver / 🥇 Gold / 💎 Platinum,可据此按需选读。
🗺️ USACO 分级学习路线
USACO 分为 Bronze → Silver → Gold → Platinum 四级逐级晋升,赛制详见理解 USACO。各级别对号入座:
🥉 Bronze — 语言基础与暴力思维
| 模块 | 章节 |
|---|---|
| C++ 基础 | 第 2 部分:C++ 基础(2.x 各章) |
| 数据结构入门 | 数组与前缀和 等 3.1–3.4 |
| 贪心 | 第 4 部分:贪心算法(4.x 各章) |
| 模拟与枚举 | 枚举与模拟(2.8)、各章中的暴力/枚举题型 |
| 倍增与构造 | 倍增与构造(2.9,倍增起步 Bronze、构造题 Silver 常见) |
🥈 Silver — 图论与 DP 入门
| 模块 | 章节 |
|---|---|
| 图论基础 | 图的基础(5.1)、BFS 与 DFS(5.2)、并查集(5.6) |
| DP 入门 | DP 入门(6.1)至 进阶 DP 模式(6.3) |
| 数据结构 | 排序与搜索、二分答案 等(3.5–3.9) |
| 字符串入门 | 字符串基础(9.1)、字符串匹配:前缀函数与 KMP(9.2)、Trie 树(9.3) |
| 数学基础 | 数论基础(8.1) |
🥇 Gold — 本书核心进阶内容
| 模块 | 章节 |
|---|---|
| 最短路 | 最短路径(5.4,含负环与差分约束) |
| 数据结构 | 线段树(5.7)、树状数组(5.8) |
| 图论进阶 | MST(5.9)、拓扑排序(5.10)、SCC(5.11)、树链剖分(5.12)、欧拉序(5.13)、网络流(5.14)、树上差分与点分治(5.15)、搜索专题(5.16:剪枝/IDDFS/A*) |
| DP 进阶 | 6.4 折半搜索 至 树形 DP(6.8) |
| 数学 | 素数筛法与积性函数(8.2)、组合数学(8.3) |
💎 Platinum — 高阶专题
| 模块 | 章节 |
|---|---|
| DP 优化 | DP 优化(6.6:单调队列/斜率/决策单调) |
| 矩阵加速 | 矩阵快速幂(8.4) |
| 字符串进阶 | Manacher 与 Z 函数(9.4)、AC 自动机(9.5,Gold/Platinum 常客) |
| 博弈论 | 博弈论入门(8.5) |
| 计算几何 | 计算几何基础(10.1) |
🔗 Gold 依赖链
Gold 各章环环相扣,按依赖关系学习事半功倍:
5.6 并查集 ──→ 5.9 MST ──→ 5.14 网络流(割与连通性思想)
                  │
5.1 树的表示 ──→ 5.13 欧拉序/LCA ──→ 5.12 树链剖分
                  │                    │
                  └──→ 5.15 树上差分与点分治
5.2 BFS/DFS ──→ 5.10 拓扑排序 ──→ 5.11 SCC(缩点后回到 DAG)
5.4 最短路(Dijkstra)──→ 6.8 树形 DP(树上路径计数/换根)
🚀 如何使用本书
💡 学习建议
- 每章都有配套练习题(🟢 简单 / 🟡 中等 / 🔴 困难 / 🏆 挑战),先尝试自己解答再参考题解
- 代码示例均为 C++17,注意竞赛中常见的 I/O 优化写法
- 卡住时用调试指南的对拍流程验证思路
📝 翻译说明:本书中文版正在持续完善中。如遇内容缺失,可参考 英文原版。
⚡ 第二部分:C++ 基础
掌握竞赛编程的 C++ 基石——从第一行 Hello World 到函数与数组。
📚 9 章 · ⏱️ 预计 2-3 周 · 🎯 目标:能编写并编译 C++ 程序
第二部分:C++ 基础
在解决算法题之前,你需要先学会「说这门语言」。第二部分是 C++ 速成课——从第一个程序开始,涵盖函数、数组和向量。你将建立起后续所有章节所需的基础技能。
你将学到什么
| 章节 | 主题 | 核心技能 |
|---|---|---|
| 第 2.1 章 | 你的第一个 C++ 程序 | 变量、输入输出、编译 |
| 第 2.2 章 | 控制流 | if/else、循环、break/continue |
| 第 2.3 章 | 函数与数组 | 可复用代码、数组、向量 |
| 第 2.4 章 | 结构体与类 | 自定义类型、运算符重载、结构体排序 |
| 第 2.5 章 | 分类讨论与矩形几何 | 分类分析、矩形相交、二维差分 |
| 第 2.6 章 | 位运算 | 位运算符、位掩码集合、子集枚举 |
| 第 2.7 章 | 指针与内存 | 地址、指针 vs 引用、new/delete、链表与树节点 |
| 第 2.8 章 | 枚举与模拟 | 解空间、子集/排列枚举、大模拟技巧、枚举+模拟套路 |
| 第 2.9 章 | 倍增与构造 | 2 的幂组合、跳 k 步倍增数组、构造三思路、小数据验证 |
为什么选择 C++?
竞赛选手绝大多数选择 C++,原因有两点:
- 速度 —— C++ 程序比 Python 或 Java 运行更快,而在时间限制严格(通常 10^8 次操作只有 1-2 秒)时,速度至关重要
- STL —— C++ 标准模板库提供了几乎所有你可能用到的数据结构和算法的现成实现
注意: USACO 接受 C++、Java 和 Python。但在顶级选手中 C++ 是最主流的选择,本书专注于 C++。
第二部分学习建议
- 亲手敲代码。 不要复制粘贴。你的手需要熟悉语法。
- 主动制造错误。 故意引入错误,看看会发生什么。读懂编译器报错本身也是一项技能。
- 运行每一个示例。 亲眼看到输出出现在屏幕上,远比仅仅阅读更能加深理解。
出发!
第 2.1 章:你的第一个 C++ 程序
2.1.0 从一道题出发:让电脑替你算数
全书从一道最简单的「题」开始——它朴素,但结构和你将来在 USACO 里遇到的每一道题一模一样:
🐄 题目:两头奶牛的牛奶 农夫 John 有两头奶牛:Bessie 今天产
a升奶,Elsie 产b升。 输入:一行两个整数a和b(读入后才知道具体数值)。 输出:它们今天一共产了多少升奶?
输入:7 5
输出:12
这道题为什么值得作为起点?
注意它和你平时「算数」的区别:
- 写代码时你还不知道 a 和 b 是多少——程序要先「读入」数据,再计算,再「输出」结果。这就是所有竞赛题的固定三段式:读入 → 处理 → 输出。
- 电脑需要被告知每一件小事:在哪里存
a和b?整数和小数有什么区别?结果怎么打印到屏幕上? - 你的代码还必须能被机器执行——需要把它编译成可运行程序,这需要搭建环境。
所以本章的路线自然是你上面看到的目标清单:搭好环境 → 写出第一行代码 → 逐行理解 → 学会变量与输入输出 → 最终独立解出上面这道奶牛题。
| 小节 | 带你完成的事 |
|---|---|
| 2.1.0b | 搭建环境(在线 5 分钟 / 本地可选) |
| 2.1.1 | 第一个程序:Hello World 逐行拆解 |
| 2.1.2 | 竞赛选手的标准程序模板 |
| 2.1.3 | 变量与数据类型——存放 a 和 b |
| 2.1.4–2.1.5 | 输入输出与算术——读入未知数据并求和 |
| 2.1.6 | 综合起来:你的第一个 USACO 风格程序 |
| 练习 | 13 道练习题巩固 |
欢迎!完成本章后,你将:
- 搭建好可用的 C++ 开发环境(用在线编译器只需 5 分钟)
- 编写、编译并运行第一个 C++ 程序
- 理解代码中每一行的含义
- 学会变量、数据类型和输入输出
- 完成 13 道练习题并查看完整题解
2.1.0b 搭建开发环境
写代码之前,你需要一个可以编写和运行代码的地方。有两种选择:在线编译器(推荐新手使用——无需安装)和本地开发环境(可选,适合离线工作)。
选项 A:在线编译器(推荐——从这里开始!)
只需一个浏览器,打开以下任意网站:
| 网站 | 地址 | 说明 |
|---|---|---|
| Codeforces IDE | codeforces.com | 免费注册账号,在任意题目页面点击 "Submit code" 即可打开代码编辑器 |
| Replit | replit.com | 新建 "C++ project",获得完整编辑器 + 终端 |
| Ideone | ideone.com | 粘贴代码,选 C++17,点 "Run" ——最简单的选项 |
| OnlineGDB | onlinegdb.com | 内置调试器,功能完善 |
使用 Ideone(新手最简单):
- 打开 ideone.com
- 在语言下拉框选择 "C++17 (gcc 8.4)"
- 将代码粘贴到文本区
- 点击绿色 "Run" 按钮
- 在底部面板查看输出
就这么简单!无需安装,无需配置。
选项 B:使用 CLion(推荐本地 IDE)
如果你想在自己的电脑上离线编写和运行 C++ 代码,强烈推荐 CLion ——JetBrains 出品的专业 C/C++ IDE。它拥有智能代码补全、一键编译运行和内置调试器,能大幅提升你的效率。
💡 学生免费! CLion 是付费软件,但 JetBrains 为学生提供免费教育许可。用你的
.edu邮箱在 JetBrains 学生许可页面 申请即可。
安装步骤:
第一步:安装 C++ 编译器(CLion 需要外部编译器)
| 操作系统 | 安装方式 |
|---|---|
| Windows | 安装 MSYS2。安装完成后在 MSYS2 终端运行:pacman -S mingw-w64-x86_64-gcc,然后将 C:\msys64\mingw64\bin 添加到系统 PATH |
| Mac | 打开终端运行:xcode-select --install,在弹出的对话框中点击「安装」,等待约 5 分钟 |
| Linux | Ubuntu/Debian:sudo apt install g++ cmake;Fedora:sudo dnf install gcc-c++ cmake |
第二步:安装 CLion
- 前往 CLion 下载页面 下载对应系统的安装包
- 运行安装包并按提示完成安装(保持默认选项即可)
- 首次启动时选择**「激活」**→ 用 JetBrains 学生账号登录,或开始 30 天免费试用
第三步:创建第一个项目
- 打开 CLion,点击 "New Project"
- 选择 "C++ Executable",将语言标准设为C++17
- 点击 "Create"——CLion 会自动生成包含
main.cpp的项目 - 在
main.cpp中编写代码,点击右上角绿色**▶ Run** 按钮即可编译运行 - 输出会出现在底部的"Run" 面板中
🔧 CLion 自动检测编译器: 首次启动时,CLion 会自动扫描已安装的编译器(GCC / Clang / MSVC)。如果检测成功,你会在 "Settings → Build → Toolchains" 中看到绿色对勾 ✅。若未检测到,请确认第一步的编译器已正确安装并添加到 PATH。
CLion 竞赛编程实用功能:
- 内置终端:底部的 Terminal 标签可以直接输入测试数据
- 调试器:设置断点、逐行执行代码、查看变量值——追踪 bug 的必备工具
- 代码格式化:Ctrl + Alt + L(Mac:Cmd + Option + L)自动整理代码缩进
如何编译和运行(本地)
安装好 g++ 后,编译和运行方法如下:
g++ -o hello hello.cpp -std=c++17
逐字分解这条命令:
| 部分 | 含义 |
|---|---|
g++ | C++ 编译器程序名 |
-o hello | -o 表示「输出文件名」;hello 是我们给程序起的名字 |
hello.cpp | 要编译的源文件(我们的 C++ 代码) |
-std=c++17 | 使用 C++17 版本(功能最丰富) |
运行方法:
./hello        # Linux/Mac:./ 表示「在当前目录」
hello.exe      # Windows(.exe 会自动添加)
🤔 为什么是
./hello而不是直接hello? 在 Linux/Mac 上,系统默认不会从当前目录运行程序(出于安全考虑)。./明确告诉系统「在当前目录找这个程序」。
2.1.1 Hello, World!
每段编程之旅都从同一个地方开始。下面是最简单的完整 C++ 程序:
#include <iostream>    // 告诉编译器我们要使用输入/输出功能

int main() {           // 每个 C++ 程序都从 main() 开始执行
    std::cout << "Hello, World!" << std::endl;  // 打印到屏幕
    return 0;          // 0 = 成功,程序正常结束
}
运行后你应该看到:
Hello, World!
每一行的含义:
第 1 行:#include <iostream>
这是一条预处理指令——在正式编译之前执行的指令。它的意思是「把 iostream 库的内容复制粘贴到我的程序中」。iostream 库提供了 cin(读取输入)和 cout(打印输出)。没有这行,你的程序就无法输出任何内容。
可以这样理解:做饭之前,你需要先把食材拿进厨房。
第 3 行:int main()
这声明了 main 函数——每个 C++ 程序的起点。运行一个 C++ 程序时,计算机总是从 main() 内部的第一行开始执行。int 表示这个函数返回一个整数(退出码)。每个 C++ 程序必须有且仅有一个 main。
第 4 行:std::cout << "Hello, World!" << std::endl;
这行打印文字。拆解来看:
std::cout—— 「控制台输出」流(可以理解为屏幕)<<—— 「放入」运算符;将数据送入流"Hello, World!"—— 要打印的文字(引号本身不会被打印)<< std::endl—— 添加换行(相当于按回车);—— C++ 中每条语句都以分号结束
第 5 行:return 0;
退出 main 并告诉操作系统程序成功结束。(非零返回值表示发生了错误。)
编译流程
图示:编译流程

上图展示了从源代码到可执行文件的三个阶段:你的 .cpp 文件输入给 g++ 编译器,最终生成可运行的二进制文件。理解这个流程有助于在编译错误发生前就预防它们。
2.1.2 竞赛选手的标准模板
解 USACO 题目时,你会用到一套标准模板。下面是完整带注释的版本:
#include <bits/stdc++.h>      // 「全包含」——一次性包含所有标准库
using namespace std;           // 让我们可以写 cout 而不是 std::cout

int main() {
    ios_base::sync_with_stdio(false);  // 禁用 C 和 C++ I/O 的同步(更快)
    cin.tie(NULL);                      // 解除 cin 和 cout 的绑定(输入更快)

    // 你的解题代码写在这里

    return 0;
}
为什么用 #include <bits/stdc++.h>?
这是 GCC 专有的头文件,一次性包含所有标准库。不用再写:
#include <iostream>
#include <vector>
#include <algorithm>
#include <map>
// ... 还有 20 多行
一行搞定。在竞赛编程中,这是普遍做法,能节省时间。
注意:
bits/stdc++.h只在 GCC 编译器(USACO 评测机使用的编译器)下有效。竞赛编程中完全没问题,但不要在生产软件中使用。
为什么用 using namespace std;?
标准库把所有内容放在名为 std 的命名空间中。没有这行,你需要到处写 std::cout、std::vector、std::sort。有了 using namespace std;,直接写 cout、vector、sort——简洁得多。
I/O 加速行
ios_base::sync_with_stdio(false);
cin.tie(NULL);
这两行让 cin 和 cout 快得多。没有它们,读取大量输入可能慢 10 倍,即使算法正确也可能导致「超时(TLE)」。每次都要加上它们。
🐛 常见错误: 加了这两行后,不要混用
cin/cout和scanf/printf。选一种风格坚持用。
2.1.3 变量与数据类型
变量是内存中一个有名字的存储位置。C++ 中每个变量都有一个类型——类型告诉计算机需要分配多少内存,以及里面会存什么数据。
🧠 思维模型:变量就像带标签的盒子
当你写:   int score = 100;

计算机做了三件事:
  1. 创建一个足以容纳整数的盒子(4 字节)
  2. 在盒子上贴上标签 "score"
  3. 把数字 100 放进盒子

竞赛编程必备类型
#include <bits/stdc++.h>
using namespace std;

int main() {
    // int:整数,范围:-2,147,483,648 到 +2,147,483,647(约 ±20 亿)
    int apples = 42;
    int temperature = -5;

    // long long:大整数,范围:约 ±9.2 × 10^18
    long long population = 7800000000LL;  // LL 后缀表示「这是 long long 字面量」
    long long trillion = 1000000000000LL;

    // double:小数/分数
    double pi = 3.14159265358979;
    double percentage = 99.5;

    // bool:只有 true 或 false
    bool isRaining = true;
    bool finished = false;

    // char:单个字符(以 0-255 的数字存储)
    char grade = 'A';     // 单引号表示字符
    char newline = '\n';  // 特殊字符:换行符

    // string:字符序列
    string name = "Alice";         // 双引号表示字符串
    string greeting = "Hello!";

    // 打印所有变量:
    cout << "苹果数量: " << apples << "\n";
    cout << "人口: " << population << "\n";
    cout << "圆周率: " << pi << "\n";
    cout << "在下雨: " << isRaining << "\n";  // true 打印 1,false 打印 0
    cout << "成绩: " << grade << "\n";
    cout << "姓名: " << name << "\n";

    return 0;
}
图示:C++ 数据类型参考

如何选择正确的类型
| 使用场景 | 选用类型 |
|---|---|
| 计数、小数字 | int |
| 可能超过 20 亿的数字 | long long |
| 小数/分数答案 | double |
| 是/否标志 | bool |
| 单个字母或字符 | char |
| 单词或句子 | string |
变量命名规则
C++ 对变量名有严格规定。掌握这些规则很关键——命名不当会导致 bug,非法名字则无法编译。
形式规则(编译器强制执行)
✅ 合法名称必须:
- 以字母(a-z、A-Z)或下划线
_开头 - 只包含字母、数字(0-9)和下划线
- 不能是 C++ 保留关键字
❌ 以下名称无法编译:
| 非法名称 | 错误原因 |
|---|---|
3apples | 以数字开头 |
my score | 包含空格 |
my-score | 包含连字符(会被解释为减号) |
int | 保留关键字 |
class | 保留关键字 |
return | 保留关键字 |
⚠️ 区分大小写!
score、Score和SCORE是三个完全不同的变量。这是常见 bug 来源——命名时保持一致。
常见命名风格
C++ 中有几种广泛使用的命名规范。竞赛编程中不必只选一种,但了解它们有助于读懂别人的代码:
| 风格 | 示例 | 通常用于 |
|---|---|---|
| 驼峰式(camelCase) | numStudents、totalScore | 局部变量、函数参数 |
| 帕斯卡式(PascalCase) | MyClass、GraphNode | 类、结构体、类型名 |
| 下划线式(snake_case) | num_students、total_score | 变量、函数(C/Python 风格) |
| 全大写(ALL_CAPS) | MAX_N、MOD、INF | 常量、宏 |
| 单字母 | n、m、i、j | 循环下标、数学风格竞赛编程 |
竞赛编程中最常用驼峰式和单字母名称。公司的生产代码中,根据风格指南通常用 snake_case 或 camelCase。
命名最佳实践
1. 有描述性——从名字就能看出用途:
// ✅ 好——一眼就知道每个变量存什么
int numCows = 5;
long long totalMilk = 0;
string cowName = "Bessie";
int maxScore = 100;

// ❌ 差——语法正确但令人困惑
int x = 5;            // x 是什么?计数?下标?值?
long long t = 0;      // t 是什么?时间?总计?临时变量?
string n = "Bessie";  // n 通常表示「数字」——用来存名字很误导!
2. 只在含义显而易见时使用单字母名称:
// ✅ 可接受——这些是公认的惯例
for (int i = 0; i < n; i++) { ... }    // i、j、k 用于循环下标
int n, m;                                // n = 计数,m = 第二维
cin >> n >> m;                           // 竞赛编程中人人都这样写

// ❌ 令人困惑——单字母但没有明确惯例
int q = 5;   // q 是计数?查询数?系数?
char z = 'A'; // 为什么用 z?
3. 常量用全大写,方便识别:
const int MAX_N = 200005;        // 数组最大长度
const int MOD = 1000000007;      // 取模常量
const long long INF = 1e18;      // 用于比较的「无穷大」
const double PI = 3.14159265359; // 数学常数
4. 避免外形相似的名称:
// ❌ 容易混淆
int total1 = 10;
int totall = 20;  // 这是「total-L」还是手误的「total-1」?

int O = 0;        // 字母 O 看起来像数字 0
int l = 1;        // 小写 L 看起来像数字 1

// ✅ 更好的替代
int totalA = 10;
int totalB = 20;
5. 不要用下划线加大写字母开头:
// ❌ 能编译,但被 C++ 标准保留
int _Score = 100;   // _X 形式的名称被编译器/库保留
int __value = 42;   // 双下划线开头始终保留

// ✅ 安全替代
int score = 100;
int myValue = 42;
竞赛编程 vs 生产代码的命名对比
| 方面 | 竞赛编程 | 生产/学校项目 |
|---|---|---|
| 变量名长度 | 简短即可:n、m、dp、adj | 有描述性:numStudents、adjacencyList |
| 循环变量 | 永远用 i、j、k | i、j、k 也没问题 |
| 常量 | MAXN、MOD、INF | kMaxSize、kModulus(Google 风格) |
| 注释 | 极少——速度优先 | 详尽——可读性优先 |
| 目标 | 快速编写、快速解题 | 编写别人能维护的代码 |
💡 本书中: 我们会混用两种风格——讲解时用描述性名称保持清晰,解题时用简短名称。关键原则:看到变量名就应该立刻知道它存的是什么。
深入了解:char、string 与字符-整数转换
我们已经简要介绍了 char 和 string。由于许多 USACO 题目涉及字符处理、数字提取和字符串操作,让我们深入看看这两种重要类型。
char 与 ASCII——每个字符都是一个数字
C++ 中的 char 以 1 字节整数(0-255)存储。每个字符按照 ASCII 表(美国信息交换标准代码)映射到一个数字。不需要背整张表,但记住几个关键范围非常有用:

关键关系:
• 'a' - 'A' = 32     (大小写字母差值)
• '0' 的 ASCII 值是 48(不是 0!)
• 数字、大写字母、小写字母各自在连续范围内
#include <bits/stdc++.h>
using namespace std;

int main() {
    char ch = 'A';

    // char 本质上是整数——可以打印其数值
    cout << ch << "\n";        // 打印:A(字符形式)
    cout << (int)ch << "\n";   // 打印:65(ASCII 值)

    // 可以对 char 做算术!
    char next = ch + 1;       // 'A' + 1 = 66 = 'B'
    cout << next << "\n";     // 打印:B

    // 比较 char(比较 ASCII 值)
    cout << ('a' < 'z') << "\n";   // 1(真,因为 97 < 122)
    cout << ('A' < 'a') << "\n";   // 1(真,因为 65 < 97)

    return 0;
}
char ↔ int 转换——最常用的技巧
竞赛编程中,你需要频繁地在字符数字和整数值之间转换。以下是完整指南:
1. 数字字符 → 整数值(例如 '7' → 7)
char ch = '7';
int digit = ch - '0';    // '7' - '0' = 55 - 48 = 7
cout << digit << "\n";   // 打印:7

// 这行得通是因为数字字符 '0'~'9' 的 ASCII 值是连续的:
// '0'=48, '1'=49, ..., '9'=57
// 所以 ch - '0' 正好是实际数值(0~9)
2. 整数值 → 数字字符(例如 7 → '7')
int digit = 7;
char ch = '0' + digit;   // 48 + 7 = 55 = '7'
cout << ch << "\n";      // 打印:7(字符 '7')

// 仅对数字 0~9 有效
3. 大小写互转
char upper = 'C';
char lower = upper + 32;           // 'C'(67) + 32 = 'c'(99)
cout << lower << "\n";            // 打印:c

// 更易读的写法:
char lower2 = upper - 'A' + 'a';  // 'C'-'A' = 2,'a'+2 = 'c'
cout << lower2 << "\n";           // 打印:c

// 反向:小写 → 大写
char ch = 'f';
char upper2 = ch - 'a' + 'A';    // 'f'-'a' = 5,'A'+5 = 'F'
cout << upper2 << "\n";           // 打印:F

// 使用内置函数(更推荐,可读性更好):
cout << (char)toupper('g') << "\n";  // 打印:G
cout << (char)tolower('G') << "\n";  // 打印:g
4. 判断字符类型(USACO 中非常实用)
char ch = '5';

// 判断是否为数字
if (ch >= '0' && ch <= '9') {
    cout << "是数字!\n";
}

// 判断是否为大写字母
if (ch >= 'A' && ch <= 'Z') {
    cout << "大写字母!\n";
}

// 判断是否为小写字母
if (ch >= 'a' && ch <= 'z') {
    cout << "小写字母!\n";
}

// 或使用内置函数:
// isdigit(ch), isupper(ch), islower(ch), isalpha(ch), isalnum(ch)
if (isdigit(ch)) cout << "数字!\n";
if (isalpha(ch)) cout << "字母!\n";
5. 经典模式:从字符串中提取数字
string s = "abc123def";
int sum = 0;
for (char ch : s) {
    if (ch >= '0' && ch <= '9') {
        sum += ch - '0';  // 将数字字符转为整数并累加
    }
}
cout << "各位数字之和:" << sum << "\n";  // 1+2+3 = 6
string 详细指南
string 是 C++ 的内置文本类型。与单个 char 不同,string 存储一串字符,并提供许多实用操作。
基本操作:
#include <bits/stdc++.h>
using namespace std;

int main() {
    // 创建字符串
    string s1 = "Hello";
    string s2 = "World";
    string empty = "";           // 空字符串
    string repeated(5, 'x');     // "xxxxx"——5 个 'x'

    // 长度
    cout << s1.size() << "\n";   // 5(等同于 s1.length())

    // 拼接
    string s3 = s1 + " " + s2;  // "Hello World"
    s1 += "!";                   // s1 变为 "Hello!"

    // 访问单个字符(从 0 开始,与数组相同)
    cout << s3[0] << "\n";      // 'H'
    cout << s3[6] << "\n";      // 'W'

    // 修改单个字符
    s3[0] = 'h';                // "hello World"

    // 比较(字典序)
    cout << ("apple" < "banana") << "\n";   // 1(真)
    cout << ("abc" == "abc") << "\n";       // 1(真)
    cout << ("abc" < "abd") << "\n";        // 1(真,逐字符比较)

    return 0;
}
遍历字符串:
string s = "USACO";

// 方法一:下标循环
for (int i = 0; i < (int)s.size(); i++) {
    cout << s[i] << " ";  // U S A C O
}
cout << "\n";

// 方法二:范围 for 循环(更简洁)
for (char ch : s) {
    cout << ch << " ";    // U S A C O
}
cout << "\n";

// 方法三:引用范围 for(可就地修改)
for (char& ch : s) {
    ch = tolower(ch);     // 将每个字符转为小写
}
cout << s << "\n";        // "usaco"
常用 string 函数:
string s = "Hello, World!";

// 子串:s.substr(起始位置, 长度)
string sub = s.substr(7, 5);     // "World"(从第 7 个字符开始取 5 个)
string sub2 = s.substr(7);       // "World!"(从第 7 个到结尾)

// 查找:s.find("文本")——返回下标,找不到返回 string::npos
size_t pos = s.find("World");    // 7(注意类型是 size_t,不是 int!)
if (s.find("xyz") == string::npos) {
    cout << "未找到!\n";
}

// 追加
s.append(" Hi");                 // "Hello, World! Hi"
// 等价于:s += " Hi";

// 插入
s.insert(5, "!!");               // "Hello!!, World! Hi"

// 删除:s.erase(起始位置, 个数)
s.erase(5, 2);                   // 从第 5 位删除 2 个字符

// 替换:s.replace(起始位置, 个数, "新文本")
string msg = "I love cats";
msg.replace(7, 4, "dogs");       // "I love dogs"
从输入读取字符串:
// cin >> 读取一个单词(遇到空白字符停止)
string word;
cin >> word;    // 输入 "Hello World" → word = "Hello"

// getline 读取整行(包含空格)
string line;
getline(cin, line);   // 输入 "Hello World" → line = "Hello World"

// ⚠️ 注意:cin >> 之后,调用 getline 前先 cin.ignore()!
int n;
cin >> n;
cin.ignore();          // 消耗残留的 '\n'
string fullLine;
getline(cin, fullLine); // 现在可以正确读取
string 与数字互转:
// 字符串 → 整数
string numStr = "42";
int num = stoi(numStr);         // stoi = "string to int" → 42
long long big = stoll("123456789012345"); // stoll = "string to long long"

// 字符串 → 浮点数
double d = stod("3.14");       // stod = "string to double" → 3.14

// 整数 → 字符串
int x = 255;
string s = to_string(x);       // "255"
string s2 = to_string(3.14);   // "3.140000"
char 数组(C 风格字符串)——了解即可
在 C(以及旧式 C++ 代码)中,字符串以以 '\0' 结尾的 char 数组存储。竞赛编程中你很少需要用到它(改用 string),但应该能认出它:
// C 风格字符串(char 数组)
char greeting[] = "Hello";  // 实际存储:H e l l o \0(共 6 个字符!)
// '\0'(空字符)标记字符串结束

// 警告:必须确保数组足够大以容纳字符串 + '\0'
char name[20];              // 最多可存 19 个字符 + '\0'

// char 数组与 string 互转
string s = greeting;        // char 数组 → string(自动转换)
// string → char 数组:使用 s.c_str() 获得 const char*
为什么竞赛编程中 string 比 char[] 更好:
| 特性 | char[](C 风格) | string(C++) |
|---|---|---|
| 大小 | 需要预定义最大长度 | 自动增长 |
| 拼接 | strcat()——手动、易出错 | s1 + s2——简单 |
| 比较 | strcmp()——返回整数 | s1 == s2——直观 |
| 长度 | strlen()——每次 O(N) | s.size()——O(1) |
| 安全性 | 缓冲区溢出风险 | 安全,由 C++ 管理 |
⚡ USACO 专业技巧: 除非题目明确要求
char数组,否则始终用string。字符串操作更简洁、更安全、更易调试。char数组在竞赛编程中唯一常见的使用场景是用scanf/printf读取超大输入以提速——但加上sync_with_stdio(false)后,string+cin/cout对 99% 的 USACO 题目已经足够快。
快速参考:字符/字符串速查表
| 操作 | 代码 | 示例 |
|---|---|---|
| 数字字符 → 整数 | ch - '0' | '7' - '0' → 7 |
| 整数 → 数字字符 | '0' + digit | '0' + 3 → '3' |
| 大写 → 小写 | ch - 'A' + 'a' 或 tolower(ch) | 'C' → 'c' |
| 小写 → 大写 | ch - 'a' + 'A' 或 toupper(ch) | 'f' → 'F' |
| 是数字? | ch >= '0' && ch <= '9' 或 isdigit(ch) | '5' → true |
| 是字母? | isalpha(ch) | 'A' → true |
| 字符串长度 | s.size() 或 s.length() | "abc" → 3 |
| 子串 | s.substr(起始, 长度) | "Hello".substr(1,3) → "ell" |
| 查找 | s.find("文本") | 返回下标或 npos |
| 字符串 → 整数 | stoi(s) | stoi("42") → 42 |
| 整数 → 字符串 | to_string(n) | to_string(42) → "42" |
| 遍历字符串 | for (char ch : s) | 逐字符遍历 |
⚠️ 整数溢出——竞赛编程中的头号 Bug
当一个数超过它所属类型的范围时会发生什么?
// 把 int 想象成一个从 -2,147,483,648 到 2,147,483,647 的表盘
// 当你超过最大值,它会回绕到最小值!

int x = 2147483647;  // int 的最大值
cout << x << "\n";   // 打印:2147483647
x++;                 // 加 1……会发生什么?
cout << x << "\n";   // 打印:-2147483648(溢出!回绕了!)
这就像老式汽车里程表到了 999999 又回到 000000。
如何避免溢出:
int a = 1000000000;    // 10 亿——int 能放下
int b = 1000000000;    // 10 亿——int 能放下
// int wrong = a * b;  // 溢出!a*b = 10^18,int 放不下

long long correct = (long long)a * b;  // 乘之前把其中一个转成 long long
cout << correct << "\n";  // 1000000000000000000 ✓

// 经验法则:如果 N 最大为 10^9,你又需要将两个这样的值相乘,就用 long long
⚡ 专业技巧: 拿不准时,用
long long。它比int稍慢,但能防止难以发现的溢出 bug。
2.1.4 用 cin 和 cout 进行输入输出
用 cout 打印输出
int score = 95;
string name = "Alice";

cout << "分数:" << score << "\n";          // 分数:95
cout << name << " 得了 " << score << "\n"; // Alice 得了 95

// "\n" vs endl
cout << "第一行" << "\n";   // 快——只是一个换行符
cout << "第二行" << endl;   // 慢——清空缓冲区并换行
⚡ 专业技巧: 始终用
"\n"而不是endl。endl会清空输出缓冲区,比"\n"慢得多。对于输出量大的题目,使用endl可能导致超时!
用 cin 读取输入
int n;
cin >> n;    // 从输入读取一个整数

string s;
cin >> s;    // 读取一个单词(遇到空白字符停止——空格、制表符、换行)

double x;
cin >> x;    // 读取一个小数
cin >> 会自动跳过空白字符。这意味着空格、制表符和换行都被同等对待。因此以下两种输入格式的处理方式完全相同:
输入格式一(同一行):  42 hello 3.14
输入格式二(分多行):
42
hello
3.14
两种都用以下代码处理:
int a; string b; double c;
cin >> a >> b >> c;  // 无论格式如何都能读取这三个值
读取多个值——最常见的 USACO 模式
USACO 题目几乎都以「读取 N,然后读取 N 个值」开头。方法如下:
典型 USACO 输入:
5          ← 第一行:N(元素个数)
10 20 30 40 50   ← 后续行:N 个值
int n;
cin >> n;              // 读取 N

for (int i = 0; i < n; i++) {
    int x;
    cin >> x;          // 读取每个元素
    cout << x * 2 << "\n";  // 处理它
}
复杂度分析:
- 时间:O(N)——读取 N 个数,每个 O(1) 处理
- 空间:O(1)——只有一个变量
x,不存储所有数据
对于输入 5\n10 20 30 40 50,会打印:
20
40
60
80
100
读取完整的一行(包含空格)
有时输入的一行包含多个单词。cin >> 每次只读一个单词,所以要用 getline:
string fullName;
getline(cin, fullName);  // 读取整行,包括空格
cout << "姓名:" << fullName << "\n";
🐛 常见 Bug: 混用
cin >>和getline会出问题。cin >> n之后,缓冲区里还残留一个\n。这时调用getline会读到那个空行而不是下一行。修复方法:在cin >>之后、getline之前调用cin.ignore()。
控制小数输出精度
double y = 3.14159;

cout << y << "\n";                            // 3.14159(默认)
cout << fixed << setprecision(2) << y << "\n"; // 3.14(恰好 2 位小数)
cout << fixed << setprecision(6) << y << "\n"; // 3.141590(6 位小数)
2.1.5 基本算术
#include <bits/stdc++.h>
using namespace std;

int main() {
    int a = 17, b = 5;

    cout << a + b << "\n";   // 22  (加法)
    cout << a - b << "\n";   // 12  (减法)
    cout << a * b << "\n";   // 85  (乘法)
    cout << a / b << "\n";   // 3   (整数除法——截断向零!)
    cout << a % b << "\n";   // 2   (取模——整除后的余数)

    // 整数除法示例:
    // 17 ÷ 5 = 3 余 2
    // 因此:17 / 5 = 3,17 % 5 = 2

    double x = 17.0, y = 5.0;
    cout << x / y << "\n";   // 3.4(操作数是 double 时进行实数除法)

    // 复合赋值运算符:
    int n = 10;
    n += 5;    // 等同于:n = n + 5   → n 现在是 15
    n -= 3;    // 等同于:n = n - 3   → n 现在是 12
    n *= 2;    // 等同于:n = n * 2   → n 现在是 24
    n /= 4;    // 等同于:n = n / 4   → n 现在是 6
    n++;       // 等同于:n = n + 1   → n 现在是 7
    n--;       // 等同于:n = n - 1   → n 现在是 6

    cout << n << "\n";  // 6

    return 0;
}
🤔 为什么整数除法会截断?
当两个操作数都是整数时,C++ 执行整数除法——直接丢弃小数部分。17 / 5 得 3,不是 3.4。这是有意为之,而且非常有用(例如:找出某个东西属于哪个「组」)。
// 200 分钟等于几小时?
int minutes = 200;
int hours = minutes / 60;     // 200 / 60 = 3(不是 3.33…)
int remaining = minutes % 60; // 200 % 60 = 20
cout << hours << " 小时 " << remaining << " 分钟\n";  // 3 小时 20 分钟
// 要得到小数结果,至少一个操作数必须是 double:
int a = 7, b = 2;
cout << a / b << "\n";           // 3    (整数除法)
cout << (double)a / b << "\n";   // 3.5  (先把 a 转成 double)
cout << a / (double)b << "\n";   // 3.5  (先把 b 转成 double)
cout << 7.0 / 2 << "\n";        // 3.5  (字面量 7.0 是 double)
2.1.6 你的第一个 USACO 风格程序
让我们把所有内容综合起来,写一个读取输入、产生输出的完整程序——就像真正的 USACO 题目。
题目: 读取两个整数 N 和 M,打印它们的和、差、积、整数商和余数。
分析思路:
- 需要两个变量存储 N 和 M
- 用
cin读取 - 用
cout打印每个结果 - N 和 M 可能很大,应该用
long long吗?安全起见用它。
💡 新手解题流程:
遇到题目时,别急着写代码。先用自然语言想清楚步骤:
- 理解题目:输入是什么?输出是什么?约束是什么?
- 手动推演样例:用样例输入,手算出输出,确认自己理解了题目
- 考虑数据范围:N 和 M 最大多少?会不会溢出?
- 写伪代码:
读取 → 计算 → 输出- 翻译成 C++:将伪代码逐行转化为真实代码
本题:读取两个数 → 执行五种运算 → 输出五个结果。非常直接!
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    long long n, m;
    cin >> n >> m;  // 在同一行读取两个数

    cout << n + m << "\n";  // 和
    cout << n - m << "\n";  // 差
    cout << n * m << "\n";  // 积
    cout << n / m << "\n";  // 整数商
    cout << n % m << "\n";  // 余数

    return 0;
}
复杂度分析:
- 时间:O(1)——只有固定次数的算术运算
- 空间:O(1)——只有两个变量
样例输入:
17 5
样例输出:
22
12
85
3
2
⚠️ 第 2.1 章常见错误
| # | 错误 | 示例 | 错在哪里 | 修复方法 |
|---|---|---|---|---|
| 1 | 整数溢出 | int a = 1e9; int b = a*a; | a*b = 10^18 超过 int 最大值约 2.1×10^9,结果「回绕」成错误值 | 用 long long |
| 2 | 使用 endl | cout << x << endl; | endl 清空输出缓冲区,大量输出时比 "\n" 慢 10 倍以上,可能导致超时 | 用 "\n" |
| 3 | 忘记 I/O 加速 | 缺少 sync_with_stdio 和 cin.tie | 默认情况下 cin/cout 与 C 的 scanf/printf 同步,大量输入时极慢 | 始终加上这两行 |
| 4 | 整数除法意外 | 7/2 期望 3.5 却得到 3 | 两个整数相除,C++ 截断小数部分 | 强转 double:(double)7/2 |
| 5 | 缺少分号 | cout << x | C++ 每条语句必须以 ; 结尾,否则编译失败 | cout << x; |
| 6 | 混用 cin >> 和 getline | cin >> n 然后 getline(cin, s) | cin >> 在缓冲区留下 \n,getline 读到空行 | 中间加 cin.ignore() |
本章总结
📌 核心要点
| 概念 | 要点 | 为什么重要 |
|---|---|---|
#include <bits/stdc++.h> | 一次性包含所有标准库 | 竞赛中节省时间,不用记每个头文件 |
using namespace std; | 省略 std:: 前缀 | 代码更简洁,竞赛编程的通用做法 |
int main() | 程序唯一入口点 | 每个 C++ 程序必须有且仅有一个 main |
cin >> x / cout << x | 读取输入/写出输出 | USACO 的核心 I/O 方法 |
int vs long long | 约 ±2×10^9 vs 约 ±9.2×10^18 | 类型用错 = 溢出 = 答案错误(竞赛中最常见的 bug) |
"\n" vs endl | "\n" 快 10 倍 | 决定 AC 还是超时 |
a / b 和 a % b | 整数除法和取模 | 时间转换、分组等核心工具 |
| I/O 加速行 | sync_with_stdio(false) + cin.tie(NULL) | 竞赛模板必备,忘加可能超时 |
❓ 常见问题
Q1:bits/stdc++.h 会拖慢编译速度吗?
A:是的,编译时间可能增加 1-2 秒。但竞赛中编译时间不计入时限,不影响结果。生产项目中不要用它。
Q2:默认用 int 还是 long long?
A:经验法则——拿不准就用
long long。它比int稍慢(在现代 CPU 上几乎感受不到),但能防止溢出。特别注意:两个int相乘,结果可能需要long long。
Q3:USACO 里不能用 scanf/printf 吗?
A:可以用!但加了
sync_with_stdio(false)后,不能混用cin/cout和scanf/printf。建议新手坚持用cin/cout,更安全。
Q4:可以省略 return 0; 吗?
A:C++11 及以后,
main()执行到末尾时编译器自动返回 0,技术上可以省略。但写上更清晰。
Q5:代码本地运行正确,USACO 评测却 Wrong Answer,怎么回事?
A:最常见的三个原因:① 整数溢出(本该用
long long却用了int);② 没处理所有边界情况;③ 输出格式错误(多了或少了空格/换行)。
🔗 与后续章节的联系
- 第 2.2 章(控制流)在本章基础上新增
if/else条件和for/while循环,让你能处理「重复 N 次」的任务 - 第 2.3 章(函数与数组)介绍函数(将代码组织成可复用的块)和数组(存储一组数据)——USACO 解题的核心工具
- 第 3.1 章(STL 核心用法)介绍
vector和sort等 STL 工具,大大简化本章手写的逻辑 - 本章学到的整数溢出预防技巧会贯穿全书,特别在第 3.2 章(前缀和)和第 6.1-6.3 章(DP)中反复用到
练习题
按顺序完成所有题目——难度逐渐递增。每题都有完整题解,尝试自己解决后再查看。
每道题只需新增 1-3 行代码,帮助你练习输入 C++ 代码和运行程序。
热身 2.1.1 — 个人问候 编写一个程序,精确打印以下内容(换成你自己的名字):
Hello, Alice!
My favorite number is 7.
I am learning C++.
(所有值可以硬编码——不需要读取输入。)
思路: 用 cout 打印三行。无需读取输入。
#include <bits/stdc++.h>
using namespace std;

int main() {
    cout << "Hello, Alice!\n";
    cout << "My favorite number is 7.\n";
    cout << "I am learning C++.\n";
    return 0;
}
关键点:
- 每条
cout语句以;\n"结尾——\n产生换行 - 也可以将多个
<<连在一条cout上 - 没有输入时不需要
cin
热身 2.1.2 — 五行数字
打印数字 1 到 5,每行一个。用恰好 5 条独立的 cout 语句(还没学循环——第 2.2 章会讲)。
思路: 五条独立的 cout 语句,每条打印一个数字。
#include <bits/stdc++.h>
using namespace std;

int main() {
    cout << 1 << "\n";
    cout << 2 << "\n";
    cout << 3 << "\n";
    cout << 4 << "\n";
    cout << 5 << "\n";
    return 0;
}
关键点:
cout << 1 << "\n"打印数字 1 后跟换行- 第 2.2 章会学用循环来做这件事——但手动写对小数量完全没问题
热身 2.1.3 — 翻倍 从输入读取一个整数,打印它的 2 倍。
样例输入: 7
样例输出: 14
思路: 读入变量,乘以 2,打印。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;
    cout << n * 2 << "\n";
    return 0;
}
关键点:
cin >> n读取一个整数存入n- 可以直接在
cout里做算术:n * 2先计算,再打印 - 若 n 可能很大(最大 10^9),用
long long n,因为n * 2可能溢出int
热身 2.1.4 — 两数之和 读取同一行上的两个整数,打印它们的和。
样例输入: 15 27
样例输出: 42
思路: 读取两个整数,相加,打印。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int a, b;
    cin >> a >> b;
    cout << a + b << "\n";
    return 0;
}
关键点:
cin >> a >> b在一条语句中读取两个值——无论它们在同一行还是不同行都有效- 在同一行声明两个变量:
int a, b;等价于int a; int b;
热身 2.1.5 — 打招呼
读取一个单词(名字,不含空格),打印 Hi, [name]!
样例输入: Bob
样例输出: Hi, Bob!
思路: 读取字符串,嵌入问候语中打印。
#include <bits/stdc++.h>
using namespace std;

int main() {
    string name;
    cin >> name;
    cout << "Hi, " << name << "!\n";
    return 0;
}
关键点:
string name;声明一个存储文本的变量cin >> name读取一个单词(遇到第一个空格停止)- 注意
cout的链式写法:字符串字面量 + 变量 + 字符串字面量
这些题需要综合运用输入、算术和输出。编码前先想清楚数学关系。
题目 2.1.6 — 年龄换算 读取一个人的整岁年龄,打印其大约的天数(按每年 365 天计算,不考虑闰年)。
样例输入: 15
样例输出: 5475
思路: 年龄乘以 365。由于年龄 × 365 不会超过 int 范围(最大约 150 岁 → 150×365 = 54750,远小于 int 上限),用 int 即可。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int years;
    cin >> years;
    cout << years * 365 << "\n";
    return 0;
}
关键点:
years * 365按整数计算——这里不存在溢出风险- 如果还要换算成小时、分钟、秒,为安全起见改用
long long
题目 2.1.7 — 秒数转换 读取秒数 S(1 ≤ S ≤ 10^9),转换为小时、分钟和剩余秒数。
样例输入: 3661
样例输出:
1 hours
1 minutes
1 seconds
思路: 使用整数除法和取模。先除以 3600 得小时数,余数(mod 3600)再除以 60 得分钟数,最后剩余的是秒数。
#include <bits/stdc++.h>
using namespace std;

int main() {
    long long s;
    cin >> s;

    long long hours = s / 3600;         // 每小时 3600 秒
    long long remaining = s % 3600;     // 去掉完整小时后剩余的秒数
    long long minutes = remaining / 60; // 每分钟 60 秒
    long long seconds = remaining % 60; // 去掉完整分钟后剩余的秒数

    cout << hours << " hours\n";
    cout << minutes << " minutes\n";
    cout << seconds << " seconds\n";

    return 0;
}
关键点:
- 用
long long是因为 S 最大 10^9(int 也够,但 long long 是好习惯) - 核心思路:
s % 3600得到去掉完整小时后的秒数,再除以 60 得分钟 - 验证:3661 → 3661/3600=1 小时,3661%3600=61,61/60=1 分钟,61%60=1 秒 ✓
题目 2.1.8 — 矩形 读取矩形的长 L 和宽 W,打印它的面积和周长。
样例输入: 6 4
样例输出:
Area: 24
Perimeter: 20
思路: 面积 = L × W,周长 = 2 × (L + W)。
#include <bits/stdc++.h>
using namespace std;

int main() {
    long long L, W;
    cin >> L >> W;

    cout << "Area: " << L * W << "\n";
    cout << "Perimeter: " << 2 * (L + W) << "\n";

    return 0;
}
关键点:
- 运算顺序:
2 * (L + W)——括号确保先加 L+W,再乘以 2 - 使用
long long以防 L、W 较大(若 L、W 最大 10^9,L*W 最大 10^18)
题目 2.1.9 — 温度转换
读取摄氏温度,打印对应的华氏温度。公式:F = C × 9/5 + 32
样例输入: 100
样例输出: 212.00
思路: 套用公式。需要小数输出,用 double。陷阱:9/5 整数运算结果是 1,不是 1.8!
#include <bits/stdc++.h>
using namespace std;

int main() {
    double celsius;
    cin >> celsius;

    double fahrenheit = celsius * 9.0 / 5.0 + 32.0;

    cout << fixed << setprecision(2) << fahrenheit << "\n";

    return 0;
}
关键点:
- 用
9.0 / 5.0(或9.0/5)而不是9/5——后者是整数除法,结果是1而不是1.8! fixed << setprecision(2)强制输出恰好 2 位小数- 验证:100°C → 100 × 9.0/5.0 + 32 = 180 + 32 = 212 ✓
题目 2.1.10 — 硬币计数 读取四个整数:25 分硬币(quarters)、10 分硬币(dimes)、5 分硬币(nickels)和 1 分硬币(pennies)的数量,打印总面值(单位:分)。
样例输入:
3 2 1 4
(3 枚 25 分,2 枚 10 分,1 枚 5 分,4 枚 1 分)
样例输出: 104
思路: 每种硬币数量乘以面值,全部相加。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int quarters, dimes, nickels, pennies;
    cin >> quarters >> dimes >> nickels >> pennies;

    int total = quarters * 25 + dimes * 10 + nickels * 5 + pennies * 1;

    cout << total << "\n";

    return 0;
}
关键点:
- 每种硬币乘以面值:quarters=25,dimes=10,nickels=5,pennies=1
- 验证:3×25 + 2×10 + 1×5 + 4×1 = 75 + 20 + 5 + 4 = 104 ✓
- 若硬币数量很大,改用
long long
🏆 挑战题
这些题需要更多思考——特别是数据类型和解题方法。
挑战 2.1.11 — 溢出探测器
读取两个整数 A 和 B(各最大 10^9),用两种方式计算它们的乘积:int 类型和 long long 类型,各打印一次结果。观察溢出时的差异。
样例输入: 1000000000 3
样例输出:
int product: -1294967296
long long product: 3000000000
(int 结果因溢出而错误;long long 结果正确。)
思路: 以 long long 读入两个数,然后两种方式各算一次乘积——一次强转为 int,一次用 long long。直观展示溢出效果。
#include <bits/stdc++.h>
using namespace std;

int main() {
    long long a, b;
    cin >> a >> b;

    // 先转成 int 再乘,强制触发整数溢出
    int int_product = (int)a * (int)b;

    // long long 乘法——值最大 10^9 时不会溢出
    long long ll_product = a * b;

    cout << "int product: " << int_product << "\n";
    cout << "long long product: " << ll_product << "\n";

    return 0;
}
关键点:
(int)a * (int)b——两个操作数都转成int再乘,乘法在int范围内溢出a * b(a、b 是long long)——乘法在long long空间内进行,不溢出- 10^9 × 3 的实际结果是 3×10^9,但 int 最大约 2.147×10^9 < 3×10^9,溢出后得到
-1294967296 - 教训: 当任意一个值可能达到约 10^5 或更大时,乘法时始终用
long long
挑战 2.1.12 — USACO 风格大数相乘
给定两个整数 N 和 M(1 ≤ N, M ≤ 10^9),打印它们的乘积。(看似简单,但必须用 long long。)
样例输入: 1000000000 1000000000
样例输出: 1000000000000000000
思路: N 和 M 各自能放进 int,但 N × M = 10^18——超出 int 上限(约 2.1×10^9),勉强放进 long long(上限约 9.2×10^18)。必须用 long long。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    long long n, m;
    cin >> n >> m;

    cout << n * m << "\n";

    return 0;
}
关键点:
- 用
long long变量读取是关键——cin >> n可以处理最大 9.2×10^18 的值 - 若用
int变量:int n, m; cin >> n >> m; cout << n * m;——这会静默溢出,输出错误答案 - 做 USACO 题时,始终检查约束:若 N 最大 10^9,且可能要算 N × N,就需要
long long
挑战 2.1.13 — 象限问题 (USACO 2016 February Bronze) 读取两个非零整数 x 和 y,判断点 (x, y) 在坐标平面的哪个象限:
- 第一象限:x > 0 且 y > 0
- 第二象限:x < 0 且 y > 0
- 第三象限:x < 0 且 y < 0
- 第四象限:x > 0 且 y < 0
只打印象限数字:1、2、3 或 4。
样例输入 1: 3 5 → 输出: 1
样例输入 2: -1 2 → 输出: 2
样例输入 3: -4 -7 → 输出: 3
样例输入 4: 8 -3 → 输出: 4
思路: 判断 x 和 y 的正负。x 和 y 正负的每种组合恰好对应一个象限。使用 if/else-if 链(第 2.2 章会完整讲,但这里很直接)。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int x, y;
    cin >> x >> y;

    if (x > 0 && y > 0) {
        cout << 1 << "\n";
    } else if (x < 0 && y > 0) {
        cout << 2 << "\n";
    } else if (x < 0 && y < 0) {
        cout << 3 << "\n";
    } else {  // x > 0 && y < 0
        cout << 4 << "\n";
    }

    return 0;
}
关键点:
&&运算符表示「且」——两个条件都必须为真- 题目保证 x ≠ 0 且 y ≠ 0,无需处理这些边界情况
- 四种情况互斥(对任意输入恰好一种为真),else-if 链完美适用
- 可以用公式简化,但显式 if/else 更清晰,速度一样快
第 2.2 章:控制流
2.2.0 什么是「控制流」?
到目前为止,我们写的每个程序都是从上到下执行的——第 1 行、第 2 行、第 3 行,结束。就像从头到尾读一本书。
但真正的程序需要做决策并重复操作。这就是「控制流」的含义——控制执行的流(顺序)。
想象一本「选择你的冒险」书:
- 有时书上说「如果你想和龙战斗,翻到第 47 页;否则翻到第 52 页」
- 有时书上说「重复这一段,直到你逃出地牢」
C++ 通过以下方式提供了恰好对应的功能:
if/else—— 根据条件做决策for/while循环 —— 重复执行一段代码
这是控制流的总览:

在循环图示中:程序不断回到「步骤 2」,直到条件变为假,才退出到「步骤 3」。
2.2.1 if 语句
if 语句让你的程序做决策:「如果这个条件为真,就执行这件事。」
基本 if
#include <bits/stdc++.h>
using namespace std;

int main() {
    int score;
    cin >> score;

    if (score >= 90) {
        cout << "优秀!\n";
    }

    cout << "完成。\n";  // 无论 score 是多少都会执行
    return 0;
}
score 为 95:打印「优秀!」然后「完成。」 score 为 80:只打印「完成。」(if 块被跳过)
if / else
int score;
cin >> score;

if (score >= 60) {
    cout << "通过\n";
} else {
    cout << "不通过\n";
}
else 块仅在 if 条件为假时执行。两个块中恰好只有一个会运行。
if / else if / else 链
需要检查多个条件时:
int score;
cin >> score;

if (score >= 90) {
    cout << "A\n";
} else if (score >= 80) {
    cout << "B\n";
} else if (score >= 70) {
    cout << "C\n";
} else if (score >= 60) {
    cout << "D\n";
} else {
    cout << "F\n";
}
C++ 从上到下按顺序检查这些条件,运行第一个为真的分支。一旦运行了一个块,就会跳过后面所有的 else if/else 块。
若 score = 85:
- 85 >= 90?否 → 跳过
- 85 >= 80?是 → 打印「B」,然后跳过后续所有 else-if
🤔 为什么这样有效? 当我们到达
else if (score >= 80)时,我们已经知道 score < 90(如果它 ≥ 90,第一个条件早就捕获了)。每个else if隐式假设所有前面的条件都为假。
比较运算符
| 运算符 | 含义 | 示例 |
|---|---|---|
== | 等于 | a == b |
!= | 不等于 | a != b |
< | 小于 | a < b |
> | 大于 | a > b |
<= | 小于等于 | a <= b |
>= | 大于等于 | a >= b |
逻辑运算符(组合条件)
| 运算符 | 含义 | 示例 |
|---|---|---|
&& | 且——两者都必须为真 | x > 0 && y > 0 |
|| | 或——至少一个为真 | x == 0 || y == 0 |
! | 非——将真翻转为假 | !finished |
int x, y;
cin >> x >> y;

if (x > 0 && y > 0) {
    cout << "两者都为正数\n";
}

if (x < 0 || y < 0) {
    cout << "至少有一个是负数\n";
}

bool done = false;
if (!done) {
    cout << "还在进行中……\n";
}
🐛 常见 Bug:= vs ==
这是新手(甚至有经验的程序员)最常犯的错误之一:
int x = 5;

// 危险的 BUG:
if (x = 10) {   // 这是把 10 赋值给 x,不是比较!
                 // x 变为 10,由于 10 不为零,这个条件永远为真
    cout << "x 是 10\n";  // 总是执行,即使 x 最初是 5!
}

// 正确写法:
if (x == 10) {  // 这才是比较 x 和 10
    cout << "x 是 10\n";  // 只有 x 真的等于 10 时才执行
}
= 运算符是赋值(存储一个值);== 运算符是比较(检查两个值是否相等)。两者看起来相似,但功能完全不同。
⚡ 专业技巧: 有些程序员写
10 == x而不是x == 10——如果不小心写了=而不是==,就变成了10 = x,会是编译错误(不能对字面量赋值)。这叫「尤达条件式」。
嵌套 if 语句
可以在 if 语句里再放 if 语句:
int age, income;
cin >> age >> income;

if (age >= 18) {
    cout << "成年人\n";
    if (income > 50000) {
        cout << "高收入成年人\n";
    } else {
        cout << "普通收入成年人\n";
    }
} else {
    cout << "未成年人\n";
}
注意:每个 else 匹配最近的、还没有 else 的 if。
2.2.2 while 循环
while 循环在条件为真时一直重复执行一段代码。条件变为假后,执行继续到循环之后。
while (条件) {
    循环体(反复执行)
}
#include <bits/stdc++.h>
using namespace std;

int main() {
    int i = 1;             // 1. 循环前初始化
    while (i <= 5) {       // 2. 检查条件——若为假则跳过循环
        cout << i << "\n"; // 3. 执行循环体
        i++;               // 4. 更新——非常重要!忘了这步 → 死循环
    }
    // 循环后:i = 6,条件 6 <= 5 为假,循环退出
    return 0;
}
输出:
1
2
3
4
5
🐛 常见 Bug:死循环
如果忘了更新变量(上面的第 4 步),条件永远不会变为假,循环就会一直运行!
int i = 1;
while (i <= 5) {
    cout << i << "\n";
    // BUG:忘了 i++——这会永远打印「1」!
}
如果程序卡住了,按 Ctrl+C 强制停止。
什么时候用 while vs for
- 当事先不知道需要迭代多少次时,用
while - 当知道次数时,用
for(下一节介绍)
while 的经典使用场景:读取直到满足某个条件。
// 常见 USACO 模式:读取直到输入结束
int x;
while (cin >> x) {    // cin >> x 在输入耗尽时返回 false
    cout << x * 2 << "\n";
}
do-while 循环
do-while 循环至少执行一次循环体,然后再检查条件:
int n;
do {
    cin >> n;
} while (n <= 0);   // 一直重新读,直到用户输入正数
当你想在判断是否重复之前先执行某件事时,这很有用。竞赛编程中不常见,但值得了解。
2.2.3 for 循环
for 循环是竞赛编程中最常用的循环。它将初始化、条件检查和更新打包在一行:
for (初始化; 条件; 更新) {
    循环体
}
等价于:
初始化;
while (条件) {
    循环体
    更新;
}
图示:for 循环流程图

流程图展示了执行过程:初始化只运行一次,之后每次迭代前检查条件,条件为假时退出循环。
常见 for 循环模式
// 从 0 数到 9(竞赛编程标准模式)
for (int i = 0; i < 10; i++) {
    cout << i << " ";
}
// 打印:0 1 2 3 4 5 6 7 8 9

// 从 1 数到 n(包含)
int n = 5;
for (int i = 1; i <= n; i++) {
    cout << i << " ";
}
// 打印:1 2 3 4 5

// 倒数
for (int i = 10; i >= 1; i--) {
    cout << i << " ";
}
// 打印:10 9 8 7 6 5 4 3 2 1

// 以 2 为步长
for (int i = 0; i <= 10; i += 2) {
    cout << i << " ";
}
// 打印:0 2 4 6 8 10
🧠 循环追踪:精确理解执行过程
学习循环时,手动追踪它们。方法如下:
代码: for (int i = 0; i < 4; i++) cout << i * i << " ";

先在纸上追踪循环,再运行——这能建立直觉并帮你发现 bug。
最常见的 USACO 循环模式
读取 N 个数并逐一处理:
int n;
cin >> n;

for (int i = 0; i < n; i++) {
    int x;
    cin >> x;
    // 在这里处理 x
    cout << x * 2 << "\n";
}
⚡ 专业技巧: 竞赛编程中,
for (int i = 0; i < n; i++)以 0 为起点是标准写法。这与数组的索引方式(第 2.3 章)一致,让一切都整齐地对应。
2.2.4 嵌套循环
可以在循环里再放一个循环。内层循环对外层循环的每一次迭代都会完整执行一遍。

// 打印 4×4 乘法表
for (int i = 1; i <= 4; i++) {         // 外层:行
    for (int j = 1; j <= 4; j++) {     // 内层:列
        cout << i * j << "\t";          // \t = 制表符
    }
    cout << "\n";  // 每行结束后换行
}
输出:
1   2   3   4
2   4   6   8
3   6   9   12
4   8   12  16
⚠️ 嵌套循环的时间复杂度
💡 为什么需要关心循环次数? 竞赛中,你的程序通常需要在 1-2 秒内完成。现代计算机每秒可以执行约 10^8 到 10^9 次简单运算。因此,如果能估算出循环体总共执行多少次,就能判断是否会超时(TLE)。这是「时间复杂度分析」的核心思想——后续章节会深入学习。
单重 N 次循环执行 N 次操作;两层嵌套 N 次循环执行 N × N = N² 次操作。
| 循环层数 | 操作次数 | N 的安全上限 | 示例 |
|---|---|---|---|
| 1 层 | N | ~10^8 | 遍历数组求和 |
| 2 层(嵌套) | N² | ~10^4 | 比较所有对 |
| 3 层(嵌套) | N³ | ~450 | 枚举所有三元组 |
N = 1000 时两层嵌套是 10^6 次操作——没问题。但 N = 100,000 时是 10^10——太慢了!
🧠 快速经验法则: 看到 N 的范围后,反向利用上表判断最多能用几层嵌套循环。例如:N ≤ 10^5 → 只能用 O(N) 或 O(N log N) 算法;N ≤ 5000 → O(N²) 可以接受。这在 USACO 中极为实用!
2.2.5 switch 语句
当你需要检查一个变量的许多具体值时,switch 比一长串 if/else if 更简洁:
int day;
cin >> day;

switch (day) {
    case 1:
        cout << "星期一\n";
        break;   // 重要:break 退出 switch
    case 2:
        cout << "星期二\n";
        break;
    case 3:
        cout << "星期三\n";
        break;
    case 4:
        cout << "星期四\n";
        break;
    case 5:
        cout << "星期五\n";
        break;
    case 6:
    case 7:
        cout << "周末!\n";  // case 6 和 7 共用这段代码
        break;
    default:
        cout << "无效的日期\n";  // 没有 case 匹配时执行
}
什么时候用 switch vs if-else
用 switch 当…… | 用 if-else 当…… |
|---|---|
| 检查一个变量的具体整数/字符值 | 比较范围(x > 10、x < 5) |
| 需要检查 3 个以上具体值 | 只有 1-2 个条件 |
| 各情况互斥 | 复杂的布尔逻辑 |
🐛 常见 Bug:忘记
break—— 没有break,执行会「穿透」到下一个 case!
int x = 2;
switch (x) {
    case 1:
        cout << "one\n";
    case 2:
        cout << "two\n";   // 这会执行
    case 3:
        cout << "three\n"; // 这也会执行(穿透!因为 case 2 后没有 break)
}
// 输出:two\nthree\n(出乎意料!)
2.2.6 break 和 continue
break —— 立即退出循环
// 找 1 到 100 中第一个 7 的倍数
for (int i = 1; i <= 100; i++) {
    if (i % 7 == 0) {
        cout << "7 的第一个倍数:" << i << "\n";  // 打印 7
        break;  // 停止搜索——已找到
    }
}
continue —— 跳到下一次迭代
// 打印 1 到 10 中除了 3 的倍数之外的所有数
for (int i = 1; i <= 10; i++) {
    if (i % 3 == 0) {
        continue;  // 跳过本次迭代的剩余部分,直接到 i++
    }
    cout << i << " ";
}
// 输出:1 2 4 5 7 8 10
嵌套循环中的 break
break 只退出最内层的循环。要退出多层,用标志变量:
bool found = false;
int target = 25;

for (int i = 0; i < 10 && !found; i++) {    // 外层循环也检查 !found
    for (int j = 0; j < 10; j++) {
        if (i * j == target) {
            cout << i << " * " << j << " = " << target << "\n";
            found = true;
            break;   // 退出内层循环;外层循环因为 !found 也会退出
        }
    }
}
2.2.7 竞赛编程中的经典循环模式
这些模式几乎出现在每一道 USACO 题解中。熟记它们。
模式一:读取 N 个数,计算总和
int n;
cin >> n;

long long sum = 0;
for (int i = 0; i < n; i++) {
    int x;
    cin >> x;
    sum += x;
}
cout << sum << "\n";
复杂度分析:
- 时间:O(N)——遍历 N 个数,每次 O(1) 处理
- 空间:O(1)——只有一个累加变量
sum
模式二:找最大值(和最小值)
int n;
cin >> n;

int maxVal, minVal;
cin >> maxVal;    // 读第一个元素
minVal = maxVal;  // 最大值和最小值都初始化为第一个元素

for (int i = 1; i < n; i++) {   // 从第二个元素开始(下标 1)
    int x;
    cin >> x;
    if (x > maxVal) maxVal = x;
    if (x < minVal) minVal = x;
}

cout << "最大值:" << maxVal << "\n";
cout << "最小值:" << minVal << "\n";
复杂度分析:
- 时间:O(N)——遍历 N 个数,每次比较 O(1)
- 空间:O(1)——只有
maxVal和minVal两个变量
🤔 为什么初始化为第一个元素? 不要初始化为 0!万一所有数都是负数呢?初始化为第一个元素保证我们从输入中的真实值开始。
模式三:统计满足条件的数量
int n;
cin >> n;

int count = 0;
for (int i = 0; i < n; i++) {
    int x;
    cin >> x;
    if (x % 2 == 0) {   // 条件:偶数
        count++;
    }
}
cout << "偶数个数:" << count << "\n";
模式四:打印星号三角形
int n;
cin >> n;

for (int row = 1; row <= n; row++) {     // row 从 1 到 n
    for (int col = 1; col <= row; col++) { // 每行打印 row 个星号
        cout << "*";
    }
    cout << "\n";  // 每行结束后换行
}
n=4 时输出:
*
**
***
****
模式五:计算各位数字之和
int n;
cin >> n;

int digitSum = 0;
while (n > 0) {
    digitSum += n % 10;  // 最后一位数字
    n /= 10;             // 删除最后一位
}
cout << digitSum << "\n";
追踪 n = 12345:
n=12345: digitSum += 5, n 变为 1234
n=1234:  digitSum += 4, n 变为 123
n=123:   digitSum += 3, n 变为 12
n=12:    digitSum += 2, n 变为 1
n=1:     digitSum += 1, n 变为 0
n=0: 循环退出。digitSum = 15 ✓
2.2.8 完整示例:USACO 风格题目
题目: 你有 N 头奶牛,每头都有一个产奶评分。找出评分最高的奶牛的评分,并统计产奶量高于平均水平的奶牛数量。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ 产奶评分 ≤ 10⁶。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    // 我们需要存储所有值来与平均值比较
    //(第 2.3 章学数组/向量——这里先用 vector 预览)

    // 第一遍:找总和和最大值
    long long sum = 0;
    int maxMilk = 0;
    vector<int> milk(n);   // 存储所有值(第 2.3 章预览)

    for (int i = 0; i < n; i++) {
        cin >> milk[i];
        sum += milk[i];
        if (milk[i] > maxMilk) maxMilk = milk[i];
    }

    double avg = (double)sum / n;

    // 第二遍:统计高于平均值的数量
    int aboveAvg = 0;
    for (int i = 0; i < n; i++) {
        if (milk[i] > avg) aboveAvg++;
    }

    cout << "最大值:" << maxMilk << "\n";
    cout << "高于平均值:" << aboveAvg << "\n";

    return 0;
}
样例输入:
5
10 20 30 40 50
样例输出:
最大值:50
高于平均值:2
(平均值为 30;产奶量 40 和 50 的奶牛高于平均值 → 2 头)
复杂度分析:
- 时间:O(N)——两遍(读取 + 统计),各 O(N),总计 O(2N) = O(N)
- 空间:O(N)——使用
vector<int> milk(n)存储所有数据
⚠️ 第 2.2 章常见错误
| # | 错误 | 示例 | 错在哪里 | 修复方法 |
|---|---|---|---|---|
| 1 | 混淆 = 和 == | if (x = 10) | = 是赋值而非比较;结果永远为真 | 用 == 比较 |
| 2 | 忘记 i++ 导致死循环 | while (i < n) { ... } 没有 i++ | 条件永远为真,程序卡死 | 确保循环变量被更新 |
| 3 | switch 中忘记 break | case 2: cout << "two"; 没有 break | 执行「穿透」到下一个 case | 每个 case 末尾加 break; |
| 4 | 差一错误 | for (int i = 0; i <= n; i++) 本应是 < n | 多循环一次,可能越界或多计 | 仔细核对 < 和 <= |
| 5 | 最大值初始化为 0 | int maxVal = 0; 但所有数都是负数 | 0 比所有输入都大,结果错误 | 初始化为第一个元素或 INT_MIN |
| 6 | 嵌套循环用了相同的变量名 | 外层 for (int i...) 和内层 for (int i...) | 内层 i 遮蔽外层 i,导致外层循环行为异常 | 内外层循环用不同变量名(如 i 和 j) |
本章总结
📌 核心要点
| 概念 | 语法 | 使用场景 | 为什么重要 |
|---|---|---|---|
if | if (条件) { ... } | 条件为真时执行 | 程序决策的基础;几乎每道题都用 |
if/else | if (...) {...} else {...} | 二选一 | 处理是/否类型的决策 |
if/else if/else | 链式 | 多选一 | 评级系统、分类场景 |
while | while (条件) {...} | 次数未知时重复 | 读取到输入结束、模拟过程 |
for | for (int i=0; i<n; i++) {...} | 次数已知时重复 | 竞赛编程中最常用的循环 |
| 嵌套循环 | 循环套循环 | 需要遍历所有对 | 注意 O(N²) 复杂度限制 |
break | break; | 找到目标后立即退出 | 提前终止节省时间 |
continue | continue; | 跳过当前迭代 | 过滤掉不需要处理的元素 |
switch | switch(x) { case 1: ... } | 检查一个变量的多个精确值 | 比长 if-else 链更简洁 |
&& / || / ! | 逻辑运算符 | 组合多个条件 | 复杂决策的基础构件 |
🧩 五种经典循环模式快速参考
| 模式 | 用途 | 复杂度 | 章节 |
|---|---|---|---|
| 读取 N 个数求和 | 读取 N 个数计算总和 | O(N) | 2.2.7 模式一 |
| 找最大/最小值 | 找最大/最小值 | O(N) | 2.2.7 模式二 |
| 统计满足条件的数量 | 统计满足条件的元素个数 | O(N) | 2.2.7 模式三 |
| 星号三角形 | 用嵌套循环打印图案 | O(N²) | 2.2.7 模式四 |
| 各位数字之和 | 提取各位数字并求和 | O(log₁₀N) | 2.2.7 模式五 |
❓ 常见问题
Q1:for 和 while 可以互换吗?什么时候该用哪个?
A:是的,任何
for循环都可以改写成while,反之亦然。经验法则:知道迭代次数(如「循环 N 次」)用for;不知道次数(如「读到输入结束」)用while。竞赛中大约 90% 的情况用for。
Q2:嵌套循环可以套多少层?有上限吗?
A:语法上没有上限,但实际中超过 3 层就需要谨慎。两层嵌套是 O(N²),三层是 O(N³)。当 N ≥ 1000 时,三层嵌套很容易超时。如果发现需要超过 3 层嵌套,通常意味着需要更高效的算法(后续章节会讲)。
Q3:break 只退出最内层循环,怎么一次退出多层?
A:两种常用方法:① 用
bool found = false标志变量,让外层循环也检查!found;② 将嵌套循环放在函数里,用return直接退出。方法①更常见——参见 2.2.6 节的完整示例。
Q4:switch 和 if-else if 哪个更快?
A:case 数量少(< 10)时,性能几乎一样。
switch的优势在于代码可读性,不是速度。竞赛中两种都可以自由选择。如果条件涉及范围比较(如x > 10),必须用if-else。
Q5:程序本地输出正确,提交后却超时(TLE),怎么办?
A:第一步:估算算法复杂度。查看 N 的范围 → 用本章的「嵌套循环复杂度表」估算总操作次数 → 若超过 10^8,就需要优化。常见优化策略:减少循环层数、用排序+二分查找替代暴力搜索(第 3.3 章)、用前缀和替代重复求和(第 3.2 章)。
🔗 与后续章节的联系
- 第 2.3 章(函数与数组)让你把本章的循环模式封装成函数,并用数组存储数据集合
- 第 3.2 章(数组与前缀和)教你把 O(N²) 区间求和查询优化到 O(N) 预处理 + O(1) 每次查询——这是「嵌套循环太慢」问题的解决方案之一
- 第 3.3 章(排序与搜索)教你二分查找,把本章 O(N) 线性搜索优化到 O(log N)
- 本章学到的五种经典循环模式(求和、找最大/最小、计数、嵌套遍历、数字处理)是本书所有算法的基础构件
- 嵌套循环复杂度分析是理解时间复杂度(贯穿全书的主题)的第一步
练习题
热身 2.2.1 — 数到十
打印 1 到 10,每行一个数字。用 for 循环。
思路: 从 1 到 10(包含)的 for 循环。
#include <bits/stdc++.h>
using namespace std;

int main() {
    for (int i = 1; i <= 10; i++) {
        cout << i << "\n";
    }
    return 0;
}
关键点:
i <= 10(而不是i < 10)因为我们要包含 10- 也可以写
for (int i = 1; i < 11; i++)——效果相同
热身 2.2.2 — 偶数 打印 2 到 20 的所有偶数,每行一个。
思路: 两种方案——步长为 2 循环,或每次循环检查是否为偶数。
#include <bits/stdc++.h>
using namespace std;

int main() {
    // 方案一:步长为 2
    for (int i = 2; i <= 20; i += 2) {
        cout << i << "\n";
    }
    return 0;
}
关键点:
i += 2每次递增 2 而不是通常的 1- 替代方案:
for (int i = 1; i <= 20; i++) { if (i % 2 == 0) cout << i << "\n"; }
热身 2.2.3 — 正负零
读取一个整数,正数打印 Positive,负数打印 Negative,零打印 Zero。
样例输入: -5 → 输出: Negative
思路: 用三路 if/else if/else 覆盖所有情况。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;

    if (n > 0) {
        cout << "Positive\n";
    } else if (n < 0) {
        cout << "Negative\n";
    } else {
        cout << "Zero\n";
    }

    return 0;
}
关键点:
- 末尾的
else精确捕获n == 0(因为上面两个条件覆盖了 n>0 和 n<0)
热身 2.2.4 — 3 的乘法表 打印 3 的前 10 个倍数(即 3、6、9、……、30),每行一个。
思路: 从 1 循环到 10,每次打印 i*3。
#include <bits/stdc++.h>
using namespace std;

int main() {
    for (int i = 1; i <= 10; i++) {
        cout << i * 3 << "\n";
    }
    return 0;
}
关键点:
- 替代方案:
for (int i = 3; i <= 30; i += 3)——效果相同
热身 2.2.5 — 五数之和 读取恰好 5 个整数(可以在同一行或不同行),打印它们的和。
样例输入: 3 7 2 8 5 → 输出: 25
思路: 循环读取 5 次,累加求和。
#include <bits/stdc++.h>
using namespace std;

int main() {
    long long sum = 0;
    for (int i = 0; i < 5; i++) {
        int x;
        cin >> x;
        sum += x;
    }
    cout << sum << "\n";
    return 0;
}
关键点:
sum用long long以防整数较大- 因为题目说「恰好 5 个整数」,循环读取恰好 5 次
题目 2.2.6 — FizzBuzz 经典编程挑战:打印 1 到 100 的数字,但:
- 如果能被 3 整除,打印
Fizz - 如果能被 5 整除,打印
Buzz - 如果能同时被 3 和 5 整除,打印
FizzBuzz
输出开头几行:
📄 Code 完整代码
1
2
Fizz
4
Buzz
Fizz
7
8
Fizz
Buzz
11
Fizz
13
14
FizzBuzz
思路: 循环 1 到 100。对每个数检查整除性——先检查同时整除的情况(被 3 和 5 整除),否则会被单独的 Fizz 或 Buzz 分支先捕获。
#include <bits/stdc++.h>
using namespace std;

int main() {
    for (int i = 1; i <= 100; i++) {
        if (i % 3 == 0 && i % 5 == 0) {
            cout << "FizzBuzz\n";
        } else if (i % 3 == 0) {
            cout << "Fizz\n";
        } else if (i % 5 == 0) {
            cout << "Buzz\n";
        } else {
            cout << i << "\n";
        }
    }
    return 0;
}
关键点:
- 先检查
i % 3 == 0 && i % 5 == 0——如果先检查i % 3 == 0,15 就会打印「Fizz」而永远到不了 FizzBuzz 分支 - 同时被 3 和 5 整除的数就是被 15 整除:
i % 15 == 0也有效
题目 2.2.7 — N 中最小值 读取 N(1 ≤ N ≤ 1000),然后读取 N 个整数,打印最小值。
样例输入:
5
8 3 7 1 9
样例输出: 1
思路: 用读取的第一个值初始化最小值,每次看到更小的就更新。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    int first;
    cin >> first;
    int minVal = first;  // 初始化为第一个元素

    for (int i = 1; i < n; i++) {   // 读取剩余 n-1 个元素
        int x;
        cin >> x;
        if (x < minVal) {
            minVal = x;
        }
    }

    cout << minVal << "\n";
    return 0;
}
关键点:
- 将
minVal初始化为读取的第一个元素(不是 0 或 INT_MAX),然后在循环中处理剩余元素 - 替代方案:用
INT_MAX作为初始值——保证大于任何 int,第一个元素一定会更新它
题目 2.2.8 — 统计正数 读取 N(1 ≤ N ≤ 1000),然后读取 N 个整数,打印其中严格正数(> 0)的个数。
样例输入:
6
3 -1 0 5 -2 7
样例输出: 3
思路: 维护一个计数器,满足条件(x > 0)时递增。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    int count = 0;
    for (int i = 0; i < n; i++) {
        int x;
        cin >> x;
        if (x > 0) {
            count++;
        }
    }

    cout << count << "\n";
    return 0;
}
关键点:
count从 0 开始,只在x > 0时递增- 0 不是正数(也不是负数——它是零),所以
x > 0正确地排除了它
题目 2.2.9 — 星号三角形 读取 N,打印一个 N 行的直角三角形,第 i 行有 i 个星号。
样例输入: 4
样例输出:
*
**
***
****
思路: 嵌套循环——外层遍历行,内层打印对应数量的星号。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;

    for (int row = 1; row <= n; row++) {
        for (int star = 1; star <= row; star++) {
            cout << "*";
        }
        cout << "\n";
    }

    return 0;
}
关键点:
- 第 1 行 1 个星号,第 2 行 2 个,……,第 N 行 N 个
- 内层循环对每个
row值恰好执行row次 - 使用
string的替代方案:cout << string(row, '*') << "\n";——创建row个*的字符串
题目 2.2.10 — 各位数字之和 读取正整数 N(1 ≤ N ≤ 10^9),打印其各位数字之和。
样例输入: 12345 → 样例输出: 15
样例输入: 9999 → 样例输出: 36
思路: 用取模技巧。N % 10 得到最后一位。N / 10 删除最后一位。重复直到 N 变为 0。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;

    int digitSum = 0;
    while (n > 0) {
        digitSum += n % 10;  // 加上最后一位
        n /= 10;             // 删除最后一位
    }

    cout << digitSum << "\n";
    return 0;
}
关键点:
n % 10提取个位数(如 12345 % 10 = 5)n /= 10是整数除法,删除最后一位(如 12345 / 10 = 1234)- 循环持续到 n = 0(所有数字都已提取)
- 追踪:12345 → +5 → 1234 → +4 → 123 → +3 → 12 → +2 → 1 → +1 → 0。总和 = 15 ✓
🏆 挑战题
挑战 2.2.11 — 考拉兹序列 从 N 开始的考拉兹序列规则如下:
- N 是偶数:下一项 = N / 2
- N 是奇数:下一项 = N × 3 + 1
- N = 1 时停止
读取 N,打印整个序列(包括 N 和 1),以及到达 1 需要的步数。
样例输入: 6
样例输出:
6 3 10 5 16 8 4 2 1
Steps: 8
思路: 用 while 循环,不断应用规则直到到达 1,同时计数步数。
#include <bits/stdc++.h>
using namespace std;

int main() {
    long long n;
    cin >> n;

    int steps = 0;
    cout << n;         // 打印起始数字

    while (n != 1) {
        if (n % 2 == 0) {
            n = n / 2;
        } else {
            n = n * 3 + 1;
        }
        cout << " " << n;  // 打印下一个数字
        steps++;
    }
    cout << "\n";
    cout << "Steps: " << steps << "\n";

    return 0;
}
关键点:
- 用
long long——即使从小数开始,序列中间值也可能很大(如 N=27 会到达 9232!) - 考拉兹猜想称这个序列总会到达 1,但对所有 N 尚未被证明
- 循环前打印 N(作为起始值),之后每步打印新值
挑战 2.2.12 — 质数判断
读取 N(2 ≤ N ≤ 10^6),若 N 是质数打印 prime,否则打印 composite。
质数是只有 1 和它本身两个因数的数。
样例输入: 17 → 输出: prime
样例输入: 100 → 输出: composite
思路: 试除法——检查 2 到 √N 中有没有能整除 N 的数。如果没有,N 是质数。只需检查到 √N,因为若 N = a×b 且 a > √N,则 b < √N(早就找到了)。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;

    bool isPrime = true;

    if (n < 2) {
        isPrime = false;
    } else {
        // 检查 2 到 sqrt(n) 的因数
        for (int i = 2; (long long)i * i <= n; i++) {
            if (n % i == 0) {
                isPrime = false;
                break;  // 找到因数,无需继续
            }
        }
    }

    cout << (isPrime ? "prime" : "composite") << "\n";
    return 0;
}
关键点:
- 用
i * i <= n而不是i <= sqrt(n),避免浮点精度问题(也稍快) (long long)i * i防止 i 较大时溢出(如 i = 1000000,i*i = 10^12)break找到任意因数后立即退出——无需继续检查- 时间复杂度:O(√N),处理 N 最大 10^6 非常轻松(√10^6 = 1000 次迭代)
挑战 2.2.13 — 评分最高的奶牛 读取 N(1 ≤ N ≤ 1000),然后读取 N 对(奶牛名字,评分)。找出评分最高的奶牛并打印其名字。
样例输入:
4
Bessie 95
Elsie 82
Moo 95
Daisy 88
样例输出: Bessie
(若有并列,打印最先出现的那头。)
思路: 跟踪目前见过的最佳评分和名字,只在严格更高时更新。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    string bestName;
    int bestRating = -1;  // 初始化为 -1,任何真实评分都高于它

    for (int i = 0; i < n; i++) {
        string name;
        int rating;
        cin >> name >> rating;

        if (rating > bestRating) {
            bestRating = rating;
            bestName = name;
        }
    }

    cout << bestName << "\n";
    return 0;
}
关键点:
- 初始化
bestRating = -1(或INT_MIN),让第一头奶牛始终成为新的最佳 - 用
>(严格大于)而非>=,这样并列时保留最先出现的(题目要求) cin >> name >> rating从同一行读取字符串和整数——完全有效
第 2.3 章:函数与数组
随着程序越来越大,你需要组织代码的方式(函数)和存储数据集合的方式(数组和向量)。本章介绍这两者——竞赛编程中最重要的两个工具。
2.3.1 函数——是什么,为什么需要
🍕 食谱类比
函数就像一份披萨食谱:

- 输入(参数):   食材——面粉、奶酪、番茄
- 过程(函数体):烹饪步骤
- 输出(返回值):做好的披萨

就像你可以用一份食谱做很多张披萨,
你可以用不同的输入多次调用一个函数。

pizza("薄底", "培根")  → 一张披萨
pizza("厚底", "蘑菇")  → 另一张披萨
没有函数,如果你需要在程序的五个地方计算「这个数是不是质数」,你就得把同样的 10 行代码复制粘贴五次。然后如果发现了 bug,就要在五个地方全部修复!
什么时候写函数
以下情况使用函数:
- 程序中某段逻辑重复了 3 次以上
- 某段代码做的是一件清晰命名的事(如「检查是否质数」「计算距离」)
- 你的
main变得太长、不好读
函数的基本语法
返回类型 函数名(参数1类型 参数1, 参数2类型 参数2, ...) {
    // 函数体
    return 值;  // 必须与返回类型匹配;void 函数可省略
}
你的第一批函数
#include <bits/stdc++.h>
using namespace std;

// ---- 函数定义(必须在使用前定义,或使用前置声明)----

// 接收一个整数,返回它的平方
int square(int x) {
    return x * x;
}

// 接收两个整数,返回较大的那个
int maxOf(int a, int b) {
    if (a > b) return a;
    else return b;
}

// void 函数:执行某件事但不返回值
void printSeparator() {
    cout << "====================\n";
}

// ---- 主函数 ----
int main() {
    cout << square(5) << "\n";       // 以 x=5 调用 square,打印 25
    cout << square(12) << "\n";      // 以 x=12 调用 square,打印 144

    cout << maxOf(7, 3) << "\n";     // 打印 7
    cout << maxOf(-5, -2) << "\n";   // 打印 -2

    printSeparator();                // 打印分隔线
    cout << "完成!\n";
    printSeparator();

    return 0;
}
🤔 为什么函数要在 main 之前?
C++ 从上到下读取你的文件。当它看到 square(5) 这样的调用时,需要已经知道 square 是什么。如果 square 在 main 之后定义,编译器会说「我从没听说过 square!」
方案一: 把所有函数定义在 main 之上(最简单)。
方案二: 使用函数原型——前置声明,告诉编译器「这个函数存在,我之后再定义」:
#include <bits/stdc++.h>
using namespace std;

int square(int x);       // 原型——只有签名,没有函数体
int maxOf(int a, int b); // 原型

int main() {
    cout << square(5) << "\n";   // OK!编译器知道 square 存在
    return 0;
}

// 完整定义可以在 main 之后
int square(int x) {
    return x * x;
}

int maxOf(int a, int b) {
    return (a > b) ? a : b;
}
2.3.2 void 函数 vs 返回值函数
void 函数:执行操作,不返回值
// void 函数执行某个动作
void printLine(int n) {
    for (int i = 0; i < n; i++) {
        cout << "-";
    }
    cout << "\n";
}

// 调用 void 函数——直接调用,不要尝试接收返回值
printLine(10);    // 打印:----------
printLine(20);    // 打印:--------------------
返回值函数:计算并返回一个值
// 返回 x 的绝对值
int absoluteValue(int x) {
    if (x < 0) return -x;
    return x;
}

// 调用返回值函数——把结果存入变量或直接使用
int result = absoluteValue(-7);
cout << result << "\n";           // 7
cout << absoluteValue(-3) << "\n"; // 3(直接使用)
多个 return 语句
函数可以有多个 return 语句——执行到第一个就停止:
string classify(int n) {
    if (n < 0) return "负数";   // n < 0 时从这里退出
    if (n == 0) return "零";    // n == 0 时从这里退出
    return "正数";              // 其他情况从这里退出
}

cout << classify(-5) << "\n";   // 负数
cout << classify(0) << "\n";    // 零
cout << classify(3) << "\n";    // 正数
2.3.3 按值传递 vs 按引用传递
向函数传递变量时有两种方式。理解这一点至关重要。
按值传递(默认):函数得到一个副本
void addOne_byValue(int x) {
    x++;  // 修改的是局部副本——原变量不变
    cout << "函数内部:" << x << "\n";  // 6
}

int main() {
    int n = 5;
    addOne_byValue(n);
    cout << "函数之后:" << n << "\n";   // 还是 5!原变量未改变
    return 0;
}
可以把它想成复印件:函数对复印件进行操作,对复印件的修改不影响原件。
按引用传递(&):函数操作原变量
void addOne_byRef(int& x) {  // & 表示「原变量的引用」
    x++;  // 直接修改原变量
    cout << "函数内部:" << x << "\n";  // 6
}

int main() {
    int n = 5;
    addOne_byRef(n);
    cout << "函数之后:" << n << "\n";   // 现在是 6!原变量被改变了
    return 0;
}
什么时候用哪种
| 用按值传递,当…… | 用按引用传递,当…… |
|---|---|
| 函数不应修改原变量 | 函数需要修改原变量 |
| 小类型(int、double、char) | 需要返回多个值 |
| 你想要安全性(无副作用) | 大型对象(避免昂贵的复制) |
通过引用返回多个值
C++ 函数只能 return 一个值。但可以通过引用参数「返回」多个值:
// 同时计算商和余数
void divmod(int a, int b, int& quotient, int& remainder) {
    quotient = a / b;
    remainder = a % b;
}

int main() {
    int q, r;
    divmod(17, 5, q, r);  // q 和 r 被函数修改
    cout << "17 / 5 = " << q << " 余 " << r << "\n";
    // 打印:17 / 5 = 3 余 2
    return 0;
}
2.3.4 递归
递归函数是调用自身的函数。它非常适合可以拆解成同类问题的更小版本的问题。
经典示例:阶乘
5! = 5 × 4 × 3 × 2 × 1 = 120
   = 5 × (4!)              ← 同样的问题,更小的输入!
💡 递归思维三步法:
- 找「自相似性」: 原问题能否拆解为同类型的更小问题?5! = 5 × 4!,4! 和 5! 是同一类型 ✓
- 确定边界条件: 最小的情况是什么?0! = 1,不能再拆解
- 写递推步骤: n! = n × (n-1)!,用更小的输入调用自身
这个思维过程在**图论算法(第 5.1 章)和动态规划(第 6.1-6.3 章)**中会反复用到。
int factorial(int n) {
    if (n == 0) return 1;            // 边界条件:停止递归
    return n * factorial(n - 1);    // 递推步骤:缩小到更小的问题
}
追踪 factorial(4):
factorial(4)
= 4 * factorial(3)
= 4 * (3 * factorial(2))
= 4 * (3 * (2 * factorial(1)))
= 4 * (3 * (2 * (1 * factorial(0))))
= 4 * (3 * (2 * (1 * 1)))   ← 边界条件!
= 4 * (3 * (2 * 1))
= 4 * (3 * 2)
= 4 * 6
= 24  ✓
每个递归函数都需要:
- 边界条件 —— 停止递归(防止无限递归)
- 递推步骤 —— 用更小的输入调用自身
🐛 常见 Bug: 忘记边界条件 → 无限递归 → 「栈溢出」崩溃!
📌 名词预告: 递归是后面一大类算法的地基——5.2 章的 DFS(走迷宫/探房间)、回溯(「选择 → 递归 → 撤销」,枚举所有排列与组合)和第 6 部分的动态规划,全是「函数调用自己处理更小的问题」。现在只需要把阶乘这种一层的递归想明白。
2.3.5 数组——固定大小的集合
🏠 邮箱类比
数组就像街道上一排邮箱:
- 所有邮箱大小相同(相同类型)
- 每个都有门号(下标,从 0 开始)
- 可以通过门号直接找到任意邮箱

图示:数组内存布局

数组在内存中是连续存储的,每个元素紧挨着前一个,因此支持 O(1) 随机访问。
数组基础
#include <bits/stdc++.h>
using namespace std;

int main() {
    // 声明一个有 5 个整数的数组(元素未初始化——是垃圾值!)
    int arr[5];

    // 逐一赋值
    arr[0] = 10;
    arr[1] = 20;
    arr[2] = 30;
    arr[3] = 40;
    arr[4] = 50;

    // 同时声明和初始化
    int nums[5] = {1, 2, 3, 4, 5};

    // 全部初始化为零
    int zeros[100] = {};          // 所有 100 个元素 = 0
    int zeros2[100];
    fill(zeros2, zeros2 + 100, 0); // 另一种方式

    // 访问和打印
    cout << arr[2] << "\n";       // 30

    // 遍历数组
    for (int i = 0; i < 5; i++) {
        cout << nums[i] << " ";   // 1 2 3 4 5
    }
    cout << "\n";

    return 0;
}
🐛 差一错误——头号数组 Bug
数组是从 0 开始索引的:如果你声明 int arr[5],合法下标是 0, 1, 2, 3, 4,不存在 arr[5]!
int arr[5] = {10, 20, 30, 40, 50};

// 错误:循环从 i=0 到 i=5 包含——下标 5 不存在!
for (int i = 0; i <= 5; i++) {   // BUG:<= 5 应改为 < 5
    cout << arr[i];               // i=5 时崩溃或打印垃圾值
}

// 正确:循环从 i=0 到 i=4(i < 5 确保 i 永远到不了 5)
for (int i = 0; i < 5; i++) {    // i 的值:0, 1, 2, 3, 4 ✓
    cout << arr[i];               // 始终有效
}
这就是「差一错误」——越过末尾一个元素。这是竞赛编程中最常见的数组 bug。
🤔 为什么从 0 开始? C++ 从 C 继承了这个设计,而 C 的设计贴近硬件。下标实际上是从数组起点的偏移量。第一个元素在偏移量 0 处(从起点无偏移)。
大数组用全局变量
main 里的局部变量存在「栈」上,空间有限(约 1-8 MB)。竞赛编程中 N 最大可达 10^6,需要用全局数组(存在不同的内存区域,空间大得多):
#include <bits/stdc++.h>
using namespace std;

const int MAXN = 1000001;  // 最大长度 + 1(常见惯例)
int arr[MAXN];              // 全局声明——大数组安全
// 全局数组会自动初始化为 0!

int main() {
    int n;
    cin >> n;
    for (int i = 0; i < n; i++) {
        cin >> arr[i];
    }
    return 0;
}
⚡ 专业技巧: 全局数组会自动初始化为 0。局部数组不会——它们在赋值前包含垃圾值!
2.3.6 常见数组算法
求和、最大值、最小值
int n;
cin >> n;

vector<int> arr(n);    // 马上学 vector;用法与数组相同
for (int i = 0; i < n; i++) cin >> arr[i];

// 求和
long long sum = 0;
for (int i = 0; i < n; i++) sum += arr[i];
cout << "总和:" << sum << "\n";

// 最大值(初始化为第一个元素!)
int maxVal = arr[0];
for (int i = 1; i < n; i++) {
    if (arr[i] > maxVal) maxVal = arr[i];
}
cout << "最大值:" << maxVal << "\n";

// 最小值(同理)
int minVal = arr[0];
for (int i = 1; i < n; i++) {
    minVal = min(minVal, arr[i]);  // min() 是内置函数
}
cout << "最小值:" << minVal << "\n";
复杂度分析:
- 时间:O(N)——每个算法只需一次遍历
- 空间:O(1)——只需几个额外变量(不计输入数组本身)
翻转数组
int arr[] = {1, 2, 3, 4, 5};
int n = 5;

// 从两端向中间交换元素
for (int i = 0, j = n - 1; i < j; i++, j--) {
    swap(arr[i], arr[j]);  // swap() 是内置函数
}
// arr 现在是 {5, 4, 3, 2, 1}
复杂度分析:
- 时间:O(N)——每对元素交换一次,共 N/2 次
- 空间:O(1)——原地交换,不需要额外数组
二维数组
二维数组就像一张表格或网格,非常适合地图、棋盘、矩阵:
int grid[3][4];  // 3 行 4 列

// 填入 i * 10 + j
for (int r = 0; r < 3; r++) {
    for (int c = 0; c < 4; c++) {
        grid[r][c] = r * 10 + c;
    }
}

// 打印
for (int r = 0; r < 3; r++) {
    for (int c = 0; c < 4; c++) {
        cout << grid[r][c] << "\t";
    }
    cout << "\n";
}
输出:
0   1   2   3
10  11  12  13
20  21  22  23
2.3.7 向量(vector)——动态数组
数组有一个大限制:大小必须在编译时确定(或事先声明得足够大)。向量解决了这个问题——在程序运行时可以按需增减大小。
数组 vs 向量对比
| 特性 | 数组 | 向量 |
|---|---|---|
| 大小 | 编译时固定 | 运行时可增减 |
| 读 N 个元素 | 必须硬编码或用 MAXN | push_back(x) 自然适用 |
| 内存位置 | 栈(快速,有限) | 堆(稍慢,无限制) |
| 语法 | int arr[5] | vector<int> v(5) |
| 竞赛编程首选 | 固定大小的简单情况 | 大多数问题 |
向量基础
#include <bits/stdc++.h>
using namespace std;

int main() {
    // 创建空向量
    vector<int> v;

    // 用 push_back 在末尾添加元素
    v.push_back(10);    // v = [10]
    v.push_back(20);    // v = [10, 20]
    v.push_back(30);    // v = [10, 20, 30]

    // 按下标访问(与数组相同,从 0 开始)
    cout << v[0] << "\n";     // 10
    cout << v[1] << "\n";     // 20

    // 常用函数
    cout << v.size() << "\n"; // 3(元素个数)
    cout << v.front() << "\n"; // 10(第一个元素)
    cout << v.back() << "\n";  // 30(最后一个元素)
    cout << v.empty() << "\n"; // 0(false——不为空)

    // 删除最后一个元素
    v.pop_back();   // v = [10, 20]

    // 清空所有元素
    v.clear();      // v = []
    cout << v.empty() << "\n"; // 1(true——现在为空)

    return 0;
}
创建带初始值的向量
vector<int> zeros(10, 0);       // 十个 0:[0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
vector<int> ones(5, 1);         // 五个 1:[1, 1, 1, 1, 1]
vector<int> primes = {2, 3, 5, 7, 11};  // 从列表初始化
vector<int> empty;              // 空向量
遍历向量
vector<int> v = {10, 20, 30, 40, 50};

// 方法一:下标循环(与数组相同)
for (int i = 0; i < (int)v.size(); i++) {
    cout << v[i] << " ";
}
cout << "\n";

// 方法二:范围 for 循环(更简洁,推荐)
for (int x : v) {
    cout << x << " ";
}
cout << "\n";

// 方法三:引用范围 for(需要修改时使用)
for (int& x : v) {
    x *= 2;  // 将每个元素就地翻倍
}
🤔 为什么下标循环用
(int)v.size()?v.size()返回的是无符号整数。把int i和无符号值比较,C++ 有时会产生意外行为(尤其是i为负时)。转成(int)是安全习惯。
USACO 中使用向量的标准模式
int n;
cin >> n;

vector<int> arr(n);         // 创建大小为 n 的向量
for (int i = 0; i < n; i++) {
    cin >> arr[i];          // 读入每个位置
}

// 现在处理 arr...
sort(arr.begin(), arr.end());  // 升序排序
二维向量
int rows = 3, cols = 4;
vector<vector<int>> grid(rows, vector<int>(cols, 0));  // 3×4 的全 0 网格

// 访问:grid[r][c]
grid[1][2] = 42;
cout << grid[1][2] << "\n";  // 42
2.3.8 向函数传递数组和向量
数组
向函数传递数组时,函数收到的是第一个元素的指针。函数内部的修改会影响原数组:
void fillSquares(int arr[], int n) {  // 数组参数的 arr[] 语法
    for (int i = 0; i < n; i++) {
        arr[i] = i * i;   // 修改的是原数组!
    }
}

int main() {
    int arr[5] = {0};
    fillSquares(arr, 5);
    // arr 现在是 {0, 1, 4, 9, 16}
    for (int i = 0; i < 5; i++) cout << arr[i] << " ";
    cout << "\n";
    return 0;
}
向量
向量传递给函数时默认是复制(大向量很慢!)。用 & 按引用传递:
// 按值传递——复制整个向量(大向量时很慢)
void printVec(vector<int> v) {
    for (int x : v) cout << x << " ";
}

// 按引用传递——不复制,可修改原向量(用于输出参数)
void sortVec(vector<int>& v) {
    sort(v.begin(), v.end());
}

// 按 const 引用传递——不复制,不可修改(只读时最佳)
void printVecFast(const vector<int>& v) {
    for (int x : v) cout << x << " ";
}
⚡ 专业技巧: 对于只读(不修改)的向量参数,始终写
const vector<int>&。这既避免了复制,也向读者表明函数不会修改向量。
⚠️ 第 2.3 章常见错误
| # | 错误 | 示例 | 错在哪里 | 修复方法 |
|---|---|---|---|---|
| 1 | 数组越界差一 | 数组大小为 n 时访问 arr[n] | 合法下标是 0 到 n-1,arr[n] 越界 | 用 i < n 而不是 i <= n |
| 2 | 忘记递归边界条件 | int f(int n) { return n*f(n-1); } | 永不停止,导致栈溢出崩溃 | 加上 if (n == 0) return 1; |
| 3 | 递归传入非法参数(如负数) | factorial(-1) | 边界条件只处理 n == 0;负值导致无限递归 → 栈溢出 | 调用前确保输入在合法范围;或在函数入口加防御:if (n < 0) return -1; |
| 4 | 向量按值传递性能问题 | void f(vector<int> v) | 复制整个向量,N 大时极慢 | 用 const vector<int>& v |
| 5 | 局部数组未初始化 | int arr[100]; sum += arr[50]; | 局部数组不会自动清零,包含垃圾值 | 用 = {} 初始化或使用全局数组 |
| 6 | main 内数组太大 | int main() { int arr[1000000]; } | 超过栈内存限制(通常 1-8 MB),程序崩溃 | 把大数组放在 main 外(全局) |
| 7 | 函数定义在调用之后 | main 调用 square(5) 但 square 定义在 main 下面 | 编译器无法识别未定义的函数 | 在 main 之前定义函数,或使用函数原型 |
本章总结
📌 核心要点
| 概念 | 要点 | 为什么重要 |
|---|---|---|
| 函数 | 定义一次,随处调用 | 减少重复代码,提高可读性 |
| 返回类型 | int、double、bool、void | 不同场景用不同返回类型 |
| 按值传递 | 函数得到副本,原变量不变 | 安全,无副作用 |
按引用传递(&) | 函数操作原变量 | 可修改原变量,避免复制大对象 |
| 递归 | 函数调用自身,必须有边界条件 | 分治、回溯、DP 的基础 |
| 数组 | 固定大小,从 0 开始,O(1) 随机访问 | 竞赛编程中最基本的数据结构 |
| 全局数组 | 避免栈溢出,自动初始化为 0 | N 超过 10^5 时必须用全局数组 |
vector<int> | 动态数组,可变大小 | 竞赛编程首选数据容器 |
push_back / pop_back | 在末尾增/删 | O(1) 操作,构建动态集合的主要方式 |
| 前缀和 | O(N) 预处理,O(1) 查询 | 区间求和的核心技巧,第 3.2 章深入讲解 |
❓ 常见问题
Q1:数组和向量哪个更好?
A:竞赛编程中两者都常用。经验法则:大小固定且已知时,全局数组最简单;大小动态变化或需要传给函数时,用
vector。很多选手默认用vector,因为它更灵活、更不容易出错。
Q2:递归深度有限制吗?会崩溃吗?
A:有。每次函数调用都在栈上分配空间,默认栈大小约 1-8 MB。实际上,约 10^4 到 10^5 层递归是安全的。超出后程序会以「栈溢出」崩溃。竞赛中如果递归深度可能超过 10^4,考虑改用迭代(循环)方式。
Q3:什么时候用按引用传递(&)?
A:两种情况:① 需要在函数内部修改原变量;② 参数是大对象(如
vector或string),想避免复制开销。对于int、double这样的小类型,复制开销可忽略不计,按值传递即可。
Q4:函数可以返回数组或向量吗?
A:数组不能直接返回,但
vector可以!vector<int> solve() { ... return result; }完全有效。现代 C++ 编译器会优化返回过程(称为 RVO),实际上不会复制整个向量。
Q5:为什么前缀和数组多一个索引?prefix[n+1] 而不是 prefix[n]?
A:
prefix[0] = 0是一个「哨兵值」,使得公式prefix[R+1] - prefix[L]在所有情况下都有效。没有这个哨兵,查询 [0, R] 时 L=0 需要特殊处理。这是一个非常常见的编程技巧:用额外的哨兵值简化边界处理。
🔗 与后续章节的联系
- 第 3.1 章(STL 核心用法)将介绍
sort、binary_search、pair等工具,让你用一行代码完成本章手动实现的操作 - 第 3.2 章(前缀和)将深入探讨题目 2.3.10 中引入的前缀和技术,包括二维前缀和和差分数组
- 第 5.1 章(图的基础)将以 2.3.4 节的递归基础为起点,讲解 DFS 和 BFS 等图遍历算法
- 第 6.1-6.3 章(动态规划):「把大问题拆解成小问题」的核心思想与递归密切相关;本章的递归思维是重要的基础
- 本章学到的函数封装和数组/向量操作将在后续每一章中持续使用
练习题
热身 2.3.1 — 平方函数
编写一个函数 int square(int x),返回 x²。在 main 中读取一个整数并打印其平方。
样例输入: 7 → 样例输出: 49
思路: 把函数写在 main 之上,用输入调用它。
#include <bits/stdc++.h>
using namespace std;

int square(int x) {
    return x * x;
}

int main() {
    int n;
    cin >> n;
    cout << square(n) << "\n";
    return 0;
}
关键点:
- 函数定义在
main之上,编译器才能识别 return x * x;——C++ 计算x * x并返回结果- 若 x 可能很大(如最大 10^9),用
long long(x² 最大 10^18)
热身 2.3.2 — 两数之大
编写函数 int myMax(int a, int b),返回两个整数中较大的。在 main 中读取两个整数并打印较大值。
样例输入: 13 7 → 样例输出: 13
思路: 比较 a 和 b,返回较大的那个。
#include <bits/stdc++.h>
using namespace std;

int myMax(int a, int b) {
    if (a > b) return a;
    return b;
}

int main() {
    int a, b;
    cin >> a >> b;
    cout << myMax(a, b) << "\n";
    return 0;
}
关键点:
- C++ 有内置的
max(a, b)函数——但自己写一遍有助于理解概念 - 三目运算符替代方案:
return (a > b) ? a : b;
热身 2.3.3 — 倒序数组
声明一个恰好有 5 个整数的数组:{1, 2, 3, 4, 5}。倒序打印(不需要输入)。
期望输出:
5 4 3 2 1
思路: 从下标 4 循环到 0(倒序)。
#include <bits/stdc++.h>
using namespace std;

int main() {
    int arr[5] = {1, 2, 3, 4, 5};

    for (int i = 4; i >= 0; i--) {
        cout << arr[i];
        if (i > 0) cout << " ";
    }
    cout << "\n";

    return 0;
}
关键点:
- 从下标
n-1 = 4循环到0(包含),使用i-- if (i > 0) cout << " "避免末尾多一个空格——不过对 USACO 来说末尾空格通常可以接受
热身 2.3.4 — 向量求和
创建一个向量,用 push_back 依次加入 10、20、30、40、50,然后打印它们的总和。
期望输出: 150
思路: 创建空向量,push 5 个值,循环求和。
#include <bits/stdc++.h>
using namespace std;

int main() {
    vector<int> v;
    v.push_back(10);
    v.push_back(20);
    v.push_back(30);
    v.push_back(40);
    v.push_back(50);

    long long sum = 0;
    for (int x : v) {
        sum += x;
    }

    cout << sum << "\n";
    return 0;
}
关键点:
- 范围 for
for (int x : v)遍历所有元素 - 一行替代方案:
accumulate(v.begin(), v.end(), 0LL)
热身 2.3.5 — Hello N 次
编写一个 void 函数 sayHello(int n),打印「Hello!」恰好 n 次。读取 n 后从 main 调用它。
样例输入: 3
样例输出:
Hello!
Hello!
Hello!
思路: 一个内含 for 循环的 void 函数。
#include <bits/stdc++.h>
using namespace std;

void sayHello(int n) {
    for (int i = 0; i < n; i++) {
        cout << "Hello!\n";
    }
}

int main() {
    int n;
    cin >> n;
    sayHello(n);
    return 0;
}
关键点:
void表示函数不返回任何值——不需要return 值;(可以用裸return;提前退出)sayHello参数中的n是main中n的独立副本(按值传递)
题目 2.3.6 — 倒序输出 读取 N(1 ≤ N ≤ 100),然后读取 N 个整数,倒序打印。
样例输入:
5
1 2 3 4 5
样例输出: 5 4 3 2 1
思路: 存入向量,然后从最后一个下标到第一个倒序打印。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<int> arr(n);
    for (int i = 0; i < n; i++) {
        cin >> arr[i];
    }

    for (int i = n - 1; i >= 0; i--) {
        cout << arr[i];
        if (i > 0) cout << " ";
    }
    cout << "\n";

    return 0;
}
关键点:
vector<int> arr(n)创建大小为 n 的向量(初始全为零)- 就像数组一样读入
arr[i] - 从
n-1循环到0(包含)打印
题目 2.3.7 — 动态平均值 读取 N(1 ≤ N ≤ 100),然后逐个读取 N 个整数。每读入一个整数后,打印当前已读所有整数的平均值(保留 2 位小数)。
样例输入:
4
10 20 30 40
样例输出:
10.00
15.00
20.00
25.00
思路: 维护累计和,每次新读入后除以已读个数。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    long long sum = 0;
    for (int i = 1; i <= n; i++) {
        int x;
        cin >> x;
        sum += x;
        double avg = (double)sum / i;
        cout << fixed << setprecision(2) << avg << "\n";
    }

    return 0;
}
关键点:
- 每次新元素读入后更新
sum;i是已读元素个数 (double)sum / i——先强转为 double 再除,得到小数结果fixed << setprecision(2)强制输出恰好 2 位小数
题目 2.3.8 — 频率统计 读取 N(1 ≤ N ≤ 100)个整数,每个整数在 1 到 10 之间。打印 1 到 10 中每个值出现的次数。
样例输入:
7
3 1 2 3 3 1 7
样例输出:
1 appears 2 times
2 appears 1 times
3 appears 3 times
4 appears 0 times
5 appears 0 times
6 appears 0 times
7 appears 1 times
8 appears 0 times
9 appears 0 times
10 appears 0 times
思路: 用数组(或向量)作为「计数器」——下标 1 到 10 存储对应值的计数。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    int freq[11] = {};  // 下标 0-10;我们用 1-10。全部初始化为 0。

    for (int i = 0; i < n; i++) {
        int x;
        cin >> x;
        freq[x]++;    // 值 x 的计数加一
    }

    for (int v = 1; v <= 10; v++) {
        cout << v << " appears " << freq[v] << " times\n";
    }

    return 0;
}
关键点:
freq[x]++是非常常见的模式——用值作为频率数组的下标- 声明
freq[11],下标 0-10,使freq[10](表示值 10)有效 int freq[11] = {}——= {}将所有元素初始化为零
题目 2.3.9 — 两数之和
读取 N(1 ≤ N ≤ 100)个整数和目标值 T。如果数组中任意两个不同元素相加等于 T,打印 YES,否则打印 NO。
样例输入:
5 9
1 4 5 6 3
(N=5,T=9,然后是数组)
样例输出: YES(因为 4+5=9 或 3+6=9)
思路: 检查所有满足 i < j 的对 (i, j),若任意一对之和等于 T,打印 YES。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n, t;
    cin >> n >> t;

    vector<int> arr(n);
    for (int i = 0; i < n; i++) cin >> arr[i];

    bool found = false;
    for (int i = 0; i < n && !found; i++) {
        for (int j = i + 1; j < n; j++) {
            if (arr[i] + arr[j] == t) {
                found = true;
                break;
            }
        }
    }

    cout << (found ? "YES" : "NO") << "\n";

    return 0;
}
关键点:
- 内层循环从
j = i + 1开始,避免同一元素使用两次,也避免重复检查相同的对 break+ 外层循环的&& !found条件确保找到匹配后立即停止- 这是 O(N²)——对 N ≤ 100 完全够用。N 最大 10^5 时,需要用集合(第 3.1 章)
题目 2.3.10 — 前缀和 读取 N(1 ≤ N ≤ 1000),然后读取 N 个整数。再读取 Q 个查询(1 ≤ Q ≤ 1000),每个查询有两个整数 L 和 R(0-indexed,包含两端)。对每个查询打印下标 L 到 R 的元素之和。
样例输入:
5
1 2 3 4 5
3
0 2
1 3
2 4
样例输出:
6
9
12
为什么不对每次查询直接求和? 暴力法:每次查询从 L 循环到 R,时间复杂度 O(N),所有查询总计 O(N×Q)。当 N=10^5,Q=10^5 时是 10^{10} 次操作——远超时限。
优化思路: 预处理一次,O(N);之后每次查询只需 O(1)。总计 O(N+Q),快得多!这就是前缀和的核心思想(第 3.2 章深入讲解)。
思路: 构建前缀和数组,prefix[i] = arr[0..i-1] 的和。则 L 到 R 的和 = prefix[R+1] - prefix[L],每次查询 O(1)。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<long long> arr(n), prefix(n + 1, 0);

    for (int i = 0; i < n; i++) {
        cin >> arr[i];
        prefix[i + 1] = prefix[i] + arr[i];  // 构建前缀和
    }
    // prefix[0] = 0
    // prefix[1] = arr[0]
    // prefix[2] = arr[0] + arr[1]
    // prefix[i] = arr[0] + arr[1] + ... + arr[i-1]

    int q;
    cin >> q;
    while (q--) {
        int l, r;
        cin >> l >> r;
        // l 到 r(含)的和 = prefix[r+1] - prefix[l]
        cout << prefix[r + 1] - prefix[l] << "\n";
    }

    return 0;
}
关键点:
prefix[i]= 前i个元素之和(prefix[0] = 0 是哨兵)- arr[L..R] 的和 =
prefix[R+1] - prefix[L]——减去 L 之前的部分 - 用样例验证:arr=[1,2,3,4,5],prefix=[0,1,3,6,10,15]。查询 [0,2]:prefix[3]-prefix[0]=6-0=6 ✓
复杂度分析:
- 时间:O(N + Q)——预处理 O(N) + 每次查询 O(1) × Q
- 空间:O(N)——前缀和数组占 N+1 的空间
💡 暴力 vs 优化: 暴力 O(N×Q) vs 前缀和 O(N+Q)。N=Q=10^5 时,前者需 10^{10} 次操作(超时),后者只需 2×10^5 次操作(瞬间)。
🏆 挑战题
挑战 2.3.11 — 数组旋转 读取 N(1 ≤ N ≤ 1000)和 K(0 ≤ K < N),再读取 N 个整数。打印向右旋转 K 位后的数组(最后 K 个元素移到最前面)。
样例输入:
5 2
1 2 3 4 5
样例输出: 4 5 1 2 3
思路: 新数组在位置 i 的元素原来在位置 (i - K + N) % N。等价地,从下标 N-K 开始打印,循环回绕。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n, k;
    cin >> n >> k;

    vector<int> arr(n);
    for (int i = 0; i < n; i++) cin >> arr[i];

    // 从下标 (n - k) % n 开始打印 n 个元素,循环回绕
    for (int i = 0; i < n; i++) {
        int idx = (n - k + i) % n;
        cout << arr[idx];
        if (i < n - 1) cout << " ";
    }
    cout << "\n";

    return 0;
}
关键点:
- 右旋 K 位:后 K 个元素先输出,再输出前 N-K 个
(n - k + i) % n将新位置i映射到旧位置——% n处理回绕- 验证:n=5,k=2。i=0: idx=(5-2+0)%5=3 → arr[3]=4。i=1: idx=4 → arr[4]=5。i=2: idx=0 → arr[0]=1。正确!
挑战 2.3.12 — 合并有序数组 读取 N₁,然后 N₁ 个已排序的整数;读取 N₂,然后 N₂ 个已排序的整数。打印合并后的有序数组。
样例输入:
3
1 3 5
4
2 4 6 8
样例输出: 1 2 3 4 5 6 8
思路: 双指针——一个指向每个数组的当前位置。每步取两个当前元素中较小的。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n1;
    cin >> n1;
    vector<int> a(n1);
    for (int i = 0; i < n1; i++) cin >> a[i];

    int n2;
    cin >> n2;
    vector<int> b(n2);
    for (int i = 0; i < n2; i++) cin >> b[i];

    // 双指针合并
    int i = 0, j = 0;
    vector<int> result;

    while (i < n1 && j < n2) {
        if (a[i] <= b[j]) {
            result.push_back(a[i++]);  // 取 a,i 前进
        } else {
            result.push_back(b[j++]);  // 取 b,j 前进
        }
    }
    // 某个数组可能还有剩余元素
    while (i < n1) result.push_back(a[i++]);
    while (j < n2) result.push_back(b[j++]);

    for (int idx = 0; idx < (int)result.size(); idx++) {
        cout << result[idx];
        if (idx < (int)result.size() - 1) cout << " ";
    }
    cout << "\n";

    return 0;
}
关键点:
- 双指针
i和j同步扫描数组a和b - 始终取当前较小的元素——维持有序性
- while 循环结束后,某个数组可能还有剩余元素——直接追加
挑战 2.3.13 — 气味距离 (USACO Bronze 风格)
N 头奶牛站成一排,每头奶牛有位置 p[i] 和气味半径 s[i]。如果两头奶牛之间的距离不超过它们半径之和,它们就能互相闻到对方。读取 N,然后 N 对(位置,半径),打印能互相闻到的奶牛对数。
样例输入:
4
1 2
5 1
8 3
15 1
样例输出: 1
(对 (1,2):距离=|5-8|=3,半径和=1+3=4,3≤4,YES。其余对距离均超过半径和,总计 1。)
思路: 检查所有满足 i < j 的对,对每对计算距离并与半径和比较。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<long long> pos(n), rad(n);
    for (int i = 0; i < n; i++) {
        cin >> pos[i] >> rad[i];
    }

    int count = 0;
    for (int i = 0; i < n; i++) {
        for (int j = i + 1; j < n; j++) {
            long long dist = abs(pos[i] - pos[j]);
            long long sumRad = rad[i] + rad[j];
            if (dist <= sumRad) {
                count++;
            }
        }
    }

    cout << count << "\n";
    return 0;
}
关键点:
- 检查满足 i < j 的对,避免同一对计数两次
abs(pos[i] - pos[j])计算位置间的绝对距离- 使用
long long以防位置和半径较大
第 2.4 章:结构体与类
竞赛编程中,你经常需要把相关数据组合在一起——例如,一个点有 x 和 y,一条边有两个端点和权重,一名学生有姓名和成绩。C++ 提供了 struct 和 class 来把数据(和行为)绑定成单一类型。本章涵盖两者,重点关注竞赛编程中最重要的内容。
2.4.1 为什么要把数据组合在一起?
🎒 背包类比
想象你要去旅行。你可以把每件东西分别拿着:
  - 左手:护照
  - 右手:手机
  - 口袋:钱包
  - 嘴里:机票 😬

或者,把所有东西放进一个背包:
  - backpack.passport ✅
  - backpack.phone ✅
  - backpack.wallet ✅
  - backpack.ticket ✅
struct/class 就是那个背包——把相关的东西组合在一个名字下。
没有结构体,如果你想存储 1000 名学生的名字和成绩,需要两个独立的数组:
string names[1000];
int scores[1000];
// 你必须手动保持下标同步——容易出错!
有了结构体,干净而安全:
struct Student {
    string name;
    int score;
};
Student students[1000];  // 每个学生自带名字和成绩
2.4.2 结构体基础
定义结构体
#include <bits/stdc++.h>
using namespace std;

struct Point {
    int x;
    int y;
};  // <-- 别忘了分号!

int main() {
    Point p;       // 声明一个 Point 变量
    p.x = 3;       // 用点号(.)访问成员
    p.y = 7;
    cout << "(" << p.x << ", " << p.y << ")" << endl;  // (3, 7)
    return 0;
}
初始化方式
// 方式一:聚合初始化(C++11,竞赛中最常用)
Point p1 = {3, 7};

// 方式二:指定初始化(C++20)
Point p2 = {.x = 3, .y = 7};

// 方式三:逐字段赋值
Point p3;
p3.x = 3;
p3.y = 7;
💡 竞赛技巧: 竞赛编程中,聚合初始化
{val1, val2, ...}是最常用的风格——输入快,读起来简洁。
带构造函数的结构体
可以定义构造函数让创建实例更简洁:
struct Point {
    int x, y;

    // 构造函数
    Point(int _x, int _y) : x(_x), y(_y) {}
};

int main() {
    Point p(3, 7);  // 调用构造函数
    cout << p.x << " " << p.y << endl;  // 3 7
}
⚠️ 警告: 一旦定义了自定义构造函数,就不能再用
Point p;(无参数)了,除非同时提供默认构造函数或给参数设默认值。
struct Point {
    int x, y;

    Point() : x(0), y(0) {}            // 默认构造函数
    Point(int _x, int _y) : x(_x), y(_y) {}  // 有参构造函数
};

Point p1;       // OK——使用默认构造函数,x=0, y=0
Point p2(3, 7); // OK——使用有参构造函数
2.4.3 结构体在竞赛编程中的应用
存储图论问题中的边
struct Edge {
    int from, to, weight;
};

int main() {
    int n, m;
    cin >> n >> m;

    vector<Edge> edges(m);
    for (int i = 0; i < m; i++) {
        cin >> edges[i].from >> edges[i].to >> edges[i].weight;
    }
}
自定义比较来排序结构体
这在 USACO 题目中极为常见。你经常需要按某个特定字段排序。
方法一:在结构体内重载 operator<
struct Event {
    int start, end;

    // 按结束时间排序(贪心调度)
    bool operator<(const Event& other) const {
        return end < other.end;
    }
};

int main() {
    vector<Event> events = {{1, 4}, {3, 5}, {0, 6}, {5, 7}, {3, 8}, {5, 9}};
    sort(events.begin(), events.end());  // 自动使用 operator<

    for (auto& e : events) {
        cout << "[" << e.start << ", " << e.end << "] ";
    }
}
方法二:lambda 比较器(更灵活)
struct Event {
    int start, end;
};

int main() {
    vector<Event> events = {{1, 4}, {3, 5}, {0, 6}, {5, 7}};

    // 按开始时间排序
    sort(events.begin(), events.end(), [](const Event& a, const Event& b) {
        return a.start < b.start;
    });
}
方法三:编写比较函数
bool compareByEnd(const Event& a, const Event& b) {
    return a.end < b.end;
}

sort(events.begin(), events.end(), compareByEnd);
💡 竞赛技巧: 对大多数 USACO 题,方法一(运算符重载)在只有一种自然排序顺序时最简洁。当同一程序需要多种不同排序顺序时,用方法二(lambda)。
多关键字排序
有时需要先按一个字段排序,再用另一个字段打破平局:
struct Student {
    string name;
    int score;

    bool operator<(const Student& other) const {
        if (score != other.score) return score > other.score;  // 高分优先
        return name < other.name;  // 分数相同时按姓名字典序
    }
};
或用 tie() 写法更简洁:
struct Student {
    string name;
    int score;

    bool operator<(const Student& other) const {
        // 按分数降序,再按姓名升序
        return tie(other.score, name) < tie(score, other.name);
    }
};
💡
tie()技巧:tie()创建一个元组用于字典序比较。调换元素顺序可反转该字段的排序方向。这是竞赛编程中非常常见的技巧。
在集合和映射中使用结构体
如果想把结构体作为 set 或 map 的键,必须定义 operator<:
struct Point {
    int x, y;
    bool operator<(const Point& other) const {
        return tie(x, y) < tie(other.x, other.y);
    }
};

set<Point> visited;
visited.insert({1, 2});
visited.insert({3, 4});

if (visited.count({1, 2})) {
    cout << "已访问过!" << endl;
}
在优先队列中使用结构体
struct State {
    int dist, node;

    // 最小堆:希望 dist 最小的在顶部
    // priority_queue 默认是最大堆,所以反转比较
    bool operator>(const State& other) const {
        return dist > other.dist;
    }
};

// 用 operator> 实现最小堆
priority_queue<State, vector<State>, greater<State>> pq;
pq.push({0, 1});   // 距离 0,节点 1
pq.push({5, 2});   // 距离 5,节点 2

auto top = pq.top();  // {0, 1}——距离最小
2.4.4 struct vs class——有什么区别?
实际情况是:struct 和 class 在 C++ 中几乎完全相同。唯一区别是默认访问级别:
| 特性 | struct | class |
|---|---|---|
| 默认访问 | public | private |
| 可以有方法? | ✅ 可以 | ✅ 可以 |
| 可以有构造函数? | ✅ 可以 | ✅ 可以 |
| 可以继承? | ✅ 可以 | ✅ 可以 |
// 这两个功能上完全相同:

struct PointS {
    int x, y;  // 默认 public
};

class PointC {
public:          // 必须显式声明为 public
    int x, y;
};
什么时候用哪个?
用 struct 当…… | 用 class 当…… |
|---|---|
| 简单数据容器 | 有不变量的复杂对象 |
| 竞赛编程(几乎始终) | 面向对象设计项目 |
| 所有成员都是 public | 需要封装(私有数据) |
| 想要最少的样板代码 | 构建库或大型系统 |
💡 竞赛惯例: 竞赛编程中,始终用
struct。它更简单、更简短,而且几乎从不需要私有成员。几乎每个竞赛选手的代码里都是struct。
2.4.5 类——完整视角
尽管 struct 足以应付竞赛编程,理解 class 对更广泛的 C++ 知识很有价值。
访问修饰符
class BankAccount {
private:    // 只能在类内部访问
    double balance;

public:     // 可以从任何地方访问
    BankAccount(double initial) : balance(initial) {}

    void deposit(double amount) {
        if (amount > 0) {
            balance += amount;
        }
    }

    void withdraw(double amount) {
        if (amount > 0 && amount <= balance) {
            balance -= amount;
        }
    }

    double getBalance() const {
        return balance;
    }
};

int main() {
    BankAccount acc(100.0);
    acc.deposit(50.0);
    acc.withdraw(30.0);
    cout << acc.getBalance() << endl;  // 120.0

    // acc.balance = 999999;  // 错误!balance 是私有的
}
为什么需要封装?
想象一台自动贩卖机:

- 公共接口:投币、按按钮、取饮料
- 私有内部:硬币计数器、库存、温控系统

你通过公共按钮与机器交互。
你不能直接伸手取饮料。

封装保护数据不被滥用。
竞赛编程中不需要这种级别的保护——代码速度更重要。但在软件工程中,它能防止大型代码库中的 bug。
成员函数(方法)
struct 和 class 都可以有成员函数:
struct Rect {
    int width, height;

    int area() const {
        return width * height;
    }

    int perimeter() const {
        return 2 * (width + height);
    }

    bool contains(int x, int y) const {
        return x >= 0 && x < width && y >= 0 && y < height;
    }
};

int main() {
    Rect r = {10, 5};
    cout << "面积:" << r.area() << endl;      // 50
    cout << "周长:" << r.perimeter() << endl;  // 30
    cout << r.contains(3, 4) << endl;            // 1(true)
}
💡 方法名后的
const: 方法名后的const关键字表示「这个方法不修改对象」。如果方法只读取数据,始终标记为const——这是良好实践,在使用const引用时也是必须的。
2.4.6 竞赛编程中的进阶结构体模式
pair——内置的「两字段结构体」
C++ 提供了 pair 作为只需要两个字段时的轻量替代:
#include <bits/stdc++.h>
using namespace std;

int main() {
    pair<int, int> p = {3, 7};
    cout << p.first << " " << p.second << endl;  // 3 7

    // pair 有内置比较(字典序)
    vector<pair<int, int>> v = {{3, 1}, {1, 5}, {3, 0}, {1, 2}};
    sort(v.begin(), v.end());
    // 结果:{1, 2}, {1, 5}, {3, 0}, {3, 1}

    // 可以用 make_pair 或直接用花括号
    auto q = make_pair(10, 20);
}
什么时候用 pair vs 自定义 struct:
用 pair | 用自定义 struct |
|---|---|
| 只有 2 个字段 | 3 个及以上字段 |
| 字段不需要有意义的名称 | 需要描述性字段名 |
| 临时分组 | 代码清晰度很重要 |
tuple——内置的「N 字段结构体」
tuple<int, string, double> t = {42, "Alice", 3.14};
cout << get<0>(t) << endl;  // 42
cout << get<1>(t) << endl;  // Alice

// 结构化绑定(C++17)——更简洁
auto [id, name, gpa] = t;
cout << name << " 的 GPA 是 " << gpa << endl;
💡 竞赛技巧: 超过 2 个字段时,带名称的
struct几乎总是比tuple更易读。pair可以随意用,但能用 struct 时就别用tuple。
含 array 或 vector 成员的结构体
struct Graph {
    int n;
    vector<vector<int>> adj;

    Graph(int _n) : n(_n), adj(_n) {}

    void addEdge(int u, int v) {
        adj[u].push_back(v);
        adj[v].push_back(u);
    }
};

int main() {
    Graph g(5);
    g.addEdge(0, 1);
    g.addEdge(1, 2);

    for (int v : g.adj[1]) {
        cout << v << " ";  // 0 2
    }
}
2.4.7 常见错误
❌ 错误一:忘记 } 后的分号
struct Point {
    int x, y;
}   // ← 缺少分号!

int main() { ... }
// 编译器给出令人困惑的错误,指向 main()
修复: 结构体/类定义的右花括号后始终加 ;。
❌ 错误二:运算符重载中忘记 const
struct Point {
    int x, y;
    // 错误——缺少 const
    bool operator<(const Point& other) {  // ← 在某些 STL 容器中无法工作
        return tie(x, y) < tie(other.x, other.y);
    }
};
修复: 比较运算符始终标记为 const:
bool operator<(const Point& other) const {  // ✅
    return tie(x, y) < tie(other.x, other.y);
}
❌ 错误三:使用未初始化的结构体成员
struct State {
    int dist, node;
};

State s;
cout << s.dist;  // 未定义行为!可能是任意值
修复: 始终初始化,或提供默认值:
struct State {
    int dist = 0;
    int node = 0;
};
❌ 错误四:优先队列中 operator< 方向搞反
struct State {
    int dist;
    // 想实现最小堆,你可能会这样写:
    bool operator<(const State& other) const {
        return dist < other.dist;  // 这会得到最大堆!(与你想要的相反)
    }
};
修复: 对 priority_queue 实现最小堆,要么反转比较,要么用 greater<>:
// 方案 A:反转 operator<
bool operator<(const State& other) const {
    return dist > other.dist;  // dist 更大的优先级更低 → 最小堆
}
priority_queue<State> pq;

// 方案 B:定义 operator> 并使用 greater<>
bool operator>(const State& other) const {
    return dist > other.dist;
}
priority_queue<State, vector<State>, greater<State>> pq;
2.4.8 练习题
🟢 题目一:学生排名
读取 n 名学生(姓名和成绩),按成绩降序排序,打印排名。
数据规模: 1 ≤ n ≤ 10⁵,姓名长度 ≤ 20,0 ≤ 成绩 ≤ 100。
输入:
3
Alice 85
Bob 92
Charlie 85

输出:
1. Bob 92
2. Alice 85
3. Charlie 85
💡 提示
定义一个带operator< 的 struct,成绩不同时高分优先,相同时按姓名字典序。
#include <bits/stdc++.h>
using namespace std;

struct Student {
    string name;
    int score;

    bool operator<(const Student& other) const {
        if (score != other.score) return score > other.score;
        return name < other.name;
    }
};

int main() {
    int n;
    cin >> n;
    vector<Student> students(n);
    for (int i = 0; i < n; i++) {
        cin >> students[i].name >> students[i].score;
    }
    sort(students.begin(), students.end());
    for (int i = 0; i < n; i++) {
        cout << i + 1 << ". " << students[i].name << " " << students[i].score << "\n";
    }
}
🟢 题目二:最近点对(一维)
给定数轴上 n 个点,找距离最小的点对。
数据规模: 2 ≤ n ≤ 10⁵,坐标为不超过 10⁹ 绝对值的整数。
输入:
5
7 1 4 9 2

输出:
1
(点 1 和点 2 之间)
💡 提示
排序后,答案是相邻元素的最小差值。#include <bits/stdc++.h>
using namespace std;
struct PointVal {
int val, originalIndex;
bool operator<(const PointVal& other) const {
return val < other.val;
}
};
int main() {
int n;
cin >> n;
vector<PointVal> points(n);
for (int i = 0; i < n; i++) {
cin >> points[i].val;
points[i].originalIndex = i;
}
sort(points.begin(), points.end());
int minDist = INT_MAX;
int bestI = 0, bestJ = 1;
for (int i = 0; i + 1 < n; i++) {
int d = points[i + 1].val - points[i].val;
if (d < minDist) {
minDist = d;
bestI = i;
bestJ = i + 1;
}
}
cout << minDist << "\n";
cout << "(点 " << points[bestI].val << " 和点 " << points[bestJ].val << " 之间)\n";
}
🟡 题目三:区间调度(贪心)
给定 n 个区间 [start, end],找不重叠区间的最大数量。
数据规模: 1 ≤ n ≤ 10⁵,0 ≤ start ≤ end ≤ 10⁹。
📄 给定 `n` 个区间 `[start, end]`,找不重叠区间的最大数量。
输入:
6
1 4
3 5
0 6
5 7
3 8
5 9

输出:
3
💡 提示
按结束时间排序区间。贪心地选择结束时间最早且与上一个已选区间不冲突的区间。#include <bits/stdc++.h>
using namespace std;
struct Interval {
int start, end;
bool operator<(const Interval& other) const {
return end < other.end;
}
};
int main() {
int n;
cin >> n;
vector<Interval> intervals(n);
for (int i = 0; i < n; i++) {
cin >> intervals[i].start >> intervals[i].end;
}
sort(intervals.begin(), intervals.end());
int count = 0, lastEnd = -1;
for (auto& it : intervals) {
if (it.start >= lastEnd) {
count++;
lastEnd = it.end;
}
}
cout << count << "\n";
}
📋 本章总结
| 概念 | 核心要点 |
|---|---|
| struct | 组合相关数据;成员默认为 public |
| class | 与 struct 相同,但成员默认为 private |
| 构造函数 | 创建实例时调用的特殊函数 |
| operator< | 让 sort()、set、map、priority_queue 支持你的类型 |
| tie() | 简洁的多关键字比较技巧 |
| pair | 内置的 2 字段结构体,支持字典序比较 |
| const 方法 | 标记不修改对象的方法 |
🎯 竞赛编程核心要点
- 竞赛中始终用
struct—— 更简单、更简短 - 掌握
operator<重载 —— 几乎每道 USACO 题都会用到 - 多关键字排序用
tie()—— 简洁且不易出错 - 记得
const—— STL 兼容性的要求 - 初始化你的成员 —— 避免未定义行为
- 2 个字段用
pair,3 个及以上用自定义 struct —— 好的经验法则
你现在知道如何创建自定义数据类型了——这是竞赛编程中组织数据的关键技能。接下来:强大的 STL 容器!
📖 第 2.5 章:分类讨论与矩形几何
2.5.0 从一道题出发:贴错的告示牌
先看一道 USACO 2021 Dec Bronze「Air Cownditioning」风格的入门真题——矩形版的它几乎年年出现:
📋 题目:告示牌(Billboard) 农夫 John 在墙上贴了两块矩形告示牌,给出两块的左下角和右上角坐标。 谷仓门也在一块矩形区域内。问:两块告示牌被门挡住之后,还剩多少可见面积? 数据范围: 所有坐标为整数,
0 ≤ x, y ≤ 1000,且每个矩形满足x1 < x2、y1 < y2。 (USACO 2018 Feb Bronze P2 原题就是三块矩形互相遮挡的版本。)
牌1: (1,2)–(6,14) 牌2: (11,2)–(16,14) 门: (7,2)–(13,10)
先试试你会的方法
思路 1:面积相加减? 总可见 = 牌1面积 + 牌2面积 − 被挡部分。但「牌1被门挡了多少」——两个矩形的遮挡关系有好几种:完全不相交、擦个边角、部分重叠、完全盖住……直接凭感觉写 if,十有八九漏掉「刚好贴边」的情况。
思路 2:逐格判断? 坐标范围如果是 10⁹,不能开数组也不能逐点扫。
关键观察: 「牌和门的相对位置」看似有无穷种,其实每一种都能用 min/max 统一表达:
- 交集的左边界 = 两矩形左边界的较大者
max(l1, l2) - 交集的右边界 = 两矩形右边界的较小者
min(r1, r2) - 若
右边界 ≤ 左边界,交集为空——「不相交」这种情形被一个if自然覆盖!
这就是本章两大主题的缩影:
- 分类讨论:像「牌和门怎么重叠」这种多情形问题,先画图列全所有情形,再写代码——不遗漏、不重复;
- 矩形几何:相交、覆盖、面积,全部归结为
min/max与乘法。
拆解这道题需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 2.5.1 | 分类讨论方法论:怎么枚举情形才不漏? |
| 2.5.2 | 矩形几何:相交判断与交集面积(本题核心) |
| 2.5.3+ | 完整题解、网格覆盖计数与练习 |
学习目标(学完本章你将能够):
- 识别需要分类讨论的题目,系统枚举所有情形
- 用「先画图、再列边界、最后写代码」的方法避免漏情况
- 处理坐标轴上的矩形交叉、覆盖、面积问题
- 判断两个矩形是否相交,计算交集面积
- 用差分思想处理网格上的矩形覆盖计数
- 读懂并实现 USACO Bronze 中常见的矩形覆盖题
2.5.1 分类讨论(Casework)
什么是分类讨论?
当问题的答案取决于若干个「互斥情形」时,需要逐一枚举每种情形,分别处理。
举几个简单例子:
- 一个数是正数、负数还是零?
- 两个区间是不相交、刚好相接,还是有重叠?
- 一个点在矩形内部、边界上,还是外部?
- 一个矩形是否被另一个矩形挡住了一部分?
这些问题都有一个共同点:不能只写一个公式就结束,而是要先判断当前输入属于哪一种情况。
核心原则:
- 完备性:不遗漏任何情形。
- 互斥性:不同情形之间最好不要重叠;如果会重叠,要明确优先级。
- 边界验证:特别检查
等于、刚好接触、刚好覆盖这些边界值。
分类讨论的通用步骤
做分类讨论题时,可以按照下面四步来:
- 画图:把题目中的对象画出来,比如区间、矩形、运动方向。
- 找边界:思考什么时候答案会发生变化,例如两个区间端点相等时。
- 列情况:把所有可能情况列出来,尽量保证没有遗漏。
- 写条件:把每种情况翻译成 C++ 的
if / else if / else。
例如:
if (第一种情况) {
// 处理第一种情况
} else if (第二种情况) {
// 处理第二种情况
} else {
// 剩余情况
}
这里最后的 else 很重要,它经常用于兜底:当前面所有明确列出的情况都不满足时,就进入最后一种情况。
示例:一维区间分类
题目描述:
给定两个闭区间 [a, b] 和 [c, d],其中 a <= b,c <= d。请判断这两个区间的关系:
- 完全不相交:两个区间之间有空隙。
- 仅端点相接:两个区间只有一个端点相同,没有长度上的重叠。
- 一个包含另一个:其中一个区间完全覆盖另一个区间。
- 部分重叠:两个区间有公共部分,但谁也没有完全包含谁。
先不要急着写代码,可以先画图:
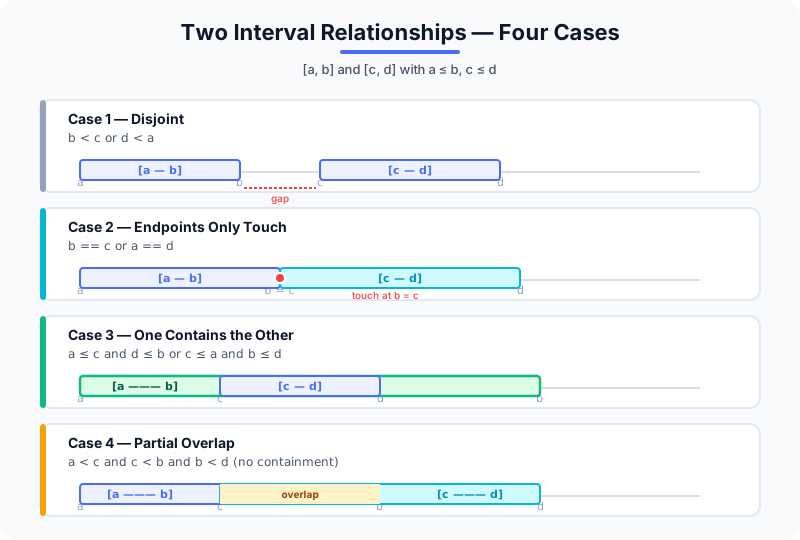
接下来把图翻译成条件。
关键边界:< 和 == 的区别
- 如果
b < c,说明[a,b]在[c,d]左边,并且中间有空隙。 - 如果
b == c,说明两个区间只在一个点相接。 - 如果
b > c,说明它们至少在横轴上有重叠或包含关系。
因此,在分类时,通常要先处理更特殊的情况,比如「完全不相交」和「端点相接」。
#include <bits/stdc++.h>
using namespace std;
int main() {
long long a, b, c, d;
cin >> a >> b >> c >> d; // 区间 [a,b] 和 [c,d]
// 如果输入不保证左端点 <= 右端点,可以先修正
if (a > b) swap(a, b);
if (c > d) swap(c, d);
if (b < c || d < a) {
cout << "完全不相交\n";
} else if (b == c || d == a) {
cout << "仅端点相接\n";
} else if (a <= c && d <= b) {
cout << "[c,d] 在 [a,b] 内部(或相等)\n";
} else if (c <= a && b <= d) {
cout << "[a,b] 在 [c,d] 内部(或相等)\n";
} else {
cout << "部分重叠\n";
}
return 0;
}
初学者常见疑问:为什么顺序很重要?
在 if / else if 中,程序会从上到下检查条件,遇到第一个满足的条件就执行,不会再继续检查后面的条件。
例如两个区间 [1, 5] 和 [1, 5]:
- 它既满足
[c,d] 在 [a,b] 内部。 - 也满足
[a,b] 在 [c,d] 内部。
这种情况并不是错误,而是说明两个区间相等。我们只要在题目要求的分类里确定一个输出即可。
💡 如果题目对「完全相等」有单独要求,就应该在包含判断之前先写
if (a == c && b == d)。
分类讨论的技巧
技巧 1:排序后减少情形数
对输入排序,可以将多种对称情形合并:
// 例:确保 a <= b(避免分别处理 a<b 和 a>b 两种情形)
if (a > b) swap(a, b);
技巧 2:用 min/max 简化区间操作
如果只关心两个区间的重叠长度,可以不必列出所有关系,而是直接算交集。
// 两区间 [a,b] 和 [c,d] 的交集长度
long long overlap = max(0LL, min(b, d) - max(a, c));
这个公式的含义是:
- 交集左端点是两个左端点中较大的那个:
max(a, c)。 - 交集右端点是两个右端点中较小的那个:
min(b, d)。 - 如果右端点小于等于左端点,说明没有正长度重叠。
注意:上面公式适合把区间看成
[a,b)和[c,d)这种「左闭右开」长度模型。若是闭区间并且要统计整数点个数,公式会略有不同。
技巧 3:画图 + 列举边界
分类讨论题必须动手画图,列出所有边界情况逐一验证。至少要检查:
- 完全分离
- 刚好相接
- 部分重叠
- 一个完全包含另一个
- 两者完全相等
技巧 4:优先写「容易判断的反面」
有些题目直接判断「相交」比较麻烦,但判断「不相交」很简单。
例如两个区间不相交只有两种情况:
b <= c || d <= a
那么相交就是它的反面:
!(b <= c || d <= a)
矩形相交也会用到同样的思想。
USACO Bronze 典型:方向判断
题目描述(USACO 风格):
一头奶牛站在二维平面上,初始位置是 (0, 0),初始方向朝北。接下来会给出 N 条指令,每条指令可能是下面三种之一:
left:原地向左转 90 度。right:原地向右转 90 度。forward D:沿当前朝向前进D步。
请输出执行完所有指令后,奶牛的最终坐标。
这个题看起来像模拟题,但本质上也需要分类讨论:
- 当前方向是北、东、南、西中的哪一个?
- 当前指令是左转、右转,还是前进?
- 如果前进,不同方向对应的
x、y变化不同。
朴素写法:直接分类讨论
最直观的写法是:
if (dir == "N") y += d;
else if (dir == "S") y -= d;
else if (dir == "E") x += d;
else if (dir == "W") x -= d;
这种写法容易理解,但如果转向逻辑也都用字符串分类,代码会比较长。
更简洁的写法:方向编号
我们可以把四个方向按顺时针编号:
0: North
1: East
2: South
3: West
这样右转就是编号 +1,左转就是编号 -1。为了避免出现负数,可以写成:
// 左转:dir - 1
// 加 4 是为了避免负数,再对 4 取模
(dir + 3) % 4
#include <bits/stdc++.h>
using namespace std;
int main() {
// 方向编码:0=N, 1=E, 2=S, 3=W
// dx/dy 对应四个方向的位移
int dx[] = {0, 1, 0, -1};
int dy[] = {1, 0, -1, 0};
int x = 0, y = 0, dir = 0; // 初始位置和方向
int n; cin >> n;
while (n--) {
string cmd; cin >> cmd;
if (cmd == "left") {
dir = (dir + 3) % 4; // 左转 = (dir-1+4)%4
} else if (cmd == "right") {
dir = (dir + 1) % 4; // 右转
} else {
int d; cin >> d;
x += dx[dir] * d;
y += dy[dir] * d;
}
}
cout << x << " " << y << "\n";
return 0;
}
2.5.2 矩形几何
坐标系中的矩形表示
竞赛中的矩形通常是轴对齐矩形,也就是矩形的边和坐标轴平行。它一般用两个对角顶点表示:
- 左下角:
(x1, y1) - 右上角:
(x2, y2)
通常满足:
x1 < x2, y1 < y2
画出来是这样:
y
↑
y2 +----------+
| |
y1 +----------+→ x
x1 x2
如果题目没有保证 x1 < x2、y1 < y2,读入后要先修正:
if (x1 > x2) swap(x1, x2);
if (y1 > y2) swap(y1, y2);
面积为什么是 (x2 - x1) * (y2 - y1)?
矩形的宽度是横坐标差:
width = x2 - x1
矩形的高度是纵坐标差:
height = y2 - y1
所以面积是:
area = (x2 - x1) * (y2 - y1)
例如矩形 (1, 2) 到 (4, 6):
- 宽度:
4 - 1 = 3 - 高度:
6 - 2 = 4 - 面积:
3 * 4 = 12
一个重要习惯:把矩形看成半开区间
在很多竞赛题里,矩形 (x1, y1, x2, y2) 表示:
x1 <= x < x2
y1 <= y < y2
也就是左边界和下边界算进去,右边界和上边界不算进去。这样做的好处是:
- 面积正好是
(x2 - x1) * (y2 - y1)。 - 两个矩形只在边界接触时,交集面积是
0。 - 用差分数组统计格子时更方便。
例如矩形 (0,0)-(2,2) 覆盖的是下面 4 个 1×1 小格子:
(0,1) (1,1)
(0,0) (1,0)
它的面积是 2 * 2 = 4。
两矩形是否相交
关键规则: 两矩形不相交,当且仅当一个矩形完全在另一个的左边、右边、下边或上边。
也就是说,如果出现下面任意一种情况,它们就没有正面积交集:
- A 在 B 的左边:
ax2 <= bx1 - B 在 A 的左边:
bx2 <= ax1 - A 在 B 的下边:
ay2 <= by1 - B 在 A 的下边:
by2 <= ay1
用图理解其中一种:
A 在 B 左边:
A B
+---+ +---+
| | | |
+---+ +---+
ax2 <= bx1
所以判断相交时,可以先判断「不相交」,再取反。
// 矩形 A: (ax1,ay1)-(ax2,ay2)
// 矩形 B: (bx1,by1)-(bx2,by2)
bool intersects(long long ax1, long long ay1, long long ax2, long long ay2,
long long bx1, long long by1, long long bx2, long long by2) {
// A 完全在 B 左边 or 右边 or 下边 or 上边
if (ax2 <= bx1 || bx2 <= ax1 || ay2 <= by1 || by2 <= ay1)
return false;
return true;
}
💡 这里使用
<=,表示两个矩形如果只是边贴边,没有面积重叠,就不算相交。
交集面积
计算两个矩形的交集,可以把问题拆成两个一维问题:
x方向的重叠长度y方向的重叠长度
交集矩形的左下角和右上角分别是:
交集左下角:max(两个左边界), max(两个下边界)
交集右上角:min(两个右边界), min(两个上边界)
对应到代码就是:
long long intersection_area(long long ax1, long long ay1, long long ax2, long long ay2,
long long bx1, long long by1, long long bx2, long long by2) {
long long ix1 = max(ax1, bx1);
long long iy1 = max(ay1, by1);
long long ix2 = min(ax2, bx2);
long long iy2 = min(ay2, by2);
if (ix2 <= ix1 || iy2 <= iy1) return 0; // 不相交,或只是边界相接
return (ix2 - ix1) * (iy2 - iy1);
}
逐步追踪示例:
矩形 A: (1,1)-(4,4)
矩形 B: (2,2)-(6,5)
第 1 步:求交集左下角
x = max(1,2) = 2
y = max(1,2) = 2
所以左下角是 (2,2)
第 2 步:求交集右上角
x = min(4,6) = 4
y = min(4,5) = 4
所以右上角是 (4,4)
第 3 步:求面积
宽 = 4 - 2 = 2
高 = 4 - 2 = 2
面积 = 2 * 2 = 4
再看一个没有面积重叠的例子:
矩形 A: (0,0)-(2,2)
矩形 B: (2,0)-(4,2)
它们只是边界接触。
交集宽度 = min(2,4) - max(0,2) = 2 - 2 = 0
所以交集面积是 0。
两矩形的并集面积
两个矩形的并集面积,指的是至少被其中一个矩形覆盖的面积。
如果直接写:
并集面积 = A 的面积 + B 的面积
会出现一个问题:重叠部分被算了两次。
所以要把重叠部分减掉一次:
并集面积 = A 的面积 + B 的面积 - A 与 B 的交集面积
这就是最简单的容斥思想。
long long union_area(long long ax1, long long ay1, long long ax2, long long ay2,
long long bx1, long long by1, long long bx2, long long by2) {
long long areaA = (ax2 - ax1) * (ay2 - ay1);
long long areaB = (bx2 - bx1) * (by2 - by1);
long long inter = intersection_area(ax1, ay1, ax2, ay2, bx1, by1, bx2, by2);
return areaA + areaB - inter;
}
举例:
矩形 A 面积 = 12
矩形 B 面积 = 10
重叠面积 = 4
如果直接相加:12 + 10 = 22,重叠部分多算了一次。
正确答案:12 + 10 - 4 = 18
💡 对两个矩形求并集面积时,这个公式很好用;但如果是三个或更多矩形,重叠关系会更复杂,通常要用扫描线、差分数组或更系统的容斥方法。
矩形内点的判断
判断一个点和矩形的关系时,要先看题目要求:
- 如果题目问点是否在矩形「内部或边界上」,使用
<=。 - 如果题目只问点是否在严格内部,使用
<。 - 如果题目要把边界单独分类,就要分别判断「边界」和「内部」。
bool point_in_rect(long long px, long long py,
long long x1, long long y1, long long x2, long long y2) {
return x1 <= px && px <= x2 && y1 <= py && py <= y2;
}
例如矩形 (0,0)-(3,2):
- 点
(1,1)在内部。 - 点
(0,1)在左边界上。 - 点
(3,2)在右上角边界上。 - 点
(4,1)在外部。
进阶:N 个矩形的覆盖面积(差分法)
当有大量矩形叠加时,如果逐个格子暴力标记,有时会比较慢;如果坐标范围不大,可以用二维差分数组统计每个格子被覆盖的次数。
先理解一维差分
假设有一个数组,我们想让区间 [l, r) 全部加 1,可以这样做:
diff[l]++;
diff[r]--;
最后从左到右做前缀和,就能知道每个位置被加了多少次。
二维差分是同样的思想,只是从「线段」变成「矩形」。
二维差分如何给矩形加 1?
如果要给矩形 [x1, x2) × [y1, y2) 覆盖区域加 1,做四个角的修改:
diff[y1][x1]++;
diff[y1][x2]--;
diff[y2][x1]--;
diff[y2][x2]++;
可以把它理解为:
- 从左下角开始加上影响。
- 到右边界之后取消影响。
- 到上边界之后取消影响。
- 右上角被取消了两次,所以要补回来一次。
#include <bits/stdc++.h>
using namespace std;
const int MAX_COORD = 1000; // 坐标范围假设为 0~1000
int diff[MAX_COORD + 2][MAX_COORD + 2]; // 多开空间,方便处理 x2/y2
// 给矩形 [x1,x2) × [y1,y2) 覆盖区域 +1
void add_rect(int x1, int y1, int x2, int y2) {
diff[y1][x1]++;
diff[y1][x2]--;
diff[y2][x1]--;
diff[y2][x2]++;
}
int main() {
int n;
cin >> n;
while (n--) {
int x1, y1, x2, y2;
cin >> x1 >> y1 >> x2 >> y2;
add_rect(x1, y1, x2, y2);
}
// 二维前缀和还原每个格子的覆盖次数
for (int y = 0; y <= MAX_COORD; y++) {
for (int x = 0; x <= MAX_COORD; x++) {
if (y > 0) diff[y][x] += diff[y - 1][x];
if (x > 0) diff[y][x] += diff[y][x - 1];
if (y > 0 && x > 0) diff[y][x] -= diff[y - 1][x - 1];
}
}
// 统计被至少一个矩形覆盖的 1×1 格子
// 左下角最大只能到 (999,999),因为格子 [999,1000) 才是最后一格
long long covered = 0;
for (int y = 0; y < MAX_COORD; y++) {
for (int x = 0; x < MAX_COORD; x++) {
if (diff[y][x] > 0) covered++;
}
}
cout << covered << "\n";
return 0;
}
为什么统计的是格子,不是点?
坐标范围是 0~1000 时,格子通常是:
横坐标区间:[0,1), [1,2), ..., [999,1000)
纵坐标区间:[0,1), [1,2), ..., [999,1000)
所以共有 1000 × 1000 个 1×1 格子。数组下标 diff[y][x] 可以理解为左下角是 (x,y) 的那个小格子的覆盖次数。
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| 边界情形遗漏 | 只考虑「一般情况」,忽略端点相等 | 逐一列出所有情形,验证 <= vs < |
| 把相接误判为相交 | 两个矩形只是边贴边,交集面积其实是 0 | 判断不相交时使用 <=,不是 < |
| 整数溢出 | 坐标值大时 x * y 超过 int | 面积、答案统一用 long long |
| 矩形方向假设错误 | 没有保证 x1 < x2、y1 < y2 | 读入后必要时用 swap 修正 |
| 差分数组越界 | 添加矩形时坐标超出范围,或没有给 x2/y2 多开空间 | 数组通常多开一格,例如 1002 × 1002 |
| 把点和格子混淆 | 坐标点数量和 1×1 格子数量不是一回事 | 覆盖面积题统计的是格子,不是坐标点 |
| 行列下标写反 | diff[y][x] 和 diff[x][y] 混用 | 统一约定第一维是 y,第二维是 x,并全程保持一致 |
调试建议
写完矩形题后,可以自己构造下面几组数据检查:
- 完全不相交:答案应该是
0。 - 刚好边界相接:交集面积也应该是
0。 - 一个矩形完全包含另一个矩形:交集面积应该等于小矩形面积。
- 两个矩形完全相同:交集面积应该等于任意一个矩形的面积。
- 只有部分重叠:手算一次宽度、高度,再和程序输出对比。
本章小结
本章最重要的思想可以总结为三句话:
- 分类讨论先画图:不要凭感觉写条件,先把所有情况画出来。
- 矩形问题拆成两个方向:分别处理
x方向和y方向,再把结果合起来。 - 覆盖问题优先想差分:当矩形很多、坐标范围不大时,二维差分比逐块暴力更清晰。
常用公式:
// 矩形面积
area = (x2 - x1) * (y2 - y1);
// 两矩形交集边界
ix1 = max(ax1, bx1);
iy1 = max(ay1, by1);
ix2 = min(ax2, bx2);
iy2 = min(ay2, by2);
// 两矩形交集面积
intersection = max(0LL, ix2 - ix1) * max(0LL, iy2 - iy1);
💪 练习题
🟢 题目 1:矩形相交判断
题目描述:
给定两个轴对齐矩形 A 和 B。每个矩形用四个整数表示:
x1 y1 x2 y2
其中 (x1, y1) 是矩形左下角,(x2, y2) 是矩形右上角,并且 x1 < x2、y1 < y2。
数据范围: -10⁹ ≤ x, y ≤ 10⁹(坐标绝对值可达 10⁹,交集面积需用 long long)。
请判断两个矩形是否存在正面积交集:
- 如果存在,输出交集面积。
- 如果不存在,输出
0。
注意:如果两个矩形只是边界相接,例如一个矩形的右边界等于另一个矩形的左边界,那么交集面积为 0。
输入格式:
ax1 ay1 ax2 ay2
bx1 by1 bx2 by2
输出格式:
一个整数,表示两个矩形的交集面积
样例输入:
1 1 4 4
2 2 6 5
样例输出:
4
样例解释:
两个矩形的交集是 (2,2)-(4,4),宽度为 2,高度为 2,面积为 4。
#include <bits/stdc++.h>
using namespace std;
int main() {
long long ax1, ay1, ax2, ay2;
long long bx1, by1, bx2, by2;
cin >> ax1 >> ay1 >> ax2 >> ay2;
cin >> bx1 >> by1 >> bx2 >> by2;
long long ix1 = max(ax1, bx1);
long long iy1 = max(ay1, by1);
long long ix2 = min(ax2, bx2);
long long iy2 = min(ay2, by2);
if (ix2 <= ix1 || iy2 <= iy1) {
cout << 0 << "\n";
} else {
cout << (ix2 - ix1) * (iy2 - iy1) << "\n";
}
return 0;
}
🟡 题目 2:奶牛放牧区域(USACO Bronze 风格)
题目描述:
农夫 John 有 N 块矩形牧场。每块牧场的边都与坐标轴平行,且坐标都是 0~1000 之间的整数。
数据范围: 1 ≤ N ≤ 1000,0 ≤ x1 < x2 ≤ 1000,0 ≤ y1 < y2 ≤ 1000。
每块牧场用左下角 (x1, y1) 和右上角 (x2, y2) 表示。它覆盖所有满足下面条件的 1×1 小格子:
x1 <= x < x2
y1 <= y < y2
如果多块牧场重叠,重叠部分只计算一次。请你求出被至少一块牧场覆盖的总格数,也就是覆盖总面积。
输入格式:
N
x1 y1 x2 y2
x1 y1 x2 y2
...
输出格式:
一个整数,表示被覆盖的 1×1 格子数量
样例输入:
3
0 0 2 2
1 1 3 3
4 4 5 5
样例输出:
8
样例解释:
- 第一块牧场面积是
4。 - 第二块牧场面积是
4。 - 它们重叠了
1个格子。 - 第三块牧场面积是
1。 - 总覆盖面积是
4 + 4 - 1 + 1 = 8。
思路: 用差分数组标记每个 1×1 格子被覆盖的次数,最后统计覆盖次数 >= 1 的格子数。
#include <bits/stdc++.h>
using namespace std;
int diff[1002][1002];
int main() {
int n;
cin >> n;
while (n--) {
int x1, y1, x2, y2;
cin >> x1 >> y1 >> x2 >> y2;
// 给矩形 [x1,x2) × [y1,y2) 加 1
diff[y1][x1]++;
diff[y1][x2]--;
diff[y2][x1]--;
diff[y2][x2]++;
}
long long ans = 0;
for (int y = 0; y <= 1000; y++) {
for (int x = 0; x <= 1000; x++) {
if (y > 0) diff[y][x] += diff[y - 1][x];
if (x > 0) diff[y][x] += diff[y][x - 1];
if (y > 0 && x > 0) diff[y][x] -= diff[y - 1][x - 1];
// 只统计左下角为 (x,y) 的 1×1 格子,最大到 (999,999)
if (x < 1000 && y < 1000 && diff[y][x] > 0) ans++;
}
}
cout << ans << "\n";
return 0;
}
🔴 题目 3:矩形分类问题(综合)
题目描述:
给定一个轴对齐矩形和 N 个点。请判断每个点与矩形的关系:
- 如果点在矩形四条边上,输出
边界。 - 如果点在矩形内部,但不在边界上,输出
内部。 - 如果点不在矩形内部,也不在边界上,输出
外部。
矩形由左下角 (x1, y1) 和右上角 (x2, y2) 给出,保证 x1 < x2、y1 < y2。
数据范围: -10⁹ ≤ 矩形坐标 ≤ 10⁹,1 ≤ N ≤ 10⁵,-10⁹ ≤ px, py ≤ 10⁹。
输入格式:
x1 y1 x2 y2
N
px py
px py
...
输出格式:
对每个点输出一行:边界、内部 或 外部。
样例输入:
0 0 4 3
5
1 1
0 2
4 3
5 1
2 3
样例输出:
内部
边界
边界
外部
边界
样例解释:
(1,1)的横纵坐标都严格在矩形范围内,所以是内部。(0,2)在左边界上。(4,3)是右上角顶点,属于边界。(5,1)在矩形外部。(2,3)在上边界上。
#include <bits/stdc++.h>
using namespace std;
int main() {
long long x1, y1, x2, y2;
cin >> x1 >> y1 >> x2 >> y2;
int n;
cin >> n;
while (n--) {
long long px, py;
cin >> px >> py;
bool on_vertical_edge = (px == x1 || px == x2) && (y1 <= py && py <= y2);
bool on_horizontal_edge = (py == y1 || py == y2) && (x1 <= px && px <= x2);
bool on_edge = on_vertical_edge || on_horizontal_edge;
bool inside = x1 < px && px < x2 && y1 < py && py < y2;
if (on_edge) cout << "边界\n";
else if (inside) cout << "内部\n";
else cout << "外部\n";
}
return 0;
}
🔴 题目 4:USACO Bronze — 遮挡广告牌
题目描述:
一面墙上贴了两块广告牌,随后一辆卡车停在墙前,挡住了其中一部分区域。广告牌和卡车在墙上的投影都可以看作轴对齐矩形。
现在给出:
- 第一块广告牌的矩形坐标。
- 第二块广告牌的矩形坐标。
- 卡车遮挡区域的矩形坐标。
请计算两块广告牌仍然可见的总面积。
注意:
- 两块广告牌之间不会相互遮挡。
- 卡车可能不遮挡某块广告牌。
- 卡车可能只遮挡广告牌的一部分。
- 卡车也可能完全遮挡某块广告牌。
- 如果卡车只和广告牌边界接触,不会减少可见面积。
数据范围(与 USACO 2018 Feb Bronze 原题一致): 所有坐标为整数,0 ≤ x, y ≤ 1000,且每个矩形满足 x1 < x2、y1 < y2。
输入格式:
三行,每行 4 个整数:
x1 y1 x2 y2
x1 y1 x2 y2
x1 y1 x2 y2
分别表示广告牌 1、广告牌 2、卡车遮挡区域。每个矩形都由左下角和右上角表示。
输出格式:
一个整数,表示两块广告牌仍然可见的总面积
样例输入:
1 2 3 5
6 0 10 4
2 1 8 3
样例输出:
17
样例解释:
广告牌 1 的面积是 (3 - 1) * (5 - 2) = 6。卡车与广告牌 1 的交集是 (2,2)-(3,3),面积是 1,所以广告牌 1 可见面积是 5。
广告牌 2 的面积是 (10 - 6) * (4 - 0) = 16。卡车与广告牌 2 的交集是 (6,1)-(8,3),面积是 4,所以广告牌 2 可见面积是 12。
总可见面积是 5 + 12 = 17。
核心思路: 分类讨论 + 容斥。总面积 = 广告牌1面积 + 广告牌2面积 - 广告牌1被卡车遮挡面积 - 广告牌2被卡车遮挡面积。每块广告牌与卡车的遮挡面积用矩形交集公式计算。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
// 计算两个矩形的交集面积
ll inter_area(ll ax1, ll ay1, ll ax2, ll ay2,
ll bx1, ll by1, ll bx2, ll by2) {
ll ix1 = max(ax1, bx1), iy1 = max(ay1, by1);
ll ix2 = min(ax2, bx2), iy2 = min(ay2, by2);
if (ix2 <= ix1 || iy2 <= iy1) return 0;
return (ix2 - ix1) * (iy2 - iy1);
}
int main() {
ll a1x1, a1y1, a1x2, a1y2; // 广告牌1
ll a2x1, a2y1, a2x2, a2y2; // 广告牌2
ll tx1, ty1, tx2, ty2; // 卡车
cin >> a1x1 >> a1y1 >> a1x2 >> a1y2;
cin >> a2x1 >> a2y1 >> a2x2 >> a2y2;
cin >> tx1 >> ty1 >> tx2 >> ty2;
ll area1 = (a1x2 - a1x1) * (a1y2 - a1y1);
ll area2 = (a2x2 - a2x1) * (a2y2 - a2y1);
ll covered1 = inter_area(a1x1, a1y1, a1x2, a1y2, tx1, ty1, tx2, ty2);
ll covered2 = inter_area(a2x1, a2y1, a2x2, a2y2, tx1, ty1, tx2, ty2);
cout << area1 + area2 - covered1 - covered2 << "\n";
return 0;
}
复杂度分析: 时间 O(1),空间 O(1)。只需计算几个矩形的面积和交集,常数时间完成。
💡 章节联系: 矩形几何是 USACO Bronze 的高频题型之一(约占 15%),常与前缀和(差分数组)结合。掌握后可直接用于解决「覆盖面积」「重叠判断」等问题。
📖 第 2.6 章:位运算
🎯 学习目标
学完本章后,你将能够:
- 看懂一个整数的二进制表示,并知道每一位像一个「开关」
- 使用六种位运算符进行高效整数操作
- 用位运算检查、设置、清除、翻转二进制位
- 用整数作为「集合」(状压表示)进行集合运算
- 枚举一个整数所有子集(状压 DP 基础)
- 理解常见的位运算技巧(lowbit、快速判断 2 的幂等)
如果你第一次接触位运算,不要急着背模板。请按下面顺序理解:
1. 先把二进制位想象成一排开关:每一位不是关(0)就是开(1)。
2. 再理解 `&`、`|`、`^` 是在「同一位置的两个开关」之间做判断。
3. 然后学习 `1 << k`:它的意思是在第 `k` 个位置放一个单独亮着的开关。
4. 最后再看集合、枚举子集和 DP。它们其实都是在操作这一排开关。
2.6.1 为什么要学位运算?
计算机存整数时,底层不是十进制的 0, 1, 2, 3...,而是一串二进制位。例如:
十进制 13 = 二进制 1101
可以把 1101 想成 4 个小灯泡:
位置: 3 2 1 0
二进制: 1 1 0 1
含义: 开 开 关 开
每一位都有自己的价值:
| 位置 | 价值 | 是否亮着 | 贡献 |
|---|---|---|---|
| 第 0 位 | 1 | 1 | 1 |
| 第 1 位 | 2 | 0 | 0 |
| 第 2 位 | 4 | 1 | 4 |
| 第 3 位 | 8 | 1 | 8 |
所以 13 = 8 + 4 + 1。
位运算就是直接操作这些小灯泡。普通加减乘除是对整个数字做运算;位运算是对数字内部的每一盏灯单独操作。
竞赛中的典型应用:
| 应用 | 场景 |
|---|---|
| 状态压缩(状压 DP) | 用一个整数表示一个集合或状态 |
| 快速幂 | 利用指数的二进制分解 |
| 枚举子集 | 遍历 N 个元素的所有子集 |
| 树状数组的 lowbit | x & (-x) 找最低有效位 |
| 奇偶判断 | x & 1 比 x % 2 更快 |
一个最小例子:为什么 x & 1 能判断奇偶?
一个数是否为奇数,只看二进制的最后一位:
12 = 1100,最后一位是 0,所以是偶数
13 = 1101,最后一位是 1,所以是奇数
1 的二进制只有最后一位是 1:
13 & 1
1101
0001
----
0001 -> 结果不是 0,所以 13 是奇数
12 & 1
1100
0001
----
0000 -> 结果是 0,所以 12 是偶数
这就是位运算的思维方式:不看整个数,只盯住你关心的那一位。
2.6.2 六种基本位运算符
| 运算符 | 名称 | 用法 | 示例(二进制) |
|---|---|---|---|
& | 按位与 (AND) | a & b | 1100 & 1010 = 1000 |
| | 按位或 (OR) | a | b | 1100 | 1010 = 1110 |
^ | 按位异或 (XOR) | a ^ b | 1100 ^ 1010 = 0110 |
~ | 按位非 (NOT) | ~a | ~1100 = 0011... |
<< | 左移 | a << k | 0001 << 2 = 0100 |
>> | 右移 | a >> k | 1100 >> 1 = 0110 |
直觉记忆
AND &:两个都是1才得1(取交集:都有才保留)
OR |:有一个是1就得1(取并集:有一个就保留)
XOR ^:不同为1,相同为0(取差集/翻转:不一样才保留)
NOT ~:0变1,1变0(取补集)
一位一位地算,别整串一起看
初学位运算时,最容易犯的错误是把 1100 & 1010 当成普通数字计算。实际上它是「同一列对同一列」计算:
1100
& 1010
------
1000
从右到左逐列看:
| 位置 | 上面的位 | 下面的位 | & 结果 | 原因 |
|---|---|---|---|---|
| 第 0 位 | 0 | 0 | 0 | 不是两个 1 |
| 第 1 位 | 0 | 1 | 0 | 不是两个 1 |
| 第 2 位 | 1 | 0 | 0 | 不是两个 1 |
| 第 3 位 | 1 | 1 | 1 | 两个都是 1 |
同理,| 是「只要有一个 1 就亮」,^ 是「两边不一样才亮」。
左移和右移:把灯泡整体搬家
<< 和 >> 不改变每一位本身,而是把整排二进制位往左或往右移动。
1 = 0001
1 << 1 = 0010 = 2
1 << 2 = 0100 = 4
1 << 3 = 1000 = 8
所以 1 << k 表示:只让第 k 位亮起来。
这也是后面所有模板的基础:
1 << k
可以理解成一个「只选中第 k 位的小工具」。
2.6.3 常用位操作模板
先记住一个核心工具:
1 << k
它表示一个只有第 k 位是 1 的数字。注意第 k 位从右往左数,并且从 0 开始:
k: 3 2 1 0
1 << 0 = 0 0 0 1
1 << 1 = 0 0 1 0
1 << 2 = 0 1 0 0
1 << 3 = 1 0 0 0
假设 x = 13 = 1101,我们想操作第 2 位,可以先造出面具 1 << 2 = 0100。后面所有操作,都是让 x 和这个面具做运算。
不要先背完整模板。我们会把每个函数单独拆开:先说它想解决什么问题,再看代码,最后用一个具体数字一步一步算。全部理解后,再把它们汇总成一张完整工具表。
1. 检查第 k 位是否为 1
问题: 给你一个整数 x,怎样知道它的第 k 位是不是亮着?
bool check(int x, int k) {
return (x >> k) & 1;
}
这段代码分成两步:
x >> k:把第k位移动到最右边。& 1:只检查最右边这一位是不是1。
为什么要移动到最右边?因为最右边最容易检查。只要和 1 做 &,就能保留最后一位,其他位都会变成 0。
假设:
x = 13 = 1101
k = 2
第 2 位是从右往左数的第三位:
位置: 3 2 1 0
x: 1 1 0 1
↑
第 2 位
计算过程:
x >> 2:
1101 >> 2 = 0011
再 & 1:
0011
0001
----
0001
结果是 1,说明 13 的第 2 位是亮着的。
如果检查第 1 位:
x >> 1:
1101 >> 1 = 0110
再 & 1:
0110
0001
----
0000
结果是 0,说明第 1 位没有亮。
2. 将第 k 位设为 1(置位)
问题: 怎样把某一盏灯打开?如果它本来就是开的,就保持打开。
int set_bit(int x, int k) {
return x | (1 << k);
}
这里的关键是 |:只要两边有一个是 1,结果就是 1。
所以我们先用 1 << k 做一个只在第 k 位为 1 的面具,再用 | 把这一位打开。
假设:
x = 13 = 1101
k = 1
mask = 1 << 1 = 0010
计算:
1101
| 0010
------
1111 = 15
第 1 位原来是 0,现在被打开了。
如果这一位本来就是 1,也不会有问题:
x = 13 = 1101
k = 2
mask = 0100
1101
| 0100
------
1101
第 2 位本来就是 1,置位后仍然是 1。
3. 将第 k 位设为 0(清位)
问题: 怎样把某一盏灯关掉?如果它本来就是关的,就保持关闭。
int clear_bit(int x, int k) {
return x & ~(1 << k);
}
这段代码看起来比置位难一点,因为多了一个 ~。我们一步一步拆开:
1 << k:制造一个只有第k位是1的面具。~(1 << k):把面具反过来,让第k位变成0,其他位变成1。x & ~(1 << k):用&保留其他位,同时把第k位变成0。
假设:
x = 13 = 1101
k = 2
先得到面具:
1 << 2 = 0100
反过来:
~0100 = ...1011
为了方便观察,我们只看最低 4 位,就是:
1011
然后做 &:
1101
& 1011
------
1001 = 9
第 2 位被关掉了,其他位保持原样。
如果第 k 位本来就是 0,清位也不会改变它:
x = 13 = 1101
k = 1
mask 反过来后最低 4 位是 1101
1101
& 1101
------
1101
4. 翻转第 k 位
问题: 怎样让某一盏灯“反过来”?开着就关掉,关着就打开。
int flip_bit(int x, int k) {
return x ^ (1 << k);
}
这里用的是 ^。它的规则是:相同得 0,不同得 1。
更适合记成:
某一位 ^ 0:保持不变
某一位 ^ 1:发生翻转
所以 x ^ (1 << k) 的意思是:只让第 k 位和 1 做异或,其他位和 0 做异或,因此只有第 k 位会翻转。
例 1:把第 1 位从 0 翻成 1。
x = 13 = 1101
k = 1
mask = 0010
1101
^ 0010
------
1111 = 15
例 2:把第 2 位从 1 翻成 0。
x = 13 = 1101
k = 2
mask = 0100
1101
^ 0100
------
1001 = 9
所以翻转不是固定变成 1,也不是固定变成 0,而是:原来是什么,就变成相反的状态。
5. 判断一个数是否是 2 的幂
问题: 怎样快速判断 x 是不是 1, 2, 4, 8, 16... 这样的数?
bool is_power_of_two(int x) {
return x > 0 && (x & (x - 1)) == 0;
}
先观察 2 的幂在二进制中的样子:
| 十进制 | 二进制 |
|---|---|
1 | 0001 |
2 | 0010 |
4 | 0100 |
8 | 1000 |
它们都有一个共同特点:二进制里只有一个 1。
再看 x - 1 会发生什么。以 x = 8 为例:
x = 1000
x - 1 = 0111
做 &:
1000
& 0111
------
0000
结果是 0,说明 8 只有一个 1,所以它是 2 的幂。
再看一个不是 2 的幂的数,比如 12:
x = 1100
x - 1 = 1011
1100
& 1011
------
1000
结果不是 0,说明 12 不只一个 1,所以不是 2 的幂。
为什么还要写 x > 0?因为 0 不是 2 的幂。如果不加这个条件,0 & -1 也会得到 0,容易误判。
6. 获取最低有效位:lowbit
问题: 怎样找到一个数从右往左数,第一盏亮着的灯?
int lowbit(int x) {
return x & (-x);
}
lowbit(x) 返回的不是第几个位置,而是这一位对应的数值。
例如:
x = 12 = 1100
从右往左看:
位置: 3 2 1 0
x: 1 1 0 0
↑
最右边的 1 在第 2 位
第 2 位的价值是 4,所以:
lowbit(12) = 4
用补码计算就是:
12 的二进制: 0000 1100
-12(补码): 1111 0100
12 & (-12): 0000 0100 = 4
这在树状数组中很常见。你可以暂时先记住:lowbit(x) 能拿到 x 最右边那个 1 代表的值。
7. 清除最低有效位
问题: 怎样把最右边那个 1 删除掉?
int clear_lowest(int x) {
return x & (x - 1);
}
它和判断 2 的幂用的是同一个核心技巧。
假设:
x = 12 = 1100
x - 1 = 11 = 1011
计算:
1100
& 1011
------
1000 = 8
可以看到,x 最右边的那个 1 被清掉了。
再来一个例子:
x = 10 = 1010
x - 1 = 9 = 1001
1010
& 1001
------
1000 = 8
这件事有什么用?如果我们不断清除最低位的 1,就能统计一个数里面有多少个 1。
8. 统计二进制中 1 的个数:popcount
问题: 怎样知道一个整数的二进制里有几盏灯亮着?
C++ 提供了内置函数:
int count_ones(int x) {
return __builtin_popcount(x);
}
例如:
x = 13 = 1101
里面有三位是 1,所以:
count_ones(13) = 3
如果不用内置函数,也可以用刚才的 clear_lowest 思想手写:
int count_ones_manual(int x) {
int cnt = 0;
while (x) {
x &= x - 1;
cnt++;
}
return cnt;
}
以 x = 13 = 1101 为例:
第 1 次:1101 -> 1100,cnt = 1
第 2 次:1100 -> 1000,cnt = 2
第 3 次:1000 -> 0000,cnt = 3
循环结束时,说明所有 1 都被清掉了,所以原来一共有 3 个 1。
常用模板汇总
前面我们已经把每个函数都单独拆开讲过了。真正写题时,可以把下面这组函数当成工具箱:
// ===== 单个位的操作(第 k 位,从 0 开始计数)=====
// 检查第 k 位是否为 1
bool check(int x, int k) { return (x >> k) & 1; }
// 将第 k 位设为 1(置位)
int set_bit(int x, int k) { return x | (1 << k); }
// 将第 k 位设为 0(清位)
int clear_bit(int x, int k) { return x & ~(1 << k); }
// 翻转第 k 位(0→1,1→0)
int flip_bit(int x, int k) { return x ^ (1 << k); }
// ===== 常用技巧 =====
// 判断 x 是否为 2 的幂(且 x > 0)
bool is_power_of_two(int x) { return x > 0 && (x & (x - 1)) == 0; }
// 获取最低有效位(lowbit,树状数组核心)
int lowbit(int x) { return x & (-x); }
// 清除最低有效位
int clear_lowest(int x) { return x & (x - 1); }
// 统计 x 中 1 的个数(popcount)
int count_ones(int x) { return __builtin_popcount(x); } // 内置函数
// 或手动:
int count_ones_manual(int x) {
int cnt = 0;
while (x) { x &= x - 1; cnt++; } // 每次清除最低位的1
return cnt;
}
本节总结
| 函数 | 作用 | 核心想法 |
|---|---|---|
check(x, k) | 检查第 k 位 | 右移到最后,再 & 1 |
set_bit(x, k) | 把第 k 位设为 1 | 用 ` |
clear_bit(x, k) | 把第 k 位设为 0 | 用 & 配合反面具关掉开关 |
flip_bit(x, k) | 翻转第 k 位 | 用 ^ 让目标位反过来 |
is_power_of_two(x) | 判断是否是 2 的幂 | 2 的幂只有一个 1 |
lowbit(x) | 找最低有效位的值 | x & -x 保留最右边的 1 |
clear_lowest(x) | 清除最右边的 1 | x & (x - 1) |
count_ones(x) | 统计 1 的个数 | 内置函数或反复清最低位 |
2.6.4 用整数表示集合(状压)
当元素数量 N ≤ 30 时,可以用一个 int 整数的 N 个二进制位表示一个集合。
编码规则: 第 i 个元素在集合中 ↔ 第 i 位为 1。
把集合想象成签到表
如果有 5 个学生,编号为 0, 1, 2, 3, 4,我们可以用 5 个开关表示他们有没有被选中:
学生编号: 4 3 2 1 0
是否选中: 1 0 1 0 1
这表示选中了学生 {0, 2, 4}。写成二进制就是 10101,十进制是 21。
这样做的好处是:一个整数就能保存一个集合,而且加入、删除、检查元素都能用 O(1) 完成。
// 集合 {0, 2, 4} 表示为:
// 二进制:10101 = 21
int S = 0; // 空集
S = set_bit(S, 0); // 加入元素 0:S = 00001 = 1
S = set_bit(S, 2); // 加入元素 2:S = 00101 = 5
S = set_bit(S, 4); // 加入元素 4:S = 10101 = 21
// 检查元素 2 是否在集合中
bool has2 = check(S, 2); // true
// 删除元素 2
S = clear_bit(S, 2); // S = 10001 = 17
// 集合大小
int size = __builtin_popcount(S); // 2
集合运算
int A = 0b1100; // {2, 3}
int B = 0b1010; // {1, 3}
int inter = A & B; // 交集:0b1000 = {3}
int unio = A | B; // 并集:0b1110 = {1, 2, 3}
int diff = A & ~B; // 差集 A-B:0b0100 = {2}
int xor_s = A ^ B; // 对称差:0b0110 = {1, 2}
这些集合运算其实和数学里的集合完全对应:
| 数学集合操作 | 位运算写法 | 小学生理解 |
|---|---|---|
| 交集 | A & B | 两个集合都选中的人,才留下 |
| 并集 | `A | B` |
| 差集 | A & ~B | 在 A 里,但不在 B 里的人 |
| 对称差 | A ^ B | 只出现一次的人 |
例如 A = {2, 3},B = {1, 3}:
A 和 B 都有 3,所以交集是 {3}
A 或 B 出现过 1、2、3,所以并集是 {1,2,3}
A 有但 B 没有的是 2,所以 A-B 是 {2}
只出现一次的是 1 和 2,所以对称差是 {1,2}
2.6.5 枚举所有子集
N 个元素的集合有 2^N 个子集,可以用 for (int s = 0; s < (1 << n); s++) 枚举。
为什么是 2^N?因为每个元素只有两种选择:
不选这个元素 -> 0
选择这个元素 -> 1
如果有 3 个元素,每个元素都有选/不选两种状态,总数就是:
2 × 2 × 2 = 8
也就是 2^3 个子集。
先看 n = 3 的完整例子
| s | 二进制 | 表示的子集 |
|---|---|---|
| 0 | 000 | {} |
| 1 | 001 | {0} |
| 2 | 010 | {1} |
| 3 | 011 | {0,1} |
| 4 | 100 | {2} |
| 5 | 101 | {0,2} |
| 6 | 110 | {1,2} |
| 7 | 111 | {0,1,2} |
所以枚举整数 0 到 2^n - 1,其实就是枚举了所有开关组合,也就是所有子集。
// 枚举 n 个元素的所有子集
void enumerate_subsets(int n) {
for (int s = 0; s < (1 << n); s++) {
cout << "子集 " << s << "(二进制 " << bitset<4>(s) << "):{";
for (int i = 0; i < n; i++) {
if (check(s, i)) cout << i << " ";
}
cout << "}\n";
}
}
// enumerate_subsets(3) 输出 2^3 = 8 个子集
枚举某集合 S 的所有子集
有时我们不是枚举全集 {0,1,2,...,n-1} 的所有子集,而是枚举一个已经给定的集合 S 的所有子集。
例如:
S = 10110 = {1,2,4}
我们只想枚举由 {1,2,4} 组成的子集,不能出现元素 0 或 3。
// 枚举 S 的所有非空子集(时间:O(3^n),见下面说明)
for (int sub = S; sub > 0; sub = (sub - 1) & S) {
// 处理子集 sub
// ...
}
// 原理:sub = (sub - 1) & S 每次在 S 的范围内减 1,跳过不属于 S 的位
为什么 sub = (sub - 1) & S 不会跑出 S?
sub - 1 会让二进制发生变化,可能产生一些不属于 S 的 1。再 & S 一次,就像用 S 做过滤器:只有 S 里本来是 1 的位置才能保留下来。
以 S = 10110 为例,枚举过程大致是:
10110
10100
10010
10000
00110
00100
00010
每一步都只使用了 S 中允许的位。
2.6.6 实战例题:状压 + 位运算
前面我们学的是「工具」,这一节开始把工具放进题目里。做位运算题时,可以按照这个顺序思考:
- 每一位代表什么? 是一个元素、一个城市,还是一个开关?
- 1 表示什么,0 表示什么? 例如 1 表示已选择,0 表示未选择。
- 要做的操作对应哪个位运算? 加入用
|,删除用& ~,检查用&或右移。 - 状态数量有多少? 如果有
n个开关,通常会有2^n种状态。
例题:集合和问题
给定 N 个数字(N ≤ 20),找有多少个子集的和恰好等于目标值 target。
为什么可以暴力枚举?
N ≤ 20 时,一共有 2^20 = 1,048,576 个子集,大约一百万个。每个子集再扫一遍最多 20 个数,大约两千万次操作,C++ 通常可以接受。
状态设计:
s是一个二进制集合。s的第i位为 1,表示选择了a[i]。- 枚举所有
s,就等于枚举所有可能的选择方案。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, target;
cin >> n >> target;
vector<int> a(n);
for (int& x : a) cin >> x;
int ans = 0;
for (int s = 0; s < (1 << n); s++) {
int sum = 0;
for (int i = 0; i < n; i++)
if (check(s, i)) sum += a[i];
if (sum == target) ans++;
}
cout << ans << "\n";
}
// 复杂度:O(2^N × N),N=20 时约 2×10^7,可以通过
例题:旅行商问题(状压 DP 基础)
N 个城市(N ≤ 20),从城市 0 出发经过所有城市恰好一次回到 0,求最短路。
这个题比集合和更难,因为它不仅要记录「访问过哪些城市」,还要记录「现在停在哪个城市」。
状态设计:
dp[mask][v]
含义是:
mask表示已经访问过的城市集合。v表示当前所在城市。dp[mask][v]表示在这种情况下的最短距离。
例如 mask = 01011 表示已经访问过城市 {0,1,3};如果 v = 3,就表示当前停在城市 3。
转移思路:
如果当前在城市 u,下一步可以去一个还没访问过的城市 v。这时:
new_mask = mask | (1 << v);
意思是把城市 v 标记为「已经访问」。
#include <bits/stdc++.h>
using namespace std;
int n;
int dist[20][20];
int dp[1 << 20][20]; // dp[mask][v] = 访问了 mask 中的城市,当前在 v,的最短距离
int main() {
cin >> n;
for (int i = 0; i < n; i++)
for (int j = 0; j < n; j++)
cin >> dist[i][j];
// 初始化
for (auto& row : dp) fill(row, row + n, INT_MAX / 2);
dp[1][0] = 0; // 从城市 0 出发,mask=1(只访问了0)
// 枚举所有状态
for (int mask = 1; mask < (1 << n); mask++) {
for (int u = 0; u < n; u++) {
if (dp[mask][u] == INT_MAX / 2) continue;
if (!check(mask, u)) continue;
// 尝试移动到下一个未访问的城市 v
for (int v = 0; v < n; v++) {
if (check(mask, v)) continue; // 已访问
int new_mask = set_bit(mask, v);
dp[new_mask][v] = min(dp[new_mask][v], dp[mask][u] + dist[u][v]);
}
}
}
// 所有城市都访问后(mask = (1<<n)-1),回到城市 0
int ans = INT_MAX;
int full = (1 << n) - 1;
for (int u = 1; u < n; u++)
ans = min(ans, dp[full][u] + dist[u][0]);
cout << ans << "\n";
// 复杂度:O(2^N × N^2),N=20 时约 4×10^8(偏大,N=15~18 通常可行)
}
⚠️ 常见错误
| 错误 | 示例 | 修复方案 |
|---|---|---|
| 移位超过类型宽度 | 1 << 31 在 int 下溢出 | 用 1LL << 31(long long) |
| 运算符优先级混淆 | a & b == 0(先算==!) | 加括号:(a & b) == 0 |
| 状压数组开太大 | dp[1<<20] 占 4MB | 提前算好内存:2^20 × 4B = 4MB |
| 枚举子集死循环 | for(sub=S; sub>=0; ...) | 条件用 sub > 0,0 表示空集 |
| 忘记第 k 位从 0 开始数 | 把第 1 位当成最右边那位 | 最右边是第 0 位 |
~ 产生很多前导 1 | 直接打印 ~0 得到 -1 | 只在配合 &、掩码时使用 |
| 示例代码里忘记定义辅助函数 | 直接调用 check(s, i) | 完整程序中要写 ((s >> i) & 1) 或补上函数 |
💪 练习题
🟢 题目 1:奇偶统计
给定整数 x,输出它的二进制表示中 1 的个数(popcount),以及是否是 2 的幂。
数据规模: 1 ≤ x ≤ 10⁹。
#include <bits/stdc++.h>
using namespace std;
int main() {
int x; cin >> x;
cout << __builtin_popcount(x) << "\n";
cout << (x > 0 && (x & (x-1)) == 0 ? "是2的幂" : "不是2的幂") << "\n";
}
🟢 题目 2:位翻转
给定整数 x 和位置数组 k[],将 x 的这些位翻转后输出结果。
数据规模: 1 ≤ x < 2³¹,1 ≤ M ≤ 100,0 ≤ k[i] < 31。
#include <bits/stdc++.h>
using namespace std;
int main() {
int x, m; cin >> x >> m;
while (m--) {
int k; cin >> k;
x ^= (1 << k); // XOR 翻转第 k 位
}
cout << x << "\n";
}
🟡 题目 3:子集枚举
给定 N 个数字(N ≤ 20),找所有和为偶数的子集数量。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> a(n);
for (int& x : a) cin >> x;
int cnt = 0;
for (int s = 0; s < (1 << n); s++) {
int sum = 0;
for (int i = 0; i < n; i++)
if ((s >> i) & 1) sum += a[i];
if (sum % 2 == 0) cnt++;
}
cout << cnt << "\n";
// 答案总是 2^(n-1)(如果有奇数)
}
🔴 题目 4:最大异或子集
给定 N 个数字(N ≤ 20),选出一个非空子集,使子集内所有数字的异或和最大,输出该最大值。
思路: 枚举所有非空子集,对每个子集计算异或和取最大。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> a(n);
for (int& x : a) cin >> x;
int ans = 0;
for (int s = 1; s < (1 << n); s++) {
int xor_sum = 0;
for (int i = 0; i < n; i++)
if ((s >> i) & 1) xor_sum ^= a[i];
ans = max(ans, xor_sum);
}
cout << ans << "\n";
}
进阶(N 较大时): 用线性基(高斯消元)在 O(N × 30) 内找最大异或值。
🔴 题目 5:USACO Bronze 风格 — 奶牛体操(位运算版)
N 头奶牛(N ≤ 20),K 轮训练。每轮训练中,奶牛按排名从 1 到 N 排列。定义一对奶牛 (i, j) 是「一致的」,若在所有 K 轮中 i 都排在 j 前面。用位运算统计有多少对奶牛是一致的。
输入: 第一行 K N,接下来 K 行每行 N 个整数(1~N 的排列,表示该轮的排名顺序)。
样例输入:
3 4
4 1 2 3
4 1 3 2
4 2 1 3
样例输出: 4
核心思路: 对每头奶牛 i,用一个 N 位整数 before[i] 记录「在某一轮中,哪些奶牛排在 i 前面」。遍历每轮排名,对奶牛 i,排在 i 前面的所有奶牛 j 的第 j 位置 1。K 轮结束后,before[i] 逐位 AND 所有轮的结果——某位保持 1 说明那头奶牛在所有轮中都排在 i 前面。统计所有 before[i] 的 popcount 之和。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int K, N;
cin >> K >> N;
// before[i] 的第 j 位 = 奶牛 j 在所有已完成轮次中是否始终排在 i 前面
vector<int> before(N, (1 << N) - 1); // 初始全1,逐轮 AND
for (int round = 0; round < K; round++) {
// 读取排名:rank[0]=第1名的奶牛编号...
vector<int> ranking(N);
for (int p = 0; p < N; p++) cin >> ranking[p];
// mask 记录当前已出现的奶牛(排在前面)
int mask = 0;
for (int p = 0; p < N; p++) {
int cow = ranking[p] - 1; // 转 0-indexed
before[cow] &= mask; // AND 上当前排在前面的奶牛集合
mask |= (1 << cow); // 将当前奶牛加入已出现集合
}
}
int ans = 0;
for (int i = 0; i < N; i++)
ans += __builtin_popcount(before[i]);
cout << ans << "\n";
}
复杂度分析: 时间 O(K × N),空间 O(N)。每位用一个 int 做 K 次 AND 操作,非常高效。
💡 章节联系: 位运算是状压 DP(第 6.3 章进阶 DP)的基础工具,也用于树状数组的 lowbit 操作(第 5.7 章)。掌握本章后,你将能读懂绝大多数竞赛代码中的位运算技巧。
本章小结
- 位就是开关:每一位只有 0 和 1 两种状态。
1 << k是核心工具:它能制造一个只选中第k位的掩码。- 单个位操作有固定套路:检查、置位、清位、翻转分别对应不同位运算。
- 状压就是用整数存集合:第
i位为 1 表示第i个元素被选中。 - 枚举子集就是枚举开关组合:
0到(1 << n) - 1覆盖了所有选/不选方案。 - 不要只背代码:做题时先问"每一位代表什么",再选择合适的位运算。
📖 第 2.7 章:指针与内存
很多初学者觉得指针「玄学」「容易崩溃」「能不用就不用」。但真相是:指针是理解 C++ 如何使用内存的钥匙。一旦你建立起「变量住在内存里,每个住处都有门牌号」的图景,指针、引用、数组、动态内存、链表、树——这些后续会反复出现的概念——会突然变得清晰。
本章不要求你成为内存管理专家,而是帮你建立正确的心智模型,并掌握竞赛中真正会用到的指针技能。
2.7.0 从一道题出发:交换为什么没生效
先看一个让无数初学者深夜调试的小程序。它是一道题的雏形,也是一个 Bug:
🐛 题目:交换两头奶牛的位置 农夫 John 要交换奶牛 A 和奶牛 B 的栅栏编号。助手写了一个函数:
void swapPens(int a, int b) {
int tmp = a;
a = b;
b = tmp;
}
int main() {
int penA = 3, penB = 7;
swapPens(penA, penB);
// penA 和 penB 变了吗?
cout << penA << " " << penB << "\n"; // 输出:3 7 ← 什么都没变!
}
为什么会失败? 因为函数拿到的是 3 和 7 的复印件——swapPens 把复印件换来换去,原件纹丝不动。函数结束后复印件被销毁,世界毫无变化。
那怎么把「原件」交给函数?直觉上有两条路:
- 告诉函数原件的「门牌号」,让它直接去那个地址改数据——这就是指针:
swapPens(&penA, &penB),参数类型int* - 给原件起个本地名当别名——这就是引用:
swapPens(penA, penB),参数类型int&(第 2.3 章你已经用过)
这件小事背后是本章全部内容的主线——「数据住在哪里」和「怎么指到那里」:
拆解这道题需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 2.7.1 | 「门牌号」是什么?内存、地址与指针的图景;& 和 * |
| 2.7.2 | 指针可以「不指向任何东西」吗?——空指针与 nullptr |
| 2.7.3 | 指针和引用到底差在哪?分别什么时候用? |
| 2.7.4 | 数组名和指针是什么关系?为什么 arr[i] 等价 *(arr+i)? |
| 2.7.5 | 把「门牌号」传给函数——指针作参数 |
| 2.7.6 | 链表节点为什么必须用指针?——动态内存 new/delete |
| 2.7.7 | 杀手级应用:用指针搭链表与二叉树 |
| 2.7.8+ | const 保护、多级指针、char*、函数指针 |
💡 心智图景先立好:普通变量保存的是数据,指针变量保存的是另一个变量的地址。带着「复印件 vs 门牌号」的问题往下读。
学习目标(学完本章你将能够):
- 理解「内存」「地址」「指针」三者的关系,建立正确的心智图景
- 使用取地址运算符
&和解引用运算符* - 区分指针和引用,知道各自的适用场景
- 理解数组名与指针的关系,看懂指针算术
- 使用
new/delete进行动态内存分配,并理解什么是内存泄漏 - 用指针搭建最基础的链表和二叉树节点
- 知道竞赛中何时该用指针、何时不该用
- 理解多级指针(
int**)的概念,看懂动态二维数组和「指针的指针」 - 使用指针操作 C 风格字符串(
char*),手动实现strlen/strcpy - 了解函数指针的基本语法,看懂回调与自定义排序的底层机制
2.7.1 内存、地址与指针:先建立图景
🏨 旅馆类比
想象计算机内存是一栋有很多房间的旅馆:

- 每个房间就是一个字节(或一组字节)的存储空间
- 每个房间都有一个门牌号——这就是内存地址
- 当你写
int x = 42;,编译器给变量x分配了一个房间(比如门牌号 1000),里面放着 42 - 指针就是一张写着「门牌号」的便条。它本身不是房间里的数据,而是「某个房间在哪里」的信息
💡 核心一句话: 普通变量保存的是数据,指针变量保存的是另一个变量的地址。
取地址 & 与解引用 *
C++ 提供两个互为反操作的运算符:
| 运算符 | 名字 | 作用 | 读法 |
|---|---|---|---|
&x | 取地址 | 得到变量 x 的内存地址 | 「x 的地址」 |
*p | 解引用 | 访问指针 p 指向的那个变量 | 「p 指向的东西」 |
#include <bits/stdc++.h>
using namespace std;
int main() {
int x = 42;
int* p = &x; // p 保存 x 的地址(p「指向」x)
cout << x << "\n"; // 42 —— x 里的数据
cout << &x << "\n"; // 0x... —— x 的地址(每次运行可能不同)
cout << p << "\n"; // 0x... —— 和 &x 相同,p 保存的就是这个地址
cout << *p << "\n"; // 42 —— 解引用:顺着地址找到 x,读出 42
*p = 100; // 通过指针修改 x(顺着门牌号去改房间内容)
cout << x << "\n"; // 100 —— x 真的被改了!
return 0;
}
🤔
int* p中的*和*p中的*是一回事吗? 不是!这是初学者最大的困惑来源:
- 在声明里,
int* p的*表示「p 是一个指向 int 的指针」(类型的一部分)- 在使用里,
*p的*是解引用运算符,表示「取出 p 指向的值」 同一个符号,两种含义,靠上下文区分。
图示:指针指向变量

🎬 互动:一步步看懂 & 与 *
下面这个可视化把「取地址 → 解引用读 → 解引用写」拆成 5 步。点击「下一步」,盯着内存房间和指针箭头,亲眼看到 *p = 100 是如何穿过指针真正改到 x 的:
2.7.2 空指针与 nullptr
一个指针如果还没指向任何有效对象,应该让它指向「空」。现代 C++ 用 nullptr 表示空指针:
int* p = nullptr; // p 不指向任何东西
if (p == nullptr) {
cout << "p 是空指针,不能解引用\n";
}
// *p; // ❌ 危险!解引用空指针 → 程序崩溃(段错误)
⚠️ 不要用旧写法
NULL或0。 老代码常写int* p = NULL;,但NULL本质是0,在重载/模板场景会引起歧义。现代 C++ 一律用nullptr,类型安全且语义清晰。
🐛 头号崩溃原因: 解引用空指针或「野指针」(指向无效地址的指针)。这是
Segmentation fault(段错误)最常见的来源。永远在解引用前确认指针有效。
🧩 辨析:& 和 * 各有两副面孔
& 和 * 都是「一符多义」,靠上下文区分。初学者把它们彻底分清,指针就懂了一半:
| 符号 | 场景 | 含义 | 例子 |
|---|---|---|---|
& | 变量前(一元) | 取地址 | int* p = &x; |
& | 类型后(声明) | 引用(别名,见第 2.3 章) | int& r = x; |
& | 两数之间(二元) | 按位与(见第 2.6 章) | a & b |
* | 类型后(声明) | 「这是个指针」 | int* p; |
* | 指针前(一元) | 解引用取值 | *p = 100; |
* | 两数之间(二元) | 乘法 | a * b |
💡 一句话记忆:贴着变量/指针单独出现 → 取地址 / 解引用;夹在两个数中间 → 位与 / 乘法;跟在类型后面 → 引用 / 指针声明。
2.7.3 指针 vs 引用:到底用哪个?
第 2.3 章你已经学过引用(int& r = x;)。引用和指针都能「间接访问」另一个变量,但它们有重要区别。
int x = 10, y = 20;
// ---- 引用 ----
int& r = x; // r 是 x 的别名,必须在声明时绑定
r = 100; // 直接改 x,x == 100
// r = y; // 这不是「让 r 指向 y」,而是把 y 的值赋给 x!
// 引用一旦绑定,终生不能改绑
// ---- 指针 ----
int* p = &x; // p 指向 x
*p = 100; // 改 x,x == 100
p = &y; // OK!指针可以改指向 y
*p = 200; // 现在改的是 y,y == 200
p = nullptr; // 指针可以为空
对比表
| 特性 | 引用 int& | 指针 int* |
|---|---|---|
| 是否必须初始化 | 必须(声明即绑定) | 可以先不初始化(但危险) |
| 能否改变指向 | 不能(终生绑定一个变量) | 能(随时改指向别处) |
| 能否为空 | 不能 | 能(nullptr) |
| 语法 | 直接当变量用 r | 需要解引用 *p |
| 安全性 | 更安全,不易出错 | 更灵活,但更易出错 |
⚡ 竞赛中的经验法则:
- 优先用引用。 函数传参、避免复制大对象,引用更安全、语法更干净(见第 2.3 章的
const vector<int>&)。- 需要指针的少数场景: ① 指向的目标需要变化(如遍历链表);② 需要表示「没有目标」的状态(
nullptr,如树的空子节点);③ 动态分配内存(new)。
2.7.4 指针与数组:它们是亲戚
C++ 中数组和指针关系密切。数组名在大多数场景会「退化」成指向首元素的指针。
#include <bits/stdc++.h>
using namespace std;
int main() {
int arr[5] = {10, 20, 30, 40, 50};
int* p = arr; // 等价于 int* p = &arr[0]; 数组名退化为首元素指针
cout << *p << "\n"; // 10 —— arr[0]
cout << *(p+1) << "\n"; // 20 —— arr[1]
cout << *(p+2) << "\n"; // 30 —— arr[2]
// 下面四种写法完全等价:
cout << arr[2] << "\n"; // 30
cout << *(arr+2) << "\n"; // 30
cout << p[2] << "\n"; // 30
cout << *(p+2) << "\n"; // 30
return 0;
}
🤔 为什么
arr[i]等价于*(arr + i)? 因为下标运算arr[i]的本质就是「从首地址arr偏移i个元素,再解引用」。这也解释了为什么数组下标从 0 开始——下标就是「偏移量」,第一个元素偏移 0。
指针算术
指针 +1 不是地址 +1 字节,而是前进一个元素的大小:
int arr[5] = {10, 20, 30, 40, 50};
int* p = arr;
// 假设 int 占 4 字节,arr 起始地址 1000:
// p 指向 1000(arr[0])
// p+1 指向 1004(arr[1])—— 自动跳过一个 int 的 4 字节
// p+2 指向 1008(arr[2])
int arr[5] = {10, 20, 30, 40, 50};
// 方式一:传统下标
for (int i = 0; i < 5; i++) cout << arr[i] << " ";
cout << "\n";
// 方式二:指针遍历(理解即可,竞赛中很少这么写)
for (int* p = arr; p < arr + 5; p++) {
cout << *p << " ";
}
cout << "\n";
⚡ 竞赛提示: STL 的
sort(arr, arr + n)、lower_bound(arr, arr + n, x)中的arr和arr + n正是「首元素指针」和「尾后指针」。理解了数组退化为指针,就理解了这些函数的参数为什么这么写。
2.7.5 指针作函数参数
第 2.3 章我们用引用实现了「函数修改原变量」。其实用指针也能做到——这是 C 语言的经典写法,在很多底层代码、链表/树操作中仍然常见。
#include <bits/stdc++.h>
using namespace std;
// 用指针:传入地址,函数内通过解引用修改原变量
void swapByPointer(int* a, int* b) {
int tmp = *a;
*a = *b;
*b = tmp;
}
// 用引用:更简洁(推荐)
void swapByRef(int& a, int& b) {
int tmp = a;
a = b;
b = tmp;
}
int main() {
int x = 1, y = 2;
swapByPointer(&x, &y); // 必须显式传地址 &x, &y
cout << x << " " << y << "\n"; // 2 1
swapByRef(x, y); // 直接传变量
cout << x << " " << y << "\n"; // 1 2
return 0;
}
💡 两者怎么选? 在 C++ 中,能用引用就用引用(语法干净、不会传空)。需要用指针的典型情况:参数本身可能是
nullptr(「可选」语义),或者你在写链表/树这类天生用指针表达的结构。
2.7.6 动态内存:new 与 delete
到目前为止,我们的数组大小要么编译时确定,要么用 vector。还有第三种方式:在运行时手动向系统申请内存,这叫动态内存分配。
栈内存 vs 堆内存

#include <bits/stdc++.h>
using namespace std;
int main() {
// 动态分配单个 int
int* p = new int; // 在堆上申请一个 int
*p = 42;
cout << *p << "\n"; // 42
delete p; // 用完必须释放!否则内存泄漏
// 动态分配数组(运行时才知道大小)
int n;
cin >> n;
int* arr = new int[n]; // 堆上申请 n 个 int
for (int i = 0; i < n; i++) arr[i] = i * i;
for (int i = 0; i < n; i++) cout << arr[i] << " ";
cout << "\n";
delete[] arr; // 释放数组要用 delete[](带方括号)!
return 0;
}
⚠️ 三条铁律
new配delete,new[]配delete[]。 申请数组用new[],就必须用delete[]释放,否则行为未定义。- 每个
new都要有对应的delete。 否则就是内存泄漏——申请的内存永远还不回去。 delete之后不要再用那个指针(变成「悬空指针」),可以delete后立刻p = nullptr;。
🤔 竞赛里到底用不用
new/delete? 绝大多数情况:不用! 竞赛中程序运行完就退出,操作系统会回收所有内存,所以「内存泄漏」通常无害;而且new/delete写起来啰嗦、容易出错。
- 需要动态数组?→ 用
vector(自动管理内存,见第 2.3 章)- 需要动态字符串?→ 用
string真正会手写new的,主要是链表、二叉树这类需要逐个创建节点的结构(见下一节)——而即便如此,很多选手也用数组模拟或静态节点池来避免new(见第 5.5、5.7 章)。
2.7.7 指针的杀手级应用:链表与树节点
指针真正不可替代的地方,是构建节点之间互相连接的数据结构。最经典的就是链表和树。本节先把链表讲扎实:它为什么存在、和数组有什么不同、怎样遍历、插入、删除,再过渡到树节点。
数组存储 vs 链表存储
数组和链表都能表示「一串元素」,但它们在内存里的组织方式完全不同:
- 数组:元素挨在一起,存放在一段连续内存中。
- 链表:每个元素是一个节点,节点可以分散在内存各处;节点里额外存一个指针,告诉我们「下一个节点在哪里」。


| 对比维度 | 数组 / vector | 单链表 |
|---|---|---|
| 内存布局 | 连续存储,像一排相邻房间 | 分散存储,靠指针串起来 |
访问第 i 个元素 | O(1),直接 a[i] | O(i),必须从头一路走过去 |
| 在中间插入/删除 | 通常 O(N),后面元素要整体移动 | 已知前驱节点时 O(1) 改指针即可 |
| 额外空间 | 只存数据 | 每个节点还要多存一个 next 指针 |
| 缓存友好性 | 好,连续访问很快 | 差,节点分散,访问可能跳来跳去 |
| 竞赛常用度 | 极高,绝大多数情况优先用 | 理解链式结构、面试题、数组模拟链表时重要 |
💡 一句话选择: 需要频繁随机访问 → 用数组 /
vector;需要频繁在已知位置插入、删除 → 链表更合适。但在竞赛中,真正手写指针链表并不多,更多是用数组模拟链表。
单链表节点:数据 + 指向下一个节点的指针
每个链表节点通常由两部分组成:
struct Node {
int data; // 当前节点保存的数据
Node* next; // 指向下一个节点;最后一个节点的 next 为 nullptr
};
链表只需要保存一个头指针 head,它指向第一个节点。之后顺着 next 一直走,就能访问整条链:
Node* head = new Node{1, nullptr};
head->next = new Node{2, nullptr};
head->next->next = new Node{3, nullptr};
// head -> 1 -> 2 -> 3 -> nullptr
🤔
cur->data是什么语法?cur是指针,cur->data等价于(*cur).data,意思是「先顺着指针找到节点,再取它的data成员」。->是「指针访问成员」的专用运算符,比(*cur).data好写。这个语法在链表、树里随处可见。
链表基础操作一:遍历、计数、查找
链表没有下标,不能直接跳到第 i 个元素。它的所有操作都建立在同一个动作上:从 head 出发,沿着 next 一个一个走。

#include <bits/stdc++.h>
using namespace std;
struct Node {
int data;
Node* next;
};
void printList(Node* head) {
for (Node* cur = head; cur != nullptr; cur = cur->next) {
cout << cur->data << " ";
}
cout << "\n";
}
int length(Node* head) {
int cnt = 0;
for (Node* cur = head; cur != nullptr; cur = cur->next) {
cnt++;
}
return cnt;
}
Node* findValue(Node* head, int target) {
for (Node* cur = head; cur != nullptr; cur = cur->next) {
if (cur->data == target) return cur;
}
return nullptr;
}
int main() {
Node* head = new Node{1, nullptr};
head->next = new Node{2, nullptr};
head->next->next = new Node{3, nullptr};
printList(head); // 1 2 3
cout << length(head) << "\n"; // 3
cout << (findValue(head, 2) != nullptr) << "\n"; // 1
return 0;
}
⚠️ 链表遍历的核心条件:
cur != nullptr。一旦cur是空指针,就不能再写cur->data或cur->next,否则会崩溃。
链表基础操作二:插入节点
链表插入的本质是改指针。不要想成「把一排元素往后挪」,链表里没有整体搬移,只有箭头重连。
头插法:插到链表最前面
如果新节点要成为新的第一个节点,只需要让它指向旧头,再更新 head:

void pushFront(Node*& head, int x) {
Node* node = new Node{x, head}; // 新节点指向旧 head
head = node; // head 改为新节点
}
这里参数写成 Node*& head,意思是「head 指针的引用」。因为函数内部不仅要改节点内容,还要修改外部的 head 本身。
尾插法:插到链表最后面
如果只有 head,每次尾插都要从头走到尾,单次 O(N)。所以实际常维护一个 tail 指针,直接指向最后一个节点:

void pushBack(Node*& head, Node*& tail, int x) {
Node* node = new Node{x, nullptr};
if (head == nullptr) { // 空链表:新节点既是头也是尾
head = tail = node;
} else {
tail->next = node; // 旧尾巴指向新节点
tail = node; // 更新尾指针
}
}
插到某个节点后面
已知节点 pos,把新节点插到它后面,只需要两步:

void insertAfter(Node* pos, int x) {
if (pos == nullptr) return;
Node* node = new Node{x, pos->next}; // 新节点先接住 pos 原来的后继
pos->next = node; // pos 再指向新节点
}
⚠️ 顺序不能反: 必须先让新节点接住
pos->next,再改pos->next。如果先写pos->next = node,原来的后半段链表就丢了。
#include <bits/stdc++.h>
using namespace std;
struct Node {
int data;
Node* next;
};
void pushFront(Node*& head, int x) {
head = new Node{x, head};
}
void pushBack(Node*& head, Node*& tail, int x) {
Node* node = new Node{x, nullptr};
if (head == nullptr) {
head = tail = node;
} else {
tail->next = node;
tail = node;
}
}
void insertAfter(Node* pos, int x) {
if (pos == nullptr) return;
pos->next = new Node{x, pos->next};
}
void printList(Node* head) {
for (Node* cur = head; cur != nullptr; cur = cur->next) {
cout << cur->data << " ";
}
cout << "\n";
}
int main() {
Node* head = nullptr;
Node* tail = nullptr;
pushBack(head, tail, 1); // 1
pushBack(head, tail, 3); // 1 -> 3
insertAfter(head, 2); // 1 -> 2 -> 3
pushFront(head, 0); // 0 -> 1 -> 2 -> 3
printList(head);
return 0;
}
链表基础操作三:删除节点
单链表删除节点也靠改指针,但有一个限制:要删除某个节点,通常需要知道它的前驱节点。因为前驱节点的 next 要绕过被删除节点,指向后面的节点。
删除头节点
头节点没有前驱,所以要单独处理,并且要修改 head 本身:
void popFront(Node*& head) {
if (head == nullptr) return;
Node* old = head;
head = head->next;
delete old;
}
删除某个节点后面的节点
已知 pos,删除 pos 后面的节点:

void eraseAfter(Node* pos) {
if (pos == nullptr || pos->next == nullptr) return;
Node* victim = pos->next;
pos->next = victim->next; // 绕过 victim
delete victim; // 释放被删除节点
}
按值删除第一个出现的节点
按值删除时,我们不知道前驱是谁,所以要一边遍历一边维护 prev 和 cur:

bool eraseValue(Node*& head, int target) {
if (head == nullptr) return false;
if (head->data == target) {
popFront(head);
return true;
}
Node* prev = head;
Node* cur = head->next;
while (cur != nullptr) {
if (cur->data == target) {
prev->next = cur->next;
delete cur;
return true;
}
prev = cur;
cur = cur->next;
}
return false;
}
#include <bits/stdc++.h>
using namespace std;
struct Node {
int data;
Node* next;
};
void pushBack(Node*& head, Node*& tail, int x) {
Node* node = new Node{x, nullptr};
if (head == nullptr) {
head = tail = node;
} else {
tail->next = node;
tail = node;
}
}
void popFront(Node*& head) {
if (head == nullptr) return;
Node* old = head;
head = head->next;
delete old;
}
bool eraseValue(Node*& head, int target) {
if (head == nullptr) return false;
if (head->data == target) {
popFront(head);
return true;
}
Node* prev = head;
Node* cur = head->next;
while (cur != nullptr) {
if (cur->data == target) {
prev->next = cur->next;
delete cur;
return true;
}
prev = cur;
cur = cur->next;
}
return false;
}
void printList(Node* head) {
for (Node* cur = head; cur != nullptr; cur = cur->next) {
cout << cur->data << " ";
}
cout << "\n";
}
void clearList(Node*& head) {
while (head != nullptr) {
popFront(head);
}
}
int main() {
Node* head = nullptr;
Node* tail = nullptr;
for (int x : {1, 2, 3, 4}) pushBack(head, tail, x);
printList(head); // 1 2 3 4
eraseValue(head, 3);
printList(head); // 1 2 4
popFront(head);
printList(head); // 2 4
clearList(head);
return 0;
}
⚠️ 关于
tail的细节: 上面的删除示例为了突出核心逻辑,只维护了head。如果你的程序还保存tail,删除尾节点时必须同步更新tail,否则tail会变成悬空指针。实际写题时,要么不维护tail,要么把删除函数也设计成能更新tail。
链表基础操作复杂度

| 操作 | 单链表复杂度 | 说明 |
|---|---|---|
| 遍历整条链 | O(N) | 必须从头走到尾 |
| 查找某个值 | O(N) | 不能二分,不能随机跳转 |
访问第 i 个节点 | O(i) | 从 head 走 i 步 |
| 头部插入 / 删除 | O(1) | 改 head 即可 |
| 已知节点后插入 | O(1) | 改两条指针 |
| 已知前驱时删除后继 | O(1) | 改一条指针并 delete |
| 只知道值时删除 | O(N) | 先找前驱,再删除 |
链表最容易写错的地方
- 忘记处理空链表:
head == nullptr时不能访问head->next。 - 忘记更新
head: 删除或插入到头部时,head本身会变。 - 改指针顺序错误: 插入时先保存旧后继,再重连;反转链表时先保存
next,再改cur->next。 - 删除后继续使用旧指针:
delete victim;之后victim就不能再解引用。 - 维护
tail时不同步: 删除尾节点、清空链表时,要让tail指向新的尾或nullptr。
二叉树节点
树是链表思想的自然延伸——每个节点不止一个「下一个」,而是有左右两个孩子指针:
struct TreeNode {
int val;
TreeNode* left; // 左孩子(没有则为 nullptr)
TreeNode* right; // 右孩子(没有则为 nullptr)
};
// 创建一个节点
TreeNode* root = new TreeNode{1, nullptr, nullptr};
root->left = new TreeNode{2, nullptr, nullptr};
root->right = new TreeNode{3, nullptr, nullptr};
// 1
// / \
// 2 3
🔗 承上启下: 链表和树的完整算法(遍历、插入、删除、BST、平衡)会在 第 5.5 章(二叉树与树算法) 详细展开。本章你要掌握的是「指针如何把节点串起来」以及「插入 / 删除本质上就是重连指针」。
🆚 指针版 vs 数组模拟版(竞赛重点)
竞赛选手往往不用 new,而是用数组下标当「指针」——这叫数组模拟(静态分配 / 节点池)。提前建立这个对照,到第 5.5/5.7 章就不会陌生:

| 维度 | 指针版 | 数组模拟版 |
|---|---|---|
| 节点定义 | struct Node{int v; Node* nxt;}; | int val[N], nxt[N]; |
| 「指向」 | 真正的指针 Node* | 数组下标(int,如 nxt[i] 存下一个下标) |
| 空指针 | nullptr | 约定一个特殊值,如 -1 或 0 |
| 新建节点 | new Node{...}(堆分配,慢) | ++cnt 取下一个空槽(无分配开销) |
| 插入 / 删除 | 改 Node* 指针 | 改 nxt[i] 下标 |
| 释放 | delete(易漏 → 泄漏) | 不用释放,整体复用数组 |
| 速度/安全 | 较慢、易写错 | 更快、更稳,竞赛主流 |
// ---- 指针版 ----
struct Node { int v; Node* nxt; };
Node* head = new Node{1, nullptr};
head->nxt = new Node{2, nullptr};
// ---- 数组模拟版(竞赛常用)----
const int N = 100005;
int val[N], nxt[N], cnt = 0; // 下标 0 留作「空」,真实节点从 1 开始
int head = 0; // 0 表示空链表
int newNode(int v) { // 「new」一个节点 → 返回下标
++cnt;
val[cnt] = v;
nxt[cnt] = 0;
return cnt;
}
void insertAfter(int pos, int id) {
nxt[id] = nxt[pos];
nxt[pos] = id;
}
// 建立 1 -> 2
head = newNode(1);
insertAfter(head, newNode(2));
// 遍历:用下标代替指针,0 代替 nullptr
for (int i = head; i != 0; i = nxt[i]) cout << val[i] << " ";
📌 拓展(了解即可): 工程开发中常用智能指针
unique_ptr/shared_ptr自动管理内存(离开作用域自动delete,杜绝泄漏)。但竞赛中几乎不用——它们有额外开销,且竞赛程序结束即回收内存。知道有这回事即可,竞赛里继续用裸指针或数组模拟。
2.7.8 const 与指针:只读保护
const 和指针结合时位置不同,含义不同。这是面试和阅读源码的高频考点:
int x = 10, y = 20;
const int* p1 = &x; // 指向 const:不能通过 p1 改值,但能改 p1 指向
// *p1 = 99; ❌ 不能改值
p1 = &y; // ✓ 能改指向
int* const p2 = &x; // const 指针:能改值,但不能改指向
*p2 = 99; // ✓ 能改值
// p2 = &y; ❌ 不能改指向
const int* const p3 = &x; // 都不能改
💡 读法口诀: 从右往左读。
const int* p读作「p 是指针,指向 const int」;int* const p读作「p 是 const 指针,指向 int」。看const离谁近就管谁。
2.7.9 多级指针:指向指针的指针
指针本身也是变量,也住在内存的某个房间里。所以——指针也有地址。指向「指针」的指针,就是多级指针,最常见的是二级指针 int**。
为什么需要指向指针的指针?
三个经典场景:
- 在函数内修改指针本身(比如让一个
int*参数指向新分配的内存) - 动态二维数组(
int**指向一组int*,每个int*再指向一行) - 命令行参数
argv(main的第二个参数就是char**)
#include <bits/stdc++.h>
using namespace std;
// 想让函数修改外部指针的指向?传二级指针!
void allocate(int** pp, int n) {
*pp = new int[n]; // 通过解引用二级指针,修改外部指针
}
int main() {
int* arr = nullptr;
allocate(&arr, 5); // 传 arr 的地址(int**)
for (int i = 0; i < 5; i++) arr[i] = i * i;
for (int i = 0; i < 5; i++) cout << arr[i] << " ";
cout << "\n";
delete[] arr;
return 0;
}
💡 也可以用指针的引用(
int*&)达到同样效果,语法更干净:void allocate(int*& p, int n) { p = new int[n]; }但二级指针是更底层的理解,也是阅读底层代码和旧代码时的常见写法。
动态二维数组
当行数和列数都在运行时才能确定时,可以用 int** 构建二维数组:
#include <bits/stdc++.h>
using namespace std;
int main() {
int n = 3, m = 4;
// 分配 n 个 int*(每行的指针)
int** mat = new int*[n];
for (int i = 0; i < n; i++) {
mat[i] = new int[m]; // 每行分配 m 个 int
}
// 赋值
for (int i = 0; i < n; i++)
for (int j = 0; j < m; j++)
mat[i][j] = i * m + j;
// 打印
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++)
cout << setw(3) << mat[i][j];
cout << "\n";
}
// 释放:先释放每一行,再释放行指针数组
for (int i = 0; i < n; i++) delete[] mat[i];
delete[] mat;
return 0;
}
⚡ 竞赛提示: 上面这种
int**二维数组在竞赛中几乎不用——它要多次new,内存不连续(缓存不友好),释放也麻烦。竞赛中的动态二维数组一律用vector<vector<int>>(见第 2.3 章),既安全又简洁。这里展示二级指针主要是帮你建立起「指针的指针」的图景,读到底层代码或旧代码时能看得懂。
图解:二级指针的层级关系

📌 总结一句话:
int x→int* p = &x(一级指针,指向变量)→int** pp = &p(二级指针,指向指针)。每一级解引用*就沿着箭头往前走一层:*pp得到p,**pp得到x。
2.7.10 指针与C风格字符串
在 C++ 诞生之前,C 语言用以 \0(空字符)结尾的字符数组来表示字符串。这种「C风格字符串」的类型是 char* 或 const char*。虽然现代 C++ 中 std::string 是绝对主流,但理解 char* 对阅读底层代码、竞赛模板、以及深化指针理解都很有帮助。
字符串字面量
const char* s = "hello"; // s 指向字符串字面量 "hello\0"
// s[0] = 'H'; ❌ 字符串字面量存在只读区,修改是未定义行为!
⚠️ 字符串字面量
"hello"的类型是const char[6](包含末尾的\0),存储在只读内存区。所以必须用const char*来指向它。老代码可能写char* s = "hello";,这在现代 C++ 中是不推荐的(甚至可能编译不过)。
用指针遍历C风格字符串
C风格字符串以 \0 结尾,所以遍历时不需要知道长度:
#include <bits/stdc++.h>
using namespace std;
// 自己实现 strlen:数到 '\0' 为止
int myStrlen(const char* s) {
int len = 0;
while (*s != '\0') { // 等价于 while (*s)
len++;
s++; // 指针前进到下一个字符
}
return len;
}
// 自己实现 strcpy:把 src 复制到 dst
void myStrcpy(char* dst, const char* src) {
while (*src != '\0') {
*dst = *src; // 逐字符复制
dst++;
src++;
}
*dst = '\0'; // 别忘了末尾的 '\0'!
}
// 更「指针味」的写法——一行搞定:
void myStrcpyV2(char* dst, const char* src) {
while ((*dst++ = *src++)); // 赋值 + 判断 + 指针前进,一体完成
}
int main() {
const char* s = "hello";
cout << myStrlen(s) << "\n"; // 5
char buf[100];
myStrcpy(buf, s);
cout << buf << "\n"; // hello
return 0;
}
💡 上面「一行搞定」的写法
while ((*dst++ = *src++));是经典 C 语言风格的指针练习。它把 赋值、指针前进、判断 压缩成一行,浓缩了指针操作的精华。如果你是初学者,建议先用分步写法理解清楚,再回来看这一行——你会发现指针没那么玄了。
C风格字符串 vs std::string
| 特性 | char* / char[] | std::string |
|---|---|---|
| 结尾标记 | \0(手动维护) | 自动管理 |
| 获取长度 | strlen(s) O(n) | s.length() O(1) |
| 拼接 | strcat(手动,危险) | s1 + s2(安全) |
| 内存管理 | 手动 | 自动 |
| 何时使用 | 阅读旧代码、底层接口、argv | 竞赛中 99% 的场景 |
⚡ 竞赛铁律:优先用
std::string。 只在main(int argc, char* argv[])的命令行参数、或调用某些 C 库函数时才会接触到char*。本节的目的不是让你回去用 C 风格字符串,而是让你看到时能读懂。
2.7.11 函数指针入门
C++ 中函数也有地址。函数指针就是指向函数的指针——可以像传递数据一样传递「要执行什么操作」。这是回调机制(callback)的基石。
基本语法
函数指针的声明语法有点特别,需要把 * 和函数名用括号括起来:
// 一个函数:输入两个 int,返回 bool
bool cmp(int a, int b) { return a > b; }
// 对应的函数指针类型:bool (*)(int, int)
bool (*fp)(int, int) = cmp; // fp 指向 cmp
// ↑ ↑ ↑
// 返回值 指针名(括号必须) 参数类型列表
// 调用函数指针:两种写法等价
cout << fp(3, 5) << "\n"; // false(3 > 5)
cout << (*fp)(3, 5) << "\n"; // false(同上,更明确)
竞赛中的典型应用:自定义排序
std::sort 的第三个参数就是一个函数指针(或函数对象):
#include <bits/stdc++.h>
using namespace std;
bool cmpAbs(int a, int b) {
return abs(a) < abs(b); // 按绝对值升序
}
int main() {
vector<int> a = {-5, 3, -1, 4, -2};
sort(a.begin(), a.end(), cmpAbs); // cmpAbs 作为函数指针传入
for (int x : a) cout << x << " "; // -1 -2 3 4 -5
cout << "\n";
return 0;
}
💡 C++ 中更推荐用 lambda 表达式 或 函数对象(functor) 代替裸函数指针,因为类型更安全、编译器更容易内联优化。但函数指针是理解这些高级特性的基础——lambda 本质上是语法糖,底层仍是函数指针或函数对象。
函数指针数组
当需要在多个操作之间动态选择时,函数指针数组非常有用:
int add(int a, int b) { return a + b; }
int sub(int a, int b) { return a - b; }
int mul(int a, int b) { return a * b; }
int (*ops[3])(int, int) = {add, sub, mul}; // 函数指针数组
int op; cin >> op;
cout << ops[op](10, 5) << "\n"; // 动态选择操作
⚡ 竞赛提示: 函数指针在竞赛中不常用(往往被 lambda、
std::function或直接重载替代),但它是理解回调、事件驱动、以及qsort等 C 标准库函数的必备知识。了解即可,不必深入研究。
⚠️ 第 2.7 章常见错误
| # | 错误 | 示例 | 错在哪里 | 修复方法 |
|---|---|---|---|---|
| 1 | 解引用空指针/野指针 | int* p; *p = 5; | p 未初始化,指向随机地址 → 段错误 | 先让 p 指向有效对象,或初始化为 nullptr 并判空 |
| 2 | new[] 用 delete 释放 | int* a = new int[n]; delete a; | 数组必须用 delete[],否则未定义行为 | 改成 delete[] a; |
| 3 | 内存泄漏 | 只 new 不 delete | 申请的堆内存永不归还 | 每个 new 配一个 delete;竞赛中优先用 vector |
| 4 | 悬空指针 | delete p; cout << *p; | delete 后内存已释放,p 指向无效区域 | delete p; 后立刻 p = nullptr; |
| 5 | 混淆声明的 * 和解引用的 * | int *p = *x; | 想取地址却写成解引用 | 取地址用 &x:int* p = &x; |
| 6 | 返回局部变量的地址 | int* f(){ int t=5; return &t; } | 函数返回后 t 已销毁,地址失效 | 返回值本身,或用 new/引用传出 |
| 7 | 引用未初始化 | int& r; | 引用必须在声明时绑定 | 声明时即 int& r = x; |
本章总结
📌 核心要点
| 概念 | 要点 | 为什么重要 |
|---|---|---|
| 地址 | 每个变量在内存中都有一个门牌号 | 指针的根基 |
指针 int* p | 保存的是「另一个变量的地址」 | 间接访问、动态结构的基础 |
&x 取地址 | 得到变量 x 的地址 | 给指针赋值、按指针传参 |
*p 解引用 | 顺着地址访问指向的变量 | 读写指针指向的数据 |
nullptr | 表示「不指向任何东西」 | 表示空状态、判空保护 |
| 引用 vs 指针 | 引用安全、不可改绑;指针灵活、可空可改绑 | 竞赛优先用引用 |
| 数组退化 | 数组名 ≈ 首元素指针;arr[i] == *(arr+i) | 理解 STL 区间参数 (arr, arr+n) |
new / delete | 堆上手动分配/释放内存 | 链表/树建节点;普通数组优先用 vector |
-> 运算符 | p->data 等价 (*p).data | 链表、树操作的标配语法 |
多级指针 int** | 指向指针的指针,用于修改指针本身或动态二维数组 | 理解底层代码、argv、动态二维数组 |
C 风格字符串 char* | 以 \0 结尾的字符数组,指针可遍历和操作 | 阅读旧代码和底层接口、理解 string 底层 |
| 函数指针 | 指向函数的指针,可像数据一样传递「操作」 | 理解回调、sort 自定义比较、qsort |
❓ 常见问题
Q1:指针这么危险,竞赛里还有必要学吗?
A:有,但要分清主次。90% 的题目你用
vector、string、引用就够了,根本不用裸指针。 但当你做到链表、二叉树、图的链式前向星,或者读别人的模板代码时,不懂指针就寸步难行。本章的目标是让你「看得懂、用得对」,而不是处处手写new。
Q2:引用和指针,到底优先用哪个?
A:优先引用。 函数传参避免复制 → 用
const T&;要修改原变量 → 用T&。只有在「目标会变化」(遍历链表)、「可能没有目标」(树的空孩子nullptr)、「动态分配」(new)这三种情况下才需要指针。
Q3:*p、&x、p->m 老是搞混怎么办?
A:记住三句话:
&x是「x 住在哪」(取地址);*p是「顺着 p 去看那个房间」(解引用);p->m是「顺着 p 找到结构体,再取它的成员 m」。多写几遍链表遍历的代码,肌肉记忆就建立了。
Q4:竞赛中真的要手动 delete 吗?会不会忘了就丢分?
A:通常不会丢分。 程序结束时操作系统自动回收全部内存,所以竞赛里的内存泄漏一般无害。真正要小心的是运行中反复 new 导致超内存(MLE)——这种情况极少。结论:能用
vector/string就别手动管理内存。下面是一个会触发 MLE 的反例——在大循环里反复
new却从不delete:// ❌ 危险:每次循环都在堆上申请,永不释放 for (int i = 0; i < 10000000; i++) { int* p = new int[1000]; // 每次 4KB,累计 ~40 GB → MLE! // ... 用完 p 却忘了 delete[] p; } // ✅ 修复:要么循环外只申请一次复用,要么用完即 delete[] p;, // 最稳妥是直接用 vector<int> p(1000);(出作用域自动回收)
Q5:为什么有些选手的树/链表代码完全不用指针?
A:他们用数组模拟(也叫静态分配/节点池):用
int left[N], right[N], val[N];三个数组当作节点,用下标当「指针」。这样更快、更不容易出错、还能避免new的开销,是竞赛中的主流写法(详见第 5.5、5.7 章)。理解了指针版,再看数组版会更透彻。
Q6:多级指针、函数指针这些东西竞赛中真用得上吗?
A:直接使用不多,但理解后读代码能力大幅提升。 二级指针帮你理解
argv(命令行参数)、动态二维数组的底层;函数指针帮你理解sort的自定义比较、qsort回调。更重要的是,这些概念是后续 STL 函数对象、lambda 表达式等高级特性的基础。一句话:可以不天天写,但不能看不懂。
🔗 与后续章节的联系
- 第 5.5 章(二叉树与树算法):本章的
TreeNode结构是树遍历、BST 的起点 - 第 5.6 章(并查集)、第 5.7 章(线段树):会看到「指针版」与「数组模拟版」两种实现的取舍
- 第 5.1 章(图的基础):链式前向星本质上是用数组模拟链表来存图
- 本章建立的「内存与地址」心智模型,会让你对
vector扩容、string底层、引用传参的理解更深刻
练习题
热身 2.7.1 — 通过指针修改
声明 int x = 5;,定义一个指针 p 指向 x,通过 *p 把 x 改成 99,然后打印 x。
期望输出: 99
思路: 用 &x 给指针赋值,再用 *p 解引用赋值。
#include <bits/stdc++.h>
using namespace std;
int main() {
int x = 5;
int* p = &x; // p 指向 x
*p = 99; // 通过指针修改 x
cout << x << "\n"; // 99
return 0;
}
关键点:
int* p = &x;——&取地址*p = 99;——*解引用,改的是x本身
热身 2.7.2 — 指针交换
编写函数 void swp(int* a, int* b),用指针交换两个变量。在 main 中读入两个整数,交换后打印。
样例输入: 3 7 → 样例输出: 7 3
#include <bits/stdc++.h>
using namespace std;
void swp(int* a, int* b) {
int tmp = *a;
*a = *b;
*b = tmp;
}
int main() {
int x, y;
cin >> x >> y;
swp(&x, &y); // 注意要传地址
cout << x << " " << y << "\n";
return 0;
}
关键点:
- 函数参数是
int*,调用时必须传地址&x, &y - 函数内用
*a、*b访问原变量
热身 2.7.3 — 数组与指针
声明 int arr[5] = {10,20,30,40,50};,定义指针 p = arr,用 *(p+2) 打印第三个元素。
期望输出: 30
#include <bits/stdc++.h>
using namespace std;
int main() {
int arr[5] = {10, 20, 30, 40, 50};
int* p = arr; // 数组名退化为首元素指针
cout << *(p + 2) << "\n"; // 30,等价于 arr[2]
return 0;
}
关键点:
p = arr等价于p = &arr[0]*(p+2)等价于p[2]、arr[2]——指针算术按元素大小前进
题目 2.7.4 — 找最大值并返回指针
读入 N 个整数存入数组,编写函数返回指向最大元素的指针,在 main 中通过该指针打印最大值。
样例输入:
5
3 9 2 9 4
样例输出: 9
思路: 函数遍历数组,记录最大元素的地址并返回。
#include <bits/stdc++.h>
using namespace std;
int* findMax(int* arr, int n) {
int* best = arr; // 先假设第一个最大
for (int i = 1; i < n; i++) {
if (arr[i] > *best) best = &arr[i];
}
return best; // 返回指向最大元素的指针
}
int main() {
int n;
cin >> n;
vector<int> a(n);
for (int i = 0; i < n; i++) cin >> a[i];
int* p = findMax(a.data(), n); // a.data() 拿到底层数组指针
cout << *p << "\n";
return 0;
}
关键点:
- 返回的是「指向数组内某元素」的指针,数组还活着,所以安全(不是返回局部变量地址!)
a.data()——vector提供底层连续数组的首指针best始终保存当前最大元素的地址
题目 2.7.5 — 用指针就地翻转数组 读入 N 个整数,用两个指针(一个从头、一个从尾)就地翻转数组并打印。
样例输入:
5
1 2 3 4 5
样例输出: 5 4 3 2 1
思路: 双指针,从两端向中间交换,正是第 2.3 章翻转算法的指针版。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<int> a(n);
for (int i = 0; i < n; i++) cin >> a[i];
int* left = &a[0];
int* right = &a[n - 1];
while (left < right) { // 指针可以直接比较大小
swap(*left, *right);
left++;
right--;
}
for (int x : a) cout << x << " ";
cout << "\n";
return 0;
}
关键点:
- 同一数组内的指针可以用
<、>比较位置 left++/right--让指针按元素前进/后退- 循环条件
left < right保证在中点相遇时停止
题目 2.7.6 — 手写链表求和
不用 vector,用 struct Node{int data; Node* next;} 手动建立一条包含 N 个整数的链表,遍历求和后打印。
样例输入:
4
10 20 30 40
样例输出: 100
思路: 边读边在尾部接新节点,再从头遍历求和。
#include <bits/stdc++.h>
using namespace std;
struct Node {
int data;
Node* next;
};
int main() {
int n;
cin >> n;
Node* head = nullptr;
Node* tail = nullptr;
for (int i = 0; i < n; i++) {
int x;
cin >> x;
Node* node = new Node{x, nullptr};
if (head == nullptr) { // 第一个节点
head = tail = node;
} else {
tail->next = node; // 接到尾部
tail = node; // 更新尾指针
}
}
long long sum = 0;
for (Node* cur = head; cur != nullptr; cur = cur->next) {
sum += cur->data;
}
cout << sum << "\n";
// 释放
while (head) { Node* t = head; head = head->next; delete t; }
return 0;
}
关键点:
- 用
head和tail两个指针,尾插法 O(1) 接节点 cur = cur->next是链表遍历的标准写法- 用完逐个
delete(竞赛中可省,程序结束自动回收)
🏆 挑战题
挑战 2.7.7 — 反转链表 (经典面试 & 竞赛基础题)
建立一条链表 1→2→3→4→5,反转它使之变成 5→4→3→2→1,然后打印。要求只用指针操作,不借助数组。
期望输出: 5 4 3 2 1
思路: 三指针法——prev、cur、next。每步把 cur->next 反指向 prev,然后三个指针整体右移。

#include <bits/stdc++.h>
using namespace std;
struct Node {
int data;
Node* next;
};
int main() {
// 建立 1→2→3→4→5
Node* head = nullptr;
for (int i = 5; i >= 1; i--) { // 倒着头插,得到正序
head = new Node{i, head};
}
// 反转
Node* prev = nullptr;
Node* cur = head;
while (cur != nullptr) {
Node* next = cur->next; // 1. 先存住下一个
cur->next = prev; // 2. 当前节点反指向前一个
prev = cur; // 3. prev 前进
cur = next; // 4. cur 前进
}
head = prev; // prev 成为新的头
// 打印
for (Node* p = head; p; p = p->next) cout << p->data << " ";
cout << "\n";
return 0;
}
关键点:
- 反转链表的核心是「先用
next备份下一个,再改cur->next的指向」,顺序不能乱,否则链断了找不回来 - 三指针
prev / cur / next同步右移,O(N) 时间、O(1) 额外空间 - 这道题是理解指针操作的「试金石」,务必亲手画图走一遍
挑战 2.7.8 — 检测链表是否有环 (快慢指针经典应用)
给定一条可能成环的链表,判断它是否有环。打印 YES 或 NO。
提示:用「快慢指针」——慢指针每次走 1 步,快指针每次走 2 步。若两者相遇则有环(这叫 Floyd 判圈算法)。

思路: 快慢指针。若无环,快指针会先到达 nullptr;若有环,快指针会在环里追上慢指针。
#include <bits/stdc++.h>
using namespace std;
struct Node {
int data;
Node* next;
};
bool hasCycle(Node* head) {
Node* slow = head;
Node* fast = head;
while (fast != nullptr && fast->next != nullptr) {
slow = slow->next; // 慢:走 1 步
fast = fast->next->next; // 快:走 2 步
if (slow == fast) return true; // 相遇 → 有环
}
return false; // fast 到达末尾 → 无环
}
int main() {
// 构造 1→2→3→4,再让 4 指回 2 形成环
Node* n1 = new Node{1, nullptr};
Node* n2 = new Node{2, nullptr};
Node* n3 = new Node{3, nullptr};
Node* n4 = new Node{4, nullptr};
n1->next = n2; n2->next = n3; n3->next = n4;
n4->next = n2; // 制造环!
cout << (hasCycle(n1) ? "YES" : "NO") << "\n"; // YES
return 0;
}
关键点:
- 循环条件
fast && fast->next必须双重判空——因为fast一次走两步,要确保fast->next->next不越过空指针 - 快慢指针是处理链表环、找中点、找倒数第 K 个节点的通用利器
- 若有环,快指针每轮比慢指针多走 1 步,最终必在环内相遇——时间 O(N),空间 O(1)
挑战 2.7.9 — 奶牛排队(USACO Bronze 风格) (用链表 + 指针模拟动态插队)
Farmer John 的 N 头奶牛排成一队(编号 1..N,从队首到队尾)。接着发生 M 个事件,每个事件形如 x y:表示编号 x 的奶牛插队到编号 y 的奶牛正后方(保证 x、y 不同,且 x 当前在队中、会先被移出原位再插入)。所有事件处理完后,从队首到队尾输出整个队列。
样例输入:
4 2
2 4
1 3
(初始队列 1 2 3 4;事件1:2 插到 4 后 → 1 3 4 2;事件2:1 插到 3 后 → 3 1 4 2)
样例输出: 3 1 4 2
思路: 频繁的「移出 + 插入」正是双向链表的拿手好戏——它能 O(1) 完成任意位置的删除和插入,而数组做这件事要 O(N) 搬移。这里用数组模拟双向链表(竞赛主流写法,呼应 2.7.7 的对照表):pre[i] 和 nxt[i] 分别存编号 i 左右邻居,用哨兵 0 表示队首之前/队尾之后。
#include <bits/stdc++.h>
using namespace std;
const int N = 100005;
int pre[N], nxt[N]; // pre[i]/nxt[i]:编号 i 的前驱/后继;0 为哨兵(队首端/队尾端)
void detach(int x) { // 把 x 从当前位置摘下
nxt[pre[x]] = nxt[x];
pre[nxt[x]] = pre[x];
}
void insertAfter(int y, int x) { // 把 x 插到 y 的正后方
int z = nxt[y]; // y 原来的后继
nxt[y] = x; pre[x] = y;
nxt[x] = z; pre[z] = x;
}
int main() {
int n, m;
cin >> n >> m;
// 初始队列 1 2 ... n,用哨兵 0 串起两端
pre[1] = 0; nxt[0] = 1; // 0 → 1
for (int i = 1; i < n; i++) { nxt[i] = i + 1; pre[i + 1] = i; }
nxt[n] = 0; pre[0] = n; // n → 0(回到哨兵,表示队尾)
while (m--) {
int x, y;
cin >> x >> y;
detach(x); // 先把 x 移出原位
insertAfter(y, x); // 再插到 y 后面
}
// 从哨兵后第一个节点开始,沿 nxt 输出整条队列
for (int i = nxt[0]; i != 0; i = nxt[i]) {
cout << i << (nxt[i] ? " " : "\n");
}
return 0;
}
关键点:
- 为什么用链表不用数组? 数组插队要把后面所有元素后移,单次 O(N),M 次就是 O(NM);双向链表删除+插入都是 O(1),总计 O(N+M),N、M 达 10^5 时差距巨大
- 哨兵 0 让队首/队尾不必特判:
nxt[0]是真正队首,pre[0]是真正队尾 - 这里以编号本身作下标(编号即「指针」),是数组模拟链表的典型用法——和 2.7.7 的对照表完全一致
detach必须在insertAfter之前,否则 x 的旧邻居关系还没断开
题目 2.7.10 — 用指针实现 myStrlen (指针遍历C风格字符串的经典练习)
不使用任何库函数,用纯指针操作实现 int myStrlen(const char* s),返回字符串长度(不含 \0)。在 main 中测试。
期望输出(输入 "hello"): 5
思路: 指针从首字符出发,逐字符前进,遇到 \0 停止。走过的步数就是长度。
#include <bits/stdc++.h>
using namespace std;
int myStrlen(const char* s) {
int len = 0;
while (*s != '\0') { // 等价于 while (*s)
len++;
s++; // 指针前进到下一个字符
}
return len;
}
int main() {
const char* s = "hello";
cout << myStrlen(s) << "\n"; // 5
return 0;
}
关键点:
*s解引用取当前字符;s++让指针前进(指针算术)- 循环条件
*s != '\0'——C 风格字符串以\0标记结尾 - 这个练习让你体会「指针 + 循环 = 字符串操作」的本质
题目 2.7.11 — 用指针实现 myStrcpy (指针赋值的经典练习)
不使用任何库函数,用纯指针操作实现 void myStrcpy(char* dst, const char* src),将 src 指向的字符串完整复制到 dst。在 main 中测试。
期望输出(输入 "world"): world
思路: 两个指针同步前进,逐字符赋值,最后手动补 \0。
#include <bits/stdc++.h>
using namespace std;
void myStrcpy(char* dst, const char* src) {
while (*src != '\0') {
*dst = *src; // 逐字符赋值
dst++;
src++;
}
*dst = '\0'; // 别忘了末尾的 '\0'!
}
// 精简版(理解原理后再看):
void myStrcpyV2(char* dst, const char* src) {
while ((*dst++ = *src++)); // 赋值 + 判断 + 前进,一体完成
}
int main() {
const char* src = "world";
char dst[100];
myStrcpy(dst, src);
cout << dst << "\n"; // world
return 0;
}
关键点:
const char* src——源字符串用const修饰,防止误修改- 必须手动追加
\0,否则dst不是合法的 C 字符串 - 精简版
(*dst++ = *src++)利用后置++:先赋值再指针前进,循环到赋值结果为\0时自动停止
题目 2.7.12 — 合并两个有序链表 (经典指针操作,面试高频题)
给定两条升序链表 L1 和 L2,将它们合并成一条新的升序链表并返回头指针。要求只修改指针,不新建节点(即不能用 new)。
样例输入(两条链表): 1→3→5 和 2→4→6
样例输出: 1 2 3 4 5 6
思路: 用一个「哨兵」哑节点(dummy)简化头处理,维护一个尾指针 tail。每次比较两条链表的当前头节点,把较小的摘下来接到 tail 后面,被摘的那条链表头指针前进。最后把剩余部分直接接上。
#include <bits/stdc++.h>
using namespace std;
struct Node {
int data;
Node* next;
};
Node* mergeTwoLists(Node* l1, Node* l2) {
Node dummy{0, nullptr}; // 哑节点,简化头部处理
Node* tail = &dummy; // tail 始终指向结果链表的尾
while (l1 != nullptr && l2 != nullptr) {
if (l1->data < l2->data) {
tail->next = l1; // 摘 l1 当前节点
l1 = l1->next; // l1 前进
} else {
tail->next = l2; // 摘 l2 当前节点
l2 = l2->next; // l2 前进
}
tail = tail->next; // tail 始终保持在尾部
}
// 把剩余的链表直接接上(最多一条非空)
tail->next = (l1 != nullptr) ? l1 : l2;
return dummy.next; // 跳过哑节点,返回真正的头
}
int main() {
// 构建 L1: 1→3→5
Node* l1 = new Node{1, new Node{3, new Node{5, nullptr}}};
// 构建 L2: 2→4→6
Node* l2 = new Node{2, new Node{4, new Node{6, nullptr}}};
Node* merged = mergeTwoLists(l1, l2);
for (Node* p = merged; p; p = p->next)
cout << p->data << " ";
cout << "\n"; // 1 2 3 4 5 6
return 0;
}
关键点:
- 哑节点(dummy node) 是链表题的经典技巧——避免当头节点为空时的特判
tail始终保持指向结果链表的最后一个节点,接新节点时 O(1)- 指针操作的核心:改了
tail->next后必须同步更新tail和被摘链表的头指针 - 这是合并(Merge)、链表归并排序(Merge Sort)的基础子操作
题目 2.7.13 — 找链表的中间节点 (快慢指针的又一经典应用)
给定一条单链表,用快慢指针找到它的中间节点。如果长度为偶数,返回第二个中间节点。
样例输入: 1→2→3→4→5
样例输出: 3(第 3 个节点是中间)
样例输入: 1→2→3→4
样例输出: 3(偶数长度,返回靠后的中间节点)
思路: 慢指针每次走 1 步,快指针每次走 2 步。当快指针到达末尾时,慢指针正好在中点。
#include <bits/stdc++.h>
using namespace std;
struct Node {
int data;
Node* next;
};
Node* findMiddle(Node* head) {
Node* slow = head;
Node* fast = head;
while (fast != nullptr && fast->next != nullptr) {
slow = slow->next; // 慢:1 步
fast = fast->next->next; // 快:2 步
}
return slow; // fast 到末尾时,slow 就是中点
}
int main() {
// 测试 1: 1→2→3→4→5(奇数)
Node* head1 = new Node{1, new Node{2, new Node{3,
new Node{4, new Node{5, nullptr}}}}};
cout << findMiddle(head1)->data << "\n"; // 3
// 测试 2: 1→2→3→4(偶数)
Node* head2 = new Node{1, new Node{2, new Node{3,
new Node{4, nullptr}}}};
cout << findMiddle(head2)->data << "\n"; // 3
return 0;
}
关键点:
- 快慢指针是处理链表「中点」「倒数第 K 个」「环检测」的通用利器,时间 O(N)、空间 O(1)
- 循环条件
fast && fast->next——因为快指针一次走两步,两个判空缺一不可 - 当
fast == nullptr(奇数长度)或fast->next == nullptr(偶数长度)时循环退出,slow恰好在中点 - 如果想要第一个中间节点(偶数长度时返回靠前那个),可以让快指针先走一步:
fast = head->next
🔗 USACO 真题练手
本章的指针 / 链表思想直接对应下面这些 USACO 官方真题。建议先用本章的「指针版」或「数组模拟版」实现,再去 usaco.org 提交验证:
| 真题 | 难度 | 考点 | 与本章的对应 |
|---|---|---|---|
| Reordering the Cows(USACO 2014 March Bronze P1) | 🟢 Bronze | 排列环 / 沿「指针」追踪 | 把 A[i] 当作「i 指向 A[i]」,顺着下标一路跳——正是 2.7.4「数组下标即指针」的思想,也是 Floyd 判圈在数组上的版本 |
| Cow Line(USACO 2009 Open Silver) | 🟡 Silver | 双端链表 / deque 模拟 | 两端频繁增删,正是 2.7.9「奶牛排队」的强化版;可用数组模拟双向链表,或直接用 deque(第 3.6 章) |
💡 解题提示:
- Reordering the Cows:每头牛要从位置
i走到目标位置,沿着「当前牛该去哪、那个位置原来的牛又该去哪」一路跟踪,就会走出一个个「环」。这种「顺着指向一路跳」的遍历,和链表遍历、Floyd 判圈是同一种思维。- Cow Line:左右两端都要 O(1) 增删,标准做法是双端队列。理解了本章的双向链表(
pre/nxt两个方向的「指针」),你就能明白deque内部为什么能两端 O(1)。
📌 更系统的题单:USACO Guide 按难度和专题(含 Stacks/Queues、Linked Lists)整理了官方真题,是赛前刷题的权威路线图。
📖 第 2.8 章:枚举与模拟
2.8.0 从两道题出发
先看两道典型的 Bronze 题目——它们分别代表了本章的两大主题。
📋 题目 1:熄灯问题(简化版) 有一个 3×3 的灯阵,每个格子要么亮(
1)要么灭(0)。现在灯全部亮着。 按下任意一个格子的开关,会翻转它自己和上下左右相邻格子的亮灭状态。 问:至少按多少次开关,才能把所有灯熄灭? 数据范围: 3×3 灯阵,开关只有「按」和「不按」两种选择。
📋 题目 2:爬行的蠕虫 一只蠕虫在一口深
n厘米的井底。每分钟它先向上爬u厘米, 如果这之后还没爬出井口,就向下滑d厘米(休息时滑落)。 问:多少分钟后蠕虫爬出井口? 数据范围:1 ≤ n, u, d ≤ 100,保证u > d。
两道题,两种思路
熄灯问题:答案藏在「每个开关按或不按」的所有组合里——共 2⁹ = 512 种。把每种组合都试一遍,检查哪种能把灯全熄灭。这就是枚举:暴力搜索整个答案空间。
爬行的蠕虫:没有任何组合可选——过程是确定的,一分钟一分钟往下推就行。爬、检查、滑落,循环往复。这就是模拟:按题意忠实复现过程。
这两招是 Bronze 级别最朴素也最可靠的得分手段:
- 枚举:答案空间有限时,把每个候选答案都验证一遍。不需要聪明,只需要不重不漏。
- 模拟:题目描述了一个过程时,让计算机一步步照做。不需要算法,只需要不出错。
拆解本章需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 2.8.1 | 枚举:什么是解空间?怎么枚举才不重不漏又够快? |
| 2.8.2 | 模拟:怎么写大模拟题才能不写错? |
| 2.8.3 | 枚举 × 模拟:两者结合的黄金套路(完整解开篇熄灯题) |
学习目标(学完本章你将能够):
- 为一道题建立正确的「解空间模型」,做到不重不漏
- 用三种手段缩小枚举空间:缩小范围、利用对称性、边枚举边排除
- 掌握子集枚举(位运算
mask)与排列枚举(next_permutation) - 用「纸上流程 → 模块化 → 统一量纲」的方法写对大模拟题
- 熟练处理日期、时间类模拟题(平闰年、大小月)
- 使用「枚举决策 + 模拟验证」套路解决 USACO Bronze 常见的开关类问题
2.8.1 枚举(Enumeration)
什么是解空间?
解空间是「所有可能的答案(候选解)组成的集合」。枚举就是逐个检查候选解,把满足条件的挑出来。
比如:
- 「熄灯问题」的解空间 = 9 个开关每个按/不按,共 2⁹ = 512 种方案;
- 「三个数中选两个」的解空间 = C(3,2) = 3 种选法;
- 「1 到 n 的整数」的解空间就是
1, 2, ..., n。
枚举的正确性取决于两件事:完备(每个可行解都被访问到)与不重(同一方案不被统计两次)。而枚举的效率取决于解空间的大小——所以枚举的功夫全在「如何让解空间变小」上。
枚举三要点
- 建立解空间模型:先把「候选答案到底是什么」想清楚,再动手写循环。是选一个数?选一对数?选一个子集?还是一组排列?
- 减少枚举空间:
- 缩小范围:利用数学关系直接收紧循环边界(如只需要枚举到 √n);
- 利用对称性:
(a, b)和(b, a)是同一方案时,只枚举a ≤ b的一半; - 边枚举边排除:一旦发现当前候选已经不可能,立即跳过(这是剪枝的雏形)。
- 选择枚举顺序:有时按特定顺序枚举能提前找到答案(如求「字典序最小的方案」就按字典序枚举),有时能让「不重不漏」自然成立。
下面用一道题把三要点全部走一遍。
完整实战 1:和为零的数对
📋 题目:和为零的数对 给定
n个整数,问其中有多少对数(i, j)(i < j)满足a[i] + a[j] = 0? 数据范围:1 ≤ n ≤ 10⁶,|a[i]| ≤ 10⁶。
第一步:建立解空间模型。 答案是一对下标 (i, j) 且 i < j——解空间是所有下标对,共 n(n−1)/2 个。
版本 1:朴素双重循环 O(n²)
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<int> a(n);
for (auto &x : a) cin >> x;
long long cnt = 0;
for (int i = 0; i < n; i++)
for (int j = i + 1; j < n; j++) // j 从 i+1 开始:天然保证 i < j
if (a[i] + a[j] == 0) cnt++;
cout << cnt << endl;
return 0;
}
注意内层 j 从 i + 1 开始——这就是「利用对称性」:(i, j) 和 (j, i) 是同一对,只统计一次。如果写成 j 从 0 开始再判断 i < j,既慢又容易把「不重」写错。
样例验证:
输入: 输出:
5
3 -3 5 -5 2 2
(3, -3) 和 (5, -5) 共 2 对。
n = 10⁶ 时双重循环约 5×10¹¹ 次——超时。换模型:不要枚举数对,改为枚举每个数,问「它的相反数出现几次」。
版本 2:有序去半(排序 + 双指针思路的雏形)O(n log n)
先把数组排序,a[i] 的相反数如果存在,必然集中出现在某个连续段——用双指针可以在一轮扫描内统计完。这个思路在第 3 章双指针部分会展开,这里先看更彻底的版本 3。
版本 3:桶标记 O(n)
值域只有 |a[i]| ≤ 10⁶,开一个桶数组记录每个值出现的次数。扫描到 a[i] 时,之前的数里值为 -a[i] 的都能和它配对:
#include <bits/stdc++.h>
using namespace std;
const int OFFSET = 1000000; // 值域 [-1e6, 1e6] 平移到 [0, 2e6]
int bucket[2000001];
int main() {
int n;
cin >> n;
vector<int> a(n);
for (auto &x : a) cin >> x;
long long cnt = 0;
for (int i = 0; i < n; i++) {
// 在「已经见过的数」中找 a[i] 的相反数
if (-a[i] >= -1000000 && -a[i] <= 1000000)
cnt += bucket[-a[i] + OFFSET];
bucket[a[i] + OFFSET]++; // 然后把自己也记入桶中
}
cout << cnt << endl;
return 0;
}
先查再记的顺序很关键:如果先把自己记进桶再查,a[i] = 0 时会把自己和自己配对。
三版对比:
| 版本 | 思路 | 复杂度 | n = 10⁶ 时约需操作 |
|---|---|---|---|
| 朴素双重循环 | 枚举所有下标对 | O(n²) | 5×10¹¹(超时) |
| 排序 + 双指针 | 有序后配对数相邻 | O(n log n) | 2×10⁷ |
| 桶标记 | 每个数直接查相反数 | O(n + V) | 10⁶ |
这条「朴素 O(n²) → 有序去半 → 桶标记 O(n)」的优化路径是枚举题的通用成长路线:先保证正确,再一步步压解空间。
完整实战 2:子集枚举——选数凑和
当候选答案是「从中挑出若干个数」时,解空间就是子集。n 个数的子集共 2ⁿ 个,正好对应 n 位二进制数——这正是第 2.6 章位运算中位掩码的用武之地。
📋 题目:选数凑和 给定
n个整数和一个目标值target,问有多少种非空选法,使得选出的数之和恰好等于target? 两种选法不同当且仅当选中的下标集合不同。 数据范围:1 ≤ n ≤ 20,|a[i]| ≤ 10⁹,|target| ≤ 10⁹。
n ≤ 20 暗示 2²⁰ ≈ 10⁶——子集枚举的典型信号:
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
long long target;
cin >> n >> target;
vector<long long> a(n);
for (auto &x : a) cin >> x;
long long cnt = 0;
for (int mask = 0; mask < (1 << n); mask++) { // 枚举每个子集
long long sum = 0;
for (int i = 0; i < n; i++)
if (mask & (1 << i)) sum += a[i]; // 第 i 位为 1 表示选它
if (sum == target) cnt++;
}
cout << cnt << endl;
return 0;
}
样例验证:
输入: 输出:
5 5
1 2 3 4 5 3
三种选法:{5}、{1,4}、{2,3}。
两个易错点:
(1 << n)中若n ≥ 31会溢出——好在n ≤ 20时1 << 20只有约 10⁶,安全;sum用long long:20 个 10⁹ 相加达 2×10¹⁰,int必爆。
完整实战 3:排列枚举——密码锁
当候选答案是「顺序也有意义」时,解空间是排列。STL 的 next_permutation 按字典序逐个生成排列,是排列枚举的标准工具。
📋 题目:密码锁 一个三位密码锁由数字 1、2、3 各一个组成。从小到大列出所有可能的密码, 求第
k个密码是什么。 数据范围:1 ≤ k ≤ 6。
#include <bits/stdc++.h>
using namespace std;
int main() {
int k;
cin >> k;
string s = "123";
sort(s.begin(), s.end()); // 必须先排成最小排列
int idx = 1;
do {
if (idx == k) {
cout << s << endl;
return 0;
}
idx++;
} while (next_permutation(s.begin(), s.end()));
return 0;
}
样例验证: k = 4 输出 231(六种排列按字典序是 123、132、213、231、312、321)。
do-while 配合先排序是固定套路:next_permutation 在已经是最大排列时返回 false,从最小排列出发正好一个不漏。
枚举剪枝:预告
「边枚举边排除」的极端形式是:枚举到一半就发现此路不通,立刻回头换一条路——这就是回溯(剪枝)。它是第 5.2 章 BFS 与 DFS 的主角,也是子集枚举从 2ⁿ 走向更聪明搜索的必经之路。现在只需记住:枚举是回溯的骨架,剪枝是枚举的加速器。
2.8.2 模拟(Simulation)
模拟题的特征与心态
模拟题的标志是:题目把过程讲得一清二楚,你只需要照做。日期推算、游戏规则、机器执行、蚂蚁爬行……USACO Bronze 每场比赛几乎都有一道。
模拟题的特点是码量大、逻辑琐碎——难的不是想到做法,而是写对。正确的心理预期是:
模拟题不是比谁聪明,是比谁细心。把「我会了」和「我写对了」之间的距离,用工程习惯填平。
五大技巧
- 先在纸上写流程:把题目过程翻译成伪代码步骤,每一步的变量变化列一个表。写代码之前手算一遍样例,纸面流程和样例对得上再动手。
- 代码模块化:一个功能一个函数(或结构体)。「翻转一格灯」写成
flip(r, c),「判断闰年」写成isLeap(y)。模块短小、命名清楚,出错时定位快。 - 统一量纲:时间统一换成秒、日期统一换成天数、金额统一换成「分」。所有比较和加减只在统一单位后进行,
3 分 20 秒与200 秒混用是模拟题最经典的 bug 来源。 - 常量命名:大小月天数表、方向数组
dx/dy、一周七天名称……提取成const数组放在文件开头,魔法数字全部消灭。 - 分块调试:每写完一个模块就用样例(或自造小数据)单独验证它,再拼装。一次只怀疑一个模块——这比盯着 200 行
main找错高效十倍。系统方法见附录调试指南。
完整实战 1:爬行的蠕虫(开篇题回收)
按纸上流程走一遍:每分钟「先爬 u,若已出井口立即结束,否则下滑 d」——注意先判断后下滑的顺序,顺序反了会多算一分钟(出井口后不会滑落)。
| 分钟 | 爬后位置 | 出井? | 滑后位置 |
|---|---|---|---|
| 1 | u | 否 | u − d |
| 2 | 2u − d | 否 | 2u − 2d |
| ... | ... | ... | ... |
#include <bits/stdc++.h>
using namespace std;
int main() {
long long n, u, d;
cin >> n >> u >> d;
long long pos = 0, minutes = 0;
while (pos < n) {
pos += u; // 先爬
minutes++;
if (pos >= n) break; // 到顶就结束,不再下滑
pos -= d; // 没到顶,才滑落
}
cout << minutes << endl;
return 0;
}
样例验证: n = 10, u = 2, d = 1 时,位置依次为 2→1、4→3、6→5、8→7、10(到顶)——输出 9 分钟。手算公式:第 k 分钟爬后位置 = ku − (k−1)d = k + 1,k = 9 时恰好为 10。✅
再验一组边界:n = 5, u = 5, d = 3——第一分钟直接爬到 5 出井,输出 1(下滑根本没发生)。
完整实战 2:日期模拟——N 天之后是几月几号
日期是模拟题的常客,考点全在平闰年和大小月上。
📋 题目:N 天之后 给定一个日期
y-m-d和整数n,求n天之后的日期。 数据范围:1900 ≤ y ≤ 2100,日期合法,1 ≤ n ≤ 10000。
模块化 + 常量表的做法:
#include <bits/stdc++.h>
using namespace std;
bool isLeap(int y) {
return (y % 4 == 0 && y % 100 != 0) || (y % 400 == 0);
}
int daysOfMonth(int y, int m) {
static const int d[] = {0, 31, 28, 31, 30, 31, 30, 31, 31, 30, 31, 30, 31};
if (m == 2 && isLeap(y)) return 29;
return d[m];
}
int main() {
int y, m, d, n;
cin >> y >> m >> d >> n;
d += n;
while (d > daysOfMonth(y, m)) { // 当前月份装不下了就进位
d -= daysOfMonth(y, m);
m++;
if (m > 12) {
m = 1;
y++;
}
}
printf("%04d-%02d-%02d\n", y, m, d);
return 0;
}
样例验证:
输入:2024 2 28 2 输出:2024-03-01 (2024 是闰年,2 月有 29 天)
输入:2023 2 28 2 输出:2023-03-02 (2023 是平年,2 月只有 28 天)
输入:2024 12 31 1 输出:2025-01-01 (跨年进位)
注意 daysOfMonth(y, m) 在 while 条件和循环体里各调用一次——月份进位后要重新查天数,写错这里(比如循环外缓存)跨月时必错。
完整实战 3:胜负判定表——win() 函数
很多游戏类模拟题的核心是一张「谁克谁」的判定表。以石头剪刀布为例:
#include <bits/stdc++.h>
using namespace std;
char names[3][8] = {"Rock", "Paper", "Scissors"}; // 0=石头 1=布 2=剪刀
// 返回 1 表示 a 赢 b,-1 表示 a 输 b,0 平局
int win(int a, int b) {
if (a == b) return 0;
return (a - b + 3) % 3 == 1 ? 1 : -1;
}
int main() {
int a, b;
cin >> a >> b;
cout << names[a] << " vs " << names[b] << ": ";
int r = win(a, b);
if (r == 1) cout << "first wins" << endl;
else if (r == -1) cout << "second wins" << endl;
else cout << "tie" << endl;
return 0;
}
这里用了一个小巧的取模公式:把三种手势编号成环(石头 0 → 布 1 → 剪刀 2 → 石头 0),(a − b + 3) % 3 == 1 恰好表示「a 克 b」——比三行 if 更不容易写反。这套写法在 USACO 的「HPS(Hoop-Toss?)」石头剪刀布系列题(见第 6.2 章)中直接可用。
2.8.3 枚举 × 模拟:黄金套路
枚举决策 + 模拟验证
把两招合起来就是 Bronze 最强大的套路之一:
决策空间大但结构有规律时——枚举「第一步的所有决策」,剩下的过程用模拟推完。
开篇的熄灯问题正是如此。直接枚举 9 个开关的 2⁹ 种按法当然可行,但有一个更优雅的观察:
第 0 行的灯一旦确定按法,第 1 行怎么按就被唯一确定了——因为第 0 行还亮着的灯,只能靠按第 1 行正下方的开关来熄灭(第 0 行自己的开关已经定死了)。同理第 1 行确定后第 2 行也随之确定。
所以只需枚举第一行的 2³ = 8 种按法,剩下的 6 个开关由「逐行熄灭上方残留亮灯」的规则模拟推出来,最后检查最末行是否全灭即可:
#include <bits/stdc++.h>
using namespace std;
int main() {
int grid[3][3];
for (int i = 0; i < 3; i++)
for (int j = 0; j < 3; j++)
cin >> grid[i][j]; // 1=亮, 0=灭
int best = INT_MAX; // 最少按键数
int bestMask = -1; // 对应的第一行按法
// 枚举第一行的按法:bit j = 1 表示按下 (0, j)
for (int mask = 0; mask < 8; mask++) {
int g[3][3], press[3][3];
memcpy(g, grid, sizeof(grid));
memset(press, 0, sizeof(press));
int cnt = 0;
// 第 0 行的按法由 mask 决定
for (int j = 0; j < 3; j++)
if (mask & (1 << j)) { press[0][j] = 1; cnt++; }
// 应用第 0 行的按键:翻转自己和上下左右
for (int j = 0; j < 3; j++)
if (press[0][j]) {
int di[] = {0, 0, 0, 1, -1};
int dj[] = {0, 1, -1, 0, 0};
for (int k = 0; k < 5; k++) {
int ni = di[k], nj = j + dj[k];
if (ni >= 0 && ni < 3 && nj >= 0 && nj < 3)
g[ni][nj] ^= 1;
}
}
// 第 i 行还亮着的灯,只能靠按第 i+1 行正下方的开关熄灭
for (int i = 0; i + 1 < 3; i++) {
for (int j = 0; j < 3; j++)
if (g[i][j] == 1) {
press[i + 1][j] = 1;
cnt++;
}
// 应用第 i+1 行新确定的按键
for (int j = 0; j < 3; j++)
if (press[i + 1][j]) {
int di[] = {0, 0, 0, 1, -1};
int dj[] = {0, 1, -1, 0, 0};
for (int k = 0; k < 5; k++) {
int ni = i + 1 + di[k], nj = j + dj[k];
if (ni >= 0 && ni < 3 && nj >= 0 && nj < 3)
g[ni][nj] ^= 1;
}
}
}
// 最末行必须全灭,方案才成立
bool ok = true;
for (int j = 0; j < 3; j++)
if (g[2][j] == 1) { ok = false; break; }
if (ok && cnt < best) {
best = cnt;
bestMask = mask;
}
}
if (bestMask < 0) {
cout << "无解" << endl;
} else {
cout << "最少按键 " << best << " 次" << endl;
cout << "第一行按法(列0到2): ";
for (int j = 0; j < 3; j++)
cout << ((bestMask >> j) & 1);
cout << endl;
}
return 0;
}
样例验证: 输入全亮的 3×3(1 1 1 / 1 1 1 / 1 1 1),输出:
最少按键 5 次
第一行按法(列0到2): 101
即按下四角加中心共 5 个开关——这与 2⁹ 全枚举对拍的结果一致(本程序的答案已用 512 种初始状态逐一和暴力全枚举对拍验证过)。
为什么这个套路如此常见?
- 枚举量从 2⁹ 降到 2³——枚举空间被「逐行确定」的结构压缩了;
- 枚举之后的每一步都是机械的模拟——正确性由「照做」保证;
- 更妙的是,枚举第一行按法时顺便得到了「按键最少」的方案——枚举顺序不影响正确性,但影响能不能顺手求最优。
USACO Bronze 的「关灯」「按行染色」「翻硬币」系列题全是这个模板:枚举第一行的全部决策 → 逐行模拟确定后续 → 检查最后一行。把 3×3 推广到 R×C(第一行按法 2^C 种),就是完整的 USACO 真题规模。
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| 枚举边界差一 | i < n 写成 i <= n,或 j 从 0 起重复枚举 | 明确区间开闭约定,i < j 用 j = i + 1 起步 |
1 << n 溢出 | n ≥ 31 时 int 位移未定义 | 子集枚举 n ≤ 20 才用 int;更大时改 long long 或换搜索 |
子集求和用 int | 20 个 10⁹ 相加达 2×10¹⁰ | sum 一律 long long |
| 模拟更新顺序颠倒 | 蠕虫题「先滑后爬」多算一分钟;先记桶再查把自己配对 | 纸上列表格逐步核对,写完用样例逐行跟踪 |
| 闰年判断写错 | 只写 y % 4 == 0,漏掉百年不闰 | 记住完整公式:(y%4==0 && y%100!=0) || y%400==0 |
| 大小月硬编码 | 二月天数、31/30 天月份靠背 | 用 daysOfMonth(y, m) 常量表 + 函数 |
| win 表写反 | 「a 克 b」和「b 克 a」弄反 | 用 (a - b + 3) % 3 == 1 这类对称公式,或写完用一组样例验证 |
| 越界方向的翻转漏判边界 | 熄灯题按 (0,0) 翻转上/左邻居 | 翻转前统一检查 0 <= ni < R && 0 <= nj < C |
调试建议
模拟题写完之后,按这个清单自造数据检查:
- 最小规模:n = 1、只有一行、只有一分钟——边界循环体是否还正确?
- 刚好卡边界:蠕虫第一分钟就出井;日期加 0 天;子集只选第一个数。
- 跨段进位:日期跨月、跨年;蠕虫整除到顶。
- 对拍:写一个朴素暴力版(如 2⁹ 全枚举),用小数据随机对拍——这是验证枚举题的终极手段。
本章小结
本章最重要的思想可以总结为两句话:
- 枚举的功夫在解空间:建对模型 → 压缩空间(缩范围 / 用对称 / 边排除)→ 选好顺序。
- 模拟的功夫在工程:纸上流程、模块化、统一量纲、常量命名、分块调试——用习惯换正确率。
速查表
| 枚举三要点 | 一句话 |
|---|---|
| 建立解空间模型 | 先想清楚候选答案是什么(数 / 数对 / 子集 / 排列) |
| 减少枚举空间 | 缩小范围、利用对称性(j = i+1)、边枚举边排除 |
| 选择枚举顺序 | 求字典序最小就按字典序枚举;利用结构逐行确定 |
| 模拟五技巧 | 一句话 |
|---|---|
| 纸上流程 | 伪代码 + 变量表,手算样例后再写代码 |
| 模块化 | 一个功能一个函数,命名即文档 |
| 统一量纲 | 时间转秒、日期转天数,单位统一后再运算 |
| 常量命名 | 大小月表、方向数组用 const 数组,消灭魔法数字 |
| 分块调试 | 每个模块单独过样例,一次只怀疑一处 |
枚举 × 模拟黄金套路:
枚举第一行的所有决策(2^C 种)
→ 逐行模拟:上一行的亮灯决定本行的按法
→ 检查最后一行是否满足条件
💪 练习题
🟢 题目 1:虫群计数
题目描述:
给定 n 个整数,问其中有多少对 (i, j)(i < j)满足 a[i] + a[j] == 10?
数据范围: 2 ≤ n ≤ 1000,0 ≤ a[i] ≤ 10。
输入格式:
第一行一个整数 n
第二行 n 个整数 a[1..n]
输出格式:
一个整数,表示满足条件的数对数量
样例输入:
5
3 7 5 5 10
样例输出:
3
提示: 直接用本章的双重循环 O(n²) 就够了(n ≤ 1000 时约 10⁶ 次)。配对有 (3,7)、(5,5)、(5,5) 共 3 对——注意下标不同、值相同的两对要分别计数。
🟢 题目 2:日期差
题目描述:
给定两个日期,求它们之间相差多少天(含首尾两端中的较早日期、不含较晚日期,即「从日期 1 走到日期 2 需要多少天」)。
数据范围: 两个日期均在 1900-01-01 到 2100-12-31 之间且合法,保证日期 1 不晚于日期 2。
输入格式:
两行,每行格式为 y m d(空格分隔)
输出格式:
一个整数,相差的天数
样例输入:
2024 2 28
2024 3 2
样例输出:
3
提示: 复用本章的 isLeap 和 daysOfMonth。逐天推进会超时吗?先算算最坏情况约 200 年 × 366 天 ≈ 7×10⁴ 次——逐天模拟完全够快。(更快的做法是儒略日公式,但模拟更不容易错。)
🟡 题目 3:熄灯问题原版
题目描述:
把本章的熄灯问题推广到 R × C 的灯阵(1 ≤ R, C ≤ 5)。给定初始灯态(不一定全亮),问是否存在按键方案把所有灯熄灭?若存在,输出最少按键数;若不存在,输出 -1。
数据范围: 1 ≤ R, C ≤ 5。
输入格式:
第一行 R C
接下来 R 行,每行 C 个 0/1 整数(1=亮)
输出格式:
一个整数:最少按键数,或 -1
样例输入:
2 3
0 1 0
1 0 1
样例输出:
2
提示: 枚举第一行的 2^C 种按法,其余行逐行模拟确定,检查最后一行。答案与 2^(R·C) 全枚举对拍验证。
🔴 题目 4:蛇形矩阵
题目描述:
从矩阵左上角出发,按「右、下、左、上」的顺序螺旋填充 1 到 n²,输出 n×n 的蛇形(螺旋)矩阵。
数据范围: 1 ≤ n ≤ 20。
输入格式:
一个整数 n
输出格式:
n 行,每行 n 个整数,右对齐占 4 列
样例输入:
4
样例输出:
1 2 3 4
12 13 14 5
11 16 15 6
10 9 8 7
提示: 纯模拟。方向数组 dx/dy + 「下一步出界或已填过就右转」。用 printf("%4d", ...) 控制格式。这是方向模拟 + 边界检查的集大成者——写对了,你就掌握了本章的所有边界技巧。
下一章预告: 进入第三部分,数据结构——数组与前缀和将把本章「桶标记」的思路推广成更强大的统计工具。
📖 第 2.9 章:倍增与构造
2.9.0 从两道题出发
先看两道题——它们代表了本章的两大主题。
📋 题目 1:巨蟒跳格 有一条
N格的线,棋子从第1格出发,每次可以向前跳 1、2、4、8、… 格——也就是恰好 2 的幂次方格(不能超出第N格)。 问:最少跳几次能恰好到达第N格? 数据范围:1 ≤ N ≤ 10^18。
📋 题目 2:构造回文 给你一个由小写字母组成的字符串
s(长度n ≤ 10^6)。 请你重排其中的字母,输出一个是回文的字符串;如果有多种方案,输出任意一种。如果无论怎么重排都无法构成回文,输出NO SOLUTION。
两道题,两种思想
巨蟒跳格:N 最大到 10^18,一步步模拟肯定不行。但「每次跳 2 的幂」这个条件暗示了答案与 N - 1 的二进制表示有关——最少步数就是「能凑出 N - 1 的最少几个 2 的幂」。这正是倍增思想的入口:用 2 的幂组合出任意数量。
构造回文:题目不是问你「最优值是多少」,而是要你亲手交出一个合法方案。答案是「构造」出来的,不是「搜索」出来的。你需要先想清楚「回文什么时候存在」(判定),再设计「怎么摆」(构造)。
这一章是全书的「思想总纲」:
- 倍增——你在很多后续章节会反复遇到它(快速幂、LCA、函数图跳步……),这里先把统一的思想讲透;
- 构造——竞赛中独立的一类题型,这里建立基本方法论,深入版见 Ad Hoc 一章。
拆解本章需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 2.9.1 | 倍增:为什么「2 的幂」能统一解决一大类「跳 k 步」问题? |
| 2.9.2 | 构造:面对「给出一组方案」类题目,从哪里下手?怎么保证正确? |
学习目标(学完本章你将能够):
- 说出倍增适用的两个条件(可组合 + 结合律),并据此判断一道题能否倍增
- 用一张「统一视角表」把快速幂、LCA、函数图跳步等应用归到同一框架下
- 手写「跳 k 步」的倍增数组
f[j][x],并用二进制分解完成查询 - 掌握构造题的三大入手思路:从特殊到一般、从下界反推、逐步交换
- 养成「构造完用小数据暴力验证」的习惯(衔接 2.8 的枚举×模拟)
2.9.1 倍增(Doubling)
核心洞察:任何正整数都是若干 2 的幂之和
这是一个看似简单却威力巨大的事实:
13 = 8 + 4 + 1 = 2^3 + 2^2 + 2^0
5 = 4 + 1 = 2^2 + 2^0
10^18 ≈ 2^59.79 —— 最多 60 个 2 的幂就够了
换成算法语言:「走 k 步」可以拆成「走若干段,每段长度是 2 的幂」。比如「走 13 步」=「走 8 步 + 走 4 步 + 走 1 步」。
于是,如果一个问题满足两个条件:
- 可组合:「走 2^i 步」的结果能由「走 2^(i-1) 步」的结果算出来;
- 结合律:分段走的顺序拼接后效果与连走相同(或者说「走 a 步再走 b 步 = 走 a+b 步」);
那么只需要预处理出所有 2 的幂长度的「一步到位」信息(共 O(log k) 个),查询时按 k 的二进制分解拼起来,就能把 O(k) 的过程压缩到 O(log k)。
💡 一个直观比喻:你要坐地铁从 A 到 E 站。与其一站一站数,不如记住「从任何一站坐 1 站到哪、坐 2 站到哪、坐 4 站到哪……」。要坐 13 站?= 坐 8 站 + 坐 4 站 + 坐 1 站,查三次表就到。
统一视角:全书中的倍增应用
倍增在本书出现了很多次,长相各不相同,但骨架完全一样。请对照下表体会「同一思想、不同化身」:
| 应用 | 问题 | 预处理什么 | 查询怎么拼 |
|---|---|---|---|
| 快速幂(数论基础 8.1.2) | 计算 a^k mod p | 反复平方:a^1, a^2, a^4, a^8, … | k 的二进制位为 1 时,把对应的平方结果乘进答案 |
| LCA 倍增(二叉树与树 5.5.8) | 树上两点最近公共祖先 | up[j][v] = v 往上跳 2^j 步的祖先 | 两点先跳到同深度(按深度差的二进制分解),再从大幂到小幂一起往上跳 |
| 函数图跳 k 步(函数图与基环树 5.3.3) | 从 x 出发沿转移函数走 k 步到哪 | jump[j][x] = x 走 2^j 步后的位置 | k 的二进制位为 1 时,x = jump[j][x] |
| 树状数组倍增(树状数组 5.8) | 找前缀和达到某阈值的最小位置 | 利用 lowbit 天然的 2 的幂结构 | 从高位到低位试探:能跳就跳 |
它们的共同骨架是:
预处理:f[j][·] 由 f[j-1][·] 复合一次得到 // "跳 2^j 步 = 跳两次 2^(j-1) 步"
查询: 把 k 写成二进制,按位拼接 // "走 k 步 = 走若干段 2 的幂"
本章不重复各章的实现细节,只在下面用「跳 k 步」这个最纯粹的版本完整实战一遍——学会了它,其他版本只是换了个「步」的含义。
完整实战一:巨蟒跳格
回到开篇题目。从第 1 格到第 N 格,需要向前跨越的距离是 d = N - 1。每次跳的格数是 2 的幂,问最少几次。
关键转化:每次跳跃的长度是 2 的幂,而任何正整数 d 都能写成若干不同的 2 的幂之和(这正是二进制表示!)。那么最少步数是多少?
- 一种跳法对应一个「2 的幂的多重集」,其和为
d; - 如果允许重复(比如 8+1+1 凑 10),步数只会更多;
- 二进制表示给出了一种「每个幂最多用一次」的方案,它用的幂的个数 =
d的二进制中 1 的个数,这已经是最少的——因为k个 2 的幂(允许重复)相加,和的二进制中 1 的个数不会超过k(每合并两个相同的 2^i 就进位成一个 2^(i+1),个数不减、位数不增)。
结论:最少步数 = d = N - 1 的二进制表示中 1 的个数。
验证一下 N = 10:d = 9 = 8 + 1,二进制 1001,1 的个数为 2。也就是跳 8 格再跳 1 格(1 → 9 → 10),共 2 步。而「8+1+1」需要 3 步,不是最优。手算核对:✅。
#include <bits/stdc++.h>
using namespace std;
int main() {
long long n;
cin >> n;
long long d = n - 1; // 需要跨越的总距离
int steps = 0;
for (long long p = 1; p <= d; p <<= 1) // 从小幂到大幂逐一检查
if (d & p) steps++;
cout << steps << "\n";
return 0;
}
N = 10 输出 2;N = 10^18 时 d 约需 60 位二进制,循环也只有 60 次——O(log N),再大的 N 也不怕。
🤔 为什么不叫「DP」? 这里「贪心地从大幂到小幂凑」之所以对,是因为二进制表示的唯一性——每一步选择都是被迫的、无后悔的。识别「这道题其实是二进制」是本题真正的考点。
完整实战二:跳 k 步的倍增数组 f[j][x]
巨蟒跳格里「一步跳多远」由我们自己选。更一般的问题是:每步的走法是固定的(由题目给定的函数决定),要跳指定的 k 步。
设有一个函数图:n 个节点 1..n,每个节点 x 恰好一条出边指向 f(x)。问从 x 出发走 k 步到哪个节点(即求 f^k(x),函数的 k 次复合)。k 可以大到 10^9,一步步走太慢。
倍增做法:定义 f[j][x] = 从 x 出发走 2^j 步后所在的节点。则:
f[0][x] = f(x) // 走 1 步(题目给定)
f[j][x] = f[j-1][ f[j-1][x] ] // 走 2^j 步 = 先走 2^(j-1) 步,再走 2^(j-1) 步
查询时把 k 按二进制分解,每一位是 1 就跳一次:
#include <bits/stdc++.h>
using namespace std;
int main() {
int n = 6; // 节点 1..6
int nxt[7] = {0, 3, 1, 5, 2, 6, 3}; // 1->3, 2->1, 3->5, 4->2, 5->6, 6->3
const int LOG = 3; // 2^2=4 < 5 步 ≤ 2^3=8,够用
static int f[LOG][7];
for (int x = 1; x <= n; x++) f[0][x] = nxt[x];
for (int j = 1; j < LOG; j++)
for (int x = 1; x <= n; x++)
f[j][x] = f[j - 1][f[j - 1][x]];
int x = 1, k = 5; // 查询:从 1 出发走 5 步
for (int j = 0; k; j++, k >>= 1) // k=5=101₂:跳 1 步,再跳 4 步
if (k & 1) x = f[j][x];
cout << "f^5(1) = " << x << "\n";
return 0;
}
运行输出 f^5(1) = 5。手算核对:1 → 3 → 5 → 6 → 3 → 5,第 5 步确实到 5。✅
逐层看这个数组(建议在纸上自己推一遍):
| x | f[0][x](走 1 步) | f[1][x](走 2 步) | f[2][x](走 4 步) |
|---|---|---|---|
| 1 | 3 | 5 | 3 |
| 2 | 1 | 3 | 5 |
| 3 | 5 | 6 | 5 |
| 4 | 2 | 1 | 3 |
| 5 | 6 | 3 | 6 |
| 6 | 3 | 5 | 3 |
查询 k = 5 = 101₂ 时:第 0 位是 1 → x = f[0][1] = 3;第 2 位是 1 → x = f[2][3] = 5。两次跳表,代替五次模拟。
💡 什么时候用倍增? 检查两个条件:①「一步」可不可以复合(走两段 2^(j-1) 步 = 走 2^j 步);②复合是否满足结合律(先走 a 再走 b = 走 a+b)。树上的祖先关系、函数图的复合、矩阵乘法、取模乘法都满足。不满足的典型例子:带「途中不能经过某点」这类约束的路径,因为两段拼起来可能在中途违规——这时不能直接倍增。
🔗 延伸阅读:这个模型的完整竞赛版(含环、
k ≤ 10^9、判「最近公共后继」等)见函数图与基环树 5.3.3;树上版本(up[j][v]找祖先、求 LCA)见二叉树与树 5.5.8;乘法版本(快速幂)见数论基础 8.1.2。
2.9.2 构造(Constructive)
构造题长什么样
大多数题问「最优值是多少」或「有多少种方案」,构造题问的是:
- 「给出一组任意合法方案」——不要求最优,只要求合法;
- 「能否做到?若能,输出方案」——判定与构造二合一;
- 「构造一个满足某某性质的 X」——性质千奇百怪,但都要你亲手造出来。
构造题的难点在于:没有固定算法可套,每题像一道谜题。但也有章法可循——下面三条思路覆盖了大部分入手方向。
构造三思路
思路一:从特殊到一般。 先在纸上摆小样例(N=3、N=4 时手动画一画),找规律,再猜一般公式,最后证明或用暴力验证。绝大多数构造题的第一步都是画小样例——不画直接想,等于闭眼走路。
思路二:从下界反推。 如果题目隐含一个「不可能比 X 更好」的下界,而你能构造出恰好达到 X 的方案,那它就是最优的(这也是「证明最优」的标准姿势)。这一思路的系统讲解见Ad Hoc 题 7.3.5「下界 + 构造」。
思路三:逐步交换。 从一个显然合法但可能不满足额外要求的初始方案出发,每次用一个保持合法性的局部交换把它往目标推进(比如排序算法就是靠不断交换逆序对把任意排列变成有序排列)。交换的正当性需要交换论证支撑,深入内容见 Ad Hoc 7.3.9。
完整实战一:构造回文(思路:判定 + 直接摆放)
第一步——判定什么时候有解。 回文从左往右读和从右往左读相同,意味着除正中间的一个位置外,字母必须成对出现(第 i 位和倒数第 i 位相同)。所以:
- 统计 26 个字母的出现次数,出现奇数次的字母最多只能有 1 个(它独占正中间);
- 奇数次的字母 ≥ 2 个 →
NO SOLUTION。
第二步——构造。 把每个字母的一半从左到右摆好,中间放那个奇数字母(若有),右半镜像。
#include <bits/stdc++.h>
using namespace std;
int main() {
string s;
cin >> s;
int cnt[26] = {0};
for (char c : s) cnt[c - 'a']++;
int odd = 0; // 出现奇数次的字母个数
for (int i = 0; i < 26; i++)
if (cnt[i] % 2 == 1) odd++;
if (odd > 1) {
cout << "NO SOLUTION\n";
return 0;
}
string half = "", mid = "";
for (int i = 0; i < 26; i++) {
half += string(cnt[i] / 2, char('a' + i)); // 每个字母取一半
if (cnt[i] % 2 == 1) mid = char('a' + i); // 奇数字母放中间
}
string rev = half;
reverse(rev.begin(), rev.end());
cout << half + mid + rev << "\n";
return 0;
}
样例核对:aabbb → 计数 a:2, b:3,奇数字母只有 b,half = "ab",mid = "b",输出 abbba。验证:abbba 反转还是 abbba,是回文,且用的字母与输入完全一致。✅
abc → a:1, b:1, c:1,奇数字母 3 个 > 1 → NO SOLUTION。✅
注意两个工程细节:判定在前、构造在后(无解时不进入构造代码),以及 10^6 的长度用 std::string 拼接依然高效。
完整实战二:构造排列(思路:从特殊到一般 + 找规律)
📋 题目:美丽的排列 构造
1..N的一个排列p,使得任意相邻两个数的差的绝对值 ≥ 2。若不存在这样的排列,输出NO SOLUTION。1 ≤ N ≤ 10^6。
第一步——画小样例(思路一)。
N = 2:只有1 2和2 1,差都是 1 → 无解;N = 3:排列如1 3 2,|1-3|=2但|3-2|=1;枚举所有 6 个排列都有一条相邻差为 1 → 无解;N = 4:2 4 1 3→ 差依次为2, 3, 2✅;N = 5:在N=4的方案后面接 5?|3-5|=2✅,得2 4 1 3 5。
第二步——归纳规律。 「差为 1」只发生在相邻整数之间。如果把所有偶数排在前面、所有奇数排在后面:
- 偶数段内部:
2, 4, 6, …,相邻差为 2 ✅; - 奇数段内部:
…, 5, 3, 1,相邻差为 2 ✅; - 衔接处:最小的偶数 2 和最大的奇数
N-1(或反过来)差远大于 2 ✅。
偶数和奇数永不相邻产生差 1,而段内相邻差恰为 2——整个构造只有一种相邻关系需要检查(衔接处),其余由「隔一个数」天然保证。
第三步——小 N 的无解证明。 N = 2, 3 时无解:N=2 显然;N=3 时 2 必须夹在 1 和 3 之间以外的位置,但排列只有 3 个位置,1 和 3 必有一个与 2 相邻,差为 1。用 2.8 章的枚举(next_permutation)跑一遍也能确认。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
if (n == 1) { cout << 1 << "\n"; return 0; }
if (n <= 3) { cout << "NO SOLUTION\n"; return 0; }
for (int i = 2; i <= n; i += 2) cout << i << " "; // 先输出所有偶数
for (int i = 1; i <= n; i += 2) cout << i << " "; // 再输出所有奇数
cout << "\n";
return 0;
}
样例:N=6 → 2 4 6 1 3 5,差依次为 2 2 5 2 2,全部 ≥ 2。✅
构造题的检验:写完用小数据暴力验证
构造题的答案不唯一,评测用 special judge 检查合法性,所以你最大的风险是构造出非法方案而不自知。标准保险动作(衔接 2.8 章的「枚举 × 模拟」):
- 写一个
check()函数,模拟检验方案是否满足题目全部性质; - 对
N = 1到10的小数据,把构造输出喂给check();无解判断用next_permutation枚举全部方案对照。
// 以美丽的排列为例的验证器
bool check(const vector<int>& p) {
for (size_t i = 0; i + 1 < p.size(); i++)
if (abs(p[i] - p[i + 1]) < 2) return false;
return true;
}
用暴力枚举对拍 N ≤ 9 的所有情形:N=2, 3 确认无解,N ≥ 4 全部通过 check()——构造的正确性就不是「我觉得对」,而是「机器证明对」。这个习惯在考场上值一道题的分数。
⚠️ 常见错误
倍增类:
- 数组维度顺序写反:
f[j][x]的第一维是层数(2^j),第二维才是节点。写成f[x][j]后,f[j-1][f[j-1][x]]这类复合就会查错内存——症状是答案偶尔对偶尔错,极难排查。建议统一背下模板f[j][x]。 - LOG 开小了:
k ≤ 10^9需要LOG = 30(2^30 > 10^9),k ≤ 10^18需要 60。少开一位,大 k 直接越界或漏跳。反过来LOG开太大也浪费内存:f数组大小是LOG × N。 - 预处理边界:
j从 1 开始循环(j=0是题给的一步转移),且2^j不能超过 k 的上界。跳 LCA 时「先到同深度再一起跳」两阶段的顺序也不能反。
构造类:
- 忘记判无解:先判定、后构造。很多选手写完构造直接输出,忘了题目里「若不可能则输出 NO SOLUTION」——有解判定(如回文的奇偶性检查)必须写在构造之前。
- 构造完不验证:交之前用小数据跑一遍
check()。构造代码改动频繁,一处 off-by-one 可能让「任意合法方案」变成「非法方案」,而编译器和样例都不一定能发现。 - 把「任意方案」做成「最优方案」:构造题只要合法就行。为了「更漂亮」的输出去加复杂逻辑,只会引入新 bug——KISS(Keep It Simple)。
📝 本章总结
| 概念 | 一句话概括 | 关键条件/口诀 |
|---|---|---|
| 倍增核心 | 任何 k = 若干 2 的幂之和,跳 k 步 = 跳若干段 2^j | 可组合 + 结合律 |
| 预处理 | f[j][·] = f[j-1][·] 复合 f[j-1][·],O(N log k) | j 从 1 开始,j=0 是一步转移 |
| 查询 | 按 k 的二进制分解逐位跳,O(log k) | 每位是 1 才跳 |
| 快速幂 | 倍增的乘法版(8.1.2) | 反复平方 |
| LCA 倍增 | 倍增的树上版(5.5.8) | up[j][v] 跳祖先 |
| 函数图跳步 | 倍增的图上版(5.3.3) | jump[j][x] 走 k 步 |
| 构造·判定先行 | 先想清何时有解,再想怎么摆 | 无解输出别忘了 |
| 构造·三思路 | 特殊到一般 / 下界反推 / 逐步交换 | 第一步永远是画小样例 |
| 构造·验证 | 小数据暴力 check + 枚举对照 | 2.8 的枚举×模拟当免费对拍器 |
🏋️ 练习题
🟢 简单:巨蟒跳格·改 从第 1 格出发,每次可跳 1、2、4、… 格(2 的幂),问恰好跳到第
N格的方案数是多少?只需输出方案数模 10^9+7。(提示:N ≤ 10^6,想一想「每个 2 的幂用任意多次」时的递推——f[d] = f[d-1] + f[d-2] + f[d-4] + …,用后缀和优化到 O(N log N)。)
🟡 中等:走 k 步 给定
n个节点的函数图(每点恰一条出边)与q次查询,每次问「从x走k步到哪」,k ≤ 10^9。(直接使用本章 2.9.1 的f[j][x]模板,注意LOG=30。完整竞赛版见函数图与基环树 5.3.3。)
🔴 较难:回文重排·计数版 给定字符串
s,问有多少种本质不同的重排是回文(模 10^9+7)。(提示:若能构成回文,答案 = 多重集合排列数(L/2)! / ∏(c_i/2)!,乘法逆元见数论基础 8.1.3。先判定,再计数。)
下一章预告:第三部分将进入数据结构的世界——从数组与前缀和开始,你会看到「预处理 + 查询」这对思想的更多化身。
🏗️ 第三部分:核心数据结构
几乎出现在每一道 USACO Bronze 和 Silver 题目中的数据结构——前缀和、排序、双指针、栈、映射和线段树。
📚 10 章 · ⏱️ 预计 2-3 周 · 🎯 目标:解决 USACO Bronze 题目
第三部分:核心数据结构
预计用时:2-3 周
第三部分是竞赛编程开始变得有趣的地方。你将学习几乎出现在每一道 USACO Bronze 和 Silver 题目中的数据结构——以及能把 O(N²) 暴力解法变成 O(N) 优雅方案的技巧。
涵盖的主题
| 章节 | 主题 | 核心思想 |
|---|---|---|
| 第 3.1 章 | STL 核心用法 | 掌握强大的内置容器:sort、map、set、queue、stack |
| 第 3.2 章 | 数组与前缀和 | O(N) 预处理后,O(1) 回答区间求和查询 |
| 第 3.3 章 | 排序与搜索 | 排序 + 二分查找,把很多 O(N²) 问题变成 O(N log N) |
| 第 3.4 章 | 双指针与滑动窗口 | 用两个协调移动的指针高效处理子数组/对 |
| 第 3.6 章 | 单调栈与单调队列 | O(N) 求下一个更大元素、滑动窗口最大/最小值 |
| 第 3.5 章 | 栈、队列与双端队列 | LIFO/FIFO 处理的有序数据结构 |
| 第 3.7 章 | 哈希技术 | 快速键查找、多项式哈希、滚动哈希 |
| 第 3.8 章 | 映射与集合 | O(log N) 查找、唯一元素集合、频率统计 |
| 第 3.9 章 | 二分答案 | 把枚举答案转化为「猜+验证」的二分问题 |
💡 树形数据结构(二叉树、并查集、线段树、树状数组)已归入第五部分:图论算法(第 5.5~5.8 章)。
学完本部分后能解决什么问题
完成第三部分后,你将能够挑战:
-
USACO Bronze: 大多数 Bronze 题目使用第三部分的技术
- 区间查询(位置 L 到 R 之间 X 类型的奶牛有多少头?)
- 排序问题(最近点对、排名、调度)
- 频率统计(每个值出现多少次?)
- 栈相关问题(括号匹配、单调处理)
-
USACO Silver 入门:
- 二分答案(攻击性奶牛、绳子切割)
- 滑动窗口最大/最小值
- 差分数组实现区间更新
引入的关键算法
| 技术 | 章节 | USACO 相关度 |
|---|---|---|
| 一维前缀和 | 3.2 | 品种统计、区间查询 |
| 二维前缀和 | 3.2 | 网格上的矩形区域求和 |
| 差分数组 | 3.2 | 区间更新、单点查询 |
带自定义比较器的 std::sort | 3.3 | 几乎所有 Silver 题目 |
二分查找(lower_bound、upper_bound) | 3.3 | 计数、区间查询 |
| 二分答案 | 3.3 | 攻击性奶牛、画家分区 |
| 单调栈 | 3.5 | 下一个更大元素、直方图 |
| 滑动窗口(单调队列) | 3.5 | 窗口最小/最大值 |
频率映射(unordered_map) | 3.7 | 统计出现次数 |
| 有序集合操作 | 3.8 | 第 K 小元素、区间查询 |
本部分学习建议
- 第 3.2 章(前缀和) 是 Bronze 中测试最频繁的技术。确保你能在 5 分钟内从零实现它。
- 第 3.3 章(二分查找) 介绍「二分答案」——这是 Silver 级别的技术,是普通解法和优秀解法的分水岭。
- 不要跳过练习题。 每章的练习题都是专门为培养所需直觉而精选的。
- 完成第 3.3 章后,你已经具备解决大多数 USACO Bronze 题目的工具。在继续学习前,尝试解 5-10 道 Bronze 题目。
🏆 USACO 技巧: 在 USACO Bronze 级别,最常用的技术是:模拟(第 2.1–2.3 章)、排序(第 3.3 章)和前缀和(第 3.2 章)。掌握这三项,几乎可以解决任何 Bronze 题目。
出发!
第 3.1 章:STL 核心用法
3.1.0a 从一道题出发:用最短的代码解最多的题
竞赛编程有个残酷的现实:一道 Silver 题 4 小时限时,但通常只有 15 分钟留给你「想清楚用什么数据结构」。看这道题——几乎所有 Silver 考点的浓缩:
🐄 题目:奶牛排行榜 有
N(N ≤ 10⁵)头奶牛,每头有产奶量m_i和品种b_i。 请依次回答:
- 把奶牛按产奶量从高到低排名次(并列同名次);
- 有多少个不同品种?
- 每个品种的总产量各是多少(品种名是字符串,如 "Holstein")?
- 任何时刻查询「当前产量最高的品种是哪个」——而且产量会实时更新。
先试试你会的方法
用第 2 章的知识硬写:
- 第 1 问:手写排序?自己实现快排/归并,比赛现场写错一个边界就全盘皆输。
- 第 2 问:对每个品种遍历整个数组查重?O(N²) 在 N=10⁵ 时超时。
- 第 3 问:品种是字符串——
int milk[品种]?字符串做不了数组下标! - 第 4 问:每次查询扫一遍所有品种找最大?查询很多次时又超时。
四问全是「数据组织」问题,而不是「算法」问题。而 C++ 早就把答案造好了:
| 问题 | 手写的困境 | STL 一行解法 |
|---|---|---|
| 1 | 手写快排易错 | sort(v.begin(), v.end(), cmp) |
| 2 | O(N²) 查重 | 插入 set,最后 set.size() |
| 3 | 字符串不能做下标 | map<string, int> |
| 4 | 每次扫描 O(N) | priority_queue,O(log N) 取最值 |
标准模板库(STL)就是 C++ 内置的现成数据结构和算法集合——快速、可靠、经数百万程序员检验。竞赛里「选对 STL 容器」经常就是解题的一半。
拆解这道题需要回答的问题
每种工具对应排行榜的一道子问题,本章逐一展开:
| 小节 | 工具 | 对应子问题 |
|---|---|---|
| 3.1.1 | sort | 第 1 问:排序 |
| 3.1.2 | pair | 排序时的捆绑(产量 + 编号) |
| 3.1.3 | map | 第 3 问:字符串做下标 |
| 3.1.4 | set | 第 2 问:去重 |
| 3.1.5–3.1.6 | stack / queue | 经典算法的地基(后续 BFS 用) |
| 3.1.7 | priority_queue | 第 4 问:动态最值 |
| 3.1.8+ | unordered_map / STL 算法 | 更快的查找与一行操作 |
3.1.0b STL 工具箱
把 STL 想象成一个工具箱,每种工具都为特定任务设计:

快速参考——该用哪个容器:
| 需求 | 使用 |
|---|---|
| 有序列表,随机访问 | vector |
| 两个值捆绑在一起 | pair |
| 键 → 值映射(有序) | map |
| 唯一元素(有序) | set |
| 键 → 值映射(快速,无序) | unordered_map |
| 唯一元素(快速,无序) | unordered_set |
| LIFO(后进先出) | stack |
| FIFO(先进先出) | queue |
| 快速获取最大/最小值 | priority_queue |
选对工具 = 竞赛编程中解题的一半!
「该用哪个容器?」决策树

图示:STL 容器概览

3.1.1 sort —— 你唯一需要的排序
我们从 sort 开始,因为几乎每道题都会用到它。
是什么,为什么重要
排序将元素序列重新排列成有序状态。不用自己实现排序算法(容易出错且费时),C++ 的 sort 具有以下特点:
- 快速:O(N log N) —— 基于比较的排序的理论最优
- 易用:一行代码
- 灵活:按任意你定义的规则排序
⚠️ 重要:
sort需要#include <algorithm>(通过#include <bits/stdc++.h>自动包含)。
#include <bits/stdc++.h>
using namespace std;
int main() {
// 对向量排序——升序(默认)
vector<int> v = {5, 2, 8, 1, 9, 3};
sort(v.begin(), v.end());
// v 现在是:{1, 2, 3, 5, 8, 9}
for (int x : v) cout << x << " ";
cout << "\n";
// 降序排序
sort(v.begin(), v.end(), greater<int>());
// v 现在是:{9, 8, 5, 3, 2, 1}
// 对数组排序
int arr[] = {4, 2, 7, 1, 5};
int n = 5;
sort(arr, arr + n); // 排序 arr[0..n-1]
// arr 现在是:{1, 2, 4, 5, 7}
return 0;
}
自定义排序(Lambda 函数)
如果想按非自然顺序排序?用 lambda —— 一个小的内联函数:
vector<int> v = {5, -3, 2, -8, 1};
// 按绝对值排序
sort(v.begin(), v.end(), [](int a, int b) {
return abs(a) < abs(b); // a 应该排在 b 前面时返回 true
});
// v 现在是:{1, 2, -3, 5, -8}(按 |值| 排序)
lambda [](int a, int b) { return ...; } 是比较规则。当 a 应该排在 b 前面时返回 true。
🐛 常见错误: 当
a == b时永远不要返回true——这违反了「严格弱序」规则,会导致未定义行为(崩溃或错误答案)。始终用<或>,绝不用<=或>=。
// 对 pair 向量排序:按第二元素降序,相同时按第一元素升序
vector<pair<int,int>> pts = {{3,5},{1,7},{2,5},{4,3}};
sort(pts.begin(), pts.end(), [](pair<int,int> a, pair<int,int> b) {
if (a.second != b.second) return a.second > b.second; // 第二元素更大的优先
return a.first < b.first; // 打平:第一元素更小的优先
});
// 结果:{1,7}, {2,5}, {3,5}, {4,3}
3.1.2 pair —— 把两个值存在一起
pair 将两个值捆绑成一个对象,可以理解为两个值的「迷你结构体」。
为什么用 pair? 经常需要把两个相关的值放在一起——比如(值,下标)、(x 坐标,y 坐标)、(成绩,姓名)。pair 能简洁地做到这点。
#include <bits/stdc++.h>
using namespace std;
int main() {
// 创建 pair
pair<int, int> point = {3, 5}; // (x, y)
pair<string, int> student = {"Alice", 95}; // (姓名, 成绩)
// 访问元素:.first 和 .second
cout << point.first << " " << point.second << "\n"; // 3 5
cout << student.first << ": " << student.second << "\n"; // Alice: 95
// pair 支持比较:先比较 .first,相同时比较 .second
pair<int,int> a = {1, 3};
pair<int,int> b = {1, 5};
cout << (a < b) << "\n"; // 1(真)—— .first 相同,比较 .second:3 < 5
// 非常常见的模式:用 pair 按第二元素排序
vector<pair<int,int>> v = {{3,9},{1,2},{4,1},{1,5}};
sort(v.begin(), v.end()); // 先按 .first 排序,再按 .second 排序
// 结果:{1,2}, {1,5}, {3,9}, {4,1}
return 0;
}
⚡ 专业技巧: 需要按某个值排序但又想保留原始下标时,把它们存成
pair<值, 下标>后排序。排序后.second就是原始下标。
💡
make_pairvs 花括号:make_pair(3, 5)和{3, 5}都能创建 pair。花括号语法{3, 5}更短,是现代 C++(C++11 及以后)的首选方式。
3.1.3 map —— 字典
map 存储键值对,就像真正的字典:给定一个单词(键),查找它的定义(值)。每个键最多出现一次。
什么时候用 map
- 频率统计:单词 → 计数,成绩 → 频率
- ID 映射到名字:学生 ID → 姓名
- 存储属性:奶牛名字 → 产奶量
#include <bits/stdc++.h>
using namespace std;
int main() {
map<string, int> phoneBook;
// 插入键值对
phoneBook["Alice"] = 555001;
phoneBook["Bob"] = 555002;
phoneBook["Charlie"] = 555003;
// 按键查找
cout << phoneBook["Alice"] << "\n"; // 555001
// 遍历(始终按键的**排序顺序**!)
for (auto& entry : phoneBook) {
cout << entry.first << " -> " << entry.second << "\n";
}
// 打印:
// Alice -> 555001
// Bob -> 555002
// Charlie -> 555003
// 删除键
phoneBook.erase("Charlie");
cout << phoneBook.size() << "\n"; // 2
return 0;
}
常用操作及时间复杂度
| 操作 | 代码 | 时间 |
|---|---|---|
| 插入/更新 | m[key] = value | O(log n) |
| 查找 | m[key] 或 m.at(key) | O(log n) |
| 检查是否存在 | m.count(key) 或 m.find(key) | O(log n) |
| 删除 | m.erase(key) | O(log n) |
| 大小 | m.size() | O(1) |
| 遍历全部 | 范围 for | O(n) |
🐛 map 访问陷阱
这是 map 最常见的 bug 之一:
map<string, int> freq;
// 危险:访问不存在的键会以值 0 创建它!
cout << freq["apple"] << "\n"; // 打印 0,但现在 "apple" 已经在 map 里了!
cout << freq.size() << "\n"; // 1——即使我们只是「查了一下」,并没有「插入」!
// 安全方式一:先检查 count
if (freq.count("apple") > 0) {
cout << freq["apple"] << "\n"; // 安全——键已存在
}
// 安全方式二:用 .find()
auto it = freq.find("apple");
if (it != freq.end()) { // .end() 表示「未找到」
cout << it->second << "\n"; // it->second 是值
}
频率统计——最常见的 map 模式
vector<string> words = {"apple", "banana", "apple", "cherry", "banana", "apple"};
map<string, int> freq;
for (const string& w : words) {
freq[w]++; // 如果 "w" 不存在,以 0 创建,然后递增为 1
}
// freq: apple→3, banana→2, cherry→1
for (auto& p : freq) {
cout << p.first << " 出现了 " << p.second << " 次\n";
}
💡 为什么
freq[w]++对新键也有效:map对缺失的值进行默认初始化。对int来说默认值是0。所以访问新键会以值0创建它,然后++使其变为1。这是故意设计的,广泛用于计数。
3.1.4 set —— 唯一有序集合
set 以有序状态存储唯一元素。插入重复值——会被悄悄忽略。
什么时候用 set
- 去除列表中的重复项
- 快速检查成员资格:「我见过这个值吗?」
- 获取动态集合的最小/最大值
#include <bits/stdc++.h>
using namespace std;
int main() {
set<int> s;
s.insert(5);
s.insert(2);
s.insert(8);
s.insert(2); // 重复——被忽略!set 仍是 {2, 5, 8}
s.insert(1);
// s 现在是:{1, 2, 5, 8}(自动排序,无重复)
// 检查成员资格
cout << s.count(2) << "\n"; // 1(存在)
cout << s.count(7) << "\n"; // 0(不存在)
// 删除
s.erase(2); // s = {1, 5, 8}
// 遍历(始终排序)
for (int x : s) cout << x << " ";
cout << "\n"; // 1 5 8
// 最小值和最大值
cout << *s.begin() << "\n"; // 1(最小;* 解引用迭代器)
cout << *s.rbegin() << "\n"; // 8(最大;r = 反向)
cout << s.size() << "\n"; // 3
return 0;
}
常用操作及时间复杂度
| 操作 | 代码 | 时间 |
|---|---|---|
| 插入 | s.insert(x) | O(log n) |
| 检查是否存在 | s.count(x) 或 s.find(x) | O(log n) |
| 删除 | s.erase(x) | O(log n) |
| 最小值 | *s.begin() | O(1) |
| 最大值 | *s.rbegin() | O(1) |
| 大小 | s.size() | O(1) |
用 set 去重
vector<int> v = {3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5};
set<int> unique_set(v.begin(), v.end()); // 从向量构建 set
// unique_set = {1, 2, 3, 4, 5, 6, 9}
cout << "唯一值个数:" << unique_set.size() << "\n"; // 7
// 如需转回排序向量:
vector<int> deduped(unique_set.begin(), unique_set.end());
💡
setvsmultiset:set每个值最多存一次。如果需要存重复值但仍想保持有序,用multiset<int>—— 它允许重复元素。
3.1.5 stack —— 后进先出
栈就像一叠盘子:你只能在顶部添加或移除。最后加入的最先被移除(LIFO:Last In, First Out,后进先出)。
什么时候用 stack
- 括号匹配
- 撤销/重做历史
- 深度优先搜索(DFS)——后续章节讲解
- 反转序列
#include <bits/stdc++.h>
using namespace std;
int main() {
stack<int> st;
st.push(1); // [1] (顶部在右侧)
st.push(2); // [1, 2]
st.push(3); // [1, 2, 3]
cout << st.top() << "\n"; // 3(查看顶部,不移除)
st.pop(); // 移除顶部 → [1, 2]
cout << st.top() << "\n"; // 2
cout << st.size() << "\n"; // 2
cout << st.empty() << "\n"; // 0(不为空)
return 0;
}
常用操作及时间复杂度
| 操作 | 代码 | 时间 |
|---|---|---|
| 压入顶部 | st.push(x) | O(1) |
| 弹出顶部 | st.pop() | O(1) |
| 查看顶部 | st.top() | O(1) |
| 检查是否为空 | st.empty() | O(1) |
| 大小 | st.size() | O(1) |
🐛 常见栈错误:不检查就弹出
stack<int> st;
// st.top(); // 崩溃!不能查看空栈的顶部
// st.pop(); // 崩溃!不能从空栈弹出
// 访问前始终检查:
if (!st.empty()) {
cout << st.top() << "\n";
st.pop();
}
经典栈问题:括号匹配
string expr = "((a+b)*(c-d))";
stack<char> parens;
bool balanced = true;
for (char ch : expr) {
if (ch == '(') {
parens.push(ch); // 开括号:压栈
} else if (ch == ')') {
if (parens.empty()) { // 闭括号但没有对应的开括号
balanced = false;
break;
}
parens.pop(); // 找到匹配:弹出开括号
}
}
if (!parens.empty()) balanced = false; // 还有未匹配的开括号
cout << (balanced ? "匹配" : "不匹配") << "\n";
3.1.6 queue —— 先进先出
队列就像商店排队:你从后面加入,从前面离开。第一个加入的最先被服务(FIFO:First In, First Out,先进先出)。
什么时候用 queue
- 模拟顾客、进程、任务的排队
- 广度优先搜索(BFS)—— 竞赛编程中最重要的算法之一(第 5.2 章)
- 按到达顺序处理元素
#include <bits/stdc++.h>
using namespace std;
int main() {
queue<int> q;
q.push(10); // [10]
q.push(20); // [10, 20]
q.push(30); // [10, 20, 30]
cout << q.front() << "\n"; // 10(排在最前——最先离开)
cout << q.back() << "\n"; // 30(排在最后——最后离开)
q.pop(); // 从前面移除 → [20, 30]
cout << q.front() << "\n"; // 20
cout << q.size() << "\n"; // 2
return 0;
}
常用操作及时间复杂度
| 操作 | 代码 | 时间 |
|---|---|---|
| 加入队尾 | q.push(x) | O(1) |
| 从队首移除 | q.pop() | O(1) |
| 查看队首 | q.front() | O(1) |
| 查看队尾 | q.back() | O(1) |
| 检查是否为空 | q.empty() | O(1) |
注意: 第 5.2 章中你会大量用到
queue来实现 BFS —— USACO 中最重要的图算法之一。
🐛 常见错误:
queue没有top()方法(那是stack的)。用front()查看队首元素,用back()查看队尾。
3.1.7 priority_queue —— 堆
priority_queue 就像一个魔法队列:无论以什么顺序插入,它总是先给你最大的元素(默认最大堆)。
什么时候用 priority_queue
- 需要快速获取最大(或最小)元素
- 找第 K 大的数
- Dijkstra 最短路算法(第 5.4 章)
- 每次都处理「最优」元素的贪心算法
#include <bits/stdc++.h>
using namespace std;
int main() {
// 最大堆:始终给你最大值
priority_queue<int> maxPQ;
maxPQ.push(5);
maxPQ.push(1);
maxPQ.push(8);
maxPQ.push(3);
// 按降序弹出
while (!maxPQ.empty()) {
cout << maxPQ.top() << " "; // 始终是当前最大值
maxPQ.pop();
}
cout << "\n"; // 打印:8 5 3 1
return 0;
}
🐛 最小堆陷阱
默认情况下,priority_queue 是最大堆(优先给最大值)。要创建最小堆(优先给最小值),需要特殊语法:
// 最大堆(默认)——优先给最大值
priority_queue<int> maxPQ;
// 最小堆——优先给最小值(注意额外的模板参数!)
priority_queue<int, vector<int>, greater<int>> minPQ;
minPQ.push(5);
minPQ.push(1);
minPQ.push(8);
minPQ.push(3);
while (!minPQ.empty()) {
cout << minPQ.top() << " ";
minPQ.pop();
}
// 打印:1 3 5 8(最小值优先)
常用操作及时间复杂度
| 操作 | 代码 | 时间 |
|---|---|---|
| 插入 | pq.push(x) | O(log n) |
| 获取最大/最小值 | pq.top() | O(1) |
| 移除最大/最小值 | pq.pop() | O(log n) |
| 检查是否为空 | pq.empty() | O(1) |
💡 含 pair 的优先队列: 可以在优先队列中存储
pair<int, int>,先比较.first再比较.second——用于 Dijkstra 算法存储{距离, 节点}时非常有用。priority_queue<pair<int,int>, vector<pair<int,int>>, greater<pair<int,int>>> minPQ; // (距离, 节点) 对的最小堆——用于 Dijkstra
3.1.8 unordered_map 和 unordered_set —— 基于哈希的速度
普通 map 和 set 是有序的(内部使用平衡二叉搜索树),操作是 O(log N)。unordered_ 变体使用哈希表,平均 O(1) —— 更快,但没有顺序保证。
unordered_map<string, int> freq;
freq["apple"]++;
freq["banana"]++;
freq["apple"]++;
cout << freq["apple"] << "\n"; // 2(与 map 接口相同)
unordered_set<int> seen;
seen.insert(5);
seen.insert(10);
cout << seen.count(5) << "\n"; // 1(找到)
cout << seen.count(7) << "\n"; // 0(未找到)
📌 深入内容在 3.7 章:
map为什么 O(log N)、unordered_map为什么平均 O(1)、两者如何选型、以及竞赛中防止unordered_map被针对性数据「hack」成 O(N) 的自定义哈希写法——这些原理与实践统一放在第 3.7 章:哈希技术。本节只需要知道:unordered_变体更快,接口与map/set完全相同,可以直接替换使用。
3.1.9 auto 关键字和范围 for
C++ 通常能自动推断变量的类型。auto 关键字告诉编译器:「你来决定类型。」
auto x = 42; // x 是 int
auto y = 3.14; // y 是 double
auto v = vector<int>{1, 2, 3}; // v 是 vector<int>
map<string, int> freq;
auto it = freq.find("cat"); // 类型本应是 map<string,int>::iterator——很长!
// auto 省去了写这么长类型名的麻烦
⚠️
auto陷阱:auto在编译时推断类型——它不会让变量变成动态类型。另外,auto x = 1000000000 * 2;会推断出int并可能溢出;写auto x = 1000000000LL * 2;才能得到long long。
范围 for
对任何容器的简洁遍历:
vector<int> nums = {10, 20, 30, 40, 50};
// 只读遍历(复制每个元素——对 int 没问题,对 string 浪费)
for (int x : nums) {
cout << x << " ";
}
// 引用:不复制,可修改元素
for (int& x : nums) {
x *= 2; // 就地翻倍每个元素
}
// const 引用:不复制,只读(大类型的最佳方式)
for (const auto& x : nums) {
cout << x << " ";
}
范围 for 经验法则:
- 小类型(
int、char):for (int x : v)—— 复制没问题 - 大类型(
string、pair、struct):for (const auto& x : v)—— 避免复制 - 需要修改:
for (auto& x : v)
3.1.10 常用 STL 算法
<algorithm> 和 <numeric> 中的这些函数适用于任何序列:
#include <bits/stdc++.h>
using namespace std;
int main() {
vector<int> v = {3, 1, 4, 1, 5, 9, 2, 6};
// 升序排序
sort(v.begin(), v.end());
// v = {1, 1, 2, 3, 4, 5, 6, 9}
// 二分查找(只能用于**已排序**的序列!)
cout << binary_search(v.begin(), v.end(), 5) << "\n"; // 1(找到)
cout << binary_search(v.begin(), v.end(), 7) << "\n"; // 0(未找到)
// lower_bound:第一个 >= 目标值的位置
auto it = lower_bound(v.begin(), v.end(), 4);
cout << *it << "\n"; // 4
cout << (it - v.begin()) << "\n"; // 下标:3
// upper_bound:第一个 > 目标值的位置
auto it2 = upper_bound(v.begin(), v.end(), 4);
cout << (it2 - v.begin()) << "\n"; // 下标:4(第一个 > 4 的元素)
// [lo, hi] 范围内的元素个数:upper_bound(hi+1) - lower_bound(lo)
// 最小值和最大值
cout << *min_element(v.begin(), v.end()) << "\n"; // 1
cout << *max_element(v.begin(), v.end()) << "\n"; // 9
// 所有元素之和
long long total = accumulate(v.begin(), v.end(), 0LL);
cout << total << "\n"; // 31
// 统计出现次数
cout << count(v.begin(), v.end(), 1) << "\n"; // 2
// 反转
reverse(v.begin(), v.end());
// 用一个值填充
fill(v.begin(), v.end(), 0); // 全为零
return 0;
}
3.1.11 综合示例:词频统计器
让我们写一个综合运用 map、vector 和 sort 的完整小程序。
问题: 读取 N 个单词,统计每个单词出现次数,然后打印:
- 所有单词及其计数(按字母顺序)
- 出现次数最多的单词
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
// 第一步:用 map 统计词频
map<string, int> freq;
for (int i = 0; i < n; i++) {
string word;
cin >> word;
freq[word]++; // 如果 word 是新的,以 0 创建,然后递增
}
// 第二步:按字母顺序打印所有单词(map 按键有序迭代)
cout << "所有单词:\n";
for (auto& entry : freq) {
// entry.first = 单词,entry.second = 计数
cout << entry.first << ": " << entry.second << "\n";
}
// 第三步:找最频繁的单词
// 对 map 用 max_element:按值(.second)比较
auto best = max_element(
freq.begin(),
freq.end(),
[](const pair<string,int>& a, const pair<string,int>& b) {
return a.second < b.second; // 按计数比较
}
);
cout << "\n最频繁的:\"" << best->first << "\"(出现了 "
<< best->second << " 次)\n";
return 0;
}
样例输入:
10
the cat sat on the mat the cat sat on
样例输出:
所有单词:
cat: 2
mat: 1
on: 2
sat: 2
the: 3
最频繁的:"the"(出现了 3 次)
复杂度分析:
- 时间:O(N log N)——每次
freq[word]++是 O(log N),共 N 次;max_element遍历 map 是 O(M),M 为不重复单词数- 空间:O(M)——map 存储 M 个不重复单词
🤔 为什么遍历
map是字母顺序?map内部使用平衡 BST,保持键有序。遍历时自动按键的有序顺序输出——无需额外排序!
💡 寻找最大值的替代方案: 除了在 map 上用
max_element,也可以把条目转移到vector<pair<string,int>>,按.second降序排序,取第一个元素。两种方法在计数后都是 O(M)。
本章总结
📌 核心要点
| 容器 | 描述 | 关键操作 | 时间 | 为什么重要 |
|---|---|---|---|---|
vector<T> | 动态数组 | push_back、[]、size | O(1) 均摊 | 最常用容器,默认选择 |
pair<A,B> | 存储两个值 | .first、.second | O(1) | 图的边、坐标等 |
map<K,V> | 有序键值对 | []、find、count | O(log n) | 频率统计、有序映射 |
set<T> | 有序唯一集合 | insert、count、erase | O(log n) | 去重、范围查询 |
stack<T> | 后进先出 | push、pop、top | O(1) | 括号匹配、DFS |
queue<T> | 先进先出 | push、pop、front | O(1) | BFS、模拟 |
priority_queue<T> | 最大堆 | push、pop、top | O(log n) | 贪心最大/最小、Dijkstra |
unordered_map<K,V> | 哈希映射(无序) | []、find、count | O(1) 均摊 | 大数据快速查找 |
unordered_set<T> | 哈希集合(无序) | insert、count、erase | O(1) 均摊 | 快速成员检查、去重 |
❓ 常见问题
Q1:vector 和普通数组有什么区别?什么时候用哪个?
A:
vector可以动态增长(push_back),知道自己的大小(.size()),可以安全传给函数。普通数组大小固定,但稍快(全局数组自动初始化为 0)。竞赛中大多数情况用vector;全局大数组(如int dp[100001])有时更方便。
Q2:什么时候选 map vs unordered_map?
A:只需查找/插入/删除时,用
unordered_map(O(1))更快。需要有序遍历或lower_bound/upper_bound时,用map(O(log N))。没有特殊要求的竞赛中,map更安全(不会被 hack)。
Q3:priority_queue 默认是最大堆还是最小堆?
A:最大堆。
pq.top()返回最大元素。最小堆需要声明为priority_queue<int, vector<int>, greater<int>>。
Q4:什么时候自定义 struct 比 pair 更好?
A:
pair的.first/.second可读性差——三个月后你可能忘了.first代表什么。struct让你给成员起有意义的名字(如.weight、.value)。字段有 3 个或以上时,必须用struct。
Q5:为什么对 vector<pair<int,int>> 排序时先按 .first?
A:
pair有内置的operator<,先比较.first,相同时比较.second。这叫字典序——与字典中单词的排序方式相同。可以放心依赖这个行为,无需自定义比较器。
Q6:s.count(x) 和 s.find(x) != s.end() 对于 set 有什么区别?
A:对
set和map,两者都是 O(log N),在检查存在性方面功能等价。count返回 0 或 1(集合无重复),find返回一个可以直接访问元素的迭代器。需要读取值时用find,只需是/否检查时用count。
🔗 与后续章节的联系
- 第 3.4 章(单调栈与单调队列):用于下一个更大元素问题的单调栈;用于滑动窗口最大/最小的单调双端队列
- 第 3.5 章(栈与队列):深入探讨
stack和queue的算法应用——括号匹配、BFS - 第 3.8 章(映射与集合):
map/set的进阶用法——频率统计、multiset - 第 3.3 章(排序):带自定义比较器的
sort与vector和pair一起使用 priority_queue在第 4 部分(贪心)和第 5.5 章(Kruskal MST)中频繁出现- 本章的 STL 容器是本书所有后续章节的基础工具
练习题
热身 3.1.1 — 集合成员查询
读取 N 个整数,然后读取 Q 个查询。对每个查询读取一个整数,若它出现在原始 N 个整数中打印 YES,否则打印 NO。
数据规模: 1 ≤ N, Q ≤ 10⁵,-10⁹ ≤ 整数 ≤ 10⁹。
样例输入:
5
10 20 30 40 50
3
20
35
50
样例输出:
YES
NO
YES
思路: 把 N 个整数存入集合,对每个查询检查 s.count(x)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
set<int> s;
for (int i = 0; i < n; i++) {
int x;
cin >> x;
s.insert(x);
}
int q;
cin >> q;
while (q--) {
int x;
cin >> x;
cout << (s.count(x) ? "YES" : "NO") << "\n";
}
return 0;
}
关键点:
s.count(x)找到时返回 1,未找到时返回 0while (q--)是常见惯用法:循环执行 q 次(每次 q 递减)- 使用 set 每次查询 O(log N),比线性搜索 O(N) 快得多
热身 3.1.2 — 字符频率 读取一个字符串(无空格),按字母顺序打印其中每个字符及其出现次数。
数据规模: 1 ≤ 字符串长度 ≤ 10⁶,由大小写字母组成。
样例输入: hello
样例输出:
e: 1
h: 1
l: 2
o: 1
思路: 用 map<char, int> 统计字符频率,遍历 map 自动按字母顺序输出。
#include <bits/stdc++.h>
using namespace std;
int main() {
string s;
cin >> s;
map<char, int> freq;
for (char c : s) {
freq[c]++;
}
for (auto& entry : freq) {
cout << entry.first << ": " << entry.second << "\n";
}
return 0;
}
关键点:
for (char c : s)遍历字符串中的每个字符freq[c]++第一次访问时以值 0 创建条目,然后递增- map 遍历始终按键有序——字符自动按字母顺序输出
热身 3.1.3 — 栈实现反转
读取一个字符串(无空格),用 stack 将其反转打印。
数据规模: 1 ≤ 字符串长度 ≤ 10⁶,由大小写字母组成。
样例输入: hello → 样例输出: olleh
思路: 把每个字符压栈,然后全部弹出——LIFO 顺序正好是倒序。
#include <bits/stdc++.h>
using namespace std;
int main() {
string s;
cin >> s;
stack<char> st;
for (char c : s) {
st.push(c);
}
while (!st.empty()) {
cout << st.top();
st.pop();
}
cout << "\n";
return 0;
}
关键点:
- 栈的 LIFO 特性:最后压入的最先弹出 = 反转
- 访问
st.top()或调用st.pop()前始终检查!st.empty() - 注意:
reverse(s.begin(), s.end()); cout << s;更简单——但用栈实现能理解概念
热身 3.1.4 — 队列模拟 模拟 5 人排队:Alice、Bob、Charlie、Dave、Eve,按顺序加入。逐一服务(从队首弹出),打印每位被服务者的名字。
期望输出:
Serving: Alice
Serving: Bob
Serving: Charlie
Serving: Dave
Serving: Eve
思路: 把所有名字加入队列,然后逐一弹出并打印直到队列为空。
#include <bits/stdc++.h>
using namespace std;
int main() {
queue<string> line;
line.push("Alice");
line.push("Bob");
line.push("Charlie");
line.push("Dave");
line.push("Eve");
while (!line.empty()) {
cout << "Serving: " << line.front() << "\n";
line.pop();
}
return 0;
}
关键点:
queue.front()不移除地访问第一个元素queue.pop()移除队首元素(无返回值——如需值,在pop()前用front())- 队列保持插入顺序——先压入的先弹出
热身 3.1.5 — 前 3 大
读取 N 个整数,用 priority_queue 找出并打印最大的 3 个值(降序)。
数据规模: 1 ≤ N ≤ 10⁶,-10⁹ ≤ 整数 ≤ 10⁹(保证 N ≥ 3 时才有 3 个输出,代码对 N < 3 安全)。
样例输入:
7
5 1 9 3 7 2 8
样例输出:
9
8
7
思路: 全部压入最大堆优先队列,弹出 3 次得到最大的 3 个。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
priority_queue<int> pq;
for (int i = 0; i < n; i++) {
int x;
cin >> x;
pq.push(x);
}
for (int i = 0; i < 3 && !pq.empty(); i++) {
cout << pq.top() << "\n";
pq.pop();
}
return 0;
}
关键点:
priority_queue<int>是最大堆——top()始终给出最大值- 弹出 3 次按顺序得到最大的 3 个值
&& !pq.empty()防卫处理 N < 3 的边界情况
题目 3.1.6 — 唯一元素 读取 N 个整数,只打印唯一的值,按它们第一次出现的顺序(不排序)。一个值出现多次时,只在第一次出现时打印。
数据规模: 1 ≤ N ≤ 10⁶,-10⁹ ≤ 整数 ≤ 10⁹。
样例输入:
8
3 1 4 1 5 9 2 6
样例输出: 3 1 4 5 9 2 6
(注意:1 出现两次,但只在第一次位置打印一次。)
思路: 用 unordered_set 追踪已见过的值。对每个元素,只有还没见过时才打印。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
unordered_set<int> seen;
bool first = true;
for (int i = 0; i < n; i++) {
int x;
cin >> x;
if (seen.count(x) == 0) { // 还没见过 x
seen.insert(x);
if (!first) cout << " ";
cout << x;
first = false;
}
}
cout << "\n";
return 0;
}
关键点:
- 不能用普通
set,因为 set 会排序输出——我们要保持原始顺序 unordered_set提供 O(1) 均摊查找:比搜索向量快得多first标志处理间隔(不打印前导/尾随空格)
题目 3.1.7 — 出现最多的单词 读取 N 个单词,打印出现次数最多的单词。如果有平局,打印字典序最小的单词。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ 单词长度 ≤ 20,由小写字母组成。
样例输入:
7
apple banana apple cherry banana apple cherry
样例输出: apple
思路: 用 map 统计计数,然后找最大计数。在所有出现该最大计数的单词中,取字典序最小的(map 遍历自然给出)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
map<string, int> freq;
for (int i = 0; i < n; i++) {
string w;
cin >> w;
freq[w]++;
}
string bestWord;
int bestCount = 0;
// map 按字母顺序迭代——最先见到的达到最大计数的单词胜出
for (auto& entry : freq) {
if (entry.second > bestCount) {
bestCount = entry.second;
bestWord = entry.first;
}
}
cout << bestWord << "\n";
return 0;
}
关键点:
- 用
>(严格大于)意味着我们保留第一个达到最大计数的单词 - 由于
map按字母顺序迭代,第一个见到的最大计数单词就是字典序最小的 - 得益于 map 的有序特性,平局处理自动完成
题目 3.1.8 — 配对求和 读取 N 个整数和目标 T。对于每对值 (a, b),a 在输入中排在 b 前面且 a + b = T,打印该对。用集合实现 O(N) 解法。
数据规模: 1 ≤ N ≤ 10⁵,-10⁹ ≤ 整数 ≤ 10⁹,-2×10⁹ ≤ T ≤ 2×10⁹(O(N²) 将超时)。
样例输入:
6 9
1 8 3 6 4 5
样例输出:
1 8
3 6
4 5
思路: 对每个元素 x,检查 T - x 是否已在已见元素的集合中。如果是,找到了一对。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, t;
cin >> n >> t;
set<int> seen;
vector<int> arr(n);
for (int i = 0; i < n; i++) cin >> arr[i];
for (int i = 0; i < n; i++) {
int complement = t - arr[i]; // 需要 arr[i] + complement = t
if (seen.count(complement)) {
// complement 在 arr[i] 之前,按顺序打印:complement arr[i]
cout << complement << " " << arr[i] << "\n";
}
seen.insert(arr[i]);
}
return 0;
}
关键点:
- 对每个元素 x,需要的「补数」是
T - x - 如果补数已在「已见」集合中,它在数组前面出现 → 有效的对
- 这是用 set 的 O(N log N)(或用 unordered_set 的 O(N)),优于暴力 O(N²)
- 先打印
complement(它在输入中较早),再打印arr[i]
题目 3.1.9 — 括号匹配
读取只含 (、)、[、]、{、} 的字符串,若所有括号都正确匹配和嵌套打印 YES,否则打印 NO。
数据规模: 1 ≤ 字符串长度 ≤ 10⁶。
样例输入 1: {[()]} → 输出: YES
样例输入 2: ([)] → 输出: NO
样例输入 3: ((() → 输出: NO
思路: 用栈。压入开括号;见到闭括号时,检查栈顶是否是对应的开括号。
#include <bits/stdc++.h>
using namespace std;
int main() {
string s;
cin >> s;
stack<char> st;
bool ok = true;
for (char ch : s) {
if (ch == '(' || ch == '[' || ch == '{') {
st.push(ch); // 开括号:压栈
} else {
// 闭括号
if (st.empty()) {
ok = false; // 没有对应的开括号
break;
}
char top = st.top();
st.pop();
// 检查是否匹配
if ((ch == ')' && top != '(') ||
(ch == ']' && top != '[') ||
(ch == '}' && top != '{')) {
ok = false;
break;
}
}
}
if (!st.empty()) ok = false; // 还有未匹配的开括号
cout << (ok ? "YES" : "NO") << "\n";
return 0;
}
关键点:
- 核心思路:最近打开的括号必须是下一个关闭的
- 栈的 LIFO 特性完美模拟了「最近打开」的要求
- 三种失败条件:(1) 空栈时遇到闭括号;(2) 括号类型不匹配;(3) 末尾还有未关闭的括号
题目 3.1.10 — 前 K 大 读取 N 个整数和 K,打印最大的 K 个值(降序)。
数据规模: 1 ≤ K ≤ N ≤ 10⁶,-10⁹ ≤ 整数 ≤ 10⁹。
样例输入:
8 3
4 9 1 7 3 5 2 8
样例输出:
9
8
7
思路: 全部压入最大堆,弹出 K 次。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, k;
cin >> n >> k;
priority_queue<int> pq;
for (int i = 0; i < n; i++) {
int x;
cin >> x;
pq.push(x);
}
for (int i = 0; i < k && !pq.empty(); i++) {
cout << pq.top() << "\n";
pq.pop();
}
return 0;
}
关键点:
- 优先队列自动把最大值放在顶部
- 每次
pop()移除当前最大值,下一个最大值浮现 - 替代方案:降序排序后取前 K 个——结果相同
🏆 挑战题
挑战 3.1.11 — 库存系统 处理库存的 M 条命令,每条是以下之一:
ADD name quantity—— 添加quantity单位的产品nameREMOVE name quantity—— 移除quantity单位(若移除量超过库存,设为 0)QUERY name—— 打印name的当前库存量(从未添加过则为 0)
数据规模: 1 ≤ M ≤ 10⁵,1 ≤ 产品名长度 ≤ 20(小写字母),1 ≤ quantity ≤ 10⁹(累计库存需 long long)。
样例输入:
6
ADD apple 10
ADD banana 5
QUERY apple
REMOVE apple 3
QUERY apple
QUERY grape
样例输出:
10
7
0
思路: 用 map<string, long long> 作为库存,解析每条命令并相应更新。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int m;
cin >> m;
map<string, long long> inventory;
while (m--) {
string cmd;
cin >> cmd;
if (cmd == "ADD") {
string name;
long long qty;
cin >> name >> qty;
inventory[name] += qty;
} else if (cmd == "REMOVE") {
string name;
long long qty;
cin >> name >> qty;
inventory[name] -= qty;
if (inventory[name] < 0) inventory[name] = 0;
} else { // QUERY
string name;
cin >> name;
// 用 count 检查存在性,避免为缺失的商品创建条目
if (inventory.count(name)) {
cout << inventory[name] << "\n";
} else {
cout << 0 << "\n";
}
}
}
return 0;
}
关键点:
inventory[name] += qty——若name不存在,以 0 创建后加 qty(正确!)- QUERY 时用
inventory.count(name)检查存在性,避免悄悄创建值为 0 的条目 - 数量用
long long以防较大
挑战 3.1.12 — 滑动窗口最大值 读取 N 个整数和窗口大小 K,打印每个连续 K 元素窗口的最大值。
数据规模: 1 ≤ K ≤ N ≤ 10⁶,-10⁹ ≤ 整数 ≤ 10⁹(O(NK) 将超时,需要 O(N))。
样例输入:
8 3
1 3 -1 -3 5 3 6 7
样例输出:
3
3
5
5
6
7
(窗口:[1,3,-1]→3,[3,-1,-3]→3,[-1,-3,5]→5,[-3,5,3]→5,[5,3,6]→6,[3,6,7]→7)
思路: 用 deque(双端队列)维护一个有用下标的窗口。双端队列按值的递减顺序存储下标——deque.front() 始终是当前窗口最大值的下标。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, k;
cin >> n >> k;
vector<int> arr(n);
for (int i = 0; i < n; i++) cin >> arr[i];
deque<int> dq; // 存储下标,队首 = 当前最大值的下标
for (int i = 0; i < n; i++) {
// 移除已超出当前窗口的下标
while (!dq.empty() && dq.front() < i - k + 1) {
dq.pop_front();
}
// 从队尾移除值小于 arr[i] 的下标
//(只要 arr[i] 还在窗口里,它们就不可能成为最大值)
while (!dq.empty() && arr[dq.back()] <= arr[i]) {
dq.pop_back();
}
dq.push_back(i);
// 从窗口满的位置(下标 k-1)开始打印最大值
if (i >= k - 1) {
cout << arr[dq.front()] << "\n";
}
}
return 0;
}
关键点:
- 双端队列维护「单调递减队列」的下标
- 队首 = 当前窗口最大值的下标
- 加入新元素
arr[i]时:从队尾移除所有 ≤arr[i]的元素(它们无用——arr[i] 更大且在窗口中待的时间更长) - 当该下标不再在窗口内时(下标 < i - k + 1),从队首移除
- 总计 O(N)——每个下标最多压入和弹出各一次
挑战 3.1.13 — 干草堆范围计数 (USACO Bronze 风格)
N 捆干草堆放在数轴上的不同位置,处理 Q 个查询:对每个查询 (L, R),打印位置在 [L, R] 范围内(包含端点)的干草堆数量。
数据规模: 1 ≤ N, Q ≤ 10⁵,0 ≤ 位置 ≤ 10⁹,0 ≤ L ≤ R ≤ 10⁹。
样例输入:
5 4
3 1 7 5 2
1 3
2 6
4 8
1 10
样例输出:
3
3
2
5
思路: 对位置排序,对每个查询用 lower_bound 和 upper_bound 在 O(log N) 内找出范围内的数量。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
vector<int> pos(n);
for (int i = 0; i < n; i++) cin >> pos[i];
sort(pos.begin(), pos.end()); // 二分查找前必须排序
while (q--) {
int l, r;
cin >> l >> r;
// lower_bound(l):第一个 >= l 的位置
// upper_bound(r):第一个 > r 的位置
// [l, r] 内的元素个数 = 这两个迭代器之间的距离
auto lo = lower_bound(pos.begin(), pos.end(), l);
auto hi = upper_bound(pos.begin(), pos.end(), r);
cout << (hi - lo) << "\n"; // 迭代器间距离 = 个数
}
return 0;
}
关键点:
- 先对位置排序——二分查找的前提条件
lower_bound(pos.begin(), pos.end(), l)返回第一个 ≥ l 的元素的迭代器upper_bound(pos.begin(), pos.end(), r)返回第一个 > r 的元素的迭代器- [l, r] 内元素个数 = 两迭代器之间的距离 =
hi - lo - 总复杂度:排序 O(N log N) + 查询 O(Q log N)——远优于暴力 O(N×Q)
展望:超越基础 STL
本章涵盖了 90% 题目中会用到的核心 STL 容器。随着进阶,你还会遇到更专业的结构:
deque<T>—— 双端队列;支持 O(1) 在两端压入/弹出。用于滑动窗口最大值(挑战 3.1.12)和单调队列(第 3.4 章)。multiset<T>—— 类似set但允许重复元素。需要有序且有重复时使用。bitset<N>—— 固定大小的位序列;处理子集/成员问题极快。- Trie(前缀树) —— 通过共享公共前缀存储字符串,支持 O(L) 查找(L 是字符串长度)。
图示:Trie 数据结构

Trie(前缀树)通过共享公共前缀存储字符串。单词 "bat"、"car"、"card"、"care"、"cat" 高效共享前缀:"ca" 只存一次,分支到 "r" 和 "t"。双圈节点标记单词结尾。Trie 用于自动补全、拼写检查和字符串匹配。字符串哈希的替代方案参见第 3.7 章(哈希技术)。
第 3.2 章:数组与前缀和
设想你有一个 N 个数字的数组,有人问你 100,000 次:「从下标 L 到 R 的元素之和是多少?」朴素做法每次重新计算——每次查询 O(N),总计 O(N × Q)。当 N = Q = 10^5 时,是 10^10 次操作,远远太慢。
前缀和用 O(N) 预处理、每次查询 O(1) 解决这个问题。这是竞赛编程中最优雅、最实用的技术之一。
💡 核心思路: 前缀和将「区间查询」问题转化为一次减法。不用每次都从 L 到 R 求和,而是预计算累积和后做两次相减。这把
O(Q)的重复计算换成了一次性的O(N)预处理。
3.2.1 前缀和的思想
数组的前缀和是一个新数组,其中每个元素存储到当前下标为止的累积和。
图示:前缀和数组

上图展示了如何从原始数组构建前缀和数组,以及如何用 sum(L, R) = P[R] - P[L-1] 在 O(1) 时间内计算区间和。蓝色单元格标示查询范围,红绿单元格展示被相减的两个前缀值。
给定数组:A = [3, 1, 4, 1, 5, 9, 2, 6](使用 1-indexed 以便说明)
下标: 1 2 3 4 5 6 7 8
A: 3 1 4 1 5 9 2 6
P: 3 4 8 9 14 23 25 31
其中 P[i] = A[1] + A[2] + ... + A[i]。
为什么用 1-indexed?
使用 1-indexed 数组让我们可以定义 P[0] = 0(「空前缀」和为零)。这使得查询公式 P[R] - P[L-1] 在 L = 1 时也能正常工作——计算 P[R] - P[0] = P[R],这是正确的。
构建前缀和数组
// 构建前缀和数组 — O(N)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
// 第一步:读取输入(1-indexed)
vector<int> A(n + 1);
for (int i = 1; i <= n; i++) cin >> A[i];
// 第二步:构建前缀和
vector<long long> P(n + 1, 0); // P[0] = 0(基础情况)
for (int i = 1; i <= n; i++) {
P[i] = P[i - 1] + A[i]; // ← 关键行:每个 P[i] = 到 i 为止所有元素之和
}
return 0;
}
复杂度分析:
- 时间:
O(N)—— 遍历数组一次 - 空间:
O(N)—— 存储前缀数组
对 A = [3, 1, 4, 1, 5] 的逐步追踪:
i=1: P[1] = P[0] + A[1] = 0 + 3 = 3
i=2: P[2] = P[1] + A[2] = 3 + 1 = 4
i=3: P[3] = P[2] + A[3] = 4 + 4 = 8
i=4: P[4] = P[3] + A[4] = 8 + 1 = 9
i=5: P[5] = P[4] + A[5] = 9 + 5 = 14
3.2.2 O(1) 区间求和查询
有了前缀和数组,下标 L 到 R 的和就是:
sum(L, R) = P[R] - P[L-1]
为什么? P[R] = 1..R 的元素之和。P[L-1] = 1..(L-1) 的元素之和。两者之差 = L..R 的元素之和。
💡 核心思路: 把 P[i] 理解为「前 i 个元素的总和」。要得到窗口 [L, R] 的和,就从「到 R 的前缀」中减去「L 之前的前缀」。就像:大三角形减去小三角形 = 梯形。
// 区间求和查询 — 预处理 O(N),每次查询 O(1)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
long long A[MAXN];
long long P[MAXN];
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
// 第一步:读取数组
for (int i = 1; i <= n; i++) cin >> A[i];
// 第二步:构建前缀和 — O(n)
P[0] = 0;
for (int i = 1; i <= n; i++) {
P[i] = P[i - 1] + A[i];
}
// 第三步:回答 q 个区间求和查询 — 每次 O(1)
for (int i = 0; i < q; i++) {
int l, r;
cin >> l >> r;
cout << P[r] - P[l - 1] << "\n"; // ← 关键行:区间和公式
}
return 0;
}
样例输入:
8 3
3 1 4 1 5 9 2 6
1 4
3 7
2 6
样例输出:
9
21
20
验证:
sum(1,4) = P[4] - P[0] = 9 - 0 = 9→ A[1]+A[2]+A[3]+A[4] = 3+1+4+1 = 9 ✓sum(3,7) = P[7] - P[2] = 25 - 4 = 21→ A[3]+...+A[7] = 4+1+5+9+2 = 21 ✓sum(2,6) = P[6] - P[1] = 23 - 3 = 20→ A[2]+...+A[6] = 1+4+1+5+9 = 20 ✓
⚠️ 常见错误: 写成
P[R] - P[L]而不是P[R] - P[L-1]。公式包含 L 和 R 两个端点——你要减去 L 之前的和,不是 L 处的和。
总复杂度: O(N + Q) —— 对 N、Q 最大 10^5 完全没问题。
3.2.3 USACO 示例:品种统计
这是一道经典的 USACO Bronze 题(2015 年 12 月)。
题目: N 头奶牛排成一列,每头的品种是 1、2 或 3。回答 Q 个查询:位置 L 到 R 中有多少头品种为 B 的奶牛?
数据规模(与原题一致): 1 ≤ N, Q ≤ 100,000,1 ≤ 品种 ≤ 3,1 ≤ L ≤ R ≤ N。
解法: 每种品种维护一个前缀和数组。
// 多品种前缀和 — O(N + Q)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
vector<int> breed(n + 1);
vector<vector<long long>> P(4, vector<long long>(n + 1, 0));
// P[b][i] = 位置 1..i 中品种 b 的奶牛数量
// 第一步:为每种品种构建前缀和
for (int i = 1; i <= n; i++) {
cin >> breed[i];
for (int b = 1; b <= 3; b++) {
P[b][i] = P[b][i - 1] + (breed[i] == b ? 1 : 0); // ← 关键行
}
}
// 第二步:每次查询 O(1) 回答
for (int i = 0; i < q; i++) {
int l, r, b;
cin >> l >> r >> b;
cout << P[b][r] - P[b][l - 1] << "\n";
}
return 0;
}
🏆 USACO 技巧: 很多 USACO Bronze 题涉及「统计范围内满足属性 X 的元素个数」。如果 Q 较大,始终考虑前缀和。
3.2.4 USACO 风格题目详解:FJ 的草地
🔗 相关题目: 这是一道受「品种统计」和「最高奶牛」启发的虚构 USACO 风格题目——两者都是经典 Bronze 题。
题目: FJ 有 N 块连续的田地,第 i 块有 grass[i] 单位的草。他需要回答 Q 个查询:「第 L 块到第 R 块(含)的草总量是多少?」N、Q 最大 10^5,每次查询需要 O(1) 回答。
数据规模: 1 ≤ N, Q ≤ 10⁵,1 ≤ grass[i] ≤ 10⁹(区间和需 long long)。
样例输入:
6 4
4 2 7 1 8 3
1 3
2 5
4 6
1 6
样例输出:
13
18
12
25
逐步解法:
第一步: 理解题目。我们有数组 [4, 2, 7, 1, 8, 3],需要区间求和。
第二步: 构建前缀和数组。
下标: 0 1 2 3 4 5 6
草量: - 4 2 7 1 8 3
P: 0 4 6 13 14 22 25
第三步: 用 P[R] - P[L-1] 回答查询:
- 查询 (1,3):
P[3] - P[0] = 13 - 0 = 13✓ - 查询 (2,5):
P[5] - P[1] = 22 - 4 = 18✓ - 查询 (4,6):
P[6] - P[3] = 25 - 13 = 12✓ - 查询 (1,6):
P[6] - P[0] = 25 - 0 = 25✓
完整 C++ 解法:
// FJ 的草地 — 前缀和解法 O(N + Q)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
// 第一步:读取草量并同步构建前缀和
vector<long long> P(n + 1, 0);
for (int i = 1; i <= n; i++) {
long long g;
cin >> g;
P[i] = P[i - 1] + g; // ← 关键行:增量前缀和
}
// 第二步:每次查询 O(1) 回答
while (q--) {
int l, r;
cin >> l >> r;
cout << P[r] - P[l - 1] << "\n";
}
return 0;
}
为什么是 O(N + Q)?
- 构建前缀和:一个循环,N 次迭代 →
O(N) - 每次查询:一次减法 → 每次
O(1),共O(Q) - 总计:
O(N + Q)—— 远好于暴力的O(NQ)
⚠️ 常见错误: 前缀和用
int而不是long long。如果草量最大 10^9 且 N = 10^5,总和可达 10^14——远超int约 2×10^9 的范围。
3.2.5 二维前缀和
对于二维网格,可以扩展前缀和在 O(1) 时间内回答矩形区间查询。
给定 R×C 的网格,定义 P[r][c] = 从 (1,1) 到 (r,c) 矩形内所有元素之和。
构建二维前缀和
P[r][c] = A[r][c] + P[r-1][c] + P[r][c-1] - P[r-1][c-1]
减法是为了消除重叠(否则左上角矩形会被计算两次)。
💡 核心思路(容斥原理): 想象四个矩形:
P[r-1][c]= 「上方」矩形P[r][c-1]= 「左方」矩形P[r-1][c-1]= 「左上角」(在上面两个中都计算了——所以减去一次)A[r][c]= 单个新单元格
二维前缀和逐步工作示例
追踪一个 4×4 网格:
原始网格 A:
c=1 c=2 c=3 c=4
r=1: 1 2 3 4
r=2: 5 6 7 8
r=3: 9 10 11 12
r=4: 13 14 15 16
逐步构建 P(从左到右、从上到下):
📄 Code 完整代码
P[1][1] = A[1][1] = 1
P[1][2] = 2 + 0 + 1 - 0 = 3
P[1][3] = 3 + 0 + 3 - 0 = 6
P[1][4] = 4 + 0 + 6 - 0 = 10
P[2][1] = 5 + 1 + 0 - 0 = 6
P[2][2] = 6 + 3 + 6 - 1 = 14
P[2][3] = 7 + 6 + 14 - 3 = 24
P[2][4] = 8 + 10 + 24 - 6 = 36
P[3][1] = 9 + 6 + 0 - 0 = 15
P[3][2] = 10 + 14 + 15 - 6 = 33
P[3][3] = 11 + 24 + 33 - 14 = 54
P[3][4] = 12 + 36 + 54 - 24 = 78
P[4][1] = 13 + 15 + 0 - 0 = 28
P[4][2] = 14 + 33 + 28 - 15 = 60
P[4][3] = 15 + 54 + 60 - 33 = 96
P[4][4] = 16 + 78 + 96 - 54 = 136
前缀和网格 P:
c=1 c=2 c=3 c=4
r=1: 1 3 6 10
r=2: 6 14 24 36
r=3: 15 33 54 78
r=4: 28 60 96 136
查询:子网格 (r1=2, c1=2) 到 (r2=3, c2=3) 的和:
ans = P[3][3] - P[1][3] - P[3][1] + P[1][1]
= 54 - 6 - 15 + 1
= 34
验证:A[2][2]+A[2][3]+A[3][2]+A[3][3] = 6+7+10+11 = 34 ✓
容斥原理图示:

// 二维前缀和 — 构建 O(R×C),查询 O(1)
#include <bits/stdc++.h>
using namespace std;
const int MAXR = 1001, MAXC = 1001;
int A[MAXR][MAXC];
long long P[MAXR][MAXC];
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int R, C;
cin >> R >> C;
for (int r = 1; r <= R; r++)
for (int c = 1; c <= C; c++)
cin >> A[r][c];
// 第一步:构建二维前缀和 — O(R × C)
for (int r = 1; r <= R; r++) {
for (int c = 1; c <= C; c++) {
P[r][c] = A[r][c]
+ P[r-1][c] // 上方矩形
+ P[r][c-1] // 左方矩形
- P[r-1][c-1]; // ← 关键行:消除重叠(被计算了两次)
}
}
// 第二步:每次查询 O(1) 回答
int q;
cin >> q;
while (q--) {
int r1, c1, r2, c2;
cin >> r1 >> c1 >> r2 >> c2;
long long ans = P[r2][c2]
- P[r1-1][c2] // 减去上方条带
- P[r2][c1-1] // 减去左方条带
+ P[r1-1][c1-1]; // 加回左上角
cout << ans << "\n";
}
return 0;
}
复杂度分析:
- 构建时间:
O(R × C) - 查询时间: 每次
O(1) - 空间:
O(R × C)
⚠️ 常见错误: 查询公式中忘记加回
P[r1-1][c1-1]。上方条带和左方条带都包含左上角,所以被减了两次——需要加回一次!
3.2.6 差分数组
前面我们学习了前缀和:它擅长解决「很多次区间求和」问题。
现在来看一个看起来相反的问题:
有一个长度为 N 的数组,一开始全是 0。接下来有很多次操作,每次都要把一整段
[L, R]全部加上一个值V。最后输出整个数组。
如果直接模拟,每次操作都从 L 循环到 R:
for (int i = L; i <= R; i++) {
A[i] += V;
}
这当然能做对,但如果 N 和操作次数 M 都是 100000,最坏情况下就是 10^10 次加法,太慢。
差分数组解决的核心问题就是:
如何不用真的修改区间里的每一个元素,也能表达「整个区间都加了 V」?
先从一个生活例子理解
想象一条直线跑道,有 8 个位置:
位置: 1 2 3 4 5 6 7 8
数值: 0 0 0 0 0 0 0 0
现在要把 [3, 6] 全部加 5。
朴素做法是给 3、4、5、6 每个位置都写上 +5。
但差分数组不这样做。它只记录两件事:
从位置 3 开始,加 5 生效
从位置 7 开始,加 5 失效
也就是:
diff[3] += 5;
diff[7] -= 5;
为什么这样就够了?因为最后我们会从左到右累加这些「变化标记」。
diff: 0 0 +5 0 0 0 -5 0
累加: 0 0 5 5 5 5 0 0
位置: 1 2 3 4 5 6 7 8
你会发现,位置 3 到 6 正好都变成了 5,位置 7 开始又恢复为 0。
这就是差分数组的全部直觉:
区间更新不直接改区间,而是在区间起点放一个「开始变化」标记,在区间终点后一个位置放一个「停止变化」标记。

差分数组到底存的是什么?
如果原数组是:
A: 2 5 5 9 7
那么差分数组 diff 存的是「当前位置相对于前一个位置变了多少」:
diff[1] = A[1] - 0 = 2
diff[2] = A[2] - A[1] = 3
diff[3] = A[3] - A[2] = 0
diff[4] = A[4] - A[3] = 4
diff[5] = A[5] - A[4] = -2
所以:
A: 2 5 5 9 7
diff: 2 3 0 4 -2
如果对 diff 做前缀和,就能还原 A:
2
2 + 3 = 5
2 + 3 + 0 = 5
2 + 3 + 0 + 4 = 9
2 + 3 + 0 + 4 - 2 = 7
因此可以把差分数组理解成:
diff[i]记录的是「从第 i 个位置开始,数值发生了多少变化」。
为什么区间加法只需要改两个位置?
假设要给 [L, R] 都加上 V。
从位置 L 开始,后面的值都应该多 V,所以:
diff[L] += V;
但是这个影响只能持续到 R,从 R+1 开始就不应该再多 V,所以要抵消掉:
diff[R + 1] -= V;
合起来就是差分数组最重要的公式:
diff[L] += V;
diff[R + 1] -= V;
注意:这就是为什么
diff通常要开到n + 2。当R = n时,我们仍然会访问diff[n + 1]。
完整例子:三次区间更新
从长度为 5 的全零数组开始:
A: 0 0 0 0 0
执行三次操作:
1) [1, 3] 加 2
2) [2, 5] 加 3
3) [3, 4] 加 -1
我们不直接修改 A,只修改 diff。
第 1 次操作:[1, 3] +2
diff[1] += 2;
diff[4] -= 2;
diff[1..6] = [2, 0, 0, -2, 0, 0]
含义是:从 1 开始多 2,从 4 开始取消这次 +2。
第 2 次操作:[2, 5] +3
diff[2] += 3;
diff[6] -= 3;
diff[1..6] = [2, 3, 0, -2, 0, -3]
第 3 次操作:[3, 4] -1
diff[3] += -1;
diff[5] -= -1; // 等价于 diff[5] += 1
diff[1..6] = [2, 3, -1, -2, 1, -3]
现在对 diff 做前缀和,还原最终数组:
i=1: 2 -> A[1] = 2
i=2: 2 + 3 = 5 -> A[2] = 5
i=3: 5 - 1 = 4 -> A[3] = 4
i=4: 4 - 2 = 2 -> A[4] = 2
i=5: 2 + 1 = 3 -> A[5] = 3
最终结果:
A:2 5 4 2 3

完整 C++ 实现
// 差分数组实现区间更新 — O(N + M)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
// diff[i] 表示从位置 i 开始,当前值发生了多少变化
// 多开 1 位:当更新区间右端点 r = n 时,需要访问 diff[n + 1]
vector<long long> diff(n + 2, 0);
// 第一步:处理所有区间更新
for (int i = 0; i < m; i++) {
int l, r;
long long v;
cin >> l >> r >> v;
diff[l] += v; // 从 l 开始,增加 v 生效
diff[r + 1] -= v; // 从 r+1 开始,取消这次增加
}
// 第二步:对 diff 做前缀和,得到最终数组
long long cur = 0;
for (int i = 1; i <= n; i++) {
cur += diff[i];
cout << cur;
if (i < n) cout << " ";
}
cout << "\n";
return 0;
}
样例输入:
5 3
1 3 2
2 5 3
3 4 -1
样例输出:
2 5 4 2 3
什么时候用差分数组?
差分数组适合这种场景:
很多次区间修改,最后统一查询结果
例如:
- 给
[L, R]所有元素加上V - 多次刷墙,每次刷一段区间
- 多次给道路区间增加交通量
- 多次给一段时间内的在线人数加 1
但要注意:
普通差分数组不适合「一边修改、一边查询区间和」的动态问题。
如果题目要求更新和查询交替出现,通常需要树状数组或线段树。
差分数组常见错误
- 数组开小了:
diff应该开n + 2,因为会访问diff[r + 1]。 - 忘记最后做前缀和:
diff本身不是答案,前缀和之后才是最终数组。 - 把
diff[r + 1] -= v写成diff[r] -= v: 这样会让位置r没有被加到。 - 数值可能溢出: 多次区间加法后数值可能很大,建议用
long long。
一句话记忆:
左端点开始加,右端点后停止加;最后扫一遍,变化变成答案。
3.2.7 二维差分数组
一维差分数组解决的是「给一段连续区间加值」。
二维差分数组解决的是类似问题:
有一个
R × C的网格,一开始全是 0。每次操作给一个矩形区域整体加上V,最后输出整个网格。
例如:
给左上角 (r1, c1) 到右下角 (r2, c2) 的整个矩形都加 V
如果直接模拟,需要枚举矩形里的每一个格子。矩形很大、操作很多时会非常慢。
二维差分的思想和一维完全一样:
不要真的修改整个矩形,只在矩形的边界上做标记。最后通过二维前缀和把这些标记扩散成最终结果。
从一维公式推广到二维
一维区间 [L, R] + V 的标记是:
diff[L] += V;
diff[R + 1] -= V;
它的意思是:
从 L 开始生效,从 R+1 开始失效
二维矩形有两个方向:行方向和列方向。
如果只写:
diff[r1][c1] += V;
那么做二维前缀和时,V 会影响从 (r1,c1) 开始往右下方的整个大矩形,而不只是我们想要的 [r1,c1]..[r2,c2]。
所以我们需要在右边和下边把影响取消掉,再把右下角被重复取消的部分加回来。
四个角的公式是:
diff[r1][c1] += V; // 从左上角开始生效
diff[r1][c2 + 1] -= V; // 到右边界之后,取消横向影响
diff[r2 + 1][c1] -= V; // 到下边界之后,取消纵向影响
diff[r2 + 1][c2 + 1] += V; // 右下角被取消了两次,加回来一次
这四个标记就是二维差分的核心。

用图理解四角标记
假设我们想给这个矩形加 V:
c1 c2
↓ ↓
. . . . .
r1 -> . +V +V +V .
. +V +V +V .
r2 -> . +V +V +V .
. . . . .
我们放四个标记:
左上角: +V 让影响开始
右上角外侧: -V 让影响不要继续向右
左下角外侧: -V 让影响不要继续向下
右下角外侧: +V 修正右下方被减了两次的问题
也就是:
(r1, c1) 放 +V
(r1, c2 + 1) 放 -V
(r2 + 1, c1) 放 -V
(r2 + 1, c2+1) 放 +V
完整例子:两个矩形更新
一个 3 × 3 网格,初始全是 0。
执行两次更新:
1) update(1, 1, 2, 2, +5)
2) update(2, 2, 3, 3, +3)
第 1 次更新:左上 2 × 2 加 5
diff[1][1] += 5;
diff[1][3] -= 5;
diff[3][1] -= 5;
diff[3][3] += 5;
第 2 次更新:右下 2 × 2 加 3
diff[2][2] += 3;
diff[2][4] -= 3;
diff[4][2] -= 3;
diff[4][4] += 3;
所有标记完成后,diff 大致是:
c=1 c=2 c=3 c=4
r=1: 5 0 -5 0
r=2: 0 3 0 -3
r=3: -5 0 5 0
r=4: 0 -3 0 3
现在对它做二维前缀和:
diff[r][c] += diff[r-1][c] + diff[r][c-1] - diff[r-1][c-1];
恢复出的最终网格是:
c=1 c=2 c=3
r=1: 5 5 0
r=2: 5 8 3
r=3: 0 3 3
中间的 (2,2) 等于 8,因为它同时被 +5 和 +3 两个矩形覆盖。
完整 C++ 实现
// 二维差分数组 — 每次矩形更新 O(1),最终重建 O(R × C)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int R, C, M;
cin >> R >> C >> M;
// 多开一圈哨兵:当 r2=R 或 c2=C 时,会访问 r2+1 或 c2+1
vector<vector<long long>> diff(R + 2, vector<long long>(C + 2, 0));
// 第一步:每次 O(1) 标记一个矩形更新
while (M--) {
int r1, c1, r2, c2;
long long v;
cin >> r1 >> c1 >> r2 >> c2 >> v;
diff[r1][c1] += v;
diff[r1][c2 + 1] -= v;
diff[r2 + 1][c1] -= v;
diff[r2 + 1][c2 + 1] += v;
}
// 第二步:二维前缀和重建最终网格
for (int r = 1; r <= R; r++) {
for (int c = 1; c <= C; c++) {
diff[r][c] += diff[r - 1][c]
+ diff[r][c - 1]
- diff[r - 1][c - 1];
}
}
// 第三步:输出最终网格
for (int r = 1; r <= R; r++) {
for (int c = 1; c <= C; c++) {
cout << diff[r][c];
if (c < C) cout << " ";
}
cout << "\n";
}
return 0;
}
二维差分什么时候用?
二维差分适合:
很多次矩形区域加法,最后统一得到整个网格
常见题型包括:
- 多次给矩形区域涂色,最后问每个格子的颜色或覆盖次数
- 多个矩形广告牌叠加,统计最终亮度
- 给地图上一块矩形区域增加高度、温度或权重
- 离线处理大量矩形更新
二维差分常见错误
- 四角符号写反: 记住是
+ - - +。 - 数组开小: 要能访问
r2 + 1、c2 + 1,所以至少开到R + 2、C + 2。 - 忘记最后二维前缀和: 四角标记只是变化,不是最终网格。
- 重建公式写错: 应该是
上 + 左 - 左上,即:
diff[r][c] += diff[r-1][c] + diff[r][c-1] - diff[r-1][c-1];
一句话记忆:
矩形更新看四角:左上加,右上减,左下减,右下加;最后做二维前缀和。
3.2.8 USACO 示例:最大子数组和
题目(Kadane 算法的变体): 给定 N 个整数(可能为负),找连续子数组的最大和。
数据规模: 1 ≤ N ≤ 10⁶,-10⁹ ≤ A[i] ≤ 10⁹(答案需 long long)。
// Kadane 算法 — O(N) 时间,O(1) 空间
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> A(n);
for (int &x : A) cin >> x;
// Kadane 算法:O(n)
long long maxSum = LLONG_MIN; // 最小 long long
long long current = 0;
for (int i = 0; i < n; i++) {
current += A[i];
maxSum = max(maxSum, current);
if (current < 0) current = 0; // ← 关键行:和为负时重新开始
}
cout << maxSum << "\n";
return 0;
}
💡 核心思路: 为什么当 current 为负时重置为 0?因为负的前缀和只会损害之后的任何子数组。如果当前运行和是 -5,任何从头开始(和为 0)的子数组都比继续 -5 要好。
用前缀和的替代方案: 最大子数组和等于 P[j] - P[i-1] 对所有对 (i,j) 的最大值。对于每个 j,当 P[i-1] 最小时取得最大。追踪运行中最小前缀和!
// 替代方案:最小前缀技巧 — 同样 O(N)
long long maxSum = LLONG_MIN, minPrefix = 0, prefix = 0;
for (int x : A) {
prefix += x;
maxSum = max(maxSum, prefix - minPrefix); // 到此处结束的最优和
minPrefix = min(minPrefix, prefix); // 追踪目前见过的最小前缀
// ⚠️ 注意:minPrefix 的更新必须在 maxSum 之后。
// 若提前更新 minPrefix,相当于允许空子数组(长度为0)参与比较,
// 会导致结果在全负数组时错误地返回 0 而非最大负数。
}
3.2.8 USACO 真题训练:把区间问题变成前缀差
前缀和/差分在 USACO 中通常不是以「请你写前缀和」出现,而是藏在下面这些题面信号里:
| 题面信号 | 首选技术 | 判断依据 |
|---|---|---|
多次询问 [L,R] 内某类元素数量/总和 | 前缀和 | 原数组不变,查询很多 |
多次给 [L,R] 加值,最后统一询问 | 差分数组 | 更新很多,但不穿插查询 |
| 网格中多次询问矩形区域 | 二维前缀和 | 矩形求和可用容斥 |
| 网格中多次给矩形加值 | 二维差分 | 四角标记,最后重建 |
真题 1:Breed Counting(USACO 2015 December Silver)— 多类别前缀和
题目链接: USACO 2015 December Silver P3: Breed Counting
对应模式: 多个前缀和数组
难度定位: Silver 入门
题干解读
N 头奶牛排成一行,每头奶牛的品种是 1、2、3 之一。接下来有 Q 次查询,每次给出区间 [L,R],要求输出这个区间里三种品种各有多少头。
数据规模(与原题一致): 1 ≤ N, Q ≤ 100,000,1 ≤ 品种 ≤ 3,1 ≤ L ≤ R ≤ N。
关键条件:
- 队伍顺序固定,不会修改。
- 查询次数很多,不能每次扫描
[L,R]。 - 品种只有 3 类,可以为每一类单独建前缀和。
思路分析
对每个品种 b 建一个前缀数组:
prefix[b][i] = 前 i 头奶牛中,品种 b 出现的次数
区间 [L,R] 中品种 b 的数量就是:
prefix[b][R] - prefix[b][L-1]
这和普通前缀和完全一样,只是把「数值求和」变成了「某个类别是否出现」。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("bcount.in", "r", stdin);
// freopen("bcount.out", "w", stdout);
int n, q;
cin >> n >> q;
vector<array<int, 4>> prefix(n + 1); // 只使用下标 1..3
for (int i = 1; i <= n; i++) {
int breed;
cin >> breed;
prefix[i] = prefix[i - 1]; // 继承前 i-1 头的计数
prefix[i][breed]++; // 当前品种加 1
}
while (q--) {
int l, r;
cin >> l >> r;
for (int b = 1; b <= 3; b++) {
int count = prefix[r][b] - prefix[l - 1][b];
cout << count << " \n"[b == 3];
}
}
return 0;
}
复杂度: 预处理 O(N × 3),每次查询 O(3),总复杂度 O(N+Q),空间 O(3N)。
易错点提醒
- 把
prefix[i] = prefix[i-1]漏掉。 只给当前品种加 1 会丢失之前所有计数。 L-1下标越界。 使用 1-indexed 前缀和时,prefix[0]是哨兵,查询从L=1也安全。- 输出格式错误。 每个查询输出 3 个数字,最后换行。
- 文件名混淆。 官方文件 I/O 是
bcount.in/out,不是breed.in/out。
拓展思考
如果品种数量从 3 变成 10^5,但每次只询问一种品种,可以改用 map<breed, vector<int>> 存每个品种出现位置,再用二分查找统计区间内出现次数。选择数据结构时始终看「类别数 × 查询模式」。
真题 2:Haybale Stacking(USACO 2012 January Bronze)— 区间加法的差分数组
题目链接: USACO 2012 January Bronze P2: Haybale Stacking
对应模式: 差分数组 + 最终重建
难度定位: Bronze/Silver 基础
题干解读
有 N 堆草,初始高度都是 0。接下来 K 条指令,每条指令给区间 [A,B] 内每一堆草加 1。所有操作完成后,输出草堆高度的中位数。
关键条件:
N可到10^6,K可到25000。- 每次直接遍历
[A,B]可能达到O(NK),太慢。 - 题目只问所有操作完成后的结果,不需要中途查询。
思路分析
差分数组把一次区间加法变成两个端点标记:
diff[A] += 1
diff[B+1] -= 1
最后从左到右取前缀和,就能恢复每个位置最终高度。然后排序高度数组,取中位数。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("stacking.in", "r", stdin);
// freopen("stacking.out", "w", stdout);
int n, k;
cin >> n >> k;
vector<int> diff(n + 2, 0); // 需要写到 b+1,最大可能是 n+1
for (int i = 0; i < k; i++) {
int a, b;
cin >> a >> b;
diff[a] += 1;
diff[b + 1] -= 1;
}
vector<int> height(n + 1);
int current = 0;
for (int i = 1; i <= n; i++) {
current += diff[i];
height[i] = current;
}
sort(height.begin() + 1, height.end());
cout << height[(n + 1) / 2] << "\n"; // n 为奇数,中位数下标固定
return 0;
}
复杂度: 区间更新 O(K),重建 O(N),排序 O(N log N),空间 O(N)。
易错点提醒
diff数组开小。 必须开到n+2,因为B=n时会写diff[n+1]。- 忘记重建。 差分数组不是最终高度,必须再做一次前缀和。
- 中位数下标错。 本题
N是奇数,用 1-indexed 高度数组时中位数是(N+1)/2。 - 误以为需要线段树。 没有中途查询,差分数组更简单也更快。
拓展思考
如果题目改成「每次区间加后立刻查询某个位置/区间」,差分数组就不够了,需要树状数组或线段树。这正是第 5.8 章和第 5.7 章要解决的问题。
⚠️ 第 3.2 章常见错误
- 区间查询差一: 写
P[R] - P[L]而不是P[R] - P[L-1]。始终用小例子验证。 - 溢出: 大值的前缀和可能超过
int范围(2×10^9)。即使元素是int,前缀数组也要用long long。 - 二维查询公式: 忘了二维查询中的
+P[r1-1][c1-1]项——非常容易疏忽。 - 差分数组大小: 声明
diff[n+1]但需要diff[n+2](因为要写入下标r+1,可能是n+1)。 - 1-indexed vs 0-indexed: 用 0-indexed 前缀和时,查询公式变为
P[R+1] - P[L]。在一道题内选定一种约定并坚持用。 - 二维差分数组大小: 声明
diff[R+1][C+1]但需要diff[R+2][C+2]——四角更新会写入(r2+1, c2+1),必须在范围内。 - 二维差分重建顺序: 二维前缀和重建必须从左到右、从上到下处理单元格(与构建二维前缀和的顺序相同)。顺序混乱会产生错误结果。
本章总结
📌 核心要点
| 技术 | 构建时间 | 查询时间 | 空间 | 使用场景 |
|---|---|---|---|---|
| 一维前缀和 | O(N) | O(1) | O(N) | 一维数组的区间和 |
| 二维前缀和 | O(RC) | O(1) | O(RC) | 二维网格的矩形和 |
| 差分数组 | O(N+M) | O(1)* | O(N) | 区间加法更新 |
| 二维差分数组 | O(RC+M) | O(1)* | O(RC) | 二维网格上的矩形加法 |
| Kadane 算法 | O(N) | — | O(1) | 最大子数组和 |
*需要 O(N) 的重建遍历后才能读取所有值。
🧩 核心公式速查
| 操作 | 公式 | 备注 |
|---|---|---|
| 一维区间和 | P[R] - P[L-1] | P[0] = 0 是哨兵值 |
| 二维矩形和 | P[r2][c2] - P[r1-1][c2] - P[r2][c1-1] + P[r1-1][c1-1] | 容斥:减两次,加一次 |
| 差分数组更新 | diff[L] += V; diff[R+1] -= V; | 数组大小应为 N+2 |
| 二维差分更新 | diff[r1][c1]+=V; diff[r1][c2+1]-=V; diff[r2+1][c1]-=V; diff[r2+1][c2+1]+=V | 四角标记 |
| 从差分恢复 | 对 diff 取前缀和(一维或二维) | 结果是最终数组 |
❓ 常见问题
Q1:前缀和和差分数组有什么关系?
A:它们是逆运算。对数组取前缀和得到前缀和数组;对前缀和数组取差分(相邻元素差)则恢复原数组。之后对这些标记取前缀和,+V 和 -V 在 [L,R] 外相互抵消,净效果恰好是给 [L,R] 加了 V。
Q2:什么时候用前缀和 vs 差分数组?
A:经验法则——看操作类型:
- 多次区间求和查询 → 前缀和(预处理
O(N),查询O(1))- 多次区间加减操作 → 差分数组(更新
O(1),最后恢复O(N))- 两种操作交替出现时,需要更高级的数据结构(如第 5.7 章的线段树)
Q3:前缀和能处理动态修改吗?(数组元素改变)
A:不能。前缀和是一次性预处理,之后数组不能改变。如果元素被修改,用树状数组(BIT)或线段树,它们支持单点更新和
O(log N)的区间查询。
Q4:为什么 Kadane 算法有两个版本(current=0 vs minPrefix)?
A:两者本质相同,都是
O(N)。第一种(经典 Kadane)更直觉:当前子数组和变负时重新开始。第二种(最小前缀法)用前缀和思维:最大子数组 = max(P[j] - P[i]) = max(P[j]) - min(P[i])。按个人喜好选择。
Q5:二维前缀和的空间限制是什么?
A:若 R、C 都最大 10^4,P 数组需要 10^8 个
long long(约 800MB)——超出内存限制。一般 R×C ≤ 10^6~10^7 是安全的。更大的网格考虑压缩或离线处理。
🔗 与后续章节的联系
- 第 3.4 章(双指针):滑动窗口也能做区间查询,但只适用于固定大小或单调移动的窗口;前缀和更通用
- 第 3.3 章(排序与搜索):二分查找可以与前缀和结合——例如在前缀和数组上二分查找第一个 ≥ 目标值的位置
- 第 5.7 章(线段树):解决前缀和无法处理的「动态更新 + 区间查询」问题
- 第 6.1–6.3 章(动态规划):很多状态转移涉及区间和;前缀和是优化 DP 的重要工具
- 差分数组的思想(「在起点 +V,在终点后 -V」)在扫描线算法、事件排序等高级技术中反复出现
练习题
题目 3.2.1 — 区间求和 🟢 简单 读取 N 个整数和 Q 个查询,每个查询给出 L 和 R,打印下标 L 到 R(1-indexed)的元素之和。
数据规模: 1 ≤ N, Q ≤ 10⁵,-10⁹ ≤ A[i] ≤ 10⁹,1 ≤ L ≤ R ≤ N(区间和需 long long)。
提示
构建前缀和数组 P,其中 P[i] = A[1]+...+A[i],每次查询回答 P[R] - P[L-1]。核心思路: O(N) 预计算前缀和,每次查询 O(1) 回答 P[R] - P[L-1]。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, q; cin >> n >> q;
vector<long long> P(n + 1, 0);
for (int i = 1; i <= n; i++) {
int x; cin >> x;
P[i] = P[i-1] + x;
}
while (q--) {
int l, r; cin >> l >> r;
cout << P[r] - P[l-1] << "\n";
}
}
复杂度: O(N + Q) —— 远好于朴素 O(N × Q)。
题目 3.2.2 — 区间加法,单点查询 🟢 简单 从 N 个零开始,处理 M 次操作:每次给 L 到 R 的所有位置加 V。所有操作后打印每个位置的值。
数据规模: 1 ≤ N, M ≤ 10⁵,1 ≤ L ≤ R ≤ N,-10⁹ ≤ V ≤ 10⁹(最终值需 long long)。
提示
对每次更新用 `diff[L]` += V,`diff[R+1]` -= V,然后对 diff 取前缀和。核心思路: 差分数组。每次区间加法只影响 diff 的 2 个位置,最终值通过前缀和得到。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, m; cin >> n >> m;
vector<long long> diff(n + 2, 0);
while (m--) {
int l, r; long long v; cin >> l >> r >> v;
diff[l] += v;
diff[r+1] -= v;
}
long long cur = 0;
for (int i = 1; i <= n; i++) {
cur += diff[i];
cout << cur << " \n"[i == n];
}
}
复杂度: O(N + M) —— 每次更新 O(1),最后扫描 O(N)。
题目 3.2.3 — 矩形求和 🟡 中等
读取 N×M 网格和 Q 个查询,每个查询给出 (r1,c1,r2,c2),打印子网格的和。
数据规模: 1 ≤ N, M ≤ 2000,1 ≤ Q ≤ 10⁵,-10⁹ ≤ 网格元素 ≤ 10⁹(子网格和需 long long)。
提示
二维前缀和。查询 = P[r2][c2] - P[r1-1][c2] - P[r2][c1-1] + P[r1-1][c1-1]。核心思路: 二维前缀和。P[i][j] = 从 (1,1) 到 (i,j) 的矩形和,对任意矩形查询用容斥相减。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, m, q; cin >> n >> m >> q;
vector<vector<long long>> P(n+1, vector<long long>(m+1, 0));
for (int i = 1; i <= n; i++)
for (int j = 1; j <= m; j++) {
int x; cin >> x;
P[i][j] = x + P[i-1][j] + P[i][j-1] - P[i-1][j-1];
}
while (q--) {
int r1, c1, r2, c2; cin >> r1 >> c1 >> r2 >> c2;
cout << P[r2][c2] - P[r1-1][c2] - P[r2][c1-1] + P[r1-1][c1-1] << "\n";
}
}
复杂度: O(N × M + Q)。
题目 3.2.4 — USACO 2016 January Bronze:割草 🔴 困难 FJ 沿一条路径割草,被访问超过一次的格子构成「双重割草」区域,统计至少被访问两次的格子数。
数据规模: 1 ≤ 指令数 N ≤ 100,1 ≤ 每次步数 ≤ 1000,方向为 N/E/S/W 之一(总步数最多 10⁵)。
提示
模拟路径,在二维访问计数中标记格子,统计值 ≥ 2 的格子。核心思路: 直接模拟——不需要复杂数据结构。沿路径走,对每个访问的格子递增二维计数器。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
map<pair<int,int>, int> cnt;
int x = 0, y = 0; cnt[{x,y}]++;
while (n--) {
char dir; int steps; cin >> dir >> steps;
int dx = (dir=='E') - (dir=='W');
int dy = (dir=='N') - (dir=='S');
while (steps--) {
x += dx; y += dy;
cnt[{x,y}]++;
}
}
int doubleMowed = 0;
for (auto& [pos, c] : cnt) if (c >= 2) doubleMowed++;
cout << doubleMowed << "\n";
}
复杂度: O(总步数 × log),受 map 操作主导。
题目 3.2.5 — 二维区间加法 🟡 中等
N×M 网格(初始全零),Q 次操作每次给矩形 [r1,c1] 到 [r2,c2] 加 V,输出最终网格。
数据规模: 1 ≤ N, M ≤ 2000,1 ≤ Q ≤ 10⁵,1 ≤ r1 ≤ r2 ≤ N,1 ≤ c1 ≤ c2 ≤ M,-10⁹ ≤ V ≤ 10⁹(最终值需 long long)。
提示
二维差分数组:每次更新标记 4 个角,然后通过二维前缀和重建。核心思路: 二维差分数组。每次矩形更新只触及 4 个角。最终网格 = 差分数组的二维前缀和。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, m, q; cin >> n >> m >> q;
vector<vector<long long>> D(n+2, vector<long long>(m+2, 0));
while (q--) {
int r1, c1, r2, c2; long long v;
cin >> r1 >> c1 >> r2 >> c2 >> v;
D[r1][c1] += v;
D[r1][c2+1] -= v;
D[r2+1][c1] -= v;
D[r2+1][c2+1] += v;
}
for (int i = 1; i <= n; i++)
for (int j = 1; j <= m; j++)
D[i][j] += D[i-1][j] + D[i][j-1] - D[i-1][j-1];
for (int i = 1; i <= n; i++)
for (int j = 1; j <= m; j++)
cout << D[i][j] << " \n"[j == m];
}
复杂度: O(Q + N × M)。
题目 3.2.6 — 最大子数组(Kadane 算法) 🟡 中等 读取 N 个整数(可能为负),找连续子数组的最大和。
数据规模: 1 ≤ N ≤ 10⁶,-10⁹ ≤ A[i] ≤ 10⁹(答案需 long long)。
提示
Kadane 算法。如果所有数都是负数,答案 = 最大的单个元素。核心思路: 在每个位置,要么开始新的子数组,要么延伸当前的。cur = max(A[i], cur + A[i]),追踪最优值。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
long long best = LLONG_MIN, cur = 0;
for (int i = 0; i < n; i++) {
long long x; cin >> x;
cur = max(x, cur + x);
best = max(best, cur);
}
cout << best << "\n";
}
为什么当 cur+x < x 时从头开始? 因为负的运行和只会损害未来的项——丢弃它,从当前元素重新开始。
下面的追踪图展示了 Kadane 算法在 [-2, 1, -3, 4, -1, 2, 1, -5, 4] 上每一步的 cur 与 best 变化,最优子数组用绿色高亮:
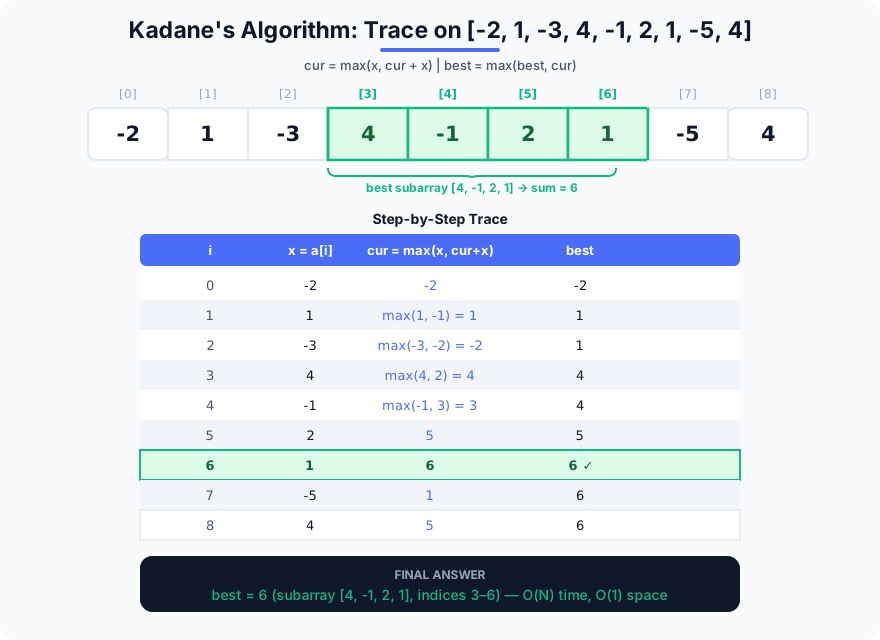 复杂度: O(N) 时间,O(1) 空间。
差分数组专项练习
下面几道题专门训练差分数组。建议先判断题目属于哪一类:
- 一维区间加法,最后输出数组:用一维差分。
- 一维区间覆盖次数,最后统计答案:用一维差分 + 扫描统计。
- 二维矩形加法或覆盖次数:用二维差分。
- 有中途查询:普通差分通常不够,需要树状数组或线段树。
题目 3.2.7 — 区间加法后的最大值 🟢 简单
有一个长度为 N 的数组,初始全为 0。接下来有 M 次操作,每次给区间 [L,R] 内所有位置加上 V。所有操作结束后,输出数组中的最大值。
数据规模: 1 ≤ N, M ≤ 10⁶,1 ≤ L ≤ R ≤ N,-10⁹ ≤ V ≤ 10⁹(最大值需 long long)。
提示
不需要保存最终数组的每个值。用差分数组记录所有区间加法,最后从左到右做前缀和,同时维护最大值。核心思路: 每次区间加法只改两个位置:diff[L] += V,diff[R+1] -= V。最后扫描时,当前前缀和就是当前位置的最终值。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
int n, m;
cin >> n >> m;
vector<long long> diff(n + 2, 0);
while (m--) {
int l, r;
long long v;
cin >> l >> r >> v;
diff[l] += v;
diff[r + 1] -= v;
}
long long cur = 0;
long long best = LLONG_MIN;
for (int i = 1; i <= n; i++) {
cur += diff[i];
best = max(best, cur);
}
cout << best << "\n";
return 0;
}
复杂度: O(N + M) 时间,O(N) 空间。
题目 3.2.8 — 被覆盖至少 K 次的位置数 🟡 中等
数轴上有 N 个位置,编号 1..N。给出 M 个区间 [L,R],表示这个区间被覆盖一次。请统计最后有多少个位置被覆盖次数至少为 K。
数据规模: 1 ≤ N, M ≤ 10⁶,1 ≤ L ≤ R ≤ N,1 ≤ K ≤ M。
提示
每个区间覆盖一次等价于区间加 `1`。先用差分数组求出每个位置的覆盖次数,再统计 `>= K` 的位置数量。核心思路: 这题不是要求输出最终数组,而是要求统计满足条件的位置数。差分数组恢复时顺手统计即可。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
int n, m, k;
cin >> n >> m >> k;
vector<int> diff(n + 2, 0);
while (m--) {
int l, r;
cin >> l >> r;
diff[l] += 1;
diff[r + 1] -= 1;
}
int cur = 0;
int answer = 0;
for (int i = 1; i <= n; i++) {
cur += diff[i];
if (cur >= k) answer++;
}
cout << answer << "\n";
return 0;
}
复杂度: O(N + M) 时间,O(N) 空间。
题目 3.2.9 — 原数组上的区间加法 🟡 中等
给定一个长度为 N 的原数组 A。接下来有 M 次操作,每次给区间 [L,R] 内所有元素加上 V。所有操作结束后,输出最终数组。
数据规模: 1 ≤ N, M ≤ 10⁵,1 ≤ L ≤ R ≤ N,-10⁹ ≤ A[i], V ≤ 10⁹(最终值需 long long)。
提示
这题初始数组不是全零。可以只用差分数组记录“额外增加量”,最后把增加量加回原数组;也可以先把原数组转成差分数组后直接修改。核心思路: 最简单的写法是:diff 只记录所有操作带来的增量。最后扫描 diff 得到当前位置总共增加了多少,再加到 A[i] 上。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
int n, m;
cin >> n >> m;
vector<long long> a(n + 1);
for (int i = 1; i <= n; i++) {
cin >> a[i];
}
vector<long long> diff(n + 2, 0);
while (m--) {
int l, r;
long long v;
cin >> l >> r >> v;
diff[l] += v;
diff[r + 1] -= v;
}
long long add = 0;
for (int i = 1; i <= n; i++) {
add += diff[i];
cout << a[i] + add << " \n"[i == n];
}
return 0;
}
复杂度: O(N + M) 时间,O(N) 空间。
题目 3.2.10 — 矩形覆盖次数 🟡 中等
有一个 R × C 的网格,初始每个格子的覆盖次数都是 0。给出 M 个矩形,每个矩形由左上角 (r1,c1) 和右下角 (r2,c2) 表示。每个矩形会让内部所有格子的覆盖次数加 1。请统计最后有多少个格子的覆盖次数至少为 K。
数据规模: 1 ≤ R, C ≤ 2000,1 ≤ M ≤ 10⁵,1 ≤ r1 ≤ r2 ≤ R,1 ≤ c1 ≤ c2 ≤ C,1 ≤ K ≤ M。
提示
这是二维差分数组。每个矩形更新四个角:左上 `+1`,右上外侧 `-1`,左下外侧 `-1`,右下外侧 `+1`。最后做二维前缀和并统计答案。核心思路: 二维差分的四角标记是 + - - +。恢复时使用二维前缀和公式:D[r][c] += D[r-1][c] + D[r][c-1] - D[r-1][c-1]。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
int R, C, M, K;
cin >> R >> C >> M >> K;
vector<vector<int>> diff(R + 2, vector<int>(C + 2, 0));
while (M--) {
int r1, c1, r2, c2;
cin >> r1 >> c1 >> r2 >> c2;
diff[r1][c1] += 1;
diff[r1][c2 + 1] -= 1;
diff[r2 + 1][c1] -= 1;
diff[r2 + 1][c2 + 1] += 1;
}
int answer = 0;
for (int r = 1; r <= R; r++) {
for (int c = 1; c <= C; c++) {
diff[r][c] += diff[r - 1][c]
+ diff[r][c - 1]
- diff[r - 1][c - 1];
if (diff[r][c] >= K) answer++;
}
}
cout << answer << "\n";
return 0;
}
复杂度: O(R × C + M) 时间,O(R × C) 空间。
题目 3.2.11 — 判断是否需要差分数组 🟡 中等
下面四种题目分别应该优先考虑什么数据结构或算法?
- 数组不变,很多次询问
[L,R]的区间和。 - 很多次给
[L,R]加值,所有操作结束后输出最终数组。 - 很多次给
[L,R]加值,并且每次操作后立刻询问某个位置的值。 - 很多次给矩形区域加值,所有操作结束后统计每个格子的最终值。
提示
区分关键点:是查询还是修改?是一维还是二维?是否有“中途查询”?✅ 完整题解
- 前缀和。 数组不变,多次区间和查询,预处理后每次
O(1)。 - 一维差分数组。 多次区间加法,最后统一恢复结果。
- 树状数组或线段树。 更新和查询交替出现,普通差分数组无法直接处理中途查询。
- 二维差分数组。 矩形区域批量加值,最后统一重建网格。
这道题的重点不是写代码,而是学会从题面信号中判断该用哪种工具。
🏆 挑战题:奶牛与油漆桶 N×M 网格中有油漆桶,每个有一个正值。选择任意矩形子网格。得分 = (子网格最大值) - (边界格子之和)。找最优矩形。(N, M ≤ 500)
✅ 解题思路
朴素枚举所有 O(N²M²) 矩形对 500² 来说太慢。改进方案:
- 用二维前缀和实现 O(1) 求和查询
- 对子网格中的最大值:预处理二维稀疏表(或每行 RMQ)实现 O(1) 最大值查询
- 边界和 = 总和 - 内部和(均通过前缀和)
总计:O(N²M²) 枚举 × O(1) 每次查询 = 对 N,M ≤ 500 在时间限制内。
第 3.3 章:排序与搜索
排序和搜索是计算机科学中最基础的两种操作。在 USACO 中,一旦把数据正确排序,大量问题就迎刃而解。而二分查找——在 O(log n) 时间内搜索有序数组——是你会反复用到的技术。
3.3.1 排序为什么重要
考虑这道题:「给定 N 头奶牛的身高,找出身高最接近的两头奶牛。」
- 不排序的做法: 比较每一对 →
O(N²)。对 N = 10^5,是 10^10 次操作,超时。 - 排序的做法: 排序身高 →
O(N log N)。然后最近的一对一定是相邻的!检查 N-1 对 →O(N)。总计:O(N log N)。✓
💡 核心思路: 排序能把很多
O(N²)暴力解法变成O(N log N)或O(N)解法。当你看到「找满足属性 X 的对」或「找涉及两个元素的最小/最大值」时,始终先考虑排序。
复杂度分析:
- 排序:
O(N log N)时间,O(log N)空间(递归栈深度;std::sort使用 Introsort——快速排序 + 堆排序 + 插入排序的混合,三个分支最多使用 O(log N) 的栈空间) - 排序后:相邻比较或双指针技术是
O(N)
3.3.2 排序的工作原理(概念)
你不需要自己实现排序算法——std::sort 帮你做了。但理解背后的思想有助于你分析时间复杂度并选择正确的方法。
以下是四种经典排序算法,每种都配有交互式可视化帮助你理解。
| 算法 | 时间复杂度 | 空间 | 稳定? | 核心思想 |
|---|---|---|---|---|
| 冒泡排序 | O(N²) | O(1) | ✅ | 交换相邻元素;大值「冒泡」到末尾 |
| 插入排序 | O(N²) / O(N) 最优 | O(1) | ✅ | 将每个元素插入已排序区域的正确位置 |
| 归并排序 | O(N log N) | O(N) | ✅ | 分治:递归分割,然后合并 |
| 快速排序 | O(N log N) 平均 | O(log N) | ❌ | 分治:以枢轴为界分区,递归 |
🫧 冒泡排序 —— O(N²)
反复扫描数组,交换顺序错误的相邻元素。每次遍历把当前最大值「冒泡」到未排序区域的末尾:
初始: [64, 34, 25, 12, 22, 11, 90]
第1遍: [34, 25, 12, 22, 11, 64, 90] ← 64 冒泡到倒数第2位
第2遍: [25, 12, 22, 11, 34, 64, 90] ← 34 冒泡到倒数第3位
第3遍: [12, 22, 11, 25, 34, 64, 90] ← 25 冒泡到倒数第4位
...
📝 注意: 90 一开始就在正确位置,第1遍没有移动它——而是 64(次大值)冒泡到倒数第2位。每次遍历保证末尾多一个元素到达最终有序位置。
冒泡排序是 O(N²)。竞赛编程中对大输入绝不要用它。 我们讲它只是因为概念上最简单。
🃏 插入排序 —— O(N²) / 最优 O(N)
把数组分为左侧「已排序区」和右侧「未排序区」。每步取未排序区的第一个元素,插入到已排序区的正确位置:
开始: [64 | 34, 25, 12, 22, 11, 90] ← | 左侧已排序
i=1: [34, 64 | 25, 12, 22, 11, 90] ← 34 插到 64 之前
i=2: [25, 34, 64 | 12, 22, 11, 90] ← 25 插到最前
i=3: [12, 25, 34, 64 | 22, 11, 90] ← 12 插到最前
...
💡 插入排序的优势: 对几乎已排序的数组非常快(接近 O(N))。
std::sort对小子数组会切换到插入排序。
void insertionSort(vector<int>& a) {
int n = a.size();
for (int i = 1; i < n; i++) {
int key = a[i]; // 要插入的元素
int j = i - 1;
// 将大于 key 的元素向右移动一位
while (j >= 0 && a[j] > key) {
a[j + 1] = a[j];
j--;
}
a[j + 1] = key; // 把 key 放到正确位置
}
}
🔀 归并排序 —— 始终 O(N log N)
分治:递归地将数组分成两半,然后将两个已排序的半部合并:
[38, 27, 43, 3, 9, 82, 10]
↓ 递归分割
[38,27,43,3] [9,82,10]
[38,27] [43,3] [9,82] [10]
[38][27][43][3] [9][82][10]
↓ 自底向上合并
[27,38] [3,43] [9,82] [10]
[3,27,38,43] [9,10,82]
[3,9,10,27,38,43,82] ✓
归并排序在所有情况下都是 O(N log N),而且是稳定排序。
void merge(vector<int>& a, int lo, int mid, int hi) {
vector<int> tmp(a.begin() + lo, a.begin() + hi + 1);
int i = lo, j = mid + 1, k = lo;
while (i <= mid && j <= hi) {
if (tmp[i - lo] <= tmp[j - lo]) {
a[k++] = tmp[i - lo]; // 左半部分更小,优先放入以保持稳定性
i++;
} else {
a[k++] = tmp[j - lo];
j++;
}
}
while (i <= mid) { a[k++] = tmp[i - lo]; i++; }
while (j <= hi) { a[k++] = tmp[j - lo]; j++; }
}
void mergeSort(vector<int>& a, int lo, int hi) {
if (lo >= hi) return;
int mid = lo + (hi - lo) / 2;
mergeSort(a, lo, mid);
mergeSort(a, mid + 1, hi);
merge(a, lo, mid, hi);
}
⚡ 快速排序 —— 平均 O(N log N)
快速排序是 std::sort 底层的核心算法之一,关键思想是分治:
- 选择一个枢轴元素(通常是最后一个元素)
- 分区: 将所有 ≤ 枢轴的元素移到左边,> 枢轴的移到右边;枢轴落到最终位置
- 对左右子数组递归
[8, 3, 6, 1, 9, 2, 7, 4] ← 枢轴 = 4
↓ 分区
[3, 1, 2, 4, 9, 6, 7, 8] ← 4 在最终位置;左边 ≤ 4,右边 > 4
↑_______↑ ↑ ↑__________↑
左子数组 右子数组
递归 [3,1,2] → [1,2,3]
递归 [9,6,7,8] → [6,7,8,9]
最终:[1, 2, 3, 4, 6, 7, 8, 9] ✓

// 对 arr[lo..hi] 用最后一个元素作枢轴进行分区。
// 返回枢轴的最终下标。
int partition(vector<int>& arr, int lo, int hi) {
int pivot = arr[hi]; // 选最后一个元素为枢轴
int i = lo - 1; // i 指向「≤ 枢轴」区域的末尾
for (int j = lo; j < hi; j++) {
if (arr[j] <= pivot) {
i++;
swap(arr[i], arr[j]); // 把 arr[j] 纳入 ≤ 枢轴区域
}
}
swap(arr[i + 1], arr[hi]); // 把枢轴放到最终位置
return i + 1; // 返回枢轴的下标
}
void quickSort(vector<int>& arr, int lo, int hi) {
if (lo >= hi) return; // 基础情况:子数组长度 ≤ 1
int p = partition(arr, lo, hi); // p 是枢轴的最终位置
quickSort(arr, lo, p - 1); // 排序左子数组
quickSort(arr, p + 1, hi); // 排序右子数组
}
⚠️ 最坏情况: 若枢轴每次都是最大或最小值(例如已排序的输入),递归深度退化到 O(N),总时间变成 O(N²)。
std::sort通过随机选择枢轴或三数取中来避免这一点,保证最坏 O(N log N)。
| 情况 | 时间 | 备注 |
|---|---|---|
| 平均 | O(N log N) | 枢轴大约将数组对半分 |
| 最坏 | O(N²) | 枢轴每次都是极端值(已排序输入) |
| 空间 | O(log N) | 递归栈深度(平均);若枢轴每次极端则最坏 O(N) |
🔢 计数排序 —— O(N + W)
适用场景: 元素是整数,值域范围 W 不太大(如 W ≤ 10^6)。
核心思想: 统计每个值出现的次数,再按值输出。
// 计数排序(稳定,O(N+W))
// 要求:所有元素在 [0, W) 范围内
void countingSort(vector<int>& a, int W) {
int n = a.size();
vector<int> cnt(W, 0), out(n);
// 第一步:统计每个值的出现次数
for (int x : a) cnt[x]++;
// 第二步:变为前缀和(cnt[i] = 最终 <= i 的元素个数)
for (int i = 1; i < W; i++) cnt[i] += cnt[i-1];
// 第三步:从后向前放置(保证稳定性!)
for (int i = n - 1; i >= 0; i--) {
out[--cnt[a[i]]] = a[i];
}
a = out;
}
// 对键范围已知的使用示例:
// countingSort(arr, 100); // 所有元素在 [0, 99]
💡 竞赛中的典型应用: 数组元素范围 ≤ 10^6 时比
std::sort快;基数排序的子程序。
📦 基数排序 —— O(N × d)
适用场景: 整数排序,位数 d 固定(如 32 位整数 d=32/基数,十进制 d=10)。
核心思想: 对每一位(从最低位到最高位)进行一次计数排序。
// 基数排序(以 10 为基数的十进制版本)
// O(N * d),d 为最大数的十进制位数
void radixSort(vector<int>& a) {
int maxVal = *max_element(a.begin(), a.end());
int n = a.size();
// 从最低位(个位)到最高位逐位排序
for (int exp = 1; maxVal / exp > 0; exp *= 10) {
vector<int> cnt(10, 0), out(n);
// 统计当前位的频率
for (int i = 0; i < n; i++)
cnt[(a[i] / exp) % 10]++;
// 前缀和
for (int i = 1; i < 10; i++)
cnt[i] += cnt[i-1];
// 从后向前放置(稳定性保证)
for (int i = n-1; i >= 0; i--) {
int digit = (a[i] / exp) % 10;
out[--cnt[digit]] = a[i];
}
a = out;
}
}
追踪示例(对 [170, 45, 75, 90, 802, 24, 2, 66] 排序):
初始:[170, 45, 75, 90, 802, 24, 2, 66]
按个位排序:[170, 90, 802, 2, 24, 45, 75, 66]
按十位排序:[802, 2, 24, 45, 66, 170, 75, 90]
按百位排序:[2, 24, 45, 66, 75, 90, 170, 802] ← 有序!
📊 排序算法完整对比
| 算法 | 平均时间 | 最坏时间 | 空间 | 稳定 | 适用场景 |
|---|---|---|---|---|---|
| 冒泡排序 | O(N²) | O(N²) | O(1) | ✅ | 教学用,不实用 |
| 插入排序 | O(N²) | O(N²) | O(1) | ✅ | 小数组或近似有序 |
| 归并排序 | O(N log N) | O(N log N) | O(N) | ✅ | 需要稳定排序 |
| 快速排序 | O(N log N) | O(N²) | O(log N) | ❌ | 通用高效(std::sort) |
| 堆排序 | O(N log N) | O(N log N) | O(1) | ❌ | 内存受限场景 |
| 计数排序 | O(N+W) | O(N+W) | O(W) | ✅ | 整数,值域有限 |
| 基数排序 | O(N×d) | O(N×d) | O(N+k) | ✅ | 固定长度整数/字符串 |
如何选择?
- 通用场景 →
std::sort(底层是快速排序/堆排序混合) - 需要稳定性 →
std::stable_sort(底层是归并排序) - 整数,值域 ≤ 10^6 → 计数排序
- 大量整数,值域很大但位数固定 → 基数排序
3.3.3 std::sort 实战
⚠️ 稳定性说明:
std::sort不稳定——它使用 Introsort(快速排序 + 堆排序 + 插入排序的混合),不保留相等元素的相对顺序。如需稳定排序,改用std::stable_sort。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> v(n);
for (int &x : v) cin >> x;
// 升序排序
sort(v.begin(), v.end());
// 降序排序
sort(v.begin(), v.end(), greater<int>());
// 只排序向量的一部分(下标 2 到 5,含)
sort(v.begin() + 2, v.begin() + 6);
for (int x : v) cout << x << " ";
cout << "\n";
return 0;
}
按多个条件排序
经常需要先按一个字段排序,相同时用另一个字段打平。用 pair 时这是自动的(先按 .first,再按 .second):
vector<pair<int, string>> students;
students.push_back({85, "Alice"});
students.push_back({92, "Bob"});
students.push_back({85, "Charlie"});
sort(students.begin(), students.end());
// 结果:{85, "Alice"}, {85, "Charlie"}, {92, "Bob"}
// 先按成绩排,成绩相同时按姓名字典序
自定义比较器
比较器是一个函数,当第一个参数应该排在第二个参数前面时返回 true。
最清晰的写法是独立函数:
struct Cow {
string name;
int weight;
int height;
};
// 按体重升序;体重相同时按身高降序
bool cmpCow(const Cow &a, const Cow &b) {
if (a.weight != b.weight) return a.weight < b.weight; // 较轻的优先
return a.height > b.height; // 打平:较高的优先
}
int main() {
vector<Cow> cows = {{"Bessie", 500, 140}, {"Elsie", 480, 135}, {"Moo", 500, 138}};
sort(cows.begin(), cows.end(), cmpCow);
for (auto &c : cows) {
cout << c.name << " " << c.weight << " " << c.height << "\n";
}
// 输出:
// Elsie 480 135
// Bessie 500 140
// Moo 500 138
return 0;
}
💡 风格说明: 将
cmp定义为独立函数(而非内联 lambda)让排序逻辑更易读、测试和复用——特别是涉及多个字段时。
排序算法稳定性
⚠️ 重要:
std::sort不稳定——相等元素排序后可能以任意顺序出现。如需保留相等元素的相对顺序,用std::stable_sort。
排序算法稳定性对比
| 算法 | 时间复杂度 | 空间复杂度 | 稳定? | C++ 函数 |
|---|---|---|---|---|
| std::sort | O(N log N) | O(log N) | ❌ | sort() |
| std::stable_sort | O(N log² N)* | O(N) | ✅ | stable_sort() |
| std::partial_sort | O(N log K) | O(1) | ❌ | partial_sort() |
| 计数排序 | O(N+K) | O(K) | ✅ | 手写 |
| 基数排序 | O(d(N+K)) | O(N+K) | ✅ | 手写 |
📝 说明:
std::sort使用 Introsort(快速排序 + 堆排序 + 插入排序的混合)。由于快速排序不稳定,std::sort不保证相等元素的相对顺序。当你按成绩对学生排序时,若需要相同成绩的学生保持原来的顺序,使用std::stable_sort。*
std::stable_sort在有足够额外内存(O(N))时是O(N log N),只有在内存受限需要原地归并时才退化到O(N log² N)。
图示:排序算法对比

这张图对比了常见排序算法的时间复杂度、空间占用和稳定性,帮助你在不同场景选择合适的算法。
计数排序 —— 小值域的 O(N+K)
当值是小范围 [0, MAXVAL] 内的有界整数时,计数排序远优于 std::sort:
// 计数排序:对范围 [0, MAXVAL] 内的整数
// 时间 O(N+MAXVAL),稳定排序
void countingSort(vector<int>& arr, int maxVal) {
vector<int> cnt(maxVal + 1, 0);
for (int x : arr) cnt[x]++;
int idx = 0;
for (int v = 0; v <= maxVal; v++)
for (int i = 0; i < cnt[v]; i++) arr[idx++] = v;
}
// USACO 使用场景:值域小时(如奶牛 ID 1-1000)比 std::sort 更快
什么时候在 USACO 用计数排序:
- 奶牛 ID 在 [1, 1000] 范围内,N = 10^6 → 计数排序是 O(N + 1000) vs O(N log N)
- 成绩值 [0, 100] → 极快
- 颜色类别 [0, 3] → 瞬间完成
注意: 若 MAXVAL 很大(如 10^9),计数排序需要 O(MAXVAL) 内存——不要用。先做坐标压缩(3.3.6 节),再计数。
3.3.4 二分查找
二分查找在已排序数组中以 O(log n) 查找目标——而线性搜索是 O(n)。
类比: 在字典里查词。你不会从 A 开始逐条读——你翻到中间,判断你的词在前面还是后面,然后重复。每步将搜索空间减半:k 步后,从 N 个候选缩减到 N/2^k。当 N/2^k < 1 时结束——需要 k = log₂(N) 步。
💡 核心思路: 只要有单调谓词——一个「假假假…真真真」(或反过来)的条件,就可以用二分查找。你可以在
O(log N)时间内二分找到假和真之间的边界。
图示:二分查找示例

上图展示在 [1,3,5,7,9,11,13] 中单步二分查找 7。左(L)、右(R)和中(M)指针清晰可见。核心技巧:用 mid = left + (right - left) / 2 计算中间位置,避免 (left + right) / 2 的整数溢出。
手写二分查找
// 二分查找 — O(log N)
#include <bits/stdc++.h>
using namespace std;
// 在有序 arr 中返回 target 的下标,未找到返回 -1
int binarySearch(const vector<int> &arr, int target) {
int lo = 0, hi = (int)arr.size() - 1;
while (lo <= hi) {
int mid = lo + (hi - lo) / 2; // ← 关键行:避免溢出(不要用 (lo+hi)/2)
if (arr[mid] == target) {
return mid; // 找到!
} else if (arr[mid] < target) {
lo = mid + 1; // 目标在右半部分
} else {
hi = mid - 1; // 目标在左半部分
}
}
return -1; // 未找到
}
int main() {
vector<int> v = {1, 3, 5, 7, 9, 11, 13, 15};
cout << binarySearch(v, 7) << "\n"; // 3(下标)
cout << binarySearch(v, 6) << "\n"; // -1(未找到)
return 0;
}
在 [1, 3, 5, 7, 9, 11, 13, 15] 中搜索 7 的逐步追踪:
lo=0, hi=7:mid=3,arr[3]=7 → 找到,下标 3 ✓
搜索 6:
lo=0, hi=7:mid=3,arr[3]=7 > 6 → hi=2
lo=0, hi=2:mid=1,arr[1]=3 < 6 → lo=2
lo=2, hi=2:mid=2,arr[2]=5 < 6 → lo=3
lo=3 > hi=2:循环结束 → 返回 -1 ✓
为什么用 lo + (hi - lo) / 2? 如果 lo 和 hi 都很大(接近 INT_MAX),lo + hi 会溢出!这个写法等价但安全。
STL 方式:lower_bound 和 upper_bound
竞赛编程中你实际上几乎总是想用这两个:
// STL 二分操作 — 全部 O(log N)
#include <bits/stdc++.h>
using namespace std;
int main() {
vector<int> v = {1, 3, 3, 5, 7, 9, 9, 11};
// lower_bound:第一个 >= target 的迭代器
auto lb = lower_bound(v.begin(), v.end(), 3);
cout << *lb << "\n"; // 3(第一个 3)
cout << lb - v.begin() << "\n"; // 1(下标)
// upper_bound:第一个 > target 的迭代器
auto ub = upper_bound(v.begin(), v.end(), 3);
cout << *ub << "\n"; // 5(所有 3 后面的第一个元素)
cout << ub - v.begin() << "\n"; // 3(下标)
// 统计出现次数:upper_bound - lower_bound
int count_of_3 = upper_bound(v.begin(), v.end(), 3)
- lower_bound(v.begin(), v.end(), 3);
cout << count_of_3 << "\n"; // 2
// 检查是否存在
bool exists = binary_search(v.begin(), v.end(), 7);
cout << exists << "\n"; // 1
// 找 <= target 的最大值(向下取整)
auto it = upper_bound(v.begin(), v.end(), 6);
if (it != v.begin()) {
--it;
cout << *it << "\n"; // 5(<= 6 的最大值)
}
return 0;
}
⚠️ 常见错误: 在未排序的容器上用
lower_bound/upper_bound。这些函数假设已排序——对未排序的数据会给出错误结果,没有任何报错!
3.3.5 二分答案
这是 USACO Silver 中最强大、最常考的技术之一。核心思想:
不是在数组中搜索某个值,而是在答案空间本身进行二分查找。
什么情况下适用? 当:
- 答案是某个范围 [lo, hi] 内的数字
- 有一个
canAchieve(X)函数检查 X 是否可行 - 该函数单调:若 X 可行,所有 ≤ X 的值也可行(或所有 ≥ X 的值可行)
💡 核心思路: 单调性意味着存在一个「阈值」将可行与不可行答案分开。二分查找以
O(log(hi-lo))次canAchieve调用找到这个阈值。若每次调用需O(f(N)),总时间为O(f(N) × log(答案范围))。
经典示例:攻击性奶牛(SPOJ AGGRCOW / 经典题)
题目: N 个马厩位于位置 p[1..N],放置 C 头奶牛以最大化任意两头奶牛间的最小距离。
数据规模: 2 ≤ C ≤ N ≤ 10⁵,0 ≤ p[i] ≤ 10⁹。
为什么用二分答案? 若能以最小间距 D 放置奶牛,也能以 D-1 的间距放置。所以可行性是单调的:存在阈值 D*,≥ D* 不可行,< D* 可行。二分查找 D*。
canPlace(minDist) 函数: 在最左侧的马厩放第一头奶牛,然后贪心地选择下一个距离至少为 minDist 的马厩。统计能放多少头奶牛——若 ≥ C,返回 true。
// 二分答案 — O(N log N log(最大距离))
#include <bits/stdc++.h>
using namespace std;
int n, c;
vector<int> stalls;
// 能否放置 c 头奶牛使任意两头间距 >= minDist?
bool canPlace(int minDist) {
int placed = 1; // 第一头放在马厩 0
int lastPos = stalls[0]; // 最后放置的奶牛的位置
for (int i = 1; i < n; i++) {
if (stalls[i] - lastPos >= minDist) { // 这个马厩足够远
placed++;
lastPos = stalls[i];
}
}
return placed >= c; // 放了 c 头奶牛吗?
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n >> c;
stalls.resize(n);
for (int &x : stalls) cin >> x;
sort(stalls.begin(), stalls.end()); // 必须先排序!
// 二分答案:最大可能的最小距离是多少?
int lo = 1, hi = stalls.back() - stalls.front();
int answer = 0;
while (lo <= hi) {
int mid = lo + (hi - lo) / 2;
if (canPlace(mid)) {
answer = mid; // mid 可行,尝试更大的
lo = mid + 1;
} else {
hi = mid - 1; // mid 不可行,尝试更小的
}
}
cout << answer << "\n";
return 0;
}
对 stalls = [1, 2, 4, 8, 9], C = 3 的追踪:
📄 Code 完整代码
排序后:[1, 2, 4, 8, 9]
lo=1, hi=8
mid=4:canPlace(4)?
在 1 放奶牛。下一个 ≥ 1+4=5 的:8,放在 8。
下一个 ≥ 8+4=12:没有。总共放了 2 头 < 3。返回 false。
→ hi = 3
mid=2:canPlace(2)?
在 1 放。下一个 ≥ 3:4,放在 4。
下一个 ≥ 6:8,放在 8。总共 3 头 ≥ 3。返回 true。
→ answer=2, lo=3
mid=3:canPlace(3)?
在 1 放。下一个 ≥ 4:4,放在 4。
下一个 ≥ 7:8,放在 8。总共 3 头 ≥ 3。返回 true。
→ answer=3, lo=4
lo=4 > hi=3:结束。答案 = 3
另一个经典:最少时间完成任务(绳子切割)
题目: 给定 N 根长度为 L[i] 的绳子,切出 K 根等长的绳子。每段能切到的最大长度是多少?
数据规模: 1 ≤ N ≤ 10⁴,1 ≤ K ≤ 10⁴,1 ≤ L[i] ≤ 10⁵(每根绳子最多切一次,不能拼接)。
📝 代码片段: 以下是代码片段——完整程序结构参考上面的攻击性奶牛示例。
// 代码片段 — 完整程序请参考攻击性奶牛示例
// 能否从绳子中切出 K 段长度 >= len 的?
bool canCut(vector<int> &ropes, long long len, int K) {
long long count = 0;
for (int r : ropes) count += r / len; // 每根绳子能切出的段数
return count >= K;
}
// 二分:最大化 len 使 canCut(len) 为真
long long lo = 1, hi = *max_element(ropes.begin(), ropes.end());
long long answer = 0;
while (lo <= hi) {
long long mid = lo + (hi - lo) / 2;
if (canCut(ropes, mid, K)) {
answer = mid;
lo = mid + 1;
} else {
hi = mid - 1;
}
}
二分答案通用模板:
// 通用模板 — 根据题目调整 lo、hi 和 check()
long long lo = 最小可能答案;
long long hi = 最大可能答案;
long long answer = lo; // 若无有效答案则为 -1
while (lo <= hi) {
long long mid = lo + (hi - lo) / 2;
if (check(mid)) { // mid 可行
answer = mid; // 保存
lo = mid + 1; // 尝试更好的(取决于题目是更大还是更小)
} else {
hi = mid - 1; // mid 不可行,降低
}
}
🏆 USACO 技巧: 每当 USACO 题目问「满足某条件的最大 X 是多少」或「满足某条件的最小 X 是多少」,就考虑二分答案。这个技术频繁解决 USACO Silver 题目。
3.3.6 坐标压缩
有时值很大(最多 10^9),但不同的值不多。坐标压缩将它们映射到小下标(0, 1, 2, ...)。
// 坐标压缩 — O(N log N)
#include <bits/stdc++.h>
using namespace std;
int main() {
vector<int> A = {100, 500, 200, 100, 700, 200};
// 第一步:获取有序唯一值
vector<int> sorted_unique = A;
sort(sorted_unique.begin(), sorted_unique.end());
sorted_unique.erase(unique(sorted_unique.begin(), sorted_unique.end()),
sorted_unique.end());
// sorted_unique = {100, 200, 500, 700}
// 第二步:将每个原始值映射到压缩后的下标
vector<int> compressed(A.size());
for (int i = 0; i < (int)A.size(); i++) {
compressed[i] = lower_bound(sorted_unique.begin(), sorted_unique.end(), A[i])
- sorted_unique.begin();
// 100→0, 200→1, 500→2, 700→3
}
for (int x : compressed) cout << x << " ";
cout << "\n"; // 0 2 1 0 3 1
return 0;
}
3.3.7 进阶二分答案——三个示例
示例一:最少时间完成任务(参数搜索)
题目: N 个工人,M 个任务各有工作量 effort[i]。将连续的任务分配给工人(每个工人得到连续的任务),最小化任意工人的最大花费时间(最小化瓶颈)。
数据规模: 1 ≤ K ≤ N ≤ 10⁵,1 ≤ effort[i] ≤ 10⁹(单个工人的工作量之和需 long long)。
这是「画家分区」问题。对答案(最大时间 T)二分,检查 T 是否可行。
📝 模板切换说明: 这里用
while (lo < hi)加hi = mid——与 3.3.5 节的while (lo <= hi)不同。我们切换是因为我们在最小化答案:canFinish(mid)为真时,mid本身是候选,所以设hi = mid(而非hi = mid - 1)避免错过它。循环结束时lo == hi就是答案,不需要单独的answer变量。详见 FAQ Q2。
// 检查:能否将任务分配给 K 个工人,使每人工作量 <= T?
bool canFinish(vector<int>& tasks, int K, long long T) {
int workers = 1;
long long current = 0;
for (int t : tasks) {
if (t > T) return false; // 单个任务超过 T——不可能
if (current + t > T) {
workers++; // 开始新工人
current = t;
if (workers > K) return false;
} else {
current += t;
}
}
return true;
}
// 对 T 二分 — 用「lo < hi」模板(最小化答案)
long long lo = *max_element(tasks.begin(), tasks.end()); // T 的最小可能值
long long hi = accumulate(tasks.begin(), tasks.end(), 0LL); // T 的最大值(1 个工人)
while (lo < hi) {
long long mid = lo + (hi - lo) / 2;
if (canFinish(tasks, K, mid)) hi = mid; // mid 可行,尝试更小
else lo = mid + 1; // mid 不可行,需要更大
}
cout << lo << "\n"; // 最小可能最大时间(循环结束时 lo == hi)
📝 注意: 这里二分查找最小可行 T,所以可行时用
hi = mid(不是answer = mid; lo = mid+1)。两种模板是镜像关系。
示例二:乘法表中的第 K 小
题目: N×M 乘法表,找第 K 小的值。
数据规模: 1 ≤ N, M ≤ 5×10⁴,1 ≤ K ≤ N×M(N×M 可达 2.5×10⁹,K 需 long long)。
表中的值是 1≤i≤N、1≤j≤M 的 i*j。对答案 X 二分:统计 ≤ X 的值有多少个。
// 统计 N×M 乘法表中 <= X 的值的个数
long long countLE(long long X, int N, int M) {
long long count = 0;
for (int i = 1; i <= N; i++) {
count += min((long long)M, X / i);
// 第 i 行的值是 i, 2i, ..., Mi
// 第 i 行中 <= X 的个数:min(M, floor(X/i))
}
return count;
}
// 二分查找第 K 小
long long lo = 1, hi = (long long)N * M;
while (lo < hi) {
long long mid = lo + (hi - lo) / 2;
if (countLE(mid, N, M) >= K) hi = mid;
else lo = mid + 1;
}
cout << lo << "\n";
复杂度: O(N log(NM)) —— 每次检查 O(N),共 O(log(NM)) 次迭代。
示例三:USACO 风格电缆长度(受 Agri-Net 启发)
题目: 给定 N 个农场位置,用电缆连接所有农场,电缆长度不超过 L。找能形成生成树的最大 L(所有边 ≤ L)。
数据规模: 1 ≤ N ≤ 500,0 ≤ 坐标 ≤ 10⁴,1 ≤ L ≤ 10⁶。
// 对最大电缆长度 L 二分
// 检查:只用 <= L 的边能否形成生成树?
// (等价于:限制到 <= L 的边后图是否连通?)
bool canConnect(vector<tuple<int,int,int>>& edges, int n, int L) {
DSU dsu(n);
for (auto [w, u, v] : edges) {
if (w <= L) dsu.unite(u, v);
}
return dsu.components == 1; // 所有节点都连通
}
3.3.8 lower_bound / upper_bound 完整速查表
// 注意:以下代码假设已定义:#define all(v) (v).begin(), (v).end()
vector<int> v = {1, 3, 3, 5, 7, 9, 9, 11};
// 0 1 2 3 4 5 6 7
// ── lower_bound:第一个 >= x 的位置 ──
lower_bound(all(v), 3) → 下标 1 (第一个 3)
lower_bound(all(v), 4) → 下标 3 (第一个 >= 4 的元素,即 5)
lower_bound(all(v), 12) → 下标 8 (越界:没有 >= 12 的元素)
// ── upper_bound:第一个 > x 的位置 ──
upper_bound(all(v), 3) → 下标 3 (所有 3 之后的第一个元素)
upper_bound(all(v), 4) → 下标 3 (与上同:没有 4)
upper_bound(all(v), 11) → 下标 8 (越界)
// ── 派生操作 ──
// 统计 x 的出现次数:
int cnt = upper_bound(all(v), 3) - lower_bound(all(v), 3); // cnt = 2
// x 是否存在?
binary_search(all(v), x) // O(log N),返回 bool
// <= x 的最大值(向下取整):
auto it = upper_bound(all(v), x);
if (it != v.begin()) cout << *prev(it);
// >= x 的最小值(向上取整):
auto it = lower_bound(all(v), x);
if (it != v.end()) cout << *it;
// < x 的最大值(严格向下取整):
auto it = lower_bound(all(v), x);
if (it != v.begin()) cout << *prev(it);
// < x 的元素个数:
lower_bound(all(v), x) - v.begin()
// <= x 的元素个数:
upper_bound(all(v), x) - v.begin()
// [a, b] 范围内的元素个数:
upper_bound(all(v), b) - lower_bound(all(v), a)
| 目标 | 代码 | 说明 |
|---|---|---|
| 第一个 >= x 的下标 | lower_bound(v.begin(), v.end(), x) - v.begin() | 若全都 < x 则等于 v.size() |
| 第一个 > x 的下标 | upper_bound(v.begin(), v.end(), x) - v.begin() | |
| x 的出现次数 | upper_bound(...,x) - lower_bound(...,x) | |
| <= x 的最大值 | *prev(upper_bound(...,x)) | 检查迭代器 ≠ begin |
| >= x 的最小值 | *lower_bound(...,x) | 检查迭代器 ≠ end |
| x 是否存在? | binary_search(...) | 返回 bool |
3.3.9 自定义谓词二分查找
对于非标准有序结构或自定义条件:
// 自定义谓词二分查找
// 在 [lo, hi] 范围内找第一个 pred(i) 为真的下标
// 假设:pred 单调,即 false...false, true...true
int lo = 0, hi = n - 1, answer = -1;
while (lo <= hi) {
int mid = lo + (hi - lo) / 2;
if (/* mid 上的某个条件 */) {
answer = mid;
hi = mid - 1; // 找更小的下标
} else {
lo = mid + 1;
}
}
// 示例:第一个 arr[i] - arr[0] >= D 的下标
// (对有序数组,arr[i] - arr[0] 单调非递减,
// 所以这个谓词是单调的:假...假,真...真)
// ⚠️ 关键要求:谓词必须单调,二分查找才有效!
{
int lo = 0, hi = n - 1, firstFar = -1;
while (lo <= hi) {
int mid = lo + (hi - lo) / 2;
if (arr[mid] - arr[0] >= D) {
firstFar = mid;
hi = mid - 1;
} else {
lo = mid + 1;
}
}
}
// 浮点数二分查找(基于精度)
double lo_f = 0.0, hi_f = 1e9;
for (int iter = 0; iter < 100; iter++) { // 100 次迭代 → 误差 < 1e-30
double mid = (lo_f + hi_f) / 2;
if (check(mid)) hi_f = mid;
else lo_f = mid;
}
// 答案:lo_f(或 hi_f,两者收敛到相同值)
🏆 USACO 专业技巧: 「二分答案」是最常见的 Silver 技术之一。当你看到「在约束条件下最大化/最小化 X」时,问自己:可行性函数是单调的吗? 如果是,就用二分查找。
3.3.10 三分查找——求单峰函数的极值 🔮 进阶 / Gold+
⚠️ 范围说明: 三分查找很少在 USACO Silver 中出现,偶尔出现在涉及几何优化或参数搜索的 Gold/Platinum 题目中。把本节当作补充知识——理解概念,但不要把它放在掌握二分查找之前。
二分查找需要单调谓词(假→真的边界)。对于单峰函数(先增后减),用三分查找找极大值。
💡 使用场景: 函数
f在[lo, hi]上单峰,即先严格递增后严格递减(或一直单方向)。三分查找以O(log((hi-lo)/eps))次求值找到极大值点。
USACO 出现情况: 三分查找在 Silver 级别极少出现。在 Gold/Platinum 级别偶尔出现在涉及几何优化(如「找直线上的最优点以最小化到各点的距离之和」)或对连续单峰函数做参数搜索的题目中。
// 三分查找:求单峰函数 f 在 [lo, hi] 上的极大值
// 前提:f 先增后减(单峰)
// 时间:连续情况 O(log((hi-lo)/eps)),整数情况 O(log N)
// f 必须在调用前声明/定义
double ternarySearch(double lo, double hi) {
for (int iter = 0; iter < 200; iter++) {
double m1 = lo + (hi - lo) / 3;
double m2 = hi - (hi - lo) / 3;
if (f(m1) < f(m2)) lo = m1; // 极大值在 [m1, hi] 中
else hi = m2; // 极大值在 [lo, m2] 中
}
return (lo + hi) / 2; // 极大值点(收敛后 lo ≈ hi)
}
// 整数三分查找(f 定义在整数上时):
int ternarySearchInt(int lo, int hi) {
// 用 > 2 而非 >= 2:保留至少 3 个候选值再暴力枚举。
// 范围缩至 2 时,m1 == m2(因为 (hi-lo)/3 == 0),会死循环。
while (hi - lo > 2) {
int m1 = lo + (hi - lo) / 3;
int m2 = hi - (hi - lo) / 3;
if (f(m1) < f(m2)) lo = m1 + 1;
else hi = m2 - 1;
}
// 检查剩余候选值 [lo, hi](最多 3 个元素)
int best = lo;
for (int x = lo + 1; x <= hi; x++)
if (f(x) > f(best)) best = x;
return best;
}
与二分查找的对比:
| 二分查找 | 三分查找 | |
|---|---|---|
| 要求 | 单调谓词 | 单峰函数 |
| 寻找 | 边界(假→真) | 极值(极大/极小) |
| 每步消除 | 一半范围 | 三分之一范围 |
| 达到 ε 精度的迭代次数 | log₂(range/ε) | log₃/₂(range/ε) ≈ 多 2.4 倍 |
⚠️ 注意: 整数三分查找需要小心——用
while (hi - lo > 2)避免范围缩到 2 或 3 个元素时的死循环,然后暴力检查剩余候选。
3.3.10 USACO 真题训练:排序之后,答案往往藏在相邻或边界中
排序与二分查找在 USACO 中最常见的作用不是「把数组排好看」,而是改变问题结构:
| 题面信号 | 常见做法 | 关键问题 |
|---|---|---|
| 找最接近/最小差值 | 排序后看相邻 | 为什么最优对一定相邻? |
| 多次区间计数 | 排序 + lower_bound/upper_bound | 左边界用谁?右边界用谁? |
| 序列几乎有序 | 排序副本对比 | 有多少位置和有序状态不同? |
| 大值域但少量点 | 排序坐标而非建大数组 | 值域 1e9 时不能开数组 |
真题 1:Out of Place(USACO 2018 January Bronze)— 排序副本找错位数量
题目链接: USACO 2018 January Bronze P3: Out of Place
对应模式: 排序副本 + 位置对比
难度定位: Bronze
题干解读
一列奶牛本来应该按身高非降序排列,但有一头奶牛站错了位置。每次只能交换相邻奶牛,问最少需要多少次交换才能恢复有序。
数据规模(与原题一致): 1 ≤ N ≤ 100,1 ≤ 身高 ≤ 10⁶。
关键条件:
- 只有一头奶牛错位,但她可能导致很多位置看起来不对。
- 身高可能重复,不能只看「第一个不同的位置」。
N很小,但这个题训练的是排序对比思维。
思路分析
把原数组复制一份并排序,得到正确的最终顺序。比较原数组和排序数组:
- 如果有
m个位置不同,答案是m - 1。 - 原因:一头错位奶牛经过相邻交换穿过
m-1个位置,每次交换能让她向正确位置移动一步。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("outofplace.in", "r", stdin);
// freopen("outofplace.out", "w", stdout);
int n;
cin >> n;
vector<int> original(n), sortedOrder(n);
for (int i = 0; i < n; i++) {
cin >> original[i];
sortedOrder[i] = original[i];
}
sort(sortedOrder.begin(), sortedOrder.end());
int different = 0;
for (int i = 0; i < n; i++) {
if (original[i] != sortedOrder[i]) different++;
}
cout << max(0, different - 1) << "\n";
return 0;
}
复杂度: 排序 O(N log N),比较 O(N),空间 O(N)。
易错点提醒
- 把不同位置数直接作为答案。 相邻交换次数是
different - 1,不是different。 - 忽略重复身高。 排序副本天然处理重复值,比手动找错位更稳。
- 以为必须模拟交换。 模拟容易错,排序对比直接给答案。
拓展思考
如果不再保证只有一头奶牛错位,而是任意排列,最少相邻交换次数就变成「逆序对数量」,需要归并排序计数或树状数组。
真题 2:Counting Haybales(USACO 2016 December Silver)— 有序数组上的区间计数
题目链接: USACO 2016 December Silver P1: Counting Haybales
对应模式: 排序 + lower_bound / upper_bound
难度定位: Silver 入门
题干解读
数轴上有 N 捆干草,位置可能很大。接下来 Q 次查询,每次给出区间 [A,B],问区间内有多少捆干草。
数据规模(与原题一致): 1 ≤ N, Q ≤ 10⁵,1 ≤ 位置 ≤ 10⁹,1 ≤ A ≤ B ≤ 10⁹。
关键条件:
- 位置值域很大,不能开频率数组或普通前缀和。
- 干草位置不会改变,查询很多。
- 只需要统计落在区间内的点数。
思路分析
排序所有位置。对于查询 [A,B]:
left = 第一个 >= A 的位置
right = 第一个 > B 的位置
answer = right - left
这正是 lower_bound 和 upper_bound 的定义。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("haybales.in", "r", stdin);
// freopen("haybales.out", "w", stdout);
int n, q;
cin >> n >> q;
vector<int> position(n);
for (int &x : position) cin >> x;
sort(position.begin(), position.end());
while (q--) {
int a, b;
cin >> a >> b;
auto left = lower_bound(position.begin(), position.end(), a);
auto right = upper_bound(position.begin(), position.end(), b);
cout << (right - left) << "\n";
}
return 0;
}
复杂度: 排序 O(N log N),每次查询 O(log N),总复杂度 O((N+Q) log N),空间 O(N)。
易错点提醒
- 右端点用错。 闭区间
[A,B]的右边界要用upper_bound(B),不是lower_bound(B)。 - 忘记排序。
lower_bound/upper_bound只对有序区间有意义。 - 试图按坐标建数组。 坐标可到
10^9,会内存爆炸。 - 迭代器差值类型。
right-left是距离,直接输出即可;若存入变量可用int(本题N≤1e5)或long long。
拓展思考
如果干草位置会动态添加/删除,静态排序数组不再适用;可以考虑 multiset、树状数组配合坐标压缩,或线段树维护动态计数。
⚠️ 第 3.3 章常见错误
- 比较器方向错误: lambda 必须在
a应该排在b前面时返回true。若a == b时返回true,会导致未定义行为(严格弱序违规)。 - 在未排序数组上二分查找:
lower_bound和upper_bound假设已排序。对未排序数据,结果毫无意义。 - 二分查找差一错误:
lo <= hi和lo < hi有区别。拿不准时,在 1 个和 2 个元素的数组上测试你的二分查找。 - 「二分答案」中答案范围错误: 若答案可能是 0,设
lo = 0而非lo = 1。若可能很大,确保hi足够大(必要时用long long)。 - 中间值计算整数溢出: 始终写
mid = lo + (hi - lo) / 2,绝不用(lo + hi) / 2。
本章总结
📌 核心要点
| 操作 | 方法 | 时间复杂度 | 备注 |
|---|---|---|---|
| 升序排序 | sort(v.begin(), v.end()) | O(N log N) | 使用 IntroSort |
| 降序排序 | sort(..., greater<int>()) | O(N log N) | |
| 自定义排序 | lambda 比较器 | O(N log N) | 必须是严格弱序 |
| 查找确切值 | binary_search | O(log N) | 返回 bool |
| 第一个 >= x 的下标 | lower_bound | O(log N) | 返回迭代器 |
| 第一个 > x 的下标 | upper_bound | O(log N) | 返回迭代器 |
| 统计值 x 的个数 | ub - lb | O(log N) | |
| 二分答案 | 手写 BS + check() | O(f(N) log V) | V = 答案范围 |
| 坐标压缩 | sort + unique + lower_bound | O(N log N) | 将大值映射到小下标 |
🧩 二分查找模板速查
| 场景 | 循环条件 | lo/hi 初值 | 更新规则 | 答案 | 参考小节 |
|---|---|---|---|---|---|
| 最大化满足条件的值 | while (lo <= hi) | lo=最小,hi=最大 | check(mid) → ans=mid, lo=mid+1 | ans | §3.3.5 |
| 最小化满足条件的值 | while (lo < hi) | lo=最小,hi=最大 | check(mid) → hi=mid | lo(循环结束时) | §3.3.7 |
| 浮点数二分查找 | 循环 100 次 | lo=最小,hi=最大 | check(mid) → hi=mid 否则 lo=mid | lo ≈ hi | §3.3.9 |
❓ 常见问题
Q1:sort 的时间复杂度是 O(N log N) 还是 O(N²)?
A:C++ 的
std::sort使用 Introsort(快速排序 + 堆排序 + 插入排序的混合),保证最坏O(N log N)。不需要担心退化到O(N²)。但注意:若自定义比较器不满足严格弱序,行为未定义(可能死循环或崩溃)。
Q2:二分查找中 lo <= hi 和 lo < hi 有什么区别?
A:两种风格对应不同模板:
while (lo <= hi):循环结束时 lo > hi,答案存在answer变量中。适合「查找目标值」或「最大化满足条件的值」。while (lo < hi):循环结束时 lo == hi,答案就是 lo。适合「最小化满足条件的值」。 两种都能解决所有问题,关键是搭配正确的更新规则。新手选一种坚持用。
Q3:「二分答案」适用于什么题目?怎么识别?
A:三个信号:① 题目问「满足……条件的最大/最小 X」;② 存在一个决策函数
check(X)能在多项式时间内判断可行性;③ 决策函数单调(X 可行 → X-1 也可行,或反过来)。三者都满足,就能用二分答案。
Q4:坐标压缩实际上有什么用?
A:当值域很大(如 10^9)但不同的值很少(如 10^5)时,坐标压缩将大值映射到小下标 0~N-1。这让你可以用数组而不是 map(更快),或对值域做前缀和/BIT 操作。USACO Silver 中频繁需要。
Q5:为什么 sort 的比较器不能用 <=?
A:C++ 排序要求比较器满足严格弱序:当 a == b 时,
comp(a,b)必须返回 false。<=在 a==b 时返回 true,违反了这条规则。结果是未定义行为——可能死循环、崩溃或产生错误排序。
🔗 与后续章节的联系
- 第 3.4 章(双指针):双指针技术经常在排序后使用——先排序
O(N log N),再双指针O(N) - 第 3.2 章(前缀和):前缀和数组本身有序,可以对其二分查找(如找第一个前缀和 >= 目标的位置)
- 第 4 部分和 5.4 章(贪心 + 最短路):Dijkstra 内部使用优先队列 + 贪心策略,与排序有根本关联
- 第 6.2 章(DP):最长递增子序列(LIS)可以用二分查找优化到
O(N log N) - **「二分答案」**是 USACO Silver 最核心的技术之一,在第 4 部分(贪心)中也常常结合使用
练习题
题目 3.3.1 — 最近点对 🟢 简单
读取 N 个整数,找差值最小的一对。
数据规模: 2 ≤ N ≤ 10⁵,-10⁹ ≤ a[i] ≤ 10⁹。
提示
排序数组,最近的一对排序后一定相邻。核心思路: 排序后,相似的值相邻。最近的一对总是排序后的相邻元素。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> a(n); for (int& x : a) cin >> x;
sort(a.begin(), a.end());
int best = INT_MAX;
for (int i = 1; i < n; i++)
best = min(best, a[i] - a[i-1]);
cout << best << "\n";
}
为什么是相邻的? 若 |a[i] - a[j]| 最小且 j > i+1,则 a[i+1] 在它们之间,所以 a[i+1]-a[i] ≤ a[j]-a[i],矛盾。
复杂度: O(N log N)。
题目 3.3.2 — 房间分配 🟡 中等
N 个事件,各有开始/结束时间,求任意时刻最多有多少个事件重叠。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ 开始 < 结束 ≤ 10⁹。
提示
创建事件:开始时 +1,结束时 -1,按时间排序,扫描追踪最大计数。核心思路: 扫描线。每个开始 +1,每个结束 -1,运行和 = 当前重叠数。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<pair<int,int>> evs;
for (int i = 0; i < n; i++) {
int s, e; cin >> s >> e;
evs.push_back({s, +1});
evs.push_back({e, -1});
}
// 相同时间时先处理结束(delta=-1),「相切」的区间不计为重叠
sort(evs.begin(), evs.end(),
[](auto& a, auto& b){ return a.first != b.first ? a.first < b.first : a.second < b.second; });
int cur = 0, best = 0;
for (auto& [t, d] : evs) { cur += d; best = max(best, cur); }
cout << best << "\n";
}
对区间 [(1,4), (2,6), (3,5)] 的追踪:
事件:(1,+1), (2,+1), (3,+1), (4,-1), (5,-1), (6,-1)
扫描: 1 2 3 2 1 0
最大:3(时刻 3 时三个区间同时活跃)
复杂度: O(N log N)。
题目 3.3.3 — 第 K 小 🟡 中等
找数组中第 K 小的元素。
数据规模: 1 ≤ K ≤ N ≤ 10⁷,-10⁹ ≤ a[i] ≤ 10⁹。
提示
简单方案:排序后直接返回。进阶练习:尝试 nth_element(平均 O(N))或二分答案。#include <bits/stdc++.h>
using namespace std;
int main() {
int n, k; cin >> n >> k;
vector<int> a(n); for (int& x : a) cin >> x;
// nth_element 重新排列,使 a[k-1] 到达正确的有序位置
nth_element(a.begin(), a.begin() + (k-1), a.end());
cout << a[k-1] << "\n";
}
替代方案:二分答案
int lo = *min_element(a.begin(), a.end());
int hi = *max_element(a.begin(), a.end());
while (lo < hi) {
int mid = lo + (hi - lo) / 2;
int cnt = count_if(a.begin(), a.end(), [&](int x){ return x <= mid; });
if (cnt >= k) hi = mid;
else lo = mid + 1;
}
cout << lo << "\n";
复杂度: nth_element 平均 O(N),最坏 O(N²);二分答案 O(N log(最大值))。
题目 3.3.4 — 攻击性奶牛 🔴 困难
N 个马厩位于位置 p[1..N],放 C 头奶牛以最大化最小间距。
数据规模: 2 ≤ C ≤ N ≤ 10⁵,0 ≤ p[i] ≤ 10⁹。
提示
对最小距离 D 二分答案,O(N) 贪心检查可行性。核心思路: 对答案 D 二分。可行性:贪心地从最左侧马厩开始放奶牛,每次跳到距离 ≥ D 的下一个。
#include <bits/stdc++.h>
using namespace std;
int N, C;
vector<int> p;
bool canPlace(int D) {
int placed = 1, last = p[0];
for (int i = 1; i < N; i++) {
if (p[i] - last >= D) { placed++; last = p[i]; }
if (placed >= C) return true;
}
return false;
}
int main() {
cin >> N >> C;
p.resize(N); for (int& x : p) cin >> x;
sort(p.begin(), p.end());
int lo = 1, hi = p.back() - p.front(), ans = 0;
while (lo <= hi) {
int mid = lo + (hi - lo) / 2;
if (canPlace(mid)) { ans = mid; lo = mid + 1; }
else hi = mid - 1;
}
cout << ans << "\n";
}
复杂度: O(N log N + N log(最大距离))。
题目 3.3.5 — 画家分区 🔴 困难
N 块画板各有宽度,K 名画家,每人画连续的画板,单位时间画一单位宽度。最小化总绘画时间。
数据规模: 1 ≤ K ≤ N ≤ 10⁵,1 ≤ 画板宽度 ≤ 10⁸(总宽度需 long long)。
提示
对最大时间 T 二分答案,贪心分配画板检查可行性。核心思路: 对答案 T 二分。可行性:贪心为每个画家填充画板,超过 T 时换下一个画家,若 ≤ K 个画家就够,T 可行。
#include <bits/stdc++.h>
using namespace std;
int N, K;
vector<long long> W;
bool canFinish(long long T) {
int painters = 1;
long long cur = 0;
for (long long w : W) {
if (w > T) return false; // 单块画板超出预算
if (cur + w > T) { painters++; cur = w; }
else cur += w;
}
return painters <= K;
}
int main() {
cin >> N >> K;
W.resize(N); for (long long& x : W) cin >> x;
long long lo = *max_element(W.begin(), W.end()); // 下界:最宽的画板
long long hi = accumulate(W.begin(), W.end(), 0LL); // 上界:总宽度
while (lo < hi) {
long long mid = lo + (hi - lo) / 2;
if (canFinish(mid)) hi = mid;
else lo = mid + 1;
}
cout << lo << "\n";
}
复杂度: O(N log(总宽度))。
⚠️ 排序与搜索常见错误
展开——频繁出现的陷阱
排序陷阱:
- ❌ 比较器用
>代替<(排序需要严格弱序) - ❌ 比较器返回
a <= b——违反严格弱序,可能导致未定义行为 - ❌ 比较器有副作用或随机性——必须是确定性的
二分查找陷阱:
- ❌
mid = (lo + hi) / 2——lo+hi 很大时溢出,用lo + (hi - lo) / 2 - ❌ 死循环:未找到目标时
lo = mid(而不是mid+1) - ❌ 「第一个/最后一个位置」变体中的边界错误——先画出不变量
- ❌ 浮点数二分:用精度终止条件
while (hi - lo > 1e-9)
二分答案陷阱:
- ❌ 检查函数不单调——二分查找无效!验证:若 D 可行,D-1 也可行吗?
- ❌ 边界太紧(遗漏边界情况):将
lo设为最小可能答案,hi设为明确可行的上界
🏆 挑战题:USACO 2016 February Silver:围牛栏 用最少的围栏围住所有 N 个点形成凸区域。这是凸包问题——查阅 Graham 扫描或 Jarvis 步进算法。虽然是 Gold 级别的主题,现在思考它能帮助你建立直觉。
第 3.4 章:双指针与滑动窗口
双指针和滑动窗口是竞赛编程中最优雅的技巧之一。它们通过利用单调性将朴素 O(N²) 解法转化为 O(N):当一个指针向前移动时,另一个指针无需回头。
3.4.1 双指针技术
题目: 给定 N 个整数组成的数组 arr 和目标值 target,找出所有和恰好等于 target 的数对。
数据规模: 1 ≤ N ≤ 10⁵,-10⁹ ≤ arr[i] ≤ 10⁹,-2×10⁹ ≤ target ≤ 2×10⁹。
arr = [2, 3, 5, 8, 9, 10, 12], target = 14
答案:(2,12), (5,9)
朴素做法:双重循环枚举每一对,O(N²) ≈ 10¹⁰ 次操作——超时。能不能利用「数组有序」这个性质,让某些枚举直接被排除?
关键观察: 设左右指针 left 指向最小值、right 指向最大值。
- 若
arr[left] + arr[right] > target:arr[right]与谁都太大——right 左移,一次性排除一整列候选。 - 若
< target:arr[left]与谁都太小——left 右移。
每步排除一行或一列,总共至多 N 步:O(N)。这就是双指针的核心思想——在有序数组中维护两个下标 left 和 right,根据当前和/窗口大小将它们相向(或同向)移动。
使用场景:
- 在有序数组中找满足给定和的对/三元组
- 检查有序数组中是否存在满足特定关系的两个元素
- 「若能用大小 k 的窗口完成 X,则用大小 k-1 的窗口也能完成」的问题

上图展示两个指针如何向中间收拢,每步都从待考虑的对中消除整行/整列。
滑动窗口变体让两个指针同向移动。满足条件时,从左侧收缩以找到最小窗口:

朴素 O(N²) 做法:
// O(N²):检查每一对
for (int i = 0; i < n; i++) {
for (int j = i + 1; j < n; j++) {
if (arr[i] + arr[j] == target) {
cout << arr[i] << " + " << arr[j] << "\n";
}
}
}
双指针 O(N) 做法(需要排序):
// 双指针 — 排序 O(N log N) + 搜索 O(N)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, target;
cin >> n >> target;
vector<int> arr(n);
for (int &x : arr) cin >> x;
sort(arr.begin(), arr.end()); // 必须先排序
int left = 0, right = n - 1;
while (left < right) {
int sum = arr[left] + arr[right];
if (sum == target) {
cout << arr[left] << " + " << arr[right] << " = " << target << "\n";
left++;
right--; // 同时移动两个指针
} else if (sum < target) {
left++; // 和太小:左指针右移(增大和)
} else {
right--; // 和太大:右指针左移(减小和)
}
}
return 0;
}
为什么这样有效?
核心思路: 排序后,若 arr[left] + arr[right] < target,则没有比 arr[right] 更小的元素能与 arr[left] 配对达到 target。所以安全地右移 left。
类似地,若和太大,没有比 arr[left] 更大的元素能与 arr[right] 配对达到 target。所以安全地左移 right。
每步至少消除一个元素 → 总计 O(N) 步。
完整追踪
数组 = [1, 2, 3, 4, 5, 6, 7, 8],target = 9:
状态:left=0(1), right=7(8)
和 = 1+8 = 9 ✓ → 打印 (1,8),left++,right--
状态:left=1(2), right=6(7)
和 = 2+7 = 9 ✓ → 打印 (2,7),left++,right--
状态:left=2(3), right=5(6)
和 = 3+6 = 9 ✓ → 打印 (3,6),left++,right--
状态:left=3(4), right=4(5)
和 = 4+5 = 9 ✓ → 打印 (4,5),left++,right--
状态:left=4, right=3 → left >= right,停止
所有对:(1,8),(2,7),(3,6),(4,5)
三数之和扩展
找和为目标值的三元组:固定一个元素,对剩余两个用双指针。
// O(N²) — 远优于 O(N³) 暴力
sort(arr.begin(), arr.end());
for (int i = 0; i < n - 2; i++) {
int left = i + 1, right = n - 1;
while (left < right) {
int sum = arr[i] + arr[left] + arr[right];
if (sum == target) {
cout << arr[i] << " " << arr[left] << " " << arr[right] << "\n";
left++; right--;
} else if (sum < target) left++;
else right--;
}
}
3.4.2 滑动窗口——固定大小
固定大小 K 的滑动窗口在数组上滑动,维护一个运行聚合值(和、最大值、不同值计数等)。
题目: 给定 N 个整数组成的数组 arr 和窗口大小 K,找任意大小为 K 的连续子数组的最大和。
数据规模: 1 ≤ K ≤ N ≤ 10⁵,-10⁹ ≤ arr[i] ≤ 10⁹(窗口和需 long long)。
数组:[2, 1, 5, 1, 3, 2],K=3
窗口:[2,1,5]=8,[1,5,1]=7,[5,1,3]=9,[1,3,2]=6
答案:9
朴素 O(NK): 对每个窗口从头重新计算和。
滑动窗口 O(N): 加上进入窗口的新元素,减去离开窗口的旧元素。
// 固定大小滑动窗口 — O(N)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, k;
cin >> n >> k;
vector<int> arr(n);
for (int &x : arr) cin >> x;
// 计算第一个窗口的和
long long windowSum = 0;
for (int i = 0; i < k; i++) windowSum += arr[i];
long long maxSum = windowSum;
// 滑动窗口:加 arr[i],减 arr[i-k]
for (int i = k; i < n; i++) {
windowSum += arr[i]; // 新元素进入窗口
windowSum -= arr[i - k]; // 旧元素离开窗口
maxSum = max(maxSum, windowSum);
}
cout << maxSum << "\n";
return 0;
}
下面的追踪图展示了窗口在 [2, 1, 5, 1, 3, 2](K=3)上逐步右移的过程,每步的窗口和与最大值标注在旁边:
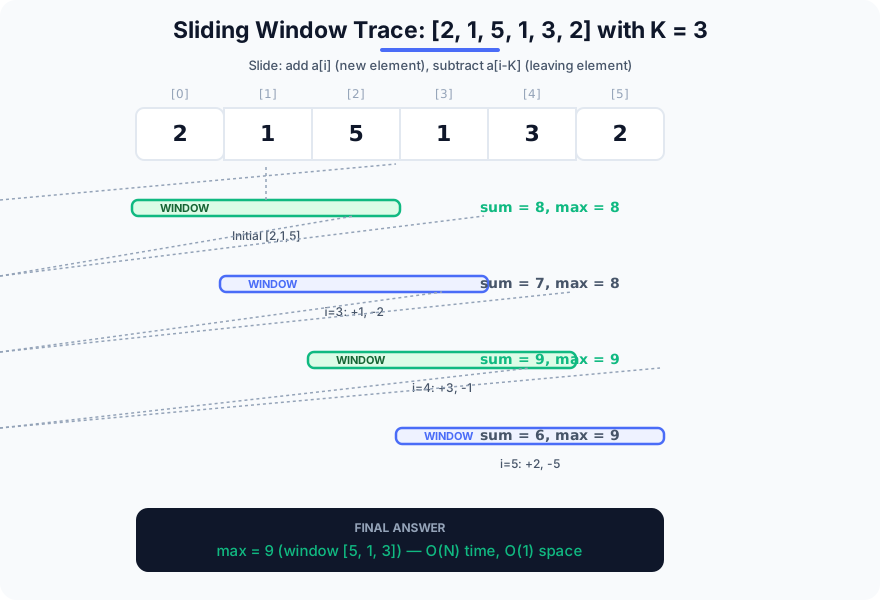
3.4.3 滑动窗口——可变大小
最强大的变体:窗口在需要时扩大,违反约束时收缩。
题目:最短子数组和
给定 N 个整数组成的数组 a[0..N-1] 和一个目标值 target。找一个连续子数组 a[l..r],使其元素之和 ≥ target,且长度 r - l + 1 尽可能短。输出这个最短长度;若不存在任何子数组的和达到 target,输出 0。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ a[i] ≤ 10⁴(所有元素为正整数),1 ≤ target ≤ 10⁹。
样例:
输入:N=7, target=7
a = [2, 3, 1, 2, 4, 3, 8]
输出:1(子数组 [8] 的和为 8 ≥ 7)
若把样例改为 target = 15,则答案为 3:和 ≥ 15 的子数组中最短的是 [4, 3, 8](长度 3,和 15)。
为什么数据范围重要: N ≤ 10⁵ 排除了 O(N²) 枚举所有子数组(10¹⁰ 次操作);所有 a[i] ≥ 1(正数)保证了「窗口和随右端扩大而严格增加、随左端收缩而减少」的单调性——这是滑动窗口正确性的前提(若有负数,收缩窗口反而可能让和变大,窗口法失效,需改用前缀和+单调队列)。
// 可变大小窗口 — O(N)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, target;
cin >> n >> target;
vector<int> arr(n);
for (int &x : arr) cin >> x;
int left = 0;
long long windowSum = 0;
int minLen = INT_MAX;
for (int right = 0; right < n; right++) {
windowSum += arr[right]; // 扩张:加入右端元素
// 满足约束时从左收缩
while (windowSum >= target) {
minLen = min(minLen, right - left + 1);
windowSum -= arr[left];
left++; // 收缩:移除左端元素
}
}
if (minLen == INT_MAX) cout << 0 << "\n"; // 不存在这样的子数组
else cout << minLen << "\n";
return 0;
}
为什么是 O(N)? 每个元素被加入一次(right 经过时),最多被移除一次(left 经过时)。总操作:O(2N) = O(N)。
题目:最多 K 个不同值的最长子数组
题目: 给定 N 个整数组成的数组 arr 和整数 K,找最长的连续子数组,使其中至多包含 K 个不同的值。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ K ≤ N,0 ≤ arr[i] ≤ 10⁹。
// 可变窗口:最多 K 个不同值的最长子数组
int left = 0, maxLen = 0;
map<int, int> freq; // 窗口内每个值的频率
for (int right = 0; right < n; right++) {
freq[arr[right]]++;
// 有 > k 个不同值时收缩
while ((int)freq.size() > k) {
freq[arr[left]]--;
if (freq[arr[left]] == 0) freq.erase(arr[left]);
left++;
}
maxLen = max(maxLen, right - left + 1);
}
cout << maxLen << "\n";
3.4.4 快慢指针
前两种模式中两个指针相向或同速同向移动。快慢指针是第三种模式:两个指针同向但不同速——slow 每次走一步,fast 每次走两步。
核心用途:
- 链表中点:
fast到达终点时,slow恰好在中间 - 环检测:有环时
fast会「套圈」追上slow - 删除倒数第 K 个节点:让
fast先走 K 步制造固定距离
这些场景的共同点:无法用下标随机访问(链表),或需要在一次遍历内完成(不允许两遍扫描)。
经典题 1:找链表中点
题目: 给定单链表,返回中间节点。若有两个中间节点,返回第二个。
数据规模: 1 ≤ 链表长度 N ≤ 10⁵,1 ≤ 节点值 ≤ 10⁵。
1 → 2 → 3 → 4 → 5
↑ slow 停在这里(第 3 个节点)
1 → 2 → 3 → 4
↑ 偶数长度时 slow 停在第 3 个节点(第二个中间节点)
struct ListNode {
int val;
ListNode *next;
ListNode(int x) : val(x), next(nullptr) {}
};
ListNode* middleNode(ListNode* head) {
ListNode *slow = head, *fast = head;
while (fast != nullptr && fast->next != nullptr) {
slow = slow->next; // 慢指针走 1 步
fast = fast->next->next; // 快指针走 2 步
}
return slow;
}
为什么有效? fast 每步比 slow 多走一步。当 fast 走完 N 步到达终点时,slow 恰好走了 N/2 步,即中间位置。
- 奇数长度(5):
fast走 1→3→5→null 停止,slow走 1→2→3 ✓ - 偶数长度(4):
fast走 1→3→null 停止,slow走 1→2→3 ✓(第二个中间节点)
经典题 2:环检测(Floyd 判圈法)
题目: 判断链表是否有环。这是快慢指针最著名的应用。
数据规模: 0 ≤ 链表节点数 N ≤ 10⁵,-10⁵ ≤ 节点值 ≤ 10⁵。
直觉: 想象两个人在环形跑道上跑步,快的人一定会「套圈」追上慢的人。若没有环,快的人会先到达终点。
bool hasCycle(ListNode* head) {
ListNode *slow = head, *fast = head;
while (fast != nullptr && fast->next != nullptr) {
slow = slow->next;
fast = fast->next->next;
if (slow == fast) return true; // 相遇 → 有环
}
return false; // fast 到达 null → 无环
}
进阶:找环的入口。 相遇后,把一个指针放回头部,两个指针改为每次都走一步,再次相遇的节点就是环入口。
ListNode* detectCycle(ListNode* head) {
ListNode *slow = head, *fast = head;
while (fast != nullptr && fast->next != nullptr) {
slow = slow->next;
fast = fast->next->next;
if (slow == fast) { // 第一阶段:相遇
slow = head; // 慢指针回到头部
while (slow != fast) { // 第二阶段:都走 1 步
slow = slow->next;
fast = fast->next;
}
return slow; // 环入口
}
}
return nullptr;
}
数学证明(简要): 设头到环入口距离为 a,相遇点距环入口为 b,环长 c。相遇时 fast 走的路程是 slow 的两倍:
slow 走了 a + b
fast 走了 a + b + k·c(多绕了 k 圈)
2(a + b) = a + b + k·c → a = k·c - b
即从头走 a 步 = 从相遇点走 k·c - b 步(绕回环入口)。所以两指针同速前进必在环入口相遇。
经典题 3:删除链表倒数第 K 个节点
题目: 一次遍历删除链表的倒数第 K 个节点。
数据规模: 1 ≤ 链表长度 N ≤ 10⁵,1 ≤ K ≤ N,1 ≤ 节点值 ≤ 10⁵。
思路: 让 fast 先走 K 步,之后 slow 和 fast 同速前进。fast 到达末尾时,slow 恰好在倒数第 K 个节点。
ListNode* removeNthFromEnd(ListNode* head, int k) {
ListNode dummy(0);
dummy.next = head;
ListNode *fast = &dummy, *slow = &dummy;
for (int i = 0; i < k; i++) fast = fast->next; // 先拉开 K 步
while (fast->next != nullptr) { // 同速前进
fast = fast->next;
slow = slow->next;
}
// slow 现在指向倒数第 K+1 个节点
slow->next = slow->next->next; // 删除倒数第 K 个
return dummy.next;
}
哑节点(dummy) 的作用:处理删除头节点的边界情况(如链表长度恰好为 K)。
快慢指针 vs 其他双指针
| 模式 | 指针方向 | 速度 | 典型题目 |
|---|---|---|---|
| 相向指针 | 两端 → 中间 | 各 1 步 | 有序数组两数之和 |
| 同向指针(滑动窗口) | 同向 | 各 1 步,但可暂停 | 最长子数组/子串 |
| 快慢指针 | 同向 | 1 步 vs 2 步 | 链表中点、环检测 |
竞赛提示: 快慢指针也常用于数组——如「原地移除元素」(LeetCode 26/27):slow 指向已处理区间的末尾,fast 扫描找合法元素写入 slow 位置。USACO 链表题不常见,但 Floyd 判圈法的思想(快慢追赶检测循环)也出现在「函数迭代求周期」类问题中:定义 f(x) 反复迭代,用 x_{i+1} = f(x_{i+1}) 的两倍速迭代即可在 O(周期) 空间 O(1) 内找到循环节,无需哈希表。
3.4.5 USACO 示例:最长满足条件的子数组
题目: 给定整数数组 arr 和阈值 K,找所有元素 ≥ K 的最长连续子数组。
数据规模: 1 ≤ N ≤ 10⁶,-10⁹ ≤ arr[i], K ≤ 10⁹。
// 双指针:所有元素 >= K 的最长连续子数组
int left = 0, maxLen = 0;
for (int right = 0; right < n; right++) {
if (arr[right] < K) {
left = right + 1; // 重置窗口:当前元素违反约束
} else {
maxLen = max(maxLen, right - left + 1);
}
}
3.4.6 USACO 真题训练:窗口、匹配与单调移动
双指针的本质是「指针不回头」。在 USACO 中常见两类题:
| 模式 | 题面信号 | 指针含义 |
|---|---|---|
| 排序后滑动窗口 | 最大集合,任意两者差距不超过 K | 窗口左右端点 |
| 区间匹配 | 每个资源只能用一次,最大匹配数量 | 当前资源 + 可匹配候选集合 |
真题 1:Diamond Collector(USACO 2016 US Open Silver)— 排序后维护合法窗口
题目链接: USACO 2016 US Open Silver P2: Diamond Collector
对应模式: 排序 + 滑动窗口 + 前后缀最优
难度定位: Silver 中等
题干解读
有 N 颗钻石,每颗有一个大小。一个展示柜中任意两颗钻石大小差不能超过 K。你有两个展示柜,求最多能展示多少颗钻石。
数据规模(与原题一致): 1 ≤ N ≤ 50,000,0 ≤ K ≤ 10⁹,0 ≤ 钻石大小 ≤ 10,000。
关键条件:
- 每个柜子对应排序数组中的一个连续窗口。
- 两个柜子不能共用钻石。
- 需要选两个不重叠窗口,使总长度最大。
思路分析
排序后,对每个左端点 left,用右指针扩张到最大 right,满足:
size[right] - size[left] <= K
得到从 left 开始的最大合法窗口长度。然后用后缀最大值 bestFrom[i] 表示从位置 i 之后能选到的最大窗口。枚举第一个柜子的左端点,第二个柜子从第一个窗口右端之后开始。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("diamond.in", "r", stdin);
// freopen("diamond.out", "w", stdout);
int n, k;
cin >> n >> k;
vector<int> diamond(n);
for (int &x : diamond) cin >> x;
sort(diamond.begin(), diamond.end());
vector<int> length(n), endAt(n);
int right = 0;
for (int left = 0; left < n; left++) {
while (right < n && diamond[right] - diamond[left] <= k) {
right++;
}
length[left] = right - left;
endAt[left] = right; // 第二个柜子必须从 right 或之后开始
}
vector<int> bestFrom(n + 1, 0);
for (int i = n - 1; i >= 0; i--) {
bestFrom[i] = max(bestFrom[i + 1], length[i]);
}
int answer = 0;
for (int first = 0; first < n; first++) {
answer = max(answer, length[first] + bestFrom[endAt[first]]);
}
cout << answer << "\n";
return 0;
}
复杂度: 排序 O(N log N),滑动窗口和后缀数组 O(N),空间 O(N)。
易错点提醒
- 右指针回退。 滑动窗口的关键是
right只增不减,否则退化成O(N²)。 - 两个柜子重叠。 第二个柜子必须从第一个窗口结束位置
endAt[first]之后选。 - 只找一个最大窗口。 题目有两个展示柜,需要组合两个不重叠窗口。
- 没有排序。 合法窗口只在排序后才是连续区间。
拓展思考
如果展示柜数量从 2 变成 M,就变成「选 M 个不重叠窗口最大化总长度」的 DP:dp[i][j] 表示从第 i 个位置开始,用 j 个柜子的最大展示数量。
真题 2:Why Did the Cow Cross the Road(USACO 2017 February Silver)— 区间匹配的贪心
题目链接: USACO 2017 February Silver P1: Why Did the Cow Cross the Road
对应模式: 排序 + 贪心匹配 + 最小堆
难度定位: Silver 中等
题干解读
有若干只鸡,每只鸡在一个具体时间 T 可以帮忙;有若干头牛,每头牛只能在时间区间 [A,B] 内过马路。一只鸡最多帮一头牛,一头牛也最多被一只鸡帮助,求最大匹配数量。
数据规模(与原题一致): 1 ≤ C ≤ 20,000(鸡的数量),1 ≤ N ≤ 20,000(牛的数量),1 ≤ T, A, B ≤ 10⁹,保证 A ≤ B。
关键条件:
- 鸡是时间点,牛是时间区间。
- 时间从小到大处理时,已经开始但还没过期的牛都可能匹配当前鸡。
- 为了给未来留下更多选择,当前鸡应该匹配结束时间最早的可用牛。
思路分析
按时间扫描鸡:
- 将鸡时间排序。
- 将牛按开始时间
A排序。 - 对每只鸡,把所有
A <= T的牛加入最小堆,堆键是结束时间B。 - 弹出所有
B < T的过期牛。 - 若堆非空,匹配
B最小的牛。
这个贪心安全:结束越早的牛越紧急,当前不匹配它,未来更可能错过。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("helpcross.in", "r", stdin);
// freopen("helpcross.out", "w", stdout);
int c, n;
cin >> c >> n;
vector<int> chicken(c);
for (int &t : chicken) cin >> t;
vector<pair<int, int>> cows(n); // {开始时间, 结束时间}
for (auto &[a, b] : cows) cin >> a >> b;
sort(chicken.begin(), chicken.end());
sort(cows.begin(), cows.end());
priority_queue<int, vector<int>, greater<int>> availableEnd;
int cowIndex = 0;
int matched = 0;
for (int t : chicken) {
while (cowIndex < n && cows[cowIndex].first <= t) {
availableEnd.push(cows[cowIndex].second);
cowIndex++;
}
while (!availableEnd.empty() && availableEnd.top() < t) {
availableEnd.pop(); // 已经过期,不能再匹配
}
if (!availableEnd.empty()) {
availableEnd.pop(); // 当前鸡匹配结束最早的牛
matched++;
}
}
cout << matched << "\n";
return 0;
}
复杂度: 排序 O((C+N) log(C+N)),每头牛最多进出堆一次,总复杂度 O((C+N) log N)。
易错点提醒
- 按结束时间排序后直接双指针。 鸡时间点和牛区间交错,仅靠两个指针不够,需要堆维护当前可选牛。
- 忘记删除过期牛。
B < T的牛无法被当前或未来鸡匹配,必须弹出。 - 匹配结束最晚的牛。 应匹配结束最早者,把更宽松的牛留给未来。
- 边界条件写错。 若
A <= T <= B,则B == T仍然可匹配,不应弹出。
拓展思考
这类题属于「按时间扫描 + 最紧急优先」模型。若每只鸡有多个时间段、每头牛也需要多个资源,问题可能升级为区间调度或二分图匹配。
⚠️ 常见错误
- 双指针前忘排序: 配对求和的双指针技术只在有序数组上有效。不排序会遗漏一些对或得到错误答案。
- 找到对时只移动一个指针: 找到匹配的对时,必须同时移动
left++和right--。只移动一个会遗漏一些对(除非不需要考虑重复)。 - 窗口大小差一: 窗口
[left, right]的大小是right - left + 1,不是right - left。 - 忘记处理空答案: 对「最小子数组」问题,将
minLen初始化为INT_MAX,输出前检查它是否改变了。
本章总结
📌 核心要点
| 技术 | 前提条件 | 时间 | 空间 | 核心思想 |
|---|---|---|---|---|
| 双指针(配对) | 有序数组 | O(N) | O(1) | 从两端逼近,消除不可能的对 |
| 双指针(三数之和) | 有序数组 | O(N²) | O(1) | 固定一个,对其余用双指针 |
| 滑动窗口(固定) | 任意 | O(N) | O(1) | 加新元素,减旧元素 |
| 滑动窗口(可变) | 任意 | O(N) | O(1~N) | 右端扩张,左端收缩 |
| 快慢指针 | 链表/序列 | O(N) | O(1) | 1 步 vs 2 步,利用速度差定位 |
❓ 常见问题
Q1:双指针一定需要排序吗?
A:不一定。「反向双指针」(如配对求和)需要排序;「同向双指针」(如滑动窗口)不需要。关键是单调性——指针只朝一个方向移动。
Q2:滑动窗口和前缀和都能计算区间和——该用哪个?
A:固定大小窗口的和/最大值,滑动窗口更直观。任意区间查询,前缀和更通用。滑动窗口只能处理「连续移动的窗口」;前缀和可以回答任意 [L,R] 查询。
Q3:滑动窗口能同时处理「满足条件的最长子数组」和「满足条件的最短子数组」吗?
A:两者都可以,但逻辑略有不同。「最长」:右端扩张直到条件不满足,再从左收缩直到条件重新满足。「最短」:右端扩张直到条件满足,再从左收缩直到条件不再满足,全程记录最小长度。
Q4:双指针如何处理重复元素?
A:取决于题目。若需要「所有不同对的值」,找到对后做
left++; right--并跳过重复值。若需要「所有对的数量」,需要仔细统计重复项(可能需要额外的计数逻辑)。
🔗 与后续章节的联系
- 第 3.2 章(前缀和):前缀和与滑动窗口互补——前缀和适合离线查询,滑动窗口适合在线处理
- 第 3.3 章(排序):排序是双指针的前提——反向双指针需要有序数组
- 第 3.6 章(单调性):单调双端队列可以增强滑动窗口——在
O(N)时间内维护窗口最小/最大值 - 第 6.1–6.3 章(DP):一些问题(如 LIS 变体)可以用双指针优化
练习题
题目 3.4.1 — 配对计数 🟢 简单
给定 N 个整数和目标值 T,统计满足 arr[i] + arr[j] = T 的对 (i < j) 的数量。
数据规模: 1 ≤ N ≤ 10⁵,-10⁹ ≤ arr[i] ≤ 10⁹,-2×10⁹ ≤ T ≤ 2×10⁹(答案可达 ~N²/2,需 long long)。
提示
先排序数组,从两端用双指针。#include <bits/stdc++.h>
using namespace std;
int main() {
int n, T; cin >> n >> T;
vector<int> a(n); for (int& x : a) cin >> x;
sort(a.begin(), a.end());
long long cnt = 0;
int L = 0, R = n - 1;
while (L < R) {
int s = a[L] + a[R];
if (s == T) {
if (a[L] == a[R]) {
// [L..R] 内所有对都有效
long long len = R - L + 1;
cnt += len * (len - 1) / 2;
break;
}
// 统计两侧的重复值
long long cl = 1, cr = 1;
while (L+1 < R && a[L+1] == a[L]) { cl++; L++; }
while (R-1 > L && a[R-1] == a[R]) { cr++; R--; }
cnt += cl * cr;
L++; R--;
} else if (s < T) L++;
else R--;
}
cout << cnt << "\n";
}
复杂度: O(N log N)。
题目 3.4.2 — 最大平均子数组 🟡 中等
找恰好长度为 K 的连续子数组,使其平均值最大。
数据规模: 1 ≤ K ≤ N ≤ 10⁵,-10⁴ ≤ a[i] ≤ 10⁴。
提示
固定大小滑动窗口:维护运行和,每步加 A[i] 减 A[i-K]。#include <bits/stdc++.h>
using namespace std;
int main() {
int n, k; cin >> n >> k;
vector<double> a(n); for (double& x : a) cin >> x;
double windowSum = 0;
for (int i = 0; i < k; i++) windowSum += a[i];
double maxSum = windowSum;
for (int i = k; i < n; i++) {
windowSum += a[i] - a[i-k];
maxSum = max(maxSum, windowSum);
}
cout << fixed << setprecision(5) << maxSum / k << "\n";
}
复杂度: O(N)。
题目 3.4.4 — 环形链表 🟢 简单
给定一个可能带环的单链表头节点,若有环返回环的入口节点,否则返回 nullptr。要求空间 O(1)。
数据规模: 1 ≤ 链表长度 ≤ 10⁴,节点值范围不限。
提示
Floyd 判圈法:快慢指针找相遇点,然后一个指针回到头部同速前进。ListNode* detectCycle(ListNode* head) {
ListNode *slow = head, *fast = head;
while (fast && fast->next) {
slow = slow->next;
fast = fast->next->next;
if (slow == fast) {
slow = head;
while (slow != fast) { slow = slow->next; fast = fast->next; }
return slow;
}
}
return nullptr;
}
复杂度: O(N) 时间,O(1) 空间。
题目 3.4.3 — 最小覆盖子串 🔴 困难
给定字符串 S 和字符串 T,找 S 中包含 T 所有字符的最短子串。
数据规模: 1 ≤ |S| ≤ 10⁶,1 ≤ |T| ≤ |S|,字符串由大小写英文字母组成。
提示
可变滑动窗口,用频率映射记录所需字符,满足所有 T 中字符时从左收缩。#include <bits/stdc++.h>
using namespace std;
int main() {
string S, T; cin >> S >> T;
unordered_map<char,int> need, have;
for (char c : T) need[c]++;
int formed = 0, required = need.size();
int L = 0, minLen = INT_MAX, minL = 0;
for (int R = 0; R < (int)S.size(); R++) {
have[S[R]]++;
if (need.count(S[R]) && have[S[R]] == need[S[R]]) formed++;
while (formed == required) {
if (R - L + 1 < minLen) { minLen = R-L+1; minL = L; }
have[S[L]]--;
if (need.count(S[L]) && have[S[L]] < need[S[L]]) formed--;
L++;
}
}
if (minLen == INT_MAX) cout << "no solution\n";
else cout << S.substr(minL, minLen) << "\n";
}
样例: S="ADOBECODEBANC",T="ABC" → "BANC" 复杂度: O(|S| + |T|)。
🏆 挑战题:USACO 2017 February Bronze——为何奶牛过马路 给定网格中的奶牛和它们的目的地,找哪头奶牛最快到达目的地。对排序好的区间用双指针/贪心方法。
第 3.5 章:栈、队列与双端队列
3.5.0 从一道题出发:括号串是否合法
先看一道经典题(LeetCode 20 / USACO Bronze 风格):
🧩 题目:合法括号串 给定一个由
(、)、[、]、{、}组成的字符串s(|s| ≤ 10⁶),判断它是否正确嵌套——每个闭括号都与最近的未匹配开括号类型一致。
"()[]{}" → 合法
"([)]" → 不合法(')' 的最近开括号是 '[')
"{[]}" → 合法
先试试你会的方法
思路 1:计数? 「左括号数 = 右括号数」远远不够——")(" 计数平衡却不合法,而且必须检查类型匹配。
思路 2:数组记录每个开括号的位置? 可以,但遇到闭括号时,你需要知道最近那个还没配对的开括号是谁——数组从头找是 O(N²),而且 ([)] 这种交错必须靠「最近的先配对」来排除。
关键观察: 括号匹配天然满足「后开的先关」——最新未匹配的开括号必须最先被闭合。这正是 后进先出(LIFO) 的顺序:开括号压入,闭括号弹出并检查。装这种顺序的容器就是栈。
改变「处理的顺序」,就得到不同容器、不同问题:
- 栈(Stack): 后进先出(像一叠盘子)——括号匹配、DFS、撤销
- 队列(Queue): 先进先出(像商店排队)——BFS、按到达顺序处理
- 双端队列(Deque): 两端均可插入/删除——滑动窗口最大值
这三种数据结构控制的正是元素被处理的顺序——本章的主角。
3.5.1 栈深度解析
我们在第 3.1 章介绍过 stack,现在用它解决实际问题。
图示:栈的操作

上图通过逐步压入和弹出操作展示了 LIFO(后进先出)性质。注意 pop() 总是移除最近压入的元素——这正是栈在括号匹配、DFS 和撤销操作中无可替代的原因。
以下是三种容器的对比——访问模式决定了各自适合不同的问题:

括号匹配问题
题目: 给定括号字符串 ()[]{}, 判断是否正确嵌套。
数据规模: 1 ≤ 字符串长度 ≤ 10⁵。
#include <bits/stdc++.h>
using namespace std;
bool isBalanced(const string &s) {
stack<char> st;
for (char ch : s) {
if (ch == '(' || ch == '[' || ch == '{') {
st.push(ch); // 开括号:压栈
} else {
// 闭括号:必须与最近的开括号匹配
if (st.empty()) return false; // 没有对应的开括号
char top = st.top();
st.pop();
// 检查是否匹配
if (ch == ')' && top != '(') return false;
if (ch == ']' && top != '[') return false;
if (ch == '}' && top != '{') return false;
}
}
return st.empty(); // 栈为空说明所有括号都匹配了
}
int main() {
cout << isBalanced("()[]{}") << "\n"; // 1(真)
cout << isBalanced("([]){}") << "\n"; // 1(真)
cout << isBalanced("([)]") << "\n"; // 0(假)
cout << isBalanced("(()") << "\n"; // 0(假——未匹配的 '(')
return 0;
}
💡 进阶预告: 栈还有一种强大的变体——单调栈,能在 O(N) 内解决「下一个/上一个更大更小元素」这类问题;双端队列配合单调性可以 O(N) 求滑动窗口最值。这些内容统一放在第 3.6 章:单调栈与单调队列深入讲解,本章先掌握三种容器本身。
3.5.2 队列与 BFS 准备
队列的 FIFO 性质使它非常适合广度优先搜索(BFS),我们在第 5.2 章详细讲解。这里先聚焦队列本身及相关模式。
图示:队列操作

队列按到达顺序处理元素:队首元素始终最先出队,新元素从队尾加入。FIFO 性质保证 BFS 按层级访问节点,从而保证最短路径距离的正确性。
用队列模拟
题目: 游乐场过山车共有 N 组游客,每组人数为 size[i],每次运行最多容纳 M 人。模拟需要多少次运行才能送完所有人。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 10⁹,1 ≤ size[i] ≤ M(保证每组都能坐下)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
queue<int> groups;
for (int i = 0; i < n; i++) {
int x;
cin >> x;
groups.push(x);
}
int runs = 0;
while (!groups.empty()) {
int capacity = m; // 本次运行的剩余容量
runs++;
while (!groups.empty() && groups.front() <= capacity) {
capacity -= groups.front(); // 这组能坐下
groups.pop();
}
}
cout << runs << "\n";
return 0;
}
3.5.3 双端队列——两端都能操作
deque(发音「deck」)支持 O(1) 的两端插入和删除。
#include <bits/stdc++.h>
using namespace std;
int main() {
deque<int> dq;
dq.push_back(1); // [1]
dq.push_back(2); // [1, 2]
dq.push_front(0); // [0, 1, 2]
dq.push_front(-1); // [-1, 0, 1, 2]
cout << dq.front() << "\n"; // -1
cout << dq.back() << "\n"; // 2
dq.pop_front(); // [-1 移除] → [0, 1, 2]
dq.pop_back(); // [2 移除] → [0, 1]
cout << dq.front() << "\n"; // 0
cout << dq.size() << "\n"; // 2
// 随机访问(像向量一样)
cout << dq[0] << "\n"; // 0
cout << dq[1] << "\n"; // 1
return 0;
}
⚠️ 第 3.5 章常见错误
| # | 错误 | 错在哪里 | 修复方法 |
|---|---|---|---|
| 1 | 对空栈/队列调用 top()/front() | 未定义行为,程序崩溃 | 先检查 !st.empty() |
| 2 | 混淆 stack 和 deque | stack 只能访问顶部,不能遍历中间元素 | 需要两端操作时改用 deque |
| 3 | 模拟题中容器选错 | 按到达顺序处理用 queue,最近优先用 stack | 先想清楚元素的处理顺序,再选容器 |
本章总结
📌 核心要点
| 结构 | 操作 | 关键使用场景 | 为什么重要 |
|---|---|---|---|
stack<T> | push/pop/top — O(1) | 括号匹配、撤销/重做、DFS | LIFO 逻辑的核心工具 |
queue<T> | push/pop/front — O(1) | BFS、模拟排队 | FIFO 逻辑的核心工具 |
deque<T> | 两端 push/pop — O(1) | 滑动窗口、BFS 变体 | 支持两端访问的多功能容器 |
单调栈与单调双端队列(下一个更大元素、滑动窗口极值等)见第 3.6 章。
❓ 常见问题
Q1:什么时候用 stack vs deque?
A:只需要 LIFO(单端访问),用
stack;需要两端操作(如滑动窗口需要队首删除 + 队尾添加),用deque。stack内部其实是以deque实现的,只是把接口限制为只暴露顶部。
Q2:BFS 一定要用 queue 吗?能用 vector 吗?
A:技术上可以用
vector+ 下标模拟,但queue更清晰不易出错。竞赛中直接用queue。唯一例外是 0-1 BFS(边权只有 0 和 1 的最短路),需要用deque。
Q3:括号匹配为什么必须用栈,数组不行吗?
A:闭括号必须与最近的未匹配开括号配对——「最近」意味着后进先出。数组从头找是 O(N²),且交错嵌套(
([)])只有靠「最近的先配对」才能正确排除。
🔗 与后续章节的联系
- 第 5.2 章(图 BFS/DFS):
queue是 BFS 的核心容器,stack可用于迭代式 DFS - 第 3.6 章(单调栈与单调队列):把单调性约束加到本章的栈和双端队列上,得到 O(N) 解决「最近更大/更小元素」和「滑动窗口极值」的强大工具——USACO Silver 高频考点
- 第 3.4 章(双指针):滑动窗口技术与本章的双端队列完美结合
- 第 6.1–6.3 章(DP):某些优化技术(如 DP 的滑动窗口极值优化)直接使用单调双端队列
练习题
题目 3.5.1 — 循环队列 🟡 中等 实现大小为 K 的循环队列,处理 PUSH/POP 操作并检测 OVERFLOW/UNDERFLOW。
#include <bits/stdc++.h>
using namespace std;
int main() {
int K, Q; cin >> K >> Q;
deque<int> q;
while (Q--) {
string op; cin >> op;
if (op == "PUSH") {
int x; cin >> x;
if ((int)q.size() == K) cout << "OVERFLOW\n";
else q.push_back(x);
} else {
if (q.empty()) cout << "UNDERFLOW\n";
else { cout << q.front() << "\n"; q.pop_front(); }
}
}
}
复杂度: O(Q)。
题目 3.5.2 — 表达式求值 🟡 中等
计算只含整数和 +、- 运算符(无括号)的简单表达式。
#include <bits/stdc++.h>
using namespace std;
int main() {
string expr; cin >> expr;
stack<long long> nums;
long long cur = 0; bool neg = false;
for (int i = 0; i < (int)expr.size(); i++) {
if (isdigit(expr[i])) cur = cur*10 + (expr[i]-'0');
else {
nums.push(neg ? -cur : cur);
cur = 0; neg = (expr[i] == '-');
}
}
nums.push(neg ? -cur : cur);
long long ans = 0;
while (!nums.empty()) { ans += nums.top(); nums.pop(); }
cout << ans << "\n";
}
题目 3.5.3 — 干草堆模拟 🟡 中等 N 堆干草,每天从最高的那堆取走一捆。D 天后打印剩余捆数。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, D; cin >> n >> D;
multiset<long long, greater<long long>> ms;
for (int i = 0; i < n; i++) { long long x; cin >> x; ms.insert(x); }
for (int d = 0; d < D && !ms.empty(); d++) {
auto it = ms.begin();
long long v = *it; ms.erase(it);
if (v > 1) ms.insert(v-1);
}
long long rem = 0;
for (long long x : ms) rem += x;
cout << rem << "\n";
}
第 3.6 章:单调栈与单调队列
单调栈和单调队列是优雅的工具,能在 O(N) 时间内解决「最近更大/更小元素」和「滑动窗口极值」问题——而朴素做法需要 O(N²)。
3.6.1 单调栈:下一个更大元素
题目: 给定 N 个整数的数组 A,对每个元素 A[i],找下一个更大元素(NGE):i 右侧第一个大于 A[i] 的元素的下标。若不存在,输出 -1。
数据规模: 1 ≤ N ≤ 10⁶,-10⁹ ≤ A[i] ≤ 10⁹(O(N²) 将超时,需要 O(N))。
朴素做法: O(N²) —— 对每个 i,向右扫描直到找到更大的元素。
单调栈做法: O(N) —— 维护一个从底到顶始终递减的栈。压入新元素时,先弹出所有更小的元素(它们刚找到了自己的 NGE!)。
💡 核心思路: 栈中存放还未找到 NGE 的元素的下标。当 A[i] 到来时,栈中所有小于 A[i] 的元素都找到了 NGE(就是 i!)。弹出它们并记录答案。
单调栈状态变化——对 A = [2, 1, 5, 6, 2, 3] 逐步追踪:

📄 
数组 A:[2, 1, 5, 6, 2, 3]
下标: 0 1 2 3 4 5
处理 i=0 (A[0]=2):栈为空 → 压入 0
栈:[0] // 栈存放未解决元素的下标
处理 i=1 (A[1]=1):A[1]=1 < A[0]=2 → 直接压入
栈:[0, 1]
处理 i=2 (A[2]=5):
A[2]=5 > A[1]=1 → 弹出 1,NGE[1] = 2 (A[2]=5 是 A[1] 的下一个更大元素)
A[2]=5 > A[0]=2 → 弹出 0,NGE[0] = 2 (A[2]=5 是 A[0] 的下一个更大元素)
栈为空 → 压入 2
栈:[2]
处理 i=3 (A[3]=6):
A[3]=6 > A[2]=5 → 弹出 2,NGE[2] = 3
压入 3
栈:[3]
处理 i=4 (A[4]=2):A[4]=2 < A[3]=6 → 直接压入
栈:[3, 4]
处理 i=5 (A[5]=3):
A[5]=3 > A[4]=2 → 弹出 4,NGE[4] = 5
A[5]=3 < A[3]=6 → 停止,压入 5
栈:[3, 5]
结束:栈中剩余 [3, 5] → NGE[3] = NGE[5] = -1(右侧无更大元素)
结果:NGE = [2, 2, 3, -1, 5, -1]
验证:
A[0]=2,下一个更大是 A[2]=5 ✓
A[1]=1,下一个更大是 A[2]=5 ✓
A[2]=5,下一个更大是 A[3]=6 ✓
A[3]=6,无更大 → -1 ✓
完整实现
// 用单调栈求下一个更大元素 — O(N)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> A(n);
for (int& x : A) cin >> x;
vector<int> nge(n, -1); // nge[i] = 下一个更大元素的下标,不存在则为 -1
stack<int> st; // 单调递减栈(存下标)
for (int i = 0; i < n; i++) {
// 当栈顶元素小于 A[i] 时
// → 当前元素 A[i] 是那些元素的 NGE
while (!st.empty() && A[st.top()] < A[i]) {
nge[st.top()] = i; // ← 关键:记录栈顶的 NGE
st.pop();
}
st.push(i); // 压入当前下标(尚未解决)
}
// 栈中剩余元素没有 NGE → 已初始化为 -1
for (int i = 0; i < n; i++) {
cout << nge[i];
if (i < n - 1) cout << " ";
}
cout << "\n";
return 0;
}
复杂度分析:
- 每个元素恰好被压入一次,最多被弹出一次
- 总操作:O(2N) = O(N)
- 空间:O(N)(栈)
⚠️ 常见错误: 在栈中存值而非下标。始终存下标——你需要知道在数组的哪个位置记录答案。
3.6.2 变体:上一个更小、上一个更大
通过改变比较方向和遍历方向,可以得到四个相关问题:
| 问题 | 栈类型 | 方向 | 使用场景 |
|---|---|---|---|
| 下一个更大元素(NGE) | 递减栈 | 从左到右 | 股票价格问题 |
| 下一个更小元素(NSE) | 递增栈 | 从左到右 | 直方图问题 |
| 上一个更大元素(PGE) | 递减栈 | 从右到左 | 区间问题 |
| 上一个更小元素(PSE) | 递增栈 | 从右到左 | 左侧最近更小元素 |
上一个更小元素的模板:
// 上一个更小元素:对每个 i,找最近的 j < i 使得 A[j] < A[i]
vector<int> pse(n, -1); // pse[i] = 上一个更小元素的下标,不存在则为 -1
stack<int> st;
for (int i = 0; i < n; i++) {
while (!st.empty() && A[st.top()] >= A[i]) {
st.pop(); // 弹出 >= A[i] 的元素(它们不是「上一个更小」)
}
pse[i] = st.empty() ? -1 : st.top(); // 栈顶就是上一个更小
st.push(i);
}
3.6.3 USACO 应用:直方图中的最大矩形
题目: 给定高度数组 H[0..N-1],找能放入直方图内的最大矩形面积。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ H[i] ≤ 10⁹(面积需 long long)。
核心思路: 对每根柱子 i,以 H[i] 为高度的最大矩形向左右延伸,直到遇到更矮的柱子。用单调栈求每个 i 的:
left[i]= 上一个更小元素的下标right[i]= 下一个更小元素的下标
每根柱子的左右边界——H = [2, 1, 5, 6, 2, 3]:

💡 公式:
宽度 = right[i] - left[i] - 1,面积 = H[i] × 宽度。左边界 = 上一个更小元素的下标;右边界 = 下一个更小元素的下标。
// 直方图中最大矩形 — O(N)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> H(n);
for (int& h : H) cin >> h;
vector<int> left(n), right(n);
stack<int> st;
// 上一个更小(左边界)
for (int i = 0; i < n; i++) {
while (!st.empty() && H[st.top()] >= H[i]) st.pop();
left[i] = st.empty() ? -1 : st.top(); // 矩形起点前的下标
st.push(i);
}
while (!st.empty()) st.pop();
// 下一个更小(右边界)
for (int i = n - 1; i >= 0; i--) {
while (!st.empty() && H[st.top()] >= H[i]) st.pop();
right[i] = st.empty() ? n : st.top(); // 矩形终点后的下标
st.push(i);
}
// 计算最大面积
long long maxArea = 0;
for (int i = 0; i < n; i++) {
long long width = right[i] - left[i] - 1; // 矩形宽度
long long area = (long long)H[i] * width;
maxArea = max(maxArea, area);
}
cout << maxArea << "\n";
return 0;
}
📌 学习建议: 提交前始终用样例输入手动追踪算法。下标边界的细微差一错误是单调栈问题最常见的 bug。
3.6.4 单调双端队列:滑动窗口最大值
题目: 给定 N 个整数的数组 A 和窗口大小 K,找每个大小为 K 的窗口从左向右滑动时的最大值,输出 N-K+1 个值。
数据规模: 1 ≤ K ≤ N ≤ 10⁶,-10⁹ ≤ A[i] ≤ 10⁹(O(NK) 将超时,需要 O(N))。
朴素做法: O(NK) —— 对每个窗口扫描求最大值。
单调双端队列做法: O(N) —— 维护一个递减双端队列(队首 = 当前窗口最大值)。
💡 核心思路: 我们想要滑动窗口的最大值。维护一个下标的双端队列,使得:
- 双端队列中的值递减(队首始终是最大值)
- 双端队列只包含当前窗口内的下标
当新元素到来时:
- 从队尾移除所有更小的元素(只要这个新元素在窗口中,它们就不可能是最大值)
- 若队首已超出当前窗口则移除
逐步追踪
📄 查看代码:逐步追踪
数组 A:[1, 3, -1, -3, 5, 3, 6, 7],K = 3
窗口 [1,3,-1]:最大 = 3
窗口 [3,-1,-3]:最大 = 3
窗口 [-1,-3,5]:最大 = 5
窗口 [-3,5,3]:最大 = 5
窗口 [5,3,6]:最大 = 6
窗口 [3,6,7]:最大 = 7
i=0, A[0]=1:双端队列=[0]
i=1, A[1]=3:3>1 → 弹出 0;双端队列=[1]
i=2, A[2]=-1:-1<3 → 压入;双端队列=[1,2];窗口 [0..2]:最大=A[1]=3 ✓
i=3, A[3]=-3:-3<-1 → 压入;双端队列=[1,2,3];窗口 [1..3]:队首=1 仍在窗口,最大=A[1]=3 ✓
i=4, A[4]=5:5>-3→弹出 3;5>-1→弹出 2;5>3→弹出 1;双端队列=[4];窗口 [2..4]:最大=A[4]=5 ✓
i=5, A[5]=3:3<5→压入;双端队列=[4,5];窗口 [3..5]:队首=4 在窗口,最大=A[4]=5 ✓
i=6, A[6]=6:6>3→弹出 5;6>5→弹出 4;双端队列=[6];窗口 [4..6]:最大=A[6]=6 ✓
i=7, A[7]=7:7>6→弹出 6;双端队列=[7];窗口 [5..7]:最大=A[7]=7 ✓
完整实现
// 用单调双端队列求滑动窗口最大值 — O(N)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, k;
cin >> n >> k;
vector<int> A(n);
for (int& x : A) cin >> x;
deque<int> dq; // 单调递减双端队列,存下标
vector<int> result;
for (int i = 0; i < n; i++) {
// 1. 移除超出当前窗口的元素
while (!dq.empty() && dq.front() <= i - k) {
dq.pop_front(); // ← 关键:弹出已过期的队首
}
// 2. 维护递减性质
// 从队尾移除所有小于 A[i] 的元素
// (只要 A[i] 还在窗口中,它们就不可能是最大值)
while (!dq.empty() && A[dq.back()] <= A[i]) {
dq.pop_back(); // ← 关键:从队尾弹出更小的元素
}
dq.push_back(i); // 加入当前元素
// 3. 第一个完整窗口形成后开始记录最大值
if (i >= k - 1) {
result.push_back(A[dq.front()]); // 队首 = 当前窗口最大值
}
}
for (int i = 0; i < (int)result.size(); i++) {
cout << result[i];
if (i + 1 < (int)result.size()) cout << "\n";
}
cout << "\n";
return 0;
}
复杂度:
- 每个元素最多被压入/弹出双端队列一次 → 总计 O(N)
- 空间:O(K)(双端队列)
⚠️ 常见错误 1: 忘记检查
dq.front() <= i - k来判断窗口过期。双端队列只能包含[i-k+1, i]范围内的下标。⚠️ 常见错误 2: 从队尾弹出时用
<而非<=。用<会保留相等元素,但重复值可能导致问题。用<=维护严格递减的双端队列。
3.6.5 USACO 题型:股票跨度(单调栈)
🔗 灵感: 这类题型在 USACO Bronze/Silver 中出现(「Haybale Stacking」风格)。
// 股票跨度问题:对每天 i,找在 i 之前有多少连续天价格 <= prices[i]
// (第 i 天的「跨度」)
vector<int> stockSpan(vector<int>& prices) {
int n = prices.size();
vector<int> span(n, 1);
stack<int> st; // 单调递减栈(存下标)
for (int i = 0; i < n; i++) {
while (!st.empty() && prices[st.top()] <= prices[i]) {
st.pop();
}
span[i] = st.empty() ? (i + 1) : (i - st.top());
st.push(i);
}
return span;
}
// span[i] = 到 i 为止(含)价格 <= prices[i] 的连续天数
3.6.6 悬线法——极大子矩形
还记得 3.6.3 节的直方图中最大矩形吗?我们用单调栈(跑两遍)求出了每个柱子左右的第一个更矮边界。这一节介绍同一问题的另一种更好懂的视角——悬线法(suspended line / "hoverline")。它不需要栈,只用两条朴素的递推,是单调栈解法适用范围的一个子集,但概念更简单、更好想、更难写错,是解决「极大子矩形」类问题的首选入门工具。
什么是悬线
悬线就是一条竖直的线段,它有两个性质:
- 初始位置:底端点固定在某个格子 (i, j) 上;
- 高度:从底端点向上最多能延伸多长(不穿过任何障碍)。
这条竖线可以在上端点不超过当前位置高度的前提下左右移动。把一条悬线向左、向右推到推不动为止,它扫过的矩形就是「包含这条悬线的极大矩形」。
💡 关键观察: 最大子矩形必定包含某条以 (i, j) 为底端点、高度恰好为该处悬线高度的悬线。所以枚举所有 N×M 个底端点,对每条悬线求出它能左右扩展到的最远边界,答案就在其中。
朴素枚举是 O(N²M) 或更差,但悬线法用递推把它优化到 O(NM)。
一维:直方图最大矩形的悬线写法
以 SPOJ HISTOGRA(直方图最大矩形)为例。定义 l[i] = 位置 i 的悬线能扩展到的最左位置(即 i 左侧第一个比 h[i] 矮的柱子的右边一格)。
l[i] 的求法不是从 i 一格一格向左走,而是**「接力」**:
- 初始
l[i] = i; - 若
h[i] <= h[l[i]-1](左边的柱子不比当前矮),说明悬线可以越过它——而l[i]-1位置的悬线已经把自己的左边界探好了,直接借用它的结果:l[i] = l[l[i]-1],继续判断; - 若
h[i] > h[l[i]-1]或已到边界,停止。
// 悬线法求直方图最大矩形 — O(N)
// l[i]:i 的悬线能扩展到的最左位置(含)
int largestRectangle(vector<int>& h) {
int n = h.size();
vector<int> l(n), r(n);
for (int i = 0; i < n; i++) {
l[i] = i;
while (l[i] > 0 && h[i] <= h[l[i] - 1])
l[i] = l[l[i] - 1]; // 接力:直接跳到左边悬线的左边界
}
for (int i = n - 1; i >= 0; i--) {
r[i] = i;
while (r[i] < n - 1 && h[i] <= h[r[i] + 1])
r[i] = r[r[i] + 1];
}
int best = 0;
for (int i = 0; i < n; i++)
best = max(best, h[i] * (r[i] - l[i] + 1));
return best;
}
为什么是 O(N)? 每次接力的效果是把 l[i] 一步跳过一整段「不矮于 h[i]」的区域,本质上每个位置至多被其他位置的跳跃「经过」一次——和单调栈的均摊分析是同一个道理,只是把「栈弹出」换成了「指针接力」。
二维:01 矩阵最大全 1 子矩形(Luogu P4147 玉蟾宫)
题目: 给定 N×M 的字符矩阵('F' = 可用,'R' = 障碍),求面积最大的全 'F' 子矩形,输出面积 × 3。
把一维模型搬到二维:把「某一列从第 i 行往上连续 'F' 的格数」看成直方图的一根柱子。三个数组逐行递推:
h[i][j]:以 (i,j) 为底端点的悬线高度——g[i][j]=='F'时h[i][j] = h[i-1][j] + 1,否则为 0;l[i][j]:这条悬线在本行内能到达的最左列;r[i][j]:能到达的最右列。
l/r 的递推是悬线法最精妙的地方——悬线向上伸长时,左右边界只会收紧,不会扩张:
l[i][j] = max( 本行内 j 左侧连续 'F' 的最左边界, l[i-1][j] ) // 取交集:左取 max
r[i][j] = min( 本行内 j 右侧连续 'F' 的最右边界, r[i-1][j] ) // 右取 min
直观理解:悬线长到第 i 行时,它扫过的矩形必须同时落在「第 i 行这一段连续 'F'」和「上一行悬线的活动范围」之内。
逐步追踪(玉蟾宫样例,第 3 行 R R R F F F、第 4 行全 F,只看 j=3 这一列):
第 2 行 (R R R F F F):h[2][3]=1, l=3, r=5, 面积 1×3=3
第 3 行 (F F F F F F):h[3][3]=2, 本行左界 0、右界 5
与上一行合并:l = max(0, 3) = 3, r = min(5, 5) = 5
面积 2×3=6
第 4 行 (全 F):h[4][3]=3, l = max(0,3)=3, r = min(5,5)=5 → 面积 3×3=9
最终答案 = 最大面积 15 × 3 = 45
完整实现
// 玉蟾宫 P4147 — 悬线法求 01 矩阵最大全 'F' 子矩形 — O(NM)
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, m;
cin >> n >> m;
vector<vector<char>> g(n, vector<char>(m));
for (int i = 0; i < n; i++)
for (int j = 0; j < m; j++) cin >> g[i][j];
vector<vector<int>> h(n, vector<int>(m, 0));
vector<vector<int>> l(n, vector<int>(m, 0));
vector<vector<int>> r(n, vector<int>(m, 0));
vector<int> rowL(m), rowR(m); // 本行内每个位置左右连续 'F' 的边界
int best = 0;
for (int i = 0; i < n; i++) {
// 本行左右边界:碰到 'R' 就断开
for (int j = 0; j < m; j++)
rowL[j] = (g[i][j] == 'F') ? (j > 0 ? rowL[j - 1] : 0) : j + 1;
for (int j = m - 1; j >= 0; j--)
rowR[j] = (g[i][j] == 'F') ? (j < m - 1 ? rowR[j + 1] : m - 1) : j - 1;
for (int j = 0; j < m; j++) {
if (g[i][j] == 'R') { h[i][j] = 0; continue; }
h[i][j] = (i == 0 || g[i - 1][j] == 'R') ? 1 : h[i - 1][j] + 1;
if (h[i][j] == 1) {
l[i][j] = rowL[j];
r[i][j] = rowR[j];
} else {
// 关键:与上一行的悬线取交集(左取 max,右取 min)
l[i][j] = max(rowL[j], l[i - 1][j]);
r[i][j] = min(rowR[j], r[i - 1][j]);
}
best = max(best, h[i][j] * (r[i][j] - l[i][j] + 1));
}
}
cout << best * 3 << endl; // 题目要求输出面积 × 3
return 0;
}
复杂度: 时间 O(NM),空间 O(NM)(可用滚动数组压到 O(M))。
悬线法 vs 单调栈
| 单调栈 | 悬线法 | |
|---|---|---|
| 适用范围 | 更广(支持扫描时维护单调信息、栈上问题) | 单调栈的子集(不需要在栈上二分的场景) |
| 直方图最大矩形 | 两遍扫描,维护栈,细节多 | 两条递推,几乎不用想 |
| 二维子矩形 | 逐行建直方图 + 单调栈,两层技巧嵌套 | h/l/r 三数组纯递推,一气呵成 |
| 好想程度 | 需要想清「弹出即定位」 | 「悬线 + 接力」,画面感强 |
| 好写程度 | 下标、边界易错 | 递推结构固定,不易写挂 |
建议: 考场上时间紧张时优先写悬线法——它解决问题的范围虽窄,但在这个范围内更好想、更难写错。两者都掌握,用时再按题目特点选择。
⚠️ 常见错误:
l/r递推忘记与上一行合并——只用了本行的rowL/rowR,得到的是「单行最大连续段」而不是极大矩形。h[i][j] > 1时必须max(rowL[j], l[i-1][j])、min(rowR[j], r[i-1][j])。- 01 矩阵题输出忘乘 3——玉蟾宫题目要求输出面积×3(背景是每格收 3 单位麦子),样例对不上时先检查是不是漏了
best * 3。h[i][j]==1时错误地读取了上一行的l/r——悬线高度为 1 时上一行是障碍,其l/r是无效值,必须只用本行边界。
⚠️ 第 3.6 章常见错误
-
存值而非下标 —— 始终存下标。你需要用它们检查窗口范围和记录答案。
-
双端队列中比较用
<而非<=—— 滑动窗口求最大值时,A[dq.back()] <= A[i]时弹出(严格非增)。求最小值时,A[dq.back()] >= A[i]时弹出。 -
忘记窗口过期检查 —— 滑动窗口双端队列中,记录最大值前始终检查
dq.front() < i - k + 1(或<= i - k)。 -
栈的底顶方向搞混 —— 「单调」性质指:从底到顶,栈是递增的(用于 NGE)或递减的(用于 NSE)。搞混时画图辅助。
-
NGE 和 PSE 的处理顺序:
- 下一个更大元素:从左到右遍历
- 上一个更大元素:从右到左遍历(或:从左到右遍历,在压入前记录 stack.top())
本章总结
📌 核心要点
| 问题 | 数据结构 | 时间复杂度 | 关键操作 |
|---|---|---|---|
| 下一个更大元素(NGE) | 单调递减栈 | O(N) | 找到更大元素时弹出 |
| 上一个更小元素(PSE) | 单调递增栈 | O(N) | 压入前栈顶就是答案 |
| 直方图中最大矩形 | 单调栈(两遍) | O(N) | 左边界 + 右边界 + 宽度 |
| 直方图中最大矩形 | 悬线法 | O(N) | l[i] = l[l[i]-1] 接力 |
| 01 矩阵最大全 1 子矩形 | 悬线法 | O(NM) | h/l/r 三数组行间递推 |
| 滑动窗口最大值 | 单调递减双端队列 | O(N) | 维护窗口范围 + 维护递减性质 |
🧩 模板速查
// 单调递减栈(用于 NGE / 下一个更大元素)
stack<int> st;
for (int i = 0; i < n; i++) {
while (!st.empty() && A[st.top()] < A[i]) {
answer[st.top()] = i; // i 是 st.top() 的 NGE
st.pop();
}
st.push(i);
}
// 单调递减双端队列(滑动窗口最大值)
deque<int> dq;
for (int i = 0; i < n; i++) {
while (!dq.empty() && dq.front() <= i - k) dq.pop_front(); // 移除过期元素
while (!dq.empty() && A[dq.back()] <= A[i]) dq.pop_back(); // 维护单调性
dq.push_back(i);
if (i >= k - 1) ans.push_back(A[dq.front()]);
}
❓ 常见问题
Q1:单调栈应该存值还是下标?
A:始终存下标。即使只需要值,存下标更灵活——通过
A[idx]可以取值,反之不行。特别是计算宽度时(如直方图问题),必须用下标。
Q2:如何判断用单调栈还是双指针?
A:观察问题结构——若需要「对每个元素找其左/右侧第一个更大/更小的元素」,用单调栈。若需要「维护滑动窗口的最大值」,用单调双端队列。若「两指针从两端相向移动」,用双指针。
Q3:为什么单调栈的时间复杂度是 O(N) 而不是 O(N²)?
A:均摊分析。每个元素最多被压入一次,最多被弹出一次,总共 2N 次操作,所以是 O(N)。虽然单次 while 循环可能弹出多个元素,但所有 while 循环的弹出总次数绝不超过 N。
练习题
题目 3.6.1 — 下一个更大元素 🟢 简单 对数组中每个元素,找其右侧第一个更大的元素。若不存在打印 -1。
数据规模: 1 ≤ N ≤ 10⁶,-10⁹ ≤ A[i] ≤ 10⁹。
提示
维护单调递减下标栈。处理 A[i] 时,弹出栈中所有更小的元素(它们找到了 NGE)。#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> a(n); for (int& x : a) cin >> x;
vector<int> nge(n, -1);
stack<int> st;
for (int i = 0; i < n; i++) {
while (!st.empty() && a[st.top()] < a[i]) {
nge[st.top()] = a[i];
st.pop();
}
st.push(i);
}
for (int x : nge) cout << x << " "; cout << "\n";
}
样例: [2,1,5,6,2,3] → [5,5,6,-1,3,-1]
复杂度: O(N) —— 每个元素最多被压入/弹出一次。
题目 3.6.2 — 每日温度 🟢 简单 对每一天,找还需等多少天才能迎来更高温度。(LeetCode 739 风格)
数据规模: 1 ≤ N ≤ 10⁵,30 ≤ T[i] ≤ 100。
提示
这正是 NGE 问题。Answer[i] = NGE下标[i] - i。用单调递减栈。#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> T(n); for (int& x : T) cin >> x;
vector<int> ans(n, 0);
stack<int> st;
for (int i = 0; i < n; i++) {
while (!st.empty() && T[st.top()] < T[i]) {
ans[st.top()] = i - st.top(); // 等待天数
st.pop();
}
st.push(i);
}
for (int x : ans) cout << x << " "; cout << "\n";
}
样例: [73,74,75,71,69,72,76,73] → [1,1,4,2,1,1,0,0]
题目 3.6.3 — 滑动窗口最大值 🟡 中等 找每个大小为 K 的滑动窗口的最大值。
数据规模: 1 ≤ K ≤ N ≤ 10⁶,-10⁹ ≤ A[i] ≤ 10⁹。
提示
用单调递减双端队列,维护下标范围在 [i-k+1, i] 内,队首 = 最大值。#include <bits/stdc++.h>
using namespace std;
int main() {
int n, k; cin >> n >> k;
vector<int> a(n); for (int& x : a) cin >> x;
deque<int> dq;
for (int i = 0; i < n; i++) {
while (!dq.empty() && dq.front() < i - k + 1) dq.pop_front();
while (!dq.empty() && a[dq.back()] <= a[i]) dq.pop_back();
dq.push_back(i);
if (i >= k - 1) cout << a[dq.front()] << " \n"[i==n-1];
}
}
样例: n=8,k=3,[1,3,-1,-3,5,3,6,7] → [3,3,5,5,6,7]
复杂度: O(N) 总计——每个元素进/出双端队列一次。
题目 3.6.4 — 直方图中最大矩形 🟡 中等 找直方图中最大矩形的面积。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ H[i] ≤ 10⁹(面积需 long long)。
提示
对每根柱子找上一个更小(左边界)和下一个更小(右边界)。宽度 = 右 - 左 - 1,面积 = 高度 × 宽度。#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> H(n); for (int& x : H) cin >> x;
vector<int> left(n), right(n);
stack<int> st;
// 上一个更小(左边界)
for (int i = 0; i < n; i++) {
while (!st.empty() && H[st.top()] >= H[i]) st.pop();
left[i] = st.empty() ? -1 : st.top();
st.push(i);
}
while (!st.empty()) st.pop();
// 下一个更小(右边界)
for (int i = n-1; i >= 0; i--) {
while (!st.empty() && H[st.top()] >= H[i]) st.pop();
right[i] = st.empty() ? n : st.top();
st.push(i);
}
long long ans = 0;
for (int i = 0; i < n; i++)
ans = max(ans, (long long)H[i] * (right[i] - left[i] - 1));
cout << ans << "\n";
}
样例: [2,1,5,6,2,3] → 10(下标 2 的柱子,高度 5,宽度 2)
复杂度: O(N) —— 两次单调栈遍历。
题目 3.6.5 — 接雨水 🔴 困难 给定高度图,计算下雨后能接住多少水。
数据规模: 1 ≤ N ≤ 10⁶,0 ≤ H[i] ≤ 10⁹(总水量需 long long)。
提示
对每个位置 i,接水量 = min(left_max[i], right_max[i]) - height[i]。#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> h(n); for (int& x : h) cin >> x;
int left = 0, right = n-1, maxL = 0, maxR = 0;
long long ans = 0;
while (left < right) {
if (h[left] <= h[right]) {
maxL = max(maxL, h[left]);
ans += maxL - h[left];
left++;
} else {
maxR = max(maxR, h[right]);
ans += maxR - h[right];
right--;
}
}
cout << ans << "\n";
}
样例: [0,1,0,2,1,0,1,3,2,1,2,1] → 6
复杂度: O(N) 时间,O(1) 空间。
🏆 挑战题:USACO 2016 February Silver——围牛栏 给定一个多边形,判断一个点是否在多边形内部。使用射线投射法——实现时需要仔细处理边界情况。
第 3.7 章:哈希技术
3.7.0 从一道题出发:相同的雪花
先看一道经典题(POJ 3349 雪花雪花雪花,USACO 风格):
❄️ 题目:相同的雪花 有
N(N ≤ 10⁵)片雪花,每片有 6 个手臂长度(顺序给定,环形)。两片雪花相同当且仅当从某个起点顺时针或逆时针读,6 个长度完全一致。 判断是否存在两片相同的雪花。
雪花 A:[1, 2, 3, 4, 5, 6]
雪花 B:[4, 3, 2, 1, 6, 5] → 从 A 的 4 开始逆时针读:4,3,2,1,6,5 ✓ 相同!
先试试你会的方法
思路 1:两两比较? C(10⁵, 2) ≈ 5×10⁹ 对,每对还要试 12 个起点——彻底超时。
思路 2:排序后比较? 6 个数的「旋转 + 翻转」等价类没有天然的排序规则,排不出来。
思路 3:用 map/set? 方向对了——给每片雪花算一个「指纹」,指纹相同才可能是同一片。但把 6 个数的序列直接塞进 map,每层比较都是 6 次操作,而且怎么定义「等价类的标准形」(旋转+翻转意义下唯一)依然很绕。
更关键的问题: 有没有办法让每片雪花变成一个整数,等价的雪花得到相同的整数、不等的雪花几乎不会撞车?——这个「任意对象 → 整数指纹」的函数,就是哈希函数;存指纹的表,就是哈希表。
用哈希解这道题:把 12 种旋转/翻转读法中最小字典序的那个序列算一个多项式哈希值存入 unordered_set,插入前查一下即可——O(N) 完成。
拆解这道题需要回答的问题
- 哈希表内部长什么样?为什么平均 O(1)?碰撞了怎么办?→ 3.7.1 之后的哈希原理与拉链法(页首动画)
map和unordered_map什么时候用哪个?→ 3.7.1 性能对比- 会被对手针对性构造数据卡成 O(N) 吗?怎么防?→ 3.7.2 防 hack(自定义哈希函数)
- 字符串也能变指纹吗?→ 3.7.3 字符串哈希(子串判等 O(1))、3.7.5 Rabin-Karp 匹配
本章按这条线展开——先看页首的哈希表演示,再逐一回答上面的问题。
3.7.1 unordered_map vs map:内部实现与性能
内部实现对比
| 特性 | map | unordered_map |
|---|---|---|
| 内部结构 | 红黑树(平衡 BST) | 哈希表 |
| 查找时间 | O(log N) | 平均 O(1),最坏 O(N) |
| 插入时间 | O(log N) | 平均 O(1),最坏 O(N) |
| 遍历顺序 | 有序(按键升序) | 无序 |
| 内存占用 | O(N),常数较小 | O(N),常数较大 |
| 最坏情况 | O(log N)(稳定) | O(N)(哈希碰撞) |
#include <bits/stdc++.h>
using namespace std;
int main() {
// map:有序,O(log N)
map<int, int> m;
m[3] = 30; m[1] = 10; m[2] = 20;
for (auto [k, v] : m) cout << k << ":" << v << " ";
// 输出:1:10 2:20 3:30 ← 有序!
// unordered_map:无序,平均 O(1)
unordered_map<int, int> um;
um[3] = 30; um[1] = 10; um[2] = 20;
// 遍历顺序不确定,但查找非常快
// 性能差异:N=10^6 次操作
// map: ~300ms;unordered_map: ~80ms(大概)
}
怎么选?
- 用
map: 需要有序遍历、需要lower_bound/upper_bound、键范围极端(高哈希碰撞风险) - 用
unordered_map: 只需查找/插入、键是整数或字符串、N 较大(> 10^5)
3.7.2 防 Hack:自定义哈希
问题: unordered_map 的默认整数哈希本质上是 hash(x) = x,攻击者可以构造大量哈希碰撞,使操作退化到 O(N) 从而 TLE。
在 Codeforces 等平台上,这是常见的 hack 技术。
解决方案:splitmix64 哈希
// 防 hack 自定义哈希器 — 使用 splitmix64
struct custom_hash {
static uint64_t splitmix64(uint64_t x) {
x += 0x9e3779b97f4a7c15;
x = (x ^ (x >> 30)) * 0xbf58476d1ce4e5b9;
x = (x ^ (x >> 27)) * 0x94d049bb133111eb;
return x ^ (x >> 31);
}
size_t operator()(uint64_t x) const {
static const uint64_t FIXED_RANDOM =
chrono::steady_clock::now().time_since_epoch().count();
return splitmix64(x + FIXED_RANDOM);
}
};
// 用法:
unordered_map<int, int, custom_hash> safe_map;
unordered_set<int, custom_hash> safe_set;
⚠️ 竞赛技巧: 在 Codeforces 上用
unordered_map时,始终加上custom_hash。USACO 测试数据不会故意构造 hack,但这是个好习惯。
3.7.3 字符串哈希(多项式哈希)
字符串哈希将字符串映射为整数,把字符串比较变成数值比较(O(1))。
核心公式
对字符串 s[0..n-1],定义哈希值为:
hash(s) = s[0]·B^(n-1) + s[1]·B^(n-2) + ... + s[n-1]·B^0 (mod M)
其中 B 是底数(通常取 131 或 131117),M 是大质数(通常取 10⁹+7 或 10⁹+9)。
前缀哈希 + O(1) 子串哈希
// 字符串哈希:O(N) 预处理,O(1) 子串哈希查询
#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;
const ull BASE = 131;
// 使用 unsigned long long 自然溢出(等价于 mod 2^64)
struct StringHash {
int n;
vector<ull> h, pw;
StringHash(const string& s) : n(s.size()), h(n + 1, 0), pw(n + 1, 1) {
for (int i = 0; i < n; i++) {
h[i + 1] = h[i] * BASE + (s[i] - 'a' + 1); // 1-indexed 前缀哈希
pw[i + 1] = pw[i] * BASE; // BASE^(i+1)
}
}
// 获取子串 s[l..r](0-indexed)的哈希值
ull get(int l, int r) {
return h[r + 1] - h[l] * pw[r - l + 1]; // ← 关键公式
}
};
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
string s = "abcabc";
StringHash sh(s);
// 比较两个子串是否相等
// s[0..2] = "abc",s[3..5] = "abc"
cout << (sh.get(0, 2) == sh.get(3, 5) ? "相等" : "不相等") << "\n"; // 相等
// 比较 s[0..1] = "ab" vs s[3..4] = "ab"
cout << (sh.get(0, 1) == sh.get(3, 4) ? "相等" : "不相等") << "\n"; // 相等
}
公式推导:
h[r+1] = s[0]*B^r + s[1]*B^(r-1) + ... + s[r]*B^0
h[l] = s[0]*B^(l-1) + ... + s[l-1]*B^0
h[r+1] - h[l] * B^(r-l+1)
= s[l]*B^(r-l) + s[l+1]*B^(r-l-1) + ... + s[r]*B^0
= hash(s[l..r]) ✓
下图直观展示了前缀哈希数组的构建过程,以及如何用 get(l, r) 公式在 O(1) 内提取任意子串的哈希值:

3.7.4 双重哈希(避免碰撞)
单重哈希(mod M)的碰撞概率约 1/M。对 N 次子串比较,预期碰撞次数约 N²/(2M)。
下图展示了两种经典的碰撞处理方式——链式法(unordered_map 内部使用)和线性探测:

- 若
M = 10⁹+7,N = 10⁶:碰撞概率约10¹²/(2×10⁹) = 500次!不安全。 - 解决方案:双重哈希,同时使用两对不同的 (B, M),碰撞概率降至
1/(M₁×M₂) ≈ 10⁻¹⁸。
// 双重哈希:同时用两对 (BASE, MOD),碰撞概率极低
struct DoubleHash {
static const ull B1 = 131, M1 = 1e9 + 7;
static const ull B2 = 137, M2 = 1e9 + 9;
int n;
vector<ull> h1, h2, pw1, pw2;
DoubleHash(const string& s) : n(s.size()),
h1(n+1,0), h2(n+1,0), pw1(n+1,1), pw2(n+1,1) {
for (int i = 0; i < n; i++) {
ull c = s[i] - 'a' + 1;
h1[i+1] = (h1[i] * B1 + c) % M1;
h2[i+1] = (h2[i] * B2 + c) % M2;
pw1[i+1] = pw1[i] * B1 % M1;
pw2[i+1] = pw2[i] * B2 % M2;
}
}
// 返回 pair<ull,ull> 作为子串 s[l..r] 的哈希「指纹」
pair<ull,ull> get(int l, int r) {
ull v1 = (h1[r+1] - h1[l] * pw1[r-l+1] % M1 + M1) % M1;
ull v2 = (h2[r+1] - h2[l] * pw2[r-l+1] % M2 + M2) % M2;
return {v1, v2};
}
};
3.7.5 应用:字符串匹配(Rabin-Karp)
// Rabin-Karp 字符串匹配:找 T 中所有 P 的出现位置
// 时间:平均 O(N+M),最坏 O(NM)(实际非常快)
#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;
vector<int> rabinKarp(const string& T, const string& P) {
int n = T.size(), m = P.size();
if (m > n) return {};
const ull BASE = 131;
ull patHash = 0, textHash = 0, pow_m = 1;
// 计算 BASE^m(自然溢出)
for (int i = 0; i < m - 1; i++) pow_m *= BASE;
// 初始哈希
for (int i = 0; i < m; i++) {
patHash = patHash * BASE + P[i];
textHash = textHash * BASE + T[i];
}
vector<int> result;
for (int i = 0; i + m <= n; i++) {
if (textHash == patHash) {
// 哈希匹配时验证(避免碰撞导致的误判)
if (T.substr(i, m) == P) result.push_back(i);
}
if (i + m < n) {
// 滚动哈希:去掉最左边的字符,加入最右边的字符
textHash = textHash - T[i] * pow_m; // 移除最左
textHash = textHash * BASE + T[i + m]; // 加入最右
}
}
return result;
}
3.7.6 应用:最长公共子串
题目: 给定字符串 S 和 T,找最长公共子串的长度。
数据规模: 1 ≤ |S|, |T| ≤ 10⁵,均由小写字母组成。
做法: 二分答案(最长公共子串的长度 L),然后用哈希集合检查是否有长度为 L 的子串同时出现在两个字符串中。
// 最长公共子串:O(N log N) — 二分查找 + 哈希
int longestCommonSubstring(const string& S, const string& T) {
StringHash hs(S), ht(T);
int ns = S.size(), nt = T.size();
auto check = [&](int len) -> bool {
unordered_set<ull> setS;
for (int i = 0; i + len <= ns; i++)
setS.insert(hs.get(i, i + len - 1));
for (int j = 0; j + len <= nt; j++)
if (setS.count(ht.get(j, j + len - 1)))
return true;
return false;
};
int lo = 0, hi = min(ns, nt);
while (lo < hi) {
int mid = (lo + hi + 1) / 2;
if (check(mid)) lo = mid;
else hi = mid - 1;
}
return lo;
}
⚠️ 常见错误
-
模数选择不当: 不要用
10⁹+7以外的数;尤其避免非质数模数(碰撞率高)。推荐:10⁹+7和10⁹+9作为双重哈希对。 -
unordered_map被 hack: 在 Codeforces 等平台上,默认哈希可被攻击。始终使用custom_hash。 -
子串哈希相减下溢:
h[r+1] - h[l] * pw[r-l+1]在有符号整数下可能为负。使用unsigned long long自然溢出,或用(... % M + M) % M确保非负。 -
底数与字符集不匹配: 对仅含小写字母(26 种)的情况,BASE 必须 > 26(通常用 31 或 131)。对全 ASCII 字符(128 种),BASE 必须 > 128(用 131 或 137)。
-
哈希碰撞导致 WA: 即使双重哈希,理论上仍可能碰撞。不确定时,哈希匹配后加直接字符串比较。
本章总结
📌 核心对比表
| 工具 | 时间复杂度 | 使用场景 |
|---|---|---|
map<K,V> | O(log N) | 需要有序性,需要范围查询 |
unordered_map<K,V> | O(1) 均摊 | 只需查找/插入,不需要键的顺序 |
| 字符串哈希(单重) | O(N) 预处理,O(1) 查询 | 子串比较、模式匹配 |
| 字符串哈希(双重) | O(N) 预处理,O(1) 查询 | 高精度场景,避免碰撞 |
❓ 常见问题
Q1:ull 自然溢出双重哈希和手动 mod 哈希哪个更好?
A:
ull自然溢出(等价于 mod 2⁶⁴)代码更简单,2⁶⁴ 足够大以至于单重哈希碰撞概率已经极低(约 10⁻¹⁸)。但精心构造的数据可以故意触发碰撞——此时双重哈希更安全。两种方式在竞赛中都有效;ull更常见。
Q2:字符串哈希能做什么 KMP 做不到的事?
A:字符串哈希擅长多字符串比较(如最长公共子串、回文子串),而 KMP 只擅长单模式匹配。哈希 + 二分查找可以用 O(N log N) 解决许多需要更复杂 KMP 实现的字符串问题。
Q3:底数该用 31 还是 131?
A:只有小写字母时用 31(小于 37 的质数,避免哈希空间太小)。混合大小写或含数字时用 131(大于 128 的质数,覆盖完整 ASCII)。关键是:BASE 必须大于字符集大小,最好是质数。
练习题
题目 3.7.1 — 哈希两数之和 🟢 简单 给定数组 A,判断是否存在两个不同元素之和等于目标值 X。
数据规模: 1 ≤ N ≤ 10⁵,-10⁹ ≤ A[i] ≤ 10⁹,-2×10⁹ ≤ X ≤ 2×10⁹(O(N²) 将超时,需要 O(N))。
提示
对每个 A[i],检查 (X - A[i]) 是否已经在哈希集合中。#include <bits/stdc++.h>
using namespace std;
int main() {
int n, X; cin >> n >> X;
vector<int> a(n); for (int& x : a) cin >> x;
unordered_set<int> seen;
for (int x : a) {
if (seen.count(X - x)) { cout << "YES\n"; return 0; }
seen.insert(x);
}
cout << "NO\n";
}
复杂度: O(N) 均摊。
题目 3.7.2 — 子串查找 🟢 简单 给定文本 T 和模式 P,打印 P 在 T 中所有出现位置的起始下标。
数据规模: 1 ≤ |P| ≤ |T| ≤ 10⁶,均由小写字母组成。
提示
滚动哈希:用前缀哈希在 O(1) 计算 T 的每个 |P| 长度窗口的哈希值。#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;
const ull BASE = 131, MOD = (1ULL<<61)-1;
int main() {
string T, P; cin >> T >> P;
int n = T.size(), m = P.size();
vector<ull> h(n+1,0), pw(n+1,1);
for(int i=0;i<n;i++) { h[i+1]=(h[i]*BASE+T[i])%MOD; pw[i+1]=pw[i]*BASE%MOD; }
ull hp=0; for(char c:P) hp=(hp*BASE+c)%MOD;
for(int i=0;i+m<=n;i++){
ull wh=(h[i+m]-h[i]*pw[m]%MOD+MOD*2)%MOD;
if(wh==hp) cout<<i<<"\n";
}
}
复杂度: O(N + M)。
题目 3.7.3 — 最长回文子串 🟡 中等 找最长回文子串的长度。
数据规模: 1 ≤ |S| ≤ 10⁶,由小写字母组成。
提示
对长度二分查找。s[l..r] 是回文串当且仅当 hash(s[l..r]) == hash(rev(s)[n-1-r..n-1-l])。#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;
const ull BASE=131;
struct Hasher {
vector<ull> h,pw;
Hasher(const string&s){
int n=s.size(); h.resize(n+1,0); pw.resize(n+1,1);
for(int i=0;i<n;i++){h[i+1]=h[i]*BASE+s[i];pw[i+1]=pw[i]*BASE;}
}
ull get(int l,int r){return h[r+1]-h[l]*pw[r-l+1];}
};
int main(){
string s; cin>>s;
string r(s.rbegin(),s.rend());
Hasher hs(s),hr(r);
int n=s.size(), ans=1;
auto check=[&](int len)->bool{
for(int i=0;i+len<=n;i++){
int j=i+len-1;
if(hs.get(i,j)==hr.get(n-1-j,n-1-i)) return true;
}
return false;
};
int lo=1,hi=n;
while(lo<=hi){int mid=(lo+hi)/2;if(check(mid)){ans=mid;lo=mid+1;}else hi=mid-1;}
cout<<ans<<"\n";
}
复杂度: O(N log N)。
题目 3.7.4 — 统计不同子串 🟡 中等 给定长度为 N 的字符串 S(N ≤ 5000),统计不同子串的个数。
提示
将所有 O(N²) 个子串的哈希值插入 unordered_set,用双重哈希避免碰撞。#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;
int main(){
string s; cin>>s;
int n=s.size();
const ull B1=131,B2=137,M1=1e9+7,M2=1e9+9;
unordered_set<ull> seen;
for(int i=0;i<n;i++){
ull h1=0,h2=0;
for(int j=i;j<n;j++){
h1=(h1*B1+s[j])%M1;
h2=(h2*B2+s[j])%M2;
seen.insert(h1*M2+h2); // 合并两个哈希值
}
}
cout<<seen.size()<<"\n";
}
复杂度: O(N²) 时间和空间(适用于 N ≤ 5000)。
题目 3.7.5 — 字符串周期 🔴 困难 找字符串 S 的最小周期(最小的 k 整除 n,使得 S = S[0..k-1] 的重复)。
数据规模: 1 ≤ |S| ≤ 10⁶,由小写字母组成。
提示
对 n 的每个因数 k,验证 s[0..k-1] 重复后是否等于 s,用哈希比较,每次检查 O(n/k)。#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;
const ull BASE=131,MOD=1e9+7;
int main(){
string s; cin>>s;
int n=s.size();
vector<ull> h(n+1,0),pw(n+1,1);
for(int i=0;i<n;i++){h[i+1]=(h[i]*BASE+s[i])%MOD;pw[i+1]=pw[i]*BASE%MOD;}
auto getHash=[&](int l,int r){return (h[r+1]-h[l]*pw[r-l+1]%MOD+MOD*2)%MOD;};
vector<int> divs;
for(int i=1;i*i<=n;i++) if(n%i==0){divs.push_back(i);if(i!=n/i)divs.push_back(n/i);}
sort(divs.begin(),divs.end());
for(int k:divs){
bool ok=true;
for(int i=0;i+k<=n&&ok;i+=k)
if(getHash(i,i+k-1)!=getHash(0,k-1)) ok=false;
if(ok){cout<<k<<"\n";return 0;}
}
}
复杂度: O(d(N) × N) ≈ 典型输入 O(N log N)。
第 3.8 章:映射与集合
3.8.0 从一道题出发:牛的编号
先看一道典型的 Silver 风格题:
🐄 题目:独特的奶牛 有
N(N ≤ 10⁵)头奶牛,每头有一个编号id_i(范围可达 10⁹,且可能是负数)。 农夫 John 想知道:
- 有多少个不同的编号?
- 哪个编号出现次数最多?(并列输出最小的编号)
- 给
Q次查询,每次问「编号严格大于x的不同编号有几个?」
先试试你会的方法
问题 1、2 用数组计数? 编号范围 10⁹ 还有负数——开 cnt[10⁹] 数组直接内存爆炸。而且编号本身没有上限,说明值域不能当下标用。
问题 3 用排序 + 二分? 排序后「大于 x 的个数」确实是二分。但若题目是边插入边查询(在线),每次重排一遍就是 O(NQ log N),超时。我们需要一个始终有序、支持动态插入的结构。
问题 1、2 的另一种直觉: 「编号 → 出现次数」天然是一个映射;「出现过哪些编号」天然是一个集合。C++ 的 map/set 就是把「值域任意的东西」变成可以 O(log N) 存取的东西——数组的下标是 0..N-1,而 map 的「下标」可以是任何可比较的值。
拆解这道题需要回答的问题
map的频率统计(问题 1、2)已在第 3.1.3 节学过,本章直接用- 有序性到底带来了什么别人做不到的能力?→ 3.8.1 回顾与选型
- 问题 3 需要「动态有序集」——
set的lower_bound怎么用?→ 3.8.2 有序操作 - 多重集合(同一编号出现多次都要保留)呢?→ 3.8.6 multiset
- USACO 真题里怎么出现?→ 3.8.4 真题与本章练习
| 小节 | 回答的问题 |
|---|---|
| 3.8.1 | 为什么有序性是 map/set 的杀手锏(选型) |
| 3.8.2 | set 的 lower_bound 动态有序查询(问题 3) |
| 3.8.4 | USACO 题目:奶牛 ID |
| 3.8.6 | multiset——允许重复的有序集合(含双 multiset 中位数) |
3.8.1 回顾:从 map/set 到「动态有序」
第 3.1.3 节已经教过 map 和 set 的基本操作(插入、查找、erase、有序遍历,以及 map[key] 自动创建的陷阱)。本节不重复这些内容,而是补上 3.1 没有讲的部分:这两个容器内部长什么样,以及它们真正的杀手锏——动态维护有序性。

内部结构决定了能力:
map/set内部是红黑树(平衡 BST):插入/查找 O(log N),元素始终有序——这是unordered_map做不到的。unordered_map/unordered_set内部是哈希表:平均 O(1) 更快,但无序。(原理与防 hack 见第 3.7 章。)
有序性带来的三个杀手锏(本章的主角):
*s.begin()/*s.rbegin()随时取最小/最大值——O(1);lower_bound(x)/upper_bound(x)动态二分查找——插入和查询交替进行也不会超时;- 遍历即有序输出——不需要额外排序。
📌 什么时候必须用
map/set而不是unordered_: 需要有序遍历、需要取最值、需要lower_bound动态查询,或担心被 hack(见 3.7.2)。只需纯查找时,unordered_更快。
回到开头的问题 3:「编号严格大于 x 的不同编号有几个?」——把所有编号存进 set,答案就是 s.end() - s.upper_bound(x),且边插入边查询也没问题。这就是 3.1 学不到、本章要练的能力。
3.8.2 set 的有序操作——lower_bound 动态查询
3.1 只展示了 set 的去重用途。真正区分新手和熟手的,是 lower_bound / upper_bound 与动态插入的组合:
#include <bits/stdc++.h>
using namespace std;
int main() {
set<int> s = {5, 3, 8, 1, 9, 2};
// s = {1, 2, 3, 5, 8, 9}(始终有序!)
// 动态二分查询(set 内置的版本,不是 <algorithm> 的)
auto it = s.lower_bound(4); // 第一个 >= 4 的元素
cout << *it << "\n"; // 5
auto it2 = s.upper_bound(4); // 第一个 > 4 的元素
cout << *it2 << "\n"; // 5
// 边插边查——排序数组做不到,set 可以
s.insert(4);
cout << *s.lower_bound(4) << "\n"; // 4(刚插入就生效)
// ⚠️ 陷阱:set 迭代器是双向迭代器,不能相减!
// s.end() - s.upper_bound(3) ← 编译错误!
// 计数「> 3 的元素有几个」的正确姿势:distance(O(log N) 之后还要 O(k) 步进,慎用于大区间)
cout << distance(s.upper_bound(3), s.end()) << "\n"; // 4(4, 5, 8, 9)
return 0;
}
⚠️ 重要陷阱:
vector排序后可以直接upper_bound(v.begin(), v.end(), x) - v.begin()拿下标,但set的迭代器是双向迭代器,-无法编译。要么用std::distance(复杂度与步数成正比),要么改用order_of_key(见下面的扩展)。
3.8.4 USACO 题目:奶牛 ID
题目(USACO 2017 February Bronze): 给定一组「已占用」的 ID 集合和 N,找第 N 个可用的 ID。
数据规模: 1 ≤ 已占用 ID 数 ≤ 10⁴,1 ≤ 查询数 Q ≤ 10⁴,1 ≤ ID ≤ 10⁹(ID 范围太大,不能开布尔数组)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
set<int> taken;
for (int i = 0; i < n; i++) {
int x; cin >> x;
taken.insert(x);
}
// 对每个查询 q,找第 q 个不在 taken 中的正整数
while (q--) {
int k; cin >> k;
// 二分查找:找最小的 x 使得 x - (x 以内已占用的数量) >= k
int lo = 1, hi = 2e9;
while (lo < hi) {
int mid = lo + (hi - lo) / 2;
// [1, mid] 中可用数量 = mid - (≤ mid 的已占用数量)
int taken_count = (int)(taken.lower_bound(mid + 1) - taken.begin());
int available = mid - taken_count;
if (available >= k) hi = mid;
else lo = mid + 1;
}
cout << lo << "\n";
}
return 0;
}
3.8.6 Multiset——允许重复的有序集合
multiset 类似于 set,但允许重复值:
#include <bits/stdc++.h>
using namespace std;
int main() {
multiset<int> ms;
ms.insert(3);
ms.insert(1);
ms.insert(3); // 允许重复
ms.insert(5);
ms.insert(1);
// ms = {1, 1, 3, 3, 5}
cout << ms.count(3) << "\n"; // 2(有几个 3)
cout << ms.count(2) << "\n"; // 0
// 只移除一个 3
ms.erase(ms.find(3)); // 只移除一个 3
// ms = {1, 1, 3, 5}
// 移除所有的 1
ms.erase(1); // 移除所有 1
// ms = {3, 5}
cout << *ms.begin() << "\n"; // 3(最小)
cout << *ms.rbegin() << "\n"; // 5(最大)
return 0;
}
用两个 Multiset 维护动态中位数
用最大 multiset(下半部分)和最小 multiset(上半部分)跟踪数据流的中位数:
#include <bits/stdc++.h>
using namespace std;
int main() {
multiset<int> lo; // 下半部分(rbegin() = 最大值)
multiset<int> hi; // 上半部分(begin() = 最小值)
int n;
cin >> n;
for (int i = 0; i < n; i++) {
int x;
cin >> x;
// 加入合适的半部分
if (lo.empty() || x <= *lo.rbegin()) {
lo.insert(x);
} else {
hi.insert(x);
}
// 重新平衡:大小差不超过 1
while (lo.size() > hi.size() + 1) {
hi.insert(*lo.rbegin());
lo.erase(lo.find(*lo.rbegin()));
}
while (hi.size() > lo.size()) {
lo.insert(*hi.begin());
hi.erase(hi.begin());
}
// 打印中位数
if (lo.size() == hi.size()) {
// 偶数个:两个中间值的平均
double median = (*lo.rbegin() + *hi.begin()) / 2.0;
cout << fixed << setprecision(1) << median << "\n";
} else {
// 奇数个:中间值在 lo 中
cout << *lo.rbegin() << "\n";
}
}
return 0;
}
3.8.7 进阶:pb_ds ——会数数的红黑树
痛点: 「集合中第 k 小的值是多少?」「严格小于 x 的元素有几个?」——set 做不到(迭代器不能相减,见 3.8.2),map 也做不到。排序数组可以做但每次插入 O(N)。
GCC 内置的 pb_ds 库提供了一个自带排名的平衡树,两个操作都是 O(log N):
#include <bits/stdc++.h>
#include <ext/pb_ds/assoc_container.hpp>
#include <ext/pb_ds/tree_policy.hpp>
using namespace std;
using namespace __gnu_pbds;
// 竞赛通用模板:直接抄
template<class T>
using ordered_set = tree<T, null_type, less<T>,
rb_tree_tag, tree_order_statistics_node_update>;
int main() {
int n, q;
cin >> n >> q;
ordered_set<int> s;
for (int i = 0; i < n; i++) { int x; cin >> x; s.insert(x); }
while (q--) {
string op; int x;
cin >> op >> x;
if (op == "k") { // 第 k 小(1-indexed)
if (x < 1 || x > (int)s.size()) cout << "invalid\n";
else cout << *s.find_by_order(x - 1) << "\n";
} else { // 严格小于 x 的元素个数
cout << s.order_of_key(x) << "\n";
}
}
return 0;
}
两个核心方法:
| 方法 | 含义 | 复杂度 |
|---|---|---|
find_by_order(k) | 返回第 k+1 小元素的迭代器(0-indexed) | O(log N) |
order_of_key(x) | 严格小于 x 的元素个数(= x 的排名) | O(log N) |
样例输入:
5 3
3 1 4 1 5
k 2
rank 4
rank 1
样例输出:
3
2
0
(去重后 s = {1, 3, 4, 5}:第 2 小是 3;小于 4 的有 1、3 共 2 个;小于 1 的没有。)
典型用法(USACO Gold 常见):
- 动态第 k 小:边插入边查询——排序数组做不到;
- 区间计数:「值在 [l, r] 内的元素个数」=
order_of_key(r+1) - order_of_key(l); - 配对
pair用less_equal可以当可删除的多重集合——multiset删不了「第 k 小」,它删得了。
⚠️ 注意:
pb_ds是 GCC 扩展,USACO / Codeforces(GCC 编译器)都支持,但 MSVC 等编译器没有。本地用 clang + Apple SDK 时也可能没有这个头文件——竞赛代码不受影响,本地测试需要换 GCC。
3.8.8 实用模式
模式一:统计不同元素
vector<int> data = {1, 5, 3, 1, 2, 5, 5, 3};
set<int> distinct(data.begin(), data.end());
cout << "不同值的个数:" << distinct.size() << "\n"; // 4
模式二:按频率分组,按值排序
vector<int> nums = {3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5};
map<int, int> freq;
for (int x : nums) freq[x]++;
// 按频率分组
map<int, vector<int>> byFreq;
for (auto &[val, cnt] : freq) {
byFreq[cnt].push_back(val);
}
// 按频率顺序打印
for (auto &[cnt, vals] : byFreq) {
for (int v : vals) cout << v << "(×" << cnt << ")\n";
}
模式三:离线查询与排序结合
将查询与事件一起排序,以 O((N+Q) log N) 一起处理:
// 示例:对每个查询点,统计有多少事件的值 <= 查询点
// 对两个数组排序,用双指针扫描
⚠️ 第 3.8 章常见错误
| # | 错误 | 错在哪里 | 修复方法 |
|---|---|---|---|
| 1 | map[key] 访问不存在的键 | 自动创建值为 0 的条目,污染数据 | 先用 m.count(key) 或 m.find(key) 检查 |
| 2 | multiset::erase(value) 删除所有相等值 | 本想删一个,却删光了 | 用 ms.erase(ms.find(value)) 只删一个 |
| 3 | 遍历时修改 map/set 大小 | 迭代器失效,崩溃或跳过元素 | 用 it = m.erase(it) 安全删除 |
| 4 | unordered_map 被 hack 退化到 O(N) | 攻击者构造哈希碰撞数据,TLE | 换用 map 或使用3.7.2 的自定义哈希 |
| 5 | 忘记 set 不存储重复值 | 插入重复后 size() 不增,计数出错 | 需要重复时用 multiset |
本章总结
📌 核心要点
| 结构 | 有序? | 允许重复? | 关键特性 | 为什么重要 |
|---|---|---|---|---|
map<K,V> | 是(有序) | 否(唯一键) | 键值映射,O(log N) | 频率统计、ID→属性映射 |
unordered_map<K,V> | 否 | 否 | 平均 O(1) 查找 | 大数据下比 map 快 5-10 倍 |
set<T> | 是(有序) | 否 | 有序唯一集合 | 去重,范围查询(lower_bound) |
unordered_set<T> | 否 | 否 | O(1) 成员检测 | 只需检查「是否见过」 |
multiset<T> | 是(有序) | 是 | 有序多集合 | 动态中位数、滑动窗口 |
🧩 「用哪个容器」速查
| 需求 | 推荐容器 | 原因 |
|---|---|---|
| 统计每个元素出现次数 | map / unordered_map | 一行 freq[x]++ |
| 去重并排序 | set | 自动去重 + 自动排序 |
| 检查元素是否已见 | unordered_set | O(1) 查找 |
| 动态有序集合 + 求极值 | set / multiset | O(1) 访问最小/最大值 |
需要 lower_bound / upper_bound | set / map | 只有有序容器支持 |
| 值→下标映射 | map / unordered_map | 坐标压缩等场景 |
❓ 常见问题
Q1:map 的 [] 运算符和 find 有什么区别?
A:
m[key]当键不存在时会自动创建默认值(int 的默认值为 0);m.find(key)只查找,不创建。如果只想检查键是否存在,用m.count(key)或m.find(key) != m.end()。
Q2:multiset 和 priority_queue 都能取极值——用哪个?
A:
priority_queue只能取极值并删除,不支持按值删除。multiset支持查找并删除任意值,更灵活。只需反复取极值时,priority_queue更简单;需要删除特定元素(如滑动窗口移除离开的元素)时,用multiset。
Q3:unordered_map 什么时候比 map 慢?
A:哈希碰撞严重时退化到
O(N)(包括被对手针对性构造数据)。原因与防法见第 3.7.2 节。
Q4:C++17 结构化绑定 auto &[key, val] 安全吗?竞赛中能用吗?
A:USACO 和大多数竞赛平台支持 C++17,
for (auto &[key, val] : m)可以安全使用。比entry.first/entry.second更简洁。
🔗 与后续章节的联系
- 第 3.3 章(排序与搜索):坐标压缩常与
map结合(值 → 压缩后下标) - 第 5.7 章(线段树):有序
set的lower_bound可以替代简单的线段树查询 - 第 5.1–5.2 章(图):
map常用于存储稀疏图的邻接表 - 第 4 部分(贪心):
multiset结合贪心策略可以高效维护动态最优选择 map频率统计模式贯穿全书,是竞赛编程中最基础的工具之一
练习题
题目 3.8.1 — 字母异位词分组 🟡 中等 将 N 个单词按其字母排序后的形式分组。
数据规模: 1 ≤ N ≤ 10⁴,1 ≤ 单词长度 ≤ 100,均由小写字母组成。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
map<string, vector<string>> groups;
for (int i = 0; i < n; i++) {
string w; cin >> w;
string key = w; sort(key.begin(), key.end());
groups[key].push_back(w);
}
for (auto& [key, words] : groups) {
sort(words.begin(), words.end());
for (const string& w : words) cout << w << " ";
cout << "\n";
}
}
复杂度: O(N × K log K),K = 平均单词长度。
题目 3.8.2 — 区间最大重叠数 🟡 中等 统计 N 个区间在点 1..M 上的最大重叠数。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 10⁶,1 ≤ L ≤ R ≤ M。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, M; cin >> n >> M;
vector<int> diff(M + 2, 0);
for (int i = 0; i < n; i++) {
int l, r; cin >> l >> r;
diff[l]++; diff[r+1]--;
}
int cur = 0, ans = 0;
for (int i = 1; i <= M; i++) {
cur += diff[i];
ans = max(ans, cur);
}
cout << ans << "\n";
}
复杂度: O(N + M)。
题目 3.8.4 — 奶牛摄影 🔴 困难 找与所有 N 个列表(每个都是 ID 的一个排列)一致的顺序。
数据规模(与 USACO 2011 原题「Cow Photography」一致): 1 ≤ N ≤ 20,000,1 ≤ K ≤ 5,ID 为 1..N 的排列。
核心思路: 对每对 (a, b),统计 a 在多少个列表中排在 b 之前。若 a 在超过一半的列表中排在 b 前面,则 a 在真实顺序中排在 b 前面。用这个成对比较来排序。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, k; cin >> n >> k;
vector<vector<int>> pos(k, vector<int>(n+1));
for (int i = 0; i < k; i++)
for (int j = 0; j < n; j++) {
int x; cin >> x; pos[i][x] = j;
}
vector<int> cows(n); iota(cows.begin(), cows.end(), 1);
sort(cows.begin(), cows.end(), [&](int a, int b){
int before = 0;
for (int i = 0; i < k; i++) before += (pos[i][a] < pos[i][b]);
return before > k / 2;
});
for (int c : cows) cout << c << "\n";
}
题目 3.8.6 — 实时不同值计数 🟢 简单 每读入一个新整数后,打印到目前为止见过的不同值的个数。
数据规模: 1 ≤ N ≤ 10⁶,-10⁹ ≤ A[i] ≤ 10⁹。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
unordered_set<int> seen;
for (int i = 0; i < n; i++) {
int x; cin >> x;
seen.insert(x);
cout << seen.size() << "\n";
}
}
复杂度: O(N) 均摊。
📖 第 3.9 章:二分答案
🎯 学习目标
学完本章后,你将能够:
- 识别「可以用二分答案」的题目特征(三要素)
- 区分「找第一个满足条件」和「找最后一个满足条件」两种模板
- 设计正确的
check函数 - 处理浮点二分和三分法求极值
- 避免整数二分中的边界死循环
3.9.1 什么是二分答案?
从枚举到二分
考虑这个问题:
你有 N 根木头,每根长度不同。需要切出 K 根长度相等(都为 x)的木棍,问 x 的最大值是多少?
数据规模:
1 ≤ N ≤ 10⁴,1 ≤ K ≤ 10⁴,1 ≤ 木头长度 ≤ 10⁸。
朴素思路: 枚举所有可能的 x,检查是否满足条件。
- 若 x 能切出 ≥ K 根 → 合法
- 若 x 太大,切不出 → 不合法
这需要 O(10^9) 次检查,太慢了。
二分答案的洞察:
如果 x = 5 可以切出 ≥ K 根,那 x = 4 肯定也可以(每根切的数量只会更多)。
也就是说,满足条件的 x 构成一个连续区间 [0, 某个上界]。
我们可以对这个区间二分,每次检查中点是否合法。
3.9.2 二分答案的三要素
使用二分答案必须满足以下三个条件:
| 条件 | 说明 | 验证方法 |
|---|---|---|
| ① 答案在固定区间内 | 能确定答案的上下界 | 分析题目数据范围 |
| ② check 函数易于实现 | 给定一个答案值,能快速判断是否合法 | 通常用贪心或 O(N) 扫描 |
| ③ 单调性 | 若 x 合法,则更小(或更大)的值也合法 | 手动举反例验证 |
单调性的两种形式
形式 1:「最大值最小化」
合法区间在左侧:0 0 0 [1 1 1 1 1]
→ 找最后一个合法值(最右侧的 1)
形式 2:「最小值最大化」
合法区间在右侧:[1 1 1 1 1] 0 0 0
→ 找第一个合法值(最左侧的 1)
3.9.3 整数二分模板
模板 A:找满足条件的最大值(最大化)
// 找最大的 x,使 check(x) == true
// 前提:check 形如 [true...true, false...false]
bool check(int x) {
// 判断 x 是否满足条件
// ...
}
int binary_search_max() {
int lo = 可能的最小值;
int hi = 可能的最大值 + 1; // hi 是第一个不合法的值
while (lo + 1 < hi) {
int mid = lo + (hi - lo) / 2; // 防溢出写法
if (check(mid))
lo = mid; // mid 合法,尝试更大的
else
hi = mid; // mid 不合法,答案在左侧
}
return lo; // lo 是最大的合法值
}
模板 B:找满足条件的最小值(最小化)
// 找最小的 x,使 check(x) == true
// 前提:check 形如 [false...false, true...true]
int binary_search_min() {
int lo = 可能的最小值 - 1; // lo 是第一个不合法的值
int hi = 可能的最大值;
while (lo + 1 < hi) {
int mid = lo + (hi - lo) / 2;
if (check(mid))
hi = mid; // mid 合法,尝试更小的
else
lo = mid; // mid 不合法,答案在右侧
}
return hi; // hi 是最小的合法值
}
为什么用 lo + 1 < hi 而不是 lo < hi?
📄 查看代码:为什么用 lo + 1 < hi 而不是 lo < hi?
终止条件分析:
循环条件 lo + 1 < hi,即 lo 和 hi 不相邻时继续
终止时:lo + 1 == hi
此时 lo 是最大的合法值,hi 是最小的不合法值
若用 lo < hi,则 mid = (lo+hi)/2 = lo,会死循环!
示例:lo=4, hi=5
mid = 4 + (5-4)/2 = 4
若 check(4)=true,lo = mid = 4(没有变化!死循环)
3.9.4 完整例题:切木头
有 N 根木头,长度为
a[1..N],需要切出 K 根长度为 H 的木棍。
每切一根,从长度 L > H 的木头中截取一段 H,剩余部分保留。
求 H 的最大值(整数)。数据规模:
1 ≤ N ≤ 10⁴,1 ≤ K ≤ 10⁴,1 ≤ a[i] ≤ 10⁸。
分析
- 答案范围: H ∈ [1, max(a)]
- check(H): 扫描所有木头,统计能切出多少根长 H 的木棍,是否 ≥ K
- 单调性: H 越大,切出的根数越少(check 从 true 变 false),满足最大化模式
#include <bits/stdc++.h>
using namespace std;
int n, k;
vector<int> a;
// 检查高度 H 能否切出 >= k 根
bool check(long long H) {
long long total = 0;
for (int x : a) {
total += x / H; // 每根木头能切出几段
}
return total >= k;
}
int main() {
cin >> n >> k;
a.resize(n);
for (int& x : a) cin >> x;
long long lo = 1, hi = *max_element(a.begin(), a.end()) + 1;
while (lo + 1 < hi) {
long long mid = lo + (hi - lo) / 2;
if (check(mid))
lo = mid; // 可以切出够多,尝试更高
else
hi = mid; // 切得太短,上界降低
}
cout << lo << endl; // 最大的合法高度
return 0;
}
追踪示例:
木头长度 = [8, 5, 3, 2],K = 5
lo=1, hi=9
mid=5:check(5) = 8/5+5/5+3/5+2/5 = 1+1+0+0 = 2 < 5 → false,hi=5
mid=3:check(3) = 8/3+5/3+3/3+2/3 = 2+1+1+0 = 4 < 5 → false,hi=3
mid=2:check(2) = 8/2+5/2+3/2+2/2 = 4+2+1+1 = 8 >= 5 → true,lo=2
lo+1 = 3 = hi,循环结束
答案:lo = 2
3.9.5 例题:最大化最小值(安置奶牛)
USACO 经典题:N 个牛栏位于 1D 数轴上(坐标已知),放 C 头奶牛,
使得相邻奶牛之间的最小距离最大,求这个最大值。数据规模(与经典题一致):
2 ≤ C ≤ N ≤ 10⁵,0 ≤ 坐标 ≤ 10⁹。
分析
- 答案范围: [1, max_coord - min_coord]
- check(D): 贪心地从左到右放置奶牛,若相邻奶牛距离 ≥ D,则放下一头
- 单调性: D 越大越难满足(最小化模式的反向)
#include <bits/stdc++.h>
using namespace std;
int n, c;
vector<int> pos;
// 检查:最小距离至少为 D,能否放 >= c 头奶牛?
bool check(int D) {
int cows = 1; // 第一头放在最左边
int last = pos[0]; // 上一头奶牛的位置
for (int i = 1; i < n; i++) {
if (pos[i] - last >= D) {
// 距离足够,放一头奶牛
cows++;
last = pos[i];
if (cows >= c) return true;
}
}
return cows >= c;
}
int main() {
cin >> n >> c;
pos.resize(n);
for (int& x : pos) cin >> x;
sort(pos.begin(), pos.end()); // 按位置排序
int lo = 0, hi = pos.back() - pos.front() + 1;
while (lo + 1 < hi) {
int mid = lo + (hi - lo) / 2;
if (check(mid))
lo = mid; // 间距 mid 可行,尝试更大
else
hi = mid;
}
cout << lo << endl;
return 0;
}
3.9.6 浮点二分
当答案是实数时,用「循环足够多次」代替「两点相邻」:
// 浮点二分(精度 1e-7)
double lo = 0.0, hi = 1e9;
for (int iter = 0; iter < 100; iter++) { // 100次足够精确到 1e-30
double mid = (lo + hi) / 2.0;
if (check(mid))
lo = mid;
else
hi = mid;
}
// (lo + hi) / 2 即为答案,精度约 1e-30
也可以用 while (hi - lo > 1e-7) 作终止条件,但循环次数不固定(约 50 次)。
注意: 浮点比较需留意精度,check 中不要用 ==。
3.9.7 三分法(求单峰函数极值)
当需要求「单峰函数」的最大/最小值时,使用三分法:
单峰函数: 存在一个极值点,左侧单调递增,右侧单调递减(或相反)。
f(x): 2 4 7 9 8 6 3
↑
极值点(峰值 = 9)
三分法思路
在区间 [lo, hi] 中取两个三等分点 lmid 和 rmid:
- 若
f(lmid) < f(rmid):极值点在lmid右侧,lo = lmid - 若
f(lmid) > f(rmid):极值点在rmid左侧,hi = rmid
// 三分法(浮点版,求单峰函数最大值点)
double ternary_search(double lo, double hi) {
for (int iter = 0; iter < 200; iter++) {
double m1 = lo + (hi - lo) / 3.0;
double m2 = hi - (hi - lo) / 3.0;
if (f(m1) < f(m2))
lo = m1;
else
hi = m2;
}
return (lo + hi) / 2.0;
}
// 三分法(整数版,数组中的单峰)
int ternary_search_int(vector<int>& a) {
int lo = 0, hi = a.size() - 1;
while (hi - lo > 2) {
int m1 = lo + (hi - lo) / 3;
int m2 = hi - (hi - lo) / 3;
if (a[m1] < a[m2])
lo = m1;
else
hi = m2;
}
// 在 [lo, hi] 中线性查找最大值
int best = lo;
for (int i = lo + 1; i <= hi; i++)
if (a[i] > a[best]) best = i;
return best;
}
3.9.8 二分答案 vs 二分查找
| 对比项 | 二分查找(Binary Search) | 二分答案(Binary on Answer) |
|---|---|---|
| 作用 | 在有序数组中找特定值 | 在答案空间中枚举猜测值 |
| 数据结构 | 需要有序数组 | 不需要数组,只需 check 函数 |
| check | 数组下标的比较 | 通常是 O(N) 或 O(N log N) 的验证 |
| 常见题型 | lower_bound, upper_bound | 最大化最小值、最小化最大值 |
| 总复杂度 | O(log N) | O(log(答案范围) × check 复杂度) |
3.9.9 USACO 真题训练:把「最优值」改成「可行性判断」
二分答案的核心不是二分模板,而是把原问题改写成:
给定一个候选答案
x,我能否在O(N)或O(N log N)时间内判断它是否可行?
识别框架
| 题面问法 | 二分方向 | check(x) 通常做什么 |
|---|---|---|
| 最大化最小值 | 找最大的可行 x | 贪心检查能否保持至少 x 的距离/容量 |
| 最小化最大值 | 找最小的可行 x | 贪心检查能否把代价控制在 x 内 |
| 最小舞台/机器数量 | 找最小的可行 x | 模拟 x 个资源是否足够 |
| 最短时间/最大等待 | 找最小的可行 x | 按时间排序后贪心分组 |
真题 1:Convention(USACO 2018 December Silver)— 最小化最大等待时间
题目链接: USACO 2018 December Silver P1: Convention
对应模式: 二分答案 + 贪心装车
难度定位: Silver 标准
题干解读
N 头奶牛按不同时间到达机场,有 M 辆巴士,每辆最多坐 C 头。你需要安排每辆车的发车时间,使得所有奶牛中的最大等待时间最小。
数据规模(与原题一致): 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 10⁵,1 ≤ C ≤ N,1 ≤ 到达时间 ≤ 10⁶。
关键条件:
- 奶牛可以按到达时间排序。
- 给定最大等待时间
x后,可以贪心判断需要多少辆车。 x越大,越容易安排;x越小,越难安排,满足单调性。
思路分析
把问题改成判定:
如果允许每头奶牛最多等
x分钟,能否用不超过M辆车送走所有奶牛?
check(x):
- 按到达时间排序。
- 当前车从第一头未安排奶牛开始。
- 只要车未满且当前奶牛等待时间
arrival[i] - firstArrival <= x,就放入当前车。 - 否则开新车。
- 最后判断用车数是否
<= M。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("convention.in", "r", stdin);
// freopen("convention.out", "w", stdout);
int n, m, c;
cin >> n >> m >> c;
vector<int> arrival(n);
for (int &x : arrival) cin >> x;
sort(arrival.begin(), arrival.end());
auto can = [&](int maxWait) {
int buses = 1;
int first = arrival[0];
int count = 0;
for (int time : arrival) {
if (count == c || time - first > maxWait) {
buses++;
first = time;
count = 0;
}
count++;
}
return buses <= m;
};
int lo = 0, hi = arrival.back() - arrival.front();
while (lo < hi) {
int mid = lo + (hi - lo) / 2;
if (can(mid)) hi = mid;
else lo = mid + 1;
}
cout << lo << "\n";
return 0;
}
复杂度: 排序 O(N log N),每次 check 为 O(N),二分约 log V 次,总复杂度 O(N log N + N log V)。
易错点提醒
- 忘记排序到达时间。 贪心装车只在时间有序时成立。
- 车满和等待超限两个条件缺一不可。 任意一个触发都要开新车。
first没有更新。 新车的等待基准必须是这辆车第一头奶牛的到达时间。- 二分方向写反。
can(mid)为真时说明答案可以更小,应移动hi = mid。
拓展思考
Convention 的 check 是「按顺序分组」模型。很多 Silver 题都类似:固定一个最大允许代价后,贪心地尽量把更多元素放进当前组,放不下再开新组。
真题 2:Cow Dance Show(USACO 2017 January Silver)— 最小舞台大小
题目链接: USACO 2017 January Silver P1: Cow Dance Show
对应模式: 二分答案 + 最小堆模拟
难度定位: Silver 进阶
题干解读
N 头奶牛按固定顺序上台,每头跳舞时间不同。舞台容量为 K,同时最多有 K 头奶牛在台上。当前有奶牛跳完后,下一头立刻上台。给定总时间上限 Tmax,求最小的 K。
数据规模(与原题一致): 1 ≤ N ≤ 10,000,1 ≤ Tmax ≤ 10⁶,1 ≤ 跳舞时间 ≤ 10⁴。
关键条件:
K越大,总演出时间越短或不变,存在单调性。- 给定
K,可以用最小堆模拟每头牛结束时间。
思路分析
check(K):
- 前
K头牛先上台,结束时间就是自己的持续时间。 - 每次取最早结束的时间
t。 - 下一头牛在
t时刻上台,结束时间为t + duration[i]。 - 所有牛处理完后,堆中最大结束时间就是总演出时间。
若总时间 <= Tmax,说明容量 K 可行。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("cowdance.in", "r", stdin);
// freopen("cowdance.out", "w", stdout);
int n, tMax;
cin >> n >> tMax;
vector<int> duration(n);
for (int &x : duration) cin >> x;
auto can = [&](int stageSize) {
priority_queue<int, vector<int>, greater<int>> finishTime;
for (int i = 0; i < n; i++) {
if ((int)finishTime.size() == stageSize) {
int earliest = finishTime.top();
finishTime.pop();
finishTime.push(earliest + duration[i]);
} else {
finishTime.push(duration[i]);
}
}
int totalTime = 0;
while (!finishTime.empty()) {
totalTime = max(totalTime, finishTime.top());
finishTime.pop();
}
return totalTime <= tMax;
};
int lo = 1, hi = n;
while (lo < hi) {
int mid = lo + (hi - lo) / 2;
if (can(mid)) hi = mid;
else lo = mid + 1;
}
cout << lo << "\n";
return 0;
}
复杂度: 每次 check(K) 为 O(N log K),二分 O(log N) 次,总复杂度 O(N log N log N),足以通过 Silver 数据。
易错点提醒
- 把舞台当成普通队列。 应该总是让最早结束的牛离开,所以要用最小堆。
- 二分边界从 0 开始。 舞台大小至少为 1。
- 只看最后弹出的值。 堆中结束时间不一定按插入顺序,稳妥做法是取所有结束时间最大值。
check中修改原数组。 模拟只应使用堆,不要改变duration。
拓展思考
如果舞台容量固定,要求最短总时间,这就是多机调度模拟;如果牛可以任意重排,问题会变成另一类调度优化,不再是本题的固定顺序模型。
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| 死循环 | while(lo < hi) + lo = mid,当 lo+1==hi 时 mid = lo 死循环 | 改用 while(lo + 1 < hi) |
| 答案差 1 | hi 设置为 max_val 而非 max_val + 1 | hi = 答案上界 + 1(左闭右开) |
| check 溢出 | check 中累加超过 int 范围 | 使用 long long |
| 浮点精度不足 | 迭代次数太少 | 设为 100 次,不必再少 |
| 三分法用于非单峰函数 | 只有单峰函数才能三分 | 先确认函数的单峰性质 |
💪 练习题(共 8 道,全部含完整解答)
🟢 基础练习(1~3)
题目 1:切绳子(浮点二分)
N 根绳子,长度已知,要切出 K 根相同长度的绳子,求最大长度(精确到 0.01m)。
数据规模: 1 ≤ N ≤ 10⁴,1 ≤ K ≤ 10⁴,1 ≤ 绳长 ≤ 10⁵(保留两位小数)。
示例:
N=4, K=11
绳子长度:8.02 7.43 4.57 5.39
答案:2.00
#include <bits/stdc++.h>
using namespace std;
int n, k;
vector<double> a;
bool check(double len) {
int total = 0;
for (double x : a) total += (int)(x / len);
return total >= k;
}
int main() {
cin >> n >> k;
a.resize(n);
for (double& x : a) cin >> x;
double lo = 0, hi = *max_element(a.begin(), a.end());
for (int iter = 0; iter < 100; iter++) {
double mid = (lo + hi) / 2.0;
if (check(mid)) lo = mid;
else hi = mid;
}
// 保留两位小数
printf("%.2f\n", lo);
return 0;
}
关键: 浮点二分用「循环固定次数(100次)」而非「精度判断」,避免精度问题导致死循环。100 次后误差约 (hi-lo)/2^100,远小于题目要求。
题目 2:数组分组(最大值最小化)
将长度 N 的数组分为恰好 K 组连续子数组,使各组元素之和的最大值最小,输出该最小最大值。
数据规模: 1 ≤ K ≤ N ≤ 10⁵,0 ≤ a[i] ≤ 10⁹(组和需 long long)。
示例:
N=5, K=3, 数组=[1,2,3,4,5]
最优分法:[1,2],[3],[4,5] → 最大组和 = max(3,3,9)=9?
不对,试 [1,2,3],[4],[5] → max(6,4,5)=6 ✓
输出:6
#include <bits/stdc++.h>
using namespace std;
int n, k;
vector<long long> a;
bool check(long long maxSum) {
for (long long x : a) if (x > maxSum) return false; // 单元素超限
int groups = 1; long long cur = 0;
for (long long x : a) {
if (cur + x > maxSum) { groups++; cur = x; }
else cur += x;
}
return groups <= k;
}
int main() {
cin >> n >> k;
a.resize(n);
long long total = 0;
for (long long& x : a) { cin >> x; total += x; }
long long lo = *max_element(a.begin(), a.end()) - 1;
long long hi = total + 1;
while (lo + 1 < hi) {
long long mid = lo + (hi - lo) / 2;
if (check(mid)) hi = mid;
else lo = mid;
}
cout << hi << "\n";
return 0;
}
下面的追踪图展示了 lo/hi/mid 在 a=[1,2,3,4,5], k=3 上的二分收敛过程,每步给出 check(mid) 的分组结果:
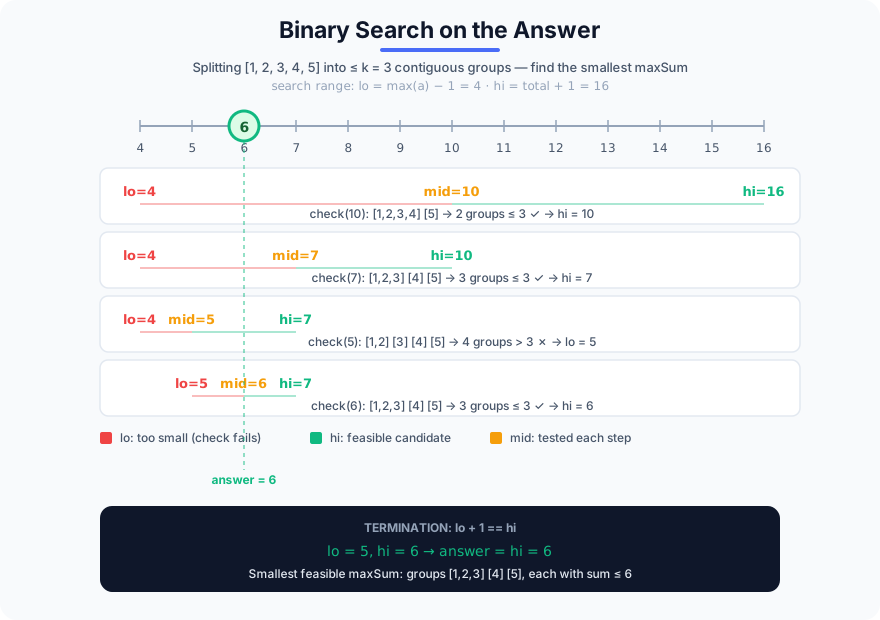
题目 3:查找有序矩阵第 K 小元素
N×N 的矩阵,每行每列均递增。找第 K 小的元素。
数据规模: 1 ≤ N ≤ 300,1 ≤ K ≤ N²,-10⁹ ≤ 矩阵元素 ≤ 10⁹。
提示: 对答案二分,check(x) = 矩阵中 ≤ x 的元素个数 ≥ K。
#include <bits/stdc++.h>
using namespace std;
int n, k;
vector<vector<int>> mat;
// 统计矩阵中 <= x 的元素个数
// 利用行有序性:每行二分
int count_le(int x) {
int cnt = 0;
for (auto& row : mat) {
// upper_bound 返回第一个 > x 的迭代器
cnt += (int)(upper_bound(row.begin(), row.end(), x) - row.begin());
}
return cnt;
}
int main() {
cin >> n >> k;
mat.assign(n, vector<int>(n));
for (auto& row : mat) for (int& x : row) cin >> x;
int lo = mat[0][0] - 1;
int hi = mat[n-1][n-1];
while (lo + 1 < hi) {
int mid = lo + (hi - lo) / 2;
if (count_le(mid) >= k) hi = mid; // mid 可能是答案,尝试更小
else lo = mid;
}
cout << hi << "\n"; // 最小的使 count_le >= k 的值
return 0;
}
复杂度: O(N log N log(max-min)),N=300, max=10^9 时约 300×8×30 ≈ 72000 次操作,极快。
🟡 进阶练习(4~6)
题目 4:安置奶牛(最大化最小值)
N 个牛栏分布在数轴上(坐标已知),放 C 头奶牛,使任意两头奶牛之间的距离尽可能大。
求最大的「最小相邻距离」。
数据规模: 2 ≤ C ≤ N ≤ 10⁵,0 ≤ 坐标 ≤ 10⁹。
#include <bits/stdc++.h>
using namespace std;
int n, c;
vector<int> pos;
bool check(int D) {
int cows = 1, last = pos[0];
for (int i = 1; i < n; i++) {
if (pos[i] - last >= D) { cows++; last = pos[i]; }
if (cows >= c) return true;
}
return cows >= c;
}
int main() {
cin >> n >> c;
pos.resize(n);
for (int& x : pos) cin >> x;
sort(pos.begin(), pos.end());
int lo = 0, hi = pos.back() - pos.front() + 1;
while (lo + 1 < hi) {
int mid = lo + (hi - lo) / 2;
if (check(mid)) lo = mid;
else hi = mid;
}
cout << lo << "\n";
return 0;
}
追踪(pos=[1,2,4,8,9], c=3):
排序后:[1,2,4,8,9],lo=0,hi=9
mid=4:check(4):1放1,下一个≥1+4=5→放8,下一个≥8+4=12>9→只放2头 < 3 ✗ → lo=4
mid=6:check(6):放1,≥7→放8,≥14>9→2头 < 3 ✗ → lo=6(⚠️等等)
重新算:
mid=4:1(place)→2(dist=1<4跳)→4(dist=3<4跳)→8(dist=4✓,place)→9(dist=1<4跳) → 2头 < 3 ✗ → lo=4?
不对,重新算 c=3:
mid=3:1(place)→2(1<3)→4(3✓,place)→8(4✓,place) → 3头 ≥ 3 ✓ → lo=3
mid=4:1(place)→4(3<4)→8(4✓,place)→9(1<4) → 2头 < 3 ✗ → hi=4
lo+1=4=hi,答案 lo=3
题目 5:跳石头(NOIP 2015)
河中有 N 块石头,起点到终点距离 L。可以移除最多 M 块石头,使最短跳跃距离最大。
求这个最大的「最短跳跃距离」。
数据规模(与原题一致): 1 ≤ L ≤ 10⁹,0 ≤ N ≤ 50,000,0 ≤ M ≤ N,1 < 石头位置 < L(石头位置互不相同)。
#include <bits/stdc++.h>
using namespace std;
int l, n, m;
vector<int> pos; // 包含起点0和终点l
bool check(int minDist) {
// 统计需要移除多少块石头,使所有相邻距离 >= minDist
int removed = 0, prev = 0;
for (int i = 1; i < (int)pos.size(); i++) {
if (pos[i] - prev < minDist) removed++; // 这块石头太近,移除
else prev = pos[i];
}
return removed <= m;
}
int main() {
cin >> l >> n >> m;
pos.push_back(0); // 起点
for (int i = 0; i < n; i++) {
int x; cin >> x;
pos.push_back(x);
}
pos.push_back(l); // 终点
sort(pos.begin(), pos.end());
int lo = 0, hi = l + 1;
while (lo + 1 < hi) {
int mid = lo + (hi - lo) / 2;
if (check(mid)) lo = mid;
else hi = mid;
}
cout << lo << "\n";
return 0;
}
关键: check(D) 采用贪心——从左到右扫描,遇到距离 < D 的石头就移除(因为移除它一定不差于移除其他石头)。统计移除数量是否 ≤ M。
题目 6:最优比率(分数规划)
给定 N 个任务,每个任务有完成时间 t[i] 和价值 v[i]。
选恰好 K 个任务,最大化 总价值 / 总时间。输出最大比率(精度 1e-6)。
数据规模: 1 ≤ K ≤ N ≤ 10⁵,1 ≤ t[i], v[i] ≤ 10⁶。
核心转化(0-1 分数规划):
二分比率 λ,检查是否存在选 K 个任务使得 Σv[i] / Σt[i] ≥ λ,
等价于 Σ(v[i] - λ*t[i]) ≥ 0。
对 w[i] = v[i] - λ*t[i] 取最大的 K 个,若其和 ≥ 0,则 λ 可行。
#include <bits/stdc++.h>
using namespace std;
int n, k;
vector<double> t_arr, v_arr;
bool check(double lam) {
// 计算每个任务的 "净收益" w[i] = v[i] - lam * t[i]
vector<double> w(n);
for (int i = 0; i < n; i++) w[i] = v_arr[i] - lam * t_arr[i];
// 取最大的 k 个净收益之和
sort(w.begin(), w.end(), greater<double>());
double sum = 0;
for (int i = 0; i < k; i++) sum += w[i];
return sum >= 0; // 能否达到比率 lam?
}
int main() {
cin >> n >> k;
t_arr.resize(n); v_arr.resize(n);
for (int i = 0; i < n; i++) cin >> t_arr[i] >> v_arr[i];
double lo = 0, hi = 1e6; // 比率的上下界
for (int iter = 0; iter < 100; iter++) {
double mid = (lo + hi) / 2.0;
if (check(mid)) lo = mid;
else hi = mid;
}
printf("%.6f\n", lo);
return 0;
}
为什么这样转化正确?
若最优比率为 λ*,则对任意 λ < λ*,都能选到 K 个任务满足 Σ(v[i]-λt[i]) ≥ 0;
对任意 λ > λ*,不可能满足。这正是「单调性」的体现。
🔴 挑战练习(7~8)
题目 7:最小化最大花费(二分 + 图)
N 个城市,M 条带权无向边。需要选一些边,连通所有城市,使最大边权最小。
(即最小生成树的最大边权最小化。)
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵,1 ≤ w ≤ 10⁹,保证图连通。
二分视角: 二分「允许的最大边权」= W,check(W) = 只用权重 ≤ W 的边,是否能连通所有城市。
等价于:Kruskal 算法跑到权重 W 时,是否已经形成生成树。
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> pa, sz;
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1) { iota(pa.begin(), pa.end(), 0); }
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false;
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y];
return true;
}
};
int n, m;
vector<tuple<int,int,int>> edges; // {w, u, v}
bool check(int maxW) {
DSU dsu(n);
int cnt = 0;
for (auto& [w, u, v] : edges) {
if (w > maxW) break;
if (dsu.unite(u, v)) cnt++;
}
return cnt == n - 1;
}
int main() {
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v, w; cin >> u >> v >> w;
edges.push_back({w, u, v});
}
sort(edges.begin(), edges.end());
int lo = 0, hi = get<0>(edges.back()) + 1;
while (lo + 1 < hi) {
int mid = lo + (hi - lo) / 2;
if (check(mid)) hi = mid;
else lo = mid;
}
cout << (check(hi) ? hi : -1) << "\n"; // -1 表示无法连通
return 0;
}
注: 实际上这等价于直接跑 Kruskal 的最大边权,无需二分——但本题作为二分思维的练习,两种做法均正确。
题目 8:最小化等待时间(二分 + 贪心)
N 个顾客到达超市,每人需要服务时间 s[i],超市有 K 个服务台。
每个服务台每次服务一人,服务完后立即接待下一人。
合理安排顾客顺序,使所有顾客等待时间之和最小。
数据规模: 1 ≤ K ≤ N ≤ 10⁵,1 ≤ s[i] ≤ 10⁴(等待总和需 long long)。
提示: 先证明「等待时间之和最小」等价于「将服务时间最短的顾客优先」,然后贪心排序直接求答案(无需二分)。
挑战版:若每个顾客有到达时刻限制 a[i],需要对答案二分「最大等待时间」。
证明: 若服务台同时开始,将顾客按服务时间升序排列,使等待时间之和最小(SPT规则)。
K 个服务台版本(贪心 + 优先队列):
维护 K 个服务台的当前空闲时刻,每次将下一位顾客分配到最早空闲的服务台。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, k;
cin >> n >> k;
vector<int> s(n);
for (int& x : s) cin >> x;
sort(s.begin(), s.end()); // 按服务时间升序(SPT 规则)
// K 个服务台的空闲时刻(最小堆)
priority_queue<long long, vector<long long>, greater<long long>> free_time;
for (int i = 0; i < k; i++) free_time.push(0);
long long total_wait = 0;
for (int i = 0; i < n; i++) {
long long earliest = free_time.top(); free_time.pop();
total_wait += earliest; // 顾客 i 的等待时间 = 服务台空闲时刻
free_time.push(earliest + s[i]);
}
cout << total_wait << "\n";
return 0;
}
示例(n=4, k=2, s=[3,1,4,2]):
排序后 s = [1,2,3,4]
服务台:[0,0](初始空闲时刻)
顾客0(s=1):分配到台0,台0变为0+1=1,wait=0
服务台:[0,1]
顾客1(s=2):分配到台0(最早空闲),台0变为0+2=2,wait=0
服务台:[1,2]
顾客2(s=3):分配到台0(空闲时=1),wait=1,台变为1+3=4
服务台:[2,4]
顾客3(s=4):分配到台0(空闲时=2),wait=2,台变为2+4=6
总等待时间 = 0+0+1+2 = 3
💡 章节联系: 二分答案是竞赛中最实用的思想之一,贯穿 USACO Bronze→Gold 的所有级别。它通常与贪心(check 函数的核心工具)和前缀和(快速验证)结合使用,是「思想轻巧、代码简洁」的典范。
⚡ 第四部分:贪心算法
无需复杂递推式的优雅算法——只需一个精妙的观察。学习贪心何时奏效、如何证明,以及强大的贪心 + 二分搜索组合。
📚 4 章 · ⏱️ 预计 1-2 周 · 🎯 目标:活动选择、调度、二分答案 + 贪心
第四部分:贪心算法
预计用时:1-2 周
贪心算法非常优雅:无需复杂的递推式,无需状态爆炸——只需一个精妙的观察,让一切迎刃而解。难点在于知道何时贪心可行,并在可行时能证明它的正确性。
涵盖的主题
| 章节 | 主题 | 核心思想 |
|---|---|---|
| 第 4.1 章 | 贪心基础 | 贪心何时奏效;交换论证法;活动选择 |
| 第 4.2 章 | 区间与调度 | 区间调度三变体;EDF;Huffman |
| 第 4.3 章 | 排序、匹配与构造 | 自定义比较器;双序列匹配;区间合并;数字字符串贪心 |
| 第 4.4 章 | 进阶贪心与 USACO 真题 | 后悔贪心;对抗匹配;位运算贪心;5 道 Silver 真题 |
学完本部分后能解决什么问题
完成第四部分后,你将能够挑战:
-
USACO Bronze:
- 带贪心决策的模拟(最优地处理事件)
- 简单的基于排序的贪心
-
USACO Silver:
- 活动选择(不重叠区间最大化)
- 调度问题(最早截止日期优先,最小化最大延迟)
- 贪心 + 二分答案
- Huffman 风格的合并问题(优先队列)
关键贪心模式
| 模式 | 排序依据 | 应用 |
|---|---|---|
| 活动选择 | 结束时间升序 | 最大不重叠区间数 |
| 最早截止日期优先 | 截止时间升序 | 最小化最大延迟 |
| 区间刺穿 | 结束时间升序 | 最少点覆盖所有区间 |
| 区间覆盖 | 开始时间升序 | 最少区间覆盖范围 |
| 分数背包 | 价值/重量降序 | 最大化带容量限制的价值 |
| Huffman 合并 | 用最小堆 | 最小化编码代价 |
贪心思维方式
编写贪心解法前,先问自己:
- 每一步「显然最优」的选择是什么?
- 能做交换论证吗? 把贪心选择与任何其他选择互换,结果只会变差(或保持不变)吗?
- 能找到反例吗? 试一些贪心可能失败的小例子。
若能回答 (1) 和 (2) 且对 (3) 找不到反例,你的贪心很可能是正确的。
本部分学习建议
- 贪心最难「验证」。 不像 DP 只需要正确的递推式,贪心需要正确性论证。多练习交换论证证明的草稿。
- 贪心失败时,DP 通常是修复方案。 硬币找零(第 4.1 章)完美地展示了这一点。
- 第 4.4 章有真实的 USACO 真题 —— 仔细研究代码,不只是高层次的想法。
- 贪心 + 二分搜索(第 4.4 章真题 Convention)是频繁出现在 Silver 的强力组合。贪心解决「检查」函数,二分查找最优答案。
💡 核心思路: 排序是大多数贪心算法的引擎,排序标准体现了「贪心选择」——优先选最好的元素。交换论证证明了这个标准是最优的。
🏆 USACO 技巧: USACO Silver 中,若题目问「在约束 Y 下最大化 X」或「达成 Z 的最小代价」,先尝试带贪心检查的二分答案。这个组合解决了相当大比例的 Silver 题目。
第 4.1 章:贪心基础
4.1.0 从一道题出发:能用几场活动
先看一道生活化的经典题:
📅 题目:活动选择 会议室只有一间。今天有
N(N ≤ 10⁵)场活动,第i场从时刻s_i开始、e_i结束。一场活动一结束下一场就能立刻开始。问:最多能安排多少场不冲突的活动?
活动:A[1,4] B[2,3] C[3,5] D[0,6] E[5,7] F[6,8]
不冲突的选择:B(2-3) → C(3-5) → E(5-7) → F(6-8)……最多 3 场?
先试试你会的方法
思路 1:暴力枚举所有组合? 每场活动只有「选」或「不选」两种可能,N 场活动就有 2^N 种组合——N = 20 时约一百万种还扛得住,N = 10⁵ 时想都别想。暴力行不通,得找更聪明的办法。
思路 2:直觉贪心? 「先结束的活动先选」——选 B(2,3),跳过和它冲突的,再选 C(3,5),再选 E(5,7)……三场。这种「只看眼前最优」的策略竟然是对的?
思路 3:但贪心总对吗? 换一道题:用硬币 {1,5,6,9} 凑 11 分,「每次拿最大硬币」得到 9+1+1 = 3 枚,而最优是 6+5 = 2 枚——贪心错了。
这就是贪心的微妙之处:同一个「每步取局部最优」策略,在活动选择里是定理,在硬币找零里是反例。本章的全部任务就是搞清楚:
- 贪心什么时候对?(贪心选择性质 + 最优子结构)
- 怎么证明它对?(交换论证——把任何最优解逐步换成贪心解而不变差)
- 贪心错了怎么办?(换一种更通用的方法,或者用「后悔贪心」拿堆撤销选择)
- USACO 里怎么快速识别贪心题?
4.1.1 什么样的问题可以用贪心解决?
贪心方法在问题具有贪心选择性质时奏效:每一步做出局部最优选择,最终得到全局最优解。
与 DP 的对比
📌 名词预告: 动态规划(Dynamic Programming,简称 DP)是本书第 6 部分才系统学习的通用算法思想——它「把所有子问题的答案都算一遍」,因此几乎总是正确但更慢。本节只需要知道这个名字;看不懂对比不影响理解贪心本身。
考虑用硬币凑出 11 分:
- 硬币:{1, 5, 6, 9}
- 贪心:9 + 1 + 1 = 3 枚
- 最优:6 + 5 = 2 枚
这里贪心失败了。贪心选择(每次选最大的硬币)没有达到全局最优。
但对于美国硬币 {1, 5, 10, 25, 50}:
- 41 分:贪心 → 25 + 10 + 5 + 1 = 4 枚 ✓(最优)
美国硬币有特殊结构使贪心可行。始终要验证!
完整演示:硬币找零——贪心的失败案例
让我们详细追踪硬币找零例子,看清楚贪心在哪里出错。
题目: 用硬币 {1, 5, 6, 9} 凑出 11 分,最少需要几枚?(枚举所有组合即可验证最优是 2 枚。)
贪心做法(每次选 ≤ 剩余金额的最大硬币):
剩余=11 → 选 9(≤11 最大)。剩余=2。已用:[9]
剩余=2 → 选 1(≤2 最大)。剩余=1。已用:[9, 1]
剩余=1 → 选 1(≤1 最大)。剩余=0。已用:[9, 1, 1]
结果:3 枚 ✗
最优做法(不贪心,跳过 9):
6 + 5 = 11。已用:[6, 5]
结果:2 枚 ✓
为什么贪心失败了? 贪心立即抓取最大的硬币(9),留下的余数(2)只能用 1 分硬币填满。它「看不出来」跳过 9 用 6+5 会更好。

现在对比用美国硬币 {1, 5, 10, 25} 凑 41 分:
剩余=41 → 选 25。剩余=16。已用:[25]
剩余=16 → 选 10。剩余=6。 已用:[25, 10]
剩余=6 → 选 5。 剩余=1。 已用:[25, 10, 5]
剩余=1 → 选 1。 剩余=0。 已用:[25, 10, 5, 1]
结果:4 枚 ✓(最优!)
美国硬币有效是因为每个面额至少是前一个的两倍——永远不需要「撤销」贪心选择。而 {1, 5, 6, 9} 中 5 和 6 太接近,会产生贪心选择阻碍更好组合的情况。
⚠️ 结论: 硬币找零是看起来可以用贪心但并非总是如此的经典例子。除非硬币面额有特殊结构(如美国硬币),否则得换用更通用的方法(如 DP,见第 6 部分)。有疑问时,试一个小反例!
💡 核心思路: 贪心在有「无悔」性质时奏效——一旦做出贪心选择,永远不需要撤销。如果总能用贪心选择替换任何非贪心选择而不使情况变差,贪心就是最优的。
贪心 vs DP 决策路径对比:

🔍 如何识别贪心问题
看到新题时,按以下清单检查:
📄 看到新题时,按以下清单检查:
1. 处理元素时有没有自然的「顺序」或「优先级」?
(如:按截止时间、结束时间、比率、大小排序……)
↓ 有
2. 能证明局部最优选择在全局上是安全的吗?
(交换论证:把贪心选择与任何其他选择互换,永远不会更好)
↓ 能
3. 能找到贪心失败的小反例吗?
↓ 找不到反例
→ 贪心很可能正确。实现并验证。
↓ 找到反例
→ 贪心失败。考虑 DP 或其他方法。
贪心可行的三个信号:
- ① 排序后,有明确的「按此顺序处理」规则
- ② 题目要求一遍扫描最大化/最小化计数或代价
- ③ 子问题独立——选择一个元素不影响剩余选择的「形状」
改用 DP 的三个信号:
- ① 选择之间有交互(选 A 会改变 B 的可用性)
- ② 需要考虑多个未来状态
- ③ 对你尝试的任何贪心规则都能找到反例
🧭 贪心证明与反例模板
在 USACO 中,写出贪心代码之前,建议先写 3 行「证据链」:
| 步骤 | 你要回答的问题 | 如果答不上来 |
|---|---|---|
| 1. 排序/选择规则 | 我为什么按这个量排序,或为什么每次选这个元素? | 说明贪心标准还不清楚 |
| 2. 安全性证明 | 任意最优解能否替换为我的选择,且答案不变差? | 需要交换论证或反例搜索 |
| 3. 失败场景 | 哪种小数据会让这个规则出错? | 若能构造,立刻改用 DP/搜索/堆 |
反例搜索技巧: 不要从大样例开始。先用 3–5 个元素构造极端情况:一个很大的早期收益、两个中等收益组合、一个边界相等的区间。大多数错误贪心都能在小数据里暴露。
候选贪心:每次选当前收益最大的元素
小反例模板:
- 选最大元素后,会不会阻止两个中等元素同时被选?
- 选结束最晚/开始最早的区间,会不会占掉大量空间?
- 选单价最高的资源,会不会让高产对象没有容量可用?
🏆 竞赛建议: 真正可靠的贪心题解通常同时具备「排序标准」「交换论证」「小反例排除」三件事。缺任何一个,都要谨慎。
USACO 贪心模式分类
理解一道题属于哪个模式通常是关键洞察(USACO 的贪心题很少让你「直接想出贪心」,而是考你识别出题面背后属于哪个已知模型):
| 模式 | 触发词/结构 | 排序依据 | 例子 |
|---|---|---|---|
| 活动选择 | 「最多不重叠区间」 | 右端点升序 | USACO Bronze 调度 |
| EDF 调度 | 「最小化最大延迟/截止时间」 | 截止时间升序 | Convention II(变体) |
| SJF / 完成时间 | 「最小化总等待/完成时间」 | 处理时间升序 | 奶牛排序(相邻交换) |
| 贪心 + 二分 | 「最小化最大值」或「最大化最小值」 | 二分答案 | USACO Convention、Haybales |
| 双指针匹配 | 两个有序数组,最大化匹配对数 | 两数组都排序 | Paired Up、分发饼干 |
| 扫描线/模拟 | 带时间戳的事件、容量约束 | 事件时间 | 奶牛信号、会议室 |
| 后悔贪心 | 「选 K 个元素且决策可取消」 | 最大堆 + 后悔节点 | USACO Gold 进阶题 |
| 自定义比较器 | 「按最优顺序排列 N 个元素」 | a+b vs b+a,w/t 比率 | 最大数,SJF |
⚠️ USACO 竞赛提示: Silver/Gold 级别的贪心题几乎总是需要正确性证明草稿——无论是交换论证还是二分搜索的单调性论证。若你无法用 2 句话草拟贪心的有效性,要更加谨慎。
4.1.2 交换论证法
交换论证是贪心算法的标准证明技术,回答「怎么证明贪心正确?」这个问题。几乎所有 USACO 的贪心正确性证明都用这个技术。
工作原理
证明模板分四步:
- 假设存在一个在某一步做出与我们的贪心算法不同选择的最优解 O。
- 找到 O 和贪心第一次不同的位置。
- 交换——把贪心的选择放入 O 在该位置的解中。证明结果至少同样好(代价不增,或数量不减)。
- 重复直到 O 完全变换成贪心解。由于每次交换维持或改善解,贪心解必然是最优的。
💡 核心思路: 不需要证明贪心是唯一最优的——只需证明没有交换可以改善它。即使多个解都达到相同最优,贪心也能找到其中一个。
📋 交换论证证明模板
给定: 贪心规则 G,最优解 O。
第一步——找差异: 设 i 是 O 和 G 第一个不同的下标。
第二步——交换: 构造 O',将位置 i 的 O 的选择替换为 G 的选择。
第三步——比较: 证明
cost(O') ≤ cost(O)(或count(O') ≥ count(O))。第四步——结论: 归纳地,反复交换把 O 变成 G 而不恶化解。因此 G 是最优的。
为什么「相邻交换」就够了
一个关键观察:若能证明交换任意两个顺序不对的相邻元素不会恶化解,那么通过标准的「冒泡排序」论证,可以将任意解重排为贪心顺序而不使情况变差。
这就是为什么交换论证几乎总是聚焦于只交换两个相邻元素——完整证明由归纳法得出。
具体示例:调度最小化加权和
题目: 有 N 个作业,作业 i 的处理时间为 t[i],权重为 w[i]。所有作业在一台机器上顺序运行。作业 i 的加权完成时间 = w[i] × (包含作业 i 在内的所有作业处理时间之和)。最小化总加权完成时间。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ t[i] ≤ 1000,1 ≤ w[i] ≤ 1000。总代价可达 10⁵ × 10⁶ × 10³ 量级,注意用 long long;O(N log N) 排序贪心是标准做法。
样例输入:
3
2 3
1 5
4 2
(格式:每行 t[i] w[i])
样例输出:
37
什么顺序最优? 用交换论证:
考虑两个相邻作业 A(处理时间 a,权重 w_A)和 B(处理时间 b,权重 w_B),设 S 是这两个作业之前所有作业的总处理时间:
| 顺序 | A 的加权代价 | B 的加权代价 | 这两个作业的总代价 |
|---|---|---|---|
| A → B | w_A × (S + a) | w_B × (S + a + b) | w_A·a + w_B·b + (w_A + w_B)·S + w_B·a |
| B → A | w_B × (S + b) | w_A × (S + b + a) | w_B·b + w_A·a + (w_A + w_B)·S + w_A·b |
A → B 更好当:w_B·a < w_A·b,即 w_A/t_A > w_B/t_B(权重/时间比更高的先做)。
贪心规则: 按 w[i]/t[i] 降序排序。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<pair<int,int>> jobs(n); // {t, w}
for (auto &[t, w] : jobs) cin >> t >> w;
// 按 w/t 比值降序排序(比值更高的先做)
sort(jobs.begin(), jobs.end(), [](const auto &a, const auto &b) {
// a.second/a.first > b.second/b.first → a.second * b.first > b.second * a.first
return (long long)a.second * b.first > (long long)b.second * a.first;
});
long long total = 0, curTime = 0;
for (auto [t, w] : jobs) {
curTime += t;
total += (long long)w * curTime;
}
cout << total << "\n";
return 0;
}
// 时间复杂度:O(N log N)
图示:贪心交换论证

上图说明了交换论证:若两个相邻元素相对于贪心标准「顺序不对」,交换它们会产生至少同样好的解。通过反复交换,可以把任何解变换成贪心解而不损失价值。
交换论证失败的情况
有时找不到有效的交换——这说明贪心不适用:
- 0/1 背包: 无法用一件物品的一部分替换另一件物品,所以交换不保持约束。
- 任意面额的硬币找零: 交换硬币选择实际上可能在其他位置强制使用更多硬币。
- 一般加权区间调度: 选择一个高利润的短作业可能阻塞两个中等利润但合计超过它的作业。
在所有这些情况下,交换论证失败,需要用 DP。
4.1.3 活动选择问题
题目: 给定 N 个活动,每个活动有开始时间 s[i] 和结束时间 f[i]。每次只能进行一个活动。若两个活动有重叠(一个在另一个结束前开始),则它们冲突。选择最多数量的不重叠活动。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ s[i] < f[i] ≤ 10⁹。一场活动一结束下一场就能立刻开始(s ≥ lastEnd 即可)。O(N²) DP 会超时,需要 O(N log N) 贪心。
样例输入:
6
1 3
2 5
3 9
6 8
5 7
8 11
样例输出:
3
(最优选择是活动 (1,3)、(6,8)、(8,11)——或等价地 (1,3)、(5,7)、(8,11))
为什么可以用贪心解决
直觉上:在所有从上一个选定活动之后开始的活动中,接下来该选哪个?结束最早的那个——它「占用」最少的未来时间,为后续活动留下最大空间。
任何其他选择(选结束更晚的活动)只会有害:它阻塞的未来活动至少与结束最早的选择一样多,甚至更多。
这就是贪心选择性质: 局部最优选择(选结束最早的相容活动)导致全局最优解。
图示:活动选择甘特图

甘特图在时间轴上展示所有活动。选中的活动(绿色)不重叠且数量最多,被拒绝的活动(灰色)因与已选活动重叠而跳过。贪心规则是:始终选结束时间最早且不冲突的活动。
贪心算法:
- 按结束时间排序活动
- 每次选择与已选活动相容且结束时间最早的活动

💡 为什么按结束时间排序? 选择结束最早的活动为后续活动留下最多时间。按开始时间排序可能选到开始很早但结束很晚的活动,占用大量时间。
// 活动选择 — O(N log N)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<pair<int,int>> activities(n); // {结束时间, 开始时间}
for (int i = 0; i < n; i++) {
int s, f;
cin >> s >> f;
activities[i] = {f, s}; // 按结束时间排序
}
sort(activities.begin(), activities.end()); // ← 关键:按结束时间排序
int count = 0;
int lastEnd = -1; // 最后一个选定活动的结束时间
for (auto [f, s] : activities) {
if (s >= lastEnd) { // 该活动在上一个结束后才开始
count++;
lastEnd = f; // 更新最后结束时间
}
}
cout << count << "\n";
return 0;
}
完整演示
活动: [(1,3), (2,5), (3,9), (6,8), (5,7), (8,11), (10,12)](格式:开始, 结束)
第一步——按结束时间排序:
活动: A B C D E F G
(s,e):(1,3) (2,5) (5,7) (6,8) (3,9) (8,11) (10,12)
排序后:A(1,3), B(2,5), C(5,7), D(6,8), E(3,9), F(8,11), G(10,12)
第二步——贪心选择(初始 lastEnd = -1):
活动 A (1,3): start=1 ≥ lastEnd=-1 ✓ 选中。lastEnd=3。count=1
活动 B (2,5): start=2 ≥ lastEnd=3?否(2 < 3)。跳过。
活动 C (5,7): start=5 ≥ lastEnd=3 ✓ 选中。lastEnd=7。count=2
活动 D (6,8): start=6 ≥ lastEnd=7?否(6 < 7)。跳过。
活动 E (3,9): start=3 ≥ lastEnd=7?否(3 < 7)。跳过。
活动 F (8,11):start=8 ≥ lastEnd=7 ✓ 选中。lastEnd=11。count=3
活动 G (10,12):start=10 ≥ lastEnd=11?否(10 < 11)。跳过。
结果:选中 3 个活动——A(1,3), C(5,7), F(8,11)
时间轴(A~G 表示活动):
时间: 0 1 2 3 4 5 6 7 8 9 10 11 12
| | | | | | | | | | | | |
A: [===] ✓ 选中
B: [======] ✗ 与 A 重叠
C: [======] ✓ 选中
D: [======] ✗ 与 C 重叠
E: [============] ✗ 与 A 和 C 重叠
F: [======] ✓ 选中
G: [======] ✗ 与 F 重叠
⚠️ 第 4.1 章常见错误
-
把贪心用在 DP 问题上: 贪心更简单不代表它正确。始终用小反例测试。任意面额的硬币找零是经典陷阱。
-
排序标准用错: 活动选择时按开始时间而非结束时间排序是经典 bug。为什么这样排序的论证(交换论证)才告诉你正确的标准。
-
重叠判断差一:
s >= lastEnd(允许相邻活动)vss > lastEnd(要求有间隔)。检查题目要求哪种。 -
不证明就假设贪心有效: 始终用小例子验证,或简短地交换论证一下。若找不到反例且能草拟贪心选择「安全」的理由,大概率是正确的。
-
忘记排序: 贪心算法几乎总是从排序开始。忘记排序意味着贪心「顺序」不存在。
-
比较器中整数溢出: 按比率
w/t排序时,避免浮点比较。用交叉乘法:w_A * t_B > w_B * t_A。乘法前始终强制转换为long long。 -
在错误的子问题上贪心: 有些问题看起来像「每次选最优元素」,但「最优」取决于未来上下文。若你在第 i 步的贪心选择改变了第 i+1 步的最优性,很可能需要 DP。
本章总结
📌 核心要点
| 题目类型 | 贪心策略 | 排序依据 | 时间 | 识别信号 |
|---|---|---|---|---|
| 最多不重叠区间 | 选结束最早的区间 | 右端点升序 | O(N log N) | 「最多活动/会议」 |
| 最少点刺穿所有区间 | 在每个未覆盖区间的右端放点 | 右端点升序 | O(N log N) | 「最少箭/传感器覆盖所有」 |
| 最少区间覆盖范围 | 每步选最远延伸的 | 左端点升序 | O(N log N) | 「最少线段覆盖 [L,R]」 |
| 区间合并 | 按左端点排序,扫描合并 | 左端点升序 | O(N log N) | 「合并重叠范围」 |
| 最小化最大延迟(EDF) | 最早截止日期优先 | 截止时间升序 | O(N log N) | 「最小化最大延迟」 |
| Huffman 编码 | 合并两个最小频率 | 最小堆 | O(N log N) | 「最小代价合并 N 堆」 |
| 最小化总完成时间(SJF) | 最短作业优先 | 处理时间升序 | O(N log N) | 「最小化加权完成时间总和」 |
| 最大数(拼接) | 比较器:a+b vs b+a | 自定义比较器 | O(N log N·L) | 「排列数字/字符串得最大数」 |
| 排列不等式 | 同向最大化,反向最小化 | 两数组都排序 | O(N log N) | 「最大/最小化两数组的点积」 |
| 双序列匹配 | 两数组排序后双指针匹配 | 两数组都排序 | O(N log N) | 「匹配 A[i] 和 B[j] 最大化满足对数」 |
| 删除 K 个数字(最小结果) | 单调栈——栈顶大于当前时弹出 | 不需要排序 | O(N) | 「删 K 个数字得最小数」 |
| 股票交易(无限次) | 累加每个正日差 | 不需要排序 | O(N) | 「无限买卖,最大利润」 |
| 后悔贪心 | 贪心选取 + 在堆中插入后悔节点 | 最大/最小堆 | O(N log N) | 「K 次操作,可隐式撤销」 |
| 多机调度(LPT) | 最长作业优先 + 最小堆分配 | 处理时间降序 | O(N log K) | 「N 个作业,K 台机器,最小完工时间」 |
| 对抗匹配(田忌赛马) | 最强打最强;否则最弱消耗最强 | 双端指针 | O(N log N) | 「双方各自最优分配,最大赢场数」 |
| 前缀/后缀双遍扫描 | 从两侧分别扫描,取最大合并 | 无/自定义 | O(N) | 「每个元素依赖左侧最小和右侧最大」 |
| 位运算贪心(字典树+逐位) | 在每层贪心选对立位 | 无 | O(N·MAXBIT) | 「数组中两个元素的最大异或值」 |
❓ 常见问题
Q1:怎么判断一个问题能不能用贪心解?
A:三个信号:① 排序后有清晰的处理顺序;② 可以用交换论证证明贪心选择永远不比其他选择差;③ 找不到反例。若找到了(如硬币找零 {1,5,6,9}),贪心失败——改用 DP。
Q2:贪心和 DP 的真正区别是什么?
A:贪心在每步做出局部最优选择且从不回头。DP 考虑所有可能的选择,从子问题解构建全局最优。贪心是 DP 的特例——当局部最优恰好等于全局最优时可以用贪心。
Q3:「二分答案 + 贪心检查」模式是什么?
A:当题目问「最小化最大值」或「最大化最小值」时,对答案 X 二分查找,用贪心的
check(X)验证可行性。参见第 4.4 章的真题 4:Convention。
Q4:活动选择为什么按结束时间而非开始时间排序?
A:按结束时间排序确保我们总是选择最早「释放资源」的活动,为后续活动留下最大空间。按开始时间排序可能选到开始很早但结束很晚的活动,阻挡后续所有活动。
Q5:什么时候用后悔贪心而不是普通贪心?
A:当:① 题目允许最多 K 次操作且 K 较小;② 每次操作可以用反向操作「撤销」;③ 普通贪心给出次优答案,因为早期选择阻碍了后来更好的选择。关键思路是在堆中插入
-x后悔节点,让你以 O(log N) 隐式撤销任何之前的选择。
练习题
| 题目 | 关键技术 | 难度 |
|---|---|---|
| 4.1.1 会议室 II | 活动选择变体 + 最小堆 | 🟡 中等 |
| 4.1.2 分数背包 | 交换论证(比率标准) | 🟢 简单 |
| 🏆 挑战题 | 区间刺穿(USACO Silver) | 🔴 困难 |
题目 4.1.1 — 会议室 II 🟡 中等
题目: N 场会议,各有开始时间 start[i] 和结束时间 end[i]。找最少需要多少间会议室使所有会议都能无重叠进行。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ start[i] < end[i] ≤ 10⁶。
输入:
3
0 30
5 10
15 20
输出: 2
💡 提示
最少会议室数 = 任意时刻最多重叠的会议数。用最小堆追踪结束时间(每间会议室何时空闲)。对每场新会议,检查最早空闲的会议室能否复用。
核心思路:
最少会议室数 = 任意时刻最多重叠的会议数。用最小堆追踪结束时间(每间会议室何时空闲)。对每场新会议,检查最早空闲的会议室能否复用。
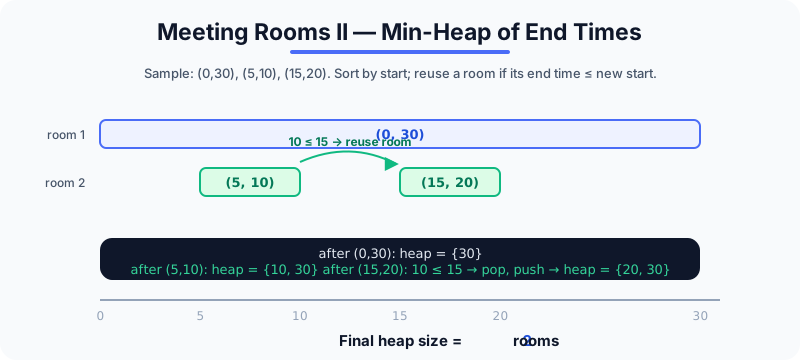
核心思路:
按开始时间排序会议,最小堆存储每间会议室的结束时间。对每场新会议:
- 若堆顶(最早结束的会议室)≤ 新会议开始时间 → 复用该会议室
- 否则 → 开新会议室
堆的最终大小就是答案。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<pair<int,int>> meetings(n);
for (int i = 0; i < n; i++)
cin >> meetings[i].first >> meetings[i].second;
sort(meetings.begin(), meetings.end()); // 按开始时间排序
// 最小堆:存储每间使用中会议室的结束时间
priority_queue<int, vector<int>, greater<int>> pq;
for (auto [start, end] : meetings) {
if (!pq.empty() && pq.top() <= start) {
// 复用最早空闲的会议室
pq.pop();
}
pq.push(end); // 该会议室被占用到 'end' 时刻
}
cout << pq.size() << "\n";
return 0;
}
// 时间复杂度:O(N log N)
题目 4.1.2 — 分数背包 🟢 简单
题目: N 件物品,物品 i 重量 w[i]、价值 v[i],背包容量 W。可以取任意分量(物品可分割)。最大化总价值。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ W ≤ 2×10⁹,1 ≤ w[i], v[i] ≤ 10⁹。
示例:
N=3, W=50
物品:(w=10, v=60), (w=20, v=100), (w=30, v=120)
输出:240.0
💡 提示
贪心有效是因为允许取分量。按价值/重量比(单位价值)降序排序,尽可能多地取比率最高的物品直到背包装满。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
double W;
cin >> n >> W;
vector<pair<double,double>> items(n); // {价值, 重量}
for (int i = 0; i < n; i++)
cin >> items[i].second >> items[i].first;
// 按单位价值(v/w)降序排序
sort(items.begin(), items.end(), [](const auto &a, const auto &b) {
return a.first / a.second > b.first / b.second;
});
double totalValue = 0.0;
double remaining = W;
for (auto [v, w] : items) {
if (remaining <= 0) break;
if (w <= remaining) {
totalValue += v;
remaining -= w;
} else {
totalValue += v * (remaining / w);
remaining = 0;
}
}
cout << fixed << setprecision(2) << totalValue << "\n";
return 0;
}
// 时间复杂度:O(N log N)
🏆 挑战题:USACO 2016 February Silver——区间刺穿
题目: FJ 有 N 段围栏,各定义为数轴上的 [L_i, R_i]。找最少的「锚点」数,使每段围栏都至少包含一个锚点(锚点在区间端点上也算包含)。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ L_i ≤ R_i ≤ 10⁹。
贪心策略: 按右端点升序排序。维护 lastPoint(最后一个锚点的位置,初始 −∞)。对每段:若 lastPoint 不在 [L_i, R_i] 内(即 lastPoint < L_i),在 R_i 放一个新锚点(尽量靠右以覆盖更多后续区间)。
样例输入:
5
1 4
3 6
7 9
2 5
8 10
样例输出:
2
(排序后 [1,4],[2,5],[3,6],[7,9],[8,10]:在 4 放锚点覆盖前 3 段,在 9 放锚点覆盖后 2 段)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<pair<int,int>> segs(n); // {右端点, 左端点}
for (int i = 0; i < n; i++) {
int l, r;
cin >> l >> r;
segs[i] = {r, l};
}
sort(segs.begin(), segs.end()); // 按右端点排序
int count = 0;
long long lastPoint = LLONG_MIN;
for (auto [r, l] : segs) {
if (lastPoint < l) {
// 当前锚点不覆盖该段——放新锚点
lastPoint = r; // 放在右端以覆盖尽量多的后续区间
count++;
}
}
cout << count << "\n";
return 0;
}
// 时间复杂度:O(N log N)
与活动选择的联系: 区间刺穿和最多不重叠区间是对偶问题:最少刺穿点数 = 最多不重叠区间数(区间调度的 König 定理)。两者都按右端点排序,代码结构几乎相同。
第 4.2 章:区间与调度
区间和调度是贪心最经典的两大战场——USACO Silver 的「排序 + 扫描」题大多落在这一类。本章用三个模型吃透它们:区间调度的三种变体、最早截止时间优先(EDF)、Huffman 合并。
📌 前置: 第 4.1 章的交换论证法和活动选择问题是本章的地基——这里每个策略的正确性都靠它证明。
4.2.1 区间调度:最大化 vs 最小化变体
本节涵盖三个相关的区间问题,看起来相似但需要微妙不同的贪心策略。
图示:数轴上的区间调度

最大化:最多不重叠区间
这正是第 4.1 章的活动选择问题。按结束时间排序,贪心选择如上所述。
最小化:「刺穿」所有区间所需最少点数
题目: 给定数轴上 N 个区间,找最少数量的「点」(每个点是一个实数),使每个区间至少包含一个点。仅共享端点的两个区间都被视为包含该端点。
数据规模: 1 ≤ N ≤ 10⁵,−10⁹ ≤ l[i] ≤ r[i] ≤ 10⁹。
样例输入:
6
1 4
2 3
3 5
6 8
7 9
9 10
(格式:第一行 N,随后每行 l[i] r[i],与上方 stabbing_points.svg 图中的 6 个区间一致)
样例输出:
3
(在 3、8、10 处放点即可覆盖全部区间;右端点排序后贪心放置的第一个点 3 落在 [1,4] 的右端)
贪心策略: 按右端点升序排序。维护 lastPoint(最后放置的点)。对每个区间:
- 若
lastPoint已在该区间内(lastPoint >= l[i]):该区间已被覆盖,跳过。 - 否则:在
r[i]放一个新点(尽量靠右,最大化对后续区间的覆盖),计数加一。
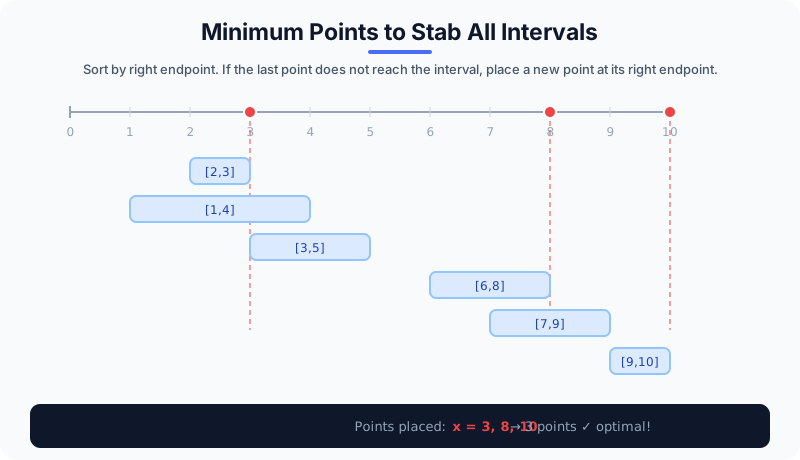
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<pair<int,int>> intervals(n); // {右端点, 左端点}
for (auto &[r, l] : intervals) cin >> l >> r;
sort(intervals.begin(), intervals.end()); // 按右端点排序
int points = 0;
long long lastPoint = LLONG_MIN;
for (auto [r, l] : intervals) {
if (lastPoint < l) { // 当前点不覆盖该区间
lastPoint = r; // 在右端放新点
points++;
}
}
cout << points << "\n";
return 0;
}
// 时间复杂度:O(N log N)
最小化:最少区间覆盖一段范围
题目: 给定 N 个区间和目标范围 [0, T],从集合中选最少数量的区间使其并集完全覆盖 [0, T]。不可能时输出「Impossible」。
数据规模: 1 ≤ T ≤ 10⁹,1 ≤ N ≤ 10⁵,−10⁹ ≤ l[i] ≤ r[i] ≤ 10⁹。
样例输入:
10 5
0 2
1 4
2 6
4 9
5 10
(格式:第一行 T 和 N,随后每行 l[i] r[i])
样例输出:
3
(选 [0,2]→[2,6]→[4,9] 延伸至 [5,10]:贪心依次推进 covered 0→6→10,3 个区间即可覆盖 [0,10])
反例样例(输出 Impossible):
10 3
0 2
1 4
2 6
(最多推进到 6 < 10,无法覆盖 [0,10])
贪心策略: 按左端点升序排序。维护 covered(当前已覆盖到的位置,初始为 0)。每步在所有满足 l[i] ≤ covered 的区间中(它们可以延伸覆盖),选右端点最大的(farthest)。将 covered 推进到 farthest,计数加一。
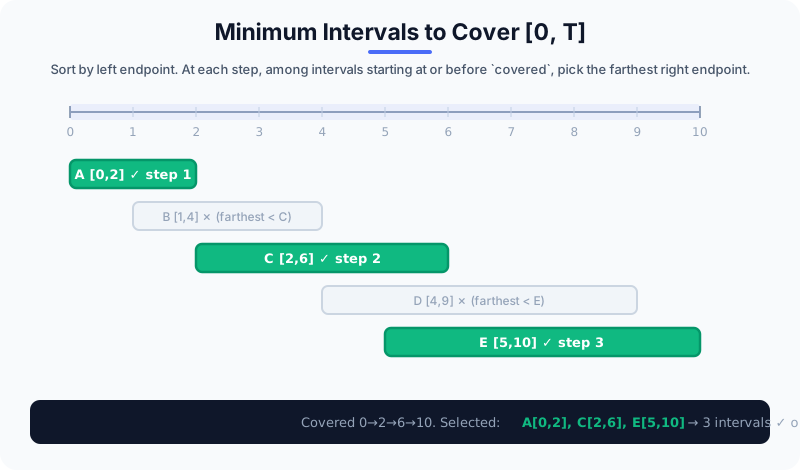
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int T, n;
cin >> T >> n;
vector<pair<int,int>> intervals(n);
for (auto &[l, r] : intervals) cin >> l >> r;
sort(intervals.begin(), intervals.end()); // 按左端点排序
int covered = 0; // 当前已覆盖到 'covered'
int count = 0;
int i = 0;
while (covered < T) {
int farthest = covered;
// 在左端点 <= covered 的所有区间中,找最远的右端点
while (i < n && intervals[i].first <= covered) {
farthest = max(farthest, intervals[i].second);
i++;
}
if (farthest == covered) {
// 没有区间能延伸覆盖——不可能
cout << "Impossible\n";
return 0;
}
covered = farthest;
count++;
}
cout << count << "\n";
return 0;
}
// 时间复杂度:O(N log N)
⚠️ 与刺穿的关键区别: 刺穿按右端点排序(尽量宽地覆盖当前区间);覆盖按左端点排序(从停下的地方尽量向右延伸覆盖)。
4.2.2 调度问题:最小化最大延迟(EDF)
题目: 一台机器,N 个作业。作业 i 有:
- 处理时间
t[i]——运行所需时长 - 截止时间
d[i]——理想上应完成的时间
机器按顺序运行作业(无重叠,无空闲)。作业 i 的延迟量是 max(0, 完成时间[i] − d[i])——超出截止时间的量(按时完成则为 0)。最小化所有作业中最大延迟量。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ t[i] ≤ 10⁹,1 ≤ d[i] ≤ 10⁹。完成时间之和可能超出 int,注意溢出。
样例输入:
4
3 6
2 8
1 4
4 9
样例输出:
1
解释: 按截止时间升序排序:job3(t=1,d=4), job1(t=3,d=6), job2(t=2,d=8), job4(t=4,d=9)。
作业 3:运行 [0,1], 完成于 1。延迟量 = max(0, 1-4) = 0
作业 1:运行 [1,4], 完成于 4。延迟量 = max(0, 4-6) = 0
作业 2:运行 [4,6], 完成于 6。延迟量 = max(0, 6-8) = 0
作业 4:运行 [6,10],完成于 10。延迟量 = max(0, 10-9) = 1
最大延迟量 = 1 ✓
贪心策略:最早截止日期优先(EDF)
规则: 按截止时间升序排列作业,按该顺序无间隙运行。
为什么 EDF 最优——交换论证:
设最优调度中两个相邻作业 A 和 B,d[A] > d[B](A 截止更晚但先运行)。设 S 是这两个作业之前所有作业的完成时间:
| 调度 | A 的延迟量 | B 的延迟量 |
|---|---|---|
| A → B | max(0, S + t[A] − d[A]) | max(0, S + t[A] + t[B] − d[B]) |
| B → A | max(0, S + t[B] − d[B]) | max(0, S + t[B] + t[A] − d[A]) |
由于 d[A] > d[B],B 更紧迫。A→B 顺序中:B 在 S + t[A] + t[B] 完成,与 B→A 顺序相同——但 B 的截止时间更早,可能延迟更多。交换到 B→A 永远不会增加最大延迟量。因此,任何非 EDF 调度都可以通过交换改善或维持,EDF 是最优的。

#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<pair<int,int>> jobs(n); // {截止时间, 处理时间}
for (int i = 0; i < n; i++) cin >> jobs[i].second >> jobs[i].first;
sort(jobs.begin(), jobs.end()); // 按截止时间排序
int time = 0;
int maxLateness = 0;
for (auto [deadline, proc] : jobs) {
time += proc; // 该作业的完成时间
int lateness = max(0, time - deadline); // 延迟多久?
maxLateness = max(maxLateness, lateness);
}
cout << maxLateness << "\n";
return 0;
}
4.2.3 Huffman 编码(贪心建树)
题目: 有 N 个符号,每个出现频率为 freq[i]。想为每个符号分配一个二进制码字(0 和 1 的字符串),使没有码字是另一个的前缀(前缀无关码)。总编码代价 = 所有符号的 freq[i] × depth[i] 之和,其中 depth[i] 是符号 i 码字的长度。最小化总代价。
数据规模: 2 ≤ N ≤ 10⁵,1 ≤ freq[i] ≤ 10⁹。总代价可达 10¹⁵ 以上,必须用 long long。
贪心规则: 始终合并频率最小的两个节点(用最小堆)。
样例输入:
5
5 7 10 15 20
(格式:第一行 N,第二行 N 个频率——与下方 huffman.svg 图中的 5 个符号一致)
样例输出:
126
(依次合并:5+7=12(代价 12),10+12=22(代价 22),15+20=35(代价 35),22+35=57(代价 57);总代价 12+22+35+57=126)
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
priority_queue<long long, vector<long long>, greater<long long>> pq; // 最小堆
for (int i = 0; i < n; i++) {
long long f; cin >> f;
pq.push(f);
}
long long totalCost = 0;
while (pq.size() > 1) {
long long a = pq.top(); pq.pop();
long long b = pq.top(); pq.pop();
totalCost += a + b; // 合并 a 和 b 的代价
pq.push(a + b); // 合并后的组频率为 a+b
}
cout << totalCost << "\n";
return 0;
}
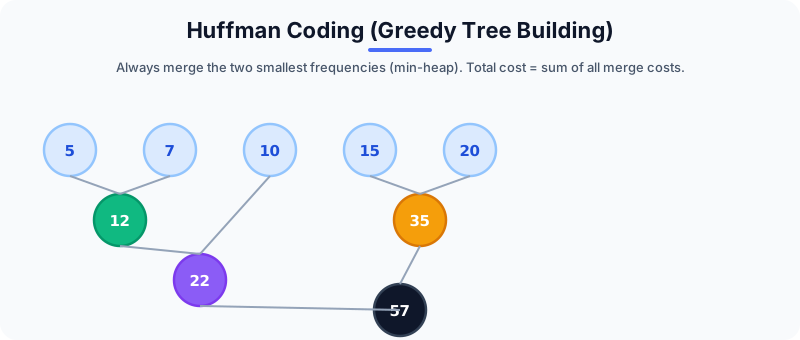
为什么总是合并最小的两个? 频率最低的两个符号应该在树中最深(码字最长),因为罕见符号的长码字对总代价的贡献较小。通过总是合并当前最小的两个,确保使用最频繁的符号保留在根附近。
USACO 中的实际应用: Huffman 算法出现在「最小代价合并 N 堆」问题中。每次需要合并两堆,支付合并后大小之和,答案就是所有合并操作的总和——由 Huffman 贪心算法计算。
4.2.4 二分答案 + 贪心检查——「最小化最大值」的标准解法
USACO Silver 出现频率最高的组合技:题面问「最小化最大值」或「最大化最小值」(最长等待最短多少?每段至少多大?),直接构造最优方案很难,但验证一个给定答案很简单——那就把「求解」换成「判定」,让二分搜索去找答案。
为什么可行(单调性论证——必写): 若最大等待 ≤ T 可行,则 ≤ T+1 也可行(限制更宽松只会更容易满足)。「可行性」随 T 单调变化,所以能在 T 的值域上二分。
模板:
// 对答案 X 二分;check(X) 用贪心 O(N) 验证
long long lo = 0, hi = 最大可能答案;
while (lo < hi) {
long long mid = lo + (hi - lo) / 2;
if (check(mid)) hi = mid; // mid 可行 → 答案 ≤ mid
else lo = mid + 1; // mid 不可行 → 答案 > mid
}
// lo 即最小可行答案
check() 怎么写(贪心): 按天然顺序扫描(通常先排序),每一步做「局部最紧」的选择——只要能塞就塞、只要不超就攒。注意 check 只需要判断可行性,不需要真的最优。
📌 完整真题演示: 第 4.4 章真题 4:Convention——「N 头奶牛、M 辆容量 C 的班车,最小化最长等待」就是用这个模式解决的:
check(T)按到达时间排序后贪心装车。此外第 3 章的二分答案有更多不带贪心的纯二分变体。
识别信号: 题面出现「最小化最大的……」「最大化最小的……」,且给定一个候选答案后能 O(N)/O(N log N) 验证 → 二分答案 + 贪心检查。
练习题
| 题目 | 关键技术 | 难度 |
|---|---|---|
| 4.2.1 最少站台数 | 事件扫描 | 🟡 中等 |
| 4.2.2 加油站 | 环形贪心 + 前缀和 | 🔴 困难 |
题目 4.2.1 — 最少站台数 🟡 中等
题目: N 辆火车,各有到达时间 arr[i] 和离开时间 dep[i]。若火车到达时所有站台都被占用,它必须等待。找最少需要多少个站台使没有火车需要等待。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ arr[i] < dep[i] ≤ 10⁶。
示例:
arr = [9:00, 9:40, 9:50, 11:00, 15:00, 18:00]
dep = [9:10, 12:00, 11:20, 11:30, 19:00, 20:00]
输出:3
💡 提示
双指针/事件扫描:将所有到达(+1)和出发(-1)事件合并为一个排序列表,扫描时维护当前站台数。峰值就是答案。注意:相同时间时,出发事件先于到达事件处理(离开的火车先让出站台再占用)。
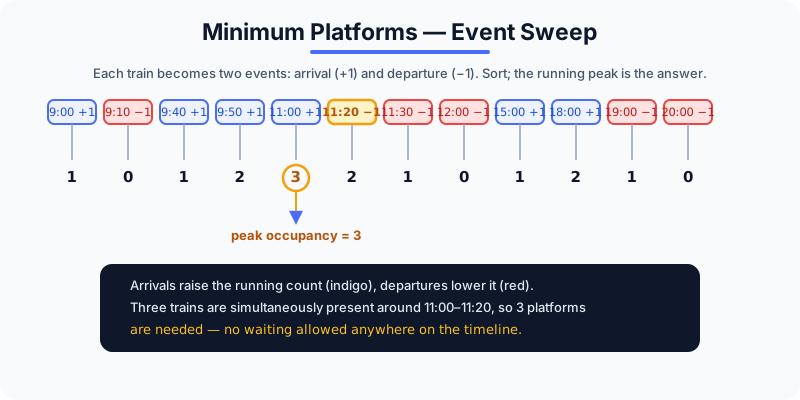
方法一:事件扫描(推荐)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<pair<int,int>> events; // {时间, 类型}:类型=0 出发,类型=1 到达
for (int i = 0; i < n; i++) {
int a, d;
cin >> a >> d;
events.push_back({a, 1}); // 到达
events.push_back({d, 0}); // 出发(类型=0 < 1,相同时间出发先处理)
}
sort(events.begin(), events.end());
int platforms = 0, maxPlatforms = 0;
for (auto [time, type] : events) {
if (type == 1) platforms++; // 火车到达
else platforms--; // 火车出发
maxPlatforms = max(maxPlatforms, platforms);
}
cout << maxPlatforms << "\n";
return 0;
}
方法二:双指针(经典)
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<int> arr(n), dep(n);
for (int &x : arr) cin >> x;
for (int &x : dep) cin >> x;
sort(arr.begin(), arr.end());
sort(dep.begin(), dep.end());
int platforms = 1, maxPlatforms = 1;
int i = 1, j = 0;
while (i < n && j < n) {
if (arr[i] <= dep[j]) {
platforms++;
i++;
} else {
platforms--;
j++;
}
maxPlatforms = max(maxPlatforms, platforms);
}
cout << maxPlatforms << "\n";
return 0;
}
// 时间复杂度:O(N log N)
题目 4.2.2 — 加油站 🔴 困难
题目: N 个加油站排成圆圈。加油站 i 有 gas[i] 升油;从 i 到 i+1 消耗 cost[i] 升。油箱初始为空、容量无限。能否完成整圈?如果能,输出起始站下标(答案唯一);否则输出 −1。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ gas[i], cost[i] ≤ 10⁴。O(N) 单次扫描是期望做法。
示例:
gas = [1, 2, 3, 4, 5]
cost = [3, 4, 5, 1, 2]
输出:3(从第 3 站出发可以完成整圈)
💡 提示
核心思路:若总油量 ≥ 总耗油量,则恰好存在一个有效起始站。贪心扫描:每当累计油箱降至零以下,将起始站重置为下一站。
两个关键定理:
- 可行性: 若
sum(gas) < sum(cost),无解。 - 唯一起始站定理: 若有解,每当从站 s 出发的运行油箱变为负数,s 到故障点之间的任何站都不是有效起始点。因此下一个候选站必须紧接在故障点之后。
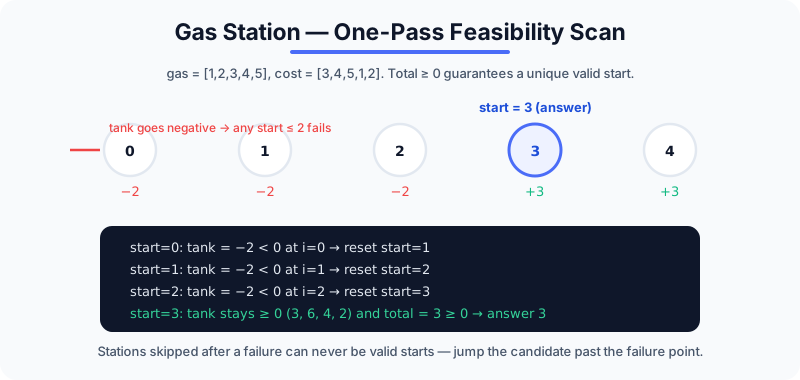
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> gas(n), cost(n);
for (int &x : gas) cin >> x;
for (int &x : cost) cin >> x;
int totalTank = 0; // 总净油量(决定可行性)
int tank = 0; // 从 'start' 出发的当前油量
int start = 0; // 当前候选起始站
for (int i = 0; i < n; i++) {
int gain = gas[i] - cost[i];
tank += gain;
totalTank += gain;
if (tank < 0) {
// 从 'start' 无法到达 i+1 — 重置
start = i + 1;
tank = 0;
}
}
if (totalTank < 0) {
cout << -1 << "\n"; // 无解
} else {
cout << start << "\n";
}
return 0;
}
// 时间复杂度:O(N)——单次扫描
第 4.3 章:排序、匹配与构造
这一章的贪心都有一个共同形态:给元素找到一个「正确的顺序」——自定义比较器、双序列同向配对、或一遍扫描构造答案。USACO 里「按某种顺序排列 N 个东西」的题几乎都在这里。
📌 前置: 第 4.1 章的交换论证法(证明「正确顺序」为什么正确)。
4.3.1 排列贪心:自定义排序标准
经典题一:最小化总完成时间(最短作业优先)
题目: N 个作业在一台机器上顺序运行,作业 i 的处理时间为 t[i]。作业的完成时间 = 之前所有作业与自身的处理时间之和。最小化所有作业完成时间之和。(1 ≤ N ≤ 10⁵,1 ≤ t[i] ≤ 10⁴;总和用 long long。)
样例输入:
5
3 1 4 1 5
样例输出:
31
(升序排序后为 1,1,3,4,5,完成时间为 1,2,5,9,14,总和 31)
贪心策略: 按处理时间升序排序(最短作业优先,SJF)。
为什么 SJF 最优?(交换论证)
设最优顺序中两个相邻作业 A(处理时间 a)和 B(处理时间 b),a > b(B 更短但排在 A 后面)。设 T 是这两个作业之前的累计完成时间:
| 顺序 | A 的完成时间 | B 的完成时间 | 两者之和 |
|---|---|---|---|
| A → B | T + a | T + a + b | 2T + 2a + b |
| B → A | T + b | T + b + a | 2T + a + 2b |
由于 a > b,2T + 2a + b > 2T + a + 2b,所以 B→A 给出更小的和。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> t(n);
for (int &x : t) cin >> x;
sort(t.begin(), t.end()); // SJF:按处理时间升序
long long totalCompletion = 0;
long long curTime = 0;
for (int i = 0; i < n; i++) {
curTime += t[i];
totalCompletion += curTime;
}
cout << totalCompletion << "\n";
return 0;
}
// 时间复杂度:O(N log N)

经典题二:最大数(拼接贪心)
题目: 给定 N 个非负整数,将它们排列后拼接成最大的数。输出为字符串。
样例输入:
5
3 30 34 5 9
样例输出:
9534330
(排序比较规则:a+b > b+a。注意 3 应排在 30 前面,因为 "330" > "303")
数据规模: 1 ≤ N ≤ 10⁵;每个数 ≤ 10⁹(作为字符串读入更方便);结果可能非常长(上百万位),必须按字符串处理。
贪心策略: 自定义比较器:对两个数 a 和 b(作为字符串),若 str(a) + str(b) > str(b) + str(a) 则 a 排在 b 前面。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<string> nums(n);
for (string &s : nums) cin >> s;
// 自定义排序:a+b > b+a 时 a 排在前面
sort(nums.begin(), nums.end(), [](const string &a, const string &b) {
return a + b > b + a;
});
// 边界情况:全为零
if (nums[0] == "0") {
cout << "0\n";
return 0;
}
string result = "";
for (const string &s : nums) result += s;
cout << result << "\n";
return 0;
}
// 时间复杂度:O(N log N · L),L = 最大数字位数
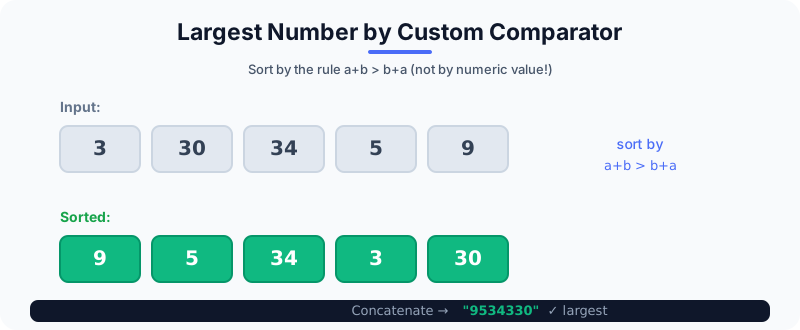
逐步追踪(nums = ["3", "30", "34", "5", "9"]):
比较部分对:
"3"+"30"="330" vs "30"+"3"="303" → "3" 排前面
"9"+"5"="95" vs "5"+"9"="59" → "9" 排前面
"34"+"3"="343" vs "3"+"34"="334" → "34" 排前面
排序后:["9", "5", "34", "3", "30"]
结果: "9534330" ✓
⚠️ 警告: 不能简单地按数值大小排序!例如 "3" > "30" 按数值,但拼接 "330" > "303",所以 "3" 应排前面。始终用拼接比较器。
经典题三:最大化(或最小化)内积
题目: 给定两个长度均为 N 的数组 A 和 B,各自可以任意重排,求 ∑ A[i] × B[i] 的最大值和最小值。(1 ≤ N ≤ 10⁵,1 ≤ A[i], B[i] ≤ 10⁹;乘积之和超出 int 范围,用 long long。)
贪心规则:
- 最大化
∑ A[i] × B[i]:A 和 B 都按升序排序(同方向配对) - 最小化
∑ A[i] × B[i]:A 按升序,B 按降序排序(反方向配对)
这是排列不等式:大配大、小配小最大化;大配小、小配大最小化。
示例: A = [1, 2, 3],B = [4, 5, 6](与下方 rearrangement_inequality.svg 图中数据一致)。 同序配对(升序×升序):1×4 + 2×5 + 3×6 = 32(最大值);反序配对(升序×降序):1×6 + 2×5 + 3×4 = 28(最小值)。
// 最大化 sum(A[i] * B[i])
sort(A.begin(), A.end());
sort(B.begin(), B.end());
long long maxSum = 0;
for (int i = 0; i < n; i++) maxSum += (long long)A[i] * B[i];
// 最小化 sum(A[i] * B[i])
sort(A.begin(), A.end());
sort(B.begin(), B.end(), greater<int>());
long long minSum = 0;
for (int i = 0; i < n; i++) minSum += (long long)A[i] * B[i];
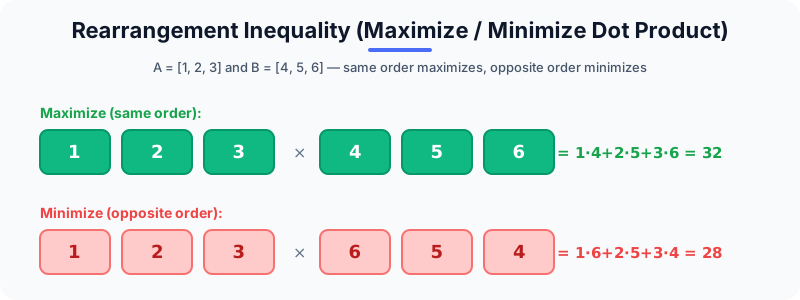
经典题四(USACO Bronze):最小代价排序(相邻交换)
题目: N(1 ≤ N ≤ 10⁵)头奶牛站成一排,奶牛 i 的「暴躁值」为 g[i](1 ≤ g[i] ≤ 10⁹,两两互不相同)。想排序这一排使暴躁值严格递增。唯一允许的操作是交换两头相邻的奶牛。交换第 i 和 j 位置的奶牛(相邻)时,代价为 g[i] + g[j]。求排序所需的最小总代价。答案可能超过 int 范围,用 64 位整数。
输入格式: 第一行 N;第二行 N 个整数 g₁, …, g_N。 数据规模: 1 ≤ N ≤ 10⁵,1 ≤ g[i] ≤ 10⁹。下方 O(N²) 逆序对暴力用于理解;正式提交需改为归并排序数逆序对(O(N log N))。
样例输入:
3
3 1 2
样例输出:
9
逆序对方案(O(N²)):
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<long long> g(n);
for (long long &x : g) cin >> x;
// 总代价 = 每对逆序对 (i,j)(i<j,g[i]>g[j])的 g[i]+g[j] 之和
long long totalCost = 0;
for (int i = 0; i < n; i++) {
for (int j = i + 1; j < n; j++) {
if (g[i] > g[j]) {
totalCost += g[i] + g[j]; // 这个逆序对的代价
}
}
}
cout << totalCost << "\n";
return 0;
}
// 时间:O(N²) — N ≤ 10^5 时用归并排序逆序对计数(O(N log N))
验证: 对 [3,1,2] 的冒泡排序:
- 交换(3,1) = 代价 4 → [1,3,2]
- 交换(3,2) = 代价 5 → [1,2,3]
- 总计 = 9 ✓
4.3.2 任务分配:双序列匹配
任务分配问题涉及将两个有序序列的元素匹配以优化某个目标。关键模式:对两个序列排序,然后用双指针扫描或直接下标配对。
最大化完成任务数(双指针)
题目: N 个工人各有能力值 ability[i],N 个任务各有难度 difficulty[i]。能力值 ≥ 难度的工人才算完成该任务,每个工人至多做一项任务。最大化完成的任务数。(1 ≤ N ≤ 2×10⁵,1 ≤ ability[i], difficulty[i] ≤ 10⁹。)
样例输入:
3
2 5 3
4 3 6
(格式:第一行 N,第二行能力值,第三行任务难度)
样例输出:
2
(排序后 ability=[2,3,5]、difficulty=[3,4,6]:能力 3 的工人完成任务 3,能力 5 的工人完成任务 4;能力 2 的工人做不了任何任务)
贪心: 对两个序列排序,用双指针贪心匹配。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> ability(n), difficulty(n);
for (int &x : ability) cin >> x;
for (int &x : difficulty) cin >> x;
sort(ability.begin(), ability.end());
sort(difficulty.begin(), difficulty.end());
// 双指针:贪心地把最弱的有能力工人分配给每个任务
int completed = 0;
int i = 0, j = 0; // i:工人指针,j:任务指针
while (i < n && j < n) {
if (ability[i] >= difficulty[j]) {
// 工人 i 能完成任务 j——匹配
completed++;
i++;
j++;
} else {
// 工人 i 太弱——尝试更强的工人
i++;
}
}
cout << completed << "\n";
return 0;
}
// 时间复杂度:O(N log N)
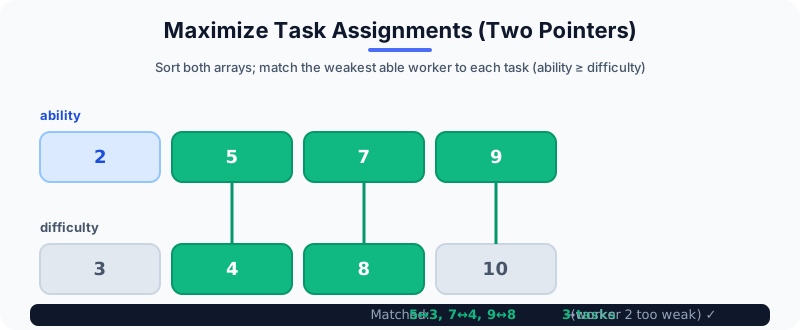
经典题(USACO Silver):配对——排列不等式实战
题目: 你有 A 组 N 头奶牛和 B 组 N 头奶牛(1 ≤ N ≤ 10⁵)。必须将 A 中每头奶牛与 B 中恰好一头配对(一对一)。奶牛 a 与奶牛 b 配对的利润是 min(a, b),其中 1 ≤ a, b ≤ 10⁹。最大化 N 对的总利润。总利润可能超过 int 范围。
输入格式: 第一行 N;第二行 A 组的 N 个整数;第三行 B 组的 N 个整数。 数据规模: 1 ≤ N ≤ 10⁵,1 ≤ a[i], b[i] ≤ 10⁹。排序 O(N log N) 轻松通过。
样例输入:
3
1 3 5
2 4 6
样例输出:
9
追踪(两数组升序排序后按下标配对):
A 排序后:[1, 3, 5]
B 排序后:[2, 4, 6]
配对 (1,2):min=1
配对 (3,4):min=3
配对 (5,6):min=5
总计 = 1+3+5 = 9 ✓
为什么同向排序? 交换论证:若某个配对中 a₁ < a₂ 与 b₁ > b₂ 配对(A 升序但 B 不是),交换到同向配对总是不差的(见 4.3.1 节排列不等式)。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<int> A(n), B(n);
for (int &x : A) cin >> x;
for (int &x : B) cin >> x;
sort(A.begin(), A.end());
sort(B.begin(), B.end());
long long total = 0;
for (int i = 0; i < n; i++) {
total += min(A[i], B[i]); // 第 i 小的与第 i 小的配对
}
cout << total << "\n";
return 0;
}
贪心模拟(USACO Bronze):奶牛信号
许多 USACO Bronze 题是带贪心技巧的纯模拟:按时间顺序处理事件,在每步贪心维护最优状态。关键是确定模拟什么以及按什么顺序。
题目: N(1 ≤ N ≤ 10⁵)头奶牛各想从牛棚出发到达牧场。奶牛 i 准备在时间 t[i](0 ≤ t[i] ≤ 10⁹)离开。牛棚和牧场之间的路同时最多容纳 C(1 ≤ C ≤ N)头奶牛,过路恰好需要 1 个时间单位。路满时奶牛在牛棚等待。假设尽早送奶牛出发,最后一头奶牛何时到达?
输入格式: 第一行 N 和 C;第二行 N 个整数 t₁, …, t_N。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, c;
cin >> n >> c;
vector<int> t(n);
for (int &x : t) cin >> x;
sort(t.begin(), t.end()); // 按出发时间顺序处理
int ans = 0;
// 每 c 头奶牛一组处理
for (int i = 0; i < n; i += c) {
// 这批奶牛中最早的是 t[i]
ans = max(ans, t[i]); // 这批出发时间至少要等最早的奶牛准备好
ans++; // 过路需要 1 个时间单位
}
cout << ans << "\n";
return 0;
}
4.3.3 区间合并
区间合并是另一种经典贪心:将所有重叠区间合并为一组不重叠的区间。
题目: 给定 N 个区间 [l[i], r[i]],把相互重叠(或共享端点)的区间合并,输出合并后的区间列表。(1 ≤ N ≤ 10⁵,−10⁹ ≤ l[i] ≤ r[i] ≤ 10⁹。)
样例输入:
5
0 2
1 4
2 6
4 9
5 10
样例输出:
1 个合并区间:
[0,10]
(5 个区间首尾相连,全部重叠,合并为一个 [0,10])
样例输入二:
4
1 3
2 6
8 10
15 18
样例输出二:
3 个合并区间:
[1,6] [8,10] [15,18]
([1,3] 与 [2,6] 重叠合并;[8,10] 与 [15,18] 与前后均不相连)
贪心算法:
- 按左端点升序排序区间
- 维护当前合并区间 [curL, curR]
- 对每个新区间 [l, r]:
- 若 l ≤ curR(重叠或相邻):延伸 curR = max(curR, r)
- 否则:完成当前合并区间,开始新的

#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<pair<int,int>> intervals(n);
for (auto &[l, r] : intervals) cin >> l >> r;
sort(intervals.begin(), intervals.end()); // 按左端点排序
vector<pair<int,int>> merged;
for (auto [l, r] : intervals) {
if (merged.empty() || l > merged.back().second) {
// 无重叠——开始新的合并区间
merged.push_back({l, r});
} else {
// 重叠——延伸右端点
merged.back().second = max(merged.back().second, r);
}
}
cout << merged.size() << " 个合并区间:\n";
for (auto [l, r] : merged) {
cout << "[" << l << "," << r << "] ";
}
cout << "\n";
return 0;
}
// 时间复杂度:O(N log N)
逐步追踪(输入已排序:[1,3],[2,6],[8,10],[15,18]):
[1,3]: merged 为空 → 直接加入。merged=[[1,3]]
[2,6]: 2 <= 3(重叠)→ 延伸:[1, max(3,6)]=[1,6]。merged=[[1,6]]
[8,10]: 8 > 6(不重叠)→ 加新区间。merged=[[1,6],[8,10]]
[15,18]: 15 > 10(不重叠)→ 加新区间。merged=[[1,6],[8,10],[15,18]]
输出:[[1,6],[8,10],[15,18]] ✓
4.3.4 字典序构造贪心
「构造字典序最小/最大的序列」是一大类贪心题的统称。核心思路一致:序列前面的位置影响最大,所以贪心地让越靠前的位置越优——每一步在「合法的候选」里选使前缀最优的那个,用一个可增删的候选集合维护后面的选择空间。
本节的三个经典题全是这个模式的不同外衣:删数字 = 每步保留让前缀最小的数字;跳跃/股票 = 从左到右每步取局部最优。
经典题:删除 K 个数字得到最小数(字典序最小构造)
题目: 给定一串数字(表示一个大整数),恰好删除 K 个数字(保持剩余数字的原始顺序)以形成最小的整数。
数据规模: 数字串长度 L ≤ 10⁶,1 ≤ K < L;结果可能带前导零,需去除。O(N) 单调栈是唯一可行做法。
例子:
"1432219",K=3 → "1219"
贪心思路: 维护单调栈。从左到右扫描:
- 若栈顶 > 当前数字且还有删除机会:弹出栈顶(删除较大的数字)
- 否则:压入当前数字
- 扫描完后若还有删除机会:从栈的右端删除

#include <bits/stdc++.h>
using namespace std;
int main() {
string num;
int k;
cin >> num >> k;
string stk = ""; // 用字符串作单调栈
for (char c : num) {
// 当栈顶大于当前数字且还有删除机会时弹出
while (k > 0 && !stk.empty() && stk.back() > c) {
stk.pop_back();
k--;
}
stk.push_back(c);
}
// 若还有删除机会,从右端删除
stk.resize(stk.size() - k);
// 移除前导零
int start = 0;
while (start < (int)stk.size() - 1 && stk[start] == '0') start++;
cout << stk.substr(start) << "\n";
return 0;
}
// 时间复杂度:O(N)
经典题:最少跳跃次数
题目: 给定数组 A[0..n-1],A[i] 是从位置 i 可以跳跃的最大步数(可以跳 0 到 A[i] 步)。从索引 0 出发,用最少次数到达最后一个索引。
样例输入:
5
2 3 1 1 4
样例输出:
2
(0→1→4:第一跳最多到 1,第二跳从 1 最多到 4,到达末尾)
数据规模: 1 ≤ N ≤ 10⁵(更大数据也可,O(N) 扫描),0 ≤ A[i] ≤ 10⁵;保证总能到达最后一个索引。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<int> A(n);
for (int &x : A) cin >> x;
int jumps = 0;
int curEnd = 0; // 当前跳跃能到达的最远位置
int farthest = 0; // 目前可到达的最远位置
for (int i = 0; i < n - 1; i++) {
farthest = max(farthest, i + A[i]); // 更新最远可达
if (i == curEnd) { // 到达当前跳跃范围的末尾
jumps++;
curEnd = farthest; // 跳到最远位置
if (curEnd >= n - 1) break; // 已经可以到达末尾
}
}
cout << jumps << "\n";
return 0;
}
// 时间复杂度:O(N)
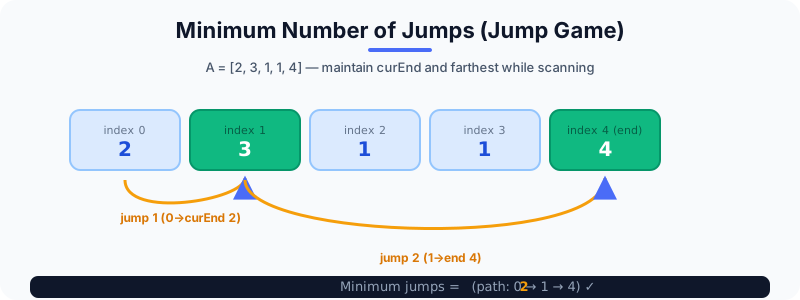
经典题:买卖股票最大利润(贪心版)
题目: 给定每日股价,可以无限次买卖(但每次只能持有一股),最大化总利润。
样例输入:
6
7 1 5 3 6 4
样例输出:
7
(捕获所有上涨段:(5−1) + (6−3) = 4 + 3 = 7)
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ price[i] ≤ 10⁹。N = 10⁵ 时逐日 O(N) 贪心即可,无需更复杂方法。
贪心思路: 只要明天价格高于今天,就「今天买明天卖」。等价于累加所有正日差。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<int> prices(n);
for (int &x : prices) cin >> x;
int profit = 0;
for (int i = 1; i < n; i++) {
if (prices[i] > prices[i - 1]) {
profit += prices[i] - prices[i - 1]; // 捕获每次上涨
}
}
cout << profit << "\n";
return 0;
}
// 时间复杂度:O(N)
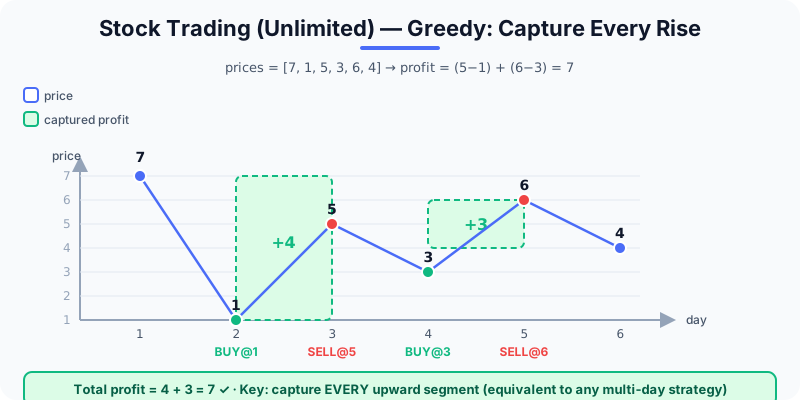
⚠️ 注意: 这是「无限次交易」版本。「最多一次交易」→ 追踪最低买入价的单次扫描。「最多两次/K 次交易」→ 需要 DP。
4.3.5 中位数贪心——「均分」与「聚集」
有一类题问的是:让若干个量「尽量靠近」——把牌均分、把仓库建在哪、人往哪里聚。它们的答案几乎总是中位数。为什么不是平均数?看这个直觉:
到定点 x 的距离之和
Σ|a[i] − x|:x 往右挪 1,左边的每个点距离 +1、右边的每个 −1。挪到左右点数相等(中位数)时就再也不动了——这就是最优解。平均数会被极端值拉偏:仓库选址题里一个超远客户会把平均数拖过去,而中位数岿然不动。
经典题一:一维仓库选址
N 个客户在数轴上(坐标可重复),建一个仓库使到所有客户的距离之和最小。
样例输入:
5
1 2 3 4 100
样例输出:
101
(中位数是 3,距离和 = 2+1+0+1+97 = 101。若选平均数 22,距离和 = 21+20+19+18+78 = 156,差得多。)
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<long long> x(n);
for (auto& v : x) cin >> v;
sort(x.begin(), x.end());
long long med = x[n / 2]; // 中位数
long long ans = 0;
for (auto v : x) ans += llabs(v - med);
cout << ans << "\n";
}
经典题二:均分纸牌(前缀和 + 中位数)
N 堆纸牌(第 i 堆 a[i] 张),总数保证能被 N 整除。每次只能把一张牌从一堆移到相邻的一堆。求让所有堆相等的最少移动次数。
样例输入:
4
9 8 17 6
样例输出:
8
转化(关键一步): 设平均值 avg。令 S[i] = (a[1]−avg) + … + (a[i]−avg)——「前 i 堆净多出的牌数」。第 i 堆与第 i+1 堆之间的移动量至少是 |S[i]|(前 i 堆多余的牌必须穿过这条边界流向右边,不足则从右边流入)。总移动次数 = Σ|S[i]|——又变成了「仓库选址」!让所有 S[i] 靠近某个值 t,最优 t 就是 S[1..N−1] 的中位数。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<long long> a(n);
for (auto& x : a) cin >> x;
long long total = 0;
for (long long x : a) total += x;
long long avg = total / n; // 题目保证整除
vector<long long> S(n + 1, 0);
for (int i = 1; i <= n; i++) S[i] = S[i-1] + a[i-1] - avg;
sort(S.begin(), S.end());
long long med = S[n / 2];
long long ans = 0;
for (int i = 0; i <= n; i++) ans += llabs(S[i] - med);
cout << ans << "\n";
}
(样例:avg=10,S = [0, −1, −2, 5, −1],中位数 −1,Σ|S[i]−(−1)| = 1+0+1+6+0 = 8。)
💡 环形版本(进阶): 若堆围成一圈,「断开位置」有 N 种选法——对每个断点算一次上述答案,取最小。经典优化是把断点的贡献排序后一次扫描求出,总复杂度 O(N log N)。这题在 USACO 风格的「Circular Barn」系列中反复出现。
中位数贪心的识别信号: 题目要「最小化 |距离/差| 的总和」或「均分」,且每个量的移动/调整是独立的——找中位数,不是平均数。
练习题
| 题目 | 关键技术 | 难度 |
|---|---|---|
| 4.3.1 统计干草堆(USACO Bronze) | 排序 + 二分统计 | 🟢 简单 |
| 4.3.2 睡觉奶牛排序(USACO Bronze) | 有序后缀观察 | 🟢 简单 |
| 4.3.3 任务调度器 | 频率公式贪心 | 🟡 中等 |
题目 4.3.1 — USACO 2016 December Bronze:统计干草堆
题目: N 捆干草放在数轴上(位置可重复)。Q 次查询:范围 [L, R] 内有多少捆干草?
输入格式: 第一行 N 和 Q;第二行 N 个整数位置;接下来 Q 行每行两个整数 L 和 R。 数据规模: 1 ≤ N, Q ≤ 10⁵,0 ≤ 位置 ≤ 10⁹,0 ≤ L ≤ R ≤ 10⁹。每次查询 O(log N) 的二分才能通过;O(N) 扫描每次查询会超时。
示例:
N=7, Q=4
位置:6 3 2 7 5 1 4
查询:2 5 / 1 1 / 4 8 / 10 15
输出:
4
1
4
0
💡 提示
排序位置,然后用 lower_bound / upper_bound 二分搜索统计 [L, R] 内的元素。这道题练习「排序 + 二分搜索」思维——大多数贪心算法的第一步。
排序后,[L, R] 内的数量 = upper_bound(R) - lower_bound(L)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
vector<int> pos(n);
for (int &x : pos) cin >> x;
sort(pos.begin(), pos.end()); // 关键:先排序以支持二分搜索
while (q--) {
int l, r;
cin >> l >> r;
auto lo = lower_bound(pos.begin(), pos.end(), l);
auto hi = upper_bound(pos.begin(), pos.end(), r);
cout << (hi - lo) << "\n";
}
return 0;
}
// 时间复杂度:O(N log N + Q log N)
题目 4.3.2 — USACO 2019 February Bronze:睡觉奶牛排序
题目: N(1 ≤ N ≤ 10⁵)头奶牛编号 1~N 以随机顺序站成一排。每次操作:取出排尾的奶牛,将其插入任意位置。最少几次操作能让队伍变为 1, 2, ..., N 的顺序?
输入格式: 第一行 N;第二行 N 个整数表示队伍从头到尾的编号。 数据规模: 1 ≤ N ≤ 10⁵。O(N) 扫描即可。
示例:
N=5
顺序:1 4 2 5 3
输出:4
💡 提示
核心思路: 找队尾已经有序的最长后缀(连续的 k, k+1, ..., N)。这些奶牛不需要移动。答案 = N − 后缀长度。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> cows(n);
for (int &x : cows) cin >> x;
// 找最长已排序后缀:cows[i], cows[i+1], ..., cows[n-1]
// 条件:cows[i] + 1 == cows[i+1](连续递增)
int keep = 1; // 至少最后一头奶牛留下
for (int i = n - 2; i >= 0; i--) {
if (cows[i] + 1 == cows[i + 1]) {
keep++;
} else {
break; // 后缀必须连续——遇到第一个断点就停
}
}
cout << n - keep << "\n";
return 0;
}
// 时间复杂度:O(N)
题目 4.3.3 — 任务调度器 🟡 中等
题目: N 个标有 A~Z 的任务(1 ≤ N ≤ 10⁴,任务标号仅大写字母),每个需要 1 个时间单位。执行标有 X 的任务后,CPU 必须等待至少 k(0 ≤ k ≤ 100)个时间单位才能再次执行 X(期间可运行其他任务或空闲)。找完成所有任务的最短总时间。
输入格式: 第一行 N 和 k;第二行 N 个用空格分隔的大写字母。
示例:
tasks = [A, A, A, B, B, B], k = 2
输出:8(A→B→空闲→A→B→空闲→A→B)
💡 提示
关键公式:ans = max(任务总数, (maxCount-1)*(k+1) + countMax)
其中 maxCount = 出现次数最多的任务的频率。
贪心策略:每个「帧」(每 k+1 个时间单位)先填最频繁的剩余任务。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, k;
cin >> n >> k;
vector<int> freq(26, 0);
for (int i = 0; i < n; i++) {
char c; cin >> c;
freq[c - 'A']++;
}
int maxCount = *max_element(freq.begin(), freq.end());
int countMax = count(freq.begin(), freq.end(), maxCount);
int ans = max(n, (maxCount - 1) * (k + 1) + countMax);
cout << ans << "\n";
return 0;
}
// 时间复杂度:O(N)
第 4.4 章:进阶贪心与 USACO 真题
普通贪心「选了就不回头」,进阶贪心要么允许后悔(撤销之前的选择)、要么换视角扫描(前后缀、逐位)、要么对抗博弈。本章讲这三个进阶模式,然后用 5 道 USACO Silver 真题把整个第四部分的模型串起来。
📌 前置: [第 4.1–4.3 章] 的基础贪心模型与交换论证。
4.4.1 后悔贪心
后悔贪心是最强大也最容易被忽视的贪心技术。核心思路:
做出贪心决策,但同时保留「撤销」它的能力——如果该决策后来不是最优的,用堆(优先队列)以 O(log N) 时间撤销它。
经典题:K 次操作获得最大利润(支持撤销)
题目: N 个数各有一个收益 x[i](可能为负),从中选数做恰好至多 K 次「操作」;每次操作取一个收益 x,之后可以花 −x 的代价撤销它(等于换成另一个数)。最大化总收益。(1 ≤ N, K ≤ 2×10⁵,|x[i]| ≤ 10⁹,答案用 long long。)
样例输入:
5 3
4 2 10 5 1
(格式:第一行 N 和 K,第二行 N 个收益值)
样例输出:
19
(第一次取 10,撤销后可再取 5:10 + 5 + 4 = 19。撤销机制等价于「允许重复取前 K 大的数」)
贪心 + 后悔做法:
- 维护最大堆
- 每步:取堆顶 x(最大收益),然后插入
-x(「后悔节点」——撤销此操作的代价) - 若之后从堆中取出
-x,相当于「取消」之前的操作
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, k;
cin >> n >> k;
priority_queue<long long> pq; // 最大堆
for (int i = 0; i < n; i++) {
long long x; cin >> x;
pq.push(x);
}
long long total = 0;
for (int i = 0; i < k; i++) {
long long top = pq.top(); pq.pop();
if (top <= 0) break; // 取该元素会损失——停止
total += top;
pq.push(-top); // 插入后悔节点:撤销此操作的代价
}
cout << total << "\n";
return 0;
}
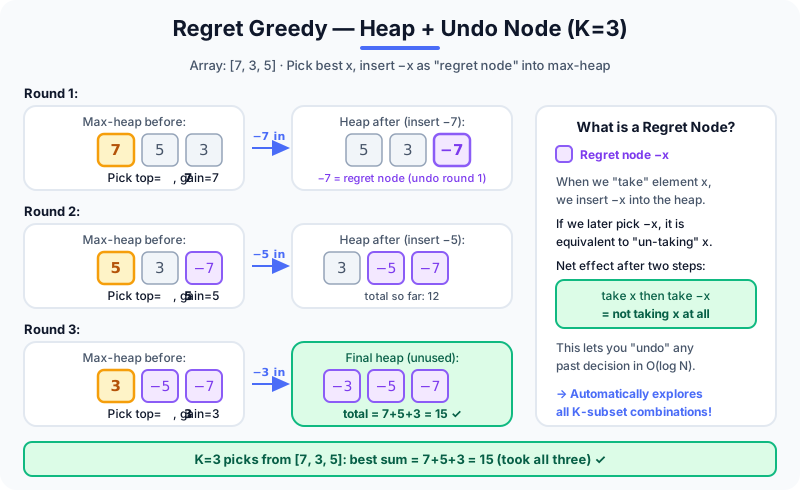
后悔的魔力: 取出 x 并插入 -x 后,若堆顶变为 y,我们可以选择:
- 取 y(正常贪心)
- 取
-x(相当于「取消 x,用下一个可用元素替换」)
这自动找到了 K 次操作的最优序列。
最小化 K 台机器的最大完工时间(LPT)
题目: N 个作业分配到 K 台机器上(每台机器顺序运行分到的作业),目标是让最晚完工的机器尽早完工。求该最小化后的最大完工时间。(1 ≤ N ≤ 2×10⁵,1 ≤ K ≤ N,1 ≤ t[i] ≤ 10⁹。)
样例输入:
6 3
7 2 5 1 9 4
(格式:第一行 N 和 K,第二行 N 个作业时长)
样例输出:
10
(降序排列 9,7,5,4,2,1,依次分给最早空闲的机器:机器 A 得 9,机器 B 得 7,机器 C 得 5+4+1=10——最大完工时间为 10)
贪心:最长处理时间优先(LPT)
按降序排列处理时间,将每个作业分配给完成时间最早的机器(用最小堆维护)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, k;
cin >> n >> k;
vector<int> t(n);
for (int &x : t) cin >> x;
sort(t.begin(), t.end(), greater<int>()); // 降序:最长作业优先
// 最小堆:存储每台机器的当前完成时间(初始全为 0)
priority_queue<long long, vector<long long>, greater<long long>> machines;
for (int i = 0; i < k; i++) machines.push(0);
for (int i = 0; i < n; i++) {
long long earliest = machines.top(); machines.pop();
machines.push(earliest + t[i]); // 将作业分配给最早空闲的机器
}
long long makespan = 0;
while (!machines.empty()) {
makespan = max(makespan, machines.top());
machines.pop();
}
cout << makespan << "\n";
return 0;
}
// 时间复杂度:O(N log N + N log K)
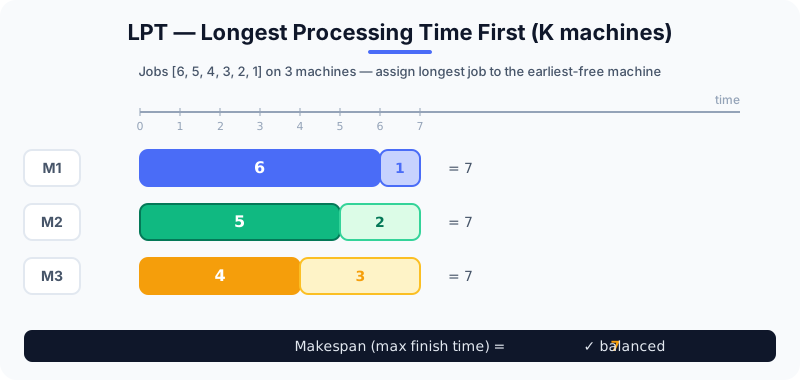
4.4.2 对抗匹配(田忌赛马)
经典的**「田忌赛马」**问题是对抗贪心匹配的原型:双方各有 N 匹马;你可以自由选择出场顺序,对手顺序已知。每场比赛速度更快的一方获胜(相同速度算平局,不计数)。最大化你赢得的比赛数。(1 ≤ N ≤ 2×10⁵,1 ≤ 马的速度 ≤ 10⁹。)
样例输入:
3
1 3 5
2 4 6
(格式:第一行 N,第二行你的马速度,第三行对手的马速度——与下方 adversarial_matching.svg 图中数据一致)
样例输出:
2
(A 最强 5 打不过 B 最强 6,用最弱的 1 消耗 6;随后 3 > 2 赢一场,5 > 4 再赢一场)
策略(双指针,O(N)):
对你的马 A(升序)和对手的马 B(升序)排序:
- 若你最强的马 A[hi] > 对手最强的马 B[bhi] → 用自己最强的打对手最强的(赢一场)
- 若你最强的 A[hi] ≤ 对手最强的 B[bhi] → 用自己最弱的消耗对手最强的(策略性认输,保留更强的马)

#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> A(n), B(n);
for (int &x : A) cin >> x;
for (int &x : B) cin >> x;
sort(A.begin(), A.end());
sort(B.begin(), B.end());
int wins = 0;
int lo = 0, hi = n - 1; // A 的双端指针(弱端和强端)
int blo = 0, bhi = n - 1; // B 的双端指针
while (lo <= hi) {
if (A[hi] > B[bhi]) {
// A 最强打赢 B 最强——赢一场
wins++;
hi--;
bhi--;
} else {
// A 最强打不赢 B 最强——用 A 最弱消耗 B 最强
lo++;
bhi--;
}
}
cout << wins << "\n";
return 0;
}
// 时间复杂度:O(N log N)
4.4.3 前缀/后缀贪心与位运算贪心
前缀/后缀贪心
许多问题可以通过**一次从左扫描(前缀)和一次从右扫描(后缀)**来解决,然后合并结果。
经典应用:分发糖果(双遍扫描)
题目: N 个孩子站成一排,各有评分 rating[i]。要求:① 每个孩子至少分到 1 颗糖;② 评分比相邻孩子高的孩子必须分到更多糖。求最少需要的总糖数。(1 ≤ N ≤ 2×10⁵,0 ≤ rating[i] ≤ 2×10⁴;结果用 long long。)
样例输入:
5
1 3 2 2 1
样例输出:
7
(糖数为 [1,2,1,1,1]:评分 3 比左右邻居都高,得 2 颗,其余各 1 颗)
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<int> rating(n);
for (int &x : rating) cin >> x;
vector<int> candy(n, 1); // 每人至少 1 颗糖
// 第一遍:满足「比左邻居评分高则多拿」
for (int i = 1; i < n; i++) {
if (rating[i] > rating[i - 1])
candy[i] = candy[i - 1] + 1;
}
// 第二遍:满足「比右邻居评分高则多拿」
for (int i = n - 2; i >= 0; i--) {
if (rating[i] > rating[i + 1])
candy[i] = max(candy[i], candy[i + 1] + 1);
}
cout << accumulate(candy.begin(), candy.end(), 0) << "\n";
return 0;
}
// 时间复杂度:O(N)
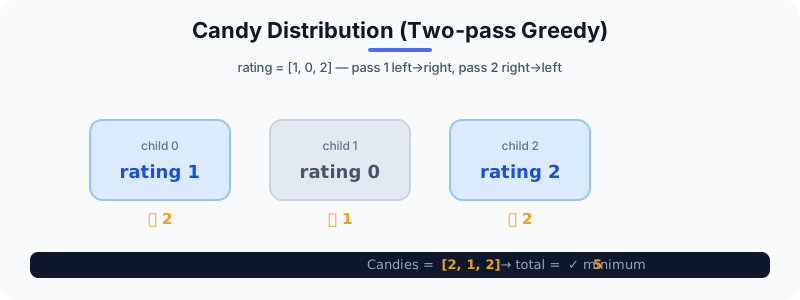
位运算贪心
经典题:最大化数组中两个元素的异或值
题目: 给定 N 个非负整数,选出其中两个数(不同位置),使它们的异或值最大。(1 ≤ N ≤ 2×10⁵,0 ≤ a[i] < 2³¹。O(N²) 两两枚举会超时,需要字典树。)
样例输入:
3
3 10 5
样例输出:
15
(10 XOR 5 = 1010₂ XOR 0101₂ = 1111₂ = 15;从高位到低位,字典树每层都走到了使 XOR 位为 1 的分支)
贪心(字典树): 将所有数字插入二进制字典树。对每个数字 x,在字典树中每层贪心地走「对立」分支(从高位到低位),逐位最大化 XOR 值。
#include <bits/stdc++.h>
using namespace std;
const int MAXBIT = 30;
struct Trie {
int ch[2];
Trie() { ch[0] = ch[1] = -1; }
};
vector<Trie> trie(1);
void insert(int x) {
int node = 0;
for (int i = MAXBIT; i >= 0; i--) {
int bit = (x >> i) & 1;
if (trie[node].ch[bit] == -1) {
trie[node].ch[bit] = trie.size();
trie.push_back(Trie());
}
node = trie[node].ch[bit];
}
}
int maxXOR(int x) {
int node = 0, res = 0;
for (int i = MAXBIT; i >= 0; i--) {
int bit = (x >> i) & 1;
int want = 1 - bit; // 贪心:尝试对立位使 XOR = 1
if (trie[node].ch[want] != -1) {
res |= (1 << i);
node = trie[node].ch[want];
} else {
node = trie[node].ch[bit];
}
}
return res;
}
int main() {
int n;
cin >> n;
vector<int> nums(n);
for (int &x : nums) cin >> x;
for (int x : nums) insert(x);
int ans = 0;
for (int x : nums) ans = max(ans, maxXOR(x));
cout << ans << "\n";
return 0;
}
// 时间复杂度:O(N × MAXBIT) = O(32N)
💡 通用位运算贪心模式: 从高位到低位处理。在每一位,贪心地选择使结果该位等于 1(或 0,取决于目标)的分支。字典树支持每次查询 O(MAXBIT) 时间。
4.4.4 USACO 真题训练:从题面识别贪心
本节把前面的贪心模式放进真实 USACO 题目中。做真题时不要先问「这是不是贪心」,而要先问:
- 排序依据是什么? 题目是否给了时间、价格、产量、资历、结束点等天然优先级?
- 局部选择是否安全? 当前最优选择会不会破坏未来更优选择?
- 如果局部选择错了,能否后悔? 若需要撤销,通常要用堆维护「后悔节点」。
真题 1:Convention II(USACO 2018 December Silver)— 排队中的「资历优先」
题目链接: USACO 2018 December Silver P2: Convention II
对应模式: 排序 + 优先队列贪心
难度定位: Silver 中等
题干解读
有 N 头奶牛,每头奶牛有:
- 到达时间
arrival - 吃草所需时间
duration - 资历
seniority:输入越早,资历越高
同一时刻只有一头奶牛能吃草。如果草地空闲且有奶牛等待,就选择资历最高的等待奶牛。要求输出所有奶牛中的最大等待时间。
数据规模(USACO 官方): 1 ≤ N ≤ 10⁵,1 ≤ arrival ≤ 10⁶,1 ≤ duration ≤ 10⁴。时间总和可能很大,用 long long。
样例输入(USACO 官方):
5
25 3
105 30
20 12
6 5
70 7
(格式:第一行 N,随后每行 arrival duration,输入顺序即资历顺序)
样例输出:
7
(时间线:奶牛 4 在 6 到达即开吃(等待 0),吃到 11;奶牛 3 在 20 到达开吃(等待 0),吃到 32;奶牛 1 在 25 到达,等 32−25=7;……最大等待来自奶牛 1 的 7)
关键点是:
- 到达顺序由
arrival决定,所以要先按到达时间排序。 - 等待队列中的选择由
seniority决定,所以要用优先队列按输入编号最小者优先。 - 当前没有等待奶牛时,时间要直接跳到下一头奶牛的到达时间,不能一秒一秒模拟。
思路分析
思路分析
这不是普通的「先来先服务」。如果多头奶牛都已经到达,USACO 规则要求资历最高者先吃草。因此需要两个顺序:
| 事件 | 依据 | 数据结构 |
|---|---|---|
| 下一头奶牛何时进入等待队列 | 到达时间升序 | 排序数组 |
| 当前从等待队列选谁吃草 | 输入编号升序 | 最小堆 |
贪心的安全性来自题目规则本身:当草地空闲时,所有已经到达的奶牛中,资历最高者必须被选择;其他选择都会违反规则。我们只需要高效模拟这个规则。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
struct Cow {
long long arrive;
long long eat;
int id; // 输入顺序,id 越小资历越高
};
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("convention2.in", "r", stdin);
// freopen("convention2.out", "w", stdout);
int n;
cin >> n;
vector<Cow> cows(n);
for (int i = 0; i < n; i++) {
cin >> cows[i].arrive >> cows[i].eat;
cows[i].id = i;
}
sort(cows.begin(), cows.end(), [](const Cow& a, const Cow& b) {
if (a.arrive != b.arrive) return a.arrive < b.arrive;
return a.id < b.id;
});
// 等待队列:资历最高者优先,也就是 id 最小者优先
priority_queue<pair<int, int>, vector<pair<int, int>>, greater<pair<int, int>>> waiting;
long long currentTime = 0;
long long maxWait = 0;
int nextCow = 0;
while (nextCow < n || !waiting.empty()) {
// 如果没人等待,时间直接跳到下一头奶牛到达时刻
if (waiting.empty() && currentTime < cows[nextCow].arrive) {
currentTime = cows[nextCow].arrive;
}
// 把所有已经到达的奶牛加入等待队列
while (nextCow < n && cows[nextCow].arrive <= currentTime) {
waiting.push({cows[nextCow].id, nextCow});
nextCow++;
}
auto [id, idx] = waiting.top();
waiting.pop();
maxWait = max(maxWait, currentTime - cows[idx].arrive);
currentTime += cows[idx].eat;
}
cout << maxWait << "\n";
return 0;
}
复杂度: 排序 O(N log N),每头奶牛进出堆一次,总复杂度 O(N log N),空间 O(N)。
易错点提醒
- 把等待队列按到达时间排序。 到达时间只决定「能否进入队列」,进入后选择谁取决于资历。
- 忘记时间跳跃。 如果当前没有等待奶牛,应令
currentTime = next arrival,否则会错误地处理空闲时间。 - 等待时间计算位置错。 奶牛开始吃草前计算
currentTime - arrive;吃完后再算会多加自己的吃草时间。 - 使用
int存时间。 到达时间与吃草时间相加可能较大,建议用long long。
拓展思考
如果规则改成「等待时间最长者优先」,优先队列的键就会变为等待时长;但等待时长随时间变化,堆中键会动态改变,模拟会更复杂。这类题常提示你:优先级必须是静态或可懒更新的,才能直接用堆贪心。
真题 2:Rental Service(USACO 2018 January Silver)— 「高产牛卖奶,低产牛出租」
题目链接: USACO 2018 January Silver P2: Rental Service
对应模式: 排序 + 前缀收益 + 枚举分界点
难度定位: Silver 进阶
题干解读
有 N 头奶牛,每头每天产若干加仑牛奶。每头牛只能做一件事:
- 卖牛奶给商店:商店有购买上限和单价。
- 出租整头牛:邻居给定固定租金。
目标是最大化总收入。
数据规模(USACO 官方): 1 ≤ N ≤ 10⁵(奶牛数),1 ≤ M ≤ 10⁵(商店数),1 ≤ R ≤ 10⁵(租客数);每头牛产量 1 ≤ c_i ≤ 10⁹;每个商店 1 ≤ 数量 ≤ 10⁹ 加仑、1 ≤ 单价 ≤ 1000;每个租金 1 ≤ r_i ≤ 10⁹。
样例输入(USACO 官方):
5 3 4
4 6 2 1 8
4 10
3 5
2 3
15 10 8 2
(格式:第一行 N M R;第二行 N 头牛的产量;随后 M 行每行「数量 单价」;最后一行 R 个租金)
样例输出:
94
(产量降序 8,6,4,2,1。最优分界:前 2 头高产牛卖奶,后 3 头低产牛出租。牛 8 卖给商店:4 加仑@10=40、3 加仑@5=15、1 加仑@3=3,共 58;牛 6 只能再卖 1 加仑@3=3。卖奶共 61。出租牛 4、2、1 得 15+10+8=33。总收益 61+33=94)
题目隐藏的关键结构是:高产牛更适合卖奶,低产牛更适合出租。我们不需要枚举每头牛的所有选择,只要枚举「前 k 头高产牛卖奶,其余低产牛出租」。
思路分析
思路分析
先排序:
- 奶牛产量降序:高产牛排前面。
- 商店价格降序:先卖给单价最高的商店。
- 租金降序:低产牛若出租,也优先拿最高租金。
然后预处理两个数组:
| 数组 | 含义 |
|---|---|
sellProfit[k] | 前 k 头高产牛全部卖奶的最大收入 |
rentProfit[x] | 后 x 头低产牛全部出租的最大收入 |
最后枚举 k:卖奶 k 头,出租 N-k 头,答案是 max(sellProfit[k] + rentProfit[N-k])。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
using ll = long long;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("rental.in", "r", stdin);
// freopen("rental.out", "w", stdout);
int n, m, r;
cin >> n >> m >> r;
vector<ll> cows(n);
for (ll &x : cows) cin >> x;
vector<pair<ll, ll>> stores(m); // {价格, 数量}
for (int i = 0; i < m; i++) {
ll quantity, price;
cin >> quantity >> price;
stores[i] = {price, quantity};
}
vector<ll> rent(r);
for (ll &x : rent) cin >> x;
sort(cows.rbegin(), cows.rend()); // 高产牛优先卖奶
sort(stores.rbegin(), stores.rend()); // 高价商店优先购买
sort(rent.rbegin(), rent.rend()); // 高租金优先出租
vector<ll> sellProfit(n + 1, 0);
int shop = 0;
ll remaining = (m > 0 ? stores[0].second : 0);
for (int i = 1; i <= n; i++) {
sellProfit[i] = sellProfit[i - 1];
ll milk = cows[i - 1];
while (milk > 0 && shop < m) {
ll take = min(milk, remaining);
sellProfit[i] += take * stores[shop].first;
milk -= take;
remaining -= take;
if (remaining == 0) {
shop++;
if (shop < m) remaining = stores[shop].second;
}
}
}
vector<ll> rentProfit(n + 1, 0);
for (int x = 1; x <= n; x++) {
rentProfit[x] = rentProfit[x - 1];
if (x <= r) rentProfit[x] += rent[x - 1];
}
ll answer = 0;
for (int sellCount = 0; sellCount <= n; sellCount++) {
int rentCount = n - sellCount;
answer = max(answer, sellProfit[sellCount] + rentProfit[rentCount]);
}
cout << answer << "\n";
return 0;
}
复杂度: 排序 O((N+M+R) log(N+M+R)),预处理和枚举 O(N+M),空间 O(N)。
易错点提醒
- 商店输入顺序是数量再价格。 代码中转成
{price, quantity}是为了按价格降序排序。 - 出租的是低产牛。 若把高产牛出租、低产牛卖奶,会破坏贪心结构。
- 收益必须用
long long。N、产量、价格都可能很大,int会溢出。 - 枚举分界点时不要超过租客数量。
rentProfit[x]中超过R的部分收益为 0。
拓展思考
这道题的本质是「排序后枚举分界点」。如果题目要求每头牛还带有不同的出租限制,简单分界点就不再成立,可能需要 DP 或最小费用流。看到 Silver 题中同时出现「排序 + 两种收益方式」时,优先尝试这种前缀收益模型。
真题 3:Rest Stops(USACO 2018 February Silver)— 从右往左选「未来最高价值」
题目链接: USACO 2018 February Silver P1: Rest Stops
对应模式: 后缀最大值 + 贪心选择
难度定位: Silver 中等
题干解读
FJ 和 Bessie 沿一条长度为 L 的路前进。Bessie 走得慢一些,但可以在休息站吃草获得快乐值。每个休息站有位置 x 和美味值 c。FJ 不停走,Bessie 可以停留吃草,问最大快乐值。
数据规模(USACO 官方): 1 ≤ L ≤ 10⁹,1 ≤ N ≤ 10⁵(休息站数),1 ≤ rB < rF ≤ 10⁹(每单位距离 Bessie/FJ 走的时间),1 ≤ x_i ≤ L,1 ≤ c_i ≤ 10⁹。答案可达 10¹⁸ 以上,必须用 long long。
样例输入(USACO 官方):
10 2 4 3
7 2
8 1
(格式:第一行 L N rF rB;随后 N 行每行「位置 美味值」)
样例输出:
15
(rF−rB = 1,Bessie 每走 1 单位距离攒下 1 单位吃草时间。两个站从右往左看都是后缀最大值(位置 8 的 1、位置 7 的 2),都值得停留:在位置 7 停留 7×1=7 单位时间得 7×2=14;再走到位置 8 时又攒下 1 单位时间,得 1×1=1。总快乐值 14+1=15)
关键条件:
- Bessie 比 FJ 慢,因此每走一段距离都会产生「可用于吃草的时间差」。
- 如果后面有一个更美味的休息站,当前较低美味值的站通常不值得停。
- 应只在从右往左看时美味值创新高的休息站停留。
思路分析
思路分析
把休息站按位置升序。若某个休息站右侧存在更高美味值的站,那么把时间留到右侧更高美味值处吃草一定不差。因此真正需要停的站,是从右往左扫描时遇到的「后缀最大美味值」站。
算法步骤:
- 从右往左标记所有
c大于右侧最大值的休息站。 - 再从左到右经过这些被选中的站。
- 上一个停留点到当前停留点的距离为
delta。 - Bessie 比 FJ 多出来的可吃草时间是
delta * (rF - rB)。 - 快乐值增加
time * c。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
using ll = long long;
struct Stop {
ll position;
ll tastiness;
};
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("reststops.in", "r", stdin);
// freopen("reststops.out", "w", stdout);
ll trailLength, n, farmerSpeed, bessieSpeed;
cin >> trailLength >> n >> farmerSpeed >> bessieSpeed;
vector<Stop> stops(n);
for (auto &s : stops) cin >> s.position >> s.tastiness;
vector<bool> chosen(n, false);
ll bestTastiness = -1;
// 从右往左选出所有「比右侧都更好」的休息站
for (int i = n - 1; i >= 0; i--) {
if (stops[i].tastiness > bestTastiness) {
chosen[i] = true;
bestTastiness = stops[i].tastiness;
}
}
ll answer = 0;
ll lastPosition = 0;
ll speedGap = farmerSpeed - bessieSpeed;
for (int i = 0; i < n; i++) {
if (!chosen[i]) continue;
ll distance = stops[i].position - lastPosition;
ll extraTime = distance * speedGap;
answer += extraTime * stops[i].tastiness;
lastPosition = stops[i].position;
}
cout << answer << "\n";
return 0;
}
复杂度: 两次线性扫描,O(N);空间 O(N)。如果输入不保证按位置升序,先排序,复杂度为 O(N log N)。
易错点提醒
- 从左往右贪心选当前最高。 这会错过后面更高美味值的站;正确视角是从右往左看后缀最大。
- 把速度差写反。 可吃草时间来自
farmerSpeed - bessieSpeed,因为 FJ 更快。 - 忘记更新
lastPosition。 每一段额外时间只来自上一次停留点到当前停留点的距离。 - 使用
int存答案。 距离、速度差、美味值相乘可能很大,必须用long long。
拓展思考
Rest Stops 是「未来更优选择支配当前选择」的典型题。只要当前选择的收益率低于未来某个选择,并且时间资源可以转移到未来,就应该跳过当前选择。这类题常用后缀最大值预处理。
真题 4:Convention(USACO 2018 February Silver)——二分答案 + 贪心检查
题目(USACO 2018 February Silver): N 头奶牛在时间 t[1..N] 到达公共汽车站。有 M 辆公共汽车,每辆最多容纳 C 头奶牛。将奶牛分配给公共汽车,最小化任意奶牛的最大等待时间(等待时间 = 发车时刻 − 到达时刻;发车时刻自定,一辆车装的所有牛一起出发)。
输入格式: 第一行 N, M, C;第二行 N 个到达时间。 数据规模(真题): 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 10⁵,1 ≤ C ≤ N,0 ≤ t[i] ≤ 10⁹。时间限制 4 秒——O(N log N) 的二分 + 贪心检查轻松通过。
做法:二分答案 + 贪心检查。

#include <bits/stdc++.h>
using namespace std;
int n, m, c;
vector<long long> cows; // 按到达时间排序
// 最大等待时间 <= maxWait 时能否调度所有奶牛?
bool canDo(long long maxWait) {
int busesUsed = 0;
int i = 0; // 当前奶牛下标
while (i < n) {
busesUsed++;
if (busesUsed > m) return false; // 公共汽车不够用了
// 该车从奶牛 i 开始服务
// 车必须在 cows[i] + maxWait 之前出发
long long depart = cows[i] + maxWait;
// 尽量多地装奶牛(容量 c,到达时间 ≤ 出发时间)
int count = 0;
while (i < n && count < c && cows[i] <= depart) {
i++;
count++;
}
}
return true;
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n >> m >> c;
cows.resize(n);
for (long long &x : cows) cin >> x;
sort(cows.begin(), cows.end());
// 对最大等待时间二分
long long lo = 0, hi = 1e14;
while (lo < hi) {
long long mid = lo + (hi - lo) / 2;
if (canDo(mid)) hi = mid;
else lo = mid + 1;
}
cout << lo << "\n";
return 0;
}
真题 5:放牧(USACO Bronze)——小数据贪心观察
题目: 三头奶牛站在数轴上不同的整数位置 a、b、c(0 ≤ a, b, c ≤ 10⁹)。每次移动可以选任意一头奶牛,将它传送到任意空的整数位置。找让三头奶牛处于三个连续整数位置(如 {k, k+1, k+2})所需的最少移动次数。
输入格式: 一行三个整数 a、b、c。
样例输入: 4 7 9 → 输出: 1(将 9 移到 5 或 6,或将 4 移到 8:{7,8,9})
样例输入 2: 1 10 100 → 输出: 2
贪心洞察: 排序后 a ≤ b ≤ c:
- 0 次移动当且仅当
c - a == 2(已是连续) - 2 次移动始终够用(上界)
- 1 次移动可行当以下任一成立:
c - b == 1或c - b == 2(b 和 c 相邻或差 1)b - a == 1或b - a == 2(a 和 b 相邻或差 1)c - a == 3(移动 b 到 a+1 或 c-1 使三者连续)
#include <bits/stdc++.h>
using namespace std;
int main() {
long long a, b, c;
cin >> a >> b >> c;
long long pos[3] = {a, b, c};
sort(pos, pos + 3);
a = pos[0]; b = pos[1]; c = pos[2];
// 0 次移动:已是连续
if (c - a == 2) { cout << 0; return 0; }
// 1 次移动:检查各情况
bool one_move = false;
// (b,c) 对保留:移动 a
if (c - b == 1 || c - b == 2) one_move = true;
// (a,b) 对保留:移动 c
if (b - a == 1 || b - a == 2) one_move = true;
// (a,c) 对保留:移动 b(需 c-a==3)
if (c - a == 3) one_move = true;
if (one_move) { cout << 1; return 0; }
cout << 2;
return 0;
}
练习题
| 题目 | 关键技术 | 难度 |
|---|---|---|
| 4.4.1 跳跃游戏 | 可达性贪心 | 🟡 中等 |
| 4.4.2 Convention II(USACO Silver) | 资历优先队列模拟 | 🔴 困难 |
| 4.4.3 加权工作调度 | 贪心失败 → DP | 🔴 困难 |
题目 4.4.1 — 跳跃游戏 🟡 中等
题目: 给定非负整数数组 A,从索引 0 出发,在位置 i 可以向前跳最多 A[i] 步。判断是否能到达最后一个索引(n-1)。
数据规模: 1 ≤ N ≤ 2×10⁵,0 ≤ A[i] ≤ 10⁵。O(N) 单次扫描即可。
示例:
A = [2, 3, 1, 1, 4] → true (0→1→4)
A = [3, 2, 1, 0, 4] → false (过不了位置 3)
💡 提示
维护 farthest = 目前可到达的最远下标。扫描每个可达位置,更新 farthest。若某时刻 i > farthest,位置 i 不可达——返回 false。
#include <bits/stdc++.h>
using namespace std;
bool canJump(vector<int>& A) {
int n = A.size();
int farthest = 0;
for (int i = 0; i < n; i++) {
if (i > farthest) return false;
farthest = max(farthest, i + A[i]);
if (farthest >= n - 1) return true;
}
return true;
}
int main() {
int n;
cin >> n;
vector<int> A(n);
for (int &x : A) cin >> x;
cout << (canJump(A) ? "true" : "false") << "\n";
}
为什么贪心正确: 每步不选具体跳跃——只是追踪从当前所有可达位置出发,所有可能跳跃的并集。这等价于同时考虑所有可能的跳跃路径。
题目 4.4.2 — USACO 2018 February Silver:Convention II 🔴 困难
题目: N(1 ≤ N ≤ 10⁵)头奶牛按资历排序(下标越小资历越高)。奶牛 i 在时间 a[i] 到达饮水处(0 ≤ a[i] ≤ 10⁶),喝水需要 t[i](1 ≤ t[i] ≤ 10⁶)个时间单位(设备每次服务一头奶牛)。设备空闲时,等待的奶牛中资历最高(下标最小)的先喝水。求所有奶牛中最大等待时间。
输入格式: 第一行 N;接下来 N 行每行 a[i] 和 t[i]。 数据规模(真题): 1 ≤ N ≤ 10⁵,0 ≤ a[i] ≤ 10⁶,1 ≤ t[i] ≤ 10⁶。优先队列模拟 O(N log N) 通过。
💡 提示
用优先队列(按资历下标最小堆)模拟。维护已到达但未喝水的奶牛的「等待队列」。每次设备空闲时,从等待队列中取资历最高(下标最小)的奶牛。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
// {到达时间, 原始下标(资历), 喝水时长}
vector<tuple<int,int,int>> cows(n);
for (int i = 0; i < n; i++) {
int a, t;
cin >> a >> t;
cows[i] = {a, i, t}; // 原始下标 i = 资历(0 = 最高资历)
}
sort(cows.begin(), cows.end()); // 按到达时间排序
// 最小堆:{资历下标, 到达时间, 喝水时长}——下标最小优先级最高
priority_queue<tuple<int,int,int>, vector<tuple<int,int,int>>, greater<>> waiting;
int curTime = 0; // 设备下次空闲的时间
int maxWait = 0;
int idx = 0;
while (idx < n || !waiting.empty()) {
// 将所有在 curTime 之前到达的奶牛加入等待队列
while (idx < n && get<0>(cows[idx]) <= curTime) {
auto [a, seniority, t] = cows[idx];
waiting.push({seniority, a, t});
idx++;
}
if (waiting.empty()) {
curTime = get<0>(cows[idx]);
continue;
}
// 服务资历最高(下标最小)的等待奶牛
auto [seniority, arrTime, drinkTime] = waiting.top();
waiting.pop();
int waitTime = curTime - arrTime;
maxWait = max(maxWait, waitTime);
curTime += drinkTime;
}
cout << maxWait << "\n";
return 0;
}
// 时间复杂度:O(N log N)
题目 4.4.3 — 加权工作调度 🔴 困难(贪心失败→用 DP)
题目: N(1 ≤ N ≤ 2×10⁵)个工作,各有开始时间 s[i]、结束时间 e[i](0 ≤ s[i] < e[i] ≤ 10⁹)和利润 p[i](1 ≤ p[i] ≤ 10⁹)。选择一组不重叠的工作(区间 [s[i], e[i]) 两两不相交)以最大化总利润。总利润可能超过 int 范围。
输入格式: 第一行 N;接下来 N 行每行 s[i]、e[i]、p[i]。
示例:
N=4
工作:(s=1,e=3,p=50), (s=2,e=5,p=10), (s=4,e=6,p=40), (s=6,e=7,p=70)
输出:160(工作 1 + 3 + 4)
为什么贪心失败?
- 按利润排序取最大值?不行。反例:(s=1,e=10,p=100) vs (s=1,e=3,p=50)+(s=4,e=7,p=60)——后者总计 110。
- 按最早结束时间?不行。贪心可能选利润为 1 的短工作,错过利润 100 的长工作。
- 贪心无法同时优化「早结束」和「最大利润」。这是加权区间调度——DP 问题。
DP 做法:
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<tuple<int,int,int>> jobs(n); // {结束时间, 开始时间, 利润}
for (int i = 0; i < n; i++) {
int s, e, p;
cin >> s >> e >> p;
jobs[i] = {e, s, p};
}
sort(jobs.begin(), jobs.end()); // 按结束时间排序
vector<int> ends;
for (auto [e, s, p] : jobs) ends.push_back(e);
vector<long long> dp(n + 1, 0); // dp[i]:前 i 个工作的最大利润(1-indexed)
for (int i = 1; i <= n; i++) {
auto [e, s, p] = jobs[i - 1];
// 二分搜索:找最后一个结束时间 <= s[i] 的工作(不重叠)
int lo = 0, hi = i - 1;
while (lo < hi) {
int mid = (lo + hi + 1) / 2;
if (ends[mid - 1] <= s) lo = mid;
else hi = mid - 1;
}
dp[i] = max(dp[i - 1], dp[lo] + p); // 跳过 vs 选取
}
cout << dp[n] << "\n";
return 0;
}
// 时间复杂度:O(N log N)
教训: 选择不重叠区间时,若区间有权重(利润),贪心不起作用——用 DP。只有当所有权重相等(最大化数量)时,才能简化为贪心。
🕸️ 第五部分:图论算法
学会在题目中看见图并高效解决它。从 BFS、DFS、并查集到最小生成树、强连通分量、网络流——覆盖 USACO Silver 至 Gold 的图论核心。
📚 16 章 · ⏱️ 预计 6-8 周 · 🎯 目标:达到 USACO Gold 水平
第五部分:图论算法
预计用时:2-3 周
图在竞赛编程中无处不在:迷宫、网络、家族树、城市地图。第五部分教你看见题目中的图并高效解决它们。
涵盖的主题
| 章节 | 主题 | 核心思想 |
|---|---|---|
| 第 5.1 章 | 图的基础 | 表示图;邻接表;图的类型 |
| 第 5.2 章 | BFS 与 DFS | 遍历、最短路径、洪水填充、连通分量、10 种变种 |
| 第 5.3 章 | 函数图 | 找规律、基环树、周期检测 |
| 第 5.4 章 | 最短路径 | Dijkstra、Bellman-Ford、Floyd-Warshall、SPFA、Johnson、负环与差分约束 |
| 第 5.5 章 | 二叉树与树算法 | BST、遍历、LCA(朴素+倍增)、欧拉序、树的直径 |
| 第 5.6 章 | 并查集 | 路径压缩+按秩合并、Kruskal MST、带权并查集、种类并查集 |
| 第 5.7 章 | 线段树 | 区间查询/更新、懒惰传播、动态开点 |
| 第 5.8 章 | 树状数组(BIT) | 前缀和、区间查询、权值BIT |
| 第 5.9 章 🥇 | 最小生成树 | Prim、Kruskal、瓶颈生成树 |
| 第 5.10 章 🥇 | 拓扑排序与 DAG DP | Kahn 算法、DAG 上的最长/最短路 |
| 第 5.11 章 🥇 | 强连通分量与缩点 | Tarjan、Kosaraju、缩点后 DAG DP |
| 第 5.12 章 🥇 | 网络流与二分图匹配 | Dinic、匈牙利算法、最大权闭合子图 |
| 第 5.13 章 🥇 | 树链剖分与树上算法 | dfs1/dfs2、跳链、dsu on tree |
| 第 5.14 章 🥇 | 欧拉序与树的展平 | 倍增 LCA、欧拉序、子树区间 |
| 第 5.15 章 🥇 | 树上差分与点分治 | 点/边差分、重心分治、容斥去重 |
| 第 5.16 章 🥈→🥇 | 搜索专题 | 剪枝三招、迭代加深 IDDFS、A*/IDA*、双向 BFS |
学完本部分后能解决什么问题
完成第五部分后,你将能够挑战:
-
USACO Bronze:
- 洪水填充(统计网格中连通区域数量)
- 可达性问题(奶牛 A 能到达奶牛 B 吗?)
- 网格/图中的简单 BFS 最短路径
-
USACO Silver:
- 隐式图上的 BFS/DFS(状态节点而非显式节点)
- 多源 BFS(到最近障碍物/火焰的距离)
- 动态连通性的并查集
- 边添加下的图连通性
- 树的问题(子树求和、深度、LCA)
引入的关键算法
| 技术 | 章节 | 时间复杂度 | USACO 相关度 |
|---|---|---|---|
| DFS(递归和迭代) | 5.2 | O(V + E) | 连通性、环检测 |
| BFS | 5.2 | O(V + E) | 最短路径(无权) |
| 网格 BFS | 5.2 | O(R × C) | 迷宫问题、洪水填充 |
| 多源 BFS | 5.2 | O(V + E) | 到最近源点的距离 |
| 连通分量 | 5.2 | O(V + E) | 统计不连通区域数量 |
| 树的遍历(前序/后序) | 5.3 | O(N) | 子树聚合 |
| 并查集(DSU) | 5.3 | O(α(N)) ≈ O(1) | 动态连通性 |
| Kruskal 最小生成树 | 5.3 | O(E log E) | 最小生成树 |
| Dijkstra 算法 | 5.4 | O((V + E) log V) | 非负权图的单源最短路 |
| Bellman-Ford | 5.4 | O(V × E) | 含负边的单源最短路;负环检测 |
| Floyd-Warshall | 5.4 | O(V³) | 小图的全对最短路 |
| SPFA | 5.4 | O(V × E) 最坏 | 有队列优化的实用 Bellman-Ford |
本部分学习建议
- 第 5.1 章主要是准备工作——阅读以了解图的表示,但真正的算法从第 5.2 章开始。
- 第 5.2 章(BFS) 是 USACO Silver 最重要的章节之一。约 1/3 的 Silver 题目涉及网格 BFS。
- BFS 中
dist[v] == -1表示未访问的模式是关键。永远不要在弹出时标记访问——要在压入时标记。 - 第 5.5 章的并查集对连通性问题比 BFS 更快编码。记住那个 15 行的模板——你会经常用到它。
- 第 5.3 章(Dijkstra) 对加权最短路径问题至关重要。用带
priority_queue<pair<int,int>>的标准模板——这是 Silver/Gold 最常见的图算法。
💡 核心思路: 大多数 USACO 图论题实际上是伪装成网格题。网格单元 (r,c) 变成图节点;相邻单元变成边。对这个隐式图做 BFS 就能找到最短路径。
🏆 USACO 技巧: 每当在题目中看到「最短路径」「最少步数」或「最少移动次数」,立刻想到 BFS。每当看到「这两个连通吗?」或「有多少组?」,想到 DSU。
第 5.1 章:图的基础
5.1.0 从一道题出发:牧场之路
第 5 部分从一道典型的 Bronze/Silver 过渡题开始:
🐄 题目:连通的牧场(USACO 风格,接近 Fence Painting / Counting Regions) 农夫 John 有
N(1 ≤ N ≤ 10⁵)个牧场和M(0 ≤ M ≤ 2×10⁵)条双向道路,第i条连接牧场u_i和v_i(1 ≤ u_i, v_i ≤ N,可能存在自环与重边,不影响连通性)。 问:有多少个「牧场群」——互相能走到的一组牧场算一群(单独一个牧场也算一群)。输入格式: 第一行 N 和 M;接下来 M 行每行 u_i 和 v_i。 数据规模: 1 ≤ N ≤ 10⁵,0 ≤ M ≤ 2×10⁵。需 O(N + M) 的 BFS/DFS 或并查集;邻接矩阵存不下(O(N²) 内存会 MLE)。
N=6, M=4
道路:1-2, 2-3, 4-5
牧场群:{1,2,3}, {4,5}, {6} → 答案 3
先试试你会的方法
思路 1:数组分组? 道路是「关系」而不是「区间」,没有顺序可言,前缀和、排序都用不上。
思路 2:套用网格题的 DFS? 方向对了——「从一个点出发访遍能到的所有点」就是第 5.2 章的图遍历。但先得回答一个更根本的问题:这 M 条道路怎么存进程序里?
注意输入的形式:一堆 (u, v) 对。它不是数组(没有下标语义)、不是网格(没有行列)。你需要一个新的容器来装「一堆东西 + 一堆连接」——这正是图。
图是竞赛编程中最通用的数据结构——城市与道路、人与友谊、任务与依赖、迷宫格子与相邻格子,全都是「节点 + 边」。Silver 级别以上的几乎每道 USACO 题都以某种形式藏着一张图。
拆解这道题需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 5.1.1 | 图是什么?V、E 的术语体系 |
| 5.1.2 | 怎么存图?邻接表 vs 邻接矩阵(本题用邻接表 + BFS/DFS 数群) |
| 5.1.3+ | 有向/无向、权重、度数——USACO 输入的读法 |
| 5.1.4+ | 特殊图:树、DAG、网格图的识别 |
本章教你用图的视角思考,更重要的是用代码存储图。学完后,你能读取任何 USACO 图的输入,毫不犹豫地选择正确的表示方式。
5.1.1 什么是图?
图 G = (V, E) 由两个集合组成:
- 顶点 V(也称节点):「东西」——城市、奶牛、单元格、状态
- 边 E:它们之间的连接——道路、友谊、转换
用 |V| = N 表示顶点数,|E| = M 表示边数。
图如何存储?
在深入术语之前,先快速预览图在代码中如何存储。有两种主要方式(详见 §5.1.2):
邻接表 —— 对每个顶点,存储其邻居列表。这是最常见的表示方式:
adj[0] = {1, 2} ← 节点 0 连接到 1 和 2
adj[1] = {0, 2, 3} ← 节点 1 连接到 0、2 和 3
adj[2] = {0, 1, 4} ← 节点 2 连接到 0、1 和 4
adj[3] = {1, 4} ← 节点 3 连接到 1 和 4
adj[4] = {2, 3} ← 节点 4 连接到 2 和 3
邻接矩阵 —— 用 V×V 的网格,adj[u][v] = 1 表示「u 和 v 之间有边」:
adj: 0 1 2 3 4
0 [ 0 1 1 0 0 ] ← 节点 0 连接到 1 和 2
1 [ 1 0 1 1 0 ] ← 节点 1 连接到 0、2 和 3
2 [ 1 1 0 0 1 ] ← 节点 2 连接到 0、1 和 4
3 [ 0 1 0 0 1 ] ← 节点 3 连接到 1 和 4
4 [ 0 0 1 1 0 ] ← 节点 4 连接到 2 和 3
💡 快速对比: 邻接表内存更少、遍历更快——95% 的情况用它。邻接矩阵支持 O(1) 边查询——V 较小(≤ 1500)或用于 Floyd-Warshall 等算法时有用。
以下两张图展示了同一个 5 节点图用邻接表和邻接矩阵存储的方式:


矩阵中,绿色 1 = 边存在,灰色 0 = 无边。对角线上的格子始终为 0(无自环)。注意矩阵是对称的——因为这是无向图。
关键术语
现在不必全部记住——快速浏览,需要时回头查看。
| 术语 | 定义 | 示例 |
|---|---|---|
| 度(Degree) | 连接到一个顶点的边数 | 节点 2 的度为 3 |
| 路径(Path) | 由边连接的顶点序列 | 1 → 2 → 4 → 6 |
| 环(Cycle) | 起点和终点相同的路径 | 1 → 2 → 3 → 1 |
| 连通(Connected) | 每个顶点都能到达其他所有顶点 | 一个连通分量 |
| 分量(Component) | 最大连通子图 | 节点的「簇」 |
| 稀疏(Sparse) | 边少:M = O(V) | 道路网络 |
| 稠密(Dense) | 边多:M = O(V²) | 完全图 |
握手引理
所有顶点度数之和等于 2M(边数的两倍)。
证明:每条边 (u, v) 对 deg(u) 和 deg(v) 各贡献 +1。
推论: 任何图中奇数度顶点的数量始终是偶数。这可以立即排除题目中的不可能情况。
图的类型
图有多种形式,以下是最常见的:
| 类型 | 描述 | USACO 频率 |
|---|---|---|
| 无向图 | A–B 边意味着 B–A 也存在;道路、牧场连接 | ⭐⭐⭐ 非常常见 |
| 有向图(Digraph) | A→B 不意味着 B→A;依赖关系、流 | ⭐⭐ 常见(Gold+) |
| 加权图 | 每条边有数值代价;道路距离 | ⭐⭐⭐ 常见(Silver+) |
| 树 | 连通、无环、恰好 N−1 条边 | ⭐⭐⭐ 各级别非常常见 |
| DAG | 有向无环图;存在拓扑序 | ⭐⭐ DP 状态常见 |
| 网格图 | 单元格为节点,4 方向边;迷宫 | ⭐⭐⭐ Bronze/Silver 最常见 |
| 完全图 K_n | 每对顶点都连接;N(N−1)/2 条边 | ⭐ 罕见;通常是理论题 |
| 二部图 | 两色顶点,边只在组间 | ⭐⭐ 匹配、2-染色 |
USACO 实际情况: Bronze/Silver 主要用无权无向图和网格图。加权图出现在 Silver 最短路中。树出现在所有级别。Gold 引入 DAG、有向图和稠密图。


5.1.2 图的表示
现在你知道图是什么了,接下来的问题是:如何用代码存储它? 这是图问题中最关键的编码决策。有三种主要表示方式,各有不同的权衡。选错会导致 TLE 或 MLE。
表示方式一:邻接表——默认选择
对每个顶点,存储其邻居列表。这是 95% 的 USACO 题目的首选。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m; // n 个顶点(1..n),m 条边
cin >> n >> m;
// adj[u] = 与 u 直接相连的顶点列表
vector<vector<int>> adj(n + 1); // 大小 n+1 以使用 1-indexed 顶点
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v); // 无向图:两个方向都要加
adj[v].push_back(u);
}
// 遍历顶点 u 的所有邻居:O(deg(u))——最优
for (int u = 1; u <= n; u++) {
cout << u << " -> ";
for (int v : adj[u]) cout << v << " ";
cout << "\n";
}
return 0;
}
属性:
- 空间:
O(V + E)—— 最优。对 V = 10^5、E = 2×10^5 轻松放进 256 MB。 - 遍历邻居:
O(deg(u))—— 只访问实际邻居,没有浪费工作。 - 检查边 (u, v):
O(deg(u))—— 必须扫描邻居列表。(这是弱点。) - 缓存性能:
vector使用连续内存 → 比链表快 5–10 倍。
表示方式二:邻接矩阵
邻接矩阵将图表示为二维数组,条目 adj[u][v] 回答:「从 u 到 v 的边存在吗?」
#include <bits/stdc++.h>
using namespace std;
const int MAXV = 1001;
// 关键:声明为全局变量!
// 局部的 bool[1001][1001] 在栈上占 ~1 MB → 栈溢出崩溃。
// 全局变量存储在 BSS 段,自动初始化为零。
bool adj[MAXV][MAXV];
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u][v] = true; // 无向图:两个方向都要设置
adj[v][u] = true;
}
// O(1) 边查询——邻接矩阵的杀手特性
if (adj[2][3]) {
cout << "边 2-3 存在\n";
}
return 0;
}
⚠️ 关键:始终使用全局数组。 局部的
bool adj[1001][1001]消耗约 1 MB 栈空间——通常会崩溃。全局数组在 BSS/数据段中,没有栈大小限制,自动初始化为零。
空间:什么时候可以用邻接矩阵?
V = 100 → bool[100][100] = 10 KB ✅ 没问题
V = 500 → bool[500][500] = 250 KB ✅ 没问题
V = 1000 → bool[1000][1000] = 1 MB ✅ 没问题
V = 1500 → bool[1500][1500] = 2.25 MB ✅ 没问题
V = 3000 → bool[3000][3000] = 9 MB ⚠️ 临界(256 MB 限制)
V = 10000 → bool[10k][10k] = 100 MB ❌ 超出典型限制
V = 10^5 → bool[10^5][10^5] = 10 GB ❌ 不可能
经验法则: V ≤ ~1500 时安全。V > 2000 时切换到邻接表。
完整对比
| 操作 | 邻接矩阵 | 邻接表 |
|---|---|---|
| 空间 | O(V²) | O(V + E) |
| 检查边 (u, v) | O(1) | O(deg(u)) |
| 遍历 u 的所有邻居 | O(V) 扫整行 | O(deg(u)) |
| 添加边 | O(1) | O(1) 均摊 |
| V ≤ 1000 时最佳 | ✅ 若需 O(1) 边查询 | ✅ 始终可用 |
| V = 10^5 时最佳 | ❌ 内存太大 | ✅ 必须用 |
| Floyd-Warshall | ✅ 自然格式 | ❌ 不能用 |
| Kruskal / BFS / DFS | ❌ 邻居遍历慢 | ✅ 必须用 |
表示方式三:边列表
将图存储为 (u, v) 或 (u, v, w) 元组的普通数组。
// 加权图的边结构体
struct Edge {
int u, v, w;
// 按权重升序排序:
bool operator<(const Edge& other) const {
return w < other.w;
}
};
vector<Edge> edges;
// 读取输入:
for (int i = 0; i < m; i++) {
int u, v, w;
cin >> u >> v >> w;
edges.push_back({u, v, w});
}
// 按权重排序——Kruskal MST 需要:
sort(edges.begin(), edges.end());
什么时候用边列表:
| 算法 | 原因 |
|---|---|
| Kruskal MST | 需要按权重排序的边;贪心处理 |
| Bellman-Ford | 对所有 M 条边迭代 N 次 |
| 全局处理所有边 | 不需要顶点结构时 |
什么时候不用:
- BFS/DFS:无法按顶点查询邻居
- 检查「边 (u, v) 是否存在」:O(M) 扫描
如何选择表示方式
V ≤ 1500?
├── 是 → 需要 O(1) 边查询或 Floyd-Warshall?
│ ├── 是 → 邻接矩阵
│ └── 否 → 邻接表
└── 否 → 邻接表(始终)
└── 还需要 Kruskal?→ 同时维护边列表
默认规则: 从邻接表开始。只在 V 明确较小(≤ 1500)或需要 Floyd-Warshall 时才切换到邻接矩阵。
5.1.3 读取图的输入
你已经了解了数据结构——现在把它们与真实的 USACO 输入联系起来。立即识别输入格式可以节省宝贵的竞赛时间。以下是你会遇到的五种格式:
格式一:标准边列表(最常见)
5 4 ← n 个顶点,m 条边(第一行)
1 2 ← 之后每行:一条无向边
2 3
3 4
4 5
int n, m;
cin >> n >> m;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u); // 有向图省略此行
}
格式二:加权边列表
4 5 ← n 个顶点,m 条边
1 2 10 ← 边 1-2,权重 10
1 3 5 ← 边 1-3,权重 5
2 3 3
2 4 8
3 4 2
int n, m;
cin >> n >> m;
vector<vector<pair<int,int>>> adj(n + 1);
// adj[u] = {邻居, 权重} 对的列表
for (int i = 0; i < m; i++) {
int u, v, w;
cin >> u >> v >> w;
adj[u].push_back({v, w});
adj[v].push_back({u, w}); // 无向加权图
}
// C++17 结构化绑定遍历:
for (auto& [v, w] : adj[1]) {
cout << "1 -> " << v << "(权重 " << w << ")\n";
}
格式三:通过父节点数组表示树
5 ← n 个节点;根始终是节点 1
2 3 1 1 ← 节点 2、3、4、5 的父节点
int n;
cin >> n;
vector<vector<int>> children(n + 1);
vector<int> par(n + 1, 0);
for (int i = 2; i <= n; i++) {
cin >> par[i];
children[par[i]].push_back(i); // 有向:父节点 -> 子节点
}
// par[1] = 0(根节点无父节点)
格式四:网格图(USACO Bronze/Silver 非常常见)
4 5 ← R 行,C 列
..... ← '.' = 可通行,'#' = 墙/障碍
.##..
.....
.....
单元格是节点;相邻的可通行单元格共享一条边。不需要显式邻接表——使用方向 delta 数组:
int R, C;
cin >> R >> C;
vector<string> grid(R);
for (int r = 0; r < R; r++) cin >> grid[r];
// 4 方向:上、下、左、右
const int dr[] = {-1, 1, 0, 0};
const int dc[] = { 0, 0, -1, 1};
// 在单元格 (r, c) 处,遍历有效的可通行邻居:
auto neighbors = [&](int r, int c) {
vector<pair<int,int>> result;
for (int d = 0; d < 4; d++) {
int nr = r + dr[d];
int nc = c + dc[d];
if (nr >= 0 && nr < R && nc >= 0 && nc < C && grid[nr][nc] != '#') {
result.push_back({nr, nc});
}
}
return result;
};
专业技巧: 8 方向移动(包括对角线):
const int dr[] = {-1,-1,-1, 0, 0, 1, 1, 1}; const int dc[] = {-1, 0, 1,-1, 1,-1, 0, 1};
将单元格压缩为一个整数(适合 visited 数组):
// 单元格 (r, c) → 整数 ID:r * C + c(0-indexed)
int cellId(int r, int c, int C) { return r * C + c; }
// 反向:id → (id / C, id % C)
格式五:含自环和重边的边列表
// 跳过自环(若题目中无意义):
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
if (u == v) continue; // 自环:跳过
adj[u].push_back(v);
adj[v].push_back(u);
}
// 去除重边(只构建简单图):
set<pair<int,int>> seen;
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
if (u > v) swap(u, v); // 规范化:始终 u < v
if (seen.insert({u, v}).second) {
// .second = true 意味着是新插入的(非重复)
adj[u].push_back(v);
adj[v].push_back(u);
}
}
5.1.4 树——图的特殊类型
树是图最重要的特殊情况。它出现在 USACO 的每个级别——Bronze 到 Platinum。掌握树等于掌握了图论的一半。
树是满足以下所有条件的图(这些条件互相等价):
- 连通且恰好有 N − 1 条边
- 连通且无环
- 任意两个顶点之间恰好有一条简单路径
- 最小连通:去掉任意一条边就会断开

1 ← 根节点(深度 0)
/ \
2 3 ← 深度 1
/ \ \
4 5 6 ← 深度 2(4、5、6 是叶节点)
树的术语
| 术语 | 定义 | 示例(上图) |
|---|---|---|
| 根 | 指定的顶部节点(深度 0) | 节点 1 |
| 父节点 | 直接在上方的唯一节点 | parent(4) = 2 |
| 子节点 | 直接在下方的节点 | children(2) = {4, 5} |
| 叶节点 | 没有子节点的节点 | 节点 4、5、6 |
| 深度 | 到根的距离 | depth(6) = 2 |
| 节点 u 的高度 | 从 u 到叶节点的最长路径 | height(2) = 1 |
| 树的高度 | 任意节点的最大深度 | 2 |
| 子树(u) | 节点 u 及其所有后代 | subtree(2) = {2,4,5} |
| u 的祖先 | 从 u 到根路径上的任意节点 | ancestors(6) = {3, 1} |
| LCA(u, v) | 最近公共祖先 | LCA(4, 6) = 1 |
给树确定根(标准 DFS 模板)
几乎所有树问题都需要选定一个根并计算父子关系。标准做法:将树作为无向图读取,然后用 DFS 确定根:
int n;
cin >> n;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < n - 1; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u); // 无向树边
}
vector<int> parent(n + 1, 0);
vector<int> depth(n + 1, 0);
vector<vector<int>> children(n + 1);
// 以节点 1 为根,用迭代 DFS(N 最大 10^5 时安全)
// 递归 DFS 对链(N = 10^5 深的路径)可能栈溢出
function<void(int, int)> rootTree = [&](int u, int par) {
parent[u] = par;
for (int v : adj[u]) {
if (v != par) { // v != par 避免向上回溯
children[u].push_back(v);
depth[v] = depth[u] + 1;
rootTree(v, u);
}
}
};
rootTree(1, 0); // 根 = 1,哨兵父节点 = 0
rootTree(1, 0) 完成后:
parent[u]= 节点 u 的父节点(若 u 是根则为 0)children[u]= 有根树中 u 的子节点列表depth[u]= u 从根开始的深度
⚠️ 深树的栈溢出警告: 对 10^5 长度的链图做递归 DFS 会溢出默认栈(通常 1–8 MB)。对于大型树,使用带显式栈的迭代 DFS 或增大栈大小。
迭代(栈安全)版本:
// 迭代 rootTree:BFS 顺序,任何树形状都安全
vector<int> order;
queue<int> bfsQ;
vector<bool> visited(n + 1, false);
bfsQ.push(1);
visited[1] = true;
parent[1] = 0;
depth[1] = 0;
while (!bfsQ.empty()) {
int u = bfsQ.front(); bfsQ.pop();
order.push_back(u);
for (int v : adj[u]) {
if (!visited[v]) {
visited[v] = true;
parent[v] = u;
depth[v] = depth[u] + 1;
children[u].push_back(v);
bfsQ.push(v);
}
}
}
// order[] = BFS 遍历顺序(适用于自底向上 DP)
5.1.5 加权图——存储边的代价
目前为止,我们的边是「裸」的——只是说「A 连接到 B」。但许多题目给每条边赋予一个代价(距离、行程时间、容量)。以下是如何存储这些额外信息:
// 方式一:pair<int,int>——紧凑、常用
vector<vector<pair<int,int>>> adj(n + 1);
// adj[u] 存储 {v, w} 对
// 添加无向加权边 u–v,权重 w:
adj[u].push_back({v, w});
adj[v].push_back({u, w});
// 用 C++17 结构化绑定遍历:
for (auto& [v, w] : adj[u]) {
cout << u << " -> " << v << "(代价 " << w << ")\n";
}
// 方式二:struct Edge——对复杂图更清晰
struct Edge {
int to; // 目标顶点
int weight; // 边代价
};
vector<vector<Edge>> adj(n + 1);
// 添加边:
adj[u].push_back({v, w});
// 遍历:
for (const Edge& e : adj[u]) {
relax(u, e.to, e.weight);
}
什么时候用 long long 权重
若边权最大 10^9 且路径可能包含多条边,累积和可能溢出 32 位 int(最大约 2.1×10^9):
最坏情况:N = 10^5 个节点,所有边权 = 10^9
最长路径和 ≈ 10^5 × 10^9 = 10^14 → int 溢出!
Dijkstra / Bellman-Ford 的安全模板:
const long long INF = 2e18; // long long 距离的安全哨兵
vector<vector<pair<int, long long>>> adj(n + 1);
// ^^^^^^^^^^^ long long 权重
vector<long long> dist(n + 1, INF);
dist[src] = 0;
规则: 若边权超过 10^4 且路径可能超过几百条边,用
long long。拿不准时用long long——性能差异可以忽略不计。
5.1.6 常见错误
这些是初学者最常犯的 bug。记住它们——能节省大量调试时间。
⚠️ Bug #1——无向图缺少反向边(最常见!)
// 错误:只加一个方向 adj[u].push_back(v); // 忘了 adj[v].push_back(u) ! // 正确:无向图 = 两个方向 adj[u].push_back(v); adj[v].push_back(u);症状: BFS/DFS 只访问半个图;某些顶点看起来无法到达。
⚠️ Bug #2——邻接表大小差一
// 错误:大小 n,但顶点下标是 1..n → adj[n] 越界! vector<vector<int>> adj(n); // 正确:大小 n+1,用于 1-indexed 顶点 vector<vector<int>> adj(n + 1);
⚠️ Bug #3——局部邻接矩阵崩溃(栈溢出)
// 错误:~1 MB 在栈上 → 栈溢出 int main() { bool adj[1001][1001]; // 局部变量在栈上! } // 正确:全局数组(BSS 段,自动初始化为零) bool adj[1001][1001]; // 在 main() 之外 int main() { ... }
⚠️ Bug #4——V 很大时用邻接矩阵(MLE)
// 错误:V = 100,000 → 10 GB 内存! bool adj[100001][100001]; // 正确:V > 1500 时用邻接表 vector<vector<int>> adj(n + 1);
⚠️ Bug #5——访问网格前未检查边界
// 错误:可能访问 grid[-1][c] → 未定义行为! if (grid[nr][nc] != '#') { ... } // 正确:先检查边界 if (nr >= 0 && nr < R && nc >= 0 && nc < C && grid[nr][nc] != '#') { ... }
⚠️ Bug #6——加权图中距离整数溢出
// 错误:边权 = 10^9,路径有 10^5 条边 → 溢出 int dist[MAXN]; // 正确:距离数组用 long long long long dist[MAXN]; const long long INF = 2e18;
本章总结
核心要点
| 概念 | 核心规则 | 为什么重要 |
|---|---|---|
| 无向边 | 同时加 adj[u]←v 和 adj[v]←u | 忘一个方向 = Bug #1 |
| 有向边 | 只加 adj[u]←v | 与无向图不同! |
| 邻接表 | vector<vector<int>> adj(n+1) | 默认;O(V+E) 空间 |
| 邻接矩阵 | 全局 bool adj[MAXV][MAXV] | 只在 V ≤ 1500 时;O(1) 边查询 |
| 加权邻接表 | vector<pair<int,int>> 或结构体 | Dijkstra、Bellman-Ford |
| 加权矩阵 | int dist[MAXV][MAXV],INF 哨兵 | Floyd-Warshall |
| 边列表 | vector<{u,v,w}> 按权重排序 | Kruskal MST 算法 |
| 网格图 | dr[]/dc[] 方向数组 | 无需显式邻接表 |
| 树 | 连通 + N−1 条边 + 无环 | 支持高效子树 DP |
| long long 权重 | 当和可能超过 2×10^9 | 防止路径和溢出 |
与后续章节的联系
| 章节 | 使用本章什么内容 |
|---|---|
| 5.2 BFS & DFS | 本章构建的邻接表;本章是硬前置条件 |
| 5.3 树与 DSU | 树的表示 + 添加并查集数据结构 |
| 5.4 最短路径 | Dijkstra 用加权邻接表;Floyd 用加权矩阵 |
| 6.x 动态规划 | 网格图支持网格 DP;DAG 支持 DAG 上的 DP |
| 5.9 MST | Kruskal 用边列表;Prim 用邻接表 |
| 6.8 树形 DP | §5.1.4 的有根树结构;children[] 数组模式 |
| 5.13 欧拉序/LCA | 在 §5.1.4 的 depth[] 和 parent[] 上构建倍增 |
常见问题
Q:应该用 0-indexed 还是 1-indexed 顶点?
USACO 输入几乎总是 1-indexed(顶点标记为 1 到 N)。用
vector<vector<int>> adj(n + 1),槽位 0 留空不用。这直接与输入对应,避免差一错误。
Q:网格图需要显式邻接表吗?
不需要。网格邻居通过
dr[]/dc[]数组即时计算——内存效率更高,代码通常也更简洁。
Q:什么时候对边权用 long long?
当权重可达 10^9 且可能要对多条边求和时(最短路径、总代价)。10^9 × 路径长度很容易超过 2^31 − 1 ≈ 2.1×10^9。拿不准就用
long long。
练习题
题目 5.1.1 — 度数统计 🟢 简单
题目: 读取一个有 N 个顶点(1 ≤ N ≤ 10⁵)和 M 条边(0 ≤ M ≤ 2×10⁵)的无向图(顶点编号 1~N,可能有重边和自环,重边按条数计入度数),打印每个顶点的度数(与它相连的边数,自环计 2 次)。
输入格式: 第一行 N 和 M;接下来 M 行每行 u 和 v(1 ≤ u, v ≤ N)。
样例输入 1:
4 4
1 2
2 3
3 4
4 1
样例输出 1: 2 2 2 2
样例输入 2:
5 3
1 2
1 3
1 4
样例输出 2: 3 1 1 1 0
💡 提示
维护 degree[] 数组。对每条边 (u, v),做 degree[u]++ 和 degree[v]++。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<int> degree(n + 1, 0);
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
degree[u]++;
degree[v]++; // 无向图:两个端点各加 +1
}
for (int u = 1; u <= n; u++) {
cout << degree[u];
if (u < n) cout << " ";
}
cout << "\n";
return 0;
}
// 时间:O(N + M),空间:O(N)
题目 5.1.2 — 是树吗? 🟢 简单
题目: 给定一个有 N 个顶点(1 ≤ N ≤ 10⁵)和 M 条边(0 ≤ M ≤ 2×10⁵)的保证连通的无向图,判断它是否是一棵树。若是输出 YES,否则输出 NO。
样例输入 1:
5 4
1 2
1 3
3 4
3 5
样例输出 1: YES
样例输入 2:
4 4
1 2
2 3
3 4
4 1
样例输出 2: NO
💡 提示
对连通图:当且仅当 M = N − 1 时是树。不需要环检测——对连通图,边数本身就够了。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v; // 读边(此题不需要用它们)
}
cout << (m == n - 1 ? "YES" : "NO") << "\n";
return 0;
}
// 时间:O(M),空间:O(1)
⚠️ 注意: 这只在图被保证连通时有效。对可能不连通的图,还需用 BFS/DFS 验证连通性(第 5.2 章)。有 N−1 条边的不连通图是森林(多棵树),不是单棵树。
题目 5.1.3 — 有向图可达性 🟡 中等
题目: 给定有 N 个顶点(1 ≤ N ≤ 10⁵)、M 条有向边(0 ≤ M ≤ 2×10⁵)和两个顶点 S、T(1 ≤ S, T ≤ N)的有向图,沿有向边走,T 从 S 可达吗?可达输出 YES,否则输出 NO。
样例输入 1:
5 4 1 4
1 2
2 3
3 4
1 5
样例输出 1: YES(路径:1 → 2 → 3 → 4)
样例输入 2:
4 3 4 1
1 2
2 3
3 4
样例输出 2: NO(边只向前 1→2→3→4,不能反向)
💡 提示
构建有向邻接表(只加 adj[u].push_back(v),不加反向边)。从 S 运行 BFS,若 T 被访问则输出 YES。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m, S, T;
cin >> n >> m >> S >> T;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v); // 有向:只加一个方向
}
vector<bool> visited(n + 1, false);
queue<int> q;
visited[S] = true;
q.push(S);
while (!q.empty()) {
int u = q.front(); q.pop();
for (int v : adj[u]) {
if (!visited[v]) {
visited[v] = true;
q.push(v);
}
}
}
cout << (visited[T] ? "YES" : "NO") << "\n";
return 0;
}
// 时间:O(V + E),空间:O(V + E)
题目 5.1.4 — 叶节点计数 🟢 简单
题目: 有根树共 N 个节点(1 ≤ N ≤ 10⁵),根 = 节点 1,通过父节点数组给出(节点 2..N 的父节点,1 ≤ parent[i] < i 或为 1..N 中任意更小编号)。统计叶节点(无子节点的节点)数量。
样例输入:
5
1 1 2 2
样例输出: 3(树:1→{2,3},2→{4,5}。叶节点:3、4、5)
💡 提示
若一个节点从未作为父节点出现,它就是叶节点。追踪 hasChild[u],hasChild[u] = false 的节点就是叶节点。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<bool> hasChild(n + 1, false);
for (int i = 2; i <= n; i++) {
int parent;
cin >> parent;
hasChild[parent] = true; // 父节点至少有一个子节点
}
int leaves = 0;
for (int u = 1; u <= n; u++) {
if (!hasChild[u]) leaves++;
}
cout << leaves << "\n";
return 0;
}
// 时间:O(N),空间:O(N)
题目 5.1.5 — 网格边数统计 🟡 中等
题目: 读取一个 N×M 的网格(1 ≤ N, M ≤ 2000,. = 可通行,# = 墙),统计隐式无向图中的边数(两个水平或垂直相邻的可通行单元格共享一条边)。
输入格式: 第一行 N 和 M;接下来 N 行每行一个长度为 M 的字符串。
样例输入 1:
3 3
...
.#.
...
样例输出 1: 8
💡 提示
对每个可通行单元格,只检查其右和下邻居,避免重复计数。若两个单元格都可通行,计一条边。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<string> grid(n);
for (int r = 0; r < n; r++) cin >> grid[r];
int edges = 0;
for (int r = 0; r < n; r++) {
for (int c = 0; c < m; c++) {
if (grid[r][c] == '#') continue;
// 检查右邻居
if (c + 1 < m && grid[r][c+1] == '.') edges++;
// 检查下邻居
if (r + 1 < n && grid[r+1][c] == '.') edges++;
}
}
cout << edges << "\n";
return 0;
}
// 时间:O(N*M),空间:O(N*M)
题目 5.1.6 — 构建邻接矩阵并查询 🟢 简单
题目: 给定有 N 个顶点(1 ≤ N ≤ 500)和 M 条边(0 ≤ M ≤ N(N−1)/2)的无向无权图,构建邻接矩阵,回答 Q 次查询(1 ≤ Q ≤ 10⁵):对每次查询 (u, v)(1 ≤ u, v ≤ N,u ≠ v),若边 u–v 存在打印 1,否则打印 0。
样例输入:
4 4
1 2
1 3
2 4
3 4
3
1 2
2 3
1 4
样例输出:
1
0
0
💡 提示
O(M) 构建邻接矩阵,每次查询 O(1)。展示了当 Q 大而 N 小时邻接矩阵优于邻接表(每次查询 O(deg))的场景。
#include <bits/stdc++.h>
using namespace std;
const int MAXV = 501;
bool adj[MAXV][MAXV]; // 全局:自动初始化为零,不会栈溢出
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u][v] = true;
adj[v][u] = true; // 无向图
}
int q;
cin >> q;
while (q--) {
int a, b;
cin >> a >> b;
cout << (adj[a][b] ? 1 : 0) << "\n"; // 每次查询 O(1)!
}
return 0;
}
// 构建:O(M),每次查询:O(1),总计:O(M + Q)
第 5.2 章:BFS 与 DFS
5.2.0a 从两道题出发:迷宫与探索
图遍历算法探索从起点可到达的每个节点,是数十种图算法的基础。但「遍历」这个词太抽象——先看两道题,它们是 USACO Bronze/Silver 的常客:
🧩 题目 1:走出迷宫(最短步数) 一个
R×C网格迷宫(1 ≤ R, C ≤ 1000),.是空地,#是墙。奶牛从左上角出发,每步上下左右移动一格。求最少几步走到右下角;若无法到达输出 −1。 数据规模:1 ≤ R, C ≤ 1000;保证左上角和右下角都是.。
🔍 题目 2:数房间(连通块) 同样的网格(
1 ≤ R, C ≤ 1000),问里面有多少个互相连通的.区域(房间)。四连通(上下左右相邻算连通)。
先试试你会的方法
题目 1 用第 2 章的循环枚举? 「最少步数」——从起点出发,第 1 步能到哪些格子?第 2 步呢?最短路径恰好是一圈一圈向外扩散的:能 k 步到达的格子,必然紧挨着某个 k−1 步到达的格子。逐层扩散 → 先到先处理 → 队列(第 3.5 章)!这就是 BFS。
题目 2 用什么? 要数连通块,就得「从一个格子出发访遍它所在的整个房间」。一条路走到黑、走不动就回头换条路——栈/递归!这就是 DFS。
两道题、两种「走法」,就是本章的两大主角:
| 题目 | 遍历方式 | 用到的第 3.5 章结构 |
|---|---|---|
| 最短步数 | 一层一层扩散 | 队列(FIFO) |
| 数房间 | 走到底再回溯 | 栈 / 递归(LIFO) |
拆解这两道题需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 5.2.0b | 选型速查:拿到图论题,何时 BFS 何时 DFS? |
| 5.2.1 | DFS:递归与回溯(深入到底再折返) |
| 5.2.2–5.2.5 | 连通块、洪水填充(题目 2 的解法) |
| 5.2.3 | BFS:逐层扩散与最短步数(题目 1 的解法) |
| 5.2.4–5.2.6 | 网格 BFS 与多源 BFS |
| 5.2.7–5.2.8 | 两者对比、DFS 环检测 |
5.2.0b BFS / DFS 选择框架:先判断目标,再选工具
BFS 和 DFS 都能遍历图,但它们回答的问题不同。做 USACO 图论题时,先不要急着写模板,先问题目要的到底是什么。
| 题目目标 | 优先选择 | 原因 | 典型 USACO 场景 |
|---|---|---|---|
| 求无权图最短步数 | BFS | 按层扩展,第一次到达就是最短 | 迷宫、网格最短路、最少操作次数 |
| 求连通块/洪水填充 | DFS 或 BFS | 只需要访问所有可达点 | Counting Rooms、岛屿计数 |
| 枚举路径或回溯方案 | DFS | 递归天然保存当前路径 | 搜索排列、路径构造、回溯剪枝 |
| 检测有向图环 | DFS 三色标记 | 能区分正在访问和已完成 | 依赖关系、函数调用图 |
| 树的子树信息 | DFS | 后序返回子树结果 | 子树大小、树形 DP 入门 |
| 多个起点到最近源点距离 | 多源 BFS | 所有源点同时入队,距离自然最小 | 最近出口、最近危险点、扩散模型 |
💡 一句话判断: 题目出现「最少步数 / 最短操作次数 / 最近」时,优先想 BFS;题目出现「递归结构 / 子树 / 枚举路径 / 回溯」时,优先想 DFS。
四类易错点预警
后文会逐一展开代码实现,但先建立错误地图:
- 访问标记错误:BFS 应在入队时标记,DFS 应在进入节点时标记。
- 边界检查错误:网格题必须先判越界,再访问
grid[nr][nc]。 - 数据结构选错:BFS 用队列,DFS 用栈/递归;用 DFS 求最短路通常是错的。
- 递归深度风险:大网格或链状图递归 DFS 可能栈溢出,需改迭代 DFS/BFS。
5.2.1 深度优先搜索(DFS)
DFS 就像探索迷宫:一直向前走直到遇到死路,然后回溯尝试另一条路。它是最自然的图遍历——递归完成了大部分工作。
核心思想
想象你站在迷宫中的十字路口。DFS 说:选一条路,尽可能走到底。遇到死路(所有邻居都已访问),回溯到上一个十字路口,尝试下一条路。重复直到访问了所有可达节点。
这种「深入后回溯」的行为与递归完美对应:每次递归调用深入一步,从调用中返回就是回溯。
下方的追踪图展示了 DFS 在图中的完整访问过程:绿色实线箭头表示递归深入,红色虚线箭头表示回溯(返回),每个节点旁的黄色徽章标注访问顺序——最终输出为 1 2 4 5 6 3。
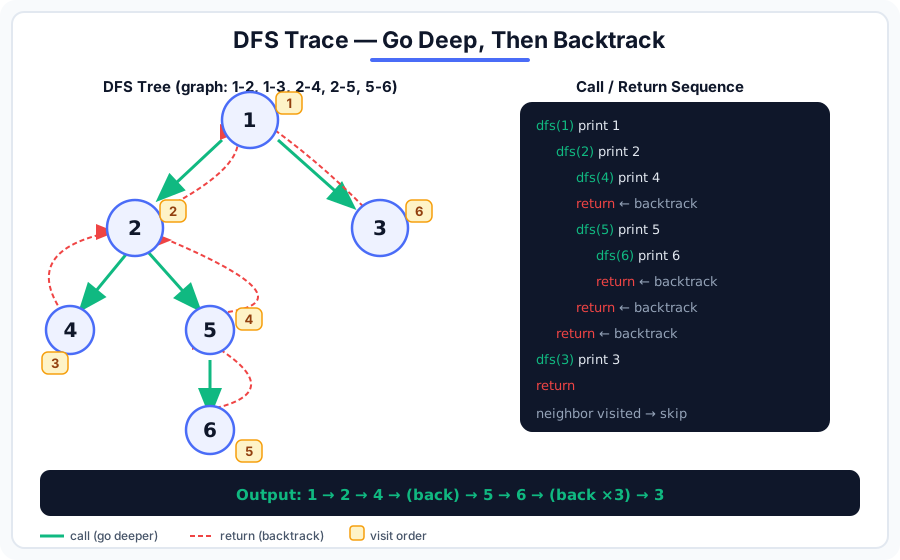
图示:DFS 遍历顺序

DFS 在回溯前尽量深入。带编号的圆圈展示访问顺序,红色虚线箭头展示回溯路径。右侧的调用栈说明了递归如何自然地实现 DFS 所需的 LIFO 行为。
递归 DFS
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
bool visited[MAXN];
void dfs(int u) {
visited[u] = true; // 标记当前节点为已访问
cout << u << " "; // 处理 u(本例中打印它)
for (int v : adj[u]) { // 对每个邻居 v
if (!visited[v]) { // 若尚未访问
dfs(v); // 递归探索 v
}
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
// 从节点 1 开始 DFS
dfs(1);
cout << "\n";
return 0;
}
逐步追踪:递归 DFS 如何工作
给定图(节点:1,2,3,4,5,6;边:1-2,1-3,2-4,2-5,5-6):
📄 给定图(节点:1,2,3,4,5,6;边:1-2,1-3,2-4,2-5,5-6):
DFS 从节点 1 开始——带调用栈的完整追踪:
调用:dfs(1)
visited[1] = true. 打印:1
节点 1 的邻居:[2, 3]
├── v=2:未访问 → 调用 dfs(2)
│ 调用:dfs(2)
│ visited[2] = true. 打印:2
│ 节点 2 的邻居:[1, 4, 5]
│ ├── v=1:已访问 → 跳过
│ ├── v=4:未访问 → 调用 dfs(4)
│ │ 调用:dfs(4)
│ │ visited[4] = true. 打印:4
│ │ 节点 4 的邻居:[2]
│ │ └── v=2:已访问 → 跳过
│ │ 从 dfs(4) 返回 ← 回溯!
│ ├── v=5:未访问 → 调用 dfs(5)
│ │ 调用:dfs(5)
│ │ visited[5] = true. 打印:5
│ │ 节点 5 的邻居:[2, 6]
│ │ ├── v=2:已访问 → 跳过
│ │ └── v=6:未访问 → 调用 dfs(6)
│ │ dfs(6):打印 6
│ │ 从 dfs(6) 返回 ← 回溯!
│ │ 从 dfs(5) 返回 ← 回溯!
│ 从 dfs(2) 返回 ← 回溯!
├── v=3:未访问 → 调用 dfs(3)
│ dfs(3):打印 3,无未访问邻居
│ 从 dfs(3) 返回 ← 回溯!
从 dfs(1) 返回
输出:1 2 4 5 6 3
💡 关键观察: 递归深度等于 DFS 树中从起始节点出发的最长路径。对于路径图 1→2→3→...→N,深度为 N——这就是栈溢出风险出现的时候。
重要: 始终在递归前而非之后标记节点为已访问!这能防止在环上无限循环。
复杂度分析
- 时间:
O(V + E)—— 每个顶点恰好访问一次(visited[]检查),每条边恰好检查两次(无向图中从两端各一次),总计 O(V + E)。 - 空间:
O(V)——visited[]数组使用 O(V),递归调用栈最坏情况深度 O(V)。
迭代 DFS(使用栈)
对于非常大的图,递归 DFS 可能导致栈溢出(递归太深)。默认栈大小通常为 1–8 MB,每个递归层次使用约 100–200 字节。当图深度超过约 10^4–10^5 时会崩溃。
迭代版本用显式的 stack<int> 替换系统调用栈:
void dfs_iterative(int start, int n) {
vector<bool> visited(n + 1, false);
stack<int> st;
st.push(start);
while (!st.empty()) {
int u = st.top();
st.pop();
if (visited[u]) continue; // 可能被多次压入
visited[u] = true;
cout << u << " ";
for (int v : adj[u]) {
if (!visited[v]) {
st.push(v);
}
}
}
}
⚠️ 注意: 迭代 DFS 访问节点的顺序可能与递归 DFS 不同。对大多数题目这无所谓——两者都访问所有可达节点。
何时用迭代 DFS:
- 图深度可能超过约 10^4(如路径图、链)
- N×M ≥ 10^6 格子的网格问题
- 任何担心栈溢出的时候
5.2.2 连通分量
连通分量是顶点的最大集合,其中每个顶点都能通过边到达其他所有顶点。把它想象成连接节点的「岛屿」——从分量中任意节点开始 DFS,会访问同一分量中的所有其他节点,但不会访问外面的节点。

算法:用 DFS 给每个分量标记
策略很简单:
- 从 1 到 N 扫描所有节点
- 找到未访问节点时,这是一个新分量的起点
- 从该节点运行 DFS,给所有可达节点打上相同的分量 ID
- 重复直到所有节点都被标记
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
int comp[MAXN]; // comp[v] = 顶点 v 的分量 ID(0 = 未访问)
void dfs(int u, int id) {
comp[u] = id;
for (int v : adj[u]) {
if (comp[v] == 0) { // 0 表示未访问
dfs(v, id);
}
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
int numComponents = 0;
for (int u = 1; u <= n; u++) {
if (comp[u] == 0) {
numComponents++;
dfs(u, numComponents); // 分配分量 ID
}
}
cout << "分量数量:" << numComponents << "\n";
// 打印各分量大小
vector<int> sz(numComponents + 1, 0);
for (int u = 1; u <= n; u++) sz[comp[u]]++;
for (int i = 1; i <= numComponents; i++) {
cout << "分量 " << i << ":" << sz[i] << " 个节点\n";
}
return 0;
}
常见 USACO 应用
连通分量以多种形式出现:
- 「有多少组?」 —— 统计分量数
- 「A 和 B 连通吗?」 —— 检查
comp[A] == comp[B] - 「最大组的大小?」 —— 找节点最多的分量
- 「加 K 条边能使图连通吗?」 —— 需要恰好
numComponents - 1条边
💡 替代方案:并查集(DSU) 也可以找连通分量,并支持动态添加边。我们将在第 5.5 章介绍 DSU。
5.2.3 广度优先搜索(BFS)
BFS 先探索所有距离为 1 的节点,再探索距离为 2 的,然后 3,以此类推。这使它非常适合在无权图中寻找最短路径。DFS 深入,BFS 扩张——就像池塘里的涟漪。
核心思想
BFS 使用队列(FIFO:先进先出)按距离源点的顺序处理节点:
- 从源节点(距离 0)开始
- 访问其所有邻居(距离 1)
- 访问其未访问的邻居(距离 2)
- 继续直到访问了所有可达节点
队列确保距离 d 的所有节点在距离 d+1 的任何节点之前被处理。这种逐层扩展保证了最短路径。
图示:BFS 逐层遍历

BFS 像池塘里的涟漪向外扩散。每「层」节点颜色不同,展示了距源点距离 d 的所有节点在距离 d+1 的任何节点之前被发现。底部的队列展示了处理顺序。
BFS 模板
以下 BFS 模板是本章最重要的代码模式,你会在数十道题中用到它(或它的变体)。
// BFS 最短路径 — O(V + E)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
// 返回从源点到所有顶点的最短距离数组
// dist[v] = -1 表示不可达
vector<int> bfs(int source, int n) {
vector<int> dist(n + 1, -1); // -1 = 未访问(也作为「已访问」标记)
queue<int> q;
dist[source] = 0; // 到源点的距离为 0
q.push(source); // 用源点初始化队列
while (!q.empty()) {
int u = q.front(); // 取出最早发现的节点
q.pop();
for (int v : adj[u]) { // 对 u 的每个邻居
if (dist[v] == -1) { // 若 v 尚未访问
dist[v] = dist[u] + 1; // ← 关键行:v 比 u 多一跳
q.push(v); // 将 v 加入队列以供未来处理
}
}
}
return dist;
}
关键部分逐行分析:
| 行 | 作用 | 为什么重要 |
|---|---|---|
dist(n+1, -1) | 将所有距离初始化为 -1 | -1 表示「尚未到达」——同时作为已访问标记 |
dist[source] = 0 | 源点到自身的距离为 0 | BFS 的起始点 |
q.push(source) | 初始化队列 | BFS 需要至少一个节点才能开始 |
u = q.front(); q.pop() | 处理最早发现的节点 | FIFO 顺序保证逐层处理 |
if (dist[v] == -1) | 只访问未访问的节点 | 防止重复访问和无限循环 |
dist[v] = dist[u] + 1 | 关键行 —— 距离加 1 | 无权图中每条边权重为 1 |
q.push(v) | 将 v 排队等待处理 | v 的邻居将在后续探索 |
BFS 为什么找到最短路径
BFS 按距离源点的顺序处理节点。第一次访问一个节点时,一定是通过最短路径。这是因为 BFS 在访问距离 d+1 的任何节点之前,会访问所有距离 d 的节点。
💡 核心思路: 把 BFS 想象成在水中投石——涟漪一层层向外扩散。距离 d 的所有单元格在距离 d+1 的任何单元格之前被处理。这种逐层处理保证了第一次到达任何节点都是通过最短路径。
BFS vs DFS 最短路径:
- BFS:保证无权图的最短路径 ✓
- DFS:不保证最短路径 ✗
5.2.4 网格 BFS——最常见的 USACO 模式
许多 USACO 题目给你一个有可通行(.)和阻塞(#)格子的网格。BFS 找从一个格子到另一个格子的最短路径。
图示:网格 BFS 距离洪水填充

从中心格子(距离 0)开始,BFS 扩展到所有可达格子,记录到达每个格子所需的最少步数。颜色越蓝表示越远。这正是 USACO 洪水填充和网格最短路径题目的工作方式。
USACO 风格的网格 BFS 题目:迷宫最短路
题目: 给定一个有墙(#)和开放格子(.)的迷宫,找从左上角 (0,0) 到右下角 (R−1, C−1) 的最短路径。打印长度,若无路径输出 -1。
数据规模: 1 ≤ R, C ≤ 1000(即最多 10⁶ 个格子,BFS 的 O(R×C) 恰好够用);格子只含 . 或 #,保证起点和终点都是 .。
// 网格 BFS 最短路径 — O(R × C)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int R, C;
cin >> R >> C;
vector<string> grid(R);
for (int r = 0; r < R; r++) cin >> grid[r];
// 找起点 (S) 和终点 (E),或使用固定角落
int sr = 0, sc = 0, er = R-1, ec = C-1;
// BFS 距离数组:-1 = 未访问
vector<vector<int>> dist(R, vector<int>(C, -1));
queue<pair<int,int>> q;
// 第一步:从源点初始化 BFS
dist[sr][sc] = 0;
q.push({sr, sc});
// 第二步:方向数组(上、下、左、右)
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
// 第三步:BFS 扩展
while (!q.empty()) {
auto [r, c] = q.front();
q.pop();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d];
int nc = c + dc[d];
if (nr >= 0 && nr < R // 行在界内
&& nc >= 0 && nc < C // 列在界内
&& grid[nr][nc] != '#' // 不是墙
&& dist[nr][nc] == -1) { // ← 关键行:尚未访问
dist[nr][nc] = dist[r][c] + 1;
q.push({nr, nc});
}
}
}
// 第四步:输出结果
if (dist[er][ec] == -1) {
cout << -1 << "\n"; // 无路径
} else {
cout << dist[er][ec] << "\n";
}
return 0;
}
⚠️ 常见错误: 在迷宫最短路中用 DFS 代替 BFS。DFS 可能找到一条路,但不是最短路。始终用 BFS 求无权网格的最短距离。
5.2.5 USACO 示例:洪水填充
USACO 喜欢「洪水填充」题目:找所有连通的同类型格子,或统计连通区域数。洪水填充本质上是网格上的 DFS/BFS——从种子格子开始「绘制」所有可达的同类型格子。
题目:统计连通区域
题目: 给定 R×C 网格(1 ≤ R, C ≤ 1000,格子只含 . 或 #),统计网格中「.」格子的不同连通区域数量(四连通)。
. . # # .
. . # . .
# # # . .
. . . # #
. . . # .
「.」格子的区域:
区域 1: 区域 2: 区域 3:
. . . .
. . . . . .
. . . .
答案:3 个区域。
完整代码(带详细注释)
#include <bits/stdc++.h>
using namespace std;
int R, C;
vector<string> grid;
vector<vector<bool>> visited;
void floodFill(int r, int c) {
// 基础情况:越界时停止递归
if (r < 0 || r >= R || c < 0 || c >= C) return; // 越界
if (visited[r][c]) return; // 已访问
if (grid[r][c] == '#') return; // 墙(不是目标类型)
// 标记此格子为已访问(当前区域的一部分)
visited[r][c] = true;
// 向 4 个方向递归
floodFill(r - 1, c); // 上
floodFill(r + 1, c); // 下
floodFill(r, c - 1); // 左
floodFill(r, c + 1); // 右
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> R >> C;
grid.resize(R);
visited.assign(R, vector<bool>(C, false));
for (int r = 0; r < R; r++) cin >> grid[r];
int regions = 0;
for (int r = 0; r < R; r++) {
for (int c = 0; c < C; c++) {
if (!visited[r][c] && grid[r][c] == '.') {
regions++; // 找到新的未访问「.」格子 → 新区域!
floodFill(r, c); // 将此区域的所有格子标记为已访问
}
}
}
cout << regions << "\n";
return 0;
}
变体:BFS 洪水填充(避免栈溢出)
对于大网格(R × C ≥ 10^6),递归洪水填充可能栈溢出。改用 BFS:
void floodFillBFS(int sr, int sc) {
queue<pair<int,int>> q;
visited[sr][sc] = true;
q.push({sr, sc});
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr >= 0 && nr < R && nc >= 0 && nc < C
&& !visited[nr][nc] && grid[nr][nc] == '.') {
visited[nr][nc] = true;
q.push({nr, nc});
}
}
}
}
💡 USACO 技巧: 洪水填充在 Bronze 和 Silver 级别非常常见。常见变体包括:统计区域数、找最大区域、检查两个格子是否在同一区域以及计算区域的周长。
5.2.6 多源 BFS
有时需要计算每个格子到最近特殊格子的距离——例如「每个空格子到最近火焰有多远?」从每个火焰格子分别启动 BFS 是 O(K × R × C)(K 是火焰数量)——太慢了。多源 BFS 一次 O(R × C) 的遍历就能解决。

核心思想
不是从一个源点运行 BFS,而是在开始 BFS 之前将所有源点格子压入队列,距离为 0。然后正常运行 BFS。每个格子都被分配到其最近源点的距离——由 BFS 的逐层性质保证。
为什么有效? 想象一个虚拟「超级源点」S* 通过代价为 0 的边连接到所有真实源点。从 S* 做 BFS 会先访问所有真实源点(距离 0),然后是其邻居(距离 1),以此类推。多源 BFS 正是如此——不需要真正创建虚拟节点。
代码模板
// 多源 BFS:同时从所有火焰格子出发
queue<pair<int,int>> q;
vector<vector<int>> dist(R, vector<int>(C, -1));
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
// 第一步:在开始 BFS 之前将所有源点以距离 0 压入队列
for (int r = 0; r < R; r++) {
for (int c = 0; c < C; c++) {
if (grid[r][c] == 'F') { // 火焰格子 = 源点
dist[r][c] = 0;
q.push({r, c});
}
}
}
// 第二步:从所有源点同时运行 BFS
while (!q.empty()) {
auto [r, c] = q.front();
q.pop();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr >= 0 && nr < R && nc >= 0 && nc < C
&& grid[nr][nc] != '#' && dist[nr][nc] == -1) {
dist[nr][nc] = dist[r][c] + 1;
q.push({nr, nc});
}
}
}
// BFS 后:dist[r][c] = (r,c) 到最近火焰格子的最小距离
💡 核心思路: 队列中源点的顺序无关紧要。BFS 先处理所有距离 0 的格子,再处理距离 1 的格子,以此类推。每个格子保证被最近的源点首先到达。
5.2.7 DFS vs BFS——何时用哪种
这是图问题中最重要的决策之一。以下是综合指南:
快速参考表
| 任务 | 用 | 原因 |
|---|---|---|
| 最短路径(无权) | BFS ✓ | 逐层保证最短 |
| 连通性/连通分量 | 任意 | 两者都行;DFS 递归更简单 |
| 环检测(有向) | DFS ✓ | 三色方案追踪当前路径 |
| 环检测(无向) | 任意 | DFS 加父节点检查,或 DSU |
| 拓扑排序 | DFS ✓ | 后序给出逆拓扑顺序 |
| 洪水填充 | 任意(DFS 更简单) | DFS 递归简洁 |
| 二部图检查 | BFS 或 DFS | 用任意方法 2-染色 |
| 到所有节点的距离 | BFS ✓ | BFS 自然计算所有距离 |
| 树遍历(前/中/后序) | DFS ✓ | 递归自然映射到树结构 |
| 路径是否存在(是/否) | 任意 | 两者都找所有可达节点 |
| 最近源点(多源) | BFS ✓ | 多源 BFS 是标准做法 |
决策流程图
需要最短路径/最少步数吗?
├── 是 → 用 BFS(始终!)
└── 否 → 需要探索路径/检测回边吗?
├── 是 → 用 DFS(递归追踪当前路径)
└── 否 → 任意都行,DFS 代码通常更短
💡 核心思路: 需要「最少步数」时用 BFS。只需要访问所有节点或检查路径属性(环、拓扑顺序、子树性质)时用 DFS。
USACO 经验法则:
- Bronze/Silver 网格题: BFS 最短路,DFS 洪水填充
- Silver 图论题: BFS 求距离,DFS 求分量
- Gold: DFS 拓扑排序、环检测;BFS 多源距离
⚠️ 第 5.2 章常见错误
错误一:用 DFS 求最短路径
DFS 深入探索一条路径,不保证最少步数。无权图的最短路径始终用 BFS。
错误二:网格 BFS 忘记边界检查
nr >= 0 && nr < R && nc >= 0 && nc < C —— 缺少其中任意一个条件都会导致越界崩溃。
// ✅ 正确:先检查边界,再检查网格
if (nr >= 0 && nr < R && nc >= 0 && nc < C && grid[nr][nc] != '#')
错误三:弹出时而非压入时标记已访问
如果弹出时才标记已访问,同一个节点可能被多次压入,导致 O(V²) 的时间而非 O(V+E)。
为什么会这样——场景: 考虑一个节点 X,它有三个邻居 A、B、C,且这三个邻居此时都已经在队列中(同一 BFS 层)。当我们依次把它们出队时,每一个都会查看 X 并问:"X 被访问过了吗?"

// ❌ 错误:弹出时才标记 → 同一节点会被多次压入
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
if (visited[r][c]) continue; // 浪费:队列中已经有很多份了
visited[r][c] = true;
for (...) {
if (!visited[nr][nc]) {
q.push({nr, nc}); // 可能被多个邻居重复压入!
}
}
}
// ✅ 正确:压入时立即标记 → 每个节点恰好压入一次
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
for (...) {
if (dist[nr][nc] == -1) {
dist[nr][nc] = dist[r][c] + 1; // 立即标记
q.push({nr, nc}); // 恰好压入一次
}
}
}
错误版本的执行追踪(A、B、C 依次出队,X 是它们共同的邻居):
| 步骤 | 出队 | visited[X]? | 对 X 的操作 | 本步后队列 |
|---|---|---|---|---|
| 1 | A | false | 压入 X | [B, C, X] |
| 2 | B | 仍是 false! | 再次压入 X | [C, X, X] |
| 3 | C | 仍是 false! | 再次压入 X | [X, X, X] |
| 4 | X | false → 置为 true | — | [X, X] |
| 5 | X | true → 跳过 | — | [X] |
| 6 | X | true → 跳过 | — | [] |
X 被入队 3 次、出队 3 次;只有第 4 步真正处理了它,第 5、6 步都是无用功。
影响: 在 1000×1000 的网格上(每格约 4 个邻居),错误版本可能将 多达 4 倍 的条目压入队列(400 万而非 100 万)——导致 TLE 或 MLE。最坏情况下(V 个节点、E = O(V²) 边的稠密图),错误版本的队列操作达 O(V + E) = O(V²);正确版本保证恰好 V 次压入。稀疏图(E = O(V))下两者都是 O(V),但错误版本常数更大。
错误四:递归 DFS 栈溢出
对 N×M = 10^6 的网格,递归 DFS 可能超出默认栈大小(通常 1–8 MB)。改用迭代 BFS 或带显式栈的迭代 DFS。
错误五:0-indexed vs 1-indexed 起点用错
确保从正确的格子开始 BFS。USACO 题目有时用 1-indexed 网格,有时 0-indexed。
本章总结
📌 核心要点
| 算法 | 数据结构 | 时间 | 空间 | 最适合 |
|---|---|---|---|---|
| DFS(递归) | 调用栈 | O(V+E) | O(V) | 连通性、环检测、树问题 |
| DFS(迭代) | 显式栈 | O(V+E) | O(V) | 同上,避免栈溢出 |
| BFS | 队列 | O(V+E) | O(V) | 最短路径、逐层遍历 |
| 多源 BFS | 队列(多源预填充) | O(V+E) | O(V) | 到最近源点的距离 |
| 三色 DFS | 颜色数组 | O(V+E) | O(V) | 有向图环检测 |
| 拓扑排序 | DFS/BFS(Kahn) | O(V+E) | O(V) | DAG 上的排序/DP |
❓ 常见问题
Q1:BFS 和 DFS 的时间复杂度都是 O(V+E),为什么 BFS 能找最短路径而 DFS 不能?
A:关键在访问顺序。BFS 用队列保证「先处理距离 d 的节点,再处理距离 d+1 的节点」,所以第一次到达一个节点始终是通过最短路径。DFS 用栈(或递归),可能经过长路到达节点,错过更短的路。
Q2:什么时候递归 DFS 会栈溢出?怎么修复?
A:默认栈大小约 1-8 MB,每次递归层次约用 100-200 字节。图深度超过约 10^4–10^5 时可能溢出。解决方案:① 切换到迭代 DFS(显式栈);② 编译时增加栈大小。
Q3:网格 BFS 中为什么用 dist == -1 表示未访问而不是 visited 数组?
A:用
dist[r][c] == -1一举两得:同时记录「访问了没」和「到达的距离」。少一个数组,代码更简洁。
Q4:DFS 拓扑排序和 Kahn's BFS 拓扑排序,什么时候用哪个?
A:DFS 拓扑排序代码更短(直接反转后序),但 Kahn's 更直观,能检测环(若最终排序长度 < N,有环)。竞赛中两者都常见,选用你更熟悉的。
🔗 与后续章节的联系
- 第 5.5 章(二叉树与树算法):树遍历(前/后序)本质上就是 DFS;第 5.6 章(并查集)处理动态连通性
- 第 6.1–6.3 章(DP):「DAG 上的 DP」需要先做拓扑排序,再按拓扑顺序计算 DP
- BFS 最短路径是 Dijkstra(Gold 级别)的简化版——Dijkstra 处理加权图,BFS 处理无权图
- 多源 BFS 在 USACO Silver 中极为常见,是必须掌握的核心技术
练习题
题目 5.2.1 — 岛屿计数 🟢 简单
题目: 给定 N×M 网格,每个格子是 .(水)或 #(陆地)。水平或垂直相邻的陆地格子属于同一岛屿。统计不同岛屿的总数。
数据规模: 1 ≤ N, M ≤ 1000;格子只含 . 或 #。
样例输入 1:
4 5
.###.
.#.#.
.###.
.....
样例输出 1: 1(所有 # 格子相连——一个岛屿)
样例输入 2:
3 5
#.#.#
.....
#.#.#
样例输出 2: 6(六个孤立的陆地格子,各自是一个岛屿)
💡 提示
扫描每个格子。找到未访问的 # 格子时,岛屿数加一,运行 DFS/BFS 标记所有相连的 # 格子为已访问。
#include <bits/stdc++.h>
using namespace std;
int R, C;
vector<string> grid;
vector<vector<bool>> visited;
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
void dfs(int r, int c) {
if (r < 0 || r >= R || c < 0 || c >= C) return;
if (visited[r][c] || grid[r][c] == '.') return;
visited[r][c] = true;
for (int d = 0; d < 4; d++)
dfs(r + dr[d], c + dc[d]);
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> R >> C;
grid.resize(R);
visited.assign(R, vector<bool>(C, false));
for (int r = 0; r < R; r++) cin >> grid[r];
int islands = 0;
for (int r = 0; r < R; r++)
for (int c = 0; c < C; c++)
if (!visited[r][c] && grid[r][c] == '#') {
islands++;
dfs(r, c);
}
cout << islands << "\n";
return 0;
}
// 时间:O(N×M),空间:O(N×M)
题目 5.2.2 — 迷宫最短路 🟢 简单
题目: 给定带 S(起点)、E(终点)、.(可通行)和 #(墙)的 N×M 迷宫,找从 S 到 E 的最少步数(只能上下左右移动)。若无路径输出 −1。
数据规模: 1 ≤ N, M ≤ 1000;网格中恰好有一个 S 和一个 E。
样例输入 1:
5 5
S...#
####.
....E
.####
.....
样例输出 1: 10
样例输入 2:
3 3
S#E
.#.
...
样例输出 2: -1
💡 提示
从 S 开始 BFS。BFS 第一次到达 E 时,dist[E] 就是最少步数。BFS 结束仍未到达 E 则输出 −1。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int R, C;
cin >> R >> C;
vector<string> grid(R);
for (int r = 0; r < R; r++) cin >> grid[r];
int sr, sc, er, ec;
for (int r = 0; r < R; r++)
for (int c = 0; c < C; c++) {
if (grid[r][c] == 'S') { sr = r; sc = c; }
if (grid[r][c] == 'E') { er = r; ec = c; }
}
vector<vector<int>> dist(R, vector<int>(C, -1));
queue<pair<int,int>> q;
dist[sr][sc] = 0;
q.push({sr, sc});
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr >= 0 && nr < R && nc >= 0 && nc < C
&& grid[nr][nc] != '#' && dist[nr][nc] == -1) {
dist[nr][nc] = dist[r][c] + 1;
q.push({nr, nc});
}
}
}
cout << dist[er][ec] << "\n";
return 0;
}
// 时间:O(N×M),空间:O(N×M)
题目 5.2.3 — 二部图检查 🟡 中等
题目: 若能将每个节点染成黑色或白色,且每条边都连接黑色节点和白色节点,则图是二部图。给定无向图,判断是否是二部图,打印 "BIPARTITE" 或 "NOT BIPARTITE"。
数据规模: 1 ≤ N ≤ 2×10⁵,0 ≤ M ≤ 2×10⁵;1 ≤ u, v ≤ N,无自环。图可能不连通(每个连通分量都要满足条件)。
样例输入 1: 4 个节点,边:1-2, 2-3, 3-4, 4-1 → BIPARTITE(4-环:1,3 黑,2,4 白)
样例输入 2: 3 个节点,边:1-2, 2-3, 3-1 → NOT BIPARTITE(三角形——奇数环不是二部图)
💡 提示
BFS 加 2-染色。给源点染色 0,对每个未染色的邻居染反色(1 - 当前颜色)。若邻居已有与当前节点相同的颜色,图不是二部图。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
vector<int> color(n + 1, -1);
bool bipartite = true;
for (int start = 1; start <= n && bipartite; start++) {
if (color[start] != -1) continue;
queue<int> q;
color[start] = 0;
q.push(start);
while (!q.empty() && bipartite) {
int u = q.front(); q.pop();
for (int v : adj[u]) {
if (color[v] == -1) {
color[v] = 1 - color[u];
q.push(v);
} else if (color[v] == color[u]) {
bipartite = false;
}
}
}
}
cout << (bipartite ? "BIPARTITE" : "NOT BIPARTITE") << "\n";
return 0;
}
题目 5.2.4 — 多源 BFS:最近火焰 🟡 中等
题目: 给定有火焰格子 F、可通行空格 . 和墙 # 的 N×M 网格,对每个空格打印到最近火焰格子的最小距离。墙不可穿越。若空格无法到达任何火焰,打印 −1。
数据规模: 1 ≤ N, M ≤ 1000;保证至少存在一个 F 格子。
样例输入:
3 4
.F..
.#.F
....
样例输出:
1 0 1 1
2 # 1 0
3 2 2 1
💡 提示
多源 BFS:在开始 BFS 之前,将所有 F 格子以距离 0 压入队列。然后 BFS 自然地给每个格子分配到最近火源的最小距离。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int R, C;
cin >> R >> C;
vector<string> grid(R);
for (auto& row : grid) cin >> row;
vector<vector<int>> dist(R, vector<int>(C, -1));
queue<pair<int,int>> q;
// 关键:将所有火源以距离 0 压入
for (int r = 0; r < R; r++)
for (int c = 0; c < C; c++)
if (grid[r][c] == 'F') {
dist[r][c] = 0;
q.push({r, c});
}
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr >= 0 && nr < R && nc >= 0 && nc < C
&& grid[nr][nc] != '#' && dist[nr][nc] == -1) {
dist[nr][nc] = dist[r][c] + 1;
q.push({nr, nc});
}
}
}
for (int r = 0; r < R; r++) {
for (int c = 0; c < C; c++) {
if (grid[r][c] == '#') cout << "# ";
else cout << dist[r][c] << " ";
}
cout << "\n";
}
return 0;
}
题目 5.2.5 — 经典问题:倒水问题(Water Jugs) 🔴 困难
题目: 有两个空桶,容量分别为 X 和 Y。可用操作:将任意一桶装满、倒空任意一桶、将一桶倒入另一桶(直到其中一个满或空)。找到任意一桶中恰好有 M 升的最少操作次数。若不可能,输出 −1。
数据规模: 1 ≤ X, Y ≤ 100,1 ≤ M ≤ max(X, Y)。状态空间至多 (X+1)×(Y+1) ≤ 10201 个,BFS 轻松处理。
样例输入: 3 5 4 → 输出: 6
💡 提示
建模为状态 BFS:每个状态是一对 (a, b),其中 a ∈ [0,X]、b ∈ [0,Y] 是当前数量。应用 6 种操作生成邻居状态。BFS 找从 (0,0) 到满足 a==M 或 b==M 的任意状态的最少操作。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int X, Y, M;
cin >> X >> Y >> M;
vector<vector<int>> dist(X + 1, vector<int>(Y + 1, -1));
queue<pair<int,int>> q;
dist[0][0] = 0;
q.push({0, 0});
while (!q.empty()) {
auto [a, b] = q.front(); q.pop();
// 生成所有 6 种可能操作
vector<pair<int,int>> next = {
{X, b}, // 装满桶 A
{a, Y}, // 装满桶 B
{0, b}, // 倒空桶 A
{a, 0}, // 倒空桶 B
{max(0, a+b-Y), min(Y, a+b)}, // 将 A 倒入 B
{min(X, a+b), max(0, a+b-X)} // 将 B 倒入 A
};
for (auto [na, nb] : next) {
if (dist[na][nb] == -1) {
dist[na][nb] = dist[a][b] + 1;
q.push({na, nb});
}
}
}
int ans = INT_MAX;
for (int a = 0; a <= X; a++)
if (dist[a][M] != -1) ans = min(ans, dist[a][M]);
for (int b = 0; b <= Y; b++)
if (dist[M][b] != -1) ans = min(ans, dist[M][b]);
cout << (ans == INT_MAX ? -1 : ans) << "\n";
return 0;
}
// 时间:O(X×Y × 6) = O(X×Y),空间:O(X×Y)
5.2.8 DFS 环检测——白/灰/黑染色
有向图环检测:三色 DFS
对于有向图,使用三色方案追踪 DFS 过程中每个节点的状态:
- 白色(0): 尚未访问
- 灰色(1): 当前在 DFS 调用栈中——已开始处理但尚未完成
- 黑色(2): 完全处理完——所有后代都已探索
核心思路: 当且仅当 DFS 遇到回边(当前节点到灰色节点的边)时,存在环。灰色节点在当前 DFS 路径上,所以指回它的边创建了环。
// 有向图环检测 — O(V+E)
vector<int> color; // 0=白, 1=灰, 2=黑
bool hasCycle = false;
void dfs(int u) {
color[u] = 1; // 标记为「处理中」(灰色)
for (int v : adj[u]) {
if (color[v] == 0) {
dfs(v); // 未访问:递归
} else if (color[v] == 1) {
hasCycle = true; // ← 回边:v 是 u 的祖先 → 有环!
}
// color[v] == 2:已完全处理,安全跳过
}
color[u] = 2; // 标记为「完成」(黑色)
}
无向图环检测(更简单!)
对于无向图,不需要三色。规则更简单:DFS 过程中,若遇到已访问的节点且不是当前节点的父节点,就有环。
// 无向图环检测 — O(V+E)
void dfs(int u, int parent) {
visited[u] = true;
for (int v : adj[u]) {
if (!visited[v]) {
dfs(v, u); // v 的父节点是 u
} else if (v != parent) {
hasCycle = true; // 已访问且不是父节点 → 有环!
}
}
}
// 调用:dfs(1, -1); // 从节点 1 开始,无父节点(用 -1 作哨兵)
5.2.9 拓扑排序
拓扑排序对**有向无环图(DAG)**的节点排序,使对每条边 u → v,u 在排序中排在 v 之前。
方法一:基于 DFS 的拓扑排序
// 拓扑排序(DFS)— O(V+E)
vector<int> topoOrder;
void dfs(int u) {
visited[u] = true;
for (int v : adj[u]) {
if (!visited[v]) dfs(v);
}
topoOrder.push_back(u); // ← 所有子节点处理完后加入(后序)
}
// 使用:
for (int u = 1; u <= n; u++)
if (!visited[u]) dfs(u);
reverse(topoOrder.begin(), topoOrder.end()); // 逆后序 = 拓扑顺序
方法二:Kahn 算法(基于 BFS 的拓扑排序)
// Kahn 算法:先处理入度为 0 的节点 — O(V+E)
vector<int> inDeg(n + 1, 0);
for (int u = 1; u <= n; u++)
for (int v : adj[u])
inDeg[v]++;
queue<int> q;
for (int u = 1; u <= n; u++)
if (inDeg[u] == 0) q.push(u); // 从无前置条件的节点开始
vector<int> order;
while (!q.empty()) {
int u = q.front(); q.pop();
order.push_back(u);
for (int v : adj[u]) {
inDeg[v]--;
if (inDeg[v] == 0) q.push(v);
}
}
// 若 order.size() != n,有环(不是 DAG)
if ((int)order.size() != n) cout << "有环\n";
else for (int u : order) cout << u << " ";
💡 关键应用: 拓扑排序是 DAG 上 DP 的基础。若依赖关系图是 DAG,按拓扑顺序处理节点——每个节点的 DP 状态只依赖之前处理过的节点。
5.2.10 变种一:0-1 BFS(权重只有 0 和 1)
问题引入
普通 BFS 只能处理无权图(每步代价相同)。当图的边权只有 0 或 1 时,用 Dijkstra 太重(O(E log V)),普通 BFS 又不对——但我们有更简单的方案:0-1 BFS,仍然 O(V+E)。
核心思想
用双端队列(deque) 代替普通队列:
- 经过权重为 0 的边 → 新节点从队首插入(代价不增,优先处理)
- 经过权重为 1 的边 → 新节点从队尾插入(代价 +1)
这样队列始终保持「距离单调不减」,与 BFS 的层序性质等价。
普通 BFS 队列(所有边权=1):
队首 [d=0, d=1, d=1, d=2, d=2] 队尾
0-1 BFS 双端队列(边权0从队首,边权1从队尾):
队首 [d=0, d=0, d=1, d=1, d=2] 队尾
↑ 权重0的邻居插到前面
完整实现
#include <bits/stdc++.h>
using namespace std;
typedef pair<int,int> pii;
// 0-1 BFS — O(V+E)
// adj[u] = {v, w},w 只有 0 或 1
vector<pii> adj[MAXN];
vector<int> bfs_01(int src, int n) {
vector<int> dist(n + 1, INT_MAX);
deque<int> dq;
dist[src] = 0;
dq.push_front(src);
while (!dq.empty()) {
int u = dq.front(); dq.pop_front();
for (auto [v, w] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
if (w == 0)
dq.push_front(v); // 代价不增,放队首
else
dq.push_back(v); // 代价 +1,放队尾
}
}
}
return dist;
}
典型应用场景
| 场景 | 0-1 BFS 怎么建模 |
|---|---|
| 网格中某些格子可以免费穿越 | 免费格子边权 = 0,普通格子 = 1 |
| 换一次道路方向不花费用 | 反向走 = 0,顺向 = 1 |
| 可以携带有限数量的道具 | 扩展状态,使用道具时边权 = 0 |
5.2.11 变种二:双向 BFS(Bidirectional BFS)
问题引入
普通 BFS 从起点向外扩展,当图很大时,搜索空间是 O(b^d)(b = 分支因子,d = 距离)。
若从起点和终点同时扩展,总搜索空间变为 O(2 × b^(d/2)) = O(b^(d/2)),指数级加速!
核心思路
维护两个 BFS 前沿(frontier):
- 正向前沿:从起点向外扩展
- 反向前沿:从终点向外扩展
每次扩展较小的前沿(减少总节点数)。当某个节点同时出现在两个前沿中,找到了最短路径。
#include <bits/stdc++.h>
using namespace std;
// 双向 BFS — 适用于无权无向图,O(b^(d/2)) 而非 O(b^d)
// 返回 src 到 dst 的最短路径长度,-1 表示不可达
int bidir_bfs(int src, int dst, int n, vector<vector<int>>& adj) {
if (src == dst) return 0;
// 两个方向的距离数组,-1 = 未访问
vector<int> dist_f(n + 1, -1), dist_b(n + 1, -1);
queue<int> qf, qb;
dist_f[src] = 0; qf.push(src);
dist_b[dst] = 0; qb.push(dst);
while (!qf.empty() || !qb.empty()) {
// 每次扩展较小的前沿
if (qf.size() <= qb.size()) {
// 扩展正向一层
int sz = qf.size();
while (sz--) {
int u = qf.front(); qf.pop();
for (int v : adj[u]) {
if (dist_f[v] == -1) {
dist_f[v] = dist_f[u] + 1;
qf.push(v);
}
// 若 v 已被反向 BFS 访问 → 找到!
if (dist_b[v] != -1)
return dist_f[v] + dist_b[v];
}
}
} else {
// 扩展反向一层
int sz = qb.size();
while (sz--) {
int u = qb.front(); qb.pop();
for (int v : adj[u]) {
if (dist_b[v] == -1) {
dist_b[v] = dist_b[u] + 1;
qb.push(v);
}
if (dist_f[v] != -1)
return dist_f[v] + dist_b[v];
}
}
}
}
return -1; // 不可达
}
速度对比
| 图类型 | BFS 节点数 | 双向 BFS 节点数 |
|---|---|---|
| 分支因子 b=10,距离 d=6 | 10^6 = 1,000,000 | 2 × 10^3 = 2,000 |
| 分支因子 b=4,距离 d=20 | 4^20 ≈ 10^12 | 2 × 4^10 ≈ 2×10^6 |
5.2.12 变种三:DFS 回溯与剪枝
什么是回溯?
回溯是 DFS 的一种应用模式:系统地枚举所有可能的选择,发现不合法时撤销(回溯)。
三要素:
- 选择:在当前状态下做一个决定
- 递归:进入下一层状态
- 撤销:从递归返回后,撤销这个决定(恢复现场)
模板框架
void backtrack(状态) {
if (达到终止条件) {
记录结果;
return;
}
for (每个可能的选择) {
if (选择不合法) continue; // 剪枝:提前排除无效分支
做选择; // 修改状态
backtrack(新状态); // 递归
撤销选择; // 恢复状态(回溯!)
}
}
经典例题一:全排列
// 生成 [1..n] 的所有排列
#include <bits/stdc++.h>
using namespace std;
vector<vector<int>> result;
vector<int> perm;
vector<bool> used;
void backtrack(int n) {
if ((int)perm.size() == n) {
result.push_back(perm);
return;
}
for (int i = 1; i <= n; i++) {
if (used[i]) continue; // 剪枝:已使用过,跳过
used[i] = true;
perm.push_back(i); // 做选择
backtrack(n); // 递归
perm.pop_back(); // 撤销选择
used[i] = false;
}
}
int main() {
int n = 3;
used.assign(n + 1, false);
backtrack(n);
for (auto& p : result) {
for (int x : p) cout << x << " ";
cout << "\n";
}
// 输出全部 6 种排列:1 2 3 / 1 3 2 / 2 1 3 / 2 3 1 / 3 1 2 / 3 2 1
return 0;
}
经典例题二:N 皇后
在 N×N 棋盘上放置 N 个皇后,使任意两个皇后不在同一行、列、对角线。统计放置方案总数(1 ≤ N ≤ 13——方案数随 N 指数增长,回溯剪枝是标准做法)。
#include <bits/stdc++.h>
using namespace std;
int n;
int ans = 0;
vector<int> col; // col[r] = 第 r 行皇后所在的列
bool is_valid(int row, int c) {
for (int r = 0; r < row; r++) {
if (col[r] == c) return false; // 同列
if (abs(col[r] - c) == abs(r - row)) return false; // 对角线
}
return true;
}
void solve(int row) {
if (row == n) { ans++; return; }
for (int c = 0; c < n; c++) {
if (!is_valid(row, c)) continue; // 剪枝
col[row] = c; // 做选择:第 row 行放在列 c
solve(row + 1); // 递归下一行
// 无需显式撤销:下次赋值会覆盖 col[row]
}
}
int main() {
cin >> n;
col.resize(n);
solve(0);
cout << ans << "\n"; // n=8 输出 92
return 0;
}
更快的 N 皇后(位运算剪枝)
// 用位运算表示列/主对角线/副对角线的占用情况,O(n!) 但常数极小
int n, ans = 0;
void solve(int row, int cols, int diag1, int diag2) {
if (row == n) { ans++; return; }
// 所有被占用的位置的掩码
int occupied = cols | diag1 | diag2;
// 可以放置的列:取反后取低 n 位
int available = (~occupied) & ((1 << n) - 1);
while (available) {
int bit = available & (-available); // 取最低的可用位
available -= bit;
solve(row + 1,
cols | bit,
(diag1 | bit) << 1,
(diag2 | bit) >> 1);
}
}
int main() {
cin >> n;
solve(0, 0, 0, 0);
cout << ans << "\n";
}
经典例题三:组合型枚举——从 n 个数里选 k 个
全排列枚举的是顺序有所谓的方案;更多时候题目要的是组合——「从 n 头奶牛中选 k 头组队」,顺序无关。关键差别只有一个:递归传一个 start,只允许向后选。
// 输出 [1..n] 中选 k 个数的所有组合
#include <bits/stdc++.h>
using namespace std;
int n, k;
vector<int> chosen;
void backtrack(int start) {
if ((int)chosen.size() == k) {
for (int i = 0; i < k; i++) cout << chosen[i] << " \n"[i==k-1];
return;
}
// 剪枝:还没选够,但剩余的元素已经不够了——整棵子树直接放弃
for (int i = start; i <= n - (k - (int)chosen.size()) + 1; i++) {
chosen.push_back(i); // 做选择
backtrack(i + 1); // 只能从 i+1 往后选 → 天然去重
chosen.pop_back(); // 撤销选择
}
}
int main() {
cin >> n >> k;
backtrack(1);
return 0;
}
样例输入:
4 2
样例输出:
1 2
1 3
1 4
2 3
2 4
3 4
(共 C(4,2) = 6 个组合;注意 2 1 从不出现——start 保证了每个组合只按升序生成一次。)
💡 为什么
start能去重? 排列型枚举每层从 0 重新尝试所有元素(用used[]防重复使用);组合型只从上一个选择的位置向后尝试。于是「先选 1 再选 2」和「先选 2 再选 1」只会有前者——顺序被固定死了,重复方案根本不会被枚举到。
⚠️ 循环上界的剪枝不可省:
i <= n - (k - chosen.size()) + 1的意思是「即使把后面所有元素全选上也凑不满 k 个时,提前收手」。n = 40, k = 20 时这个剪枝能把搜索树从「每个空位都试到底」削到恰好 C(40,20) 条路径——一个数量级的差别。
剪枝的三种武器(比赛里拉开差距的地方)
回溯的复杂度上限都是指数级,剪枝决定它能不能过题。常用的三种:
| 剪枝类型 | 含义 | 判断依据 |
|---|---|---|
| 可行性剪枝 | 当前状态已经违法,整棵子树放弃 | 子集和:部分和已超过目标 rem < 0 |
| 乐观剪枝(下界/上界预估) | 即使最顺利也到不了目标,放弃 | 子集和:剩余所有数全加起来都不够 |
| 排序 + 对称性剪枝 | 等价方案只试一种 | 先排序,跳过与前一决策等价的分支 |
实战:子集和——给定 n 个正整数,选出若干个使和恰好等于 T,输出所有方案:
#include <bits/stdc++.h>
using namespace std;
int n; long long T;
vector<long long> a;
vector<int> cur;
vector<vector<int>> ans;
void backtrack(int i, long long rem) {
if (rem == 0 && i == n) { ans.push_back(cur); return; }
if (i == n || rem < 0) return; // 可行性剪枝:已经超了
cur.push_back(i); // 选 a[i]
backtrack(i + 1, rem - a[i]);
cur.pop_back(); // 撤销
backtrack(i + 1, rem); // 不选 a[i]
}
int main() {
cin >> n >> T;
a.resize(n);
for (auto& x : a) cin >> x;
backtrack(0, T);
cout << ans.size() << "\n";
for (auto& s : ans) {
for (size_t j = 0; j < s.size(); j++) cout << a[s[j]] << " \n"[j==s.size()-1];
}
}
样例输入:
6 10
3 34 4 12 5 2
样例输出:
1
3 5 2
这个基础版只用了可行性剪枝(rem < 0)。进阶:预处理后缀和 suffix[i] = a[i] + ... + a[n-1],在递归开头加一句 if (suffix[i] < rem) return;——剩余的数全选也不够时整棵子树放弃。T 很大而数字都很小的输入下,这一句能把运行时间砍掉几个数量级。
💡 与第 2.6 章的关系: 2.6.5 枚举所有子集用位掩码
for (s = 0; s < (1<<n); s++)也能枚举子集——n ≤ 20 时两者等价。回溯的优势是剪枝:位掩码枚举必须把每个子集「看一眼」,回溯可以在半路上整棵砍掉。n 稍大时(n = 30+)这是过与不过的区别。
5.2.13 变种四:割点与桥(Tarjan 算法)
问题引入
在一个通信网络中,哪个节点被摧毁会导致网络分裂?哪条线路被切断会导致网络不连通?
- 割点(Articulation Point): 删除该节点后图的连通分量数增加
- 桥(Bridge): 删除该边后图的连通分量数增加
核心思想:DFS 序 + low 值
DFS 时给每个节点分配一个时间戳 disc[u](进入时间)。
再定义 low[u] = 通过 u 的子树(含至多一条回边)能到达的最早时间戳。
low[u] = min(
disc[u], // u 自身的时间戳
min(disc[v] for all v: (u,v) 是回边), // 直接回边
min(low[v] for all v: v 是 u 的树边子节点) // 子节点的 low 值
)
判断割点:
- 根节点:有 ≥ 2 个子树子节点
- 非根节点 u:存在子节点 v 使得
low[v] >= disc[u](v 的子树无法绕过 u 连到 u 的祖先)
判断桥: 边 (u, v) 是桥当且仅当 low[v] > disc[u](v 的子树严格不能绕过这条边)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<int> adj[MAXN];
int disc[MAXN], low[MAXN], timer_val = 0;
bool visited[MAXN], is_cut[MAXN];
vector<pair<int,int>> bridges;
void dfs(int u, int parent) {
visited[u] = true;
disc[u] = low[u] = ++timer_val;
int child_cnt = 0; // u 作为根时的子树数量
for (int v : adj[u]) {
if (!visited[v]) {
child_cnt++;
dfs(v, u);
low[u] = min(low[u], low[v]);
// 判断割点(非根)
if (parent != -1 && low[v] >= disc[u])
is_cut[u] = true;
// 判断桥
if (low[v] > disc[u])
bridges.push_back({u, v});
} else if (v != parent) {
// 回边(不走父节点方向)
low[u] = min(low[u], disc[v]);
}
}
// 判断割点(根节点:有 >= 2 个子树)
if (parent == -1 && child_cnt >= 2)
is_cut[u] = true;
}
int main() {
int n, m;
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
for (int i = 1; i <= n; i++)
if (!visited[i]) dfs(i, -1);
cout << "割点:";
for (int i = 1; i <= n; i++)
if (is_cut[i]) cout << i << " ";
cout << "\n桥:";
for (auto [u, v] : bridges)
cout << u << "-" << v << " ";
cout << "\n";
return 0;
}
完整追踪示例
📄 查看代码:完整追踪示例
图:1-2-3-4,另有 2-4
DFS 从 1 开始:disc[1]=1, low[1]=1
→ 访问 2:disc[2]=2, low[2]=2
→ 访问 3:disc[3]=3, low[3]=3
→ 访问 4:disc[4]=4, low[4]=4
→ 邻居 2 已访问(回边):low[4] = min(4, disc[2]) = 2
回退到 3:low[3] = min(3, low[4]) = 2
回退到 2:low[2] = min(2, low[3]) = 2
low[3]=2 >= disc[2]=2? YES → 2 是割点(删2后3-4孤立)
注意:low[3]=2 不严格大于 disc[2]=2,所以 2-3 不是桥
最终:割点={2},桥={}
5.2.14 变种五:迭代加深 DFS(IDDFS)
问题引入
如果你需要找最短路径,但图太大无法用 BFS(内存不足),或者需要找有限步数内的解,可以使用 迭代加深 DFS(Iterative Deepening DFS,IDDFS)。
特点:
- 用 DFS 的空间效率(O(d),只记当前路径)
- 用 BFS 的最优性(逐层探索)
原理: 从深度限制 limit=1 开始,不断增加限制,每次做一次深度受限的 DFS:
limit=1 → DFS 最多走 1 步
limit=2 → DFS 最多走 2 步
limit=3 → DFS 最多走 3 步
...
直到找到目标
每次重新从根出发,看起来浪费,但由于树的节点数指数增长,最深一层的节点占大部分,总代价只比 BFS 多约 35%(当 b=2 时),却省去了 BFS 的大量内存。
#include <bits/stdc++.h>
using namespace std;
// 迭代加深 DFS 框架
bool dfs_limited(int node, int depth, int limit, int parent,
vector<vector<int>>& adj) {
if (depth == limit) {
// 在最大深度检查是否是目标
return is_goal(node);
}
for (int v : adj[node]) {
if (v == parent) continue;
if (dfs_limited(v, depth + 1, limit, node, adj))
return true;
}
return false;
}
int iddfs(int src, int max_depth, vector<vector<int>>& adj) {
for (int limit = 0; limit <= max_depth; limit++) {
if (dfs_limited(src, 0, limit, -1, adj))
return limit; // 找到目标,返回最小步数
}
return -1; // 未找到
}
A* 搜索简介
IDDFS 的升级版是 IDA*(Iterative Deepening A*):在深度限制的基础上加入启发函数 h(n)(对剩余距离的估计),直接剪掉 depth + h(n) > limit 的分支。
// IDA* 框架
int threshold;
int target;
int h(int node) {
return /* 到目标的估计距离(必须是下界)*/;
}
int search(int node, int g, int parent, vector<vector<int>>& adj) {
int f = g + h(node);
if (f > threshold) return f; // 超过阈值,剪枝并返回 f
if (node == target) return -1; // 找到!-1 作为成功标志
int min_t = INT_MAX;
for (int v : adj[node]) {
if (v == parent) continue;
int t = search(v, g + 1, node, adj);
if (t == -1) return -1;
min_t = min(min_t, t);
}
return min_t;
}
int ida_star(int src) {
threshold = h(src);
while (true) {
int t = search(src, 0, -1, adj);
if (t == -1) return threshold; // 找到
if (t == INT_MAX) return -1; // 无解
threshold = t; // 更新阈值
}
}
5.2.15 变种六:BFS 分层遍历
二叉树的层序遍历
BFS 的一个重要变种是精确追踪当前在第几层(第几步),常用于树的层序遍历、按层输出节点等。

// 层序遍历二叉树,每层单独输出
#include <bits/stdc++.h>
using namespace std;
struct TreeNode { int val; TreeNode* left, *right; };
vector<vector<int>> level_order(TreeNode* root) {
if (!root) return {};
vector<vector<int>> result;
queue<TreeNode*> q;
q.push(root);
while (!q.empty()) {
int sz = q.size(); // 当前层的节点数
vector<int> level;
for (int i = 0; i < sz; i++) {
TreeNode* node = q.front(); q.pop();
level.push_back(node->val);
if (node->left) q.push(node->left);
if (node->right) q.push(node->right);
}
result.push_back(level); // 一整层
}
return result;
}
图的 BFS 按层处理
在图中,有时需要「先处理完所有距离 d 的节点,再处理距离 d+1 的」。方法完全相同:用 sz = q.size() 快照当前层大小。
// 图 BFS 按层处理模板
void bfs_by_layer(int src, vector<vector<int>>& adj, int n) {
vector<int> dist(n + 1, -1);
queue<int> q;
dist[src] = 0;
q.push(src);
int layer = 0;
while (!q.empty()) {
int sz = q.size(); // 当前层的节点数量
cout << "第 " << layer << " 层:";
for (int i = 0; i < sz; i++) {
int u = q.front(); q.pop();
cout << u << " ";
for (int v : adj[u]) {
if (dist[v] == -1) {
dist[v] = dist[u] + 1;
q.push(v);
}
}
}
cout << "\n";
layer++;
}
}
5.2.16 变种七:记忆化 DFS(DFS + 动态规划)
DFS 经常需要处理重叠子问题——相同状态被多次访问。用记忆化(memoization)避免重复计算,这正是 DP 的核心。
记忆化 DFS 模板
// 有向图上,从节点 u 出发能到达的最大价值(记忆化 DFS)
#include <bits/stdc++.h>
using namespace std;
int n;
vector<int> adj[MAXN];
int val[MAXN]; // 每个节点的价值
int memo[MAXN]; // memo[u] = 从 u 出发的最大价值(-1=未计算)
int dfs(int u) {
if (memo[u] != -1) return memo[u]; // 已算过,直接返回
memo[u] = val[u]; // 至少获得当前节点的价值
for (int v : adj[u]) {
memo[u] = max(memo[u], val[u] + dfs(v));
}
return memo[u];
}
int main() {
cin >> n;
fill(memo, memo + n + 1, -1);
// ... 读入图和价值 ...
int ans = 0;
for (int i = 1; i <= n; i++)
ans = max(ans, dfs(i));
cout << ans << "\n";
return 0;
}
记忆化 DFS vs 标准 DP
| 对比 | 记忆化 DFS | 标准 DP(递推) |
|---|---|---|
| 编写方式 | 递归(自顶向下) | 迭代(自底向上) |
| 何时计算 | 用到时才算 | 按顺序全部算 |
| 适用场景 | 状态转移顺序复杂时 | 状态转移顺序清晰时 |
| 栈溢出风险 | 有(深度过大时) | 无 |
5.2.17 BFS/DFS 变种速查表
| 变种 | 场景 | 数据结构 | 时间复杂度 |
|---|---|---|---|
| 普通 BFS | 无权最短路、连通性 | 队列 | O(V+E) |
| 普通 DFS | 连通性、环检测、拓扑排序 | 栈/递归 | O(V+E) |
| 0-1 BFS | 边权 0 或 1 的最短路 | 双端队列 | O(V+E) |
| 双向 BFS | 大图中点对最短路 | 两个队列 | O(b^(d/2)) |
| 多源 BFS | 到多个源点的最短距离 | 队列(多源初始化) | O(V+E) |
| 回溯 DFS | 枚举所有合法方案 | 递归+恢复现场 | 问题相关 |
| 割点/桥 | 找关键节点/边 | DFS+disc/low | O(V+E) |
| IDDFS | 内存受限的最短路 | 递归(限深) | O(b^d),空间 O(d) |
| BFS 分层 | 按层处理节点 | 队列+层快照 | O(V+E) |
| 记忆化 DFS | DAG 上 DP | 递归+备忘录 | O(状态数×转移数) |

变种专项练习题(共 8 道,全部含完整解答)
题目 5.2.6 — 0-1 BFS:网格最少翻转 🟡 中等
题目: N×M 网格,每格是 0(免费通过)或 1(需花费 1 元)。从左上角到右下角(只能上下左右移动),求最少花费。
数据规模: 1 ≤ N, M ≤ 2000;每格只含 0 或 1。0-1 BFS 的 O(N×M) 恰好够用。
示例:
输入:3 3
0 1 0
0 0 1
1 0 0
输出:0
(路径 (0,0)→(1,0)→(1,1)→(2,1)→(2,2),全走 0 格,花费 0)
思路: 经过 0 格子边权为 0,经过 1 格子边权为 1,使用 0-1 BFS(双端队列)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int R, C; cin >> R >> C;
vector<vector<int>> grid(R, vector<int>(C));
for (auto& row : grid) for (int& x : row) cin >> x;
vector<vector<int>> dist(R, vector<int>(C, INT_MAX));
deque<pair<int,int>> dq;
dist[0][0] = grid[0][0];
dq.push_back({0, 0});
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
while (!dq.empty()) {
auto [r, c] = dq.front(); dq.pop_front();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr < 0 || nr >= R || nc < 0 || nc >= C) continue;
int nd = dist[r][c] + grid[nr][nc];
if (nd < dist[nr][nc]) {
dist[nr][nc] = nd;
if (grid[nr][nc] == 0)
dq.push_front({nr, nc}); // 免费:队首
else
dq.push_back({nr, nc}); // 花费:队尾
}
}
}
cout << dist[R-1][C-1] << "\n";
return 0;
}
追踪:
dist[0][0]=0(grid=0,放队首)
处理(0,0):扩展(1,0) grid=0→dist=0,放队首;(0,1) grid=1→dist=1,放队尾
处理(1,0):扩展(1,1) grid=0→dist=0;(2,0) grid=1→dist=1
...
最终 dist[2][2] = 0
题目 5.2.7 — 回溯:子集枚举 🟢 简单
题目: 给定长度为 N 的数组,输出所有子集(包含空集),每行一个子集,元素从小到大,子集按字典序排列。
数据规模: 1 ≤ N ≤ 15(共 2^N 个子集,指数枚举只对小的 N 可行);1 ≤ a[i] ≤ 10⁹,元素互不相同。
示例:
📄 Code 完整代码
输入:3
1 2 3
输出:
(空行,空集)
1
1 2
1 2 3
1 3
2
2 3
3
思路: 对每个元素,递归时选择「选」或「不选」(二叉回溯树)。
#include <bits/stdc++.h>
using namespace std;
int n;
vector<int> a, cur;
void backtrack(int idx) {
// 输出当前子集
for (int i = 0; i < (int)cur.size(); i++) {
if (i) cout << " ";
cout << cur[i];
}
cout << "\n";
for (int i = idx; i < n; i++) {
cur.push_back(a[i]); // 选 a[i]
backtrack(i + 1);
cur.pop_back(); // 不选 a[i](回溯)
}
}
int main() {
cin >> n;
a.resize(n);
for (int& x : a) cin >> x;
sort(a.begin(), a.end()); // 保证字典序
backtrack(0);
return 0;
}
理解回溯树(N=2,a=[1,2]):
backtrack(0):输出[]
选1 → backtrack(1):输出[1]
选2 → backtrack(2):输出[1,2]
不选2
不选1
选2 → backtrack(2):输出[2]
不选2
题目 5.2.8 — 回溯+剪枝:数字组合求和 🟡 中等
题目: 给定不含重复元素的正整数数组 candidates 和目标值 target,找出所有和为 target 的组合(每个数可以重复使用,组合内数字升序排列,不同组合间无重复)。
数据规模: 1 ≤ N ≤ 30,2 ≤ candidates[i] ≤ 40,1 ≤ target ≤ 500。答案组合数有保证在合理范围内。
示例:
candidates=[2,3,6,7], target=7
输出:[2,2,3], [7]
#include <bits/stdc++.h>
using namespace std;
vector<int> cands;
vector<vector<int>> result;
vector<int> cur;
void backtrack(int idx, int remain) {
if (remain == 0) {
result.push_back(cur);
return;
}
for (int i = idx; i < (int)cands.size(); i++) {
if (cands[i] > remain) break; // 剪枝:已排序,超过 remain 的后续都不用看
cur.push_back(cands[i]);
backtrack(i, remain - cands[i]); // i 而非 i+1,允许重复使用
cur.pop_back();
}
}
int main() {
int n, target;
cin >> n >> target;
cands.resize(n);
for (int& x : cands) cin >> x;
sort(cands.begin(), cands.end()); // 排序,为了剪枝和去重
backtrack(0, target);
for (auto& v : result) {
for (int i = 0; i < (int)v.size(); i++) {
if (i) cout << " ";
cout << v[i];
}
cout << "\n";
}
return 0;
}
关键剪枝: 数组已排序,若 cands[i] > remain,后续更大的数也一定超过,直接 break。
题目 5.2.9 — 双向 BFS:单词接龙 🟡 中等
题目: 给定起始单词 beginWord、目标单词 endWord 和单词列表。每次只能改变一个字母,且改变后的单词必须在列表中。求从 beginWord 到 endWord 的最短转换路径长度(含首尾单词),若不存在返回 0。
数据规模: 1 ≤ 单词数 ≤ 5000;单词均为小写字母,长度 1 ≤ L ≤ 10;beginWord != endWord。
示例:
beginWord = "hit", endWord = "cog"
wordList = ["hot","dot","dog","lot","log","cog"]
输出:5(hit→hot→dot→dog→cog)
普通 BFS 版:
#include <bits/stdc++.h>
using namespace std;
int word_ladder(string begin, string end, vector<string>& wordList) {
unordered_set<string> words(wordList.begin(), wordList.end());
if (!words.count(end)) return 0;
queue<string> q;
unordered_map<string, int> dist;
dist[begin] = 1;
q.push(begin);
while (!q.empty()) {
string cur = q.front(); q.pop();
// 枚举所有相差一个字母的单词
for (int i = 0; i < (int)cur.size(); i++) {
string next = cur;
for (char c = 'a'; c <= 'z'; c++) {
next[i] = c;
if (next == cur) continue;
if (next == end) return dist[cur] + 1;
if (words.count(next) && !dist.count(next)) {
dist[next] = dist[cur] + 1;
q.push(next);
}
}
}
}
return 0;
}
int main() {
string begin, end; int n;
cin >> begin >> end >> n;
vector<string> wordList(n);
for (auto& w : wordList) cin >> w;
cout << word_ladder(begin, end, wordList) << "\n";
return 0;
}
双向 BFS 优化版(大词表时更快):
int word_ladder_bidir(string begin, string end, vector<string>& wordList) {
unordered_set<string> words(wordList.begin(), wordList.end());
if (!words.count(end)) return 0;
// 两个方向的已访问集合
unordered_set<string> front_visited = {begin};
unordered_set<string> back_visited = {end};
int step = 1;
while (!front_visited.empty() && !back_visited.empty()) {
// 每次扩展较小的前沿(提高效率)
if (front_visited.size() > back_visited.size())
swap(front_visited, back_visited);
unordered_set<string> next_front;
for (const string& word : front_visited) {
string next = word;
for (int i = 0; i < (int)next.size(); i++) {
char orig = next[i];
for (char c = 'a'; c <= 'z'; c++) {
next[i] = c;
if (back_visited.count(next)) return step + 1; // 相遇!
if (words.count(next) && !front_visited.count(next))
next_front.insert(next);
next[i] = orig;
}
}
}
front_visited = next_front;
step++;
}
return 0;
}
题目 5.2.10 — 割点与桥:关键服务器 🔴 困难
题目: 有 N 台服务器和 M 条连接。若断开某条连接后,某些服务器无法相互通信,则这条连接是关键连接(即桥)。找出所有关键连接。
数据规模: 2 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵;可能存在重边(两台服务器之间有多条连接);保证初始时整个网络连通。Tarjan 的 O(N+M) 是必需的。
示例:
输入:4 4
1-2, 1-3, 2-3, 3-4
输出:3-4
(删去 1-2 或 1-3 或 2-3,{1,2,3} 仍然连通;只有 3-4 是桥)
直接使用 5.2.13 节的 Tarjan 桥检测算法:
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<pair<int,int>> adj[MAXN]; // {邻居, 边编号}
int disc[MAXN], low[MAXN], timer_val = 0;
bool visited[MAXN];
vector<pair<int,int>> bridges;
void dfs(int u, int par_edge) {
visited[u] = true;
disc[u] = low[u] = ++timer_val;
for (auto [v, eid] : adj[u]) {
if (eid == par_edge) continue; // 不走来时的边(用边ID区分,处理重边)
if (!visited[v]) {
dfs(v, eid);
low[u] = min(low[u], low[v]);
if (low[v] > disc[u]) // 桥的判断
bridges.push_back({u, v});
} else {
low[u] = min(low[u], disc[v]);
}
}
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, m; cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v;
adj[u].push_back({v, i});
adj[v].push_back({u, i});
}
for (int i = 1; i <= n; i++)
if (!visited[i]) dfs(i, -1);
cout << "关键连接数:" << bridges.size() << "\n";
for (auto [u, v] : bridges)
cout << u << " - " << v << "\n";
return 0;
}
注意用「边 ID」而非「父节点」 来避免走回来时的边,这样可以正确处理重边(两个节点之间有多条边的情况)。
题目 5.2.11 — 记忆化 DFS:最长递增路径 🟡 中等
题目: 给定 N×M 矩阵,每次可以向上下左右移动到严格更大的相邻格子。求矩阵中最长递增路径的长度。
数据规模: 1 ≤ N, M ≤ 500(N×M ≤ 2.5×10⁵ 个状态,记忆化 DFS 的 O(N×M) 可行);0 ≤ mat[i][j] ≤ 10⁹。
示例:
输入:3 3
9 9 4
6 6 8
2 1 1
输出:4(路径 1→2→6→9)
思路: 因为只能往更大的格子走,不会有环,图是 DAG。用记忆化 DFS:memo[r][c] = 从 (r,c) 出发的最长路径长度。
#include <bits/stdc++.h>
using namespace std;
int R, C;
vector<vector<int>> mat;
vector<vector<int>> memo;
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
int dfs(int r, int c) {
if (memo[r][c] != 0) return memo[r][c]; // 已计算过
memo[r][c] = 1; // 至少长度为 1(只含自身)
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr < 0 || nr >= R || nc < 0 || nc >= C) continue;
if (mat[nr][nc] > mat[r][c]) { // 严格更大才能走
memo[r][c] = max(memo[r][c], 1 + dfs(nr, nc));
}
}
return memo[r][c];
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
cin >> R >> C;
mat.assign(R, vector<int>(C));
memo.assign(R, vector<int>(C, 0));
for (auto& row : mat) for (int& x : row) cin >> x;
int ans = 0;
for (int r = 0; r < R; r++)
for (int c = 0; c < C; c++)
ans = max(ans, dfs(r, c));
cout << ans << "\n";
return 0;
}
为什么不需要 visited 数组? 因为路径单调递增,不可能访问同一个格子两次,天然无环。memo[r][c]!=0 就代表已经算过了。
题目 5.2.12 — 多源 BFS:地图离源距离 🟡 中等
题目: N×M 网格,有些格子是障碍 #,有些是出口 E,其余是空格 .。
对所有空格,输出到最近出口的步数(不能穿越障碍),若无法到达输出 -1。
数据规模: 1 ≤ N, M ≤ 1000;保证至少有一个出口 E。
思路: 多源 BFS——把所有出口以距离 0 同时压入队列,BFS 向外扩散。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int R, C; cin >> R >> C;
vector<string> grid(R);
for (auto& row : grid) cin >> row;
vector<vector<int>> dist(R, vector<int>(C, -1));
queue<pair<int,int>> q;
// 所有出口以距离 0 入队
for (int r = 0; r < R; r++)
for (int c = 0; c < C; c++)
if (grid[r][c] == 'E') {
dist[r][c] = 0;
q.push({r, c});
}
int dr[] = {-1,1,0,0}, dc[] = {0,0,-1,1};
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
for (int d = 0; d < 4; d++) {
int nr = r+dr[d], nc = c+dc[d];
if (nr<0||nr>=R||nc<0||nc>=C) continue;
if (grid[nr][nc]=='#') continue;
if (dist[nr][nc] != -1) continue;
dist[nr][nc] = dist[r][c] + 1;
q.push({nr, nc});
}
}
for (int r = 0; r < R; r++) {
for (int c = 0; c < C; c++) {
if (grid[r][c] == '#') cout << "# ";
else if (grid[r][c] == 'E') cout << "E ";
else cout << dist[r][c] << " ";
}
cout << "\n";
}
return 0;
}
题目 5.2.13 — 综合挑战:迷宫中的钥匙 🔴 困难
题目: N×M 迷宫,包含:
S:起点E:终点#:墙.:空地a~f:钥匙(小写字母)A~F:锁住的门(大写字母,需要对应钥匙才能进入)
从 S 走到 E,求最少步数。钥匙捡起后一直携带。若无法到达输出 −1。
数据规模: 1 ≤ N, M ≤ 50;每类钥匙至多出现一次;保证恰好有一个 S 和一个 E。状态空间 N×M×64 ≤ 160,000。
提示: 状态需要扩展为 (行, 列, 已携带的钥匙集合),用 BFS 搜索最短路。
关键:状态 = (位置 + 钥匙集合)。钥匙只有 6 把,用 6 位二进制整数表示集合(0~63)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int R, C; cin >> R >> C;
vector<string> grid(R);
for (auto& row : grid) cin >> row;
int sr, sc, er, ec;
for (int r = 0; r < R; r++)
for (int c = 0; c < C; c++) {
if (grid[r][c] == 'S') { sr=r; sc=c; }
if (grid[r][c] == 'E') { er=r; ec=c; }
}
// dist[r][c][keys] = 步数,keys 是 6 位位掩码
vector<vector<vector<int>>> dist(R, vector<vector<int>>(C, vector<int>(64, -1)));
queue<tuple<int,int,int>> q;
dist[sr][sc][0] = 0;
q.push({sr, sc, 0});
int dr[] = {-1,1,0,0}, dc[] = {0,0,-1,1};
while (!q.empty()) {
auto [r, c, keys] = q.front(); q.pop();
if (r == er && c == ec) {
cout << dist[er][ec][keys] << "\n";
return 0;
}
for (int d = 0; d < 4; d++) {
int nr = r+dr[d], nc = c+dc[d];
if (nr<0||nr>=R||nc<0||nc>=C) continue;
char cell = grid[nr][nc];
if (cell == '#') continue;
// 门:需要对应钥匙
if (isupper(cell) && !(keys & (1 << (cell-'A')))) continue;
// 捡钥匙
int nkeys = keys;
if (islower(cell)) nkeys |= (1 << (cell-'a'));
if (dist[nr][nc][nkeys] == -1) {
dist[nr][nc][nkeys] = dist[r][c][keys] + 1;
q.push({nr, nc, nkeys});
}
}
}
cout << -1 << "\n"; // 无法到达
return 0;
}
状态空间大小: R × C × 64 = 最多 50×50×64 = 160,000 个状态,BFS 可以高效处理。
示例追踪:
起点 S(0,0),keys=0
→ 走到 a(0,1):keys = 0 | (1<<0) = 1(拿到钥匙 a)
→ 走到 A(1,1):keys=1,A 对应位 0,keys&1=1 ✓,可以通过
→ 最终到达 E
题目 5.2.14 — 拓扑排序:课程先修 🟡 中等
题目: 有 N 门课程和 M 条先修关系 (u, v) 表示课程 u 必须在 v 之前完成。判断是否存在合法的课程修读顺序,若存在则输出其中一种(任意合法序均可),否则输出 "IMPOSSIBLE"。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵;1 ≤ u, v ≤ N,u ≠ v。
示例:
输入:4 4
1 2
1 3
2 4
3 4
输出:1 2 3 4(或其他合法拓扑序)
核心思路: Kahn 算法(BFS 拓扑排序)。维护每个节点的入度,每次取入度为 0 的节点加入排序,将其所有邻居入度减 1。若最终排序长度 < N,说明图中有环。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, m; cin >> n >> m;
vector<vector<int>> adj(n + 1);
vector<int> inDeg(n + 1, 0);
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v);
inDeg[v]++;
}
queue<int> q;
for (int u = 1; u <= n; u++)
if (inDeg[u] == 0) q.push(u);
vector<int> order;
while (!q.empty()) {
int u = q.front(); q.pop();
order.push_back(u);
for (int v : adj[u]) {
inDeg[v]--;
if (inDeg[v] == 0) q.push(v);
}
}
if ((int)order.size() != n) {
cout << "IMPOSSIBLE\n";
} else {
for (int i = 0; i < n; i++)
cout << order[i] << " \n"[i == n-1];
}
return 0;
}
复杂度分析: 时间 O(N + M),空间 O(N + M)。
题目 5.2.15 — 有向图环检测 🟡 中等
题目: 给定 N 个节点、M 条有向边的图,判断是否存在环。若存在输出 "CYCLE",否则输出 "DAG"。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵;1 ≤ u, v ≤ N。
示例:
输入1:3 3 1→2, 2→3, 3→1 → CYCLE
输入2:3 2 1→2, 1→3 → DAG
核心思路: 三色 DFS。白色(0)=未访问,灰色(1)=在当前路径上,黑色(2)=已完成。遇到灰色邻居则发现回边,存在环。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, m; cin >> n >> m;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v);
}
vector<int> color(n + 1, 0); // 0=白, 1=灰, 2=黑
bool hasCycle = false;
function<void(int)> dfs = [&](int u) {
color[u] = 1; // 灰色:正在处理
for (int v : adj[u]) {
if (color[v] == 0) dfs(v);
else if (color[v] == 1) hasCycle = true; // 回边
}
color[u] = 2; // 黑色:处理完成
};
for (int u = 1; u <= n && !hasCycle; u++)
if (color[u] == 0) dfs(u);
cout << (hasCycle ? "CYCLE" : "DAG") << "\n";
return 0;
}
复杂度分析: 时间 O(N + M),空间 O(N + M)。
题目 5.2.16 — IDDFS:限定步数的可达性 🔴 困难
题目: 给定 N 个节点的无向图和起点 S、终点 T,求从 S 到 T 的最短路径长度。但图的节点数可能极大(N ≤ 10^6),内存有限,无法存储完整的 BFS 距离数组。保证答案 d ≤ 20。
数据规模: 2 ≤ N ≤ 10⁶,1 ≤ M ≤ 2×10⁶;1 ≤ S, T ≤ N;保证 S 可达 T。
核心思路: 迭代加深 DFS(IDDFS)。从深度限制 limit=0 开始递增,每次做一次深度不超过 limit 的 DFS。DFS 只需要 O(d) 的栈空间,而不需要 O(N) 的 BFS 距离数组。找到目标时当前 limit 就是最短路径。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, m, s, t;
cin >> n >> m >> s >> t;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
vector<bool> on_path(n + 1, false); // 当前路径上的节点(防止重复访问)
// 深度受限的 DFS,返回是否找到目标
function<bool(int, int)> dfs_limited = [&](int u, int depth) -> bool {
if (u == t) return true;
if (depth == 0) return false;
on_path[u] = true;
for (int v : adj[u]) {
if (on_path[v]) continue;
if (dfs_limited(v, depth - 1)) {
on_path[u] = false;
return true;
}
}
on_path[u] = false;
return false;
};
int ans = -1;
for (int limit = 0; limit <= 20; limit++) {
if (dfs_limited(s, limit)) {
ans = limit;
break;
}
}
cout << ans << "\n";
return 0;
}
复杂度分析: 每轮 DFS 时间 O(V+E),最多 d+1 轮。但第 i 轮只搜索深度 ≤ i 的节点,实际总代价为 O(b^d)(b 为分支因子),与 BFS 相同量级。空间仅 O(d)(路径栈),远优于 BFS 的 O(V)。
📖 第 5.3 章:函数图(Functional Graphs)
5.3.0 从一道题出发:转圈的游戏
先看一道 USACO 2016 Feb Silver「Circular Barn」风格的题:
🐄 题目:转圈的奶牛 有
N(N ≤ 10⁵)个房间围成环形走廊,每个房间有一头奶牛。所有奶牛同时按规则移动:房间i的奶牛移动到房间f(i)。 给出每个房间的目的地f(i),经过T秒(T ≤ 10⁹)后,问每个房间里有几头奶牛?
N=5, f = [2, 3, 1, 1, 4]
1 号房奶牛走 1→2,2 号走 2→3,3 号走 3→1(在 1,2,3 之间转圈)
4 号走 4→1(之后加入这个圈),5 号走 5→4(下一步也进圈)
先试试你会的方法
思路 1:直接模拟 T 步? 每步 O(N),T = 10⁹ 时要 10¹⁴ 次操作——完全不可能。
思路 2:每个奶牛单独算? 注意到「房间 i 的奶牛走 T 步到哪」和别的奶牛无关,可以逐点计算。但 T = 10⁹ 还是太大……除非发现走很多步之后奶牛一定在环上转圈——周期一旦知道,T 步等价于 T mod 周期 步!
关键观察: 这道题的图有个特殊性质——每个房间恰好有一条出边(奶牛只有一个去处)。这种图必然形成「尾巴 + 环」的 ρ 形结构。题目的一切困难都源于此,而一切解法也源于此:
- 「走 T 步到哪」= 沿唯一路径走,先经过尾巴,再在环上循环 → 周期可预计算
- T 很大 → 用倍增(或快速幂思想)一次跳 2^k 步
- 「哪些房间最终有奶牛」→ 找出环和到环的距离即可
拆解这道题需要回答的问题
- 「每个节点恰好一条出边」的图长什么样?为什么一定有环?→ 5.3.1 函数图与 ρ 形结构
- 怎么高效找出每个环、以及每个节点到环的距离?→ 5.3.2 Floyd 判环 / 着色法
- T = 10⁹ 步怎么算?→ 5.3.3 倍增加速跳 k 步
- USACO 还会怎么出这种题?→ 5.3.4 题型模式(约会问题、继承链、轮换密码……)
学习目标(学完本章你将能够):
- 识别函数图的特征结构(每节点恰好一条出边)
- 找到函数图中的所有环(环检测)
- 计算图中每个节点距离其所在环的步数
- 解决"从节点 x 出发走 k 步到哪里"的跳跃问题(含快速幂加速)
- 应用到 USACO Silver 中的函数图专题
5.3.1 什么是函数图?
定义
函数图(Functional Graph) 是每个节点恰好有一条出边的有向图。
node[i] → next[i],每个节点有且仅有一个后继节点。
等价地,函数图就是一个映射 f: {1..N} → {1..N},从 i 走一步到 f(i)。
结构特征:ρ 形(rho 形)
由于每个节点只有一条出边,从任意节点出发最终必然进入环(因为节点有限,走无限步必然重复)。
💡 Code 代码(12 行)
典型结构(ρ 形):
1 → 2 → 3 → 4 → 5
↑ ↓
8 ← 6
↑
7
节点 5, 6, 8 构成环
节点 1, 2, 3 是"尾巴"(最终进入环)
节点 4 是环的入口
节点 7 指向 8(悬挂在环上)
关键结论:
- 每个连通分量恰好包含一个环
- 其他节点都是"树"状悬挂在环上的
5.3.2 找环(Floyd 判环 / 着色法)
方法一:着色法(推荐,适合 USACO)
用三种颜色追踪 DFS 状态(与有向图环检测完全相同):
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200005;
int nxt[MAXN]; // nxt[i] = i 的后继节点
int color[MAXN]; // 0=未访问, 1=访问中, 2=已完成
int on_cycle[MAXN]; // on_cycle[i] = i 是否在环上
int cycle_id[MAXN]; // 所在环的编号(-1表示不在环上)
int dist_to_cycle[MAXN]; // 到所在环的距离(环上节点为0)
int n;
int num_cycles = 0;
void find_cycle(int start) {
// 沿着出边走,找到环的起点
vector<int> path;
int cur = start;
while (color[cur] == 0) {
color[cur] = 1; // 标记为"访问中"
path.push_back(cur);
cur = nxt[cur];
}
if (color[cur] == 1) {
// cur 是环的入口,标记整个环
int cycle = num_cycles++;
int v = cur;
do {
on_cycle[v] = true;
cycle_id[v] = cycle;
dist_to_cycle[v] = 0;
v = nxt[v];
} while (v != cur);
}
// 将路径上的节点标记为"已完成"
for (int v : path) color[v] = 2;
}
int main() {
cin >> n;
fill(cycle_id, cycle_id + n + 1, -1);
fill(color, color + n + 1, 0);
for (int i = 1; i <= n; i++) cin >> nxt[i];
for (int i = 1; i <= n; i++)
if (color[i] == 0) find_cycle(i);
// 计算非环节点到环的距离(BFS 从环向外)
queue<int> q;
// 建反向图
vector<vector<int>> rev(n + 1);
for (int i = 1; i <= n; i++) rev[nxt[i]].push_back(i);
for (int i = 1; i <= n; i++)
if (on_cycle[i]) { dist_to_cycle[i] = 0; q.push(i); }
while (!q.empty()) {
int u = q.front(); q.pop();
for (int v : rev[u]) {
if (!on_cycle[v] && dist_to_cycle[v] == 0 && v != u) {
// 尚未计算距离
dist_to_cycle[v] = dist_to_cycle[u] + 1;
cycle_id[v] = cycle_id[u]; // 继承所在环
q.push(v);
}
}
}
// 输出结果
for (int i = 1; i <= n; i++) {
cout << "节点 " << i
<< (on_cycle[i] ? " [在环上]" : " [不在环上]")
<< ",到环距离=" << dist_to_cycle[i]
<< ",所在环=" << cycle_id[i] << "\n";
}
return 0;
}
方法二:Floyd 判环(快慢指针)
适合判断单条路径是否有环(不需要找具体哪个节点在环上):
// Floyd 快慢指针判环
// 从节点 start 出发,判断是否存在环
bool has_cycle_floyd(int start) {
int slow = start, fast = start;
do {
slow = nxt[slow];
fast = nxt[nxt[fast]];
} while (slow != fast);
return true; // 函数图一定有环(节点有限)
}
// 找环的入口节点(环起点)
int find_cycle_entry(int start) {
int slow = start, fast = start;
do {
slow = nxt[slow];
fast = nxt[nxt[fast]];
} while (slow != fast);
// 相遇后,slow 从 start 重新出发,fast 留在原地,同速走
slow = start;
while (slow != fast) {
slow = nxt[slow];
fast = nxt[fast];
}
return slow; // 环的入口
}
下面的动画演示了 Floyd 判环的完整过程(🐢 慢指针 1 步、🐰 快指针 2 步,相遇后进入第二阶段找环入口)——对函数图来说,把链表的 next 换成 nxt 即可:
5.3.3 跳 k 步问题(倍增加速)
问题: 从节点 x 出发,走 k 步后到哪里?
朴素做法:循环 k 次,O(k) 可能很慢(k ≤ 10^18)。
倍增加速: 预处理 jump[v][j] = 从 v 出发跳 2^j 步后的节点,类似 LCA 倍增。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200005;
const int LOG = 40; // log2(10^18) ≈ 60,按需调整
int n;
long long nxt_arr[MAXN];
long long jump[MAXN][LOG]; // jump[v][j] = 从 v 走 2^j 步
void preprocess() {
// 第 0 层:直接后继
for (int v = 1; v <= n; v++) jump[v][0] = nxt_arr[v];
// 倍增构建
for (int j = 1; j < LOG; j++)
for (int v = 1; v <= n; v++)
jump[v][j] = jump[jump[v][j-1]][j-1];
}
// 从节点 v 出发,走 k 步
long long walk(long long v, long long k) {
for (int j = 0; j < LOG; j++)
if ((k >> j) & 1)
v = jump[v][j];
return v;
}
int main() {
cin >> n;
for (int i = 1; i <= n; i++) cin >> nxt_arr[i];
preprocess();
int q; cin >> q;
while (q--) {
long long v, k;
cin >> v >> k;
cout << walk(v, k) << "\n";
}
return 0;
}
5.3.4 USACO Silver 典型题型
题型 1:函数图的连通性
问题模式: 判断两个节点是否能相互到达,或最终是否落在同一环中。
解法: 找出每个节点所属的环(cycle_id[]),同一环 = 可以相互到达。
// 两节点 u, v 是否最终落在同一环?
bool same_cycle(int u, int v) {
return cycle_id[u] == cycle_id[v] && cycle_id[u] != -1;
}
题型 2:从每个节点走恰好 k 步后的分布
// 统计走 k 步后,每个节点各有多少节点落在上面
vector<int> count_after_k_steps(int n, int k) {
vector<int> cnt(n + 1, 0);
for (int i = 1; i <= n; i++) {
cnt[walk(i, k)]++;
}
return cnt;
}
5.3.5 完整例题:奶牛跳跃(USACO Silver 风格)
题目: N 头奶牛编号 1~N,每头奶牛 i 喜欢奶牛 nxt[i](构成函数图)。
定义「喜欢链」:从 i 出发沿喜欢关系走 k 步。
Q 次查询,每次给出 (i, k),输出走 k 步后到达的奶牛编号。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ Q ≤ 10⁵,1 ≤ nxt[i] ≤ N,0 ≤ k ≤ 10⁹。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005, LOG = 20;
int n, q;
int jump[MAXN][LOG];
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
cin >> n >> q;
for (int i = 1; i <= n; i++) cin >> jump[i][0];
for (int j = 1; j < LOG; j++)
for (int i = 1; i <= n; i++)
jump[i][j] = jump[jump[i][j-1]][j-1];
while (q--) {
int v, k; cin >> v >> k;
for (int j = 0; j < LOG; j++)
if ((k >> j) & 1) v = jump[v][j];
cout << v << "\n";
}
return 0;
}
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| 死循环 | 朴素走 k 步但不考虑环 | 倍增法;或找到环后取模 |
| jump 数组越界 | jump[0][j] 未初始化(若节点编号从0开始) | 确保哨兵节点正确 |
| 循环检测不完整 | 只检测从某个起点出发的路径 | 对所有未访问节点都执行 find_cycle |
| 有向图判环用无向图方法 | 函数图是有向图 | 不能用「父节点排除法」 |
💪 练习题
🟢 题目 1:找所有环
给定函数图,输出所有环的节点集合(每行一个环,节点按访问顺序)。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ nxt[i] ≤ N。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> nxt(n + 1);
for (int i = 1; i <= n; i++) cin >> nxt[i];
vector<int> color(n + 1, 0);
vector<bool> on_cycle(n + 1, false);
for (int start = 1; start <= n; start++) {
if (color[start] != 0) continue;
vector<int> path;
unordered_map<int,int> pos; // 节点在 path 中的位置
int cur = start;
while (color[cur] == 0) {
color[cur] = 1;
pos[cur] = path.size();
path.push_back(cur);
cur = nxt[cur];
}
if (color[cur] == 1 && pos.count(cur)) {
// 找到环:从 cur 开始到 path 末尾
cout << "环:";
for (int i = pos[cur]; i < (int)path.size(); i++) {
on_cycle[path[i]] = true;
cout << path[i] << " ";
}
cout << "\n";
}
for (int v : path) color[v] = 2;
}
return 0;
}
🟡 题目 2:走 k 步
给定函数图和 Q 次查询 (v, k),每次输出从 v 出发走 k 步后的节点(k ≤ 10^9)。
核心思路: 使用倍增法预处理 jump[v][j](从 v 跳 2^j 步到达的节点),查询时按 k 的二进制分解跳步。k ≤ 10^9 需要 LOG=30。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200005, LOG = 30;
int n, q;
int jump[MAXN][LOG];
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
cin >> n >> q;
for (int i = 1; i <= n; i++) cin >> jump[i][0];
// 倍增预处理
for (int j = 1; j < LOG; j++)
for (int i = 1; i <= n; i++)
jump[i][j] = jump[jump[i][j-1]][j-1];
while (q--) {
int v; long long k;
cin >> v >> k;
// 按 k 的二进制分解跳步
for (int j = 0; j < LOG; j++)
if ((k >> j) & 1)
v = jump[v][j];
cout << v << "\n";
}
return 0;
}
复杂度分析: 预处理时间 O(N × LOG),每次查询时间 O(LOG),空间 O(N × LOG)。
🔴 题目 3:最远公共祖先(函数图上的 LCA)
函数图中,定义节点 u 和 v 的「公共后继」为第一个同时是 u 的后继和 v 的后继的节点。
给 Q 次查询,找 (u, v) 的最近公共后继。
数据规模: 1 ≤ N ≤ 2×10⁵,1 ≤ Q ≤ 2×10⁵,1 ≤ u, v ≤ N。
核心思路: 在函数图中,每个节点沿出边走最终一定进入环。两节点的"最近公共后继"只在两者属于同一连通分量时存在。算法分三步:(1) 着色法找出每个节点所在环及到环的距离;(2) 先让距环更远的节点走到与另一节点到环距离相同的位置(保证同步);(3) 用倍增法从高到低跳,找到第一个公共节点。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200005, LOG = 20;
int n, q;
int nxt[MAXN];
int jump[MAXN][LOG];
int color[MAXN], on_cycle[MAXN], cycle_id[MAXN];
int dist_to_cycle[MAXN];
void find_cycle(int start, int& num_cycles) {
vector<int> path;
unordered_map<int,int> pos;
int cur = start;
while (color[cur] == 0) {
color[cur] = 1;
pos[cur] = path.size();
path.push_back(cur);
cur = nxt[cur];
}
if (color[cur] == 1 && pos.count(cur)) {
int cid = num_cycles++;
int v = cur;
do {
on_cycle[v] = true;
cycle_id[v] = cid;
dist_to_cycle[v] = 0;
v = nxt[v];
} while (v != cur);
}
for (int v : path) color[v] = 2;
}
// 从 v 走 k 步
int walk(int v, int k) {
for (int j = 0; j < LOG; j++)
if ((k >> j) & 1) v = jump[v][j];
return v;
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
cin >> n >> q;
for (int i = 1; i <= n; i++) cin >> nxt[i];
// 找环
fill(cycle_id, cycle_id + n + 1, -1);
int num_cycles = 0;
for (int i = 1; i <= n; i++)
if (color[i] == 0) find_cycle(i, num_cycles);
// BFS 从环向外计算 dist_to_cycle
vector<vector<int>> rev(n + 1);
for (int i = 1; i <= n; i++) rev[nxt[i]].push_back(i);
queue<int> bfs;
for (int i = 1; i <= n; i++)
if (on_cycle[i]) { dist_to_cycle[i] = 0; bfs.push(i); }
while (!bfs.empty()) {
int u = bfs.front(); bfs.pop();
for (int v : rev[u]) {
if (!on_cycle[v] && dist_to_cycle[v] == 0 && v != u) {
dist_to_cycle[v] = dist_to_cycle[u] + 1;
cycle_id[v] = cycle_id[u];
bfs.push(v);
}
}
}
// 倍增预处理
for (int i = 1; i <= n; i++) jump[i][0] = nxt[i];
for (int j = 1; j < LOG; j++)
for (int i = 1; i <= n; i++)
jump[i][j] = jump[jump[i][j-1]][j-1];
while (q--) {
int u, v; cin >> u >> v;
// 不同连通分量 → 无公共后继
if (cycle_id[u] != cycle_id[v] || cycle_id[u] == -1) {
cout << -1 << "\n";
continue;
}
// 让到环距离大的先走,使两者到环距离相同
if (dist_to_cycle[u] < dist_to_cycle[v]) swap(u, v);
if (dist_to_cycle[u] != dist_to_cycle[v])
u = walk(u, dist_to_cycle[u] - dist_to_cycle[v]);
// 倍增找最近公共后继
if (u == v) { cout << u << "\n"; continue; }
for (int j = LOG - 1; j >= 0; j--)
if (jump[u][j] != jump[v][j]) {
u = jump[u][j];
v = jump[v][j];
}
cout << jump[u][0] << "\n";
}
return 0;
}
复杂度分析: 预处理(找环 + BFS + 倍增)时间 O(N × LOG),每次查询时间 O(LOG),空间 O(N × LOG)。
💡 章节联系: 函数图是 USACO Silver 的独特题型,每季赛约出现 1 道。它结合了图遍历(第 5.2 章)和 LCA 倍增(第 5.4 章)的思想,是 Gold 拓扑排序(第 5.10 章)的前置知识。
第 5.4 章:最短路径
在节点间寻找最短路径是图论中最基础的问题之一。它出现在 GPS 导航、网络路由、游戏 AI 中,对我们来说最重要的是——USACO 题目。本章涵盖四种算法(Dijkstra、Bellman-Ford、Floyd-Warshall、SPFA),并解释何时使用哪种。
5.4.0 从一道题出发:送货的最短时间
先看一道 Silver 风格的题目:
🐄 题目:奶酪配送(USACO 风格)
N(1 ≤ N ≤ 2×10³)个牧场、M(1 ≤ M ≤ 10⁴)条双向道路。第i条道路连接u_i、v_i,通行需要t_i分钟(1 ≤ t_i ≤ 10⁴,不同道路耗时不同)。 奶牛 Bessie 从牧场 1 出发,要把奶酪送到每一个牧场。 对每个牧场输出:最早送达时刻(编号 1 到 N,共 N 行)。输入格式: 第一行 N 和 M;接下来 M 行每行 u_i、v_i、t_i。
N=5, M=6
道路(u, v, t):1-2 (4), 1-3 (1), 3-2 (1), 3-4 (2), 2-5 (7), 4-5 (1)
答案:dist = [0, 2, 1, 3, 4]
(到牧场 2:1→3→2 只要 1+1=2 分钟,比直接走 1-2 的 4 分钟更快!)
先试试你会的方法
思路 1:BFS? 第 5.2 章的 BFS 求的是「边数最少」的路径。但这里每条边耗时不同——直连 2 分钟的路可能不如「两条 1 分钟的路」绕行。BFS 数层数,不数分钟。
思路 2:DP / 暴力枚举所有路径? 路径条数随边数指数增长,无法枚举。
关键观察: 到达每个牧场的时刻一旦确定就不可能再变早(否则就有更短的路)。于是可以按时刻从小到大逐个「敲定」牧场——每次取出当前已知最早到达且还没敲定的牧场,用它的出边去更新邻居。这就是 Dijkstra:BFS 的队列换成优先队列,边权参与累加。
拆解这道题需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 5.4.1 | 问题的形式定义:单源 (SSSP) vs 全对 (APSP);为什么 BFS 不够用 |
| 5.4.2 | Dijkstra:非负权、单源——本题的标准解法 |
| 5.4.3 | 边权有负数怎么办?Bellman-Ford |
| 5.4.4 | 点很少(N ≤ 500)且要所有点对?Floyd-Warshall |
| 5.4.5–5.4.6 | 四种算法怎么选?SPFA 是什么? |
| 5.4.9 | USACO 真题:先判断边权,再选择工具 |
5.4.1 问题定义
单源最短路径(SSSP)
给定加权图 G = (V, E) 和源节点 s,找从 s 到所有其他节点的最短距离。

从源点 A:
dist[A] = 0dist[B] = 1dist[C] = 5dist[D] = 5(A→B→D = 1+4)dist[E] = 8(A→B→D→E = 1+4+3)
全对最短路径(APSP)
找所有节点对之间的最短距离。
为什么不直接用 BFS?
BFS 找无权图的最短路径(每条边 = 距离 1)。有了权重:
- 有些路径有很多短权重的边
- 另一些有少量大权重的边
- BFS 完全忽略权重 → 答案错误
5.4.2 Dijkstra 算法
最重要的最短路径算法。 用于约 90% 涉及加权最短路径的 USACO 题目。
核心思想:贪心 + 优先队列
Dijkstra 是一个贪心算法:
- 维护一个「已确定」节点集合(最短距离已最终确定)
- 每次处理当前距离最小的未访问节点
- 处理节点时,尝试松弛其邻居(如果找到更短路径则更新距离)
为什么贪心有效: 若所有边权非负,当前距离最小的节点不可能通过其他节点得到改善(所有替代路径 ≥ 当前距离)。
逐步追踪

起点: 节点 0 | 初始: dist = [0, ∞, ∞, ∞, ∞]
| 步骤 | 处理节点 | 松弛操作 | dist 数组 | 队列 |
|---|---|---|---|---|
| 1 | 节点 0(dist=0) | 0→1: min(∞, 0+4)=4; 0→2: min(∞, 0+2)=2; 0→3: min(∞, 0+5)=5 | [0, 4, 2, 5, ∞] | {(2,2),(4,1),(5,3)} |
| 2 | 节点 2(dist=2) | 2→3: min(5, 2+1)=3 ← 改善! | [0, 4, 2, 3, ∞] | {(3,3),(4,1),(5,3_旧)} |
| 3 | 节点 3(dist=3) | 3→1: min(4, 3+1)=4(无变化); 3→4: min(∞, 3+3)=6 | [0, 4, 2, 3, 6] | {(4,1),(6,4),(5,3_旧)} |
| 4 | 节点 1(dist=4) | 无可松弛 | [0, 4, 2, 3, 6] | {(6,4)} |
| 5 | 节点 4(dist=6) | 完成! | [0, 4, 2, 3, 6] | {} |
最终: dist = [0, 4, 2, 3, 6]
完整 Dijkstra 实现
// Dijkstra 算法(优先队列)— O((V+E) log V)
#include <bits/stdc++.h>
using namespace std;
typedef pair<int, int> pii; // {距离, 节点}
typedef long long ll;
const ll INF = 1e18; // 使用 long long 避免 int 溢出!
const int MAXN = 100005;
// 邻接表:adj[u] = {权重, v} 列表
vector<pii> adj[MAXN];
vector<ll> dijkstra(int src, int n) {
vector<ll> dist(n + 1, INF); // dist[i] = 到节点 i 的最短距离
dist[src] = 0;
// 最小堆:{距离, 节点}
priority_queue<pii, vector<pii>, greater<pii>> pq;
pq.push({0, src});
while (!pq.empty()) {
auto [d, u] = pq.top(); pq.pop(); // 取距离最小的节点
// 关键:若已找到到 u 的更好路径则跳过(过期条目)
if (d > dist[u]) continue;
// 松弛 u 的所有邻居
for (auto [w, v] : adj[u]) {
ll newDist = dist[u] + w;
if (newDist < dist[v]) {
dist[v] = newDist; // 更新距离
pq.push({newDist, v}); // 将更新后的条目加入队列
}
}
}
return dist;
}
Dijkstra 的关键要点
🚫 关键:Dijkstra 对负边权不起作用! 若存在负边权,Dijkstra 可能产生错误结果。算法正确性依赖于贪心假设:一旦节点从优先队列弹出(已确定),其距离就是最终的——负边破坏这个假设。对含负边权的图,改用 Bellman-Ford 或 SPFA。

- 只对非负权重有效。 负边破坏贪心假设。
- 当边权较大时,距离用
long long。dist[u] + w可能溢出int。 - 用
greater<pii>让priority_queue成为最小堆。 if (d > dist[u]) continue;检查对正确性和性能至关重要。
5.4.3 Bellman-Ford 算法
单源最短路径算法,比 Dijkstra 慢,但支持负权边,还能检测负环。
核心思想
Bellman-Ford 只做一件事,反复做:
遍历所有边,如果经过边 u→v 能让 dist[v] 变小,就更新 dist[v]。 这个操作叫松弛。
if (dist[u] != INF && dist[u] + w < dist[v]) {
dist[v] = dist[u] + w; // 松弛
}

松弛很简单:已知到 u 的距离,尝试"先到 u 再走到 v",如果比当前到 v 更短就更新。
为什么重复 V-1 轮?
一轮松弛只能把已知距离沿边向外传播一层:
- 第 1 轮后:找到所有最多用 1 条边能到的最短路
- 第 2 轮后:找到所有最多用 2 条边能到的最短路
- 第 k 轮后:找到所有最多用 k 条边能到的最短路
没有负环时,最短路径不会重复经过节点,最多使用 V-1 条边。所以 V-1 轮一定够。

为什么不用 Dijkstra?
Dijkstra 一旦确定某个点的距离就不再修改。但负权边意味着"绕远路可能更短",这个假设被打破。
A → B 权重 10,A → C 权重 5,C → B 权重 -3
A 到 B 的最短路是 A→C→B = 2,而不是直接的 A→B = 10。Dijkstra 可能提前锁定 B=10,错过更短路线。
Bellman-Ford 从不提前锁定任何点,每轮都重新检查所有边,因此能正确处理负权。
逐步追踪

边:A→B(4), A→C(2), A→F(15), C→B(1), B→D(5), C→D(8), B→E(7), D→E(-6), D→F(4), E→F(2),源点 A。
| 轮次 | dist[A] | dist[B] | dist[C] | dist[D] | dist[E] | dist[F] | 关键变化 |
|---|---|---|---|---|---|---|---|
| 初始 | 0 | ∞ | ∞ | ∞ | ∞ | ∞ | — |
| 第1轮 | 0 | 4 | 2 | ∞ | ∞ | 15 | 直达 B,C,F |
| 第2轮 | 0 | 3 | 2 | 9 | 11 | 15 | C→B 改进 B |
| 第3轮 | 0 | 3 | 2 | 8 | 2 | 13 | B→D, D→E(-6) 连锁 |
| 第4轮 | 0 | 3 | 2 | 8 | 2 | 4 | E→F 最终改进 |
| 第5轮 | 0 | 3 | 2 | 8 | 2 | 4 | 无变化,收敛 |
最终最短路:A→C→B→D→E→F = 2+1+5+(-6)+2 = 4
要点:
- 直达不代表最短:F 初始为 15,最终变成 4
- 负边放大改进:D 变短后,D→E(-6) 让 E 大幅下降
- V-1 轮是上限:6 个节点最多 5 轮,实际第 4 轮就收敛了
算法流程
Bellman-Ford(src):
1. dist[src] = 0, 其余 = ∞
2. 重复 V-1 轮:遍历所有边,尝试松弛
3. 第 V 次检查:如果还能松弛 → 存在负环
负环检测
负环是总权重为负的环,每绕一圈距离就减小,最短路不存在。
A→B(2), B→C(-5), C→A(1) → 环总权 = -2

检测方法:V-1 轮后所有最短路应已稳定。如果第 V 次遍历还能松弛,说明存在从源点可达的负环。
for (auto& [u, v, w] : edges) {
if (dist[u] != INF && dist[u] + w < dist[v]) {
return {}; // 负环!
}
}
⚠️ 此法只检测从源点可达的负环。要检测全图负环,需用"超级源点"技巧(见 SPFA 章节)。
完整实现
// Bellman-Ford 算法 — O(V * E)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
typedef tuple<int, int, int> Edge; // {起点, 终点, 权重}
const ll INF = 1e18;
// 返回最短距离数组,若检测到负环则返回空数组
vector<ll> bellmanFord(int src, int n, vector<Edge>& edges) {
vector<ll> dist(n + 1, INF);
dist[src] = 0;
for (int iter = 0; iter < n - 1; iter++) {
bool updated = false;
for (auto& [u, v, w] : edges) {
if (dist[u] != INF && dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
updated = true;
}
}
if (!updated) break; // 提前收敛
}
// 第 V 次检查:检测从源点可达的负环
for (auto& [u, v, w] : edges) {
if (dist[u] != INF && dist[u] + w < dist[v]) {
return {}; // 存在负环
}
}
return dist;
}
| 关键代码 | 作用 |
|---|---|
dist[u] != INF | 只从已可达节点扩展,避免 INF + w 溢出 |
updated 标记 | 本轮无更新则提前终止 |
| 第 V 次遍历 | 还能松弛 = 存在负环 |
什么时候用 Bellman-Ford?
- 没有负边 → Dijkstra 更快
- 有负边但无负环,求单源最短路 → Bellman-Ford 或 SPFA
- 需要检测从源点可达的负环 → Bellman-Ford
- 图很大 → O(VE) 可能 TLE,考虑 SPFA 或其他方法
💡 一句话总结: 每轮遍历所有边做松弛,第 k 轮保证找到最多用 k 条边的最短路,V-1 轮一定收敛;第 V 轮还能松弛则存在负环。
5.4.4 Floyd-Warshall 算法
一次算出所有节点对之间的最短路径。
核心思想:试试每个节点当中转站
想象你要查全国所有城市之间的最短路线。最朴素的想法:对每对城市 (i, j),直接看有没有边相连。但这只考虑了直达路线。
关键洞察:i 到 j 的最短路,要么直达,要么经过某个中转站 k:
最短路 i→j = min( 直达 i→j, 经过中转 i→k→j )
Floyd-Warshall 就把这个想法系统化:依次尝试每个节点 k 当中转站,看能不能让 i→j 更短。

if (dist[i][k] + dist[k][j] < dist[i][j]) {
dist[i][j] = dist[i][k] + dist[k][j]; // 经过 k 更短,更新
}
逐步追踪
4 个节点(0-3),5 条无向边:0-1(3), 0-2(8), 1-2(2), 1-3(5), 2-3(1)

初始距离矩阵(只填直达边,无直达 = ∞):
| dist | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 0 | 0 | 3 | 8 | ∞ |
| 1 | 3 | 0 | 2 | 5 |
| 2 | 8 | 2 | 0 | 1 |
| 3 | ∞ | 5 | 1 | 0 |
k=0:让节点 0 当中转站。检查所有 (i, j),看 i→0→j 是否比 i→j 更短。
| i | j | i→0→j | 当前 dist[i][j] | 结果 |
|---|---|---|---|---|
| 1 | 2 | 3+8=11 | 2 | 11 ≥ 2,不更新 |
| 2 | 1 | 8+3=11 | 2 | 11 ≥ 2,不更新 |
| 其他 | — | — | — | 节点 3 到 0 不可达,跳过 |
k=0 无更新。当前矩阵不变。
k=1:让节点 1 当中转站。
| i | j | i→1→j | 当前 dist[i][j] | 结果 |
|---|---|---|---|---|
| 0 | 2 | 3+2=5 | 8 | 5 < 8,更新! dist[0][2]=5 |
| 0 | 3 | 3+5=8 | ∞ | 8 < ∞,更新! dist[0][3]=8 |
| 2 | 0 | 2+3=5 | 8 | 更新(对称) |
| 3 | 0 | 5+3=8 | ∞ | 更新(对称) |
| 2 | 3 | 2+5=7 | 1 | 7 ≥ 1,不更新 |
k=1 后矩阵:
| dist | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 0 | 0 | 3 | 5 | 8 |
| 1 | 3 | 0 | 2 | 5 |
| 2 | 5 | 2 | 0 | 1 |
| 3 | 8 | 5 | 1 | 0 |
k=2:让节点 2 当中转站。
| i | j | i→2→j | 当前 dist[i][j] | 结果 |
|---|---|---|---|---|
| 0 | 3 | 5+1=6 | 8 | 6 < 8,更新! dist[0][3]=6 |
| 1 | 3 | 2+1=3 | 5 | 3 < 5,更新! dist[1][3]=3 |
| 0 | 1 | 5+2=7 | 3 | 7 ≥ 3,不更新 |
k=2 后矩阵:
| dist | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 0 | 0 | 3 | 5 | 6 |
| 1 | 3 | 0 | 2 | 3 |
| 2 | 5 | 2 | 0 | 1 |
| 3 | 6 | 3 | 1 | 0 |
k=3:让节点 3 当中转站。所有检查都没有更短的路径,矩阵不变。
最终结果:dist[0][3]=6(路径 0→1→2→3),dist[1][3]=3(路径 1→2→3)

为什么 k 必须是最外层循环?
这是 Floyd-Warshall 最常见的实现错误。
理解关键:当处理中间节点 k 时,dist[i][k] 和 dist[k][j] 必须是还没尝试过 k 当中转站时的值(即只用 {0..k-1} 当中转站算出的最短路)。
- k 在最外层 ✅:处理 k 时,i 和 j 的双层循环只读取
dist[i][k]和dist[k][j],这两个值在当前 k 这轮不会被修改(因为 k 行和 k 列的值只取决于 {0..k-1},不受新的更新影响),所以是安全的 - k 在最内层 ❌:同一个 k 轮中,前面刚更新的
dist[i][k]会被后面的 (i', j') 读取,相当于"同一轮内重复使用 k 当中转站",结果不对
一句话记忆:k 在最外层,i 和 j 在内层——顺序不能换!
完整实现
// Floyd-Warshall 全对最短路径 — O(V^3)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const ll INF = 1e18;
const int MAXV = 505;
ll dist[MAXV][MAXV];
void floydWarshall(int n) {
// 初始化:dist[i][i]=0, 有边设为边权, 无边设为 INF
// ...(读入时已完成)
// ⚠️ 关键:k 必须是最外层循环!
for (int k = 1; k <= n; k++) { // 中转站
for (int i = 1; i <= n; i++) { // 起点
for (int j = 1; j <= n; j++) { // 终点
if (dist[i][k] != INF && dist[k][j] != INF) {
dist[i][j] = min(dist[i][j], dist[i][k] + dist[k][j]);
}
}
}
}
// 若 dist[i][i] < 0,则节点 i 在负环上
}
| 关键代码 | 作用 |
|---|---|
k 在最外层 | 保证 DP 不变量:处理 k 时只用 {1..k-1} 当中转站的结果 |
dist[i][k] != INF | 防止 INF + w 溢出 |
dist[i][i] < 0 | 负环检测:正常情况自己到自己距离为 0,< 0 说明有负环 |
什么时候用 Floyd-Warshall?
- 需要所有节点对之间最短路径,且 V ≤ 500(V³ ≈ 1.25×10⁸ 勉强可行)
- V > 500 时,对每个节点跑 Dijkstra 更快:O(V × (V+E) log V)
- 需要检测全图负环:跑完后检查
dist[i][i] < 0 - 代码极短:只有 5 行核心逻辑,适合 V 小的题目
💡 一句话总结: 依次让每个节点 k 当中转站,更新所有 (i,j) 对——如果 i→k→j 比当前 i→j 更短就更新。三重循环,k 必须在最外层。
5.4.5 算法对比表
| 算法 | 时间复杂度 | 负边 | 负环检测 | 多源 | 最适合 |
|---|---|---|---|---|---|
| BFS | O(V + E) | ✗ 否 | ✗ 否 | ✓ 是(多源 BFS) | 无权图 |
| Dijkstra | O((V+E) log V) | ✗ 否 | ✗ 否 | ✗(每源运行一次) | 加权非负边图 |
| Bellman-Ford | O(V × E) | ✓ 是 | ✓ 是 | ✗ | 负边、检测负环 |
| SPFA | 最坏 O(V × E),平均 O(E) | ✓ 是 | ✓ 是 | ✗ | 稀疏图含负边 |
| Floyd-Warshall | O(V³) | ✓ 是 | ✓ 是(对角线) | ✓ 是(全对) | 稠密图、全对查询 |
如何选择?
图有负边吗?
├── 有 → Bellman-Ford、SPFA(或全对用 Floyd-Warshall)
└── 没有 → V ≤ 500 且需要全对最短路?
├── 是 → Floyd-Warshall O(V³)
└── 否 → 无权图(所有边 = 1)?
├── 是 → BFS O(V+E)
└── 否 → 边权只有 0 或 1?
├── 是 → 0-1 BFS O(V+E)
└── 否 → Dijkstra O((V+E) log V)
5.4.6 SPFA——带队列优化的 Bellman-Ford
上一节学完了 Bellman-Ford:每轮扫一遍所有边,重复 V-1 轮。你可能会想——大多数边一轮下来根本不会产生松弛,扫它们纯属浪费。SPFA 就是来解决这个问题。
从 Bellman-Ford 到 SPFA:一个直觉
Bellman-Ford 每轮做的事:遍历所有 E 条边,看哪些能松弛。
但想想看:只有 dist[u] 刚刚变小的节点 u,它的出边才有可能松弛邻居 v。如果 dist[u] 这一轮没变,那它的邻居们也不会因此变好。
SPFA 的核心思路: 谁的距离刚更新,就把谁加入队列;从队列中取出节点时,只松弛它的邻居。没更新的节点根本不用管。

左边 Bellman-Ford 每轮扫 6 条边,5 轮共 30 次检查;右边 SPFA 只处理更新节点的邻居,总共约 12 次检查——结果完全相同,效率提升显著。
队列的工作流程
SPFA 的结构与 BFS 几乎一模一样,唯一的区别是:BFS 的节点只进队一次,而 SPFA 的节点可以反复进队(因为距离可能被多次改善)。

关键细节:
| 要点 | 说明 |
|---|---|
| 队列里放什么 | 距离刚被更新的节点 |
| 出队后做什么 | 遍历它的所有出边,尝试松弛 |
inQueue 标记 | 如果节点已在队列中,就不重复入队(但 dist 已经更新了,出队时自然使用新值) |
| 为什么可以反复入队 | 因为负边可能让同一条路多次变短;不同于 Dijkstra "锁定"节点,SPFA 允许反复改进 |
逐步追踪
下面用和 Bellman-Ford 完全相同的图来跑 SPFA,方便你对比两种算法的过程。

| 出队 | 松弛操作 | dist 数组 | 队列 |
|---|---|---|---|
| — | 初始:dist[A]=0,A 入队 | A=0, B=∞, C=∞, D=∞, E=∞, F=∞ | {A} |
| A | A→B(4)✓ A→C(2)✓ A→F(15)✓ | A=0, B=4, C=2, D=∞, E=∞, F=15 | {C, B, F} |
| C | C→B(1)✓ B:4→3; C→D(8)✓ | A=0, B=3, C=2, D=10, E=∞, F=15 | {B, F, D} |
| B | B→D(5)✓ D:10→8; B→E(7)✓ | A=0, B=3, C=2, D=8, E=10, F=15 | {F, D, E} |
| F | F 的邻居无法改善 | 不变 | {D, E} |
| D | D→E(-6)✓ E:10→2; D→F(4)✓ F:15→12 | A=0, B=3, C=2, D=8, E=2, F=12 | {E, F} |
| E | E→F(2)✓ F:12→4 | A=0, B=3, C=2, D=8, E=2, F=4 | {F} |
| F | 无改善 | 不变 | {} ← 空,结束! |
最终结果: A→C→B→D→E→F = 2+1+5+(-6)+2 = 4 ——与 Bellman-Ford 完全一致。
💡 对比 Bellman-Ford:BF 跑了 5 轮 × 10 条边 = 50 次边检查;SPFA 只做了约 18 次。节点越多、图越稀疏,SPFA 的优势越明显。
负环检测
和 Bellman-Ford 类似,SPFA 也能检测负环:
- 原理:没有负环时,一个节点最多进队 V-1 次(对应最短路最多 V-1 条边)
- 判据:如果某节点进队次数 ≥ V,说明存在负环
cnt[v]++;
if (cnt[v] >= n) return {}; // 负环!
⚠️ 上面代码检测的是从 src 出发可达的负环。若要判断全图是否存在负环(包含从 src 不可达的部分),需建立超级源点——见下方。
完整实现
// SPFA(Bellman-Ford + 队列优化)
vector<ll> spfa(int src, int n) {
vector<ll> dist(n + 1, INF);
vector<bool> inQueue(n + 1, false);
vector<int> cnt(n + 1, 0); // cnt[v] = v 进入队列的次数
queue<int> q;
dist[src] = 0;
q.push(src);
inQueue[src] = true;
while (!q.empty()) {
int u = q.front(); q.pop();
inQueue[u] = false;
for (auto [w, v] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
if (!inQueue[v]) {
q.push(v);
inQueue[v] = true;
cnt[v]++;
// 负环检测:若节点进入队列 >= n 次
if (cnt[v] >= n) return {}; // 负环!
}
}
}
}
return dist;
}
| 关键代码 | 作用 |
|---|---|
inQueue 数组 | 避免同一节点重复入队,保持队列精简 |
cnt[v]++ | 统计入队次数,用于负环检测 |
inQueue[u] = false | 出队时清除标记,允许后续再次入队 |
负环检测:判断全图是否存在负环
上面的 SPFA 检测的是从 src 出发可达的负环。若要判断全图是否存在负环(包含从 src 不可达的部分),需建立超级源点:
// 判断全图负环(包含不可达部分)
// 建立超级源点 0,向所有节点连 0 权边,从 0 跑 Bellman-Ford
bool hasNegativeCycle(int n) {
// 原图节点 1..n,超级源点 0
vector<ll> dist(n + 1, 0); // 全部初始化为 0(等价于超级源点到所有节点距离为 0)
vector<bool> inQueue(n + 1, true);
vector<int> cnt(n + 1, 0);
queue<int> q;
// 所有节点入队(超级源点效果)
for (int i = 1; i <= n; i++) q.push(i);
while (!q.empty()) {
int u = q.front(); q.pop();
inQueue[u] = false;
for (auto [w, v] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
if (!inQueue[v]) {
q.push(v); inQueue[v] = true;
if (++cnt[v] >= n) return true; // 负环!
}
}
}
}
return false;
}
何时使用 SPFA
- 所有边非负 → Dijkstra 更稳定
- 有负边、无负环、单源最短路 → SPFA 是首选(比 Bellman-Ford 快得多)
- 需要检测可达负环 → SPFA(入队次数判据)
- 需要检测全图负环 → 超级源点 + SPFA
⚠️ SPFA 最坏情况: 最坏时间复杂度是 O(V × E)——与朴素 Bellman-Ford 相同。在精心构造的图(竞赛中常见的「反 SPFA」数据)上,SPFA 会退化并 TLE。所以:能用 Dijkstra 就用 Dijkstra;只有存在负边时才考虑 SPFA。
💡 一句话总结: Bellman-Ford 每轮扫所有边,SPFA 只松弛"刚更新节点的邻居"——用队列跳过无用边,结果相同,通常快得多。
5.4.7 Johnson 算法——全源最短路
Floyd-Warshall 是 O(N³),跑 N 次 Bellman-Ford 是 O(N²M)。Johnson 算法通过重新标注边权,将 N 次 Dijkstra 应用于无负权的图,复杂度 O(NM log M),在稀疏图上优于 Floyd。
算法步骤
- 建超级源点 0,向所有节点连 0 权边
- 用 Bellman-Ford 求 0 到所有点的最短路
h[i](若存在负环则无解) - 重新标注边权:
w'(u,v) = w(u,v) + h[u] - h[v](保证非负) - 以每个点为源点跑 N 次 Dijkstra
- 还原答案: 实际最短路 = Dijkstra 结果 -
h[s]+h[t]
// Johnson 全源最短路 — O(NM log M)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const ll INF = 1e18;
int n, m;
// adj[u] = {v, w},edges 存所有边用于 Bellman-Ford
vector<pair<int,ll>> adj[505];
struct Edge { int u, v; ll w; };
vector<Edge> edges;
vector<ll> bellman_ford(int s) {
vector<ll> dist(n + 1, INF);
dist[s] = 0;
for (int i = 0; i < n; i++) {
for (auto [u, v, w] : edges) {
if (dist[u] != INF && dist[u] + w < dist[v])
dist[v] = dist[u] + w;
}
}
return dist;
}
vector<ll> dijkstra(int s, int n) {
vector<ll> dist(n + 1, INF);
priority_queue<pair<ll,int>, vector<pair<ll,int>>, greater<>> pq;
dist[s] = 0; pq.push({0, s});
while (!pq.empty()) {
auto [d, u] = pq.top(); pq.pop();
if (d > dist[u]) continue;
for (auto [v, w] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
pq.push({dist[v], v});
}
}
}
return dist;
}
// 返回 dist[i][j] = i 到 j 的真实最短路
// 若 i 到 j 不可达返回 INF
vector<vector<ll>> johnson() {
// 超级源点 n+1 向所有节点连 0 权边
for (int i = 1; i <= n; i++)
edges.push_back({n + 1, i, 0});
// Bellman-Ford 求势函数 h[]
vector<ll> h = bellman_ford(n + 1);
// 重新标注边权(保证非负)
for (auto& e : edges) {
if (e.u != n + 1) // 不处理超级源点的虚拟边
e.w += h[e.u] - h[e.v];
}
// 同步更新邻接表
for (int u = 1; u <= n; u++)
for (auto& [v, w] : adj[u])
w += h[u] - h[v];
// N 次 Dijkstra
vector<vector<ll>> ans(n + 1, vector<ll>(n + 1, INF));
for (int s = 1; s <= n; s++) {
auto d = dijkstra(s, n);
for (int t = 1; t <= n; t++) {
if (d[t] != INF)
ans[s][t] = d[t] - h[s] + h[t]; // 还原真实距离
}
}
return ans;
}
💡 为什么重标后边权非负? 三角不等式保证
h[v] ≤ h[u] + w(u,v),因此w'(u,v) = w(u,v) + h[u] - h[v] ≥ 0。
5.4.8 输出最短路径方案
用 pre[] 数组记录前驱节点,松弛时同步更新:
// Dijkstra 带路径输出
vector<int> dijkstra_with_path(int src, int dst, int n) {
vector<ll> dist(n + 1, INF);
vector<int> pre(n + 1, -1); // pre[v] = v 的前驱
priority_queue<pair<ll,int>, vector<pair<ll,int>>, greater<>> pq;
dist[src] = 0; pq.push({0, src});
while (!pq.empty()) {
auto [d, u] = pq.top(); pq.pop();
if (d > dist[u]) continue;
for (auto [v, w] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
pre[v] = u; // 记录前驱
pq.push({dist[v], v});
}
}
}
// 根据 pre[] 还原路径(逆序)
vector<int> path;
for (int v = dst; v != -1; v = pre[v])
path.push_back(v);
reverse(path.begin(), path.end());
// 检查路径是否从 src 出发
if (path.empty() || path[0] != src) return {}; // 不可达
return path; // src → ... → dst
}
当所有边权为 1(无权图)时,BFS 就是用简单队列的 Dijkstra。
0-1 BFS: 当边权只有 0 或 1 时,用双端队列代替队列的强力技巧:

双端队列:[队首 → 距离最小 ... → 队尾 → 距离最大]
松弛邻居 v(经由权重 w 的边 u→v):
w = 0 → push_front(v) (与 u 距离相同——放在前面)
w = 1 → push_back(v) (多一步——放在后面)
💡 效率: 0-1 BFS 运行 O(V+E)——比 Dijkstra 的 O((V+E) log V) 更快。当边权只有 0 和 1 时,始终优先用 0-1 BFS。
// 0-1 BFS — O(V + E),处理 {0,1} 权重边
vector<int> bfs01(int src, int n) {
vector<int> dist(n + 1, INT_MAX);
deque<int> dq;
dist[src] = 0;
dq.push_front(src);
while (!dq.empty()) {
int u = dq.front(); dq.pop_front();
for (auto [w, v] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
if (w == 0) dq.push_front(v); // 0 权重:加到前面
else dq.push_back(v); // 1 权重:加到后面
}
}
}
return dist;
}
5.4.8 网格上的 Dijkstra
许多 USACO 题目涉及网格最短路径,图是隐式的:
// 网格 Dijkstra — 找从 (0,0) 到 (R-1,C-1) 的最短路径
// 每个格子有进入代价
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
typedef tuple<ll,int,int> tli;
const ll INF = 1e18;
int dx[] = {0,0,1,-1};
int dy[] = {1,-1,0,0};
ll dijkstraGrid(vector<vector<int>>& grid) {
int R = grid.size(), C = grid[0].size();
vector<vector<ll>> dist(R, vector<ll>(C, INF));
priority_queue<tli, vector<tli>, greater<tli>> pq;
dist[0][0] = grid[0][0];
pq.push({grid[0][0], 0, 0});
while (!pq.empty()) {
auto [d, r, c] = pq.top(); pq.pop();
if (d > dist[r][c]) continue;
for (int k = 0; k < 4; k++) {
int nr = r + dx[k], nc = c + dy[k];
if (nr < 0 || nr >= R || nc < 0 || nc >= C) continue;
ll newDist = dist[r][c] + grid[nr][nc];
if (newDist < dist[nr][nc]) {
dist[nr][nc] = newDist;
pq.push({newDist, nr, nc});
}
}
}
return dist[R-1][C-1];
}
5.4.9 USACO 真题训练:先判断边权,再选择最短路工具
最短路题的第一步不是写 Dijkstra,而是判断图的边权结构:
| 边权类型 | 首选算法 | 典型信号 |
|---|---|---|
| 所有边权相同 | BFS | 最少步数、无权道路 |
| 非负不同权重 | Dijkstra | 路径代价、时间、距离不同 |
| 只有 0/1 权重 | 0-1 BFS | 免费边/付费边、翻转代价 0 或 1 |
| 有负边 | Bellman-Ford/SPFA | 返利、负代价、差分约束 |
| 多源最近距离 | 多源 BFS / Dijkstra | 最近出口、最近危险点 |
真题 1:Piggy Back(USACO 2014 December Silver)— 三次 BFS 拼出最优会合点
题目链接: USACO 2014 December Silver P1: Piggy Back
对应模式: 无权图最短路 + 枚举会合点
难度定位: Silver 标准
题干解读
Bessie 从节点 1 出发,Elsie 从节点 2 出发,目标都是到达节点 N。Bessie 单独走一条边花费 B 单位能量,Elsie 单独走一条边花费 E 单位;两人会合后一起走,每条边共花费 P 单位。她们可以选择在任何节点会合(也可以不专门会合)。求两人都到达 N 的最小总能量。
数据规模(真题): 1 ≤ B, E, P ≤ 40,000;4 ≤ N ≤ 40,000;1 ≤ M ≤ 40,000;保证图为连通无向无权图。
关键条件:
- 图是无权图,边表示一步道路。
- 会合点未知,但可以枚举。
- 需要知道三个来源到每个点的最短步数:1、2、N。
思路分析
分别从 1、2、N 做 BFS:
d1[x] = Bessie 从 1 到 x 的最少边数
d2[x] = Elsie 从 2 到 x 的最少边数
dn[x] = 从 x 到 N 的最少边数
若在点 x 会合,总代价为:
B * d1[x] + E * d2[x] + P * dn[x]
枚举所有 x 取最小值即可。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
const int INF = 1e9;
vector<int> bfs(int start, const vector<vector<int>>& adj) {
int n = (int)adj.size() - 1;
vector<int> dist(n + 1, INF);
queue<int> q;
dist[start] = 0;
q.push(start);
while (!q.empty()) {
int u = q.front();
q.pop();
for (int v : adj[u]) {
if (dist[v] == INF) {
dist[v] = dist[u] + 1;
q.push(v);
}
}
}
return dist;
}
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("piggyback.in", "r", stdin);
// freopen("piggyback.out", "w", stdout);
long long bCost, eCost, togetherCost;
int n, m;
cin >> bCost >> eCost >> togetherCost >> n >> m;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < m; i++) {
int a, b;
cin >> a >> b;
adj[a].push_back(b);
adj[b].push_back(a);
}
vector<int> d1 = bfs(1, adj);
vector<int> d2 = bfs(2, adj);
vector<int> dn = bfs(n, adj);
long long answer = LLONG_MAX;
for (int meet = 1; meet <= n; meet++) {
if (d1[meet] == INF || d2[meet] == INF || dn[meet] == INF) continue;
long long cost = bCost * d1[meet] + eCost * d2[meet] + togetherCost * dn[meet];
answer = min(answer, cost);
}
cout << answer << "\n";
return 0;
}
复杂度: 三次 BFS,总时间 O(N+M),空间 O(N+M)。
易错点提醒
- 用 Dijkstra 过度复杂化。 本题所有边长度相同,BFS 更简单更快。
- 只枚举两人路径上的交点。 最优会合点可能不是你直观看到的某条路径节点,直接枚举所有点最稳。
- 忘记不可达判断。 若某个距离是 INF,不能参与计算。
- 总代价用 int。 边数和费用相乘,建议用
long long。
拓展思考
这道题体现一个重要技巧:多次最短路 + 枚举中转点。在加权图中,同样思路可以改为从多个源跑 Dijkstra。
真题 2:Shortcut(USACO 2019 January Gold)— Dijkstra 后构造最短路树
题目链接: USACO 2019 January Gold P3: Shortcut
对应模式: Dijkstra + 最短路树 + 子树贡献
难度定位: Gold
题干解读
农场是带权无向图,节点 i 有 c[i] 头奶牛,所有奶牛每天都沿着到 1 号谷仓的最短路回家,总通勤时间 = Σ dist[i] × c[i]。你可以在恰好一个节点修一条直达谷仓的捷径,通过捷径耗时固定为 T(修在节点 v 后,v 及其最短路树子树中所有奶牛都改走 v→1 的捷径)。问最多能减少多少总通勤时间。
数据规模(真题): 2 ≤ N ≤ 10,000;1 ≤ M ≤ 50,000;1 ≤ T ≤ 10⁹;1 ≤ c[i] ≤ 10,000;1 ≤ 边权 ≤ 10,000。
关键条件:
- 需要先知道每个节点到 1 的最短距离。
- 若有多条最短路,题目要求按编号较小父节点确定路径树。
- 某个节点修捷径影响的是其最短路树子树中的所有奶牛。
思路分析
步骤:
- 从节点 1 跑 Dijkstra,得到
dist[x]。 - 同时记录最短路树父节点
parent[x]:若距离更短,更新;若距离相同,选编号更小的父节点。 - 按
parent建树。 - DFS 统计每个节点子树内奶牛数量
subtreeCows[x]。 - 若在 x 修捷径,节省为:
(dist[x] - T) * subtreeCows[x]
取最大值。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
using ll = long long;
const ll INF = (ll)4e18;
struct Edge {
int to;
int w;
};
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("shortcut.in", "r", stdin);
// freopen("shortcut.out", "w", stdout);
int n, m;
ll t;
cin >> n >> m >> t;
vector<ll> cows(n + 1);
for (int i = 1; i <= n; i++) cin >> cows[i];
vector<vector<Edge>> adj(n + 1);
for (int i = 0; i < m; i++) {
int a, b, w;
cin >> a >> b >> w;
adj[a].push_back({b, w});
adj[b].push_back({a, w});
}
vector<ll> dist(n + 1, INF);
vector<int> parent(n + 1, 0);
priority_queue<pair<ll, int>, vector<pair<ll, int>>, greater<pair<ll, int>>> pq;
dist[1] = 0;
parent[1] = 0;
pq.push({0, 1});
while (!pq.empty()) {
auto [d, u] = pq.top();
pq.pop();
if (d != dist[u]) continue;
for (const Edge &e : adj[u]) {
int v = e.to;
ll nd = d + e.w;
if (nd < dist[v] || (nd == dist[v] && u < parent[v])) {
dist[v] = nd;
parent[v] = u;
pq.push({nd, v});
}
}
}
vector<vector<int>> tree(n + 1);
for (int v = 2; v <= n; v++) {
tree[parent[v]].push_back(v);
}
vector<ll> subtreeCows = cows;
vector<int> order;
order.reserve(n);
stack<int> st;
st.push(1);
while (!st.empty()) {
int u = st.top();
st.pop();
order.push_back(u);
for (int v : tree[u]) st.push(v);
}
for (int i = (int)order.size() - 1; i >= 0; i--) {
int u = order[i];
for (int v : tree[u]) {
subtreeCows[u] += subtreeCows[v];
}
}
ll answer = 0;
for (int u = 1; u <= n; u++) {
answer = max(answer, (dist[u] - t) * subtreeCows[u]);
}
cout << answer << "\n";
return 0;
}
复杂度: Dijkstra O((N+M) log N),建树和统计 O(N),空间 O(N+M)。
易错点提醒
- 忽略字典序父节点。 距离相同时必须选编号更小的父节点,否则最短路树错误。
- 只看单个节点奶牛数。 捷径影响整棵子树中的奶牛,不只是当前节点。
- 递归 DFS 栈风险。
N可较大,用迭代顺序统计更稳。 - 节省值可能为负。 取
max时从 0 开始即可,不修捷径相当于节省 0。
拓展思考
Shortcut 是 Gold 中典型的「最短路结果不是终点,而是后续结构的输入」。跑完 Dijkstra 后,还要把最短路关系转成树,再在树上做统计。
⚠️ 五大经典 Dijkstra Bug
- 用
int而不是long long—— 距离和溢出 → 静默的错误答案 - 最大堆而非最小堆 —— 忘记
greater<pii>→ 优先处理错误的节点 - 缺少过期条目检查(
if (d > dist[u]) continue)—— 不是错误但慢约 10 倍 - 忘记
dist[src] = 0—— 所有距离保持为 INF - 对负边用 Dijkstra —— 未定义行为,可能无限循环或给出错误答案
本章总结
📌 核心要点
| 算法 | 复杂度 | 处理负边 | 使用场景 |
|---|---|---|---|
| BFS | O(V+E) | ✗ | 无权图 |
| Dijkstra | O((V+E) log V) | ✗ | 非负权重加权 SSSP |
| Bellman-Ford | O(VE) | ✓ | 负边、检测负环 |
| SPFA | 最坏 O(VE),平均快 | ✓ | 稀疏图含负边 |
| Floyd-Warshall | O(V³) | ✓ | 全对、V ≤ 500 |
| 0-1 BFS | O(V+E) | 不适用 | 只有 0 或 1 权重的边 |
❓ 常见问题
Q1:为什么 Dijkstra 对负边不起作用?
A:Dijkstra 的贪心假设是「当前距离最短的节点不能通过后续路径改善」。有了负边,这个假设失败——通过负边的较长路径最终可能更短。结论:有负边必须用 Bellman-Ford(O(VE))或 SPFA(平均 O(E),最坏 O(VE))。
Q2:SPFA 和 Bellman-Ford 有什么区别?
A:SPFA 是队列优化版的 Bellman-Ford。Bellman-Ford 每轮遍历所有边;SPFA 只更新距离被改善的节点的邻居,用队列追踪哪些节点需要处理。实践中 SPFA 快得多(平均 O(E)),但理论最坏情况相同(O(VE))。
Q3:Floyd-Warshall 中为什么 k 循环必须在最外层?
A:这是最常见的 Floyd-Warshall 实现错误! DP 不变量是:处理第 k 次外层循环后,
dist[i][j]表示只用 {1, 2, ..., k} 作中间节点时从 i 到 j 的最短路径。处理中间节点 k 时,dist[i][k]和dist[k][j]必须已经基于 {1..k-1} 完整计算好。若 k 在内层,dist[i][k]可能在同一轮刚被更新,导致错误结果。记住:k 在最外层,i 和 j 在内层——顺序很重要!
Q4:USACO 题目如何判断用 Dijkstra 还是 BFS?
A:关键问题:边是否有权重?
- 无权图(边权=1 或求最少边数)→ BFS,O(V+E),更快更简单
- 加权图(不同的非负权重)→ Dijkstra
- 边权只有 0 或 1 → 0-1 BFS(比 Dijkstra 快,O(V+E))
- 有负边 → Bellman-Ford/SPFA
Q5:什么时候用 Floyd-Warshall?
A:需要所有节点对之间的最短距离,且 V ≤ 500(
O(V³)≈ 1.25×10^8 在 V=500 时勉强可行)。典型场景:给定多个源和目标,查询任意对之间的距离。V > 500 时,对每个节点运行 Dijkstra(O(V × (V+E) log V))更快。
🔗 与其他章节的联系
- 第 5.2 章(BFS 与 DFS):BFS 是「无权图的 Dijkstra」;本章是 BFS 的直接扩展
- 第 5.5 章(二叉树与树算法):树上的最短路径就是唯一的根到节点路径(DFS/BFS 够用)
- 第 6.1 章(DP 入门):Floyd-Warshall 本质上是 DP(状态 = 「使用前 k 个节点」);很多最短路变体可以用 DP 建模
- USACO Gold:最短路 + DP 的组合、最短路 + 二分搜索、最短路 + 数据结构优化
5.4.10 负环与差分约束
前面几节我们反复强调「有负环时最短路不存在」。本节补上两块拼图:如何严格判定负环,以及负环判定最重要的应用——差分约束系统:把一组形如 x[j] − x[i] ≤ c 的不等式变成一张图,用最短路求解。
负环判定的两种标准写法
方法一:Bellman-Ford 第 N 轮。 5.4.3 节说过,没有负环时 V−1 轮一定收敛。反过来:
判定准则:跑完 V−1 轮后再做第 V 轮,如果仍存在能松弛的边 ⇔ 图中有负环。
⚠️ 注意:朴素写法只能检测从源点可达的负环。要判定全图是否含负环,用「超级源点」技巧:虚拟一个源点 0 向所有节点连 0 权边(等价实现:dist 全部初始化为 0,所有节点入队)。
方法二:SPFA 计数法。 没有负环时,任何节点的最短路最多 V−1 条边,所以一个点最多被松弛更新 V−1 次:
判定准则:若某个节点入队次数 ≥ V,说明存在负环。
超级源点版两种方法写在一起(实测输出一致):
// 负环判定:Bellman-Ford 与 SPFA 双判定(超级源点版,检测全图)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const ll INF = 1e18;
int n, m;
vector<tuple<int,int,ll>> edges; // {u, v, w}
vector<vector<pair<int,ll>>> adj; // adj[u] = {v, w}
// 方法一:Bellman-Ford——第 n 轮仍能松弛 <=> 有负环
bool bellmanFordHasNegCycle() {
vector<ll> dist(n + 1, 0); // 超级源点版:全部初值 0
for (int i = 1; i <= n; i++) { // 跑 n 轮
bool updated = false;
for (auto& [u, v, w] : edges)
if (dist[u] != INF && dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
updated = true;
}
if (!updated) return false; // 提前收敛,无负环
}
return true; // 第 n 轮仍在松弛 → 负环
}
// 方法二:SPFA——某点入队次数 >= n <=> 有负环
bool spfaHasNegCycle() {
vector<ll> dist(n + 1, 0);
vector<bool> inQueue(n + 1, true);
vector<int> cnt(n + 1, 0); // ⚠️ cnt 初值必须是 0
queue<int> q;
for (int i = 1; i <= n; i++) q.push(i); // 全部入队 = 超级源点效果
while (!q.empty()) {
int u = q.front(); q.pop();
inQueue[u] = false;
for (auto [v, w] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
if (!inQueue[v]) {
q.push(v); inQueue[v] = true;
if (++cnt[v] >= n) return true; // 负环!
}
}
}
}
return false;
}
int main() {
cin >> n >> m;
adj.assign(n + 1, {});
for (int i = 0; i < m; i++) {
int u, v; ll w; cin >> u >> v >> w;
edges.push_back({u, v, w});
adj[u].push_back({v, w});
}
cout << (bellmanFordHasNegCycle() ? "YES" : "NO") << "\n";
cout << (spfaHasNegCycle() ? "YES" : "NO") << "\n";
return 0;
}
验证(手算核对):
输入 1:3 点 3 边,环 1→2(1)→3(-1)→1(-1),环权 = -1 < 0
→ 两种方法都输出 YES ✅
输入 2:3 点 3 边 1→2(4), 1→3(2), 2→3(1),无环
→ 两种方法都输出 NO ✅
输入 3:负环在 2↔3(各 -5),从节点 1 「不可达」……但超级源点版照样报 YES ✅
输入 3 正是超级源点的价值:朴素 Bellman-Ford 从节点 1 出发检测不到这个负环。
差分约束系统:不等式组 ⟺ 图
定义: n 个变量 x₁..xₙ,m 条约束,每条形如 x[j] − x[i] ≤ c(c 可正可负)。求一组满足所有约束的取值,或判定无解。
核心观察: 把不等式改写成 x[j] ≤ x[i] + c,这和最短路松弛后的三角不等式 dist[v] ≤ dist[u] + w 一模一样。于是:
建边规则:约束
x[j] − x[i] ≤ c⟺ 从 i 向 j 连一条权为 c 的有向边。
跑完单源最短路后,dist[] 本身就是一组解——因为每条边 (i→j, c) 都满足 dist[j] ≤ dist[i] + c。
求解流程:
- 每条约束
x[j] − x[i] ≤ c加边 i→j 权 c - 建超级源点 0,向所有节点连 0 权边(保证连通 + 能检测全图负环)
- 从 0 跑 Bellman-Ford / SPFA
- 有负环 ⇔ 不等式组无解(例如
x₁ < x₂且x₂ < x₁转出的图恰是负环);否则x[i] = dist[i]是一组解
为什么会有解? 若 {a₁..aₙ} 是解,{a₁+d..aₙ+d} 也是解(做差后 d 被消掉)——差分约束只能确定变量之间的相对关系。超级源点连 0 权边相当于固定 x[i] ≤ 0。
求最大解还是最小解? 这是差分约束最容易搞混的地方:
| 想要什么 | 怎么跑 | 原理 |
|---|---|---|
| x[i] 的最大取值 | 边权 c,跑最短路 | 每条 x[j] ≤ x[i] + c 都是收紧的上界,最短路把上界压到最紧 |
| x[i] 的最小取值 | 边权取反建 ≥,跑最长路 | 对偶地把下界抬到最紧 |
常见约束的转换表(先统一成 ≤ 形式再建边):
| 题意 | 转化 | 连边 |
|---|---|---|
x[a] − x[b] ≥ c | x[b] − x[a] ≤ −c | add(a, b, −c) |
x[a] − x[b] ≤ c | 不变 | add(b, a, c) |
x[a] = x[b] | 双向 ≤ 0 | add(a, b, 0), add(b, a, 0) |
可行性判定完整程序(小 K 的农场 风格)
🐄 题目(洛谷 P1993 风格): n 个变量 x₁..xₙ,m 条约束,每条是
x[a] − x[b] ≥ c、x[a] − x[b] ≤ c或x[a] = x[b]三种之一。判断是否有解。
// 差分约束可行性判定 — O(nm)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 10005, MAXM = 300005; // ⚠️ MAXM 必须装下:m 条约束 + n 条源点边
// (等式约束一条拆两条,还要留余量!)
int head[MAXN], nxt[MAXM], to[MAXM], wt[MAXM], ecnt = 0;
long long dist_[MAXN];
int cnt_[MAXN];
bool inQ[MAXN];
void addEdge(int u, int v, int w) { // u → v 权 w,对应 x[v] <= x[u] + w
to[ecnt] = v; wt[ecnt] = w; nxt[ecnt] = head[u]; head[u] = ecnt++;
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
memset(head, -1, sizeof(head));
for (int i = 0; i < m; i++) {
int op, a, b, c = 0;
cin >> op >> a >> b;
if (op != 3) cin >> c;
if (op == 1) addEdge(a, b, -c); // x[a]-x[b] >= c => x[b] <= x[a]-c
else if (op == 2) addEdge(b, a, c); // x[a]-x[b] <= c => x[a] <= x[b]+c
else { addEdge(a, b, 0); addEdge(b, a, 0); } // x[a] = x[b]
}
// 超级源点 0 → 所有节点连 0 权边
for (int i = 1; i <= n; i++) addEdge(0, i, 0);
// SPFA 判负环(超级源点版:dist 全 0,全部入队)
memset(dist_, 0, sizeof(dist_));
memset(cnt_, 0, sizeof(cnt_)); // ⚠️ cnt 初值必须是 0
queue<int> q;
for (int i = 0; i <= n; i++) { q.push(i); inQ[i] = true; }
bool negCycle = false;
while (!q.empty() && !negCycle) {
int u = q.front(); q.pop();
inQ[u] = false;
for (int e = head[u]; e != -1; e = nxt[e]) {
int v = to[e];
if (dist_[u] + wt[e] < dist_[v]) {
dist_[v] = dist_[u] + wt[e];
if (!inQ[v]) {
q.push(v); inQ[v] = true;
if (++cnt_[v] >= n + 1) { negCycle = true; break; } // 共 n+1 个点
}
}
}
}
cout << (negCycle ? "No" : "Yes") << "\n";
return 0;
}
验证(手算核对):
输入 1:x₁=x₂, x₁−x₂≥5, x₂−x₃≤2 → x₁=x₂ 与 x₁≥x₂+5 矛盾 → 输出 No ✅
输入 2:x₁−x₂≥1 且 x₂−x₁≥1 → x₁ > x₂ > x₁ 矛盾 → 输出 No ✅
输入 3:只有 x₁ = x₂ → 取 x₁=x₂=0 即可 → 输出 Yes ✅
经典例题:区间约束(POJ 1201 风格)
🐄 题目: 从
0..N中选若干整数(每个数最多选一次),给定 n 个约束「区间 [a, b] 中至少要选 c 个数」。求最少要选多少个数。输入格式: 第一行 n 和 N;接下来 n 行每行 a、b、c(1 ≤ a ≤ b ≤ N ≤ 5×10⁴)。
建模: 设 S[i] = 在 0..i 中已选的个数(前缀和),则:
| 题目条件 | 不等式 | 建边(≥ 形式,边 u→v 权 w 表示 S[v] ≥ S[u] + w) |
|---|---|---|
| 区间 [a,b] 至少选 c 个 | S[b] − S[a−1] ≥ c | add(a−1, b, c) |
| 前缀单调不减(不选也行) | S[i] − S[i−1] ≥ 0 | add(i−1, i, 0) |
| 每个数最多选一次 | S[i] − S[i−1] ≤ 1,即 S[i−1] ≥ S[i] − 1 | add(i, i−1, −1) |
求最少选多少个 = 求 S[N] 的最小值 = 求 S 的最小取值 → 跑最长路(SPFA 里把 < 换成 >)。由于相邻约束 i−1↔i 把整张图串成链,从 S[0]=0 出发天然连通,甚至不需要超级源点。
// 区间约束:最少选数 — 差分约束 + 最长路 SPFA
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, N; // n 个约束,数值范围 0..N
cin >> n >> N;
vector<vector<pair<int,int>>> adj(N + 1); // adj[u] = {v, w} 表示 S[v] >= S[u] + w
for (int i = 0; i < n; i++) {
int a, b, c; cin >> a >> b >> c;
adj[a - 1].push_back({b, c}); // S[b] >= S[a-1] + c
}
for (int i = 1; i <= N; i++) {
adj[i - 1].push_back({i, 0}); // S[i] >= S[i-1] + 0
adj[i].push_back({i - 1, -1}); // S[i-1] >= S[i] - 1
}
// 最长路 SPFA(求最小取值):松弛方向是「变大」
vector<int> dist(N + 1, INT_MIN);
vector<bool> inQueue(N + 1, false);
queue<int> q;
dist[0] = 0; q.push(0); inQueue[0] = true;
while (!q.empty()) {
int u = q.front(); q.pop();
inQueue[u] = false;
for (auto [v, w] : adj[u]) {
if (dist[u] + w > dist[v]) { // ⚠️ 最长路:> 而不是 <
dist[v] = dist[u] + w;
if (!inQueue[v]) { q.push(v); inQueue[v] = true; }
}
}
}
cout << dist[N] << "\n";
return 0;
}
验证:
输入:n=3, N=5,约束 (1,3,2), (2,5,3), (1,5,2)
输出:3 ✅ (手算:选 {2,3,4}——区间[1,3]含2个、[2,5]含3个、[1,5]含3个,全部满足)
输入:n=1, N=10,约束 (1,10,1)
输出:1 ✅ (随便选一个数即可)
⚠️ 差分约束与负环的四大常见错误
- SPFA 判负环的
cnt初值错误。cnt[v]统计的是 v 入队次数,必须从 0 开始,在每次q.push(v)时++cnt[v]并与 n 比较。常见 bug:把cnt写成「松弛次数」(那要和 n×m 比,用 n 会误报)、或在初始化入队时就给 cnt 加了 1 导致正常图误判负环。 - 方向搞反:到底最短路还是最长路? 记住对偶关系:
≤约束 + 最短路 → 求得每组变量的最大取值;≥约束 + 最长路 → 求得最小取值。如果题目求「最少选多少个」,你却跑了最短路,得到的是「至多」语义的答案。写代码前先明确一组解的语义,再选方向。 - 链式前向星边数组开小。 差分约束的实际边数 = m 条约束边 + n 条超级源点边,等式约束还要一条拆两条。
MAXM至少开m + n + m(上界再留余量),否则addEdge静默越界——RE 都算运气好,最怕改了别的数组还全然不知。 - 忘记超级源点 / 连通性。 不加超级源点,SPFA 只能检测从源点可达的负环,图不连通时会漏判「无解」。另外注意有些题(如上面的区间题)约束本身已把所有点串起来,这时可以省掉超级源点——但要先想清楚为什么可以省。
💡 一句话总结: 差分约束 = 把
x[j] − x[i] ≤ c变成边 i→j 权 c,超级源点连全图跑 SPFA;有负环 ⇔ 无解;求最大用最短路、求最小用最长路。
练习题
题目 5.4.1 — 经典 Dijkstra 🟢 简单
题目: 给定 N 座城市(1 ≤ N ≤ 10⁵)和 M 条双向道路(1 ≤ M ≤ 2×10⁵),各有行驶时间 w(1 ≤ w ≤ 10⁹)。找从城市 1 到城市 N 的最短行驶时间,若不可达输出 −1。答案可能超过 int 范围,用 64 位整数。
输入格式: 第一行 N 和 M;接下来 M 行每行 u、v、w。
样例输入 1:
5 6
1 2 2
1 3 4
2 3 1
2 4 7
3 5 3
4 5 1
样例输出 1: 6(最短路:1→2→3→5,代价 2+1+3=6)
样例输入 2: 3 个城市,节点 3 不可达 → 输出: -1
💡 提示
从节点 1 做标准 Dijkstra。距离用 long long——最大路径 = N × 最大权重 = 10^5 × 10^9 = 10^14,int 会溢出。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
typedef pair<ll,int> pli;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<vector<pair<int,int>>> adj(n + 1);
for (int i = 0; i < m; i++) {
int u, v, w; cin >> u >> v >> w;
adj[u].push_back({v, w});
adj[v].push_back({u, w});
}
vector<ll> dist(n + 1, LLONG_MAX);
priority_queue<pli, vector<pli>, greater<pli>> pq;
dist[1] = 0;
pq.push({0, 1});
while (!pq.empty()) {
auto [d, u] = pq.top(); pq.pop();
if (d > dist[u]) continue;
for (auto [v, w] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
pq.push({dist[v], v});
}
}
}
cout << (dist[n] == LLONG_MAX ? -1 : dist[n]) << "\n";
return 0;
}
// 时间:O((N + M) log N),空间:O(N + M)
题目 5.4.2 — 网格 BFS 🟢 简单
题目: 机器人从 R×C 网格(1 ≤ R, C ≤ 1000)的格子 (0,0) 出发,部分格子是墙(#),其余可通行(.),每步可上下左右移动一格。找到达 (R-1, C-1) 的最少步数,不可能时输出 −1。
输入格式: 第一行 R 和 C;接下来 R 行每行一个长度为 C 的字符串。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int R, C;
cin >> R >> C;
vector<string> grid(R);
for (auto& row : grid) cin >> row;
vector<vector<int>> dist(R, vector<int>(C, -1));
queue<pair<int,int>> q;
if (grid[0][0] != '#') {
dist[0][0] = 0;
q.push({0, 0});
}
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr >= 0 && nr < R && nc >= 0 && nc < C
&& grid[nr][nc] != '#' && dist[nr][nc] == -1) {
dist[nr][nc] = dist[r][c] + 1;
q.push({nr, nc});
}
}
}
cout << dist[R-1][C-1] << "\n";
return 0;
}
题目 5.4.3 — 负边检测 🟡 中等
题目: 给定有 N 个节点(1 ≤ N ≤ 10³)、M 条有向边(1 ≤ M ≤ 10⁴,权重 −10⁹ ≤ w ≤ 10⁹,保证无自环)的有向图,找从节点 1 到节点 N 的最短距离。若存在可从节点 1 到达且能到达节点 N 的负环,输出 "NEGATIVE CYCLE"。若节点 N 不可达,输出 "UNREACHABLE"。距离用 64 位整数。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<tuple<int,int,ll>> edges(m);
for (auto& [u, v, w] : edges) cin >> u >> v >> w;
const ll INF = 1e18;
vector<ll> dist(n + 1, INF);
dist[1] = 0;
// Bellman-Ford:V-1 遍
for (int iter = 0; iter < n - 1; iter++) {
for (auto [u, v, w] : edges) {
if (dist[u] != INF && dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
}
}
}
// 第 V 遍:检测负环
vector<bool> inNegCycle(n + 1, false);
for (int iter = 0; iter < n; iter++) {
for (auto [u, v, w] : edges) {
if (dist[u] != INF && dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
inNegCycle[v] = true;
}
if (inNegCycle[u]) inNegCycle[v] = true;
}
}
if (dist[n] == INF) cout << "UNREACHABLE\n";
else if (inNegCycle[n]) cout << "NEGATIVE CYCLE\n";
else cout << dist[n] << "\n";
return 0;
}
题目 5.4.4 — 多源 BFS:僵尸爆发 🟡 中等
题目: K(1 ≤ K ≤ N)座已感染城市同时爆发僵尸。城市间共有 M 条双向道路(无权,走一条路花 1 个时间单位),N 座城市编号 1~N(1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵)。每个时间单位,僵尸扩散到所有相邻(未感染)城市。找僵尸到达每座可达城市的最少时间,永远无法到达的城市输出 −1。
输入格式: 第一行 N、M、K;接下来 M 行每行 u、v;最后一行 K 个感染城市编号。
💡 提示
多源 BFS:将所有 K 座感染城市以时间 0 加入队列。然后正常运行 BFS。这等价于添加一个虚拟「超级源点」通过 0 代价边连接到所有 K 座城市。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m, k;
cin >> n >> m >> k;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
vector<int> dist(n + 1, -1);
queue<int> q;
// 将所有 K 个僵尸源以时间 0 压入
for (int i = 0; i < k; i++) {
int z; cin >> z;
dist[z] = 0;
q.push(z);
}
// 从所有源同时做标准 BFS
while (!q.empty()) {
int u = q.front(); q.pop();
for (int v : adj[u]) {
if (dist[v] == -1) {
dist[v] = dist[u] + 1;
q.push(v);
}
}
}
for (int u = 1; u <= n; u++) {
cout << dist[u];
if (u < n) cout << " ";
}
cout << "\n";
return 0;
}
题目 5.4.5 — Floyd 全对最短路 🟡 中等
题目: 给定 N 座城市(1 ≤ N ≤ 300)和 M 条双向道路(1 ≤ M ≤ N(N−1)/2,边权 1 ≤ w ≤ 10⁹),回答 Q 次查询(1 ≤ Q ≤ 10⁵):「城市 u 到城市 v 的最短距离在 D 以内吗?」在以内输出 YES,否则输出 NO(u = v 时距离为 0)。
输入格式: 第一行 N 和 M;接下来 M 行每行 u、v、w;下一行 Q;接下来 Q 行每行 u、v、D。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
const ll INF = 1e18;
vector<vector<ll>> dist(n + 1, vector<ll>(n + 1, INF));
for (int i = 1; i <= n; i++) dist[i][i] = 0;
for (int i = 0; i < m; i++) {
int u, v; ll w;
cin >> u >> v >> w;
dist[u][v] = min(dist[u][v], w);
dist[v][u] = min(dist[v][u], w);
}
// Floyd-Warshall:O(N³)
for (int k = 1; k <= n; k++)
for (int i = 1; i <= n; i++)
for (int j = 1; j <= n; j++)
if (dist[i][k] != INF && dist[k][j] != INF)
dist[i][j] = min(dist[i][j], dist[i][k] + dist[k][j]);
int q;
cin >> q;
while (q--) {
int u, v; ll D;
cin >> u >> v >> D;
cout << (dist[u][v] <= D ? "YES" : "NO") << "\n";
}
return 0;
}
// 时间:O(N³ + Q),空间:O(N²)
题目 5.4.6 — 最大瓶颈路径 🔴 困难
题目: 给定 N 座城市(1 ≤ N ≤ 10⁵)和 M 条双向道路(1 ≤ M ≤ 2×10⁵),每条道路有重量限制 w(1 ≤ w ≤ 10⁶,能通过的最大货物重量)。找从城市 1 到城市 N 最大化路径最小边权的路径——即一趟能运送的最重货物;不可达时输出 −1。
💡 提示
修改版 Dijkstra: 不是最小化总代价,而是最大化瓶颈。dist[v] = 到 v 的任意路径的最大最小边权。用最大堆。松弛:dist[v] = max(dist[v], min(dist[u], weight(u,v)))。
#include <bits/stdc++.h>
using namespace std;
typedef pair<int,int> pii;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<vector<pii>> adj(n + 1);
for (int i = 0; i < m; i++) {
int u, v, w; cin >> u >> v >> w;
adj[u].push_back({v, w});
adj[v].push_back({u, w});
}
// 修改版 Dijkstra:最大化瓶颈
vector<int> dist(n + 1, 0);
priority_queue<pii> pq; // 最大堆:{瓶颈, 节点}
dist[1] = INT_MAX;
pq.push({INT_MAX, 1});
while (!pq.empty()) {
auto [d, u] = pq.top(); pq.pop();
if (d < dist[u]) continue;
for (auto [v, w] : adj[u]) {
int newBottleneck = min(dist[u], w); // ← 关键:取路径上的最小值
if (newBottleneck > dist[v]) {
dist[v] = newBottleneck;
pq.push({dist[v], v});
}
}
}
cout << dist[n] << "\n";
return 0;
}
// 时间:O((N + M) log N),空间:O(N + M)
题目 5.4.7 — 差分约束:日程安排 🟡 中等
题目: 你要安排 n(1 ≤ n ≤ 500)项任务,任务 i 需要 t[i](1 ≤ t[i] ≤ 100)个连续时间单位完成。给定 m(0 ≤ m ≤ 3000)条先后约束,每条形如「任务 a 必须在任务 b 开始之前结束」(即 x[b] ≥ x[a] + t[a],其中 x[i] 是任务 i 的开始时刻,时刻从 0 开始)。求在所有满足约束的安排中,max(x[i]) 的最小值(无约束时答案为 0)。
输入格式: 第一行 n 和 m;第二行 n 个整数 t[1..n];接下来 m 行每行 a、b(a ≠ b),表示任务 a 先于任务 b。
样例输入:
3 2
5 3 2
1 2
2 3
样例输出: 8(一种最优安排:x[1]=0, x[2]=5, x[3]=8,最晚开始的任务 3 最早只能在时刻 8 开始)
💡 提示
对每条约束 x[b] ≥ x[a] + t[a] 建边 a → b 权 t[a](最长路语义)。求 max(x) 的最小值即求每组 x 的最小取值 → 从超级源点向所有任务连 0 权边、跑最长路 SPFA,答案 = max(dist[i])(无约束的任务 dist=0,所以答案至少为 0)。SPFA 可顺便判负环——若约束中出现环(如 1 先于 2、2 又先于 1)则无解;本题保证不会发生,但养成判的习惯更安全。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<int> t(n + 1);
for (int i = 1; i <= n; i++) cin >> t[i];
vector<vector<pair<int,int>>> adj(n + 1); // adj[u]={v,w}: x[v] >= x[u] + w
for (int i = 0; i < m; i++) {
int a, b; cin >> a >> b;
adj[a].push_back({b, t[a]}); // x[b] >= x[a] + t[a]
}
for (int i = 1; i <= n; i++) adj[0].push_back({i, 0}); // 超级源点
// 最长路 SPFA(求最小取值)
vector<int> dist(n + 1, INT_MIN);
vector<bool> inQueue(n + 1, false);
queue<int> q;
dist[0] = 0; q.push(0); inQueue[0] = true;
while (!q.empty()) {
int u = q.front(); q.pop();
inQueue[u] = false;
for (auto [v, w] : adj[u]) {
if (dist[u] + w > dist[v]) { // 最长路:> 而不是 <
dist[v] = dist[u] + w;
if (!inQueue[v]) { q.push(v); inQueue[v] = true; }
}
}
}
int latest = 0;
for (int i = 1; i <= n; i++) latest = max(latest, dist[i]);
cout << latest << "\n";
return 0;
}
// 时间:O(nm)(SPFA 最坏),空间:O(n + m)
第 5.4 章结束 — 下一章:第 6.1 章:动态规划入门
第 5.5 章:二叉树与树算法
🎯 本章目标: 从零开始理解二叉树,先掌握节点、递归和遍历,再学习 BST、LCA、欧拉序等竞赛常用技巧。每一步都会用直觉、图示和代码解释,确保你不仅会写代码,更理解背后的「为什么」。
1. 先认识树的基本结构:根、父子关系、深度、高度。
2. 再学习树的表示方式与递归思维:为什么树天然适合递归。
3. 接着学习遍历:前序、中序、后序、层序,这是后面所有算法的共同基础。
4. 然后进入第一个应用:二叉搜索树(BST),理解有序结构如何支持搜索、插入、删除。
5. 最后扩展到竞赛树算法:LCA 二进制倍增与欧拉序,把树上查询优化到
O(log N) 或更快。
🧭 阅读建议: 如果你第一次学树,请按顺序阅读;如果你已经会遍历,可以直接跳到 BST 或 LCA。但不要跳过遍历思想——LCA、欧拉序、树形 DP 本质上都建立在 DFS 遍历之上。
5.5.0 从一道题出发:家谱的最近公共祖先
先看一道 Silver 风格的题目:
🐄 题目:家族聚会(USACO 风格,LCA 模型) 一头传奇奶牛的家族是一棵家谱树:祖先在上,后代在下,每个节点有唯一的父亲。给出
N(1 ≤ N ≤ 10⁵)个节点的家谱(根为节点 1,N−1 条父子关系)和Q(1 ≤ Q ≤ 10⁵)次询问:奶牛u和奶牛v的最近公共祖先是谁——同时是两者祖先、且离它们最近的那头牛?输入格式: 第一行 N 和 Q;第 2..N 行给出节点 2..N 的父节点;接下来 Q 行每行 u 和 v。 数据规模: 1 ≤ N, Q ≤ 10⁵。单次 O(N) 的暴力爬树总代价 O(NQ) = 10¹⁰ 会超时,需要 O(N log N) 预处理 + O(log N) 查询。
家谱: 1
/ \
2 3
/ \
4 5
询问 (4, 5) → 答案 2
询问 (4, 3) → 答案 1
先试试你会的方法
思路 1:对每次询问,一步步往上走? 从 4、5 各自往上标记祖先,直到相遇——单次最坏 O(N),Q 次询问就是 O(NQ) = 10¹⁰,超时。
思路 2:数组/哈希存「谁是祖先」? 关系是「层级」而不是「顺序」,第 3 部分的线性结构都装不下「一个父亲、多个孩子、深度不限」的形状。
关键观察: 这棵家谱有一个宝贵性质——每个节点最多分出有限个孩子,且没有任何环路。这种「连通无环」的结构叫树。树的层级性让它天然适合递归处理(整棵树的问题 = 根 + 两个子树的同类问题),也让「往上走 k 步」可以被倍增加速。
拆解这道题需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 5.5.1 | 树/二叉树是什么?为什么它天然适合递归? |
| 5.5.2 | 怎么访问所有节点?前序/中序/后序/层序遍历 |
| 5.5.3 | 高度、规模、平衡——树的「形状」指标 |
| 5.5.4–5.5.5 | 二叉搜索树:让树支持有序查找 |
| 5.5.6 | 只给遍历序列,能还原树吗? |
| 5.5.7–5.5.8 | LCA:从 O(N) 暴力到 O(log N) 倍增——本题的正解 |
| 5.5.9 | 欧拉序:把子树问题变成区间问题 |
5.5.1 从树到二叉树:先建立模型
用生活直觉理解二叉树
想象一个公司的组织架构:CEO 在最顶端,他直接管理两个部门(左:技术部,右:市场部);每个部门经理又各管两个小组…… 这种每个节点最多分两叉的层级结构,就是二叉树。
更准确地定义:
二叉树是一种层级数据结构:
- 每个节点最多有 2 个子节点:左子节点和右子节点
- 恰好有一个根节点(无父节点)
- 每个非根节点恰好有一个父节点
先分清 3 个概念
很多初学者会把「二叉树」「二叉搜索树」「普通树」混在一起。它们的关系是:
| 名称 | 限制 | 典型用途 |
|---|---|---|
| 普通树 | 每个节点可以有任意多个子节点 | 家族关系、文件夹、通用树题 |
| 二叉树 | 每个节点最多 2 个子节点 | 遍历、表达式树、堆、线段树基础 |
| 二叉搜索树(BST) | 二叉树 + 左小右大 | 有序集合、搜索、插入、删除 |
🔑 关键区别: 二叉树只限制「最多两个孩子」,并不要求左边小、右边大;BST 才有排序性质。先理解二叉树的结构与遍历,再理解 BST 的有序性,会更自然。
叶节点 — 没有子节点的节点
内部节点 — 至少有一个子节点的节点
高度 — 从根到任意叶节点的最长路径(边数)
深度 — 从根到该节点的距离(边数)
子树 — 一个节点及其所有后代
💡 深度 vs 高度的区别: 深度是从根往下看,高度是从叶往上量。就像一栋楼——你住的楼层是"深度",这栋楼的总层数是"高度"。
图示

在这棵树中:
- 高度 = 2(最长的根到叶路径:A → B → D,经过了 2 条边)
- 根 = A,叶节点 = D, E, F
- B 是 D 和 E 的父节点;D 是 B 的左子节点,E 是 B 的右子节点
在程序里如何表示二叉树
二叉树常见有两种表示方式:
- 指针表示:每个节点保存
left和right指针,最贴近树的结构,适合讲解 BST、递归遍历、构造/删除节点。 - 数组表示:如果树接近完全二叉树,可以用下标表示父子关系,例如堆中常用
left = 2*i、right = 2*i+1。
本章前半部分用指针表示,因为它最容易看清楚「节点—左子树—右子树」的递归关系。后面的 LCA 和欧拉序会改用邻接表,因为竞赛题通常给的是普通树,而不是指针二叉树。
C++ 节点定义
本章使用统一的 struct TreeNode:
#include <bits/stdc++.h>
using namespace std;
struct TreeNode {
int val;
TreeNode* left;
TreeNode* right;
// 构造函数:用值初始化,无子节点
TreeNode(int v) : val(v), left(nullptr), right(nullptr) {}
};
💡 为什么用裸指针? 竞赛编程中为速度通常手动管理内存。
nullptr(C++11)始终比未初始化的指针安全——务必初始化left = right = nullptr。
5.5.2 树的遍历:先学会如何访问节点
遍历 = 恰好访问每个节点一次。学习树算法时,遍历是第一块地基:后面的 BST 中序输出、树高计算、LCA 预处理、欧拉序,本质上都依赖遍历。
三种 DFS 遍历访问的是同一棵树,但「处理根节点」的时机不同:

递归遍历的统一模板
看到树的递归代码时,可以固定问自己 3 个问题:
- 当前节点为空怎么办? 这是递归的基础情况。
- 当前节点要做什么? 比如输出值、统计答案、更新深度。
- 左右子树什么时候处理? 根在前就是前序,根在中间就是中序,根在最后就是后序。
void dfs(TreeNode* root) {
if (root == nullptr) return; // 1. 空节点直接返回
// 2. 在这里处理 root,就是前序
dfs(root->left); // 3. 递归处理左子树
// 2. 在这里处理 root,就是中序
dfs(root->right); // 3. 递归处理右子树
// 2. 在这里处理 root,就是后序
}
有 4 种基本遍历:
| 遍历 | 顺序 | 使用场景 |
|---|---|---|
| 前序 | 根 → 左 → 右 | 复制树、前缀表达式 |
| 中序 | 左 → 根 → 右 | BST 有序输出 |
| 后序 | 左 → 右 → 根 | 删除树、后缀表达式 |
| 层序 | BFS 按层 | 最短路、层级操作 |
💡 记忆口诀: 前序的"根"在最前,中序的"根"在中间,后序的"根"在最后。名字就暗示了顺序!
5.5.2.1 前序遍历
前序遍历就像领导视察:先看当前部门,再去左边,再去右边。
// 前序遍历 — O(N) 时间,O(H) 空间(H = 高度)
// 访问顺序:根,左子树,右子树
void preorder(TreeNode* root) {
if (root == nullptr) return; // 基础情况
cout << root->val << " "; // 先处理根
preorder(root->left); // 然后左子树
preorder(root->right); // 然后右子树
}
// 对于树: [5]
// / \
// [3] [8]
// / \
// [1] [4]
// 前序:5 3 1 4 8
迭代版前序(用栈):
// 前序遍历迭代版
void preorderIterative(TreeNode* root) {
if (root == nullptr) return;
stack<TreeNode*> stk;
stk.push(root);
while (!stk.empty()) {
TreeNode* node = stk.top(); stk.pop();
cout << node->val << " "; // 处理当前节点
// 先压右子节点(这样左子节点先被处理——LIFO!)
if (node->right) stk.push(node->right);
if (node->left) stk.push(node->left);
}
}
5.5.2.2 中序遍历
中序遍历就像读一本书:先读左边页,再读当前页,再读右边页。对于 BST,中序遍历会产生有序序列——这是 BST 最重要的性质。
// 中序遍历 — O(N) 时间
// 访问顺序:左子树,根,右子树
// 关键性质:BST 的中序遍历产生有序输出!
void inorder(TreeNode* root) {
if (root == nullptr) return;
inorder(root->left); // 先左子树
cout << root->val << " "; // 然后根
inorder(root->right); // 然后右子树
}
// 对 BST(值 {1, 3, 4, 5, 8}):
// 中序:1 3 4 5 8 ← 有序!这是 BST 最重要的性质
🔑 核心思路: 任何 BST 的中序遍历始终产生有序序列。这就是为什么
std::set能按有序迭代——内部使用中序遍历。
迭代版中序(稍复杂):
// 中序遍历迭代版
void inorderIterative(TreeNode* root) {
stack<TreeNode*> stk;
TreeNode* curr = root;
while (curr != nullptr || !stk.empty()) {
// 尽量向左走
while (curr != nullptr) {
stk.push(curr);
curr = curr->left;
}
// 处理最左侧未处理的节点
curr = stk.top(); stk.pop();
cout << curr->val << " ";
// 转向右子树
curr = curr->right;
}
}
5.5.2.3 后序遍历
后序遍历就像收拾房间:先收拾左边,再收拾右边,最后收拾当前这块。最适合用来释放内存(先删子节点,最后删根节点,安全!)。
// 后序遍历 — O(N) 时间
// 访问顺序:左子树,右子树,根
// 用于:删除树、求值表达式树
void postorder(TreeNode* root) {
if (root == nullptr) return;
postorder(root->left); // 先左子树
postorder(root->right); // 然后右子树
cout << root->val << " "; // 根最后
}
// ── 用后序遍历清理内存 ──
void deleteTree(TreeNode* root) {
if (root == nullptr) return;
deleteTree(root->left); // 先删左子树
deleteTree(root->right); // 再删右子树
delete root; // 最后删这个节点(安全:子节点已删)
}
5.5.2.4 层序遍历(BFS)
层序遍历就像从上往下扫描一栋楼:先看第一层,再看第二层……逐层往下。
// 层序遍历(BFS)— O(N) 时间,O(W) 空间(W = 最大层宽)
// 使用队列:逐层处理节点
void levelOrder(TreeNode* root) {
if (root == nullptr) return;
queue<TreeNode*> q;
q.push(root);
while (!q.empty()) {
int levelSize = q.size(); // 当前层的节点数
for (int i = 0; i < levelSize; i++) {
TreeNode* node = q.front(); q.pop();
cout << node->val << " ";
if (node->left) q.push(node->left);
if (node->right) q.push(node->right);
}
cout << "\n"; // 层间换行
}
}
// 对 BST [5, 3, 8, 1, 4]:
// 第 0 层:5
// 第 1 层:3 8
// 第 2 层:1 4
遍历汇总
树: [5]
/ \
[3] [8]
/ \ /
[1] [4] [7]
前序: 5 3 1 4 8 7
中序: 1 3 4 5 7 8 ← 有序!
后序: 1 4 3 7 8 5
层序: 5 | 3 8 | 1 4 7
5.5.3 树的高度、规模与平衡
5.5.3.1 计算树的高度
学完遍历后,最自然的第一个问题是:这棵树有多深?高度、节点数、叶子数都可以用同一种思想解决:先解决子树,再合并答案。这就是后序思想的典型应用。
树的高度就像量一栋楼有多少层:最高的那栋楼的高度就是整栋楼的层数。对树来说,就是从根到最远叶节点的边数。
// 树的高度 — O(N) 时间,O(H) 递归栈空间
// 高度 = 最长的根到叶路径的长度
// 约定:空树高度 = -1,叶节点高度 = 0
int height(TreeNode* root) {
if (root == nullptr) return -1; // 空子树高度 -1
int leftHeight = height(root->left); // 左子树高度
int rightHeight = height(root->right); // 右子树高度
return 1 + max(leftHeight, rightHeight); // +1 表示当前节点
}
5.5.3.2 检查平衡
平衡二叉树要求每个节点的左右子树高度差不超过 1。
为什么需要平衡?因为不平衡的 BST 会退化(像前面说的链表),操作变慢。就像一栋楼如果左边盖了 100 层,右边只有 1 层——这不只是不好看,更会影响效率。
// 检查平衡 BST — O(N) 时间
// 不平衡时返回 -1,否则返回子树高度
int checkBalanced(TreeNode* root) {
if (root == nullptr) return 0; // 空树平衡,高度 0
int leftH = checkBalanced(root->left);
if (leftH == -1) return -1; // 左子树不平衡
int rightH = checkBalanced(root->right);
if (rightH == -1) return -1; // 右子树不平衡
// 检查当前节点的平衡:高度差不超过 1
if (abs(leftH - rightH) > 1) return -1; // 不平衡!
return 1 + max(leftH, rightH); // 平衡时返回高度
}
bool isBalanced(TreeNode* root) {
return checkBalanced(root) != -1;
}
5.5.3.3 节点计数
// 节点计数 — O(N)
int countNodes(TreeNode* root) {
if (root == nullptr) return 0;
return 1 + countNodes(root->left) + countNodes(root->right);
}
// 专门统计叶节点
int countLeaves(TreeNode* root) {
if (root == nullptr) return 0;
if (root->left == nullptr && root->right == nullptr) return 1; // 叶节点!
return countLeaves(root->left) + countLeaves(root->right);
}
5.5.4 二叉搜索树(BST):让树支持有序搜索
前面我们只把树当作一种层级结构。现在给二叉树加上一条排序规则,就得到 BST。BST 的核心价值是:每次比较都能决定下一步往左还是往右。
用查字典的直觉理解 BST
想象你在一本按字母顺序排列的字典里查 "mango":
- 翻到中间,看到 "lemon" —— M 在 L 后面,往后翻
- 再翻一半,看到 "papaya" —— M 在 P 前面,往前翻
- 再翻一半,看到 "mango" —— 找到了!
每次比较都能排除一半的范围,这就是 BST 搜索的核心思想。
二叉搜索树是带有关键排序性质的二叉树:
BST 性质: 对每个节点 v:
- 左子树中所有值都严格小于
v.val - 右子树中所有值都严格大于
v.val
[5] ← 有效的 BST
/ \
[3] [8]
/ \ / \
[1] [4] [7] [10]
5 的左边 = {1, 3, 4} — 都 < 5 ✓
5 的右边 = {7, 8, 10} — 都 > 5 ✓
💡 为什么这很重要? BST 性质保证了中序遍历必然输出有序序列——这是 BST 最强大的性质,后面会反复用到。
5.5.4.1 BST 搜索
BST 搜索就像查字典:每次比较后,目标值要么更小(向左),要么更大(向右),每次都能排除半个搜索空间。
// BST 搜索 — 平均 O(log N),最坏 O(N)
// 返回值为 'target' 的节点指针,找不到返回 nullptr
TreeNode* search(TreeNode* root, int target) {
// 基础情况:空树或找到目标
if (root == nullptr || root->val == target) {
return root;
}
// BST 性质:target 更小则向左
if (target < root->val) {
return search(root->left, target);
}
// target 更大则向右
return search(root->right, target);
}
迭代版本(避免大树时的栈溢出):
// BST 搜索迭代版
TreeNode* searchIterative(TreeNode* root, int target) {
while (root != nullptr) {
if (target == root->val) return root; // 找到
else if (target < root->val) root = root->left; // 向左
else root = root->right; // 向右
}
return nullptr; // 未找到
}
5.5.4.2 BST 插入
插入就是在搜索路径的末端创建一个新节点——就像字典里加一个新词,你需要顺着字母顺序找到正确的空位。
// BST 插入 — 平均 O(log N)
// 返回子树(可能是新的)的根节点
TreeNode* insert(TreeNode* root, int val) {
// 到达空位时,在此创建新节点
if (root == nullptr) {
return new TreeNode(val);
}
if (val < root->val) {
root->left = insert(root->left, val); // 递归向左
} else if (val > root->val) {
root->right = insert(root->right, val); // 递归向右
}
// val == root->val:重复值,忽略(或按需处理)
return root;
}
// 用法:
// TreeNode* root = nullptr;
// root = insert(root, 5);
// root = insert(root, 3);
// root = insert(root, 8);
5.5.4.3 BST 删除
删除是最复杂的 BST 操作。为什么?因为删掉一个节点后,树可能会「断裂」,你需要用一个合适的节点来「补位」。有 3 种情况,由简到繁:
情况 1:节点是叶节点(无子节点) —— 最简单,直接删掉就行。
[5] [5]
/ \ → / \
[3] [8] [3] [8]
/
[7] ← 删除这个叶节点
情况 2:节点只有一个子节点 —— 用子节点「顶替」它。
[5] [5]
/ \ → / \
[3] [8] [3] [7]
/ \
[7] ← 删除 [8],让 [7] 顶替它的位置
\
[9] ← [7] 的子树跟着 [7] 一起过去
情况 3:节点有两个子节点 —— 最复杂。用一个中序后继(右子树中的最小值)来替换,然后删除后继节点。
为什么用中序后继?因为中序后继是比被删节点大的最小值——用它来替换,BST 性质仍然成立。
[5] [5]
/ \ → / \
[3] [8] [3] [7]
/ \ / \ / \ \
[1] [4][7][10] [1] [4] [10]
删除 [8]:中序后继是 [7](右子树中最小)
把 [8] 的值替换为 [7],然后删掉原来的 [7](叶节点,情况 1)
// BST 删除 — 平均 O(log N)
// 辅助函数:找子树中最小节点
TreeNode* findMin(TreeNode* node) {
while (node->left != nullptr) node = node->left;
return node;
}
// 从以 'root' 为根的树中删除值为 'val' 的节点
TreeNode* deleteNode(TreeNode* root, int val) {
if (root == nullptr) return nullptr; // 值未找到
if (val < root->val) {
// 情况:目标在左子树
root->left = deleteNode(root->left, val);
} else if (val > root->val) {
// 情况:目标在右子树
root->right = deleteNode(root->right, val);
} else {
// 找到要删除的节点!
// 情况一:无子节点(叶节点)
if (root->left == nullptr && root->right == nullptr) {
delete root;
return nullptr;
}
// 情况二A:只有右子节点
else if (root->left == nullptr) {
TreeNode* temp = root->right;
delete root;
return temp;
}
// 情况二B:只有左子节点
else if (root->right == nullptr) {
TreeNode* temp = root->left;
delete root;
return temp;
}
// 情况三:有两个子节点——用中序后继替换
else {
TreeNode* successor = findMin(root->right); // 右子树中最小
root->val = successor->val; // 复制后继的值
root->right = deleteNode(root->right, successor->val); // 删除后继
}
}
return root;
}
5.5.4.4 BST 退化问题
⚠️ 关键问题: 如果按有序顺序插入(1, 2, 3, 4, 5...),BST 会退化为链表:
[1]
\
[2]
\
[3] ← 每次操作 O(N),不是 O(log N)!
\
[4]
\
[5]
想象一个极端的字典:如果所有词都按字母顺序从 A 到 Z 排列,你每次查 Z 都要从头翻到尾——这就失去了"每次排除一半"的优势。
这就是平衡 BST(AVL 树、红黑树)存在的原因。C++ 中 std::set 和 std::map 用红黑树实现——始终保证 O(log N)。

std::set / std::map 代替手写 BST。它们始终保持平衡。学习 BST 基础是为了理解它们为什么有效,竞赛中直接用 STL(见第 3.8 章)。
5.5.5 完整 BST 实现:把操作组合起来
这是完整的、可直接用于竞赛的 BST:
#include <bits/stdc++.h>
using namespace std;
struct TreeNode {
int val;
TreeNode* left;
TreeNode* right;
TreeNode(int v) : val(v), left(nullptr), right(nullptr) {}
};
struct BST {
TreeNode* root;
BST() : root(nullptr) {}
// ── 插入 ──
TreeNode* _insert(TreeNode* node, int val) {
if (!node) return new TreeNode(val);
if (val < node->val) node->left = _insert(node->left, val);
else if (val > node->val) node->right = _insert(node->right, val);
return node;
}
void insert(int val) { root = _insert(root, val); }
// ── 搜索 ──
bool search(int val) {
TreeNode* curr = root;
while (curr) {
if (val == curr->val) return true;
curr = (val < curr->val) ? curr->left : curr->right;
}
return false;
}
// ── 中序遍历(有序输出) ──
void _inorder(TreeNode* node, vector<int>& result) {
if (!node) return;
_inorder(node->left, result);
result.push_back(node->val);
_inorder(node->right, result);
}
vector<int> getSorted() {
vector<int> result;
_inorder(root, result);
return result;
}
// ── 高度 ──
int _height(TreeNode* node) {
if (!node) return -1;
return 1 + max(_height(node->left), _height(node->right));
}
int height() { return _height(root); }
};
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
BST bst;
vector<int> vals = {5, 3, 8, 1, 4, 7, 10};
for (int v : vals) bst.insert(v);
cout << "有序输出:";
for (int v : bst.getSorted()) cout << v << " ";
cout << "\n";
// 输出:1 3 4 5 7 8 10
cout << "高度:" << bst.height() << "\n"; // 2
cout << "搜索 4:" << bst.search(4) << "\n"; // 1(真)
cout << "搜索 6:" << bst.search(6) << "\n"; // 0(假)
return 0;
}
5.5.6 从遍历序列重建树
经典题:给定前序和中序遍历,重建原始树。
核心思路:
- 前序数组的第一个元素始终是根
- 在中序数组中,根将其分为左右子树
让我们一步步来看:
💡 Code 代码(12 行)
前序:[3, 9, 20, 15, 7]
中序:[9, 3, 15, 20, 7]
第一步:前序第一个 = 3,所以根是 3
第二步:在中序里找 3,把它左边和右边分开
[9, | 3 |, 15, 20, 7]
↑左子树 ↑ ↑右子树↑
第三步:递归处理左子树和右子树
左子树:前序 [9],中序 [9] → 叶节点 9
右子树:前序 [20, 15, 7],中序 [15, 20, 7]
→ 根 20,左 15,右 7
// 从前序 + 中序重建树 — O(N^2) 朴素版
TreeNode* build(vector<int>& pre, int preL, int preR,
vector<int>& in, int inL, int inR) {
if (preL > preR) return nullptr;
int rootVal = pre[preL]; // 前序第一个 = 根
TreeNode* root = new TreeNode(rootVal);
// 在中序数组中找根
int rootIdx = inL;
while (in[rootIdx] != rootVal) rootIdx++;
int leftSize = rootIdx - inL; // 左子树节点数
// 递归构建左右子树
root->left = build(pre, preL+1, preL+leftSize, in, inL, rootIdx-1);
root->right = build(pre, preL+leftSize+1, preR, in, rootIdx+1, inR);
return root;
}
TreeNode* buildTree(vector<int>& preorder, vector<int>& inorder) {
int n = preorder.size();
return build(preorder, 0, n-1, inorder, 0, n-1);
}
5.5.7 最近公共祖先(LCA)——从暴力方法开始
前面的内容都围绕二叉树展开。竞赛中的树题通常是普通树:每个节点可能有很多个孩子,输入也常常是边列表。LCA 是普通树上最重要的查询之一。我们先从最直觉的暴力方法学起,再升级到二进制倍增。
用家族族谱理解 LCA
LCA 就是找两个人的最近共同祖先。比如:
- 你和表哥的 LCA 是你们的爷爷(而不是太爷爷)
- 你和亲兄弟的 LCA 是你们的爸爸
有根树中两个节点 u 和 v 的 LCA 是它们的最深公共祖先。
📄 有根树中两个节点 `u` 和 `v` 的 **LCA** 是它们的最深公共祖先。
[1]
/ \
[2] [3]
/ \ \
[4] [5] [6]
/
[7]
LCA(4, 5) = 2 (4 和 5 都是 2 的后代)
LCA(4, 6) = 1 (最深公共祖先是根 1)
LCA(2, 4) = 2 (节点 2 是 4 的祖先,也是自身的祖先)
O(N) 暴力 LCA
暴力法的思路非常直觉:从根分别走到 u 和 v,记录路径,然后找两条路径的最后一个公共点。就像两个人从北京出发,一个人去了上海,一个人去了广州,他们的 LCA 就是路径分开前最后经过的共同城市。
// LCA 暴力法 — 每次查询 O(N)
// 策略:找从根到每个节点的路径,然后找最后一个公共节点
// 第一步:找从根到目标节点的路径
bool findPath(TreeNode* root, int target, vector<int>& path) {
if (root == nullptr) return false;
path.push_back(root->val); // 将当前节点加入路径
if (root->val == target) return true; // 找到目标!
// 先尝试左子树,再尝试右子树
if (findPath(root->left, target, path)) return true;
if (findPath(root->right, target, path)) return true;
path.pop_back(); // 回溯:目标不在这个子树中
return false;
}
// 第二步:用两条路径找 LCA
int lca(TreeNode* root, int u, int v) {
vector<int> pathU, pathV;
findPath(root, u, pathU); // 从根到 u 的路径
findPath(root, v, pathV); // 从根到 v 的路径
// 找两条路径的最后一个公共节点
int result = root->val;
int minLen = min(pathU.size(), pathV.size());
for (int i = 0; i < minLen; i++) {
if (pathU[i] == pathV[i]) {
result = pathU[i]; // 仍然公共
} else {
break; // 分叉了
}
}
return result;
}
💡 USACO 说明: 对于 USACO Silver 题目,O(N) 暴力 LCA 并非总是够用。N ≤ 10^5 个节点且 Q ≤ 10^5 次查询时,总计 O(NQ) = O(10^10)——太慢了。只在 N, Q ≤ 5000 时使用暴力。本章 §5.5.8 讲解 O(log N) 的二进制倍增 LCA 用于更难的题目。
5.5.8 LCA 进阶:二进制倍增(O(log N))
本节将 §5.5.7 的朴素 LCA 升级为 O(N log N) 预处理 + O(log N) 查询,是 USACO Gold 的必备技术。
从暴力法到倍增法
暴力 LCA 慢在一个地方:每次查询都可能从节点一路爬到根。如果查询很多,重复爬同样的祖先链会浪费大量时间。倍增法的做法是:提前记住每个节点向上跳 1、2、4、8…… 步分别会到哪里。
核心思想
朴素 LCA 每次查询最多爬 O(N) 步太慢。二进制倍增预先存储:
anc[v][k] = v 的第 2^k 个祖先
将 N 步拆成最多 log N 次「跳跃」,每次跳 2 的幂次。
直觉理解: 想象你要爬 1000 级楼梯。朴素法是一步步走(1000 步)。倍增法是:先跳 512 级,再跳 256 级,再跳 128 级…… 总共不到 10 次跳跃就到了!这就是二进制倍增的威力——用二进制的思想把线性步数压缩到对数级。
构建 anc 表:
anc[v][0]= v 的直接父节点(DFS 时记录)anc[v][k]=anc[anc[v][k-1]][k-1](跳 2^k = 跳两次 2^(k-1))
完整实现
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 500005, LOG = 20;
vector<int> adj[MAXN];
int depth[MAXN], anc[MAXN][LOG];
// DFS 建树,同时计算 anc[v][k]
void dfs(int u, int par, int d) {
depth[u] = d;
anc[u][0] = par; // 直接父节点
for (int k = 1; k < LOG; k++)
anc[u][k] = anc[anc[u][k-1]][k-1]; // 倍增构建
for (int v : adj[u])
if (v != par) dfs(v, u, d + 1);
}
// O(log N) LCA 查询
int lca(int u, int v) {
// 步骤1:把深度更大的节点提升到与另一个相同深度
if (depth[u] < depth[v]) swap(u, v);
int diff = depth[u] - depth[v];
for (int k = 0; k < LOG; k++)
if ((diff >> k) & 1) u = anc[u][k];
// 步骤2:两个在相同深度的节点同步上跳,直到相遇
if (u == v) return u; // 其中一个本来就是另一个的祖先
for (int k = LOG - 1; k >= 0; k--)
if (anc[u][k] != anc[v][k]) {
u = anc[u][k];
v = anc[v][k];
}
return anc[u][0]; // 此时 u, v 的父节点就是 LCA
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, q; cin >> n >> q;
for (int i = 0; i < n - 1; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
dfs(1, 1, 0); // 根为1,根的父节点设为自身
while (q--) {
int u, v; cin >> u >> v;
cout << lca(u, v) << "\n";
}
return 0;
}
步骤 2 的关键理解: 从高位到低位枚举,若跳 2^k 后仍不同,就跳(否则可能跳过 LCA)。最终 u 和 v 停在 LCA 的直接子节点上,anc[u][0] 即为 LCA。
复杂度对比
| 方法 | 预处理 | 单次查询 | 适用场景 |
|---|---|---|---|
| 朴素爬树(§5.5.5) | O(N) | O(N) | N ≤ 5000,代码简单 |
| 二进制倍增 | O(N log N) | O(log N) | N, Q ≤ 5×10^5,USACO Gold |
| Euler Tour + RMQ | O(N log N) | O(1) | 超高频查询(超竞赛范围) |
5.5.9 欧拉序(DFS 时间戳):把子树变成区间
LCA 解决的是两个点之间的祖先关系;欧拉序解决的是另一个常见问题:如何快速处理某个节点的整棵子树。欧拉序将树「展平」为一个线性数组,将子树查询转化为区间查询,从而用线段树或树状数组 O(log N) 回答。
核心思想
DFS 时给每个节点记录进入时间 in[u] 和退出时间 out[u]:
💡 Code 代码(12 行)
1
/ \
2 3
/ \
4 5
DFS 顺序:1(in=1) → 2(in=2) → 4(in=3,out=3) → 5(in=4,out=4) → 2(out=4) → 3(in=5,out=5) → 1(out=5)
in = [_, 1, 2, 5, 3, 4] (节点1~5的进入时间)
out = [_, 5, 4, 5, 3, 4] (节点1~5的退出时间)
节点2的子树 = [in[2], out[2]] = [2, 4] = {节点2, 4, 5} ✓
关键性质: 节点 u 的子树 = 欧拉序数组中下标 [in[u], out[u]] 的连续区间。
💡 直觉理解: 想象你在树上走了一圈又回到起点。你进入一个房间时记录「进入时间」,离开时记录「退出时间」。一个房间的子树(所有它内部的房间)恰好在你进入和离开它之间的这段时间被访问到——所以它们在时间线上形成一个连续区间。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<int> children[MAXN];
int val[MAXN];
int in_time[MAXN], out_time[MAXN], timer_val = 0;
int euler_arr[MAXN]; // euler_arr[in_time[u]] = val[u]
void dfs_euler(int u, int parent) {
in_time[u] = ++timer_val; // 进入:记录时间戳
euler_arr[timer_val] = val[u]; // 在展平数组中记录值
for (int v : children[u]) {
if (v != parent) dfs_euler(v, u);
}
out_time[u] = timer_val; // 退出:记录最终时间戳
}
// 查询节点 u 的子树中所有值的和
// 用前缀和数组 prefix 预处理 euler_arr
int subtree_sum(int u, int prefix[]) {
return prefix[out_time[u]] - prefix[in_time[u] - 1];
}
int main() {
int n; cin >> n;
for (int i = 0; i < n - 1; i++) {
int u, v; cin >> u >> v;
children[u].push_back(v);
children[v].push_back(u);
}
for (int i = 1; i <= n; i++) cin >> val[i];
dfs_euler(1, -1); // 从根 1 开始
// 构建前缀和
int prefix[MAXN] = {};
for (int i = 1; i <= n; i++)
prefix[i] = prefix[i-1] + euler_arr[i];
// 查询节点 u 的子树和
int u; cin >> u;
cout << subtree_sum(u, prefix) << "\n";
return 0;
}
实际应用:子树更新 + 子树查询
| 需求 | 工具 | 替换欧拉序后的复杂度 |
|---|---|---|
| 静态子树求和 | 前缀和 | O(1) 查询 |
| 动态单点修改 + 子树求和 | 树状数组(BIT) | O(log N) |
| 区间修改 + 子树查询 | 线段树(懒惰传播) | O(log N) |
5.5.10 USACO 风格入门例题
题目:「奶牛家族树」(USACO Bronze 风格)
题目说明:
FJ 有 N(1 ≤ N ≤ 10⁵)头奶牛,编号 1 到 N。奶牛 1 是所有奶牛的祖先(「根」)。对每头奶牛 i(2 ≤ i ≤ N),其父节点是 parent[i](1 ≤ parent[i] ≤ N,且 parent[i] < i,保证无环)。奶牛的深度定义为从根(奶牛 1)到该奶牛的边数(奶牛 1 的深度为 0)。
给定树和 M(1 ≤ M ≤ 10⁵)次查询,每次查询「奶牛 x 的深度是多少?」
输入格式: 第一行 N 和 M;第 2..N 行给出 parent[2..N];接下来 M 行每行一个查询编号 x。
// 奶牛家族树 — 深度查询
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<int> children[MAXN]; // 邻接表:children[i] = i 的子节点列表
int depth[MAXN]; // depth[i] = 节点 i 的深度
// DFS 计算深度
void dfs(int node, int d) {
depth[node] = d;
for (int child : children[node]) {
dfs(child, d + 1); // 子节点深度 +1
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
for (int i = 2; i <= n; i++) {
int par;
cin >> par;
children[par].push_back(i); // par 是 i 的父节点
}
dfs(1, 0); // 从根(奶牛 1)以深度 0 开始 DFS
while (m--) {
int x;
cin >> x;
cout << depth[x] << "\n";
}
return 0;
}
// 时间:O(N + M)
// 空间:O(N)
⚠️ 常见错误
空指针崩溃:
// ❌ 错误:没有空指针检查!
void inorder(TreeNode* root) {
inorder(root->left); // root 为空时崩溃
cout << root->val;
inorder(root->right);
}
// ✅ 正确:始终先检查空指针
void inorder(TreeNode* root) {
if (root == nullptr) return; // ← 关键!
inorder(root->left);
cout << root->val;
inorder(root->right);
}
大输入时的栈溢出:
// ❌ 危险:10^5 个节点的退化树(倾斜)
// 递归深度 = 10^5,默认栈 ~8MB,约 10^4~10^5 时溢出!
// ✅ 安全:大树用迭代
void dfsIterative(TreeNode* root) {
stack<TreeNode*> stk;
if (root) stk.push(root);
while (!stk.empty()) {
TreeNode* node = stk.top(); stk.pop();
process(node);
if (node->right) stk.push(node->right);
if (node->left) stk.push(node->left);
}
}
5 大 BST/树 Bug
- 忘记
nullptr基础情况 —— 立即导致段错误 - 插入/删除后没有返回(可能是新的)根节点 —— 树结构损坏
- 栈溢出 —— N > 10^5 时用迭代遍历
- 内存泄漏 —— 始终
delete删除的节点(或用智能指针) - STL set 够用时却手写 BST —— 竞赛中直接用
std::set
本章总结
📌 核心要点
| 概念 | 要点 | 时间复杂度 |
|---|---|---|
| BST 搜索 | 根据比较结果向左/向右走 | 平均 O(log N),最坏 O(N) |
| BST 插入 | 找到正确位置,在空处插入 | 平均 O(log N) |
| BST 删除 | 3 种情况:叶节点、单子节点、双子节点 | 平均 O(log N) |
| 中序 | 左 → 根 → 右 | O(N) |
| 前序 | 根 → 左 → 右 | O(N) |
| 后序 | 左 → 右 → 根 | O(N) |
| 层序 | BFS 按层 | O(N) |
| 高度 | max(左高, 右高) + 1 | O(N) |
| LCA(暴力) | 找路径再比较 | 每次查询 O(N) |
| LCA(二进制倍增) | 预处理 2^k 祖先 | 预处理 O(N log N),查询 O(log N) |
| 欧拉序 | DFS 时间戳展平树 | 预处理 O(N),子树查询 O(1)~O(log N) |
🧩 从浅到深的完整脉络
- 二叉树基础:先理解根、父子、叶子、深度、高度。
- 遍历:学会前序、中序、后序、层序,这是所有树算法的基本动作。
- 高度/平衡/计数:用递归合并子树答案。
- BST:给二叉树加上排序规则,得到高效搜索结构。
- LCA:从两个节点向上找最近公共祖先,暴力法先建立直觉。
- 二进制倍增:把一步步爬祖先优化成按 2 的幂跳跃。
- 欧拉序:把树的子树变成数组区间,连接线段树和树状数组。
❓ 常见问题
Q1:什么时候用 BST vs std::set?
A:竞赛编程中几乎始终用
std::set。std::set由红黑树(平衡 BST)支持,保证O(log N);手写 BST 可能退化到O(N)。只在需要自定义 BST 行为时(如追踪子树大小来查询「第 K 大」)才考虑手写,或使用__gnu_pbds::tree(策略树)。
Q2:线段树和 BST 是什么关系?
A:线段树(第 5.7 章)是完全二叉树,但不是 BST——节点存储区间聚合值(如区间和),而不是有序的键。两者都是二叉树,结构相似,但目的完全不同。理解 BST 的指针/递归操作使线段树代码更容易理解。
Q3:前序/中序/后序遍历,竞赛中最常用哪种?
A:中序最重要——它输出 BST 的有序序列。后序常用于树形 DP(先处理子节点再处理父节点)。**层序(BFS)**用于按层处理。前序较少用,但对树的序列化/反序列化有用。
Q4:递归和迭代实现哪个更好?
A:递归代码简洁易懂(竞赛中首选)。但 N ≥ 10^5 且树可能退化时,递归有栈溢出风险(默认栈 ~8MB,支持约 10^4~10^5 层)。USACO 题目通常用非退化树,所以递归通常没问题;但不确定时,迭代更安全。
Q5:LCA 在竞赛编程中有多重要?
A:非常重要!LCA 是树形 DP 和路径查询的基础。在 USACO Silver 偶尔出现,USACO Gold 几乎必考。本章 §5.5.5 的暴力 LCA 处理 N ≤ 5000 的情况;§5.5.8 的二进制倍增 LCA 处理 N, Q ≤ 5×10^5 的大型树,是竞赛必备。
🔗 与其他章节的联系
- 第 2.3 章(函数与数组):递归基础——二叉树遍历是递归的完美应用
- 第 3.8 章(映射与集合):
std::set/std::map由平衡 BST 支持;理解 BST 能更好地使用它们 - 第 5.7 章(线段树):线段树是完全二叉树;build/query/update 的递归结构与 BST 遍历完全相同
- 第 5.2 章(图论算法):树是特殊的无向图(连通无环);所有树算法都是图算法的特例
- §5.5.8 LCA 倍增 + §5.5.9 欧拉序:直接建立在本章树遍历基础上,是 Gold 级核心技术
基础练习题
题目 5.5.1 — BST 验证 🟢 简单
给定一棵有 N(1 ≤ N ≤ 5000)个节点的二叉树(节点值 −10⁹ ≤ val ≤ 10⁹,可能重复),判断它是否满足 BST 性质(每个节点的值严格大于左子树所有值、严格小于右子树所有值)。满足输出 YES,否则输出 NO。
提示
常见错误:只检查 `root->left->val < root->val` 是不够的。需要向下传递允许的 (minVal, maxVal) 范围。核心思路: 向下传递允许的 (min, max) 范围,每个节点必须严格在其范围内。
#include <bits/stdc++.h>
using namespace std;
struct TreeNode { int val; TreeNode *left, *right; };
bool isValidBST(TreeNode* root, long long lo, long long hi) {
if (!root) return true;
if (root->val <= lo || root->val >= hi) return false;
return isValidBST(root->left, lo, root->val)
&& isValidBST(root->right, root->val, hi);
}
// 用法:isValidBST(root, LLONG_MIN, LLONG_MAX);
为什么需要最小/最大边界? 因为根的右子树中的某个节点,即使是某个祖先的左子节点,也必须 > 根。只传直接父节点不够。
复杂度: O(N) 时间,O(H) 递归栈。
题目 5.5.2 — BST 中序第 K 小 🟢 简单 给定有 N(1 ≤ N ≤ 5000,节点值互不相同)个节点的 BST 和整数 K(1 ≤ K ≤ N),找 BST 中第 K 小的元素。
提示
中序遍历按有序访问节点,访问到第 K 个节点时停止。int kthSmallest(TreeNode* root, int k) {
stack<TreeNode*> st;
TreeNode* cur = root;
while (cur || !st.empty()) {
while (cur) { st.push(cur); cur = cur->left; }
cur = st.top(); st.pop();
if (--k == 0) return cur->val;
cur = cur->right;
}
return -1;
}
复杂度: O(H + K) —— 对小 K 远优于 O(N)。
题目 5.5.3 — 树的直径 🟡 中等 给定有 N(1 ≤ N ≤ 5000)个节点的二叉树,找任意两个节点间的最长路径(边数,不需要经过根)。
提示
对每个节点,经过它的最长路径 = 左高度 + 右高度。单次 DFS:返回高度,同时更新全局直径。核心思路: 后序 DFS。每个节点计算:(a) 供父节点使用的自身高度;(b) 经过它的最优路径(更新全局答案)。
int diameter = 0;
int height(TreeNode* root) {
if (!root) return 0;
int L = height(root->left);
int R = height(root->right);
diameter = max(diameter, L + R); // 经过该节点的路径:左边 L 条边 + 右边 R 条边
return 1 + max(L, R); // 返回给父节点的高度
}
// 答案:diameter(边数)。若要节点数,diameter+1。
为什么有效? 直径必然经过某个「顶点」节点——路径上的最高节点。该顶点的贡献 = height(左) + height(右)。我们把每个节点都当作潜在的顶点来访问。
复杂度: O(N)。
题目 5.5.4 — BST 展平/中位数 🟡 中等 给定有 N(1 ≤ N ≤ 10⁵,N 为奇数,节点值互不相同)个节点的 BST,节点存奶牛的成绩(1 ≤ val ≤ 10⁹),找奶牛成绩的中位数(第 ⌈N/2⌉ 小的值)。
提示
中序遍历得到有序数组,返回下标 (N-1)/2 处的元素。void inorder(TreeNode* root, vector<int>& arr) {
if (!root) return;
inorder(root->left, arr);
arr.push_back(root->val);
inorder(root->right, arr);
}
int findMedian(TreeNode* root) {
vector<int> arr;
inorder(root, arr);
return arr[(arr.size() - 1) / 2]; // 偶数 N 时取下中位数
}
大树优化: 用题目 5.5.2 的第 K 小方法直接查找——无需展平:kthSmallest(root, (n+1)/2),节省 O(N) 内存。
复杂度: O(N) 时间和空间(或用第 K 小方法 O(H + N/2))。
题目 5.5.5 — 最大路径和 🔴 困难 给定有 N(1 ≤ N ≤ 10⁵)个节点的二叉树,节点值 −10⁹ ≤ val ≤ 10⁹(可能有负值),找任意两个节点间路径和最大的路径(路径至少含一个节点),输出最大路径和。答案可能超过 int 范围。
提示
对每个节点 v:经过它的最优路径 = max(0, left_max_down) + max(0, right_max_down) + v->val。负值分支夹在 0 处。核心思路: DFS 返回「从该节点向下出发的最优单侧路径」。全局答案考虑「以该节点为顶点的最优双侧路径」。负值子路径夹在 0 处(不包含它们)。
int bestSum = INT_MIN;
int maxGain(TreeNode* root) {
if (!root) return 0;
// 夹到 0:可以选择不包含子树(如果它是负的)
int L = max(0, maxGain(root->left));
int R = max(0, maxGain(root->right));
// 以 root 为转折点的最优路径
bestSum = max(bestSum, root->val + L + R);
// 向父节点返回单侧路径(只能选一个分支)
return root->val + max(L, R);
}
// 答案:调用 maxGain(root) 后的 bestSum
关键思路: 路径是「V」形——先上到某个顶点,再下来。每个节点恰好作为顶点考虑一次。
复杂度: O(N)。
综合补充练习题
题目 5.5.1 — 子树求和(通用树) 🟢 简单
题目: 读取一棵有根树(根 = 节点 1,N 个节点,1 ≤ N ≤ 10⁵),每个节点有一个值(−10⁹ ≤ val ≤ 10⁹,答案用 64 位整数)。输出每个节点子树(包含自身)的值之和。
样例:
输入:5 个节点,值=[1,2,3,4,5],父节点数组=[_, 1,1,2,2]
输出:15 11 3 4 5
(节点1子树和=1+2+3+4+5=15;节点2子树=2+4+5=11;...)
思路: 后序 DFS,从叶节点向上累加。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n; cin >> n;
vector<long long> val(n + 1);
for (int i = 1; i <= n; i++) cin >> val[i];
vector<vector<int>> children(n + 1);
for (int i = 2; i <= n; i++) {
int p; cin >> p;
children[p].push_back(i);
}
vector<long long> sub(n + 1);
function<void(int)> dfs = [&](int u) {
sub[u] = val[u];
for (int v : children[u]) { dfs(v); sub[u] += sub[v]; }
};
dfs(1);
for (int i = 1; i <= n; i++) cout << sub[i] << " \n"[i==n];
return 0;
}
复杂度: O(N) 时间与空间。
题目 5.5.2 — 树的直径(通用树,两次 BFS) 🟡 中等
题目: 给定一棵 N(2 ≤ N ≤ 10⁵)个节点的无权无向树(N−1 条边),求树的直径(任意两点间最长路径的长度,以边数计)。
注: 题目 5.5.3 只处理二叉树结构。本题处理通用树(每个节点可有任意多个子节点)。
样例:
输入:5
1 2 / 1 3 / 3 4 / 3 5
输出:3(路径 2-1-3-4 或 2-1-3-5)
思路: 两次 BFS——第一次从任意节点找最远点 u,第二次从 u 出发找直径。
直觉上:树的直径是一条最长的「链」,它的两个端点一定是叶子。从任意点出发,BFS 找到的最远点一定是直径的一个端点;再从这个端点出发,BFS 找到的最远点就是另一个端点。
#include <bits/stdc++.h>
using namespace std;
int n;
vector<int> adj[100005];
pair<int,int> bfs_far(int src) {
vector<int> dist(n + 1, -1);
queue<int> q;
dist[src] = 0; q.push(src);
int far = src;
while (!q.empty()) {
int u = q.front(); q.pop();
for (int v : adj[u]) {
if (dist[v] == -1) {
dist[v] = dist[u] + 1;
q.push(v);
if (dist[v] > dist[far]) far = v;
}
}
}
return {far, dist[far]};
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
cin >> n;
for (int i = 0; i < n - 1; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v); adj[v].push_back(u);
}
auto [u, _] = bfs_far(1);
auto [v, d] = bfs_far(u);
cout << d << "\n";
return 0;
}
题目 5.5.3 — LCA 查询(二进制倍增) 🟡 中等
题目: 给定有根树(根为 1,N 个节点,1 ≤ N ≤ 5×10⁵)和 Q 次查询(1 ≤ Q ≤ 5×10⁵),每次给出两个节点 u、v(1 ≤ u, v ≤ N),输出它们的 LCA 编号。
直接使用 §5.5.8 的 LCA 二进制倍增实现:
// 见 §5.5.8 完整实现(dfs 预处理 + lca 查询函数)
// main() 中:
int n, q; cin >> n >> q;
// 读入树,dfs(1, 1, 0),然后 q 次查询 lca(u, v)
追踪(树:1-2-3-4 链,查询 lca(4,1)):
depth = [_, 0, 1, 2, 3]
anc[4][0]=3, anc[4][1]=1(3的父的父), anc[3][0]=2, ...
lca(4, 1): depth[4]=3 > depth[1]=0
diff=3=0b11, k=0时(diff>>0)&1=1, u=anc[4][0]=3
k=1时(diff>>1)&1=1, u=anc[3][1]=1
现在 depth[1]=depth[1]=0, u==v=1, 返回 1 ✓
题目 5.5.4 — 欧拉序子树求和(静态) 🟡 中等
题目: N(1 ≤ N ≤ 10⁵)个节点的有根树(根为 1),每个节点有一个值(−10⁹ ≤ val ≤ 10⁹,子树和用 64 位整数)。Q(1 ≤ Q ≤ 10⁵)次查询,每次询问以节点 u 为根的子树中所有值之和。
思路: 构建欧拉序后,用前缀和数组 O(1) 回答每次查询。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<int> adj[MAXN];
long long val[MAXN];
int in_t[MAXN], out_t[MAXN], timer_v = 0;
long long ea[MAXN]; // 欧拉序展平后的值数组
void dfs(int u, int par) {
in_t[u] = ++timer_v;
ea[timer_v] = val[u];
for (int v : adj[u])
if (v != par) dfs(v, u);
out_t[u] = timer_v;
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, q; cin >> n;
for (int i = 1; i <= n; i++) cin >> val[i];
for (int i = 0; i < n - 1; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v); adj[v].push_back(u);
}
cin >> q;
dfs(1, -1);
// 前缀和
long long prefix[MAXN] = {};
for (int i = 1; i <= n; i++) prefix[i] = prefix[i-1] + ea[i];
while (q--) {
int u; cin >> u;
cout << prefix[out_t[u]] - prefix[in_t[u]-1] << "\n";
}
return 0;
}
为什么正确? 欧拉序保证 u 的子树节点恰好占据 [in_t[u], out_t[u]] 区间,前缀和 O(1) 回答区间和。
题目 5.5.5 — 最小生成树(Kruskal) 🔴 困难
题目: 读取 N 个节点(1 ≤ N ≤ 2×10⁵)、M 条边(1 ≤ M ≤ 5×10⁵)的带权无向连通图(可能不连通),边权 1 ≤ w ≤ 10⁹,求最小生成树权重之和(若不连通输出 IMPOSSIBLE)。答案可能超过 int 范围。
用 Kruskal 算法(并查集详见第 5.6 章):
#include <bits/stdc++.h>
using namespace std;
vector<int> par, rnk;
int find(int x) { return par[x]==x ? x : par[x]=find(par[x]); }
bool unite(int x, int y) {
x=find(x); y=find(y);
if (x==y) return false;
if (rnk[x]<rnk[y]) swap(x,y);
par[y]=x; if(rnk[x]==rnk[y]) rnk[x]++;
return true;
}
int main() {
int n, m; cin >> n >> m;
par.resize(n+1); rnk.assign(n+1,0);
iota(par.begin(),par.end(),0);
vector<tuple<int,int,int>> edges(m);
for (auto& [w,u,v] : edges) cin >> u >> v >> w;
sort(edges.begin(), edges.end());
long long ans = 0; int cnt = 0;
for (auto [w,u,v] : edges)
if (unite(u,v)) { ans+=w; if(++cnt==n-1) break; }
cout << (cnt==n-1 ? to_string(ans) : "IMPOSSIBLE") << "\n";
return 0;
}
第 5.5 章(树算法完整版)结束 — 下一章:第 5.6 章:并查集
📖 第 5.6 章:并查集
🎯 学习目标
学完本章后,你将能够:
- 用「路径压缩 + 按秩合并」实现 O(α(n)) 的并查集
- 用并查集判断图的连通性和环
- 实现带权并查集解决差值/关系问题
- 用种类并查集解决多关系分组问题
- 独立完成 10 道从基础到挑战的练习题
5.6.1 从一道真实问题出发
问题:网络连通
你负责管理一个由 N 台服务器(编号 1~N)构成的数据中心网络。网络工程师陆续在两台服务器之间建立直连链路(无向),你需要随时回答:服务器 A 和服务器 B 目前是否可以互相通信?
初始状态:每台服务器各自孤立
1 2 3 4 5
建立链路 (1,2):1——2 3 4 5
建立链路 (3,4):1——2 3——4 5
建立链路 (2,3):1——2——3——4 5
查询 (1,4):可以通信 ✓(1→2→3→4)
查询 (1,5):不可通信 ✗(5 是孤岛)
朴素解法的瓶颈:
| 做法 | 查询时间 | 合并时间 |
|---|---|---|
| 暴力 BFS/DFS | O(N+M) | O(1) |
维护 group[] 数组 | O(1) | O(N)(需遍历更新) |
| 并查集 | O(α(N)) ≈ O(1) | O(α(N)) ≈ O(1) |
当 N、M 高达 10^5,且操作交替出现时,并查集是唯一实用的选择。
5.6.2 核心思想:用「树」表示一个集合
关键洞察: 把同一个连通块里的服务器,组织成一棵树。树的根节点作为这个集合的「代表」。
- 判断两台服务器是否连通:看它们是否在同一棵树(根节点相同)
- 合并两个连通块:把一棵树的根,指向另一棵树的根
用一个 pa[](parent,父节点)数组来表示这片森林:

关键观察:
- 每一次
unite都是把一棵树的根指向另一棵树的根,而不是任意两个节点直接相连 unite(2, 3)实际执行的是pa[find(3)] ← find(2),即pa[3] ← 1,所以合并后4仍然挂在3下(而不是直接挂到1下)- 要让
4直接挂到根1下,需要借助 5.6.4 节的路径压缩
5.6.3 两个核心操作
Find(查找根节点)
沿着 pa[] 指针向上爬,找到根:
int find(int x) {
while (pa[x] != x)
x = pa[x];
return x; // pa[x] == x 时 x 就是根
}
判断 A、B 是否连通:find(A) == find(B)
Unite(合并两个集合)
将两棵树的根连起来:
void unite(int x, int y) {
int rx = find(x);
int ry = find(y);
if (rx != ry)
pa[rx] = ry; // 把 rx 的树接到 ry 下面
}
5.6.4 优化一:路径压缩
问题: 若一直把新树接到旧树下面,树可能变成一条长链:
1 ← 2 ← 3 ← 4 ← 5 ← 6
find(1) 需要爬 5 步,时间 O(N)
路径压缩: 在 find(x) 的过程中,把路径上所有节点直接连到根节点。

int find(int x) {
// 若 x 不是根,先递归找到根 root
// 然后顺手把 x 的父亲改为 root("压扁")
return pa[x] == x ? x : pa[x] = find(pa[x]);
}
5.6.5 优化二:按节点数合并
问题: 合并时如果总把大树接到小树下,大树变得更高,find 更慢。
按节点数合并: 把小树接到大树下,保证树高 ≤ O(log N)。

struct DSU {
vector<int> pa, sz; // sz[i] = i 为根时,这棵树的节点总数
int groups; // 当前连通块数量
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1), groups(n) {
iota(pa.begin(), pa.end(), 0); // pa[i] = i
}
// 路径压缩查根
int find(int x) {
return pa[x] == x ? x : pa[x] = find(pa[x]);
}
// 按节点数合并,返回 true 表示两者原本不连通(发生了合并)
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false; // 已在同一集合
if (sz[x] < sz[y]) swap(x, y); // x 是大树
pa[y] = x; // 小树接到大树
sz[x] += sz[y];
groups--;
return true;
}
// 判断是否连通
bool connected(int x, int y) { return find(x) == find(y); }
// 所在连通块大小
int size(int x) { return sz[find(x)]; }
};
复杂度:
| 优化 | 单次操作 |
|---|---|
| 无优化 | O(N) |
| 仅路径压缩 | 均摊 O(α(N)) |
| 仅按节点数 | O(log N) |
| 两者同时(推荐) | 均摊 O(α(N)) ≈ O(1) |
α(N)是反 Ackermann 函数,增长极其缓慢,α(10^80) < 5。实践中视为常数。
5.6.6 回到网络连通问题:完整代码
现在用并查集完整解决开头的问题:
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> pa, sz;
int groups;
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1), groups(n) {
iota(pa.begin(), pa.end(), 0);
}
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false;
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y]; groups--;
return true;
}
bool connected(int x, int y) { return find(x) == find(y); }
};
int main() {
int n, q;
cin >> n >> q;
DSU dsu(n);
while (q--) {
int op, a, b;
cin >> op >> a >> b;
if (op == 1) {
// 建立链路
if (dsu.unite(a, b))
cout << "新增链路:" << a << " - " << b << "\n";
else
cout << "已连通,无需新增\n";
} else {
// 查询
cout << (dsu.connected(a, b) ? "可以通信" : "无法通信") << "\n";
}
}
return 0;
}
5.6.7 进阶:带权并查集
问题引入
有 N 名学生,班主任陆续告诉你:「B 同学比 A 同学高 D 厘米(即 height[B] - height[A] = D)」。
你需要回答:
- B 比 A 高多少厘米?
- 某条信息是否与之前的矛盾?
朴素思路: 用图建模,但查询每次都要 BFS 遍历路径,O(N) 每次查询太慢。
带权并查集的思路: 在每个节点存储「它到根节点的高度差 dist[x]」,查询时直接用 dist 相减。

核心设计
dist[x]= height[x] - height[find(x)](x 的身高减去根的身高)- 路径压缩时,累加路径上的
dist,把 x 直接连到根:
压缩前:x → p → root
dist[x] = height[x] - height[p]
dist[p] = height[p] - height[root]
压缩后:x → root
新的 dist[x] 应该 = height[x] - height[root]
= dist[x] + dist[p]
int find(int x) {
if (pa[x] == x) return x;
int root = find(pa[x]);
dist[x] += dist[pa[x]]; // 压缩同时累加路径权值
pa[x] = root;
return root;
}
合并时计算新边权值
「声明 height[y] - height[x] = d」:
📄 「声明 height[y] - height[x] = d」:
我们有:dist[x] = height[x] - height[rx]
dist[y] = height[y] - height[ry]
若把 ry 接到 rx 下,则需要 dist[ry] 满足:
height[ry] - height[rx] = ?
由 height[y] - height[x] = d 推导:
(dist[y] + height[ry]) - (dist[x] + height[rx]) = d
height[ry] - height[rx] = d + dist[x] - dist[y]
所以 dist[ry] = d + dist[x] - dist[y]
// 完整带权并查集
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
int pa[MAXN], sz[MAXN];
long long dist[MAXN]; // dist[x] = height[x] - height[find(x)]
void init(int n) {
for (int i = 1; i <= n; i++) { pa[i] = i; sz[i] = 1; dist[i] = 0; }
}
int find(int x) {
if (pa[x] == x) return x;
int root = find(pa[x]);
dist[x] += dist[pa[x]];
pa[x] = root;
return root;
}
// 声明 height[y] - height[x] = d
// 返回 true = 无矛盾;false = 与已知矛盾
bool unite(int x, int y, long long d) {
int rx = find(x), ry = find(y);
long long dx = dist[x], dy = dist[y];
if (rx == ry) {
// 已在同集合,验证是否矛盾
return (dy - dx == d);
}
// 合并:小树接大树
if (sz[rx] < sz[ry]) {
swap(rx, ry); swap(dx, dy); d = -d;
}
pa[ry] = rx;
dist[ry] = d + dx - dy;
sz[rx] += sz[ry];
return true;
}
long long query(int x, int y) {
find(x); find(y);
return dist[y] - dist[x]; // height[y] - height[x]
}
int main() {
int n = 5;
init(n);
unite(1, 2, 3); // height[2] - height[1] = 3(2 比 1 高 3cm)
unite(2, 3, 5); // height[3] - height[2] = 5
// 查询 1 和 3 的差
cout << "3 比 1 高 " << query(1, 3) << " cm\n"; // 输出 8
// 添加矛盾信息
cout << (unite(1, 3, 10) ? "一致" : "矛盾") << "\n"; // 矛盾(应该是8)
cout << (unite(1, 3, 8) ? "一致" : "矛盾") << "\n"; // 一致
return 0;
}
5.6.8 进阶:种类并查集
问题引入
经典题: 动物王国中有三类动物 A、B、C,满足:A 吃 B,B 吃 C,C 吃 A。
依次输入 N 条信息,格式为:
1 X Y:X 和 Y 是同类2 X Y:X 吃 Y
若某条信息与前面的所有真实信息矛盾,则它是「假话」。求假话总数。
关键难点: 需要同时追踪「是否同类」「是否捕食关系」两种关系,普通并查集只能处理一种等价关系。

解法:把每个节点拆成三份
将每个动物 x 扩展为三个虚拟节点:
| 节点 | 含义 |
|---|---|
x(原始) | 与 x 同类的集合 |
x + n | 被 x 吃的集合(x 的猎物) |
x + 2n | 吃 x 的集合(x 的天敌) |
处理「X 和 Y 同类」:
x 的同类 = y 的同类 → unite(x, y)
x 的猎物 = y 的猎物 → unite(x+n, y+n)
x 的天敌 = y 的天敌 → unite(x+2n, y+2n)
处理「X 吃 Y」(X 的猎物就是 Y 的同类):
x 的猎物 = y 的同类 → unite(x+n, y)
x 的天敌 = y 的猎物 → unite(x+2n, y+n)
x 的同类 = y 的天敌 → unite(x, y+2n)
判断矛盾「X 和 Y 同类」时:
若 connected(x, y+n) → 矛盾(x 和 y 一个吃另一个,不可能同类)
若 connected(x, y+2n) → 矛盾
判断矛盾「X 吃 Y」时:
若 connected(x, y) → 矛盾(同类不可能有捕食关系)
若 connected(x, y+n) → 矛盾(y 吃 x,但说 x 吃 y)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 150005;
int pa[MAXN * 3], sz[MAXN * 3];
void init(int n) {
for (int i = 0; i < 3 * (n + 1); i++) { pa[i] = i; sz[i] = 1; }
}
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
bool same(int x, int y) { return find(x) == find(y); }
void unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return;
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y];
}
int main() {
int n, k;
cin >> n >> k;
init(n);
int lies = 0;
while (k--) {
int t, x, y;
cin >> t >> x >> y;
// 编号越界直接判假
if (x < 1 || x > n || y < 1 || y > n) { lies++; continue; }
if (t == 1) {
// 声明 x 和 y 同类
if (same(x, y + n) || same(x, y + 2 * n)) {
lies++; // 矛盾:x 和 y 之间有捕食关系
} else {
unite(x, y);
unite(x + n, y + n);
unite(x + 2 * n, y + 2 * n);
}
} else {
// 声明 x 吃 y
if (x == y) { lies++; continue; } // 自己不能吃自己
if (same(x, y) || same(x, y + n)) {
lies++; // 矛盾
} else {
unite(x + n, y);
unite(x + 2 * n, y + n);
unite(x, y + 2 * n);
}
}
}
cout << lies << "\n";
return 0;
}
5.6.9 USACO 真题训练:连通性问题的两种反向思维
并查集擅长处理「只加边」的连通性。一旦题目出现删点/删边,通常要考虑离线反向处理:把删除倒过来看成添加。
| 题面信号 | DSU 思路 | 关键转换 |
|---|---|---|
| 动态添加边后问连通 | 直接 unite | 每次合并维护连通块数 |
| 按顺序关闭节点 | 反向打开节点 | 删除变添加 |
| 最大化最小边权使排列可达 | 二分答案 + DSU | 只保留权值 ≥ x 的边 |
| 判断两个点是否在同一集合 | find 比较根 | find(a) == find(b) |
真题 1:Closing the Farm(USACO 2016 US Open Silver)— 反向开点维护连通性
题目链接: USACO 2016 US Open Silver P3: Closing the Farm
对应模式: 离线反向处理 + 并查集
难度定位: Silver 标准
题干解读
有 N 个农场和 M 条双向道路。农场会按给定顺序一个个关闭,每关闭一个后,问剩余开放农场是否仍然连通。
关键难点:
- 正向看是「删点 + 删边」,普通 DSU 不支持删除。
- 但如果倒着看,就是「逐个打开农场 + 添加边」,DSU 正好擅长。
思路分析
反向处理关闭顺序:
- 一开始所有农场都关闭。
- 按关闭顺序的反序逐个打开农场。
- 每打开一个农场,连通块数
components++。 - 与所有已经打开的邻居
unite,每成功合并一次components--。 - 若当前开放农场数量大于 0 且
components == 1,说明所有开放农场连通。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> parent, size;
DSU(int n) : parent(n + 1), size(n + 1, 1) {
iota(parent.begin(), parent.end(), 0);
}
int find(int x) {
return parent[x] == x ? x : parent[x] = find(parent[x]);
}
bool unite(int a, int b) {
a = find(a);
b = find(b);
if (a == b) return false;
if (size[a] < size[b]) swap(a, b);
parent[b] = a;
size[a] += size[b];
return true;
}
};
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("closing.in", "r", stdin);
// freopen("closing.out", "w", stdout);
int n, m;
cin >> n >> m;
vector<vector<int>> adj(n + 1);
for (int i = 0; i < m; i++) {
int a, b;
cin >> a >> b;
adj[a].push_back(b);
adj[b].push_back(a);
}
vector<int> closeOrder(n);
for (int &x : closeOrder) cin >> x;
DSU dsu(n);
vector<bool> open(n + 1, false);
vector<string> answer(n);
int components = 0;
for (int i = n - 1; i >= 0; i--) {
int barn = closeOrder[i];
open[barn] = true;
components++;
for (int neighbor : adj[barn]) {
if (open[neighbor] && dsu.unite(barn, neighbor)) {
components--;
}
}
answer[i] = (components == 1 ? "YES" : "NO");
}
for (const string &s : answer) cout << s << "\n";
return 0;
}
复杂度: 每条边最多被检查两次,DSU 操作近似 O(1),总复杂度 O((N+M) α(N))。
易错点提醒
- 正向删除硬做。 DSU 不支持删除,正向维护会非常麻烦。
- 和未打开邻居合并。 只能合并
open[neighbor] == true的邻居。 - 答案顺序反了。 反向计算得到的是原问题每一步的答案,要写回
answer[i]。 - 连通块计数忘记加一。 每打开一个新点,先形成一个新连通块。
拓展思考
这类「删除变添加」是 USACO Silver/Gold 常见技巧。如果操作可以完全离线读取,并且删除操作很难维护,优先尝试倒序处理。
真题 2:Wormhole Sort(USACO 2020 January Silver)— 二分答案 + DSU 连通块
题目链接: USACO 2020 January Silver P3: Wormhole Sort
对应模式: 二分答案 + 按边权建 DSU
难度定位: Silver 进阶
题干解读
有 N 头奶牛,每头当前位置上有一头目标不一定正确的奶牛。虫洞连接两个位置,每条虫洞有宽度。两头奶牛可以通过虫洞交换位置。要求找到最大宽度 W,使得只使用宽度至少为 W 的虫洞,也能把所有奶牛放回正确位置。
关键条件:
- 若宽度阈值
W可行,那么更小的阈值也可行,因为可用边更多。 - 给定阈值
W,只保留宽度 ≥W的边,用 DSU 判断每头奶牛当前位置和目标位置是否连通。
思路分析
check(W):
- 初始化 DSU。
- 对每条虫洞
(a,b,width),若width >= W,合并a和b。 - 对每个位置
i,如果当前位置上的奶牛应该去p[i],则必须满足find(i) == find(p[i])。 - 全部满足则可行。
然后对 W 二分,找最大的可行宽度。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> parent, size;
DSU(int n) : parent(n + 1), size(n + 1, 1) {
iota(parent.begin(), parent.end(), 0);
}
int find(int x) {
return parent[x] == x ? x : parent[x] = find(parent[x]);
}
void unite(int a, int b) {
a = find(a);
b = find(b);
if (a == b) return;
if (size[a] < size[b]) swap(a, b);
parent[b] = a;
size[a] += size[b];
}
};
struct Edge {
int a, b, width;
};
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("wormsort.in", "r", stdin);
// freopen("wormsort.out", "w", stdout);
int n, m;
cin >> n >> m;
vector<int> target(n + 1);
bool alreadySorted = true;
for (int i = 1; i <= n; i++) {
cin >> target[i];
if (target[i] != i) alreadySorted = false;
}
vector<Edge> edges(m);
int maxWidth = 0;
for (auto &e : edges) {
cin >> e.a >> e.b >> e.width;
maxWidth = max(maxWidth, e.width);
}
if (alreadySorted) {
cout << -1 << "\n";
return 0;
}
auto can = [&](int minWidth) {
DSU dsu(n);
for (const Edge &e : edges) {
if (e.width >= minWidth) dsu.unite(e.a, e.b);
}
for (int i = 1; i <= n; i++) {
if (dsu.find(i) != dsu.find(target[i])) return false;
}
return true;
};
int lo = 1, hi = maxWidth + 1; // [可行, 不可行)
while (lo + 1 < hi) {
int mid = lo + (hi - lo) / 2;
if (can(mid)) lo = mid;
else hi = mid;
}
cout << lo << "\n";
return 0;
}
复杂度: 每次检查 O((N+M) α(N)),二分 O(log W) 次,总复杂度 O((N+M) log W)。
易错点提醒
- 方向理解错。 阈值越小,可用虫洞越多,所以可行性是「大到小」单调。
- 检查位置错。 要判断位置
i和target[i]是否连通,不是判断奶牛编号和位置编号的其他组合。 - 已经有序的特殊情况。 官方要求输出
-1。 - 边权等于阈值可用。 条件是
width >= minWidth,不要写成>。
拓展思考
也可以把边按宽度从大到小排序,逐步加入 DSU,直到所有错位奶牛都连通;这能避免二分的重复建图,但实现需要维护未满足位置集合。
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| 带权并查集路径压缩后权值错误 | 没在递归中累加 dist | dist[x] += dist[pa[x]] 在改 pa[x] 前执行 |
合并时没更新 sz | 只改了 pa,忘记维护大小 | sz[rx] += sz[ry] |
| 种类并查集数组开小 | 需要 3N 个节点 | int pa[MAXN * 3] |
| 先 unite 再判矛盾 | 合并后信息已融合,无法判断 | 必须先判矛盾,再 unite |
find 递归爆栈 | 极长链时(N > 10^5)递归深度溢出 | 用迭代版路径压缩替代 |
💪 练习题(共 10 道,全部含完整解答)
🟢 基础练习(1~4)
题目 1:朋友圈计数
给 N 个人(编号 1~N)和 M 对朋友关系,同一朋友圈里的人可以互相联系。
求最终共有多少个朋友圈。
输入: N M,然后 M 行每行 A B 表示 A 和 B 是朋友。
输出: 朋友圈数量。
示例:
输入:5 3
1 2
2 3
4 5
输出:2
({1,2,3} 和 {4,5})
思路: 每次合并时若两人原本不在同一集合(unite 返回 true),连通块数 -1。最终 dsu.groups 就是答案。
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> pa, sz;
int groups;
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1), groups(n) {
iota(pa.begin(), pa.end(), 0);
}
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false;
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y]; groups--;
return true;
}
};
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, m;
cin >> n >> m;
DSU dsu(n);
while (m--) {
int a, b; cin >> a >> b;
dsu.unite(a, b);
}
cout << dsu.groups << "\n";
return 0;
}
下图展示 N=5、M=3 次合并时集合的演变过程:
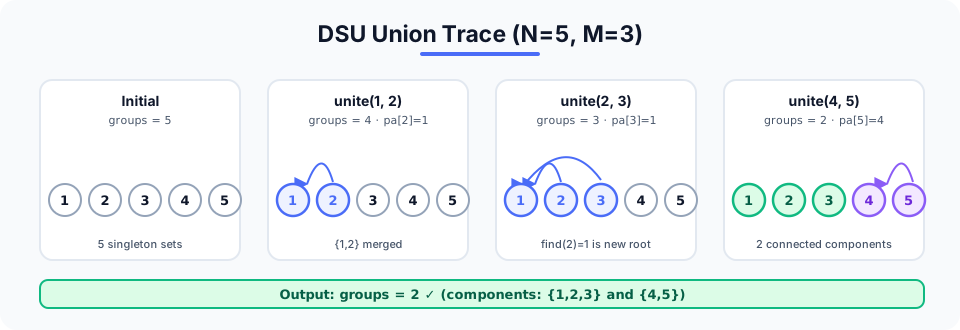
题目 2:判断图中是否有环
给 N 个节点和 M 条无向边,判断这个图是否包含环。
输入: N M,然后 M 行每行 U V 表示一条边。
输出: YES(有环)或 NO(无环)。
思路: 加一条边 (u, v) 时,若 u 和 v 已经连通(find(u)==find(v)),则这条边构成环。
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> pa, sz;
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1) {
iota(pa.begin(), pa.end(), 0);
}
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false; // 已连通 = 加边后形成环
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y];
return true;
}
};
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, m;
cin >> n >> m;
DSU dsu(n);
bool has_cycle = false;
while (m--) {
int u, v; cin >> u >> v;
if (!dsu.unite(u, v)) has_cycle = true;
}
cout << (has_cycle ? "YES" : "NO") << "\n";
return 0;
}
关键点: unite 返回 false 代表两端已连通 → 这条边是多余边 → 存在环。
题目 3:最大连通块
给 N 个节点和 M 条边,输出最大连通块包含的节点数。
思路: 用带 sz[] 的并查集,合并结束后遍历所有节点,找 sz[find(i)] 的最大值。
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> pa, sz;
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1) {
iota(pa.begin(), pa.end(), 0);
}
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
void unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return;
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y];
}
int size(int x) { return sz[find(x)]; }
};
int main() {
int n, m;
cin >> n >> m;
DSU dsu(n);
while (m--) {
int u, v; cin >> u >> v;
dsu.unite(u, v);
}
int ans = 0;
for (int i = 1; i <= n; i++)
ans = max(ans, dsu.size(i));
cout << ans << "\n";
return 0;
}
题目 4:Kruskal 最小生成树
给 N 个节点和 M 条带权无向边,求最小生成树的总权重。若图不连通输出 -1。
思路: Kruskal 算法:将所有边按权重从小到大排序,依次尝试加入。若两端不在同一集合(不会成环),则加入 MST。最终若 MST 边数 = N-1,则图连通。
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> pa, sz;
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1) {
iota(pa.begin(), pa.end(), 0);
}
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false;
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y];
return true;
}
};
int main() {
int n, m;
cin >> n >> m;
vector<tuple<int,int,int>> edges(m);
for (auto& [w, u, v] : edges) cin >> u >> v >> w;
sort(edges.begin(), edges.end()); // 按权重排序
DSU dsu(n);
long long total = 0;
int cnt = 0; // MST 中的边数
for (auto& [w, u, v] : edges) {
if (dsu.unite(u, v)) {
total += w;
cnt++;
if (cnt == n - 1) break; // 找够 n-1 条边
}
}
cout << (cnt == n - 1 ? total : -1) << "\n";
return 0;
}
追踪示例(N=4, 边:1-2权1, 2-3权2, 1-3权3, 3-4权4):
排序后:(1,1,2), (2,2,3), (3,1,3), (4,3,4)
加边(1,2)权1 → unite成功,cnt=1,total=1
加边(2,3)权2 → unite成功,cnt=2,total=3
加边(1,3)权3 → find(1)=find(3),已连通,跳过
加边(3,4)权4 → unite成功,cnt=3=n-1,total=7
输出:7
🟡 进阶练习(5~8)
题目 5:网络连通性查询
给 N 台服务器,M 次操作:
connect A B:在 A 和 B 之间建立链路query A B:询问 A 和 B 是否可以通信block A B:断开 A 和 B 之间的直连链路(注意:不是断开连通性!)
输出所有 query 的结果。
提示: 普通并查集不支持「断边」。解决方案:离线倒序处理——将操作逆序执行,把「断边」变成「加边」。
核心思路:
- 先记录所有操作
- 从后向前处理:
block变成connect,正向的connect但时间上在block之前需要排除 - 用并查集 + 离线逆序处理,输出时逆序输出 query 结果
更简洁的方案:预处理每条边「实际存在的时间段」,再用离线并查集。
以下给出离线逆序 + 回收操作的简化版本(假设每对服务器最多断开一次):
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> pa, sz;
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1) {
iota(pa.begin(), pa.end(), 0);
}
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false;
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y];
return true;
}
bool connected(int x, int y) { return find(x) == find(y); }
};
int main() {
int n, m;
cin >> n >> m;
vector<tuple<int,int,int>> ops(m); // {type, a, b},type: 0=connect,1=query,2=block
set<pair<int,int>> blocked; // 已断开的边
for (auto& [t, a, b] : ops) {
string op; cin >> op >> a >> b;
if (op == "connect") t = 0;
else if (op == "query") t = 1;
else { t = 2; blocked.insert({min(a,b), max(a,b)}); }
}
// 逆序处理
DSU dsu(n);
// 先加入所有「最终状态下存在」的边(connect 且未被 block 的)
for (auto& [t, a, b] : ops) {
if (t == 0) {
auto key = make_pair(min(a,b), max(a,b));
if (!blocked.count(key)) dsu.unite(a, b);
}
}
vector<string> answers;
for (int i = m - 1; i >= 0; i--) {
auto [t, a, b] = ops[i];
if (t == 2) {
// 逆序时 block 变 connect
dsu.unite(a, b);
} else if (t == 1) {
answers.push_back(dsu.connected(a, b) ? "YES" : "NO");
}
// connect 在逆序中不处理(已在初始化时加入)
}
reverse(answers.begin(), answers.end());
for (auto& s : answers) cout << s << "\n";
return 0;
}
题目 6:身高差查询(带权并查集)
N 名学生,M 条信息。每条信息格式为 A B D 表示「B 比 A 高 D cm(可为负)」。
然后 Q 次查询,每次询问「B 比 A 高多少 cm」,若无法推断输出 unknown,若已知矛盾输出 conflict。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
int pa[MAXN], sz_arr[MAXN];
long long dist[MAXN];
void init(int n) {
for (int i = 1; i <= n; i++) { pa[i] = i; sz_arr[i] = 1; dist[i] = 0; }
}
int find(int x) {
if (pa[x] == x) return x;
int root = find(pa[x]);
dist[x] += dist[pa[x]];
pa[x] = root;
return root;
}
// 声明 height[b] - height[a] = d,返回 false 表示矛盾
bool add_info(int a, int b, long long d) {
int ra = find(a), rb = find(b);
long long da = dist[a], db = dist[b];
if (ra == rb) return (db - da == d);
if (sz_arr[ra] < sz_arr[rb]) { swap(ra, rb); swap(da, db); d = -d; }
pa[rb] = ra;
dist[rb] = d + da - db;
sz_arr[ra] += sz_arr[rb];
return true;
}
int main() {
int n, m, q;
cin >> n >> m;
init(n);
bool global_conflict = false;
for (int i = 0; i < m; i++) {
int a, b; long long d;
cin >> a >> b >> d;
if (!add_info(a, b, d)) global_conflict = true;
}
cin >> q;
while (q--) {
int a, b; cin >> a >> b;
int ra = find(a), rb = find(b);
if (ra != rb) cout << "unknown\n";
else if (global_conflict) cout << "conflict\n";
else cout << dist[b] - dist[a] << "\n";
}
return 0;
}
输入示例:
5 3
1 2 3 → height[2] - height[1] = 3
2 3 5 → height[3] - height[2] = 5
1 3 8 → height[3] - height[1] = 8(与前两条一致)
2
1 3 → 输出 8
1 4 → 输出 unknown
题目 7:方格染色(种类并查集变形)
N × N 方格,每格初始为白色。M 次操作,每次给某行或某列的所有格子染色(黑←→白 翻转)。
操作结束后,询问 Q 个格子的颜色(黑或白)。
提示: 用「行并查集」和「列并查集」分别维护,结合奇偶性(翻转次数的奇偶)跟踪颜色。
用带权并查集,dist[x] 记录奇偶性(0=未翻转,1=翻转过奇数次):
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200005;
int pa[MAXN];
int flip[MAXN]; // flip[x] = x 相对于根的翻转次数(mod 2)
void init(int n) {
for (int i = 0; i <= n; i++) { pa[i] = i; flip[i] = 0; }
}
int find(int x) {
if (pa[x] == x) return x;
int root = find(pa[x]);
flip[x] ^= flip[pa[x]]; // 路径上翻转次数的奇偶叠加
pa[x] = root;
return root;
}
// 声明「x 和 y 属于同组,且翻转关系为 d(0=同色,1=不同色)」
void unite(int x, int y, int d) {
int rx = find(x), ry = find(y);
int fx = flip[x], fy = flip[y];
if (rx == ry) return;
pa[ry] = rx;
flip[ry] = d ^ fx ^ fy;
}
// 查询 x 的颜色相对于根的偏移
int query(int x) {
find(x);
return flip[x];
}
此模板适用于所有「奇偶关系」类型的种类并查集问题。
题目 8:标准并查集模板(Luogu P3367)
即标准并查集模板题:M 次操作,每次 1 X Y(合并 X 和 Y 所在的集合)或 2 X Y(查询 X 和 Y 是否在同一集合,输出 Y 或 N)。
这是标准并查集裸题,直接套模板:
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> pa, sz;
explicit DSU(int n) : pa(n + 1), sz(n + 1, 1) {
iota(pa.begin(), pa.end(), 0);
}
int find(int x) { return pa[x] == x ? x : pa[x] = find(pa[x]); }
void unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return;
if (sz[x] < sz[y]) swap(x, y);
pa[y] = x; sz[x] += sz[y];
}
bool connected(int x, int y) { return find(x) == find(y); }
};
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, m;
cin >> n >> m;
DSU dsu(n);
while (m--) {
int op, x, y;
cin >> op >> x >> y;
if (op == 1) dsu.unite(x, y);
else cout << (dsu.connected(x, y) ? "Y" : "N") << "\n";
}
return 0;
}
🔴 挑战练习(9~10)
题目 9:食物链(NOIP 2001 P2024)
N 种动物,三类关系(A 吃 B,B 吃 C,C 吃 A 循环)。K 条信息,格式同 5.6.8 节。
求假话数量。
直接使用 5.6.8 节的「种类并查集」代码,注意细节:
- 自己吃自己(x == y 且 type=2):假话
- 编号越界(x > n 或 y > n):假话
- 矛盾检测先于合并
// 直接使用 5.6.8 节代码即可
// 关键测试:
// N=100, K=7
// 1 101 1 → x=101 > N=100,假话,lies=1
// 2 1 2 → 声明 1 吃 2,无矛盾,合并
// 2 2 3 → 声明 2 吃 3,无矛盾,合并
// 2 3 1 → 1 吃 2 吃 3 吃 1 ← 合法循环
// 1 1 3 → 1 和 3 同类?但 1 吃 3,矛盾,lies=2
// 2 3 3 → x==y,自己吃自己,lies=3
// 1 1 2 → 1 和 2 同类?但 1 吃 2,矛盾,lies=4
// 输出:4
完整代码见 5.6.8 节,直接提交即可。
题目 10:可持久化并查集(综合应用)
给 N 个元素和 M 次操作,每次操作为「合并两个集合」或「回滚到历史的某一版本」。每次操作后回答若干查询(例如某两个元素在当前版本下是否连通)。
提示: 需要「可持久化并查集」——用按秩合并(不用路径压缩)+ 线段树维护历史版本的 pa[] 数组。
为什么不能路径压缩? 路径压缩会改变树的结构,版本回滚后结构会乱。只用按秩合并(树高 O(log N)),每次 find 最多 O(log N) 步,可接受。
// 可持久化并查集框架(用持久化线段树维护 pa[])
// 每次 unite 操作只改动 2 个节点(rx 和 ry),
// 对线段树做单点修改,生成新版本
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
const int MAXLOG = 20;
struct Node {
int left, right, val, rnk; // rnk = 树的秩
} tr[MAXN * MAXLOG * 4];
int root[MAXN], cnt = 0; // root[i] = 第 i 个版本的根节点
// 建初始线段树(所有节点 pa[i] = i)
int build(int l, int r) {
int node = ++cnt;
if (l == r) {
tr[node].val = l; // pa[l] = l(自己是根)
tr[node].rnk = 0;
return node;
}
int mid = (l + r) / 2;
tr[node].left = build(l, mid);
tr[node].right = build(mid + 1, r);
return node;
}
// 持久化单点修改 pa[pos] = new_val
int update(int prev, int l, int r, int pos, int new_val, int new_rnk = -1) {
int node = ++cnt;
tr[node] = tr[prev]; // 复制上一版本
if (l == r) {
tr[node].val = new_val;
if (new_rnk >= 0) tr[node].rnk = new_rnk;
return node;
}
int mid = (l + r) / 2;
if (pos <= mid)
tr[node].left = update(tr[prev].left, l, mid, pos, new_val, new_rnk);
else
tr[node].right = update(tr[prev].right, mid + 1, r, pos, new_val, new_rnk);
return node;
}
// 查询 pa[pos]
int query(int node, int l, int r, int pos) {
if (l == r) return tr[node].val;
int mid = (l + r) / 2;
if (pos <= mid) return query(tr[node].left, l, mid, pos);
return query(tr[node].right, mid + 1, r, pos);
}
int n;
// 在版本 ver 中查找 x 的根(不做路径压缩!)
int find(int ver, int x) {
int pa = query(root[ver], 1, n, x);
if (pa == x) return x;
return find(ver, pa);
}
int main() {
int m;
cin >> n >> m;
root[0] = build(1, n);
for (int i = 1; i <= m; i++) {
int op; cin >> op;
if (op == 1) {
// 合并
int x, y; cin >> x >> y;
int rx = find(i - 1, x), ry = find(i - 1, y);
// ... 按秩合并,生成 root[i]
} else if (op == 2) {
// 回滚到第 k 版本
int k; cin >> k;
root[i] = root[k];
} else {
// 查询
int x; cin >> x;
cout << find(i - 1, x) << "\n";
root[i] = root[i - 1];
}
}
return 0;
}
完整实现参考:Luogu P3402 可持久化并查集
💡 章节联系: 并查集是图论最基础的工具之一——判连通性(第 5.2 章)、Kruskal MST(第 5.9 章)都依赖并查集。带权并查集在 USACO Gold 和信奥中频繁出现,建议重点掌握。
第 5.7 章:线段树入门
线段树是竞赛编程中最强大的数据结构之一,解决了前缀和无法处理的根本问题:带更新的区间查询。
但在学它之前,先认识一个「轻量级亲戚」——如果你永远不需要更新,它更简单也更快。
5.7.0 稀疏表(Sparse Table)——静态区间最值的 O(1) 查询
场景: 数组固定不变,只有查询:A[l..r] 的最小值(或最大值)是多少?这是经典的 RMQ(Range Minimum Query)问题。
前缀和解决不了它——最小值没有「逆运算」(前缀和能用 pre[r] - pre[l-1] 是因为减法能撤销加法)。但静态这个条件允许一个取巧的思路:
预处理所有「长度为 2 的幂」的区间的最值,查询时用两段可重叠的块拼出任意区间。
定义 st[j][i] = A[i .. i + 2^j - 1] 中的最小值:
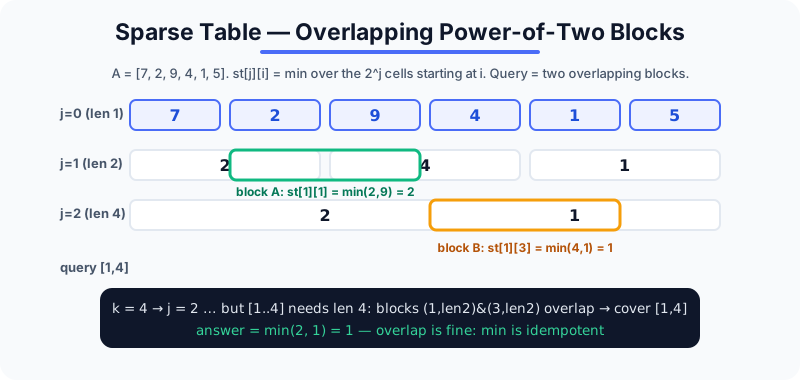
构建(倍增递推): 长度 2^j 的块 = 两个长度 2^(j-1) 的块拼起来:
st[j][i] = min(st[j-1][i], // 左半段 [i, i+2^(j-1)-1]
st[j-1][i + (1 << (j-1))]); // 右半段
查询: 对区间 [l, r](长 k = r−l+1),取 j = ⌊log₂k⌋,用起点对齐和终点对齐的两块盖住它:
min(st[j][l], st[j][r - (1 << j) + 1])
两块加起来覆盖 2·2^j ≥ k 个格子——中间可能重叠,甚至超出。没关系:min(a, a) = a,重复统计不改变结果。这种「重复用没关系」的性质叫幂等性,最大值、gcd、按位与都有;求和没有(所以稀疏表不能做区间和)。
完整实现:
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, q;
cin >> n >> q;
vector<int> a(n);
for (auto& x : a) cin >> x;
int LOG = 1;
while ((1 << LOG) <= n) LOG++;
vector<vector<int>> st(LOG, vector<int>(n));
st[0] = a; // j=0:长度 1 的块就是元素自身
for (int j = 1; j < LOG; j++)
for (int i = 0; i + (1 << j) <= n; i++)
st[j][i] = min(st[j-1][i], st[j-1][i + (1 << (j-1))]);
while (q--) {
int l, r;
cin >> l >> r; // 0-indexed,闭区间
int j = 31 - __builtin_clz(r - l + 1); // ⌊log₂ k⌋ 的位运算快算法
cout << min(st[j][l], st[j][r - (1 << j) + 1]) << "\n";
}
return 0;
}
样例输入:
6 4
7 2 9 4 1 5
0 2
3 5
1 4
0 5
样例输出:
2
1
1
1
(min(7,2,9)=2;min(4,1,5)=1;min(2,9,4,1)=1;全局最小=1。)
| 预处理 | 查询 | 更新 | 内存 | |
|---|---|---|---|---|
| 稀疏表 | O(N log N) | O(1) | ❌ 不支持 | O(N log N) |
| 线段树 | O(N) | O(log N) | O(log N) | O(N) |
💡 什么时候选谁: 数组从读入后再也不会变 → 稀疏表(更快、代码 20 行)。边查询边改 → 只能线段树。另外稀疏表的「倍增」思路(2^j 的块由两个 2^(j-1) 的块拼成)会在第 5.13 章的倍增 LCA 里再次登场——那是同一招在树上的应用。
5.7.1 问题:为什么需要线段树
思考这个挑战:
- 数组
A,共 N 个整数 - Q1:
A[l..r]的和是多少?(区间求和查询) - Q2: 更新
A[i] = x(单点更新)
前缀和方案: 区间查询 O(1),但更新需要重新计算所有前缀和,O(N)。对于 M 次混合查询,总计 O(NM) —— N,M = 10^5 时太慢了。
线段树方案: 查询和更新都是 O(log N)。M 次混合查询总计:O(M log N) ✓
| 数据结构 | 构建 | 查询 | 更新 | 最适合 |
|---|---|---|---|---|
| 简单数组 | O(N) | O(N) | O(1) | 只有更新 |
| 前缀和 | O(N) | O(1) | O(N) | 只有查询 |
| 线段树 | O(N) | O(log N) | O(log N) | 查询 + 更新 |
| 树状数组(BIT) | O(N log N) | O(log N) | O(log N) | 代码更简单,仅限前缀和 |
上图展示了在数组 [1, 3, 5, 7, 9, 11] 上构建的线段树。每个内部节点存储其区间的和。对区间 [2,4] 的查询(和=21)只需组合 2 个节点——O(log N) 而不是 O(N)。
5.7.2 结构:什么是线段树?
线段树是一棵完全二叉树:
- 每个叶节点对应一个数组元素
- 每个内部节点存储其区间的聚合值(和、最小值、最大值等)
- 根节点覆盖整个数组 [0..N-1]
- 覆盖 [l..r] 的节点有两个子节点:[l..mid] 和 [mid+1..r]
对 N 个元素的数组,树最多有 4N 个节点(我们使用大小为 4N 的 1-indexed 树数组作为安全上界)。
数组:[1, 3, 5, 7, 9, 11](下标 0..5)
树(1-indexed,节点 i 的子节点是 2i 和 2i+1):
[0..5]=36
/ \
[0..2]=9 [3..5]=27
/ \ / \
[0..1]=4 [2]=5 [3..4]=16 [5]=11
/ \ / \
[0]=1 [1]=3 [3]=7 [4]=9
下图展示了线段树的完整结构,以及查询 sum([2,4]) 时蓝色高亮的访问路径:

5.7.3 构建线段树
// 构建线段树 — O(N)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
int tree[4 * MAXN]; // 线段树数组(大小为 4 倍数组长度)
int arr[MAXN]; // 原始数组
// 构建:递归填充 tree[]
// node = 当前树节点下标(从 1 开始)
// start, end = 该节点覆盖的范围
void build(int node, int start, int end) {
if (start == end) {
// 叶节点:存储数组元素
tree[node] = arr[start];
} else {
int mid = (start + end) / 2;
// 先构建左右子节点
build(2 * node, start, mid); // 左子节点
build(2 * node + 1, mid + 1, end); // 右子节点
// 内部节点:子节点之和
tree[node] = tree[2 * node] + tree[2 * node + 1];
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
for (int i = 0; i < n; i++) cin >> arr[i];
build(1, 0, n - 1); // 从节点 1 开始构建,覆盖 [0..n-1]
return 0;
}
对 [1, 3, 5, 7, 9, 11] 的构建追踪:
📄 Code 完整代码
build(1, 0, 5):
build(2, 0, 2):
build(4, 0, 1):
build(8, 0, 0): tree[8] = arr[0] = 1
build(9, 1, 1): tree[9] = arr[1] = 3
tree[4] = tree[8] + tree[9] = 4
build(5, 2, 2): tree[5] = arr[2] = 5
tree[2] = tree[4] + tree[5] = 9
build(3, 3, 5):
...
tree[3] = 27
tree[1] = 9 + 27 = 36
5.7.4 区间查询
查询 arr[l..r] 的和:
核心思路: 递归下降树,在每个覆盖 [start..end] 的节点处:
- 若 [start..end] 完全在 [l..r] 内:直接返回该节点的值(完成!)
- 若 [start..end] 完全在 [l..r] 外:返回 0(无贡献)
- 否则:递归进入两个子节点,将结果求和
// 区间查询:arr[l..r] 的和 — O(log N)
// node = 当前树节点,[start, end] = 覆盖范围
// [l, r] = 查询范围
int query(int node, int start, int end, int l, int r) {
if (r < start || end < l) {
// 情况一:当前区间完全在查询范围外
return 0; // 求和的单位元(求最小值用 INT_MAX)
}
if (l <= start && end <= r) {
// 情况二:当前区间完全在查询范围内
return tree[node]; // ← 关键行:直接使用该节点!
}
// 情况三:部分重叠——递归进入子节点
int mid = (start + end) / 2;
int leftSum = query(2 * node, start, mid, l, r);
int rightSum = query(2 * node + 1, mid + 1, end, l, r);
return leftSum + rightSum;
}
// 用法:arr[2..4] 的和
int result = query(1, 0, n - 1, 2, 4);
cout << result << "\n"; // 5 + 7 + 9 = 21
在 [1,3,5,7,9,11] 的树上查询 [2..4] 的追踪:
query(1, 0, 5, 2, 4):
query(2, 0, 2, 2, 4): [0..2] 与 [2..4] 部分重叠
query(4, 0, 1, 2, 4): [0..1] 在 [2..4] 外 → 返回 0
query(5, 2, 2, 2, 4): [2..2] 在 [2..4] 内 → 返回 5
返回 0 + 5 = 5
query(3, 3, 5, 2, 4): [3..5] 与 [2..4] 部分重叠
query(6, 3, 4, 2, 4): [3..4] 在 [2..4] 内 → 返回 16
query(7, 5, 5, 2, 4): [5..5] 在 [2..4] 外 → 返回 0
返回 16 + 0 = 16
返回 5 + 16 = 21 ✓
只访问了 4 个节点——O(log N)!
下图展示了哪些节点被访问以及原因——绿色节点直接返回其值,橙色节点递归进入子节点,灰色节点立即被剪枝:

5.7.5 单点更新
更新 arr[i] = x(修改单个元素):
// 单点更新:设置 arr[idx] = val — O(log N)
void update(int node, int start, int end, int idx, int val) {
if (start == end) {
// 叶节点:更新值
arr[idx] = val;
tree[node] = val;
} else {
int mid = (start + end) / 2;
if (idx <= mid) {
update(2 * node, start, mid, idx, val); // 在左子树中更新
} else {
update(2 * node + 1, mid + 1, end, idx, val); // 在右子树中更新
}
// 子节点更改后,更新这个内部节点
tree[node] = tree[2 * node] + tree[2 * node + 1];
}
}
// 用法:设置 arr[2] = 10
update(1, 0, n - 1, 2, 10);
单点更新只修改从更新的叶节点到根节点路径上的节点——仅 O(log N) 个节点,其他所有分支保持不变:

5.7.6 完整实现
这是完整的、可直接用于竞赛的线段树:
// 线段树 — O(N) 构建,O(log N) 查询/更新
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
long long tree[4 * MAXN];
void build(int node, int start, int end, long long arr[]) {
if (start == end) {
tree[node] = arr[start];
return;
}
int mid = (start + end) / 2;
build(2 * node, start, mid, arr);
build(2 * node + 1, mid + 1, end, arr);
tree[node] = tree[2 * node] + tree[2 * node + 1];
}
long long query(int node, int start, int end, int l, int r) {
if (r < start || end < l) return 0;
if (l <= start && end <= r) return tree[node];
int mid = (start + end) / 2;
return query(2 * node, start, mid, l, r)
+ query(2 * node + 1, mid + 1, end, l, r);
}
void update(int node, int start, int end, int idx, long long val) {
if (start == end) {
tree[node] = val;
return;
}
int mid = (start + end) / 2;
if (idx <= mid) update(2 * node, start, mid, idx, val);
else update(2 * node + 1, mid + 1, end, idx, val);
tree[node] = tree[2 * node] + tree[2 * node + 1];
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
long long arr[MAXN];
for (int i = 0; i < n; i++) cin >> arr[i];
build(1, 0, n - 1, arr);
while (q--) {
int type;
cin >> type;
if (type == 1) {
// 单点更新:设置 arr[i] = v
int i; long long v;
cin >> i >> v;
update(1, 0, n - 1, i, v);
} else {
// 区间查询:arr[l..r] 的和
int l, r;
cin >> l >> r;
cout << query(1, 0, n - 1, l, r) << "\n";
}
}
return 0;
}
样例输入:
6 5
1 3 5 7 9 11
2 2 4
1 2 10
2 2 4
2 0 5
1 0 0
样例输出:
21
26
41
(第1次查询 [2,4] = 5+7+9 = 21;执行 update arr[2]=10 后,第2次查询 [2,4] = 10+7+9 = 26;第3次查询 [0,5] = 1+3+10+7+9+11 = 41)
5.7.7 线段树 vs 树状数组(BIT)
| 特性 | 线段树 | 树状数组(BIT) |
|---|---|---|
| 代码复杂度 | 中等(约 30 行) | 简单(约 15 行) |
| 区间查询 | 任意结合性操作 | 仅限前缀和 |
| 区间更新 | 可以(需懒惰传播) | 可以(需技巧) |
| 单点更新 | O(log N) | O(log N) |
| 空间 | O(4N) | O(N) |
| 使用场景 | 区间最小/最大、复杂查询 | 带更新的前缀和 |
💡 核心思路: 若需要带更新的区间和,树状数组更简单。若需要区间最小值、区间最大值,或任何非前缀操作,用线段树。
5.7.8 区间最小值查询变体
只需将聚合操作从 + 改为 min:
// 区间最小线段树 — 结构相同,操作不同
void build_min(int node, int start, int end, int arr[]) {
if (start == end) { tree[node] = arr[start]; return; }
int mid = (start + end) / 2;
build_min(2*node, start, mid, arr);
build_min(2*node+1, mid+1, end, arr);
tree[node] = min(tree[2*node], tree[2*node+1]); // ← 改为 min
}
int query_min(int node, int start, int end, int l, int r) {
if (r < start || end < l) return INT_MAX; // ← min 的单位元
if (l <= start && end <= r) return tree[node];
int mid = (start + end) / 2;
return min(query_min(2*node, start, mid, l, r),
query_min(2*node+1, mid+1, end, l, r));
}
5.7.9 带懒惰传播的区间更新
前面的线段树处理单点更新。对于区间更新:「给 [L, R] 的所有元素加 V」怎么办?
没有懒惰传播,需要 O(N) 次更新(每个元素一次)。有了懒惰传播,实现 O(log N) 区间更新。

💡 核心思路: 不立即更新所有受影响的叶节点,而是「懒惰地」推迟更新——在适用的最高节点存储更新,只在真正需要子节点时才向下传递。
每个节点现在存储两个值:
tree[node]:该区间的实际聚合值(区间和)lazy[node]:尚未向子节点传递的待处理更新
向下传递规则: 访问有待处理懒惰更新的节点时:
- 将懒惰更新应用到该节点的值
- 将懒惰更新传递给两个子节点(向下传递)
- 清除该节点的懒惰值
📄 3. 清除该节点的懒惰值
// 带懒惰传播的线段树
// 支持:区间加法更新、区间求和查询 — 各 O(log N)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const int MAXN = 100005;
ll tree[4 * MAXN]; // tree[node] = 区间和
ll lazy[4 * MAXN]; // lazy[node] = 待处理的加法值(0 表示无待处理)
// ── 向下传递:将待处理懒惰传递给子节点 ──
void pushDown(int node, int start, int end) {
if (lazy[node] == 0) return; // 无待处理更新
int mid = (start + end) / 2;
int left = 2 * node, right = 2 * node + 1;
// 更新左子节点的和:加 lazy * (左子节点元素数量)
tree[left] += lazy[node] * (mid - start + 1);
tree[right] += lazy[node] * (end - mid);
// 将懒惰传递给子节点
lazy[left] += lazy[node];
lazy[right] += lazy[node];
// 清除当前节点的懒惰(已向下传递)
lazy[node] = 0;
}
// ── 构建 ──
void build(int node, int start, int end, ll arr[]) {
lazy[node] = 0;
if (start == end) {
tree[node] = arr[start];
return;
}
int mid = (start + end) / 2;
build(2*node, start, mid, arr);
build(2*node+1, mid+1, end, arr);
tree[node] = tree[2*node] + tree[2*node+1];
}
// ── 区间更新:给 [l, r] 内所有元素加 val ──
void update(int node, int start, int end, int l, int r, ll val) {
if (r < start || end < l) return; // 范围外:无操作
if (l <= start && end <= r) {
// 当前区间完全在 [l, r] 内:应用懒惰,不递归
tree[node] += val * (end - start + 1); // ← 关键:乘以区间长度
lazy[node] += val; // 存储给子节点的待处理值
return;
}
// 部分重叠:先向下传递已有懒惰,再递归
pushDown(node, start, end); // ← 关键:递归前必须先 pushDown!
int mid = (start + end) / 2;
update(2*node, start, mid, l, r, val);
update(2*node+1, mid+1, end, l, r, val);
// 从子节点更新当前节点
tree[node] = tree[2*node] + tree[2*node+1];
}
// ── 区间查询:[l, r] 内元素之和 ──
ll query(int node, int start, int end, int l, int r) {
if (r < start || end < l) return 0; // 范围外
if (l <= start && end <= r) {
return tree[node]; // 完全在内:返回存储的和(已包含懒惰!)
}
// 部分重叠:先向下传递,再递归
pushDown(node, start, end); // ← 关键:递归前必须先 pushDown!
int mid = (start + end) / 2;
ll leftSum = query(2*node, start, mid, l, r);
ll rightSum = query(2*node+1, mid+1, end, l, r);
return leftSum + rightSum;
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
ll arr[MAXN];
for (int i = 0; i < n; i++) cin >> arr[i];
build(1, 0, n-1, arr);
while (q--) {
int type;
cin >> type;
if (type == 1) {
// 区间更新:给 [l, r] 加 val
int l, r; ll val;
cin >> l >> r >> val;
update(1, 0, n-1, l, r, val);
} else {
// 区间查询:[l, r] 之和
int l, r;
cin >> l >> r;
cout << query(1, 0, n-1, l, r) << "\n";
}
}
return 0;
}
⚠️ 懒惰传播常见错误
4 大懒惰传播 Bug:
- 递归前忘记
pushDown—— 子节点会在父节点的懒惰之上再接收子节点自己的,导致查询结果错误 - 大小乘数用错 —— 写
tree[node] += val而非tree[node] += val * (end - start + 1)。节点存的是和,给(end-start+1)个元素各加 val 意味着和增加val×(大小) - 未将
lazy[]初始化为 0 —— 用memset(lazy, 0, sizeof(lazy))或在build()中初始化 - 混合不同操作的懒惰 —— 若同时有「区间加」和「区间乘」两种懒惰,顺序很重要,需要两个独立的懒惰数组和仔细处理的 pushDown
懒惰传播通用化
该模式适用于任何满足以下条件的操作:
- 聚合是结合性操作(和、最小值、最大值、XOR……)
- 更新在聚合上分配(给
n个元素各加k,和增加k*n)
| 更新 | 查询 | 懒惰存储 | pushDown 公式 |
|---|---|---|---|
| 区间加 | 区间和 | 加法增量 | tree[child] += lazy * size; lazy[child] += lazy |
| 区间赋值 | 区间和 | 赋值 | tree[child] = lazy * size; lazy[child] = lazy |
| 区间加 | 区间最小 | 加法增量 | tree[child] += lazy; lazy[child] += lazy |
| 区间赋值 | 区间最小 | 赋值 | tree[child] = lazy; lazy[child] = lazy |
5.7.10 区间赋值(第二类懒惰)
区间加是最常见的懒惰操作,但竞赛中还有另一类:把 [L, R] 内所有元素设为同一个值 V。
区别在于 pushDown 逻辑:区间加的懒惰是「增量叠加」,区间赋值的懒惰是「直接覆盖」。
// 带区间赋值懒惰的线段树
// tree[i] = 区间和,lazy[i] = 赋值标记(-1 表示无标记)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const int MAXN = 100005;
ll tree[4*MAXN];
ll lazy[4*MAXN]; // -1 = 无标记
void build(int s, int t, int p, ll a[]) {
lazy[p] = -1;
if (s == t) { tree[p] = a[s]; return; }
int m = s + ((t - s) >> 1);
build(s, m, p*2, a);
build(m+1, t, p*2+1, a);
tree[p] = tree[p*2] + tree[p*2+1];
}
// ── pushDown:区间赋值 ──
void pushDown(int p, int s, int t) {
if (lazy[p] == -1) return;
int m = s + ((t - s) >> 1);
// 左子树所有元素赋值为 lazy[p],共 m-s+1 个
tree[p*2] = lazy[p] * (m - s + 1);
tree[p*2+1] = lazy[p] * (t - m);
lazy[p*2] = lazy[p]; // 覆盖(不是叠加!)
lazy[p*2+1] = lazy[p];
lazy[p] = -1; // 清除标记
}
// ── 区间赋值更新 ──
void update(int l, int r, ll c, int s, int t, int p) {
if (l <= s && t <= r) {
tree[p] = c * (t - s + 1); // 整段赋值
lazy[p] = c;
return;
}
pushDown(p, s, t);
int m = s + ((t - s) >> 1);
if (l <= m) update(l, r, c, s, m, p*2);
if (r > m) update(l, r, c, m+1, t, p*2+1);
tree[p] = tree[p*2] + tree[p*2+1];
}
// ── 区间求和查询(同区间加版本,先 pushDown) ──
ll query(int l, int r, int s, int t, int p) {
if (l <= s && t <= r) return tree[p];
pushDown(p, s, t);
int m = s + ((t - s) >> 1);
ll res = 0;
if (l <= m) res += query(l, r, s, m, p*2);
if (r > m) res += query(l, r, m+1, t, p*2+1);
return res;
}
⚠️ 区间赋值 vs 区间加的关键区别:pushDown 时,赋值用覆盖(
lazy[child] = val),加法用叠加(lazy[child] += val)。若两种操作混用,必须维护两个独立的 lazy 数组,处理优先级。
5.7.11 动态开点线段树
使用场景
当值域极大(如 $10^9$)时,无法预先开 4N 的数组。但如果操作次数 M 较少(如 $10^5$),实际被访问到的节点只有 $O(M \log V)$ 个。
核心思路: 节点只在访问到时才创建,用 ls[p]、rs[p] 记录左右子节点编号(替代 2p/2p+1)。
// 动态开点线段树(权值线段树 / 值域线段树)
// 典型应用:区间统计、求第 k 小
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 2e6 + 5; // 节点池上限(M * log V)
int ls[MAXN], rs[MAXN]; // 左右子节点编号
long long sum[MAXN];
int cnt, root; // 节点计数器,根节点编号
// 单点加 1(用于插入值 x 到权值线段树)
void update(int &p, int s, int t, int x) {
if (!p) p = ++cnt; // 节点不存在则动态创建
sum[p]++;
if (s == t) return;
int m = s + ((t - s) >> 1);
if (x <= m) update(ls[p], s, m, x);
else update(rs[p], m+1, t, x);
}
// 区间求和
long long query(int p, int s, int t, int l, int r) {
if (!p) return 0; // 节点不存在,该区间无元素
if (l <= s && t <= r) return sum[p];
int m = s + ((t - s) >> 1);
long long res = 0;
if (l <= m) res += query(ls[p], s, m, l, r);
if (r > m) res += query(rs[p], m+1, t, l, r);
return res;
}
// 用法示例:插入若干值后查询 [l, r] 内有多少个
// update(root, 1, 1e9, val);
// query(root, 1, 1e9, l, r);
空间复杂度: M 次操作后节点数为 $O(M \log V)$,远小于 $4V$。
5.7.12 线段树优化建图
使用场景
图论中,若需要「一个点向一段区间内所有点连边」或「一段区间内所有点向一个点连边」,朴素建图边数为 $O(N^2)$,用线段树可降到 $O(N \log N)$。
做法
建两棵线段树:
| 树 | 方向 | 说明 |
|---|---|---|
| 出树(区间→点) | 子节点→父节点(0 权边) | 叶节点连原图点,区间节点汇聚到父节点 |
| 入树(点→区间) | 父节点→子节点(0 权边) | 父节点分发到叶节点,叶节点连原图点 |
区间 [2,4] → 点 u 连边:
在入树中,对应 [2,4] 区间节点连一条权为 w 的边到 u
入树内部父→子连 0 权边,叶节点与原图点重合
点 u → 区间 [2,4] 连边:
在出树中,u 连一条权为 w 的边到对应 [2,4] 区间节点
出树内部子→父连 0 权边,叶节点与原图点重合
建好后,以每个原图点为源点跑 Dijkstra 即可在 $O((N \log N + M) \log N)$ 内解决区间连边的最短路问题。
🔗 参考题目: CF786B Legacy(点→区间、区间→点、点→点混合连边最短路)
线段树变体速览
| 变体 | 用途 | 复杂度 |
|---|---|---|
| 基础线段树 | 单点更新 + 区间查询 | O(log N) |
| 懒惰传播(区间加) | 区间更新 + 区间查询 | O(log N) |
| 懒惰传播(区间赋值) | 区间赋值 + 区间查询 | O(log N) |
| 动态开点线段树 | 值域大但操作少 | O(M log V) 空间 |
| 权值线段树 | 全局第 k 小、逆序对 | O(log V) 查询 |
| 线段树优化建图 | 区间连边的最短路 | O(N log N) 建图 |
| 可持久化线段树 | 维护历史版本 | O(log N) 每版本 |
⚠️ 常见错误
- 数组大小太小: 始终分配
tree[4 * MAXN]。对非 2 的幂次方大小的数组,用2 * MAXN会越界。 - 范围外的单位元用错: 求和查询返回 0;求最小查询返回
INT_MAX;求最大查询返回INT_MIN。 - 忘记更新父节点: 更新子节点后,必须重新计算父节点:
tree[node] = tree[2*node] + tree[2*node+1]。 - 0-indexed vs 1-indexed 混淆: 本实现使用 0-indexed 数组但 1-indexed 树节点,保持一致性。
- 前缀和足够时用线段树: 若没有更新操作,前缀和(
O(1)查询)优于线段树(O(log N)查询)。合适时用更简单的工具。
本章总结
📌 核心要点
| 操作 | 时间 | 关键代码行 |
|---|---|---|
| 构建 | O(N) | tree[node] = tree[2*node] + tree[2*node+1] |
| 单点更新 | O(log N) | 递归到叶节点,向上更新 |
| 区间查询 | O(log N) | 完全在内/完全在外时提前返回 |
| 空间 | O(4N) | 分配 tree[4 * MAXN] |
❓ 常见问题
Q1:什么时候选线段树 vs 前缀和?
A:简单规则——若数组从不改变,前缀和更好(
O(1)查询 vsO(log N))。若数组被修改(单点更新),用线段树或 BIT。若需要区间更新(给一段区间加值),用带懒惰传播的线段树。
Q2:为什么树数组大小需要 4N?
A:线段树是完全二叉树。当 N 不是 2 的幂次方时,最后一层可能不完整但仍需空间。最坏情况下需要约 4N 个节点。用
4*MAXN是安全上界。
Q3:树状数组(BIT)和线段树哪个更好?
A:BIT 代码更短(约 15 行 vs 30 行),常数更小,但只能处理「可前缀分解」的操作(如求和)。线段树更通用(可以处理区间最小/最大、GCD 等),支持更复杂的操作(如懒惰传播)。竞赛中:能用 BIT 就用 BIT,BIT 不够用时切换到线段树。
Q4:线段树能处理哪些类型的查询?
A:任何满足结合律的操作:求和(+)、最小值(min)、最大值(max)、GCD、XOR、乘积等。关键是有「单位元」(如求和的 0、最小值的
INT_MAX、最大值的INT_MIN)。
Q5:什么是懒惰传播?什么时候需要?
A:当需要「给区间 [L,R] 的每个元素加 V」(区间更新)时,朴素做法从 L 到 R 逐个更新叶节点(
O(N)),太慢。懒惰传播将更新「懒惰地」存储在内部节点,只在子节点实际需要被查询时才向下传递,将区间更新也优化为O(log N)。
🔗 与后续章节的联系
- 第 3.2 章(前缀和):线段树的「简化版」——没有更新操作时用前缀和
- 第 5.1–5.2 章(图):欧拉序 + 线段树可以高效处理树上路径查询
- 第 6.1–6.3 章(DP):某些 DP 优化需要线段树维护 DP 值的区间最小/最大
- 线段树是 USACO Gold 级别的核心数据结构,掌握它能解决大量 Gold 题目
练习题
题目 5.7.1 — 经典区间和 🟢 简单 实现线段树,处理 N 个元素和 Q 次查询:单点更新或区间求和。
提示
使用 5.7.6 节的完整实现,用标志区分查询类型(1 = 更新,2 = 查询)。#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
long long tree[4*MAXN];
int n, q;
void build(int node, int s, int e, int arr[]) {
if (s==e) { tree[node]=arr[s]; return; }
int mid=(s+e)/2;
build(2*node,s,mid,arr); build(2*node+1,mid+1,e,arr);
tree[node]=tree[2*node]+tree[2*node+1];
}
void update(int node,int s,int e,int idx,long long val) {
if (s==e) { tree[node]=val; return; }
int mid=(s+e)/2;
if (idx<=mid) update(2*node,s,mid,idx,val);
else update(2*node+1,mid+1,e,idx,val);
tree[node]=tree[2*node]+tree[2*node+1];
}
long long query(int node,int s,int e,int l,int r) {
if (r<s||e<l) return 0;
if (l<=s&&e<=r) return tree[node];
int mid=(s+e)/2;
return query(2*node,s,mid,l,r)+query(2*node+1,mid+1,e,l,r);
}
int arr[MAXN];
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
cin>>n>>q;
for(int i=1;i<=n;i++) cin>>arr[i];
build(1,1,n,arr);
while(q--) {
int t; cin>>t;
if(t==1) { int i; long long v; cin>>i>>v; update(1,1,n,i,v); }
else { int l,r; cin>>l>>r; cout<<query(1,1,n,l,r)<<"\n"; }
}
}
复杂度: O(N) 构建,每次查询/更新 O(log N)。
题目 5.7.2 — 区间最小值 🟡 中等 同上,但查询区间最小值,处理单点更新。
提示
将树操作中的 `+` 改为 `min`,范围外返回 `INT_MAX`。在上面的解法中修改两行:
// 在 build/update 中:
tree[node] = min(tree[2*node], tree[2*node+1]);
// 在 query 中——范围外的单位元:
if (r < s || e < l) return INT_MAX;
// 合并:
return min(query(2*node,s,mid,l,r), query(2*node+1,mid+1,e,l,r));
初始化:tree[叶节点] = arr[s](相同)。唯一改变的是聚合函数和单位元。
题目 5.7.3 — 逆序对计数 🔴 困难
统计满足 i < j 且 arr[i] > arr[j] 的对 (i,j) 的个数。
提示
从左到右处理元素。对每个元素 x,查询已插入的元素中 > x 的个数。核心思路: 将值坐标压缩到 [1..N]。对每个元素 x(从左到右),逆序对数 += (已插入元素数)- (已插入的 ≤ x 的数量)= query(N) - query(x)。然后插入 x。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 300005;
int tree[MAXN], n;
void update(int i){for(;i<=n;i+=i&-i) tree[i]++;}
int query(int i){int s=0;for(;i>0;i-=i&-i)s+=tree[i];return s;}
int main(){
cin>>n;
vector<int> a(n);
for(int&x:a)cin>>x;
// 坐标压缩
vector<int> sorted=a; sort(sorted.begin(),sorted.end());
sorted.erase(unique(sorted.begin(),sorted.end()),sorted.end());
for(int&x:a) x=lower_bound(sorted.begin(),sorted.end(),x)-sorted.begin()+1;
int m=sorted.size();
long long inv=0;
for(int i=0;i<n;i++){
inv += (i - query(a[i])); // 已见过的中大于 a[i] 的个数
update(a[i]);
}
cout<<inv<<"\n";
}
复杂度: O(N log N),用 BIT(对此问题比线段树更合适)。
🏆 挑战题:USACO 2016 February Gold:围牛栏 需要带更新的区间最大查询的题目。尝试分别用树状数组和线段树解决,理解两者的权衡。
第 5.8 章:树状数组(BIT)
树状数组(又名二进制索引树 / BIT)是竞赛编程中最常用的数据结构之一:不到 15 行代码,却能在 O(log N) 时间内支持单点更新和前缀查询。
1. 先从一个很朴素的问题出发:为什么普通前缀和遇到修改会变慢?
2. 再认识
lowbit:它告诉我们每个小盒子应该管理几个数。3. 然后看懂
tree[i] 到底存的是哪一段和。4. 接着分别拆开讲查询和更新:先手算,再看代码。
5. 最后学习差分 BIT、逆序对、权值 BIT 等进阶用法。
想象一排同学每人手里有一些糖。老师经常问“前 7 个同学一共有多少糖?”,也经常让“第 3 个同学多拿 5 颗糖”。如果每次都从第 1 个数到第 7 个,会很慢;如果每次有人变了都重算所有前缀和,也很慢。树状数组就是把同学分成许多大小不同的小组,每个小组长帮忙记录一段糖果总数,这样查询和修改都不用找太多人。
5.8.1 先从问题出发:为什么需要树状数组?
在学习树状数组前,我们先回忆两个最简单的方法。
方法一:直接数组
如果数组是:
A = [3, 1, 4, 1, 5, 9, 2, 6]
想求 A[1..7] 的和,就从头加到尾:
3 + 1 + 4 + 1 + 5 + 9 + 2 = 25
- 优点:修改很快,比如
A[3] += 10,直接改一个数。 - 缺点:查询慢,问一次前缀和可能要加很多个数。
方法二:前缀和数组
前缀和把“从开头到当前位置的总和”提前存起来:
prefix[i] = A[1] + A[2] + ... + A[i]
这样查询 A[1..7] 很快,直接看 prefix[7]。
但如果 A[3] 变了,会发生什么?
prefix[3], prefix[4], prefix[5], ..., prefix[n]
后面很多前缀和都要跟着改。
所以前缀和的矛盾是:
| 操作 | 直接数组 | 前缀和数组 |
|---|---|---|
| 修改一个位置 | 快,O(1) | 慢,可能要改很多个 |
| 查询前缀和 | 慢,可能要加很多个 | 快,O(1) |
树状数组想解决的就是这个矛盾:
能不能让修改不要太慢,查询也不要太慢?
答案是可以。BIT 让这两个操作都变成 O(log N)。
直接数组:修改快,查询慢
前缀和:查询快,修改慢
树状数组:修改和查询都比较快
5.8.2 核心积木:什么是 lowbit?
树状数组最重要的积木只有一个:lowbit。
int lowbit(int x) {
return x & (-x);
}
先不要急着背公式。我们先弄懂它在回答什么问题:
从右往左看,
x的第一个1代表多大的数?
例如 x = 6:
6 的二进制 = 0110
从右往左看,第一个 1 在第 1 位
这一位代表 2
所以 lowbit(6) = 2
再看几个例子:
lowbit(1) = lowbit(0001) = 1
lowbit(2) = lowbit(0010) = 2
lowbit(3) = lowbit(0011) = 1
lowbit(4) = lowbit(0100) = 4
lowbit(6) = lowbit(0110) = 2
lowbit(8) = lowbit(1000) = 8
lowbit 的位运算原理
对任意正整数 x,lowbit(x) = x & (-x) 返回 x 的二进制表示中最低位 1 所代表的值。
以 x = 6 为例:
x = 6 → 二进制:0110
-x = -6 → 补码:1010(按位取反 + 1)
x & (-x) = 0010 = 2 ← 最低位 1 对应 2^1 = 2
如果你现在还不熟悉补码,也没关系。先把 lowbit(x) 当作一个小工具:
它能帮我们找到
x最右边那个1对应的数值。
示例:
| x | 二进制 | lowbit(x) | 小学生版理解 |
|---|---|---|---|
| 1 | 0001 | 1 | 最右边的 1 代表 1 |
| 2 | 0010 | 2 | 最右边的 1 代表 2 |
| 3 | 0011 | 1 | 最右边的 1 代表 1 |
| 4 | 0100 | 4 | 最右边的 1 代表 4 |
| 6 | 0110 | 2 | 最右边的 1 代表 2 |
| 8 | 1000 | 8 | 最右边的 1 代表 8 |
为什么 lowbit 对 BIT 很重要?
在 BIT 里,lowbit(i) 不只是一个位运算结果,它还表示:
tree[i]这个小盒子要管理几个原数组元素。
例如:
lowbit(6) = 2 → tree[6] 管 2 个数
lowbit(8) = 8 → tree[8] 管 8 个数
lowbit(3) = 1 → tree[3] 管 1 个数
所以可以先记住一句话:
lowbit(i)决定tree[i]这个盒子的大小。
5.8.4 tree[i] 到底存什么?
BIT 的精妙之处:tree[i] 不存储单个元素,而是存储一段区间的和。
更准确地说:
tree[i] = A[i - lowbit(i) + 1] + ... + A[i]
也就是说,tree[i] 管的是:
以 i 结尾,长度为 lowbit(i) 的一段
如果把 tree[i] 想成一个小盒子,那么:
- 盒子的右端点:永远是
i。 - 盒子的长度:由
lowbit(i)决定。 - 盒子里装的东西:这一段
A的总和。
用 n = 8 看完整盒子分工
假设原数组下标从 1 到 8,那么每个盒子负责的范围是:
下标 i: 1 2 3 4 5 6 7 8
tree[i] 管理的范围:
tree[1] = A[1] (长度 lowbit(1)=1)
tree[2] = A[1]+A[2] (长度 lowbit(2)=2)
tree[3] = A[3] (长度 lowbit(3)=1)
tree[4] = A[1]+...+A[4] (长度 lowbit(4)=4)
tree[5] = A[5] (长度 lowbit(5)=1)
tree[6] = A[5]+A[6] (长度 lowbit(6)=2)
tree[7] = A[7] (长度 lowbit(7)=1)
tree[8] = A[1]+...+A[8] (长度 lowbit(8)=8)
BIT 结构(n=8):每个 tree[i] 覆盖恰好 lowbit(i) 个以下标 i 结尾的元素。

为什么这样分组有用?
因为这些盒子大小不一样:有的管 1 个数,有的管 2 个数,有的管 4 个数,有的管 8 个数。
就像班级里有:
1 人小组、2 人小组、4 人小组、8 人小组
老师问“前 7 个人一共有多少糖”时,不需要一个一个问,可以直接问几个组长:
前 7 个 = [1..4] + [5..6] + [7]
这正好对应:
tree[4] + tree[6] + tree[7]
5.8.6 前缀查询:怎样快速算 A[1..i]?
BIT 的查询函数通常叫 query(i),意思是求:
A[1] + A[2] + ... + A[i]
核心动作是:
i -= lowbit(i);
这句话的意思是:
我已经拿到了以
i结尾的一段和,下一步就跳到这段的前面继续拿。
手算 query(7)
我们要算:
A[1] + A[2] + A[3] + A[4] + A[5] + A[6] + A[7]
从 i = 7 开始:
| 当前 i | lowbit(i) | 加哪个盒子 | 这个盒子负责 | 下一步 |
|---|---|---|---|---|
| 7 | 1 | tree[7] | A[7] | 7 - 1 = 6 |
| 6 | 2 | tree[6] | A[5] + A[6] | 6 - 2 = 4 |
| 4 | 4 | tree[4] | A[1] + A[2] + A[3] + A[4] | 4 - 4 = 0 |
所以:
query(7) = tree[7] + tree[6] + tree[4]
= A[7] + (A[5]+A[6]) + (A[1]+A[2]+A[3]+A[4])
= A[1] + A[2] + ... + A[7]
这三段刚好不重不漏:
[1..4] + [5..6] + [7]
查询 prefix(7) 的跳转路径(i -= lowbit(i) 向下跳):

对应代码:
long long query(int i) {
long long sum = 0;
while (i > 0) {
sum += tree[i];
i -= lowbit(i);
}
return sum;
}
💡 记忆口诀: 查询是“往前跳”,每跳一次就拿走一整盒已经算好的和。
5.8.7 单点更新:为什么要一路向上改?
如果 A[3] 增加了 val,哪些 tree[i] 会受影响?
答案是:所有负责范围里包含 A[3] 的盒子都要跟着加 val。
从前面的盒子分工可以看到:
tree[3] = A[3]
tree[4] = A[1]+A[2]+A[3]+A[4]
tree[8] = A[1]+...+A[8]
所以更新 A[3] 时,要改:
tree[3], tree[4], tree[8]
核心动作是:
i += lowbit(i);
这句话的意思是:
当前盒子改完后,跳到下一个更大的、也包含当前位置的盒子。
手算 update(3, val)
| 当前 i | lowbit(i) | 修改哪个盒子 | 下一步 |
|---|---|---|---|
| 3 | 1 | tree[3] += val | 3 + 1 = 4 |
| 4 | 4 | tree[4] += val | 4 + 4 = 8 |
| 8 | 8 | tree[8] += val | 8 + 8 = 16,超过 n,停止 |
更新位置 3 的跳转路径(i += lowbit(i) 向上跳):

对应代码:
void update(int i, long long val) {
while (i <= n) {
tree[i] += val;
i += lowbit(i);
}
}
💡 记忆口诀: 更新是“往后跳”,每跳一次就告诉一个受影响的组长:“你管的总和变了!”
查询和更新的方向对比
| 操作 | 跳转方向 | 跳转代码 | 直觉 |
|---|---|---|---|
查询 query(i) | 往前跳 | i -= lowbit(i) | 拿走当前盒子,继续拿前面的盒子 |
更新 update(i,val) | 往后跳 | i += lowbit(i) | 通知所有包含这个位置的大盒子 |
每次跳转都会让二进制发生明显变化,所以最多跳大约 log N 次。
5.8.8 把查询和更新写成完整代码
前面我们已经分别手算了 query 和 update。现在把它们合在一起,就是最经典的树状数组模板。
先抓住三个重点:
- 数组从 1 开始编号:因为
lowbit(0)=0,用 0 会卡住。 - 查询往前跳:
i -= lowbit(i)。 - 更新往后跳:
i += lowbit(i)。
// ══════════════════════════════════════════════════════════════
// 树状数组(BIT)—— 经典实现
// 支持:单点更新 O(log N),前缀和查询 O(log N)
// 数组必须使用 1-indexed(关键!)
// ══════════════════════════════════════════════════════════════
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 300005;
int n;
long long tree[MAXN]; // BIT 数组,1-indexed
// ── lowbit:返回最低位 1 的值 ──
inline int lowbit(int x) {
return x & (-x);
}
// ── 更新:给位置 i 加 val ──
// 向上遍历:i += lowbit(i)
// 覆盖位置 i 的每个祖先节点都被更新
void update(int i, long long val) {
for (; i <= n; i += lowbit(i))
tree[i] += val;
// 时间:O(log N) — 最多 log2(N) 次迭代
}
// ── 查询:返回前缀和 A[1..i] ──
// 向下遍历:i -= lowbit(i)
// 将 [1..i] 分解为 O(log N) 个不重叠的区间
long long query(int i) {
long long sum = 0;
for (; i > 0; i -= lowbit(i))
sum += tree[i];
return sum;
// 时间:O(log N) — 最多 log2(N) 次迭代
}
// ── 构建:从已有数组 A[1..n] 初始化 BIT ──
// 方法一:N 次单独更新 — O(N log N)
void build_slow(long long A[]) {
fill(tree + 1, tree + n + 1, 0LL);
for (int i = 1; i <= n; i++)
update(i, A[i]);
}
// 方法二:O(N) 构建(利用「直接父节点」关系)
void build_fast(long long A[]) {
for (int i = 1; i <= n; i++) {
tree[i] += A[i];
int parent = i + lowbit(i); // BIT 中的直接父节点
if (parent <= n)
tree[parent] += tree[i];
}
}
// 方法三:O(N) 构建(利用前缀和)
// 原理:tree[i] = sum(A[i-lowbit(i)+1 .. i])
// = prefix[i] - prefix[i - lowbit(i)]
void build_prefix(long long A[], long long prefix[]) {
// 先求前缀和
for (int i = 1; i <= n; i++) prefix[i] = prefix[i-1] + A[i];
// 利用前缀和直接计算每个节点
for (int i = 1; i <= n; i++)
tree[i] = prefix[i] - prefix[i - lowbit(i)];
}
// ── 完整示例 ──
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int q;
cin >> n >> q;
long long A[MAXN] = {};
for (int i = 1; i <= n; i++) cin >> A[i];
build_fast(A); // O(N) 初始化
while (q--) {
int type;
cin >> type;
if (type == 1) {
// 单点更新:A[i] += val
int i; long long val;
cin >> i >> val;
update(i, val);
} else {
// 前缀查询:A[1..r] 的和
int r;
cin >> r;
cout << query(r) << "\n";
}
}
return 0;
}
5.8.7 区间查询:用两个前缀和相减
会了前缀查询后,区间查询就很自然了。
如果要算 A[l..r],可以先算 A[1..r],再减掉前面不需要的 A[1..l-1]:
A[l..r] = A[1..r] - A[1..l-1]
这和前缀和数组的思想完全一样,只是这里的 query 由 BIT 在 O(log N) 内完成:
// 区间求和:A[l..r] 的和
// 时间:O(log N) — 两次前缀查询
long long range_query(int l, int r) {
return query(r) - query(l - 1);
// query(r) = A[1] + A[2] + ... + A[r]
// query(l-1) = A[1] + A[2] + ... + A[l-1]
// 差值 = A[l] + A[l+1] + ... + A[r]
}
// 示例:
// A = [3, 1, 4, 1, 5, 9, 2, 6] (1-indexed)
// range_query(3, 6) = query(6) - query(2)
// = (3+1+4+1+5+9) - (3+1)
// = 23 - 4 = 19
// 验证:A[3]+A[4]+A[5]+A[6] = 4+1+5+9 = 19 ✓
5.8.9 什么时候用 BIT?和前缀和、线段树对比
学到这里,你可能会问:既然有前缀和,也有线段树,为什么还要学 BIT?
简单说:
- 前缀和:适合不修改的数组。
- BIT:适合“单点修改 + 区间求和”。
- 线段树:适合更复杂的区间操作。
| 操作 | 前缀和数组 | 树状数组(BIT) | 线段树 |
|---|---|---|---|
| 构建 | O(N) | O(N) 或 O(N log N) | O(N) |
| 前缀查询 | O(1) | O(log N) | O(log N) |
| 区间查询 | O(1) | O(log N) | O(log N) |
| 单点更新 | O(N) 重建 | O(log N) ✓ | O(log N) ✓ |
| 区间更新 | O(N) | O(log N)(差分 BIT) | O(log N)(懒惰标记) |
| 区间最小/最大 | O(1)(稀疏表) | ❌ 不支持 | ✓ 支持 |
| 代码复杂度 | 极简 | 简单(10 行) | 复杂(50+ 行) |
| 常数因子 | 最小 | 非常小 | 较大 |
| 空间 | O(N) | O(N) | O(4N) |
什么时候选 BIT?
- ✅ 只需前缀/区间和 + 单点更新
- ✅ 需要极简代码(竞赛中减少 bug)
- ✅ 逆序对计数、归并排序计数问题
- ❌ 需要区间最小/最大 → 用线段树
- ❌ 需要复杂区间操作(区间乘法等)→ 用线段树
5.8.10 交互式可视化:BIT 更新过程
5.8.6 区间更新 + 单点查询(差分 BIT)
前面讲的是标准 BIT:
单点更新 + 前缀查询
现在往前走一步:如果题目经常说“把一整段都加上 val”,怎么办?
直接逐个位置修改太慢。这里可以借用差分数组,让 BIT 维护差分数组。这样就能支持:
区间更新 + 单点查询
原理
设差分数组 D[i] = A[i] - A[i-1](D[1] = A[1])。
你可以把差分数组理解成“变化通知单”:
D[l] += val:从l开始,每个位置都多val。D[r+1] -= val:从r+1开始,把刚才的增加取消掉。
所以给 A[l..r] 全部加 val,只需要改两个位置:
D[l] += val
D[r+1] -= val
而 A[i] 等于差分数组前缀和:
A[i] = D[1] + D[2] + ... + D[i]
// ══════════════════════════════════════════════════════════════
// 差分 BIT:区间更新 + 单点查询
// ══════════════════════════════════════════════════════════════
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 300005;
int n;
long long diff_bit[MAXN]; // 差分数组 D[] 上的 BIT
inline int lowbit(int x) { return x & (-x); }
// 更新差分 BIT 的位置 i:D[i] += val
void diff_update(int i, long long val) {
for (; i <= n; i += lowbit(i))
diff_bit[i] += val;
}
// 查询 A[i] = D[1..i] 的和 = 差分 BIT 的前缀查询
long long diff_query(int i) {
long long s = 0;
for (; i > 0; i -= lowbit(i))
s += diff_bit[i];
return s;
}
// 区间更新:给 A[l..r] 全部加 val
// 等价于:D[l] += val,D[r+1] -= val
void range_update(int l, int r, long long val) {
diff_update(l, val); // D[l] += val
diff_update(r + 1, -val); // D[r+1] -= val
}
// 单点查询:返回 A[i] 的当前值
// A[i] = D[1] + D[2] + ... + D[i] = prefix_sum(D, i)
long long point_query(int i) {
return diff_query(i);
}
进阶:区间更新 + 区间查询(双 BIT)
同时支持区间更新和区间查询,使用两个 BIT:
// ══════════════════════════════════════════════════════════════
// 双 BIT:区间更新 + 区间查询
// 公式:sum(1..r) = B1[r] * r - B2[r]
// 其中 B1 是 D[] 上的 BIT,B2 是 (i-1)*D[i] 上的 BIT
// ══════════════════════════════════════════════════════════════
long long B1[MAXN], B2[MAXN];
inline int lowbit(int x) { return x & (-x); }
void add(long long* b, int i, long long v) {
for (; i <= n; i += lowbit(i)) b[i] += v;
}
long long sum(long long* b, int i) {
long long s = 0;
for (; i > 0; i -= lowbit(i)) s += b[i];
return s;
}
// 区间更新:给 A[l..r] 加 val
void range_add(int l, int r, long long val) {
add(B1, l, val);
add(B1, r + 1, -val);
add(B2, l, val * (l - 1)); // 补偿前缀公式
add(B2, r + 1, -val * r);
}
// 前缀和 A[1..r]
long long prefix_sum(int r) {
return sum(B1, r) * r - sum(B2, r);
}
// 区间和 A[l..r]
long long range_sum(int l, int r) {
return prefix_sum(r) - prefix_sum(l - 1);
}
5.8.11 USACO 风格题:用 BIT 统计逆序对
题目描述
统计逆序对(O(N log N))
给定长度为 N 的整数数组 A(元素不同,范围 1..N),统计逆序对的数量。
逆序对:一对下标 (i, j),满足 i < j 但 A[i] > A[j]。
数据规模: 1 ≤ N ≤ 5×10⁵。逆序对最多约 N²/2 ≈ 1.25×10¹¹,需要 long long。
样例输入:
5
3 1 4 2 5
样例输出:
3
解释: 逆序对是 (3,1)、(3,2)、(4,2),共 3 对。
先用小例子理解逆序对
数组:
[3, 1, 4, 2, 5]
从左到右看:
3在1前面,而且3 > 1,所以(3,1)是逆序对。3在2前面,而且3 > 2,所以(3,2)是逆序对。4在2前面,而且4 > 2,所以(4,2)是逆序对。
一共 3 对。
为什么 BIT 能帮忙?
处理到当前数 a 时,左边的数都已经出现过。我们只需要知道:
左边已经出现的数里面,有多少个 > a?
如果用 BIT 维护“每个值出现过几次”,就可以快速得到:
已经出现的总数 - 已经出现且 <= a 的数量
这就是代码里的:
(i - 1) - query(a)
解法:BIT 逆序对计数
// ══════════════════════════════════════════════════════════════
// 用树状数组统计逆序对 — O(N log N)
//
// 核心思路:
// 从左到右处理 A[i]。
// 对每个 A[i],以 A[i] 为右端点的逆序对数
// = 已处理过的值中大于 A[i] 的数量
// = (目前处理的元素数) - (已处理的 <= A[i] 的元素数)
// = i-1 - prefix_query(A[i])
// 对所有 i 求和即为总逆序对数。
//
// BIT 的作用:追踪已见过的值的频率。
// 见到值 v 后:update(v, +1)
// 查询 <= x 的值的数量:query(x)
// ══════════════════════════════════════════════════════════════
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const int MAXN = 300005;
int n;
int bit[MAXN]; // 频率计数 BIT
inline int lowbit(int x) { return x & (-x); }
// 在位置 v 加 1(见到了值 v)
void update(int v) {
for (; v <= n; v += lowbit(v))
bit[v]++;
}
// 统计已见过的 [1..v] 中的值的数量
int query(int v) {
int cnt = 0;
for (; v > 0; v -= lowbit(v))
cnt += bit[v];
return cnt;
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n;
ll inversions = 0;
for (int i = 1; i <= n; i++) {
int a;
cin >> a;
// 统计以 a 为右端点的逆序对:
// 已见过的值中大于 a 的数量
// = (目前已见 i-1 个元素) - (已见的 <= a 的数量)
int less_or_equal = query(a); // [1..a] 中已见的数量
int greater = (i - 1) - less_or_equal; // [a+1..n] 中已见的数量
inversions += greater;
// 标记我们已见过值 a
update(a);
}
cout << inversions << "\n";
return 0;
}
/*
对 A = [3, 1, 4, 2, 5] 的追踪:
i=1, a=3:已见=[],query(3)=0,greater=0-0=0。逆序对=0。update(3)。
i=2, a=1:已见=[3],query(1)=0,greater=1-0=1。逆序对=1。update(1)。
(3 > 1:1 个逆序对:(3,1) ✓)
i=3, a=4:已见=[3,1],query(4)=2,greater=2-2=0。逆序对=1。update(4)。
(没有已见的元素 > 4)
i=4, a=2:已见=[3,1,4],query(2)=1,greater=3-1=2。逆序对=3。update(2)。
(3>2 且 4>2:2 个逆序对:(3,2),(4,2) ✓)
i=5, a=5:已见=[3,1,4,2],query(5)=4,greater=4-4=0。逆序对=3。update(5)。
最终:3 ✓
*/
复杂度分析:
- 时间:O(N log N) —— N 次迭代,每次 O(log N) 的更新 + 查询
- 空间:O(N)(BIT)
扩展: 若数组元素不在 1..N 范围内,先做坐标压缩再使用 BIT:
// 任意值的坐标压缩
vector<int> A(n);
for (int i = 0; i < n; i++) cin >> A[i];
// 步骤一:排序去重
vector<int> sorted_A = A;
sort(sorted_A.begin(), sorted_A.end());
sorted_A.erase(unique(sorted_A.begin(), sorted_A.end()), sorted_A.end());
// 步骤二:将每个值替换为它的排名(1-indexed)
for (int i = 0; i < n; i++) {
A[i] = lower_bound(sorted_A.begin(), sorted_A.end(), A[i]) - sorted_A.begin() + 1;
// A[i] 现在在 [1..M],M = sorted_A.size()
}
// 现在用 n = sorted_A.size() 使用 BIT
5.8.12 权值树状数组:全局第 k 小
权值 BIT 是 BIT 的另一种常见用法。
前面的 BIT 通常把下标当作数组位置:
位置 1、位置 2、位置 3、...
权值 BIT 把下标当作“数值大小”:
值 1、值 2、值 3、...
也就是说,bit[v] 表示值 v 出现了多少次。这样我们就能高效查询「序列中第 k 小的元素」。
例如当前数列是:
[1, 2, 2, 4, 7]
那么频率是:
值 1 出现 1 次
值 2 出现 2 次
值 4 出现 1 次
值 7 出现 1 次
第 3 小是 2,因为排好序后是:
1, 2, 2, 4, 7
↑
第 3 小
朴素做法:二分 + 前缀查询,O(log² N)
// 在值域 [1..MAXV] 上的 BIT 中,找第 k 小的值
int kth_binary_search(int k) {
int lo = 1, hi = MAXV;
while (lo < hi) {
int mid = (lo + hi) / 2;
if (query(mid) >= k)
hi = mid;
else
lo = mid + 1;
}
return lo;
}
倍增优化:O(log N)
二分法已经够好理解,但每次二分都要调用一次 query,所以是 O(log² N)。
借助 BIT 的树形结构,倍增法可以在 O(log N) 内完成第 k 小查询:
// 全局第 k 小(倍增法)— O(log N)
// 前提:BIT 维护值域频率,bit[v] = v 的出现次数
int kth(int k) {
int sum = 0, x = 0;
// 从最高位开始,逐位确定答案
for (int i = (int)log2(MAXV); i >= 0; --i) {
int nx = x + (1 << i);
if (nx <= MAXV && sum + bit[nx] < k) {
x = nx; // 这一段全选,继续向右扩展
sum += bit[nx];
}
// 否则答案在 [x+1, x + 2^(i-1)] 范围内,不扩展
}
return x + 1; // x 是最后一个 sum < k 的位置,答案是 x+1
}
// 完整示例:动态维护序列,支持插入和第 k 小查询
// 插入值 v:update(v, 1)
// 删除值 v:update(v, -1)
// 查询第 k 小:kth(k)
💡 原理解析: BIT 的树形态使得
bit[x]正好是以 x 为根的子树之和(x 的二进制最低位之前的区间)。倍增时,每次尝试将 x 的某一位设为 1:若该位为 1 时的前缀和仍 < k,说明答案在右侧,就扩展;否则缩小在左侧查找。共 O(log V) 步。
💡 章节联系: BIT 和线段树是 USACO 中最常配合使用的两个数据结构。BIT 用 1/5 的代码量处理 80% 的场景。掌握 BIT 后,回到第 5.7 章学习线段树懒惰传播——那是 BIT 无法触达的领域。
5.8.13 常见错误
❌ 错误一:lowbit 实现有误
// ❌ 错误 — 常见笔误
int lowbit(int x) { return x & (x - 1); } // 这会清除最低位,而非返回它!
// x=6 (0110):x&(x-1) = 0110&0101 = 0100 = 4(错误,应为 2)
// ✅ 正确
int lowbit(int x) { return x & (-x); }
// x=6:-6 = ...11111010(补码)
// 0110 & 11111010 = 0010 = 2 ✓
记忆口诀: x & (-x) 读作「x 与负 x 相与」。-x 是按位取反加 1,保留最低位的 1,清除其下所有位,反转其上所有位,相与只保留最低位。
❌ 错误二:0-indexed 数组(0-indexed 陷阱)
BIT 必须使用 1-indexed 数组。0-indexed 会导致死循环!
// ❌ 错误 — 0-indexed 导致死循环!
// 如果 i = 0:query 循环:i -= lowbit(0) = 0 - 0 = 0 → 死循环!
// ✅ 正确 — 转换为 1-indexed
for (int i = 0; i < n; i++) {
update(i + 1, arr[i]); // 将 0-indexed 的 i 转换为 1-indexed 的 i+1
}
// 注意:对 0-indexed 范围 [l, r] 的查询用 query(r+1) - query(l)
❌ 错误三:大和的整数溢出
// ❌ 错误 — tree[] 对大和应该用 long long
int tree[MAXN]; // 和超过 2^31 时溢出
// ✅ 正确
long long tree[MAXN];
// 还有:统计逆序对时,逆序对数最多 N*(N-1)/2 ≈ 4.5×10^10(N=3×10^5)
// 结果计数器始终用 long long!
long long inversions = 0; // ✅ 不是 int!
❌ 错误四:多组测试数据间忘记清空 BIT
// ❌ 错误 — 多组测试数据时
int T; cin >> T;
while (T--) {
// 忘记清空 tree[]!
// 上一组测试数据的旧数据污染结果
solve();
}
// ✅ 正确 — 每组测试数据前重置
int T; cin >> T;
while (T--) {
fill(tree + 1, tree + n + 1, 0LL); // 清空 BIT
solve();
}
5.8.14 本章总结
📋 公式速查
| 操作 | 代码 | 描述 |
|---|---|---|
| lowbit | x & (-x) | x 的最低位 1 的值 |
| 单点更新 | for(;i<=n;i+=lowbit(i)) t[i]+=v | 向上传播 |
| 前缀查询 | for(;i>0;i-=lowbit(i)) s+=t[i] | 向下分解 |
| 区间查询 | query(r) - query(l-1) | 差值公式 |
| 区间更新(差分 BIT) | upd(l,+v); upd(r+1,-v) | 差分数组 |
| 逆序对计数 | (i-1) - query(a[i]) | 处理每个元素时计数 |
| 权值 BIT 第 k 小 | 在频率 BIT 上找最小的 x,使 query(x) >= k | 把值域当下标 |
| 数组必须 | 1-indexed | 0-indexed → 死循环 |
🧩 从浅到深的完整脉络
- 先看矛盾:普通数组查询慢,前缀和修改慢。
- 再学
lowbit:它决定每个tree[i]管几个数。 - 理解盒子分工:
tree[i]存的是以i结尾的一段和。 - 掌握两个方向:查询往前跳,更新往后跳。
- 套用区间查询:
sum(l,r)=query(r)-query(l-1)。 - 进阶到差分 BIT:把区间修改变成两个差分点修改。
- 应用到计数问题:逆序对、频率统计、第 k 小都可以用 BIT。
❓ 常见问题
Q1:BIT 和线段树都支持前缀和 + 单点更新,该选哪个?
A:尽可能用 BIT。BIT 只有 10 行代码,常数更小(实测快 2-3 倍),出错概率更低。只有需要区间最小/最大(RMQ)、区间赋色或更复杂区间操作时才选线段树。竞赛中,BIT 是「默认武器」,线段树是「重型火炮」。
Q2:BIT 能支持区间最小查询(RMQ)吗?
A:标准 BIT 不能支持 RMQ,因为最小值运算没有「逆运算」(无法像减法那样「撤销」一次最小合并)。区间最小/最大需要用线段树或稀疏表。有一种「静态 BIT RMQ」技术,但只在无更新情况下有效,实际用处有限。
Q3:BIT 能做二维(2D BIT)吗?
A:可以!二维 BIT 解决二维前缀和 + 单点更新问题,复杂度 O(log N × log M)。代码结构使用两层嵌套循环:
// 二维 BIT 更新 void update2D(int x, int y, long long v) { for (int i = x; i <= N; i += lowbit(i)) for (int j = y; j <= M; j += lowbit(j)) bit[i][j] += v; }USACO 中不常见,但偶尔会在二维坐标计数题中用到。

5.8.15 练习题
🟢 简单一:区间求和(单点更新) 给定长度为 N 的数组,支持两种操作:
1 i x:A[i] 加 x2 l r:查询 A[l] + A[l+1] + ... + A[r]
提示: BIT 的直接应用。用 update(i, x) 和 query(r) - query(l-1)。
🟢 简单二:小于 K 的元素个数 给定 N 次操作,每次要么插入一个整数(范围 1..10^6),要么查询「当前已插入的整数中有多少个 ≤ K?」
提示: BIT 维护值域上的频率数组。update(v, 1) 插入值 v,query(K) 是答案。
🟡 中等一:区间加法,单点查询 给定长度为 N 的数组(初始全零),支持两种操作:
1 l r x:给 A[l..r] 的每个元素加 x2 i:查询 A[i] 的当前值
提示: 使用差分 BIT(第 5.8.6 节)。
🟡 中等二:逆序对计数(含坐标压缩) 给定长度为 N 的数组,元素范围 1..10^9(可能有重复),统计逆序对数量。
提示: 先坐标压缩,再用 BIT 计数(第 5.8.11 节的变体)。注意相等元素:(i,j) 满足 i<j 且 A[i]>A[j](严格大于)才算逆序对。
🔴 困难:区间加法,区间求和(双 BIT) 给定长度为 N 的数组,支持两种操作:
1 l r x:给 A[l..r] 的每个元素加 x2 l r:查询 A[l] + ... + A[r]
提示: 用双 BIT。公式:prefix_sum(r) = B1[r] * r - B2[r],其中 B1 维护差分数组,B2 维护加权差分数组。
🟢 简单一:区间求和
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
int n, q;
long long tree[MAXN];
int lowbit(int x) { return x & (-x); }
void update(int i, long long val) { for (; i <= n; i += lowbit(i)) tree[i] += val; }
long long query(int i) { long long s=0; for (; i > 0; i -= lowbit(i)) s += tree[i]; return s; }
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
cin >> n >> q;
while (q--) {
int t; cin >> t;
if (t == 1) { int i; long long x; cin >> i >> x; update(i, x); }
else { int l, r; cin >> l >> r; cout << query(r) - query(l-1) << "\n"; }
}
}
🟡 中等一:区间加法,单点查询(差分 BIT)
核心思路:在 BIT 中维护差分数组。range_add(l,r,x) = update(l,x) + update(r+1,-x)。单点查询 = query(i)。
void range_add(int l, int r, long long x) { update(l, x); update(r+1, -x); }
long long point_query(int i) { return query(i); }
🟡 中等二:逆序对计数
// 先坐标压缩,然后对每个元素 x:
// 逆序对 += (已插入的元素数) - query(压缩后的 x)
// 然后插入 x:update(压缩后的 x, 1)
🔴 困难:区间加法,区间求和(双 BIT)
// prefix_sum(r) = (r+1)*sum(D[1..r]) - sum(i*D[i], i=1..r)
// = (r+1)*B1.query(r) - B2.query(r)
// 其中 B1 存 D[i],B2 存 i*D[i]
struct DoubleBIT {
long long B1[MAXN], B2[MAXN];
int n;
DoubleBIT(int n) : n(n) { memset(B1,0,sizeof(B1)); memset(B2,0,sizeof(B2)); }
void add(int i, long long v) {
for (int x=i; x<=n; x+=x&-x) { B1[x]+=v; B2[x]+=v*i; }
}
void range_add(int l, int r, long long v) { add(l,v); add(r+1,-v); }
long long prefix(int i) {
long long s=0; for(int x=i;x>0;x-=x&-x) s+=(i+1)*B1[x]-B2[x]; return s;
}
long long range_query(int l, int r) { return prefix(r)-prefix(l-1); }
};
第 5.9 章:最小生成树
5.9.0 从一道题出发:修路问题
先看一道典型的 Gold 风格题目:
🌾 题目:光纤铺设 农夫 John 的农场有
N个谷仓(N ≤ 10⁵)。他要铺设光纤网络,使任意两个谷仓都能互相通信(可以经其他谷仓中转)。 可以直接连接谷仓u和v的方案有E种,每种有一个成本w。 问:最少花多少钱,能让所有谷仓连通?
输入样例:
N=4, E=5
边:(1,2,4) (1,3,2) (2,3,5) (2,4,3) (3,4,1)
先试试你会的方法
思路 1:每条边都修? 全修当然连通,成本 4+2+5+3+1 = 15。但明显浪费——谷仓 1 和 3 之间已经有路,何必再修 1-2、2-3 这条更贵的绕路?
思路 2:贪心地从最便宜的边修起? 先修 (3,4,1),再修 (1,3,2),再修 (2,4,3)——此时四个谷仓已经全部连通,剩下两条边不需要。成本 1+2+3 = 6。
等等,「从便宜到贵逐条加边,加到全连通为止」——这个朴素的直觉恰好就是正确的算法(Kruskal)。但它为什么对?会不会有某种情况,先修一条贵边反而更划算?
拆解这道题需要回答的问题
- 「所有点连通且无环」的边集在图论中叫什么?为什么恰好 N−1 条边?→ 生成树
- 「按权从小到大加边,不成环才加」为什么正确?→ 割边性质
- 判断「加这条边会不会成环」需要什么工具?→ 第 5.6 章的并查集
- 除了从小到大加边,还有别的等价做法吗?→ Prim 算法(从点出发扩张)
- USACO 会怎么包装这道题?→ 5.9.6 节的题型模式
本章按这条线逐一展开:
| 小节 | 回答的问题 |
|---|---|
| 5.9.0 | 生成树的定义与「恰好 N−1 条边」 |
| 5.9.1 | 贪心为什么对:割边/环性质 |
| 5.9.2 | Kruskal 算法 + 完整代码 |
| 5.9.3 | Prim 算法(另一种扩张视角) |
| 5.9.5 | Kruskal 重构树(Gold 高频进阶) |
学习目标:
- 理解什么是生成树,以及 MST 的用途
- 用 DSU 实现 Kruskal 算法,时间复杂度 O(E log E)
- 用优先队列实现 Prim 算法,时间复杂度 O(E log V)
- 识别 USACO 中的 MST 问题,并运用割边性质与环性质
5.9.0b 什么是生成树?
对于一个有 N 个顶点和 E 条边的连通图,生成树是满足以下条件的边的子集:
- 连通所有 N 个顶点
- 恰好使用 N−1 条边
- 不包含环
一个图可以有许多生成树。最小生成树是边权之和最小的那棵。
图: 某棵生成树: MST:
1 1 1
/ \ / \ / \
2 3 边权: 2 3 2 3
|\ /| 1-2: 4 | |
| X | 1-3: 2 4 4
|/ \| 2-3: 5 总权=4+2+3=9 总权=4+2+1=7 ← 最小
4 5 2-4: 3
3-4: 1
4-5: 6
💡 为什么恰好是 N−1 条边? N 个节点的树恰好有 N−1 条边。少了则不连通;多了则有环。
5.9.1 割边性质与环性质
这两个基本性质是 MST 算法正确性的理论基础:
割边性质(Cut Property): 对图的任意划分(将顶点分为两组 S 和 V−S),连接两组的最小权重边一定属于某棵 MST。
环性质(Cycle Property): 对图中任意一个环,环上最大权重的边一定不属于任何 MST(权重有并列时除外)。
这两个性质同时证明了 Kruskal 算法和 Prim 算法的正确性。
5.9.2 Kruskal 算法
核心思想: 将所有边按权重排序,贪心地加入不构成环的最便宜边。用 DSU 以 O(α(N)) ≈ O(1) 的时间检测是否成环。
算法流程:
- 将所有边按权重从小到大排序
- 用 N 个分量初始化 DSU(每个顶点自成一组)
- 对每条边 (u, v, w)(按排序顺序):
- 若
find(u) ≠ find(v):将此边加入 MST,调用union(u, v) - 否则:跳过(会构成环)
- 若
- 当 MST 包含 N−1 条边时停止
#include <bits/stdc++.h>
using namespace std;
// ── 并查集(DSU)──────────────────────────────────
struct DSU {
vector<int> parent, rank_;
int components;
DSU(int n) : parent(n), rank_(n, 0), components(n) {
iota(parent.begin(), parent.end(), 0); // parent[i] = i
}
int find(int x) {
if (parent[x] != x)
parent[x] = find(parent[x]); // 路径压缩
return parent[x];
}
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false; // 已在同一分量中
if (rank_[x] < rank_[y]) swap(x, y);
parent[y] = x; // 将秩小的挂到秩大的下面
if (rank_[x] == rank_[y]) rank_[x]++;
components--;
return true;
}
bool connected(int x, int y) { return find(x) == find(y); }
};
// ── Kruskal MST ────────────────────────────────────
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m; // n 个顶点,m 条边
// edges[i] = {权重, u, v}
vector<tuple<int,int,int>> edges(m);
for (auto& [w, u, v] : edges) {
cin >> u >> v >> w;
u--; v--; // 0-indexed
}
sort(edges.begin(), edges.end()); // 按权重排序(第一个元素)
DSU dsu(n);
long long mst_weight = 0;
int edges_added = 0;
vector<pair<int,int>> mst_edges;
for (auto& [w, u, v] : edges) {
if (dsu.unite(u, v)) { // 仅在不构成环时加边
mst_weight += w;
mst_edges.push_back({u, v});
edges_added++;
if (edges_added == n - 1) break; // MST 构建完成
}
}
if (edges_added < n - 1) {
cout << "图不连通——MST 不存在\n";
} else {
cout << "MST 权重:" << mst_weight << "\n";
}
return 0;
}
复杂度: 排序 O(E log E) + DSU 操作 O(E · α(N)) ≈ O(E log E)。
Kruskal 算法追踪示例
顶点:4 个(0, 1, 2, 3)
边(已排序):(0,1,1)、(1,2,2)、(2,3,3)、(0,2,5)、(1,3,6)
第 1 步:边 (0,1,w=1) → find(0)=0 ≠ find(1)=1 → 加入 DSU: {0,1},{2},{3}
第 2 步:边 (1,2,w=2) → find(1)=0 ≠ find(2)=2 → 加入 DSU: {0,1,2},{3}
第 3 步:边 (2,3,w=3) → find(2)=0 ≠ find(3)=3 → 加入 DSU: {0,1,2,3}
edges_added = 3 = n-1 → 完成
MST 权重 = 1 + 2 + 3 = 6
5.9.3 Prim 算法
核心思想: 从一个起始顶点出发逐步扩张 MST。每一步,加入将 MST 内某顶点与 MST 外某顶点相连的最小权重边。用小根堆(优先队列)高效选取最便宜的边。
Prim vs Kruskal 的选择: 对于稠密图(E ≈ V²),Prim 算法更优——邻接表 + 堆的实现为 O(E log V),而 Kruskal 需要排序 E 条边,复杂度为 O(E log E)。在稠密图上 E log V < E log E,但在竞赛实践中两者通常都能满足约束。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
// 邻接表:adj[u] = {边权, 邻居} 的列表
vector<vector<pair<int,int>>> adj(n);
for (int i = 0; i < m; i++) {
int u, v, w;
cin >> u >> v >> w;
u--; v--;
adj[u].push_back({w, v});
adj[v].push_back({w, u}); // 无向图
}
// 用小根堆实现 Prim
vector<bool> in_mst(n, false);
long long mst_weight = 0;
int edges_added = 0;
// 小根堆:{边权, 顶点}
priority_queue<pair<int,int>, vector<pair<int,int>>, greater<>> pq;
pq.push({0, 0}); // 从顶点 0 出发,代价 0
while (!pq.empty() && edges_added < n) {
auto [w, u] = pq.top(); pq.pop();
if (in_mst[u]) continue; // 已加入 MST,跳过(懒惰删除)
in_mst[u] = true;
mst_weight += w;
edges_added++;
for (auto [edge_w, v] : adj[u]) {
if (!in_mst[v]) {
pq.push({edge_w, v}); // 候选扩展边
}
}
}
if (edges_added < n) {
cout << "图不连通\n";
} else {
cout << "MST 权重:" << mst_weight << "\n";
}
return 0;
}
复杂度: 用二叉堆时为 O(E log V)。
5.9.4 MST 性质在解题中的应用
除了直接计算 MST,以下几个性质在 USACO 中非常实用:
性质 1:唯一性
若所有边权互不相同,则 MST 唯一。若存在相同边权,可能有多棵总权重相等的 MST。
性质 2:瓶颈生成树
MST 最小化了任意两顶点之间路径上的最大边权。即:MST 上 u 到 v 的路径具有最小可能的"瓶颈"边。
💡 USACO 应用: "u 到 v 路径上最大边权的最小值是多少?"→ 答案是 MST 上 u 到 v 路径中的最大边权。
性质 3:MST 作为贪心框架
很多 USACO Gold 题目可以归结为带有变形的 Kruskal 算法:
- 按某种代价对"连接"排序
- 贪心合并各组,只要合并合法
- DSU 追踪哪些组已连通
非标准"边"上的 Kruskal 算法
经典 USACO 模式:边不是显式给出的——你需要自己分析排序的依据和"合并"的含义。
示例模式(USACO 2016 February Gold — Fencing the Cows):
- 奶牛分布在各个牧场中;连接两头奶牛有代价
- 目标:以最小总代价将所有奶牛连通
- 解法:建图后运行 Kruskal 算法
5.9.5 Kruskal 重构树
Kruskal 重构树(Kruskal 树)是在 Kruskal 算法过程中构建的一种强大结构,它编码了连通分量的"合并历史"。
构建方法: 当 Kruskal 算法通过权重为 w 的边合并包含 u 和 v 的分量时:
- 创建一个新节点 x,值为 w
- 将 u 所在分量和 v 所在分量的根分别设为 x 的子节点
- 用 x 替代这两个分量成为新的根
构建完毕后,该树具有以下结构:
- N 个叶节点(原始顶点)
- N-1 个内部节点(每条 MST 边对应一个,值 = 边权)
- 共 2N-1 个节点
📄 Code 完整代码
示例 MST 边(已排序):(0,1,w=1)、(1,2,w=2)、(2,3,w=3)
合并 (0,1,w=1) 后: 节点 4(w=1)
/ \
0 1
合并 (1,2,w=2) 后: 节点 5(w=2)
/ \
节点4 2
(w=1)
/ \
0 1
合并 (2,3,w=3) 后: 节点 6(w=3)
/ \
节点5 3
(w=2)
/ \
节点4 2
(w=1)
/ \
0 1
关键性质:LCA 即瓶颈边
Kruskal 树中 u 和 v 的 LCA 的值 = MST 上 u 到 v 路径中最大边权 = u 和 v 之间最小可能瓶颈。
这意味着:
- 查询"u 和 v 之间的最小瓶颈"→ 在 Kruskal 树中求 LCA
- 查询"使 u 和 v 连通的最小边权是多少?"→ 同上
#include <bits/stdc++.h>
using namespace std;
struct DSU {
vector<int> parent, rank_, root; // root[i] = 以 i 为根的分量在 Kruskal 树中的根节点
DSU(int n) : parent(n), rank_(n, 0), root(n) {
iota(parent.begin(), parent.end(), 0);
iota(root.begin(), root.end(), 0);
}
int find(int x) {
return parent[x] == x ? x : parent[x] = find(parent[x]);
}
// 返回此次合并创建的新 Kruskal 树节点
int unite(int x, int y, int new_node) {
x = find(x); y = find(y);
if (x == y) return -1;
if (rank_[x] < rank_[y]) swap(x, y);
parent[y] = x;
if (rank_[x] == rank_[y]) rank_[x]++;
root[x] = new_node; // 新 Kruskal 树节点成为合并后分量的根
return new_node;
}
int get_root(int x) { return root[find(x)]; }
};
// 构建 Kruskal 重构树
// 返回:Kruskal 树的邻接表和节点值
// 叶节点 0..n-1 为原始顶点;节点 n..2n-2 为内部节点(MST 边)
void build_kruskal_tree(
int n,
vector<tuple<int,int,int>>& edges, // {权重, u, v}——必须已排序
vector<vector<int>>& ktree, // ktree[node] = Kruskal 树中的子节点
vector<int>& node_val // node_val[node] = 边权(内部节点)或 0(叶节点)
) {
ktree.assign(2 * n, {});
node_val.assign(2 * n, 0);
DSU dsu(n);
int next_node = n; // 下一个内部节点的 ID
for (auto [w, u, v] : edges) {
int ru = dsu.find(u), rv = dsu.find(v);
if (ru == rv) continue; // 同一分量,跳过
// 创建新内部节点
int x = next_node++;
node_val[x] = w;
// 添加子节点:u 和 v 所在分量的 Kruskal 树根
ktree[x].push_back(dsu.get_root(u));
ktree[x].push_back(dsu.get_root(v));
dsu.unite(u, v, x);
}
}
// 构建完毕后,在 ktree 上用倍增 LCA 回答瓶颈查询
// ktree 中的 lca(u, v) 即为 MST 上 u 和 v 之间的瓶颈边权
USACO Gold 应用
题型:"对于每个查询 (u, v, k),统计从 u 出发仅使用权重 ≤ k 的边可以到达的顶点数"
在 Kruskal 树中,阈值 k 下以某个 LCA 为根的子树,恰好包含当只允许使用权重 ≤ node_val[LCA] 的边时,从 u 可以到达的所有顶点。
// 查询:仅使用权重 <= threshold 的边时,
// 与 u 在同一连通分量中的顶点数是多少?
// → 在 Kruskal 树中找 u 的最深祖先 x,满足 node_val[x] <= threshold
// → 答案 = sz[x](子树大小,计算的是叶节点数 = 原始顶点数)
💡 原因: Kruskal 树精确记录了边的合并顺序。内部节点 x 的子树包含了在权重为
node_val[x]的边加入时同属一个连通分量的所有顶点。
5.9.6 USACO Gold 题型模式
模式 1:直接求 MST
"以最小总连接代价连通所有 N 个节点。"
直接应用 Kruskal 或 Prim 算法。
模式 2:排序 + DSU(Kruskal 式贪心)
"按某种顺序处理事件/对;合并分组;查询连通性。"
这本质是 Kruskal 算法,只是没有明确称其为 MST。核心思路:按某种标准排序,再用 DSU 合并。
// 模板:Kruskal 式贪心
sort(events.begin(), events.end(), comparator);
DSU dsu(n);
for (auto& event : events) {
if (dsu.unite(event.u, event.v)) {
// 处理合并操作
}
}
模式 3:MST + 附加查询
"求 MST,然后对 MST 上的路径回答查询。"
构建 MST,再由 MST 的边构造出一棵树,最后回答路径查询(通常与第 5.13 章的欧拉游览结合使用)。
💡 思路陷阱
陷阱 1:把"最小瓶颈路"误当"最短路"
错误判断: "求 u 到 v 路径上最大边权的最小值,用 Dijkstra 最短路"
实际情况: 最短路最小化边权之和;最小瓶颈路最小化路径上的最大边 — 这是 MST 问题
图:u→A(w=1), u→B(w=5), A→v(w=10), B→v(w=6)
Dijkstra 最短路(u→v):u→A→v,总权=11,最大边=10
MST 瓶颈路(u→v): u→B→v,总权=11,最大边=6 ← 最小瓶颈
关键:最小瓶颈路 = MST 上 u→v 的路径(由割边性质保证)
识别信号: 题目要求"最小化路径上的最大/最重边" → MST + 树上路径,而非 Dijkstra
陷阱 2:贪心合并时忘记"Kruskal 视角"
错误判断: "按某种顺序处理操作,感觉像贪心,写个模拟"
实际情况: 操作可以排序 + 用 DSU 合并 → 本质是 Kruskal 的变体
典型题:N 个集合,每次可以合并代价最小的两个集合(权重 = 两集合大小之积)
错误:模拟优先队列,每次弹出最小的两个合并 → 复杂度 O(N² log N)
正确:认识到"按代价排序 + DSU 合并"就是 Kruskal-style greedy → O(N log N)
识别信号: "处理 N 个对象,按某种代价合并,最终连通" → 先想 Kruskal 框架
⚠️ 常见错误
-
忘记判断连通性: 不是所有图都连通。Kruskal 结束后,验证
edges_added == n - 1;Prim 结束后,验证edges_added == n。 -
DSU 实现有误(未路径压缩或未按秩合并): 朴素 DSU 不加优化时每次操作 O(N),导致 Kruskal 整体为 O(E·N) 而非 O(E log E)。
-
边数差一: MST 有 N−1 条边。若停在 N 条边,则多加了一条。
-
将 Kruskal 用于有向图: 两种算法都假设无向边。有向图需要不同方法(最小树形图 / 朱-刘/Edmonds 算法——USACO Gold 不考)。
-
整数溢出: 若边权最大 10⁹ 且 N = 10⁵,MST 总权重可达约 10¹⁴。请使用
long long。
📋 章节小结
📌 核心要点
| 概念 | 说明 |
|---|---|
| MST 定义 | N−1 条边连通所有 N 个顶点,总权重最小 |
| Kruskal 算法 | 排序边,贪心加入不构成环的边(DSU);O(E log E) |
| Prim 算法 | 从源点出发用小根堆扩张;O(E log V) |
| 割边性质 | 任意割的最小边一定在所有 MST 中 |
| 环性质 | 任意环的最大边不在任何 MST 中 |
| 瓶颈路径 | MST 路径最小化了任意两顶点间的最大边 |
| USACO 题型 | 排序 + DSU 就是伪装后的 Kruskal——要认出来! |
❓ 常见问题
Q:Kruskal 和 Prim 各适用什么场景?
A:竞赛中几乎总是优先选 Kruskal + DSU——实现更简洁,对稀疏图(USACO 的典型场景)效果好。只有在 E ≈ V² 的稠密图时才考虑 Prim。
Q:对所有边权加同一个常数,MST 会变吗?
A:不会——给所有边加常数不改变 MST 包含哪些边(只影响总权重)。
Q:一个图能有多棵 MST 吗?
A:可以,当存在相等边权时。但 MST 的总权重(总和)始终唯一。
Q:图不连通怎么办?
A:此时不存在生成树(无法连通所有顶点)。改为计算最小生成森林——每个连通分量各自的 MST。
Q:我的 Kruskal 在 USACO 评测机上答案错误——哪里出问题了?
A:检查:① 顶点编号是 1-indexed 还是 0-indexed 是否一致?② DSU 的路径压缩是否正确?③ 总权重是否使用了 long long?
🔗 与后续章节的联系
- 第 6.8 章(树形 DP): 构建 MST 后它就是一棵树,可以在 MST 上做树形 DP 来回答路径查询。
- 第 5.13 章(欧拉游览): 欧拉游览可以在 MST 树结构上支持区间查询。
- 第 5.3 节(DSU): Kruskal 算法大量依赖 DSU,请准备好第 5.3 节中带路径压缩的 DSU 模板。
🏋️ 练习题
🟢 简单
5.9-E1. 经典 MST
给定 N 个城市和 M 条有权道路,求连通所有城市的最小总权重。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵,1 ≤ w ≤ 10⁹(总权重需 long long)。
(标准 Kruskal——热身题)
提示
按权重排序边,用 DSU 应用 Kruskal 算法。输出 MST 的边权之和。
#include <bits/stdc++.h>
using namespace std;
// ...(使用 5.9.2 中的 Kruskal 模板)
5.9-E2. 是否连通?
给定 N 个节点和 M 条边,判断图是否连通。若连通,输出 MST 权重;若不连通,输出连通分量的数量。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵,1 ≤ w ≤ 10⁹。
提示
Kruskal 算法结束后,检查 edges_added == n - 1。若不满足,图不连通。连通分量的数量为 dsu.components。
🟡 中等
5.9-M1. 最小瓶颈路径 (USACO 风格)
给定 N 个节点、M 条有权边以及 Q 个查询 (u, v),对每个查询求从 u 到 v 的任意路径上最大边权的最小值。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵,1 ≤ Q ≤ 1000,1 ≤ w ≤ 10⁹,保证图连通。
提示
核心思路:查询 (u, v) 的答案就是 MST 上 u 到 v 路径中的最大边权。
构建 MST。对每个查询,在 MST 树上找路径并返回最大边。(朴素:对每个查询做 DFS/BFS,O(N·Q)。高效:LCA + 倍增,见第 5.13 章。)
竞赛中,若 Q ≤ 1000,朴素的 O(N·Q) 方案通常能通过。
5.9-M2. Kruskal 式贪心 (USACO 2016 February Gold — Fencing the Cows)
N 头奶牛,每头在某个牧场中。在牧场 i 和 j 之间移动一头奶牛的代价为 |i - j|。用最小总代价将所有牧场连成一组。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ 牧场坐标 ≤ 10⁹。
提示
这本质是在完全图上求 MST,但排序所有 O(N²) 条边太慢。核心观察:对于数轴上的点,MST 始终只使用相邻边!将奶牛按位置排序,只在相邻牧场之间添加边。
🔴 困难
5.9-H1. 动态连通性 (进阶)
给定 N 个节点,处理 Q 次操作:"添加边 (u,v,w)"或"查询:到目前为止所有已添加边的 MST 权重是多少?"
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ Q ≤ 2×10⁵,1 ≤ w ≤ 10⁹。
提示
维护一个有序的边集合,增量运行 Kruskal 算法。当新增边 (u,v,w) 时:若 u 和 v 在当前 MST 中已连通,只有当 w 小于 MST 路径上的最大边权时,才用新边替换。
这需要找到树上路径中的最大边——使用欧拉游览 + 线段树,或倍增。
🏆 挑战
5.9-C1. Steiner 树(近似)
给定一个图和一组"必选"顶点集合 S,求连通 S 中所有顶点的最小权重子树(Steiner 树问题)。当 |S| ≤ 15 时,用状压 DP 精确求解。
数据规模: 1 ≤ N ≤ 500,1 ≤ M ≤ 2000,1 ≤ |S| ≤ 15,1 ≤ w ≤ 10⁶。
提示
这不是 MST 问题——而是状压 DP 与最短路的结合。定义 dp[mask][v] = 以顶点 v 为节点、生成 mask 中所有顶点的最小代价树。
第 5.10 章:拓扑排序与 DAG DP
5.10.0 从一道题出发:挤奶顺序
先看一道简化自 USACO 2019 Feb Silver「Cow Lineup」的题:
🐄 题目:挤奶顺序 有
N头奶牛(N ≤ 10⁵)要依次通过挤奶门,编号 1..N。 农夫 John 给出M条顺序约束:奶牛a必须排在奶牛b前面。 请给出一 个合法的排队顺序;若不存在(约束互相矛盾),输出-1。 附加问:若还要让字典序最小的合法顺序,怎么排?
样例:
N=5, M=4
约束:1 在 3 前、3 在 2 前、1 在 4 前、4 在 5 前
合法顺序之一:1, 3, 2, 4, 5
先试试你会的方法
思路 1:直接排序? 约束不是「编号小的在前」,而是任意的先后关系——普通排序无从下手。
思路 2:逐个约束检查、反复调整? 每次发现冲突就交换两头牛——但一次交换可能破坏其他约束,可能反复震荡,而且怎么知道「根本无解」(比如 1 要在 2 前、2 要在 3 前、3 又要在 1 前)?
关键观察: 每条约束 a 在 b 前 就是一条有向边 a → b。5 头牛 4 条边构成一张图。问题变成:能否把所有顶点排成一条线,使每条边的起点都排在终点前面?
这就是拓扑排序。而「无解」恰好对应「图里有环」——环意味着 A 等B、B 等C、C 又等 A,死锁。
拆解这道题需要回答的问题
- 「没有环的有向图」有什么特殊性质?→ DAG 与拓扑序的存在性
- 怎么高效地排出拓扑序?→ Kahn 算法(反复拿走「没有前置」的点,即入度为 0 的点)
- 「约束矛盾」怎么自动检测?→ 拿不满 N 个点 = 有环
- 排好序之后还能干什么?→ 在 DAG 上跑 DP(最长路径、路径计数)
- 如果图有环呢?环上的点可以互相到达,需要缩点成 SCC 后再拓扑排序
本章按这条线展开:
| 小节 | 回答的问题 |
|---|---|
| 5.10.0 | DAG 与拓扑序的定义 |
| 5.10.1 | Kahn 算法(同时检测无解) |
| 5.10.2 | DFS 实现拓扑排序 |
| 5.10.3–5.10.4 | 拓扑序上的 DP 与 USACO 题型 |
| 5.10.5–5.10.7 | 有环怎么办:SCC、缩点、差分约束、2-SAT |
学习目标:
- 用 Kahn 算法(BFS)和 DFS 实现拓扑排序
- 检测有向图中的环
- 在 DAG 上应用 DP:最长路径、路径计数、关键路径分析
- 用 Tarjan 或 Kosaraju 算法求强连通分量(SCC)
- 构建缩点 DAG,并在一般有向图上做 DAG DP
- 将 2-SAT 问题规约为 SCC 问题求解
- 识别"在约束下排序"的问题本质是拓扑排序
5.10.0b 什么是 DAG?
有向无环图的边有方向且不含环:
DAG(合法): 不是 DAG(含环):
A → B → D A → B
↓ ↓ ↑ ↓
C ──────►E D ← C
DAG 在以下场景中自然出现:
- 先修课程: 课程 A 必须在课程 B 之前修
- 构建系统: 模块 A 必须在模块 B 之前编译
- 状态机: 谜题状态,不能返回之前的状态
- 任务调度: 事件 A 必须在事件 B 之前发生
DAG 的核心操作是拓扑排序:将所有顶点排成一条线,使得对于每条有向边 (u → v),u 都出现在 v 之前。
DAG: 合法的拓扑序:
A → B → D A, C, B, D, E
↓ ↑ A, B, C, D, E
C ──────► (可能存在多个合法排序)
5.10.1 Kahn 算法(BFS 拓扑排序)
核心思想: 反复移除入度为 0(没有前置依赖)的顶点。移除一个顶点后,其后继顶点的入度各减 1;任何入度降至 0 的顶点加入队列。
#include <bits/stdc++.h>
using namespace std;
// 返回拓扑序,若检测到环则返回空 vector
vector<int> topoSort(int n, vector<vector<int>>& adj) {
// 第 1 步:计算入度
vector<int> indegree(n, 0);
for (int u = 0; u < n; u++)
for (int v : adj[u])
indegree[v]++;
// 第 2 步:将所有源点(入度为 0 的顶点)加入队列
queue<int> q;
for (int i = 0; i < n; i++)
if (indegree[i] == 0)
q.push(i);
vector<int> order;
while (!q.empty()) {
int u = q.front(); q.pop();
order.push_back(u);
for (int v : adj[u]) {
indegree[v]--; // 删除边 u → v
if (indegree[v] == 0) // v 的最后一个前置完成
q.push(v);
}
}
// 若输出不包含所有顶点,说明有环
if ((int)order.size() != n) return {}; // 检测到环
return order;
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<vector<int>> adj(n);
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
u--; v--;
adj[u].push_back(v);
}
vector<int> order = topoSort(n, adj);
if (order.empty()) {
cout << "检测到环——不存在拓扑序\n";
} else {
for (int v : order) cout << v + 1 << " ";
cout << "\n";
}
return 0;
}
复杂度: O(V + E)
💡 环检测: 若 Kahn 算法的输出顶点数少于 N,则存在环。那些"卡住"的顶点(入度始终无法降至 0 的)就是环的组成部分。
Kahn 算法追踪示例
📄 查看代码:Kahn 算法追踪示例
图:0→1, 0→2, 1→3, 2→3, 3→4
初始入度:[0, 1, 1, 2, 1]
队列:[0]
弹出 0 → order=[0],入度 1→0, 2→0
队列:[1, 2]
弹出 1 → order=[0,1],入度 3→1
弹出 2 → order=[0,1,2],入度 3→0
队列:[3]
弹出 3 → order=[0,1,2,3],入度 4→0
队列:[4]
弹出 4 → order=[0,1,2,3,4]
5 个顶点全部处理完 → 合法的拓扑序!
5.10.2 基于 DFS 的拓扑排序
另一种方法:DFS 按完成时间的逆序输出结果。
#include <bits/stdc++.h>
using namespace std;
vector<int> adj_list[100001];
vector<int> topo_order;
int color[100001]; // 0=白色(未访问), 1=灰色(栈中), 2=黑色(已完成)
bool has_cycle = false;
void dfs(int u) {
color[u] = 1; // 标记为"处理中"
for (int v : adj_list[u]) {
if (color[v] == 1) {
has_cycle = true; // 后向边 → 有环!
return;
}
if (color[v] == 0)
dfs(v);
}
color[u] = 2; // 标记为"已完成"
topo_order.push_back(u); // 完成子树后再加入结果
}
int main() {
int n, m;
cin >> n >> m;
// ... 读取边 ...
for (int i = 0; i < n; i++)
if (color[i] == 0)
dfs(i);
reverse(topo_order.begin(), topo_order.end()); // ← 关键:反转完成顺序
// topo_order 现在是合法的拓扑序
}
为什么要反转完成顺序? DFS 中,一个顶点完成(加入结果)的时间晚于其所有可达顶点完成的时间。因此 DFS 中较晚完成的顶点应排在最前面;取反转后即得拓扑序。
⚠️ Kahn vs DFS: 两者都有效。Kahn 更直观,且能自然地通过计数检测环。DFS 版对于递归实现有时更简洁。
5.10.3 DAG 上的 DP
一旦得到拓扑序,就可以高效地在 DAG 上运行 DP:按拓扑序处理顶点,根据前驱顶点的状态更新每个顶点的状态。
核心思路: 按拓扑序处理顶点 v 时,v 的所有前驱都已处理完毕。因此可以用 dp[前驱] 来计算 dp[v]。
DAG 中的最长路径
// 到达每个顶点的最长路径
vector<int> dp(n, 0); // dp[v] = 到达 v 的最长路径
// 按拓扑序处理
for (int u : topo_order) {
for (int v : adj[u]) {
dp[v] = max(dp[v], dp[u] + edge_weight[u][v]);
// ↑ 当前最优 ↑ 通过 u→v 延伸路径
}
}
int ans = *max_element(dp.begin(), dp.end());
从源点到各顶点的路径计数
vector<long long> cnt(n, 0);
cnt[source] = 1; // 到达源点的方案数为 1
for (int u : topo_order) {
for (int v : adj[u]) {
cnt[v] += cnt[u]; // 加上到达 u 的所有路径,经 u→v 延伸
cnt[v] %= MOD; // 若需要取模
}
}
// cnt[t] = 从 source 到 t 的路径数
USACO 风格示例:关键路径(最早完成时间)
任务 1..N,各有执行时长。任务 v 在所有前置任务完成后才能开始。求每个任务最早的开始时间。
// earliest_start[v] = max(earliest_start[u] + duration[u]) 对所有前驱 u 取最大
vector<int> earliest(n, 0);
for (int u : topo_order) {
for (int v : adj[u]) {
earliest[v] = max(earliest[v], earliest[u] + duration[u]);
}
}
// 项目总完成时间 = max(earliest[v] + duration[v]) 对所有 v
int finish_time = 0;
for (int v = 0; v < n; v++)
finish_time = max(finish_time, earliest[v] + duration[v]);
5.10.4 DAG DP 在 USACO Gold 中的题型模式
模式 1:将状态转移视为 DAG
很多 DP 问题可以可视化为 DAG:
- 顶点 = DP 状态
- 边 = 状态之间的转移
- DAG 性质 = 转移只向"前方"进行(无环)
认识到这一点,可以将 DP 递推式转化为显式图问题。
模式 2:排序/调度
"N 个任务有先后依赖关系(任务 A 必须在任务 B 之前完成)。求调度顺序 / 最少执行阶段数 / 关键路径。"
直接应用拓扑排序 + DAG DP。
模式 3:带约束的路径计数
"在给定约束(选择 B 不能跟在选择 A 之后)下,有多少种合法的选择序列?"
将选择建模为顶点,约束建模为有向边(A → B 表示"A 后面接 B 不合法"),然后在结果 DAG 中计路径数。
模式 4:DAG 中的最短/最长路径
DAG 的最短路可以用拓扑排序 + DP 在 O(V+E) 内解决——比 Dijkstra 的 O(E log V) 更快。若图无负边且同时是 DAG,优先选这种方法。
// DAG 中从源点 s 出发的最短路(支持负权!)
vector<int> dist(n, INT_MAX);
dist[s] = 0;
for (int u : topo_order) {
if (dist[u] == INT_MAX) continue;
for (auto [v, w] : adj[u]) {
dist[v] = min(dist[v], dist[u] + w);
}
}
5.10.5 强连通分量(SCC)
有向图的**强连通分量(SCC)**是顶点的极大子集,子集内任意两个顶点互相可达。
示例:
0 → 1 → 2
↑ ↓ ↓
└── 3 4
SCC:{0, 1, 3}、{2}、{4}
- 0→1→3→0:互相可达 → 同一个 SCC
- 2 可从 SCC{0,1,3} 到达,但无法返回 → 独立的 SCC
- 4 同理孤立
SCC 在 USACO Gold 中的意义:
- 缩点 DAG: 将每个 SCC 收缩为单个节点后,结果必然是 DAG。这使得可以在有环图上做 DAG DP。
- 2-SAT: 每子句含 2 个字面量的布尔可满足性问题可以规约为 SCC。
- 可达性查询: "u 能到达 v 吗?" → 判断它们是否在同一 SCC,或 SCC(u) 是否在缩点 DAG 中可达 SCC(v)。
Tarjan SCC 算法
核心思想: 一次 DFS,维护一个栈和两个数组:
disc[v]:v 的 DFS 发现时间low[v]:从 v 的子树出发,经过至多一条"后向边"可达的最小发现时间
当 low[v] == disc[v] 时,v 是某个 SCC 的根——弹出栈中直到 v 为止的所有顶点。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
int disc[MAXN], low[MAXN], timer_val = 0;
bool on_stack[MAXN];
stack<int> stk;
int scc_id[MAXN]; // 每个顶点属于哪个 SCC?
int scc_count = 0;
void dfs(int u) {
disc[u] = low[u] = ++timer_val;
stk.push(u);
on_stack[u] = true;
for (int v : adj[u]) {
if (disc[v] == 0) { // 树边:v 未访问
dfs(v);
low[u] = min(low[u], low[v]);
} else if (on_stack[v]) { // 后向边,属于当前 SCC
low[u] = min(low[u], disc[v]);
}
// 交叉边/前向边(on_stack[v]==false 且 disc[v]!=0):忽略
}
// 若 u 是某个 SCC 的根
if (low[u] == disc[u]) {
scc_count++;
while (true) {
int v = stk.top(); stk.pop();
on_stack[v] = false;
scc_id[v] = scc_count;
if (v == u) break;
}
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v; u--; v--;
adj[u].push_back(v);
}
for (int i = 0; i < n; i++)
if (disc[i] == 0)
dfs(i);
cout << "SCC 数量:" << scc_count << "\n";
for (int i = 0; i < n; i++)
cout << "顶点 " << i << " → SCC " << scc_id[i] << "\n";
return 0;
}
复杂度: O(V + E)——一次 DFS。
💡 SCC 编号说明: Tarjan 算法以缩点 DAG拓扑序的逆序给 SCC 编号。编号为 1 的 SCC 是 DAG 的汇点;编号最大的 SCC 是源点。
Kosaraju SCC 算法
核心思想: 两次 DFS。
- 第一遍: 在原图上运行 DFS,按完成时间将顶点压入栈。
- 第二遍: 在转置图(所有边反向)上,按完成时间的逆序(弹栈顺序)处理顶点。第二遍中每棵 DFS 树恰好是一个 SCC。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN]; // 原图
vector<int> radj[MAXN]; // 转置图(边反向)
bool visited[MAXN];
int scc_id[MAXN];
stack<int> finish_order;
// 第一遍:在原图上 DFS,记录完成顺序
void dfs1(int u) {
visited[u] = true;
for (int v : adj[u])
if (!visited[v])
dfs1(v);
finish_order.push(u); // 完全处理后压栈
}
// 第二遍:在转置图上 DFS,标记 SCC
void dfs2(int u, int id) {
visited[u] = true;
scc_id[u] = id;
for (int v : radj[u])
if (!visited[v])
dfs2(v, id);
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
for (int i = 0; i < m; i++) {
int u, v; cin >> u >> v; u--; v--;
adj[u].push_back(v);
radj[v].push_back(u); // 反向边
}
// 第一遍:填充 finish_order
fill(visited, visited + n, false);
for (int i = 0; i < n; i++)
if (!visited[i])
dfs1(i);
// 第二遍:在转置图上按逆完成顺序处理
fill(visited, visited + n, false);
int scc_count = 0;
while (!finish_order.empty()) {
int u = finish_order.top(); finish_order.pop();
if (!visited[u])
dfs2(u, ++scc_count);
}
cout << "SCC 数量:" << scc_count << "\n";
return 0;
}
复杂度: O(V + E)——两次 DFS。
Tarjan vs Kosaraju 对比
| Tarjan | Kosaraju | |
|---|---|---|
| DFS 次数 | 1 次 | 2 次 |
| 空间 | 栈 + 数组 | 原图 + 转置图 |
| SCC 编号顺序 | 拓扑逆序 | 拓扑正序 |
| 竞赛推荐 | 更简洁,竞赛首选 | 更易理解和调试 |
💡 USACO 中: Tarjan 更简洁,是竞赛编程的首选。Kosaraju 更易于理解和调试。
缩点 DAG + DP
找到 SCC 后,可以构建缩点 DAG,并在其上运行 DP。
// 用 Tarjan 算法找 SCC 后,构建缩点 DAG
// scc_id[v] = 顶点 v 所在的 SCC(1-indexed,拓扑逆序)
// scc_count = SCC 总数
vector<int> scc_adj[MAXN]; // 缩点 DAG 中的边
set<pair<int,int>> seen; // 避免重复边
for (int u = 0; u < n; u++) {
for (int v : adj[u]) {
if (scc_id[u] != scc_id[v]) {
// 不同 SCC 之间的边
auto e = make_pair(scc_id[u], scc_id[v]);
if (!seen.count(e)) {
seen.insert(e);
scc_adj[scc_id[u]].push_back(scc_id[v]);
}
}
}
}
// 现在 scc_adj 是 DAG——对其做 DAG DP
// 示例:缩点 DAG 按 SCC 大小加权的最长路径
vector<int> scc_size(scc_count + 1, 0);
for (int i = 0; i < n; i++) scc_size[scc_id[i]]++;
// DAG DP:dp[v] = 以 SCC v 为结尾的路径上的最大顶点数
vector<int> dp(scc_count + 1, 0);
// 按拓扑序处理(Tarjan 给出拓扑逆序,因此从 1 到 scc_count 遍历)
for (int u = 1; u <= scc_count; u++) {
dp[u] += scc_size[u];
for (int v : scc_adj[u]) {
dp[v] = max(dp[v], dp[u]);
}
}
int ans = *max_element(dp.begin() + 1, dp.end());
5.10.6 差分约束(补充内容)
差分约束系统是一组形如以下的不等式:
x_j - x_i ≤ w_{ij}
当 USACO 题目要求"给变量赋值,使所有成对差值约束满足,并找到最小/最大赋值"时,就会出现这类问题。
核心思路: 差分约束系统等价于最短路问题!
将每个约束 x_j - x_i ≤ w 转化为有向边 i → j,权重为 w。
则:
- 若约束图无负环 → 存在可行解
- 最紧的可行解由从虚源出发的最短路给出
// 求解差分约束系统
// 约束:x[b] - x[a] <= w → 添加边 a→b,权重 w
// 返回最小合法赋值(x[i] = 从虚源到 i 的最短距离)
// 若不可行(含负环)则返回空 vector
vector<long long> solve_difference_constraints(
int n, // n 个变量 x[0..n-1]
vector<tuple<int,int,int>>& constraints // {a, b, w}: x[b]-x[a]<=w
) {
// 添加虚源 s = n,添加边 s→i 权重 0(对所有 i)
// (使 x[i] >= 0 并提供公共参考点)
int s = n;
vector<tuple<int,int,int>> edges = constraints;
for (int i = 0; i < n; i++)
edges.push_back({s, i, 0}); // x[i] - x[s] <= 0 → x[i] <= 0
// 从源点 s 运行 Bellman-Ford
vector<long long> dist(n + 1, 0); // 源点距离 = 0
for (int iter = 0; iter < n; iter++) {
for (auto [u, v, w] : edges) {
if (dist[u] + w < dist[v])
dist[v] = dist[u] + w;
}
}
// 检测负环
for (auto [u, v, w] : edges) {
if (dist[u] + w < dist[v])
return {}; // 含负环 → 无可行解
}
return vector<long long>(dist.begin(), dist.begin() + n);
}
USACO 题型: "给时间/位置赋值,使 A 在 B 之后至少 D 时间发生"的问题可以直接对应差分约束。
5.10.7 2-SAT(二元可满足性问题)
2-SAT 是 Tarjan SCC 最重要的应用之一。它解决这样的问题:给 N 个布尔变量赋值(真/假),使得一组每条包含 2 个字面量的子句的合取为真。
问题形式
有 N 个布尔变量 x₁, x₂, ..., xₙ(每个可以是真或假)。给定 M 个子句,每条形如:
(xᵢ = aᵢ) OR (xⱼ = aⱼ)
其中 aᵢ, aⱼ ∈ {true, false}。
目标: 找到满足所有子句的赋值,或报告无解。
💡 USACO 伪装: "对每组选择 A 或 B。若从第 i 组选了 A,则必须从第 j 组选 B。"这就是 2-SAT!
构建蕴含图
核心转换: OR 子句 (p OR q) 等价于两条蕴含:
¬p → q (若 p 为假,则 q 必为真)
¬q → p (若 q 为假,则 p 必为真)
对每个变量 xᵢ,创建两个节点:2i(xᵢ = true)和 2i+1(xᵢ = false,即 ¬xᵢ)。
变量 xᵢ → 节点 2i (xᵢ 为 TRUE)
节点 2i+1 (xᵢ 为 FALSE,¬xᵢ)
对子句 (xᵢ = a) OR (xⱼ = b):
- 设 p =
xᵢ = a对应的节点,¬p =xᵢ = ¬a对应的节点 - 设 q =
xⱼ = b对应的节点,¬q =xⱼ = ¬b对应的节点 - 添加边:¬p → q 以及 ¬q → p
2-SAT 实现
#include <bits/stdc++.h>
using namespace std;
struct TwoSat {
int n;
vector<vector<int>> adj, radj;
vector<int> order, comp;
vector<bool> visited;
TwoSat(int n) : n(n), adj(2*n), radj(2*n), comp(2*n), visited(2*n) {}
// 添加子句:(变量 u 取值 val_u) OR (变量 v 取值 val_v)
// val = true → 使用节点 2*var
// val = false → 使用节点 2*var+1
void add_clause(int u, bool val_u, int v, bool val_v) {
// ¬(u=val_u) → (v=val_v)
adj[2*u + !val_u].push_back(2*v + val_v);
radj[2*v + val_v].push_back(2*u + !val_u);
// ¬(v=val_v) → (u=val_u)
adj[2*v + !val_v].push_back(2*u + val_u);
radj[2*u + val_u].push_back(2*v + !val_v);
}
// 强制变量 u 取值 val(添加单元子句:u=val 被强制)
// 等价于:add_clause(u, val, u, val)
// 即:要么 u=val 要么 u=val → u 必须为 val
void force(int u, bool val) {
// ¬val → val(即若 ¬val 则 val,强制 val 为真)
adj[2*u + !val].push_back(2*u + val);
radj[2*u + val].push_back(2*u + !val);
}
void dfs1(int v) {
visited[v] = true;
for (int u : adj[v])
if (!visited[u]) dfs1(u);
order.push_back(v);
}
void dfs2(int v, int c) {
comp[v] = c;
for (int u : radj[v])
if (comp[u] == -1) dfs2(u, c);
}
// 若可满足返回 true,并将解填入 result[]
bool solve(vector<bool>& result) {
// 在蕴含图上运行 Kosaraju SCC
fill(visited.begin(), visited.end(), false);
for (int v = 0; v < 2*n; v++)
if (!visited[v]) dfs1(v);
fill(comp.begin(), comp.end(), -1);
int c = 0;
for (int i = (int)order.size()-1; i >= 0; i--) {
if (comp[order[i]] == -1)
dfs2(order[i], c++);
}
result.resize(n);
for (int i = 0; i < n; i++) {
// 若 xᵢ 和 ¬xᵢ 在同一个 SCC → 矛盾 → 无解
if (comp[2*i] == comp[2*i+1]) return false;
// 选择:若 SCC(xᵢ) 的编号大于 SCC(¬xᵢ),则 xᵢ = true
// (Kosaraju 给拓扑序较后的 SCC 分配更大的编号)
result[i] = comp[2*i] > comp[2*i+1];
}
return true;
}
};
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m; // n 个变量,m 个子句
TwoSat sat(n);
for (int i = 0; i < m; i++) {
// 读取子句:(x[u] = a) OR (x[v] = b)
// 其中 u,v 为 0-indexed,a,b 为 0 或 1
int u, a, v, b;
cin >> u >> a >> v >> b;
sat.add_clause(u, a, v, b);
}
vector<bool> result;
if (sat.solve(result)) {
for (int i = 0; i < n; i++)
cout << "x[" << i << "] = " << result[i] << "\n";
} else {
cout << "不可满足\n";
}
return 0;
}
复杂度: O(N + M)——在蕴含图上运行 Kosaraju SCC。
为什么这个方法有效
核心洞见:若 xᵢ 和 ¬xᵢ 在同一个 SCC 中,则蕴含图中存在从 xᵢ 到 ¬xᵢ 的路径,以及从 ¬xᵢ 到 xᵢ 的路径。这意味着 xᵢ 强迫 ¬xᵢ,¬xᵢ 也强迫 xᵢ——产生矛盾,不存在合法赋值。
若没有变量与其否定落在同一 SCC 中,则始终可以根据拓扑序构造合法赋值。
USACO 2-SAT 题型模式
模式 1:"每组恰好选择 A 或 B"
对第 i 组:变量 xᵢ = true 表示"选 A",false 表示"选 B"
约束"若第 i 组选 A,则第 j 组必须选 B":
add_clause(i, false, j, false) // ¬(i=A) OR ¬(j=A)
模式 2:"A、B、C、D 中至多有一个为真"(n 变量的至多一个约束)
// 链式编码:若 xᵢ 为真,则 x_{i+1}..x_{n-1} 都为假
// 朴素方法:对每对 (i, j)(i < j)add_clause(i, false, j, false),O(n²) 条子句
// 链式技巧 O(n):引入辅助变量 yᵢ = "x₀..xᵢ 中至少有一个为真"
模式 3:"将 N 个元素分到 L 侧或 R 侧,有约束"
xᵢ = true → 元素 i 在左侧
xᵢ = false → 元素 i 在右侧
约束"i 和 j 不能同时在左侧":add_clause(i, false, j, false)
约束"若 j 在右侧则 i 必须在左侧":add_clause(i, true, j, true)
💡 思路陷阱
陷阱 1:把含环的有向图当 DAG 处理
错误判断: "这题有拓扑顺序,用 toposort + DP 就行了"
实际情况: 图中可能有环(SCC),直接 toposort 会漏掉部分节点
反例:有向图 A→B→C→A→D
错误:toposort 输出 [D](只有 3 个节点在环外)
正确:先用 Tarjan 找 SCC,把 {A,B,C} 缩成一个超级节点,再在缩点 DAG 上做 DP
识别信号: 题目说"有向图"但没说"无环" → 先检测环或求 SCC,再决定是否能用 toposort
陷阱 2:2-SAT 误认为是普通贪心
错误判断: "每个位置选 A 或 B,有约束,贪心从左到右扫一遍"
实际情况: 约束之间有传递性,贪心无法保证全局一致
反例:5 个组,约束如下(若选 A₁ 则必须选 B₂,若选 A₂ 则必须选 B₃...)
贪心:组 1 选 A₁ → 组 2 选 B₂ → 组 3 选 A₃ → 组 4 选 B₄ → 组 5 可能无解
2-SAT:建立完整蕴含图,SCC 分析一次性得出全局一致解
识别信号: 每个位置/元素有两种选择 + 成对约束("如果...则...")→ 考虑 2-SAT
⚠️ 常见错误
-
混淆有向图与无向图的环: 拓扑排序只适用于有向图。无向图中,任意连通分量都有生成树——不需要"环检测"。
-
DP 初始化差一: 对"从源点出发的路径计数",初始化
cnt[source] = 1,而非 0。对"最长路径",若计边数则初始化dp[v] = 0;若路径可能不存在,需正确处理 -∞。 -
忽略不可达顶点: DAG 最短路中若
dist[u] == INT_MAX,跳过该顶点——从不可达顶点出发会得到错误值。 -
大图 DFS 拓扑排序栈溢出: N = 10⁵ 且有深链时,递归 DFS 可能栈溢出。对大输入优先使用 Kahn 算法(BFS)。
-
在有环图上使用拓扑排序: Kahn 会静默返回部分排序。务必检查
order.size() == n。
📋 章节小结
📌 核心要点
| 概念 | 说明 |
|---|---|
| DAG | 无环的有向图;建模依赖/排序关系 |
| 拓扑排序 | 所有边从左指向右的线性序;O(V+E) |
| Kahn 算法 | BFS 基于入度;自然检测环 |
| DFS 拓扑排序 | DFS 完成后加入结果;最后反转 |
| 环检测 | Kahn:输出数 < N 有环;DFS:灰→灰边有环 |
| DAG DP | 按拓扑序处理;dp[v] 仅依赖 dp[前驱] |
| 最长路径 | dp[v] = max(dp[u] + 权重),对所有前驱 u |
| 路径计数 | cnt[v] = sum(cnt[u]),对所有前驱 u |
| SCC(Tarjan) | 一次 DFS;disc[]/low[]/栈;O(V+E);拓扑逆序 |
| SCC(Kosaraju) | G 和 Gᵀ 各一次 DFS;O(V+E);拓扑正序 |
| 缩点 DAG | 每个 SCC 收缩为一个节点;结果必然是 DAG |
| 2-SAT | N 个布尔变量 + 2 字面量子句;建蕴含图 → SCC;O(N+M) |
| 差分约束 | x[j]-x[i]≤w → 边 i→j;可行 = 无负环(Bellman-Ford) |
❓ 常见问题
Q:每棵树都是 DAG 吗?
A:有根树(边从父节点指向子节点)是 DAG。无根树没有方向,不适用此问题。若将树根化,则是 DAG。
Q:拓扑排序可以有多个合法序吗?
A:可以。若两个顶点之间没有依赖关系,顺序可互换。只有当 DAG 是一条简单路径(链)时,拓扑序才唯一。
Q:Dijkstra 与 DAG 最短路——分别在什么时候用?
A:若图是 DAG,用拓扑排序 + DP:O(V+E),支持负权,更简单。若图有环但无负边,用 Dijkstra:O(E log V)。若有环且有负边,用 Bellman-Ford:O(VE)。
Q:如何求"完成所有任务的最少轮次/阶段数"?
A:这就是 DAG 中的"最长路径"(关键路径)。最少阶段数 = 1 + 最长路径的长度。
🔗 与后续章节的联系
- 第 6.8 章(树形 DP): 树形 DP 是在特殊 DAG(有根树)上的 DP,本章技术直接适用。
- 第 6.3 章(进阶 DP): 状压 DP 的状态通常构成 DAG(转移只从子集到超集)。
- 第 5.2 章(BFS/DFS): 本章的两种算法都是对第 5.2 章 BFS/DFS 的扩展。
🏋️ 练习题
🟢 简单
5.10-E1. 课程表 (等价于 LeetCode 207)
N 门课程,M 个先修要求。给定先修对 (a, b),表示"必须先修 b 才能修 a",判断能否完成所有课程(即是否无环)。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ M ≤ min(N(N−1)/2, 5×10⁵)。
提示
运行 Kahn 算法。若输出包含所有 N 门课程,则无环 → 可以完成。否则有环 → 无法完成。
5.10-E2. DAG 中的最长路径
给定 N 个顶点、M 条有权有向边和源点 S,求从 S 出发的最长路径。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵,0 ≤ S < N,1 ≤ w ≤ 10⁶,保证图无环。
提示
拓扑排序,然后按拓扑序处理顶点。初始化 dp[S] = 0,dp[其他] = -∞。对每条边 u→v:dp[v] = max(dp[v], dp[u] + w)。
🟡 中等
5.10-M1. 网格路径计数 (网格 DP 作为 DAG)
在 N×M 的网格中,每步只能向右或向下走。某些格子被封锁。统计从 (1,1) 到 (N,M) 的路径总数。
数据规模: 1 ≤ N, M ≤ 2000,被封锁的格子至多 N×M 个。答案对 10⁹+7 取模。
提示
网格是 DAG(移动只向右/向下)。按行主序处理格子(已是拓扑序)。cnt[i][j] = cnt[i-1][j] + cnt[i][j-1],若 (i,j) 未被封锁。
5.10-M2. 带依赖的任务调度 (USACO 风格)
N 个任务各有执行时长,M 条依赖边。每个任务只有在其所有前置任务完成后才能开始。所有可并行的任务同时进行。求完成所有任务的最短总时间。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵,1 ≤ 时长 ≤ 10⁶,保证依赖无环。
提示
这是关键路径法(CPM)。运行 Kahn 拓扑排序。对拓扑序中的每个顶点,计算 earliest_start[v] = max(earliest_start[u] + duration[u]) 对所有前驱 u 取最大。答案 = max(earliest_start[v] + duration[v])。
🔴 困难
5.10-H1. 路径计数取模 (USACO Gold 2012 — Cow Rectangles)
给定有 N 个顶点(至多 10⁵)和 M 条边的 DAG,源点 S 到目标 T。统计 S 到 T 的路径总数对 10⁹+7 取模的结果。某些顶点被"标记";只统计经过至少一个标记顶点的路径。
提示
用容斥原理:(经过 ≥1 个标记顶点的路径数)=(所有路径数)-(不经过任何标记顶点的路径数)。对"不经过任何标记顶点"的情形,将标记顶点从图中移除后重新计数。
🏆 挑战
5.10-C1. 缩点 DAG + DP (困难)
给定可能含环的有向图。在缩点 DAG(每个 SCC 收缩为单个顶点)中,求路径上经过的最大顶点数。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵。
提示
运行 Tarjan 或 Kosaraju 求 SCC 及其大小。构建缩点 DAG。在缩点 DAG 上做最长路径 DP,每个顶点的"权值"为该 SCC 的大小。答案为 max dp[v]。
第 5.11 章:强连通分量与缩点
5.11.0 从一道题出发:受欢迎的牛
先看一道经典题(HAOI 2006,也是 USACO 常见考点「最受欢迎的奶牛」的模型):
🐄 题目:受欢迎的牛 有
N头奶牛(N ≤ 10⁴),每头牛都有一个自己崇拜的牛的列表。崇拜关系是单向的:a 崇拜 b不代表b 崇拜 a。 一头牛是「明星牛」,当且仅当其他所有牛都崇拜它(注意:明星牛可以崇拜自己,也可以崇拜别的牛)。 求明星牛的数量。
样例:
N=4, M=4
崇拜关系(有向边):1→2, 2→1, 1→3, 3→4
答案:1(只有 4 号牛被所有牛崇拜:1→2→1 环里的牛都能到 4,3 也能到 4,而 4 谁也到不了却人人能到它)
先试试你会的方法
思路 1:传递闭包(Floyd)。 「a 能到 b」就用邻接矩阵跑一遍 Floyd-Warshall,然后对每头牛检查「其他所有牛都能到它」。这是经典做法——但复杂度 O(N³),N = 10⁴ 时是 10¹² 次运算,超时。
思路 2:每个点 BFS 一遍。 O(N·(N+M)),同样是 10⁸ 以上,勉强或超时(M 大时必然超)。
关键观察: 样例中 1 和 2 互相崇拜(1→2、2→1)——1 能到的 2 都能到,2 被崇拜的 1 也被崇拜。环上的牛在「可达性」意义上完全等价!如果我们把「互相可达」的牛捏成一个整体,图的规模会大幅缩小,而且捏完之后不会再有环——这就回到了上一章学的 DAG!
「互相可达的极大子图」就是本章的主角:强连通分量(SCC)。把每个 SCC 缩成一个点(缩点),再在缩出来的 DAG 上分析,是本题也是一大批 Gold 题目的通用套路。
拆解这道题需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 5.11.1 | 什么是强连通、SCC?环里的点为什么「等价」? |
| 5.11.2 | DFS 生成树的四种边——理解 Tarjan 的钥匙 |
| 5.11.3 | Tarjan 算法:一次 DFS 求出所有 SCC |
| 5.11.4 | Kosaraju 算法:两次 DFS 的替代方案 |
| 5.11.5–5.11.6 | 缩点建 DAG,在 DAG 上做 DP,解决两道完整例题 |
学习目标:
- 理解强连通分量的定义与「等价类」视角
- 掌握 DFS 生成树中四种边的分类
- 手写 Tarjan 算法:dfn/low 数组、栈、dfn == low 判定
- 了解 Kosaraju 算法并能对比选择
- 掌握缩点建图,理解「Tarjan 的 SCC 编号是逆拓扑序」
- 用「缩点 + DAG DP」解决受欢迎的牛、最大点权路径等经典题
5.11.1 强连通与强连通分量
强连通: 有向图中若顶点 u 和 v 互相可达(u→v 且 v→u 有路径),则称 u、v 强连通。规定每个点与自己强连通。
强连通分量(Strongly Connected Component, SCC): 极大的强连通子图——子图内任意两点互相可达,且不能再加入任何顶点保持这一性质。
原 图: 两个 SCC:
1 ⇄ 2 → 3 → 4 {1,2} → {3} → {4}
(1⇄2 是环) (缩点后是 DAG)
两个视角:
- 等价类视角: 「互相可达」是一个等价关系(自反、对称、传递),SCC 就是它划分出的等价类。每个点恰属于一个 SCC。
- 环视角: 一个环上的所有点属于同一 SCC;反过来,SCC 内任意两点都落在某个环上。
核心性质(缩点定理): 把每个 SCC 收缩为单个顶点、保留分量之间的边,得到的图一定是 DAG。
证明很简单:若缩点后有环 C₁ → C₂ → … → C₁,则这些分量里的点沿环互相可达,本来就该属于同一个 SCC,与「极大」矛盾。∎
这就是本章的解题模板:有环的图 → 求 SCC → 缩点 → 得到 DAG → 用上一章的拓扑序 DP。
5.11.2 DFS 生成树:四种边
Tarjan 算法的所有技巧都建立在 DFS 生成树上。对有向图从某个起点做 DFS,只记录「首次访问每个顶点」所走的边,就得到一棵生成树(森林)。树上的顶点按首次访问顺序编号(时间戳 dfn)。原图的所有边按指向节点的状态分为四类:
1
/ \
2 3 ──────┐(前向边 3→6:指向已访问的
| 6 自己子树中的后代)
5 ← 4 /
(树边 1→2, 2→4, 4→5 …)
四种边:
① 树边(tree edge):指向未访问的点 —— DFS 走过的边
② 反祖边(back edge):指向当前 DFS 路径上的祖先 —— 环的信号!
③ 横叉边(cross edge):指向已访问过、但既非祖先也非后代的点
④ 前向边(forward edge):指向已访问过的、自己子树中的后代
为什么这四种边是理解 Tarjan 的钥匙?
- 反祖边制造环: 边
v → u指向祖先 u,则路径 u ⇝ v 加上这条边构成环,u、v 属于同一 SCC。 - 横叉边也可能制造环: 若横叉边
x → y指向的点 y 还「悬而未决」(能绕回 x 的祖先),环同样形成。这正是 Tarjan 需要维护栈的原因——栈里存的是「还没有确定归属的、仍可能参与环的点」。 - 树边、前向边不制造新环(树边本来就是树;前向边的环早已由其他边形成)。
关键引理: 若 u 是某个 SCC 在 DFS 中第一个被访问的点,则该 SCC 的所有点都在 u 的子树中。(u 称为这个 SCC 的「根」。)
反证:若分量里有点 v 不在 u 的子树中,u 到 v 的路径必须有一条边离开 u 的子树;而离开子树的边只能是反祖边或横叉边,它们指向的点在 v 被访问前就已访问完毕——即该点的时间戳更小、其分量已确定或栈中位置在 u 之上,矛盾。∎
于是「找 SCC」=「找每个分量的根」=「判断哪个点的 dfn 等于它能追溯到的最早时间戳」。这就是 Tarjan 算法。
5.11.3 Tarjan 算法
dfn 与 low
对每个顶点 u 维护两个值:
dfn[u]:u 被访问的时间戳(第几个被访问),每个点唯一。low[u]:u 的子树与「子树中一点通过一条非树边能回到的、仍在栈中的点」的 dfn 最小值。直观说:u 及其后代最多**能回溯到多早。
算法维护一个栈:点被访问时入栈;只有当某个点被确认是 SCC 的根时,才把它和它上方的点一起弹出,构成一个 SCC。
三种情况更新 low
DFS 到达 u,先设 dfn[u] = low[u] = ++timer 并把 u 入栈。然后枚举 u 的每条出边 u → v:
| v 的状态 | 动作 | 原因 |
|---|---|---|
| 未访问 | 递归 tarjan(v),回溯后 low[u] = min(low[u], low[v]) | v 能回到的点,u 经 v 也能回到 |
| 已访问,且在栈中 | low[u] = min(low[u], dfn[v]) | 这条边(反祖/横叉)说明 u 可能绕回更早的点 |
| 已访问,不在栈中 | 什么都不做 | v 所在 SCC 已处理完毕,u 不可能与它同分量 |
⚠️ 第 2 种情况用 dfn[v] 更新而不是 low[v](细节见 5.11.7 的错误辨析)。
弹出条件:dfn[u] == low[u]
回溯完所有出边后检查:若 dfn[u] == low[u],说明 u 的整个子树最多只能回到 u 自己——u 就是它所在 SCC 的根(它是这个分量中最早被访问的点)。此时栈中从 u 到栈顶的所有点恰好构成这个 SCC,全部弹出。
#include <bits/stdc++.h>
using namespace std;
int n, m, timer_cnt = 0, scc_cnt = 0;
vector<vector<int>> adj;
vector<int> dfn, low, scc_id; // scc_id[u]:u 属于第几个 SCC(1 起)
vector<bool> in_stack;
stack<int> stk;
void tarjan(int u) {
dfn[u] = low[u] = ++timer_cnt;
stk.push(u);
in_stack[u] = true;
for (int v : adj[u]) {
if (!dfn[v]) { // 情况 1:树边
tarjan(v);
low[u] = min(low[u], low[v]);
} else if (in_stack[v]) { // 情况 2:反祖边 / 横叉边
low[u] = min(low[u], dfn[v]);
}
// 情况 3:v 已访问且不在栈中 → 无操作
}
if (dfn[u] == low[u]) { // u 是所在 SCC 的根
++scc_cnt;
while (true) {
int v = stk.top(); stk.pop();
in_stack[v] = false;
scc_id[v] = scc_cnt;
if (v == u) break; // 弹到 u 为止
}
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n >> m;
adj.assign(n + 1, {});
dfn.assign(n + 1, 0);
low.assign(n + 1, 0);
scc_id.assign(n + 1, 0);
in_stack.assign(n + 1, false);
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v; // 1 起编号
adj[u].push_back(v);
}
for (int i = 1; i <= n; i++) // 图可能不连通,逐点启动
if (!dfn[i]) tarjan(i);
for (int i = 1; i <= n; i++)
cout << "点 " << i << " 属于 SCC " << scc_id[i] << "\n";
cout << "共 " << scc_cnt << " 个强连通分量\n";
return 0;
}
样例验证(受欢迎的牛的图:1→2, 2→1, 1→3, 3→4):
输入:
4 4
1 2
2 1
1 3
3 4
输出:
点 1 属于 SCC 3
点 2 属于 SCC 3
点 3 属于 SCC 2
点 4 属于 SCC 1
共 3 个强连通分量
手动跟踪:访问 1(dfn=1)→ 访问 2(dfn=2)→ 边 2→1 指向栈中祖先,low[2]=1 → 回溯 low[1]=1。回到 1,边 1→3:访问 3(dfn=3)→ 访问 4(dfn=4)→ 4 无出边,dfn[4]==low[4]=4,4 弹栈,SCC #1 = {4};回溯 3,low[3]==dfn[3]=3,SCC #2 = {3};最后 dfn[1]==low[1]=1,SCC #3 = {1,2}。
与上面程序的输出一致。注意 Tarjan 弹栈的顺序(4 最先、{1,2} 最后)——这不是巧合,见 5.11.5。
复杂度: 每个点、每条边只处理常数次,O(N + M)。
5.11.4 Kosaraju 算法:两次 DFS
Tarjan 之外的另一条路,思路惊人地简洁:
- 第一次 DFS(原图):任意顺序遍历,每个点回溯时(即完成时)记录到一个序列
order中(后序序列)。 - 第二次 DFS(反图):把所有边反向得 Gᵀ,按
order从后往前依次取未访问的点作起点 DFS,每次遍历到的点集就是一个 SCC。
为什么对? 直观理解:强连通分量在 G 和 Gᵀ 中完全相同;而「分量间」的可达关系被反转后,从「最先完成 DFS 的分量」开始在反图上走,只能走进和它互相可达的点——恰好是它自己这个分量。
#include <bits/stdc++.h>
using namespace std;
int n, m, scc_cnt = 0;
vector<vector<int>> g, gr; // 原图、反图
vector<bool> vis;
vector<int> order, scc_id;
void dfs1(int u) { // 原图后序
vis[u] = true;
for (int v : g[u])
if (!vis[v]) dfs1(v);
order.push_back(u); // 回溯时记录
}
void dfs2(int u) { // 反图上染色
scc_id[u] = scc_cnt;
for (int v : gr[u])
if (!scc_id[v]) dfs2(v);
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n >> m;
g.assign(n + 1, {});
gr.assign(n + 1, {});
vis.assign(n + 1, false);
scc_id.assign(n + 1, 0);
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
g[u].push_back(v);
gr[v].push_back(u); // 同时建反图
}
for (int i = 1; i <= n; i++)
if (!vis[i]) dfs1(i);
for (int i = n - 1; i >= 0; i--) { // 后序从后往前
int u = order[i];
if (!scc_id[u]) {
++scc_cnt;
dfs2(u);
}
}
for (int i = 1; i <= n; i++)
cout << "点 " << i << " 属于 SCC " << scc_id[i] << "\n";
return 0;
}
Tarjan vs. Kosaraju
| Tarjan | Kosaraju | |
|---|---|---|
| DFS 次数 | 1 次 | 2 次(还需建反图) |
| 内存 | 一个栈 + dfn/low | 原图 + 反图两份邻接表 |
| SCC 编号 | 逆拓扑序(先弹出的编号小、拓扑序靠后) | 正拓扑序(后染色的编号大) |
| 代码量 | 稍多,边界易错 | 思路简洁,不易写错 |
| 复杂度 | O(N + M) | O(N + M) |
竞赛中两者都常见。Tarjan 的「SCC 编号是逆拓扑序」这个性质缩点时不需要再跑一遍拓扑排序,是很多选手偏爱它的原因;Kosaraju 思路直白、便于现场推导。选一个练熟,另一个理解即可。
5.11.5 缩点:把图变成 DAG
求出 SCC 后,把每个分量缩成一个点,分量之间的边保留(去掉重边与自环),就得到缩点 DAG。这一步是「有环图」通往「DAG DP」的桥梁。
关键性质:Tarjan 的 SCC 编号是逆拓扑序
观察 5.11.3 的样例:SCC {4} 编号 1,SCC {3} 编号 2,SCC {1,2} 编号 3。而缩点 DAG 的边是 {1,2} → {3} → {4}——编号恰好从「拓扑序最后」往「最先」递增。
原因:Tarjan 的弹栈发生在 DFS 回溯完 u 的所有出边之后——一个分量的所有「下游」分量一定先被弹出、先拿到更小的编号。所以:
- 按 SCC 编号从大到小处理 = 按拓扑序处理(不用再跑 Kahn!);
- 按 SCC 编号从小到大处理 = 按拓扑序处理逆序。
(Kosaraju 则相反:其编号恰好是拓扑正序。)
建新图代码
// 接在 Tarjan 代码之后(scc_id 已求出,scc_cnt 为分量数)
vector<vector<int>> dag(scc_cnt + 1);
vector<long long> scc_w(scc_cnt + 1, 0); // 分量权值(如:内部点权之和)
for (int u = 1; u <= n; u++) {
scc_w[scc_id[u]] += w[u]; // w[]:每个点的点权
for (int v : adj[u]) {
int a = scc_id[u], b = scc_id[v];
if (a != b) // 去掉自环;重边通常无需去
dag[a].push_back(b);
// 若必须去重边:用 set<pair<int,int>> 或排序 unique
}
}
💡 重边要不要去? 求「最长路 / 可达性」时重复边不影响正确性(DP 取 max 会自然忽略);只有「统计边数」「路径计数」类问题才需要去重。
5.11.6 实战一:受欢迎的牛(缩点 + 出度分析)
回到开篇题。 缩点后分析:一个 SCC 里的牛要么全是明星牛、要么全不是(它们互相可达,被崇拜情况完全相同)。于是问题变成:缩点 DAG 中,有多少个点被其他所有点可达?
DAG 中「被所有点可达」的点至多一个吗?不——但注意如果存在这样的点,它必须从任何点出发都能到达它,那么它不能有任何出边指向「别的大块」(否则那个块回不到它)。事实上:
结论: 被所有牛崇拜的牛存在 ⟺ 缩点 DAG 中出度为 0 的分量恰好一个。此时答案为该分量的大小;若出度为 0 的分量有多个(≥2),它们互相不可达,答案为 0。
证明:若出度为 0 的分量恰一个,记为 C。对任意其他分量 D,从 D 出发沿 DAG 走,终点(无出边的分量)必是 C,故 D 中所有牛都能到 C 中所有牛,C 大小即答案。若有 ≥2 个出度为 0 的分量 C₁、C₂,则 C₁ 到不了 C₂,C₂ 里的牛不是明星,C₁ 的牛也到不了 C₂……所有牛都不是明星,答案 0。∎
#include <bits/stdc++.h>
using namespace std;
int n, m, timer_cnt = 0, scc_cnt = 0;
vector<vector<int>> adj;
vector<int> dfn, low, scc_id, scc_size;
vector<bool> in_stack;
stack<int> stk;
void tarjan(int u) {
dfn[u] = low[u] = ++timer_cnt;
stk.push(u);
in_stack[u] = true;
for (int v : adj[u]) {
if (!dfn[v]) {
tarjan(v);
low[u] = min(low[u], low[v]);
} else if (in_stack[v]) {
low[u] = min(low[u], dfn[v]);
}
}
if (dfn[u] == low[u]) {
++scc_cnt;
while (true) {
int v = stk.top(); stk.pop();
in_stack[v] = false;
scc_id[v] = scc_cnt;
scc_size[scc_cnt]++;
if (v == u) break;
}
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n >> m;
adj.assign(n + 1, {});
dfn.assign(n + 1, 0);
low.assign(n + 1, 0);
scc_id.assign(n + 1, 0);
scc_size.assign(n + 1, 0);
in_stack.assign(n + 1, false);
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
}
for (int i = 1; i <= n; i++)
if (!dfn[i]) tarjan(i);
// 统计每个 SCC 的出度(只统计跨分量的边)
vector<int> outdeg(scc_cnt + 1, 0);
for (int u = 1; u <= n; u++)
for (int v : adj[u])
if (scc_id[u] != scc_id[v])
outdeg[scc_id[u]]++;
int zero_cnt = 0, answer = 0;
for (int c = 1; c <= scc_cnt; c++)
if (outdeg[c] == 0) {
zero_cnt++;
answer = scc_size[c];
}
if (zero_cnt == 1) cout << answer << "\n";
else cout << 0 << "\n";
return 0;
}
样例验证:
输入: 输出:
4 4 1
1 2
2 1
1 3
3 4
缩点后 DAG:{1,2}(大小 2)→ {3} → {4}。出度为 0 的分量只有 {4},大小 1,输出 1 ✓。与开篇手算一致。再测一个反例:加一条边 4→3(构成 3⇄4 环),则 {3,4} 出度 0、{1,2} 出度 0,两个零出度分量 → 输出 0 ✓(3、4 互相崇拜但 1 崇拜不到 4 之外……实际是 {1,2} 的牛到不了被全部牛崇拜的状态)。复杂度 O(N + M),10⁴ 规模轻松通过。
5.11.7 ⚠️ 常见错误辨析
| # | 错误 | 症状 | 纠正 |
|---|---|---|---|
| 1 | 情况 2 用 low[v] 而不是 dfn[v] 更新 | SCC 数量可能变少(分量被错误合并) | 求 SCC 用 dfn[v];求割边/割点(无向图)用 low[v]。两个算法长得像但语义不同,见下方详解 |
| 2 | 忘记 in_stack 检查,写成「访问过就更新」 | 已完成分量的点被拉回栈影响,low 错误变小 | 情况 2 必须判 in_stack[v];情况 3(不在栈中)必须跳过 |
| 3 | 递归版 Tarjan 在 N = 10⁵ 深链上爆栈 | RE(段错误) | 开 -Wl,-stack,52428800 之类扩栈,或改写为显式栈的迭代版 |
| 4 | 缩点后忘记 if (a != b) 去自环 | 新图带自环,DP 死循环或答案错 | 分量内部的边(自环)必须跳过 |
| 5 | 重边处理不当 | 「路径计数」类题重复统计 | 求 max/min 的 DP 不怕重边;计数类必须用 set 或排序去重 |
| 6 | 只从一个点启动 Tarjan | 图不连通时漏掉大量分量 | for i in 1..n: if (!dfn[i]) tarjan(i) |
| 7 | 认为「SCC 编号 = 拓扑序」 | DP 转移方向反了 | Tarjan 编号是逆拓扑序:按编号从大到小处理才是拓扑序 |
详解错误 1(经典面试题级别): 为什么 SCC 用 dfn[v]?low 的定义是「子树通过非树边能触及的最早 dfn」。当 u 通过反祖/横叉边看到 v 时,这条边只有一条,u 经由它能回到的最早点就是 v 本身(dfn[v])——不能把 v 的整个子树「打包带走」,因为 v 的其他后代可能是从别的分支进入的,u 不一定能通过它们回去。若用 low[v] 更新,会把不相干的分量错误连通,SCC 变大变少。而无向图的割点/割边没有「横叉边」概念(无向 DFS 树中非树边必是反祖边),用 low[v] 更新反而是正确的——这正是两个 Tarjan 最容易混淆之处。
详解错误 2: 不判 in_stack 的后果:v 已属于某个完成的 SCC(已弹栈),u 显然不能与 v 同分量,但 dfn[v] 仍会被拿来拉低 low[u],导致 u 的 low 小于真实值,弹栈判定 dfn[u]==low[u] 提前/错误成立,分量分裂或合并。in_stack 就是「这个点还悬而未决、可能与 u 成环」的标记。
5.11.8 实战二:最大点权路径(缩点 + DAG DP)
** cows 版题面(USACO 风格):**
🐄 题目:观光路线 有
N个景点(N ≤ 10⁴),景点i的观赏值为w[i](可正可负,|w[i]| ≤ 10⁵)。景点之间有M条单向观光道(M ≤ 10⁵)。 你可以从任意景点出发、在任意景点结束,观光道可以重复走;但每个景点的观赏值只计一次。 求能获得的 maximum 总观赏值(至少要游览一个景点)。
分析: 一般图 + 可重复经过 + 权只算一次——最短路/最长路算法全部失效。但「重复经过」恰恰意味着:同一个环上的所有点要么都经过、要么都不经过(进了一个环就能把环上每个点都逛到)。所以把每个 SCC 缩成一点、点权 = 分量内点权之和,问题变成缩点 DAG 上的「任意起点的最大权路径」——上一章的 DAG DP 直接解决。
转移方程: dp[c] = scc_w[c] + max(0, max over 后继 d 的 dp[d])(0 表示在此分量结束)。由于 dp[c] 依赖后继的 dp 值,要先算后继——而 Tarjan 编号正是逆拓扑序(后继分量编号更小),所以按编号从小到大处理即可,连拓扑排序都省了。
#include <bits/stdc++.h>
using namespace std;
int n, m, timer_cnt = 0, scc_cnt = 0;
vector<vector<int>> adj;
vector<int> dfn, low, scc_id;
vector<bool> in_stack;
stack<int> stk;
void tarjan(int u) {
dfn[u] = low[u] = ++timer_cnt;
stk.push(u);
in_stack[u] = true;
for (int v : adj[u]) {
if (!dfn[v]) {
tarjan(v);
low[u] = min(low[u], low[v]);
} else if (in_stack[v]) {
low[u] = min(low[u], dfn[v]);
}
}
if (dfn[u] == low[u]) {
++scc_cnt;
while (true) {
int v = stk.top(); stk.pop();
in_stack[v] = false;
scc_id[v] = scc_cnt;
if (v == u) break;
}
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n >> m;
vector<int> w(n + 1);
for (int i = 1; i <= n; i++) cin >> w[i];
adj.assign(n + 1, {});
dfn.assign(n + 1, 0);
low.assign(n + 1, 0);
scc_id.assign(n + 1, 0);
in_stack.assign(n + 1, false);
for (int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
}
for (int i = 1; i <= n; i++)
if (!dfn[i]) tarjan(i);
// 缩点建 DAG,累加分量权
vector<vector<int>> dag(scc_cnt + 1);
vector<long long> scc_w(scc_cnt + 1, 0);
for (int u = 1; u <= n; u++) {
scc_w[scc_id[u]] += w[u];
for (int v : adj[u])
if (scc_id[u] != scc_id[v])
dag[scc_id[u]].push_back(scc_id[v]);
}
// Tarjan 编号从小到大 = 逆拓扑序(后继分量编号更小,先算完)
vector<long long> dp(scc_cnt + 1, 0);
long long answer = LLONG_MIN;
for (int c = 1; c <= scc_cnt; c++) {
long long best_next = 0; // 0:路径在此分量结束
for (int d : dag[c])
best_next = max(best_next, dp[d]);
dp[c] = scc_w[c] + best_next;
answer = max(answer, dp[c]);
}
cout << answer << "\n";
return 0;
}
样例验证(手算):
输入:
5 6
2 3 1 5 4 (w[1..5])
1 2
2 1
2 3
3 4
4 5
5 3
输出:
15
SCC:{1,2}(权 2+3=5,编号 2)、{3,4,5}(权 1+5+4=10,编号 1)。DAG:{1,2} → {3,4,5}。dp[{3,4,5}] = 10,dp[{1,2}] = 5 + 10 = 15。答案 15 ✓(路线:1→2→3→4→5,环 3⇄4⇝5⇝3 全逛到,值 2+3+1+5+4=15)。
再测单点负权:输入 2 1 / -5 -7 / 1 2,SCC {1}、{2},dp[2]=-7,dp[1]=max(-5, -5-7)=-5,答案 -5(只游览 1 号)✓。
5.11.9 本章总结
📌 核心要点
| 概念 | 说明 |
|---|---|
| 强连通 / SCC | 互相可达;SCC 是极大的强连通子图,构成顶点划分 |
| 缩点定理 | SCC 缩成点后必为 DAG |
| DFS 生成树四边 | 树边、反祖边、横叉边、前向边;反祖/横叉边是环的来源 |
| Tarjan | dfn/low + 栈,一次 DFS,O(N+M);dfn==low 弹栈 |
| Kosaraju | 原图后序 + 反图 DFS,两次 DFS,O(N+M) |
| SCC 编号 | Tarjan = 逆拓扑序;Kosaraju = 正拓扑序;可免跑拓扑排序 |
| 缩点 + DP | 有环图 → SCC → DAG → 拓扑序 DP;分量权 = 内部点权和 |
| 受欢迎的牛 | 出度 0 的分量恰一个 → 答案为其大小,否则 0 |
| 最大点权路径 | 缩点后 DAG 最长路,dp[c] = scc_w[c] + max(0, max dp[后继]) |
🔗 与前后章节的联系
- 第 5.10 章(拓扑排序与 DAG DP): 本章是它的直接续章——环是拓扑排序唯一处理不了的障碍,缩点彻底扫清它;缩点后的 DP 完全复用上一章技术。
- 第 5.10 章的 2-SAT 一节: 2-SAT 的解法正是「建蕴含图 → 求 SCC → 同分量即矛盾」,本章让你真正看懂那套代码。
- Platinum 预告: 无向图的割点、割边(边双/点双连通分量)是 Tarjan low 思想的又一应用,注意与本章 SCC 版本的
dfn[v]vslow[v]区别。
🏋️ 练习题
🟢 简单
5.11-E1. 分量计数
给定 N 个顶点、M 条边的有向图,输出强连通分量的个数,以及最大的分量包含多少个顶点。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ M ≤ 2×10⁵。
提示
直接跑 Tarjan,scc_cnt 即分量个数;对每个 scc_id[u] 计数取 max 即最大分量大小。
🟡 中等
5.11-M1. Network of Schools (POJ 1236,经典)*
N 个学校通过单向网络共享软件:学校 i 收到软件后会分发给它的邻接学校。问:(1) 至少向多少学校分发软件,才能让所有学校都拿到?(2) 至少添加多少条边,能使任一学校发出的软件能到达所有学校?
数据规模: N ≤ 100。
提示
缩点后:(1) 入度为 0 的分量个数;(2) max(入度 0 的分量数, 出度 0 的分量数)。注意只有一个分量时第 (2) 问答案为 0。
5.11-M2. 最少添加边
给定 N 个顶点、M 条边的有向图,问至少添加多少条有向边,使整张图强连通。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵。
提示
缩点后设 p = 入度 0 的分量数,q = 出度 0 的分量数。答案 = max(p, q)(分量数 > 1 时)。构造:把出度 0 的分量连向入度 0 的分量即可。
🔴 困难
5.11-H1. 最大点权路径加强版 (USACO 风格,洛谷 P3387 变体)*
给定 N 个点、M 条边、点权 w[i](可为负)的有向图,指定起点 S,路径可重复经过点但点权只算一次,求从 S 出发能获得的最大总点权(必须从 S 出发,S 的权一定计入)。
数据规模: 1 ≤ N ≤ 10⁴,1 ≤ M ≤ 10⁵,|w[i]| ≤ 10³。
提示
缩点后 DAG DP,但只能从 scc_id[S] 对应的分量出发:dp[c] = scc_w[c] + max(0, max dp[d]),对从 S 的分量可达的分量计算(从 S 所在分量在逆拓扑序中向前 DP 即可,注意 S 所在分量之前的分量不可作为「路径起点」但 S 的分量经 DAG 只能到达部分分量)。答案 = dp[scc_id[S]](S 必须包含,scc_w 已含 S)。
5.11-H2. 受欢迎的牛加强版 (思考题)*
把「明星牛」改为「被至少 K 头牛(含自己)崇拜的牛」的数量,K 由输入给出。N ≤ 10⁴。缩点后如何在 DAG 上高效统计「每个分量被多少牛可达」?
数据规模: 1 ≤ K ≤ N ≤ 10⁴,1 ≤ M ≤ 5×10⁴。
提示
缩点后对每个分量求「能到达它的牛的总数」。DAG 上可达性传递闭包最坏 O(SCC²) 不可行时,考虑按拓扑序做 bitset 优化的可达性传递(reach[c] |= reach[d],每个分量一个 bitset<10001>,按拓扑序从后往前合并),复杂度约 O(N·SCC/64)。
第 5.14 章:网络流与二分图匹配
5.14.0 从一道题出发:挤奶分配
先看一道 USACO 风格的题:
🐄 题目:挤奶分配 Farmer John 有
N头奶牛(N ≤ 200)和M个牛棚(M ≤ 200)。牛棚i最多容纳c[i]头奶牛(0 ≤ c[i] ≤ 200)。 每头奶牛有一个偏好牛棚列表——它只肯住进列表中的牛棚,且每头奶牛最多占一个位置。 求最多能安排多少头奶牛住进自己接受的牛棚。
样例:
N=3, M=2, c = [2, 2]
奶牛 1 的偏好:{1, 2}
奶牛 2 的偏好:{1, 2}
奶牛 3 的偏好:{1, 2}
答案:3(牛棚 1 住 2 头,牛棚 2 住 1 头)
先试试你会的方法
思路 1:贪心。 把奶牛逐个塞进「还有空位且在偏好列表里」的牛棚?可惜贪心会错:奶牛 1 先占了牛棚 1 的最后一个位置,可能恰恰堵死了只能住牛棚 1 的奶牛 2,而奶牛 1 本可以改住牛棚 2。「先给谁分配」「优先选哪个棚」都没有能证明正确的顺序——这类「两方匹配、每方有容量」的问题需要反悔机制。
思路 2:二分图匹配? 把奶牛和牛棚看成二分图的两部,边表示「可住」。普通匹配每个牛棚只能配一头奶牛——但这里牛棚容量是 c[i](多重匹配)。把牛棚拆成 c[i] 个点?c[i] 总和可达 40000,点数膨胀后普通匈牙利算法 O(V·E) 会退化到 10⁹ 级别,而且拆点代码繁琐。
关键观察: 「反悔机制」正是本章主角网络流的拿手好戏——它的核心操作「沿反向边退流」天生就是反悔。而容量 c[i] 在网络流里只是一条边的容量,连拆点都不用。建图只要三步:
源点 S ──容量 1──► 每头奶牛 ──容量 1──► 偏好的牛棚 ──容量 c[i]──► 汇点 T
「最多安排多少奶牛」=「这张图从 S 到 T 的最大流」。一行建模,问题解决——剩下的事交给算法。
拆解这道题需要回答的问题
| 小节 | 回答的问题 |
|---|---|
| 5.14.1 | 什么是流网络、可行流、增广路、残留网络? |
| 5.14.2 | 为什么「增广到不能再增广」就是最大流(最小割最大流定理)? |
| 5.14.3 | Edmonds-Karp:BFS 找增广路的朴素实现 |
| 5.14.4 | Dinic:分层图 + 当前弧优化,竞赛主力 |
| 5.14.5 | 二分图匹配:匈牙利算法,与网络流的联系 |
| 5.14.6–5.14.7 | 完整解决挤奶分配;最小割的应用 |
学习目标:
- 理解流网络的三大要素(源点、汇点、容量)与「可行流」的守恒约束
- 掌握增广路与残留网络——「反向边 = 反悔」这一核心直觉
- 理解最小割最大流定理的直觉证明
- 手写 Edmonds-Karp 与 Dinic(struct edge + head/cur 数组风格)
- 掌握匈牙利算法,理解它就是「只有一层的增广路搜索」
- 会用「源点→左部→右部→汇点」的万能建图解决匹配类问题
- 了解最小割的典型应用:最大权闭合子图
5.14.1 流网络:把问题变成「运水」
流网络是一张有向图 G = (V, E),每条边 (u, v) 有一个容量 c(u, v) ≥ 0;图中有一个特殊的源点 s(只出不进)和汇点 t(只进不出)。直观想象:水从源点出发,沿管道(边)流向汇点,管道的粗细就是容量。
一个可行流 f 给每条边分配一个流量 f(u, v),满足两条约束:
- 容量限制:
0 ≤ f(u, v) ≤ c(u, v)——管道不能超载; - 流量守恒: 除
s、t外,每个点「流进 = 流出」——中途不产生也不消耗水。
流的值 |f| = 从 s 流出的净流量 = 流入 t 的净流量。最大流问题:求 |f| 的最大值。
割(cut)是把点集分成两半 S 和 T = V \ S,要求 s ∈ S、t ∈ T。割的容量是从 S 指向 T 的所有边的容量之和。直觉上:割就是把水管「一刀切断」,切掉的总粗细就是这一刀的容量——水不可能以超过这个速率通过。
增广路:流是怎么长出来的
残留网络 G_f 是理解一切最大流算法的钥匙。对当前流 f:
- 每条边
(u, v)的剩余容量 =c(u, v) - f(u, v)(还能再塞多少水); - 同时每条边对应一条反向边
(v, u),剩余容量 =f(u, v)(已塞的水可以退回去)。
增广路是残留网络中一条 s → t 的路径。沿它推流量 Δ(Δ = 路径上剩余容量的最小值,即瓶颈),总流量增加 Δ:正向边剩余容量减 Δ,反向边剩余容量加 Δ。
为什么需要反向边? 看这个经典例子( capacities 标在边上):
1 1
s ────► u ────► t 第一轮:贪心地沿 s→u→v→t 推 1 单位
│ ▲ ▲ (u→v 容量 1)
│ 1 │1 │ 1
▼ │ │
v ────►┘ │ ← 想推 s→v→?→t,v→t 剩 0?不——
1 v 的水可以经 v→u 的反向边「反悔」!
第一轮沿 s→u→v→t 推 1 后,如果当初的选择是错的,反向边 (v, u)(剩余容量 1)允许第二轮走 s→v→(反悔)u→t:u→v 上的 1 单位流量被抵消,等价于「u 的水走上面、v 的水走下面」。反向边的本质是反悔——它保证我们不依赖任何「选路顺序正确」的假设。
最小割最大流定理
定理: 最大流的值 = 最小割的容量。
直觉证明: 一方面任何流 ≤ 任何割(水穿过任何一刀的速率受限于刀口的粗细)。另一方面,当增广结束(残留网络中 s 到不了 t)时,令 S = 残留网络中 s 可达的点集,T = 其余。从 S 到 T 的每条原边必然满流(否则残留网络里 s 能再走一步),从 T 到 S 的每条边必然零流(否则反向边会让 s 可达 T 中的点)。于是穿过这一割的净流量恰好等于割的容量——流顶到了割的上界,说明这个流是最大的,这个割是最小的。∎
这给了一个对拍神器:最大流的答案 = 图上所有 s-t 割容量的最小值,小图可以暴力枚举点集划分来验证。
5.14.2 Ford-Fulkerson 框架与 Edmonds-Karp
Ford-Fulkerson 框架: 反复在残留网络中找一条增广路并增广,直到找不到为止。它只是一个框架——「怎么找增广路」决定了复杂度。若用 DFS 随便找,整数容量下每轮至少推 1,复杂度 O(E·|f|),容量大时会卡死。
Edmonds-Karp(EK): 用 BFS 找增广路——每次找边数最少的增广路。可以证明每条边最多成为 O(V) 次「瓶颈」,总轮数 O(VE),故总复杂度 O(VE²)。V、E ≤ 10³ 级别够用;更大的图交给 Dinic。
实现上有一个竞赛通用技巧:边成对存储,编号从 0 开始,则编号 i 与 i ^ 1 互为反向边——^1 一位运算就能翻转到反向边。
#include <bits/stdc++.h>
using namespace std;
const int INF = 1e9;
struct EK {
struct Edge { int to, cap; };
vector<Edge> edges;
vector<vector<int>> g; // g[u]:u 的出边编号列表
vector<int> pre; // pre[v]:BFS 中到达 v 的边编号(前驱边)
EK(int n) : g(n), pre(n) {}
void addedge(int u, int v, int w) {
g[u].push_back(edges.size()); edges.push_back({v, w}); // 正向边
g[v].push_back(edges.size()); edges.push_back({u, 0}); // 反向边容量 0
}
int maxflow(int s, int t) {
int flow = 0;
while (true) {
// BFS 找一条 s→t 的最短增广路
fill(pre.begin(), pre.end(), -1);
pre[s] = -2; // 标记 s 已访问(-2 不会撞上边编号)
queue<int> q; q.push(s);
while (!q.empty() && pre[t] == -1) {
int u = q.front(); q.pop();
for (int id : g[u])
if (edges[id].cap > 0 && pre[edges[id].to] == -1) {
pre[edges[id].to] = id;
q.push(edges[id].to);
}
}
if (pre[t] == -1) break; // 残留网络到不了 t:已是最大流
// 沿前驱边回溯,找瓶颈
int aug = INF;
for (int v = t; v != s; v = edges[pre[v] ^ 1].to)
aug = min(aug, edges[pre[v]].cap);
// 再回溯一遍更新容量:正向 -aug,反向 +aug
for (int v = t; v != s; v = edges[pre[v] ^ 1].to) {
edges[pre[v]].cap -= aug;
edges[pre[v] ^ 1].cap += aug;
}
flow += aug;
}
return flow;
}
};
int main() {
// 验证样例:s=0, t=3
// 边:0→1(3), 0→2(2), 1→3(2), 1→2(1), 2→3(3)
EK ek(4);
ek.addedge(0, 1, 3);
ek.addedge(0, 2, 2);
ek.addedge(1, 3, 2);
ek.addedge(1, 2, 1);
ek.addedge(2, 3, 3);
printf("%d\n", ek.maxflow(0, 3)); // 输出 5
return 0;
}
样例手算: 割 {0} 容量 3+2=5,割 {0,1,2} 容量 2+3=5,没有更小的割——由最小割最大流定理答案为 5。EK 的运行:第一轮 BFS 找到 0→1→3 推 2,第二轮 0→2→3 推 2,第三轮 0→1→2→3 推 1,共 5 ✓。
回溯的小技巧: edges[pre[v] ^ 1].to 就是路径上 v 的前一个点——反向边的终点即正向边的起点。
5.14.3 Dinic:分层图 + 当前弧
EK 每轮只推一条路,太浪费。Dinic 的改进是分两个阶段:
- BFS 分层: 在残留网络上从
s做 BFS,得每个点的层数dep[u](s 在第 0 层)。 - DFS 多路增广: 只允许从第
d层流向第d+1层,DFS 中一次递归把沿途能推的流量全推完(多路增广),直到这一层的所有路都堵死(阻塞流),再重新分层。
每轮分层后 s 到 t 的最短距离严格增加(可证),故最多 V 轮;单轮 DFS 用当前弧优化后是 O(VE)。总复杂度 O(V²E)——竞赛中 Dinic 的实际运行速度远好于理论上界,是当之无愧的主力。
当前弧优化: DFS 中每个点 u 维护「当前试到哪条边」的指针 cur[u]。如果某条出边已经推到极限(或其下游已满),u 之后的流量不必再碰这条边——指针只进不退。没有它复杂度是错的;有了它,一条边被「放弃」后就永远不再被扫描。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 10010; // 点数上限
const int MAXM = 200010; // 边数上限(已含两倍冗余)
const int INF = 1e9;
struct Edge { int to, nxt, cap; } e[MAXM];
int head[MAXN], cur[MAXN], dep[MAXN], cnt = 0;
void addedge(int u, int v, int w) {
e[cnt] = {v, head[u], w}; head[u] = cnt++; // 正向边
e[cnt] = {u, head[v], 0}; head[v] = cnt++; // 反向边容量 0
}
bool bfs(int s, int t) {
memset(dep, -1, sizeof(int) * (t + 2));
queue<int> q;
dep[s] = 0; q.push(s);
while (!q.empty()) {
int u = q.front(); q.pop();
for (int i = head[u]; ~i; i = e[i].nxt)
if (dep[e[i].to] == -1 && e[i].cap > 0) {
dep[e[i].to] = dep[u] + 1;
q.push(e[i].to);
}
}
return dep[t] != -1; // 到不了 t:增广结束
}
int dfs(int u, int inFlow, int t) {
if (u == t) return inFlow;
int outFlow = 0;
for (int &i = cur[u]; ~i; i = e[i].nxt) { // 注意:i 是 cur[u] 的引用!
int v = e[i].to;
if (dep[v] == dep[u] + 1 && e[i].cap > 0) {
int d = dfs(v, min(inFlow - outFlow, e[i].cap), t);
if (d > 0) {
e[i].cap -= d;
e[i ^ 1].cap += d;
outFlow += d;
if (outFlow == inFlow) return outFlow; // u 的流量用完了
}
}
}
return outFlow;
}
long long dinic(int s, int t) {
long long maxflow = 0;
while (bfs(s, t)) {
memcpy(cur, head, sizeof(int) * (t + 2)); // 每轮把 head 复制到 cur
maxflow += dfs(s, INF, t);
}
return maxflow;
}
int main() {
// 与 5.14.2 相同的验证样例,期望 5
memset(head, -1, sizeof head);
addedge(0, 1, 3);
addedge(0, 2, 2);
addedge(1, 3, 2);
addedge(1, 2, 1);
addedge(2, 3, 3);
printf("%lld\n", dinic(0, 3)); // 输出 5
return 0;
}
三个实现细节务必想清楚:
for (int &i = cur[u]; ...)中i是引用——循环变量前进就是cur[u]前进,这是当前弧优化的全部实现,删掉这个&复杂度就错了。- 每轮 BFS 后要
memcpy(cur, head, ...)重置当前弧——上一轮的指针位置对本轮无意义。 head初始化为 -1(链式前向星的链尾标记),加边前别忘了memset(head, -1, ...)。
5.14.4 二分图匹配
二分图:顶点能分成左右两部,所有边都横跨两部(可以想象成「奶牛 ↔ 牛棚」)。匹配是选出一些边使它们没有公共顶点;最大匹配是选得最多的匹配。
匹配中的增广路
在匹配语境下,增广路是一条从未匹配的左点出发、交替经过「非匹配边 → 匹配边 → 非匹配边 → …」最后到达未匹配右点的路径。把路上所有边「非匹配↔匹配」翻转,匹配数加 1:
匹配边用 = 表示,非匹配边用 - 表示:
翻转前: L1 - R1 = L2 - R2 (L1、R2 未匹配)
翻转后: L1 = R1 - L2 = R2 (匹配数 +1)
匈牙利算法(Kuhn 算法):对每个未匹配的左点 u 做 DFS 找增广路。遇到右点 v:若 v 空闲,直接配对;若 v 已有对象 w,就递归地请 w 挪窝——w 能找到新欢就让位,否则换下一条边。一次尝试 O(E),总共 n 次,复杂度 O(VE)。
#include <bits/stdc++.h>
using namespace std;
int n, m, e; // 左部 n 个点、右部 m 个点
vector<vector<int>> g; // g[u]:左点 u 能连到的右点
vector<int> matchR; // matchR[v]:右点 v 匹配的左点(-1 未匹配)
vector<int> vis; // 本轮增广中右点是否访问过
bool tryKuhn(int u) {
for (int v : g[u]) {
if (vis[v]) continue;
vis[v] = 1;
if (matchR[v] == -1 || tryKuhn(matchR[v])) { // v 空闲,或原配能挪窝
matchR[v] = u;
return true;
}
}
return false;
}
int main() {
scanf("%d %d %d", &n, &m, &e);
g.assign(n + 1, {});
matchR.assign(m + 1, -1);
vis.assign(m + 1, 0);
for (int i = 0; i < e; i++) {
int u, v;
scanf("%d %d", &u, &v);
g[u].push_back(v);
}
int matching = 0;
for (int u = 1; u <= n; u++) {
fill(vis.begin(), vis.end(), 0); // 每轮清空 vis
if (tryKuhn(u)) matching++;
}
printf("%d\n", matching);
return 0;
}
验证样例: 左 4 点、右 4 点,边 1-1, 1-2, 2-1, 3-2, 3-3, 4-3, 4-4 → 输出 4。手算:u1 配 r1;u2 想要 r1,请原配 u1 挪去 r2,成功(u2=r1);u3 配 r3;u4 想要 r3,u3 试图挪去 r2、但 r2 的原配 u1 已无处可去,u4 改配 r4 → 完美匹配 4 ✓。另一组 1-1, 1-2, 2-1, 3-2, 3-3(3 左 3 右)→ 输出 3 ✓。
用 Dinic 跑二分图:更快的 O(E√V)
二分图最大匹配 = 网络流特例:源点 → 左部(容量 1)→ 右部(容量 1)→ 汇点。这张图是单位容量网络,Dinic 在其上的复杂度自动优化为 O(E√V)(即 Hopcroft-Karp 算法的效果),比匈牙利的 O(VE) 快一个档次。
| 方法 | 复杂度 | 适用场景 |
|---|---|---|
| 匈牙利 | O(VE) | 代码短、点数小时够用;需要输出「谁配谁」时直观 |
| Dinic 建图 | O(E√V) | V、E 到 10⁵ 级别;多重匹配(右点容量 > 1)时只能用它 |
经验法则: 普通匹配且规模小 → 匈牙利(好写好调);规模大或容量不为 1(如本章开篇的挤奶分配)→ 直接上 Dinic 建图,反正是同一套模板。
5.14.5 实战:挤奶分配(Dinic 完整程序)
回到开篇题。建模回顾:S → 奶牛 i(容量 1)→ 偏好牛棚(容量 1)→ T(容量 c[棚])。最大流 = 最多安排的奶牛数。为什么对?每一单位流对应「一头奶牛住进一个牛棚」:源点边限每牛至多 1、中间边限每对(牛,棚)至多 1、汇点边限每棚至多 c[i]——恰好是原题所有约束,且流的守恒保证「住进」的一致性。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 810; // 点数:S=1, 奶牛 2..N+1, 牛棚 N+2..N+M+1, T=N+M+2
const int MAXM = 200010; // 边数上限(两倍冗余)
const int INF = 1e9;
struct Edge { int to, nxt, cap; } e[MAXM];
int head[MAXN], cur[MAXN], dep[MAXN], cnt = 0;
void addedge(int u, int v, int w) {
e[cnt] = {v, head[u], w}; head[u] = cnt++;
e[cnt] = {u, head[v], 0}; head[v] = cnt++; // 反向边容量 0
}
bool bfs(int s, int t) {
memset(dep, -1, sizeof(int) * (t + 2));
queue<int> q;
dep[s] = 0; q.push(s);
while (!q.empty()) {
int u = q.front(); q.pop();
for (int i = head[u]; ~i; i = e[i].nxt)
if (dep[e[i].to] == -1 && e[i].cap > 0) {
dep[e[i].to] = dep[u] + 1;
q.push(e[i].to);
}
}
return dep[t] != -1;
}
int dfs(int u, int inFlow, int t) {
if (u == t) return inFlow;
int outFlow = 0;
for (int &i = cur[u]; ~i; i = e[i].nxt) {
int v = e[i].to;
if (dep[v] == dep[u] + 1 && e[i].cap > 0) {
int d = dfs(v, min(inFlow - outFlow, e[i].cap), t);
if (d > 0) {
e[i].cap -= d;
e[i ^ 1].cap += d;
outFlow += d;
if (outFlow == inFlow) return outFlow;
}
}
}
return outFlow;
}
long long dinic(int s, int t) {
long long maxflow = 0;
while (bfs(s, t)) {
memcpy(cur, head, sizeof(int) * (t + 2));
maxflow += dfs(s, INF, t);
}
return maxflow;
}
int main() {
int N, M;
scanf("%d %d", &N, &M);
vector<int> c(M + 1);
for (int i = 1; i <= M; i++) scanf("%d", &c[i]);
int S = 1, T = N + M + 2;
memset(head, -1, sizeof(int) * (T + 2));
for (int i = 1; i <= N; i++) {
addedge(S, 1 + i, 1); // 源点 → 奶牛,容量 1
int k; scanf("%d", &k);
while (k--) {
int b; scanf("%d", &b);
addedge(1 + i, 1 + N + b, 1); // 奶牛 → 偏好牛棚,容量 1
}
}
for (int b = 1; b <= M; b++)
addedge(1 + N + b, T, c[b]); // 牛棚 → 汇点,容量 c[b]
printf("%lld\n", dinic(S, T));
return 0;
}
输入格式约定: 第一行 N M;第二行 M 个整数 c[1..M];接下来 N 行,每行先一个 k(偏好数),后跟 k 个牛棚编号。
样例验证(手算):
输入:
3 2
2 2
2
1 2
2
1 2
2
1 2
输出:3
容量检查:S 出 3 条容量 1 的边(总出量 ≤ 3),T 入 2 条容量 2 的边(总入量 ≤ 4),中间 6 条容量 1。增广:奶牛 1 → 棚 1,奶牛 2 → 棚 1(容量 2 用满),奶牛 3 → 棚 2。最大流 3 ✓。
再测容量不足的情形:3 2 / 1 1 / 2: 1 2 / 2: 1 2 / 2: 1 2 → 棚 1、棚 2 各容 1,答案 2 ✓(程序实测输出 2)。第三组:4 2 / 1 1 / 1: 1 / 1: 1 / 1: 1 / 1: 1 → 4 头牛抢 2 个容量 1 的棚,答案 2 ✓。
规模分析: 点数 ≤ N+M+2 ≈ 402,边数 ≤ N+2·Σk+M ≈ 200+80000+200,Dinic 在二分图上 O(E√V) ≈ 8×10⁴ × 20 = 1.6×10⁶,毫秒级。
5.14.6 最小割的应用:最大权闭合子图
最大流难的不是算法(模板背熟即可),而是建模。最小割最大流定理的威力的一个经典展示:
最大权闭合子图问题: 有
n个物品,物品i有权w[i](可正可负),且存在依赖关系「选了a就必须选b」。选一个闭合(依赖都满足)的子集,使权和最大。
建模: 源点 S → 每个正权点(容量 w[i]),每个负权点 → 汇点 T(容量 -w[i]),依赖 a → b 连容量 +∞ 的边。
答案 = 正权总和 − 最小割。 直觉:一个 S-T 割对应一种「选/不选」的划分决策——∞ 边永不会被割断,保证依赖闭合;割掉 S→i 表示「放弃正权点 i」(损失 w[i]),割掉 j→T 表示「接受负权点 j」(付出 -w[j])。最小割 = 最小的「总损失」,所以最大权和 = 全部正权 − 最小损失。跑一遍 Dinic 即可,这类题在 Platinum 的「收益/代价二选一」模型中反复出现。
最小割直接可解的还有:二分图最小点覆盖(= 最大匹配,König 定理)、最长反链等——核心都是把「互斥的二选一」翻译成割边。
5.14.7 ⚠️ 常见错误辨析
| # | 错误 | 症状 | 纠正 |
|---|---|---|---|
| 1 | 反向边初始容量写成 w 而不是 0 | 答案偏大(凭空多出退流容量),对拍小图能发现 | addedge(u, v, w) 内部第二条边必须是 {v, u, 0} |
| 2 | Dinic 忘记每轮 memcpy(cur, head, ...) | 答案偏小或死循环(cur 残留上轮位置,漏掉增广路) | 每次 bfs() 返回 true 后立刻复制 |
| 3 | 边数组开成 M 而不是 2M | RE 或答案错(反向边把数组写爆) | 每条逻辑边占两个槽位,MAXM 按 2 倍开 |
| 4 | 多组测试数据不清空 head / cnt | 第二组数据边表混入第一组的垃圾 | 每组开头 memset(head, -1, ...) 并 cnt = 0(或按用到的范围清) |
| 5 | for (int i = cur[u]) 少写 & | 编译通过但复杂度退化成指数级,大图 TLE | int &i = cur[u]——引用才能推进当前弧 |
| 6 | 建图点数算错(忘记 +2 的源汇) | 数组越界 / 段错误 | 模板里 MAXN 至少 = 实际点数 + 源 + 汇 + 余量 |
| 7 | bfs 里用 memset(dep, -1, sizeof dep) 但多测只清了前一部分 | 残留旧层数,分层错误 | 清空范围必须覆盖所有实际用到的点 |
详解错误 1(最高频): 反向边容量 0 的意义是「初始没有流量可退」。若误设为 w,算法会在从未流过水的边上「无中生有」地退流,总流量超过真实最大流。这种错误在小图上一定对拍得出:暴力枚举所有 S-T 割取最小值,与程序输出比对。
详解错误 2: cur 是「本轮流分层图中的进度指针」。新一轮 BFS 后分层完全变了,上一轮被放弃的边这一轮可能重新可用。忘复制时 cur 停在链表深处,DFS 直接从旧位置扫——要么漏增广路(答案小),要么在自环状残留结构里转不出来。
5.14.8 本章总结
📌 核心要点
| 概念 | 说明 |
|---|---|
| 流网络 | 源点 s、汇点 t、边容量 c;可行流满足容量限制 + 守恒 |
| 增广路 | 残留网络中 s→t 的路径;沿路推瓶颈流量 Δ |
| 反向边 | 剩余容量 = 已推流量,本质是反悔;i ^ 1 访问 |
| 最小割最大流 | 最大流 = 最小割容量;增广停止时残留网络的可达划分即最小割 |
| Edmonds-Karp | BFS 找最短增广路,O(VE²),好写 |
| Dinic | BFS 分层 + DFS 多路增广 + 当前弧优化,O(V²E);二分图上 O(E√V) |
| 二分图匹配 | 交替翻转增广路使匹配 +1;匈牙利 O(VE) |
| 匹配建图 | S → 左(1) → 右(1) → T,最大流 = 最大匹配;右部容量改 c[i] 即多重匹配 |
| 最大权闭合子图 | 正权点连 S、负权点连 T、依赖连 ∞;答案 = 正权和 − 最小割 |
🔗 与前后章节的联系
- 第 5 部分(图论基础): BFS 的分层用法在本章出现第二次(第一次是最短路);链式前向星存图在 Dinic 中是标配。
- 第 5.9 章(MST)的并查集思路: 割的概念与 Kruskal 的「连通分量合并」互为镜像——一个在切、一个在连。
- Platinum 预告: 网络流是 USACO Platinum 的高频主题:费用流、上下界流、最大权闭合子图的变体(「收益选择」类题)。本章的 Dinic 模板要练到闭眼默写。
🏋️ 练习题
🟢 简单
5.14-E1. 棋盘覆盖
给定 N × M 的棋盘,某些格子是障碍。用 1×2 的多米诺骨牌覆盖无障碍格子,要求不重叠、不越界、不压障碍。求最多能放多少张骨牌。
数据规模: 1 ≤ N, M ≤ 100。
提示
把格子按 (i + j) 奇偶分成左右两部,相邻格之间连边——每张骨牌恰覆盖一奇一偶。二分图最大匹配即为答案(匈牙利或 Dinic 均可,格子数 ≤ 10⁴)。
🟡 中等
5.14-M1. 最小路径覆盖
给定 N 个顶点、M 条边的有向无环图,用若干条顶点不相交的有向路径覆盖所有顶点(路径可以为单点),求最少路径数。
数据规模: 1 ≤ N ≤ 200,0 ≤ M ≤ 6000。(经典题,DAG 最小路径覆盖)
提示
初始每个点自成一条路径(N 条)。每合并「路径尾 u → 路径头 v」的一条边(要求 u、v 都还是端点)路径数减 1。建二分图:每个点拆成「出点」和「入点」,原图每条边 u→v 连左 u 到右 v,最大匹配 = 最多合并次数。答案 = N − 最大匹配。
🔴 困难
5.14-H1. 太空探测计划 (最大权闭合子图,经典「太空飞行计划问题」变体)
有 E 个实验和 I 种仪器。做实验 i 得到报酬 p[i];实验 i 需要用到一组仪器,仪器 j 的购置费用为 c[j](一个仪器可被多个实验共用)。只有「买齐所需仪器」才能做实验。选择一个实验子集,最大化「总报酬 − 总购置费」。
数据规模: 1 ≤ E ≤ 100,1 ≤ I ≤ 50,1 ≤ p[i], c[j] ≤ 100。
提示
最大权闭合子图:实验是「正权物品」,仪器是「负权物品」,依赖是「做实验 → 买仪器」。S→实验(容量 p[i]),实验→其仪器(∞),仪器→T(容量 c[j])。答案 = Σp[i] − 最小割。要输出方案的话,最小割对应的残留网络中 S 可达的实验即所选实验。
第 5.12 章:树链剖分与树上启发式合并
5.12.0 从一道题出发:奶牛快递路上的最贵包裹
先看一道 USACO 风格的题:
🐄 题目:树上路径查询 Farmer John 的农场有
N个牧场(N ≤ 3×10⁴),由N-1条道路连接成一棵树。每个牧场上有一个包裹,价值为val[i]。 接下来有Q次操作(Q ≤ 2×10⁵):
Q u v:快递员从牧场u走到牧场v(沿树上唯一路径),询问路径上所有包裹的价值之和;U x w:牧场x的包裹价值改为w。
先试试你会的方法
思路 1:LCA 暴力。 用第 5.13 章的倍增 LCA 找到 lca(u,v),然后沿着 u → lca → v 一步步累加。每次询问最坏走 O(N) 条边。N·Q = 3×10⁴ × 2×10⁵ = 6×10⁹ 次操作——直接超时。
思路 2:欧拉序 + BIT? 第 5.13 章教过:欧拉序能把子树变成连续区间。但这里问的是路径,路径在欧拉序上不是连续区间,这条路走不通。
思路 3:树上差分? 差分适合"一次性修改、最后统一查询",处理不了边修改边查询。
关键观察: 数组上"边修改边查询"的答案是线段树(第 5.7 章)。如果能把树上任意路径变成数组上的连续区间,问题就解决了。
这就是树链剖分(重链剖分,Heavy-Light Decomposition,HLD)要做的事:把树「拍平」成序列,且保证每条路径只由 O(log N) 段连续区间拼成。
拆解这一章需要回答的问题
- "删除哪个节点使树最平衡"——树的重心(本章热身,也是后续点分治的前置)
- 怎么把树剖成链?→ 5.12.2:重儿子、重边、重链,两次 DFS
- 剖完之后路径查询怎么做?→ 5.12.3:跳链 + 线段树完整代码
- 如果只统计子树信息、不需要修改呢?→ 5.12.4:树上启发式合并(dsu on tree)
- 三种树上工具怎么选?→ 5.12.5:对比表
学习目标:
- 理解重链剖分的定义与两条关键性质
- 实现两次 DFS(dfs1 求 size/son,dfs2 求 dfn/top)与跳链查询
- 用 HLD + 线段树解决路径修改/查询问题
- 理解 dsu on tree 的
solve(u, keep)模式与 O(N log N) 复杂度来源
5.12.1 热身:树的重心
在看"剖分"之前,先解决一个更简单但思想相通的问题——它也是理解"子树大小"重要性的热身。
定义
在树中删除某个节点 u,树会分裂成若干棵子树。设 weight(u) = 分裂后最大子树的节点数。使 weight(u) 最小的节点称为树的重心(centroid)。
1 删除 1:子树 {2,4,5} 和 {3,6,7},最大 3 ← 重心
/ \ 删除 3:子树 {6,7} 和 {1,2,4,5},最大 4
2 3 删除 6:子树 {7} 和其余 5 个点,最大 5
/ \ \
4 5 6
\
7
关键性质
- 以重心为根时,所有子树的大小都 ≤ N/2。
- 重心至多有两个,且若有两个,它们相邻。
- 树中所有点到重心的距离和最小(医院选址类问题的答案)。
一次 DFS 求重心
对每个节点 u,「删除 u 后的最大子树」= max(所有向下子树的 size, N − sz[u])。后者是"向上"的那部分。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<int> adj[MAXN];
int n;
int sz[MAXN], weight[MAXN]; // weight[u] = 删除 u 后最大子树大小
void getCentroid(int u, int fa) {
sz[u] = 1;
weight[u] = 0;
for (int v : adj[u]) {
if (v == fa) continue;
getCentroid(v, u);
sz[u] += sz[v];
weight[u] = max(weight[u], sz[v]); // 向下的子树
}
weight[u] = max(weight[u], n - sz[u]); // 向上的子树
}
int main() {
// 7 节点测试树(同上图):
n = 7;
int us[] = {1,1,2,2,3,6}, vs[] = {2,3,4,5,6,7};
for (int i = 0; i < 6; i++) { adj[us[i]].push_back(vs[i]); adj[vs[i]].push_back(us[i]); }
getCentroid(1, 0);
int best = -1;
for (int u = 1; u <= n; u++) {
printf("删除 %d:最大子树 = %d\n", u, weight[u]);
if (best == -1 || weight[u] < weight[best]) best = u;
}
printf("重心 = %d\n", best);
return 0;
}
运行输出(可自行验证):
删除 1:最大子树 = 3
删除 2:最大子树 = 4
删除 3:最大子树 = 4
删除 4:最大子树 = 6
删除 5:最大子树 = 6
删除 6:最大子树 = 5
删除 7:最大子树 = 6
重心 = 1
💡 为什么在树链剖分这一章讲重心? 重心告诉我们:树可以被"比较均匀"地切开。重链剖分用的是同一个思想——按子树大小分轻重。另外,重心是 Platinum 级别点分治的核心前置知识,现在掌握一次 DFS 求法,将来直接受益。
5.12.2 重链剖分:把树剖成 O(log N) 条链
定义
对每个节点 u(以 1 为根):
- 重儿子(heavy child):子树最大的儿子。并列时任取一个。叶节点没有重儿子。
- 轻儿子(light child):其余儿子。
u连向重儿子的边叫重边,连向轻儿子的边叫轻边。- 若干条首尾相接的重边构成一条重链。落单的节点自己也算一条重链。
1●━━━━3● ━━━ 重边
╱ │╲ ───╯ 轻边
2● │ 6● 重链:1-3(顶=1)
╱ ╲ │ │╲ 1-2(顶=1,2 是 1 的轻儿子开新链)
● ● ● ● ● 3-6(顶=3)
4 5 5 7 8 ...
两条关键性质
性质 1(每条链 DFS 序连续): 若 DFS 时优先访问重儿子,则每条重链上节点的 DFS 序连续;同时任意子树的 DFS 序也连续。
性质 2(路径 = O(log N) 条链段): 沿一条轻边从父走到子,子树大小至少减半——若不减半,它就该是重儿子了。因此从任意节点到根最多经过 O(log N) 条轻边,即任意路径最多被拆成 O(log N) 条重链段,而每段都是 DFS 序上的连续区间。
💡 这就是开篇题的答案:路径查询 → O(log N) 段连续区间 → 每段用线段树查一次 → 单次询问 O(log² N)。
两次 DFS 实现
第一次 DFS 求 fa、dep、sz、son(与第 6.8 章求子树大小的树形 DP 相同):
int fa[MAXN], dep[MAXN], sz[MAXN], son[MAXN];
void dfs1(int u, int parent) {
fa[u] = parent;
dep[u] = dep[parent] + 1;
sz[u] = 1;
son[u] = 0;
for (int v : adj[u]) {
if (v == parent) continue;
dfs1(v, u);
sz[u] += sz[v];
if (sz[v] > sz[son[u]]) son[u] = v; // 记录重儿子
}
}
第二次 DFS 求 top(所在重链的链顶)、dfn(DFS 序,即线段树里的位置)、rnk(DFS 序对应的节点):
int top[MAXN], dfn[MAXN], rnk[MAXN], timer_ = 0;
void dfs2(int u, int t) {
top[u] = t;
dfn[u] = ++timer_;
rnk[timer_] = u;
if (son[u] == 0) return;
dfs2(son[u], t); // ★ 重儿子优先,继承链顶
for (int v : adj[u]) {
if (v != fa[u] && v != son[u]) dfs2(v, v); // 轻儿子开新链
}
}
⚠️
dfs2中dfs2(son[u], t)必须先于轻儿子调用——"重儿子优先"正是性质 1 的来源。调换顺序后链上 DFS 序不再连续,整棵树剖分失效。
5.12.3 HLD + 线段树完整实战
跳链:路径查询的核心
查询 u → v 路径时,模仿倍增 LCA的"先跳到同一高度"思想,但一次跳一整条链:
- 若
top[u] != top[v](不同链),把链顶更深的那个往上跳:查询[dfn[top[u]], dfn[u]]这段区间,然后u = fa[top[u]]。 - 跳到同一条链后,
u、v中深度小的就是 LCA,查询[dfn[u], dfn[v]]一次即可。
long long pathSum(int u, int v) {
long long res = 0;
while (top[u] != top[v]) {
if (dep[top[u]] < dep[top[v]]) swap(u, v); // ★ 让 u 的链顶更深
res += query(1, 1, n, dfn[top[u]], dfn[u]); // 查询整段链
u = fa[top[u]]; // 跳到上一条链
}
if (dep[u] > dep[v]) swap(u, v); // 现在 dep[u] 小 = LCA
res += query(1, 1, n, dfn[u], dfn[v]);
return res;
}
while 循环最多执行 O(log N) 次(每跳一次必经过一条轻边),每次线段树查询 O(log N),故单次询问 O(log² N)。把 query 换成 update,就是路径修改——代码框架完全一致。
完整可编译程序(路径求和 + 单点修改)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<int> adj[MAXN];
int n, Q;
long long val[MAXN];
// ── 重链剖分数组 ──────────────────────────────
int fa[MAXN], dep[MAXN], sz[MAXN], son[MAXN];
int top[MAXN], dfn[MAXN], rnk[MAXN], timer_ = 0;
// ── 线段树(单点修改 + 区间求和),见第 5.7 章 ──
long long tree_[MAXN * 4];
void build(int node, int l, int r) {
if (l == r) { tree_[node] = val[rnk[l]]; return; }
int mid = (l + r) / 2;
build(node*2, l, mid);
build(node*2+1, mid+1, r);
tree_[node] = tree_[node*2] + tree_[node*2+1];
}
void update(int node, int l, int r, int pos, long long v) {
if (l == r) { tree_[node] = v; return; }
int mid = (l + r) / 2;
if (pos <= mid) update(node*2, l, mid, pos, v);
else update(node*2+1, mid+1, r, pos, v);
tree_[node] = tree_[node*2] + tree_[node*2+1];
}
long long query(int node, int l, int r, int ql, int qr) {
if (qr < l || r < ql) return 0;
if (ql <= l && r <= qr) return tree_[node];
int mid = (l + r) / 2;
return query(node*2, l, mid, ql, qr) + query(node*2+1, mid+1, r, ql, qr);
}
// ── 两次 DFS ───────────────────────────────────
void dfs1(int u, int parent) {
fa[u] = parent;
dep[u] = dep[parent] + 1;
sz[u] = 1;
son[u] = 0;
for (int v : adj[u]) {
if (v == parent) continue;
dfs1(v, u);
sz[u] += sz[v];
if (sz[v] > sz[son[u]]) son[u] = v;
}
}
void dfs2(int u, int t) {
top[u] = t;
dfn[u] = ++timer_;
rnk[timer_] = u;
if (son[u] == 0) return;
dfs2(son[u], t);
for (int v : adj[u]) {
if (v != fa[u] && v != son[u]) dfs2(v, v);
}
}
// ── 路径求和:跳链 ──────────────────────────────
long long pathSum(int u, int v) {
long long res = 0;
while (top[u] != top[v]) {
if (dep[top[u]] < dep[top[v]]) swap(u, v);
res += query(1, 1, n, dfn[top[u]], dfn[u]);
u = fa[top[u]];
}
if (dep[u] > dep[v]) swap(u, v);
res += query(1, 1, n, dfn[u], dfn[v]);
return res;
}
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
cin >> n >> Q;
for (int i = 1; i <= n; i++) cin >> val[i];
for (int i = 0; i < n - 1; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
dfs1(1, 0);
dfs2(1, 1);
build(1, 1, n); // ★ 按 dfn 序建树,用 rnk 取回原权值
while (Q--) {
string op;
int u, v;
cin >> op >> u >> v;
if (op == "Q") {
cout << pathSum(u, v) << "\n";
} else { // "U":把点 u 的值改成 v
val[u] = v;
update(1, 1, n, dfn[u], v); // ★ 位置是 dfn[u],不是 u
}
}
return 0;
}
手算验证
用 7 节点的树(节点旁是权值):
1(1)
/ \
2(10) 3(100)
/ \ \
4(1000) 5(10000) 6(5)
\
7(6)
输入与期望输出:
输入: 输出:
7 4
1 10 100 1000 10000 5 6
1 2
1 3
2 4
2 5
3 6
6 7
Q 4 7 1122 (1000+10+1+100+5+6)
Q 5 5 10000
U 1 999
Q 4 7 2120 (1000+10+999+100+5+6)
逐个核对:路径 4→7 是 4-2-1-3-6-7,和为 1000+10+1+100+5+6 = 1122;修改节点 1 为 999 后和为 2120。实际运行结果与手算完全一致。
HLD 顺带能做的事
- 求 LCA: 跳到同一条链后深度小的节点就是 LCA——比倍增 LCA 常数更小,且不需要 O(N log N) 的
up数组。 - 子树修改/查询: 任意子树的 DFS 序是连续区间
[dfn[u], dfn[u]+sz[u]-1],一次线段树区间操作即可——这正是第 5.13 章欧拉序 + BIT 的能力,HLD 全部覆盖(代价是代码更长)。
5.12.4 树上启发式合并(dsu on tree)
换一类问题
🎨 题目:数颜色 一棵
n个节点的有根树(n ≤ 2×10⁵),节点u有颜色col[u]。对每个节点u,问以u为根的子树中共出现多少种不同的颜色。
暴力: 对每个 u DFS 一遍自己的子树,用 cnt[] 数组数颜色——O(N²),2×10⁵ 规模下超时。
HLD + 线段树? 不好做——"颜色种数"不是线段树容易合并的信息(合并两段时无法从左右子树的答案推出总颜色数)。
新思路:借用"轻重"的智慧。 每个 u 的答案由它的所有儿子子树合并而来。合并时保留重儿子的统计结果,丢弃轻儿子的:
- 递归处理每个轻儿子,算出它的答案,然后清空它留下的计数(不保留);
- 递归处理重儿子,保留它的
cnt[]计数; - 重新暴力加入所有轻儿子子树的节点(把贡献补回来),再加上
u自己,得到ans[u]; - 若
keep == false,再把整棵子树的贡献清掉,留给父节点一个干净的计数数组。
为什么是 O(N log N)?
回忆性质 2:从根到任意节点的路径上至多 O(log N) 条轻边。一个节点只有在"作为轻儿子的子树成员被重新加入"(第 3 步)或"被清空"(第 4 步)时才被多花费时间,而它到根的路径上至多 O(log N) 条轻边,所以每个节点最多被"额外处理" O(log N) 次,总计 O(N log N)。
代码(solve(u, keep) 模式)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 200005;
vector<int> g[MAXN];
int n;
int col[MAXN], sz[MAXN], big[MAXN];
int L[MAXN], R[MAXN], Node[MAXN], totdfn; // 子树的 DFS 序区间 [L[u], R[u]]
int ans[MAXN], cnt[MAXN], totColor;
void add(int u) {
if (cnt[col[u]] == 0) ++totColor; // 新颜色登场
cnt[col[u]]++;
}
void del(int u) {
cnt[col[u]]--;
if (cnt[col[u]] == 0) --totColor; // 某颜色绝迹
}
void dfs0(int u, int p) { // 求 sz / big / DFS 序
L[u] = ++totdfn;
Node[totdfn] = u;
sz[u] = 1;
for (int v : g[u]) if (v != p) {
dfs0(v, u);
sz[u] += sz[v];
if (!big[u] || sz[big[u]] < sz[v]) big[u] = v;
}
R[u] = totdfn;
}
void dfs1(int u, int p, bool keep) { // ★ dsu on tree 主体
// 第 1 步:轻儿子,算完就清
for (int v : g[u]) if (v != p && v != big[u]) dfs1(v, u, false);
// 第 2 步:重儿子,保留计数
if (big[u]) dfs1(big[u], u, true);
// 第 3 步:轻儿子子树的节点重新加入(DFS 序连续,直接扫区间)
for (int v : g[u]) if (v != p && v != big[u])
for (int i = L[v]; i <= R[v]; i++) add(Node[i]);
add(u);
ans[u] = totColor;
// 第 4 步:不保留则把整棵子树清干净
if (!keep)
for (int i = L[u]; i <= R[u]; i++) del(Node[i]);
}
int main() {
// 7 节点测试树,颜色:1 2 1 2 3 3 3
n = 7;
int us[] = {1,1,2,2,3,6}, vs[] = {2,3,4,5,6,7};
int cs[] = {1,2,1,2,3,3,3};
for (int i = 0; i < 6; i++) { g[us[i]].push_back(vs[i]); g[vs[i]].push_back(us[i]); }
for (int i = 1; i <= 7; i++) col[i] = cs[i-1];
dfs0(1, 0);
dfs1(1, 0, false);
for (int i = 1; i <= n; i++) printf("%d%c", ans[i], " \n"[i == n]);
return 0;
}
运行输出:
3 2 2 1 1 1 1
手算验证:子树 1 含颜色 {1,2,3} → 3;子树 2 = {节点2,4,5},颜色 {2,3} → 2;子树 3 = {3,6,7},颜色 {1,3} → 2;子树 4/5/7 单节点 → 1;子树 6 = {6,7},颜色 {3} → 1。全部吻合。
💡 dsu on tree 的适用信号: "对每个节点统计子树内的信息 + 信息不易用数据结构合并(颜色种数、出现次数最多的颜色的和、合法路径条数等)+ 无修改操作(离线)。三者齐备时,它是代码量最小的 O(N log N) 解法——经典题 Lomsat gelral(CF600E,子树众数颜色之和)就是模板题。
5.12.5 三种树上工具对比
| 工具 | 前置 | 预处理 | 单次操作 | 支持修改 | 适用场景 |
|---|---|---|---|---|---|
| 重链剖分 + 线段树(本章) | 线段树 5.7 | O(N) | 路径 O(log² N) | ✅ 单点/区间 | 在线的路径查询与修改 |
| 欧拉序 + BIT(5.13 章) | BIT 5.8 | O(N) | 子树 O(log N) | ✅ | 只需子树查询、代码要短 |
| dsu on tree(本章) | 无需数据结构 | — | 全部 O(N log N) 预处理完 | ❌ 仅离线 | 每个节点的子树统计,信息难合并 |
选择口诀:
- 问路径 + 要在线修改 → 重链剖分;
- 只问子树 + 修改简单 → 欧拉序 + BIT(代码短、常数小);
- 对每个节点都要子树答案 + 信息难合并 + 无修改 → dsu on tree。
⚠️ 常见错误
-
跳链比较写反:
if (dep[top[u]] < dep[top[v]]) swap(u, v);的目的是让 u 的链顶更深(先跳深的)。写成dep[top[u]] > dep[top[v]]会导致跳过 LCA、答案错乱。同理,同链后取dep[u] > dep[v]时swap后u是 LCA——别把方向搞反。 -
线段树用原编号而不是 dfn 序:
build时叶节点权值应是val[rnk[l]],单点修改的位置是dfn[u]而不是u。树剖把树"重排"了,线段树维护的是 dfn 序上的序列。 -
dfs2 忘了重儿子优先: 先递归轻儿子再递归重儿子,链上 DFS 序不连续,查询区间全是错的。
dfs2(son[u], t)必须放在轻儿子循环之前。 -
dsu on tree 忘了清轻儿子: 第 1 步递归轻儿子必须传
keep=false,否则cnt[]里残留着轻儿子子树的颜色,父节点的统计会重复计数。 -
清空用 memset 而不是按子树大小遍历:
keep=false时清空必须for (i = L[u]; i <= R[u]; i++) del(Node[i]);——只花 O(子树大小)。若对整个cnt[]做memset,每次是 O(值域),总复杂度退化成 O(N · 值域),直接超时。
📋 章节小结
📌 核心要点
| 概念 | 说明 |
|---|---|
| 树的重心 | 删除后最大子树最小的节点;一次 DFS,O(N) |
| 重儿子 / 重边 / 重链 | 子树最大的儿子;重边连成链;每点恰属一条链 |
| 两次 DFS | dfs1 求 fa/dep/sz/son;dfs2 重儿子优先求 top/dfn/rnk |
| 路径 = O(log N) 段区间 | 轻边使子树减半;路径可拆成 O(log N) 条连续链段 |
| 跳链查询 | 深链顶先跳,u = fa[top[u]];同链后一次区间操作 |
| dsu on tree | 轻儿子算完就清、重儿子保留;O(N log N);仅离线 |
❓ 常见问题
Q:重链剖分和第 5.13 章的欧拉序有什么区别?
A:欧拉序只保证子树是连续区间;重链剖分用"重儿子优先"的 DFS,额外保证每条重链也是连续区间,所以能处理路径。
Q:跳链求 LCA 和倍增 LCA 用哪个?
A:写了树剖就顺手用跳链——不用额外数组、常数更小;没写树剖就用倍增。两者查询都是 O(log N)。
Q:dsu on tree 能处理带修改的问题吗?
A:不能(标准形式)。需要在线修改时考虑 HLD + 数据结构,或更高级的树上莫队。
🔗 与后续章节的联系
- [第 5.13 章(欧拉游览): 子树查询的轻量方案;HLD 是它的超集。
- Platinum 点分治: 以树的重心递归分割,把路径问题降到 O(N log² N)——本章 5.12.1 是直接前置。
- [第 5.7 章(线段树): HLD 的"发动机",区间合并的性质决定能维护什么信息。
🏋️ 练习题
🟢 简单
5.12-E1. 找重心
给定 N 个节点的树,输出树的重心节点编号(若有多个,输出编号最小的)。
数据规模: 1 ≤ N ≤ 10⁵。
提示
一次 DFS 求 sz[],对每个 u 计算 max(最大儿子子树, N - sz[u]),取最小者。见 5.12.1 的代码。
🟡 中等
5.12-M1. 路径最大值 (USACO 风格)
N 个节点的带权树。两种操作:CHANGE x w 修改点权;QMAX u v 查询 u 到 v 路径上点权的最大值。
数据规模: N ≤ 3×10⁴,操作数 Q ≤ 2×10⁵,权值 ≤ 10⁹。
提示
把 5.12.3 的线段树换成"区间最大值"(第 5.7 章的 max 变体),pathSum 改为 pathMax:跳链时对每段区间取 max。注意初始答案用极小值 -INF 而不是 0。
🔴 困难
5.12-H1. 子树颜色数 (CF600E / 数颜色)
N 个节点的有根树,节点 u 有颜色 c[u]。对每个节点 u,求 u 的子树中出现次数最多的颜色编号之和(多个颜色并列时全加)。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ c[u] ≤ N。
提示
dsu on tree 模板变体:维护 cnt[color] 和 maxCnt,另开一个 sum[maxCnt] 数组记录"出现恰好 maxCnt 次的颜色编号和"。add 时更新 maxCnt 与 sum;del 时注意 sum 的回退(maxCnt 只减不增地维护即可,清空时统一重置)。答案 = ans[u] = sum[maxCnt]。
第 5.13 章:欧拉游览与树的展开
欧拉游览(又称 DFS 序或重链剖分线性化)是将树展开为线性数组的技术。展开后,子树查询变为数组上的区间查询——用树状数组或线段树可在 O(log N) 内求解。
本章还介绍用于 LCA(最近公共祖先)的倍增,它能在 O(log N) 时间内解决树上路径查询。
学习目标:
- 实现带进/出时间戳的 DFS 序欧拉游览
- 用游览结果将子树查询转化为数组区间查询
- 实现倍增 LCA:O(N log N) 预处理 + 每次查询 O(log N)
- 结合欧拉游览 + LCA 高效回答路径查询
5.13.0 动机:为什么要展开树?
假设有一棵树,需要:
- 更新 v 子树中所有顶点的值
- 查询 v 子树中所有顶点的值之和
仅用 DFS,最坏情况下每次操作需 O(N)。但若将 v 的子树转化为连续的数组区间 [in[v], out[v]],就可以用 BIT 或线段树,每次操作 O(log N)。
欧拉游览恰好提供了这种能力: 子树与连续区间之间的一一映射。
5.13.1 DFS 进/出时间戳(欧拉游览)
为每个顶点分配两个时间戳:
in[v]:DFS 第一次访问 v 时的时间("进入时刻")out[v]:DFS 完成 v 的子树时的时间("退出时刻")
关键性质: 顶点 u 在顶点 v 的子树中,当且仅当 in[v] ≤ in[u] ≤ out[v]。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
int in_time[MAXN], out_time[MAXN];
int order[MAXN]; // order[i] = 第 i 个被访问的顶点
int timer_val = 0;
void dfs(int u, int par) {
in_time[u] = ++timer_val; // 记录进入时刻
order[timer_val] = u; // 记录该位置对应的顶点
for (int v : adj[u]) {
if (v != par)
dfs(v, u);
}
out_time[u] = timer_val; // 记录退出时刻(等于或晚于 in_time)
}
示例:
📄 Code 完整代码
树(以 1 为根): DFS 顺序: 进/出时刻:
1 访问 1 in[1]=1, out[1]=7
/|\ 访问 2 in[2]=2, out[2]=4
2 5 7 访问 4 in[4]=3, out[4]=3
/| \ 返回 2
4 3 6 访问 3 in[3]=4, out[3]=4
返回 1
访问 5 in[5]=5, out[5]=6
访问 6 in[6]=6, out[6]=6
返回 1
访问 7 in[7]=7, out[7]=7
顶点 2 的子树 = {2, 4, 3} → 区间 [2, 4] ✓ (in[2]=2, out[2]=4)
顶点 5 的子树 = {5, 6} → 区间 [5, 6] ✓ (in[5]=5, out[5]=6)
顶点 1 的子树 = 全部 → 区间 [1, 7] ✓ (in[1]=1, out[1]=7)
5.13.2 用 BIT/线段树处理子树查询
得到欧拉游览结果后,可以将顶点值映射到数组位置,并用树状数组处理区间查询。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
int in_time[MAXN], out_time[MAXN];
int val[MAXN]; // 顶点值
int flat[MAXN]; // flat[i] = 欧拉游览第 i 个位置对应顶点的值
int timer_val = 0;
// ── 树状数组(BIT),支持区间求和 ─────────────────
long long bit[MAXN];
int n;
void bit_update(int i, long long delta) {
for (; i <= n; i += i & (-i))
bit[i] += delta;
}
long long bit_query(int i) {
long long s = 0;
for (; i > 0; i -= i & (-i))
s += bit[i];
return s;
}
long long bit_range(int l, int r) {
return bit_query(r) - bit_query(l - 1);
}
// ── 欧拉游览 DFS ────────────────────────────────────
void dfs(int u, int par) {
in_time[u] = ++timer_val;
flat[timer_val] = val[u]; // 将顶点值放到游览对应位置
for (int v : adj[u]) {
if (v != par) dfs(v, u);
}
out_time[u] = timer_val;
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n;
for (int i = 1; i <= n; i++) cin >> val[i];
for (int i = 0; i < n - 1; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
dfs(1, 0);
// 用 flat 数组初始化 BIT
for (int i = 1; i <= n; i++)
bit_update(i, flat[i]);
// 查询示例:
// 顶点 v 的子树和:
int v;
cin >> v;
cout << bit_range(in_time[v], out_time[v]) << "\n";
// 将顶点 u 的值增加 delta:
int u; long long delta;
cin >> u >> delta;
bit_update(in_time[u], delta);
return 0;
}
复杂度:
- 预处理:O(N) DFS + O(N log N) BIT 初始化
- 子树查询:O(log N)
- 单点更新(顶点 v):O(log N)——在位置
in_time[v]更新 - 子树更新(给 v 子树中所有顶点加 delta):用差分 BIT,在
in_time[v]和out_time[v]+1处更新
5.13.3 最近公共祖先(LCA)
两个顶点 u 和 v 的 LCA 是同时为它们祖先的最深顶点。
树: LCA(4, 6) = 2
1 LCA(4, 7) = 1
/ \ LCA(5, 3) = 2
2 7
/ \
3 4
/
5
|
6
LCA 有许多应用:
- u 和 v 之间的距离: dist(u, v) = depth[u] + depth[v] - 2·depth[LCA(u,v)]
- 路径查询: u 到 v 路径上的查询可以用 LCA + 欧拉游览来回答
倍增 LCA
预处理: 对每个顶点 v,预计算 up[v][k] = v 的第 2^k 个祖先。
up[v][0] = parent(v) (直接父节点)
up[v][1] = parent(parent(v)) (祖父节点)
up[v][2] = 往上 2 步
...
up[v][k] = up[up[v][k-1]][k-1]
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
const int LOG = 17; // 2^17 > 10^5
vector<int> adj[MAXN];
int up[MAXN][LOG]; // up[v][k] = v 的第 2^k 个祖先
int depth[MAXN];
void dfs(int u, int par, int d) {
depth[u] = d;
up[u][0] = par; // 直接父节点
// 填充倍增表
for (int k = 1; k < LOG; k++) {
up[u][k] = up[up[u][k-1]][k-1];
// 第 2^k 个祖先 = 第 2^(k-1) 个祖先的第 2^(k-1) 个祖先
}
for (int v : adj[u]) {
if (v != par)
dfs(v, u, d + 1);
}
}
// 求 u 和 v 的 LCA
int lca(int u, int v) {
// 第 1 步:将 u 和 v 提升到同一深度
if (depth[u] < depth[v]) swap(u, v);
int diff = depth[u] - depth[v];
for (int k = 0; k < LOG; k++) {
if ((diff >> k) & 1) // 若 diff 的第 k 位为 1
u = up[u][k]; // 向上跳 2^k 步
}
// 现在 depth[u] == depth[v]
if (u == v) return u; // u 在 v 的子树中(或反之)
// 第 2 步:同时对 u 和 v 二分倍增,找 LCA
for (int k = LOG - 1; k >= 0; k--) {
if (up[u][k] != up[v][k]) { // 若祖先不同则向上跳
u = up[u][k];
v = up[v][k];
}
}
return up[u][0]; // 当前位置再往上一步 = LCA
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, q;
cin >> n >> q;
for (int i = 0; i < n - 1; i++) {
int u, v;
cin >> u >> v;
adj[u].push_back(v);
adj[v].push_back(u);
}
// 初始化:根 = 1,根的父节点指向自身(哨兵)
up[1][0] = 1;
dfs(1, 1, 0);
while (q--) {
int u, v;
cin >> u >> v;
cout << lca(u, v) << "\n";
}
return 0;
}
复杂度: O(N log N) 预处理 + 每次 LCA 查询 O(log N)。
两顶点之间的距离
int dist(int u, int v) {
return depth[u] + depth[v] - 2 * depth[lca(u, v)];
}
5.13.4 欧拉游览 + LCA 处理路径查询
问题: 每个顶点有一个值,回答 Q 次查询:"从 u 到 v 路径上所有顶点的值之和"。
方法: 定义 prefix[v] = 根到 v 路径上所有顶点的值之和,则:
path_sum(u, v) = prefix[u] + prefix[v] - prefix[LCA(u,v)] - prefix[parent(LCA(u,v))]
当值需要动态更新时,需要以 DFS 序为下标的 BIT——这正是欧拉游览的作用。
// 用前缀和 + LCA 求 path_sum(u, v)
// 定义:prefix[v] = 根到 v 的路径上所有顶点值之和(含两端)
// 则:path_sum(u,v) = prefix[u] + prefix[v] - prefix[lca] - prefix[parent[lca]]
long long path_sum(int u, int v) {
int l = lca(u, v);
return prefix[u] + prefix[v] - prefix[l] - prefix[up[l][0]];
// ↑ LCA 的父节点
}
5.13.5 USACO Gold 欧拉游览题型模式
模式 1:子树更新 + 查询
"对 v 子树中的所有顶点值加 x。查询所有顶点的总和。"
欧拉游览将子树映射到区间 [in[v], out[v]]。使用区间更新的 BIT(懒惰传播或 BIT 差分数组)。
模式 2:带更新的路径和
"更新顶点 v 的值。查询 u 到 w 路径上的总和。"
LCA + 前缀和 + 以 DFS 序为下标的 BIT。
模式 3:基于 LCA 区间的欧拉游览
在欧拉游览中,当 in[u] ≤ in[v] 时,区间 [in[u], in[v]] 恰好包含 u 到 v 路径上的顶点(还有一些额外的,取决于 u 是否是 v 的祖先)。用于高级 LCA 变体。
5.13.6 预览:重链剖分(HLD)
欧拉游览 + LCA 的组合能处理大多数 Gold 级别的树题。但有一类问题需要对路径进行区间更新和查询——而不仅仅是子树。标准的欧拉游览对此不够用。
重链剖分(HLD) 是 Platinum 级别处理此类问题的技术,它直接建立在欧拉游览的概念上。
HLD 解决的问题
"给定 N 个顶点的树,处理 Q 次查询,每次为以下两种之一:
update(u, v, delta):给 u 到 v 路径上所有顶点加 deltaquery(u, v):返回 u 到 v 路径上所有顶点的总和"
欧拉游览能高效处理子树更新/查询,但跨树的路径查询需要 HLD 的 O(log²N)。
核心思路
通过始终沿"重子节点"(子树最大的子节点)将树分解为重链,可以保证:
- 任意根到叶路径最多经历 O(log N) 次链的切换
- 每条链在 DFS 序中是连续区间
- 路径查询 = 对各段链的 O(log N) 次区间查询 → 配合线段树为 O(log²N)
📄 Code 完整代码
重子节点:子树最大的子节点
重路径:从某顶点沿重子节点向下到叶节点的链
树: sz[] 值: 重边(→):
1 (sz=7) 7
/ \ / \
2 3 (sz=4) 3 4
/ \ / \ / \ / \
4 5 6 7 1 1 2 1
重子节点:1→3 (sz=4 > sz=3), 3→6 (sz=2 > sz=1)
重链:{1, 3, 6}、{2}、{4}、{5}、{7}
HLD 实现草图(仅供参考)
// 重链剖分 — O(N log N) 预处理,O(log²N) 路径查询
// 完整实现是 Platinum 级别;以下是概念性草图
int heavy[MAXN]; // heavy[v] = v 的重子节点(叶节点为 -1)
int head[MAXN]; // head[v] = v 所在重链的顶端节点
int pos[MAXN]; // pos[v] = v 在 HLD 展开数组中的位置
int cur_pos = 0;
// 第 1 步:找重子节点(需先用树形 DP 计算 sz[])
void find_heavy(int u, int par) {
sz[u] = 1;
heavy[u] = -1;
int max_sz = 0;
for (int v : adj[u]) {
if (v == par) continue;
find_heavy(v, u);
sz[u] += sz[v];
if (sz[v] > max_sz) {
max_sz = sz[v];
heavy[u] = v; // v 是重子节点
}
}
}
// 第 2 步:沿重链分配位置
void decompose(int u, int par, int h) {
head[u] = h; // 链头
pos[u] = cur_pos++; // 在展开数组中的位置
if (heavy[u] != -1)
decompose(heavy[u], u, h); // 延续重链
for (int v : adj[u]) {
if (v == par || v == heavy[u]) continue;
decompose(v, u, v); // 从 v 开始新链
}
}
// 第 3 步:利用 LCA + 链跳转进行路径查询
long long path_query(int u, int v) {
long long result = 0;
while (head[u] != head[v]) {
if (depth[head[u]] < depth[head[v]]) swap(u, v);
// u 的链头更深;查询 pos[head[u]]..pos[u]
result += seg_query(pos[head[u]], pos[u]);
u = parent[head[u]]; // 跳到链头的父节点
}
// 现在 u 和 v 在同一条链上
if (depth[u] > depth[v]) swap(u, v);
result += seg_query(pos[u], pos[v]); // 查询链上该段
return result;
}
复杂度:
- 预处理:
find_heavyO(N) +decomposeO(N) = O(N) - 路径查询:O(log N) 次链切换 × O(log N) 线段树 = O(log²N)
📘 何时用 HLD vs 欧拉游览:
- 子树查询/更新 → 欧拉游览 + BIT(O(log N))
- 路径查询/更新,无区间更新 → LCA + 前缀和(O(log N))
- 路径区间更新 + 区间查询 → HLD + 线段树(O(log²N)) ← Platinum 级别
关键结论:本章的所有内容(欧拉游览、LCA、倍增)都是 HLD 的先修知识。掌握第 5.13 章后,HLD 是自然而然的延伸。
💡 思路陷阱
陷阱 1:把"路径查询"误用欧拉序(应用 LCA)
错误判断: "欧拉序把树压成数组,路径查询 u→v 就是 [in[u], in[v]] 区间查询"
实际情况: 欧拉序只保证子树对应连续区间,路径不是连续区间
树:1-2-3-4(链),欧拉序:in[1]=1, in[2]=2, in[3]=3, in[4]=4
查询路径 1→4 看起来是 [1,4],但路径 2→4 是 [2,4] ——偶然正确
查询路径 3→1(往上走):in[3]=3, in[1]=1,区间 [1,3] 包含节点 2,
而 2 不在 3→1 的路径上 ← 错误!
正确方法:path_sum(u,v) = prefix[u] + prefix[v] - prefix[LCA] - prefix[parent(LCA)]
识别信号: 查询涉及两点之间的路径(非子树) → 必须用 LCA 分解,不能直接用欧拉游览区间
陷阱 2:LCA 倍增时 LOG 取值过小
错误判断: "树最多 10⁴ 个节点,LOG=13 够了(2^13=8192 > 10⁴/2)"
实际情况: 需要 2^LOG > N,对于 N=10⁴ 需要 LOG=14(2^14=16384)
// 安全做法:LOG 永远用 ceil(log2(N)) + 1,或直接用 20 覆盖 10^6
const int LOG = 20; // 2^20 = 1048576,覆盖 N≤10^6 的所有情形
// 不要"精确计算",用大一点的常数不会影响复杂度
识别信号: LCA 在深链上得到错误答案 → 检查 LOG 是否足够大
⚠️ 常见错误
-
LOG 取值有误: N ≤ 10⁵ 时用
LOG = 17(2^17 = 131072 > 10⁵);N ≤ 10⁶ 时用LOG = 20。 -
根节点的父节点哨兵: 根节点没有父节点。将
up[root][0] = root(指向自身),避免倍增时越界。 -
欧拉游览计时器的差一: 若 BIT 是 1-indexed,则计时器从 1 开始(而非 0)。
-
路径和公式出错: 注意要减去
prefix[parent(LCA)],而非prefix[LCA]。LCA 顶点本身在路径上,应被计入一次。 -
LCA 算法假设树有根: 倍增是在固定根的基础上建立的。若题目没有指定根,选一个(通常是顶点 1)。
📋 章节小结
📌 核心要点
| 概念 | 说明 |
|---|---|
| 欧拉游览 | DFS 时间戳 in[v], out[v];v 的子树 = 区间 [in[v], out[v]] |
| 子树查询 | 映射为数组区间查询;用 BIT/线段树;O(log N) |
| 倍增 | up[v][k] = v 的第 2^k 个祖先;O(N log N) 预处理 |
| LCA | 深度对齐后二分查找分叉点;O(log N) |
| 距离 | dist(u,v) = depth[u] + depth[v] - 2·depth[LCA(u,v)] |
| 路径和 | prefix[u] + prefix[v] - prefix[LCA] - prefix[parent(LCA)] |
❓ 常见问题
Q:存在 O(1) 的 LCA 算法吗?
A:有——对特殊欧拉游览应用 RMQ(区间最值查询)可以在 O(N log N) 预处理后实现 O(1) 查询。但 USACO Gold 中 O(log N) 的倍增已完全够用。
Q:如果树以无向图形式给出(没有指定根)怎么办?
A:以顶点 1 为根。根的选择不影响 LCA 算法的正确性,只影响 depth[] 的值。
Q:欧拉游览可以用于边权树吗?
A:可以。将边权赋给下方端点(子节点)。路径查询方式相同,但公式改为 prefix[u] + prefix[v] - 2*prefix[LCA](不减 parent(LCA),因为 LCA 顶点承载的是它到父节点的边权)。
🔗 与后续章节的联系
- Platinum:重链剖分(HLD): HLD 将树分解为链,再用欧拉游览 + 线段树实现 O(log²N) 的带区间更新的路径查询。
- 第 6.8 章(树形 DP): LCA 允许"在线"回答树形 DP 查询——无需离线处理即可处理路径查询。
- 第 5.7 章(线段树): 当 BIT 不支持带懒惰传播的区间更新时,用懒惰线段树替代 BIT。
🏋️ 练习题
🟢 简单
5.13-E1. 子树和查询
给定每个顶点有值的树,回答 Q 次查询:"顶点 v 的子树中所有顶点的值之和是多少?"
提示
计算欧拉游览(进/出时刻)。对 DFS 序建立前缀和数组。查询为 prefix[out[v]] - prefix[in[v] - 1],复杂度 O(N + Q)。
5.13-E2. LCA 基础
给定 N 个顶点的树,回答 Q 次查询:"u 和 v 的 LCA 是什么?"
提示
使用 5.13.3 节的倍增模板。O(N log N) 预处理,每次查询 O(log N)。
🟡 中等
5.13-M1. 距离查询
给定 N 个顶点、单位边权的树,回答 Q 次查询:"顶点 u 和顶点 v 之间的距离是多少?"
提示
dist(u, v) = depth[u] + depth[v] - 2 * depth[LCA(u, v)]。用倍增求 LCA。
5.13-M2. 子树更新 + 查询 (USACO 风格)
给定一棵树,处理 Q 次操作:
update v delta:给 v 子树中所有顶点加deltaquery v:返回顶点 v 的当前值
提示
欧拉游览将 v 的子树映射为区间 [in[v], out[v]]。使用差分 BIT:O(log N) 区间更新,O(log N) 单点查询。
🔴 困难
5.13-H1. 带更新的路径查询 (USACO Gold 难度)
给定带权树,处理 Q 次操作:
update u val:将顶点 u 的值设为 valquery u v:u 到 v 路径上所有顶点的值之和
提示
LCA + 欧拉游览路径和。对于动态更新,用以 DFS 序为下标的 BIT 维护前缀和。path_sum(u, v) = bit_prefix(in[u]) + bit_prefix(in[v]) - bit_prefix(in[lca]) - bit_prefix(in[parent(lca)])。
🏆 挑战
5.13-C1. 统计经过某顶点的路径数 (困难)
给定一棵树。对每个顶点 v,统计满足"v 在 u 到 w 路径上"的路径 (u, w) 的数量(含 u=v 或 w=v 的情形)。
提示
对固定的 v,路径 (u, w) 经过 v 当且仅当 LCA(u, w) = v,或 LCA(u, v) = v,或 LCA(v, w) = v。使用欧拉游览 + 计数:v 的答案等于 C(sz[v], 2) 减去完全在 v 某棵子树内的路径数。这需要对 v 各子节点的子树大小进行仔细的容斥。
第 5.15 章:树上差分与点分治
5.15.0 从一道题出发:货运路径上的"距离恰好为 k"
先看一道 USACO 风格的题:
🚚 题目:货运路径 Farmer John 的农场有
N个牧场(N ≤ 4×10⁴),由N-1条道路连接成一棵树,每条道路长度为 1。 接下来有Q次询问(Q ≤ 100),每次给出一个整数k(k ≤ 2×10⁴),询问:树上距离恰好为 k 的无序点对 (u, v) 有多少个(u < v,两点可以相同则 u = v 时不计)。
先试试你会的方法
思路 1:每次询问 BFS 全树。 对每个 k,从每个点出发 BFS 一遍,数出距离为 k 的点。一次询问 O(N²)(或 O(N·k)),Q 次就是天文数字——超时。
思路 2:枚举所有点对求 LCA 算距离? C(N, 2) ≈ 8×10⁸ 对,每对还要 O(log N) 求 LCA——也超时。
思路 3:DP? "距离恰好为 k"涉及两段路径拼起来(u → lca → v),状态里"经过哪个分叉点"没法省掉,普通树形 DP(第 6.8 章)做不了任意 k 的全局计数。
关键观察: 问题的形态决定了武器——
- 如果修改/询问是**"先一堆路径修改、最后统一查询"(离线一次性),那就像数组差分一样,可以在树上做差分**:O(1) 给一条路径整体 +1,最后 O(N) 还原。
- 如果是**"全局统计所有点对"(本题!),那要用点分治**:每次挑树的重心,把所有路径按"是否经过重心"分成两类,层层分治下去。
本章讲这两个技术。它们共用同一块基石——第 5.13 章的倍增 LCA,以及第 5.12 章 5.12.1 节的树的重心。
拆解这一章需要回答的问题
- 怎么把"路径整体 +1"变成 4 个单点修改?→ 5.15.1:树上差分
- 全局路径统计为什么从重心开始?→ 5.15.2:点分治思想
- 「距离为 k 的点对数」完整代码 → 5.15.3:排序 + 双指针 + 容斥
- 还能问什么变形?→ 5.15.4:点分治变形一览
学习目标:
- 掌握点差分与边差分的修改公式与"子树求和还原"
- 理解点分治"选重心保证分治规模减半"的复杂度证明
- 独立实现「距离为 k 的点对数」,并会用容斥去重
- 分清树上差分(离线修改)与 HLD(在线查询)的适用边界
5.15.1 树上差分:路径修改的 O(1) 写法
回顾:数组差分
数组上想给区间 [l, r] 整体 +1,可以 diff[l]++, diff[r+1]--,最后扫一遍前缀和就还原出每个位置的真实值。核心是:修改打到端点上,求和时自然"摊开"。
树上差分做同样的事,只是"区间"换成了路径,"前缀和"换成了子树和。
点差分:路径上每个点 +1
先看公式。设 p = lca(u, v),fa[p] 是 p 的父节点。要让路径 u → p → v 上的每个节点权值 +1:
diff[u]++ diff[v]++ diff[p]-- diff[fa[p]]--
为什么是对的?还原时对每个节点算以它为根的子树内 diff 之和:
1 路径 4 → 5(lca = 2):
/ \ diff[4]++ diff[5]++ diff[2]-- diff[1]--
2 3
/ \ 还原(子树和):1:0 2:1 3:0 4:1 5:1
4 5 恰好路径 {4,2,5} 上的点 = 1 ✓
直观理解:点 x 的子树和 = "子树里所有 diff 修改,对 x 的净影响"。diff[u]++ 从 u 出发向上影响 u 到根的每个点;diff[p]-- 在 p 处把这份影响截断——但它自己也被抵消了,所以再给 fa[p]--……不对,是 fa[p]-- 会多减一次 p 之上的部分,正好把 diff[u]、diff[v] 中越过 p 的部分全部抵消。画图验证:u 子树和里包含 u 的 +1(u 在自己子树里 ✓),p 的子树和包含 4、5 的 +1 和 2 的 -1,净 +1 ✓,而 1 的子树和包含 +1+1-1-1 = 0 ✓。
边差分:路径上每条边 +1
树的边不好单独编号打标记,所以我们把每条边挂在它深度较大的端点上("这条边通向我的父亲")。要让路径 u → v 上的每条边 +1:
diff[u]++ diff[v]++ diff[p] -= 2
验证(同上图,路径 4 → 5,lca = 2):
diff[4]++ diff[5]++ diff[2]-=2
还原(子树和,即"我挂的那条边的真实经过次数"):
边(1-2): 挂在 2 上,2 的子树和 = 1+1-2 = 0 ✓(路径不经过它)
边(2-4): 挂在 4 上,4 的子树和 = 1 ✓
边(2-5): 挂在 5 上,5 的子树和 = 1 ✓
与点差分的区别:p 自己也被 lca 处的 -1 抵消了"向父亲那条边"的份额,所以直接 -= 2 一次搞定,不需要动 fa[p]。
完整代码:路径加 + 最后查询每个点/每条边的经过次数
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005, LOG = 17;
int n;
vector<pair<int,int>> adj[MAXN]; // (邻居, 边编号)
int dep[MAXN], fa[LOG][MAXN];
int diffPoint[MAXN]; // 点差分
int diffEdge[MAXN]; // 边差分:挂在"深度较大端点"上
void dfs(int u, int f) {
dep[u] = dep[f] + 1;
fa[0][u] = f;
for (int j = 1; j < LOG; j++) fa[j][u] = fa[j-1][fa[j-1][u]];
for (auto [v, id] : adj[u]) {
if (v == f) continue;
dfs(v, u);
}
}
int lca(int u, int v) {
if (dep[u] < dep[v]) swap(u, v);
for (int j = LOG-1; j >= 0; j--)
if (dep[fa[j][u]] >= dep[v]) u = fa[j][u];
if (u == v) return u;
for (int j = LOG-1; j >= 0; j--)
if (fa[j][u] != fa[j][v]) { u = fa[j][u]; v = fa[j][v]; }
return fa[0][u];
}
// 路径 u-v 上每个点经过次数 +1(点差分)
void addPathPoint(int u, int v) {
int p = lca(u, v);
diffPoint[u]++; diffPoint[v]++;
diffPoint[p]--; diffPoint[fa[0][p]]--;
}
// 路径 u-v 上每条边经过次数 +1(边差分)
void addPathEdge(int u, int v) {
int p = lca(u, v);
diffEdge[u]++; diffEdge[v]++; diffEdge[p] -= 2;
}
int cntPoint[MAXN], cntEdge[MAXN]; // 子树求和还原后的结果
void collect(int u, int f) {
cntPoint[u] = diffPoint[u];
cntEdge[u] = diffEdge[u];
for (auto [v, id] : adj[u]) {
if (v == f) continue;
collect(v, u);
cntPoint[u] += cntPoint[v];
cntEdge[u] += cntEdge[v];
}
}
int main() {
// 测试树:
// 1
// / \
// 2 3
// / \ \
// 4 5 6
n = 6;
int us[] = {1,1,2,2,3}, vs[] = {2,3,4,5,6};
for (int i = 0; i < 5; i++) {
adj[us[i]].push_back({vs[i], i});
adj[vs[i]].push_back({us[i], i});
}
dfs(1, 0);
// 3 条路径:2->6(2-1-3-6)、4->5(4-2-5)、1->6(1-3-6)
addPathPoint(2, 6); addPathPoint(4, 5); addPathPoint(1, 6);
addPathEdge(2, 6); addPathEdge(4, 5); addPathEdge(1, 6);
collect(1, 0);
// 手算期望:
// 点:1:2 2:2 3:2 4:1 5:1 6:2
// 边:(1-2):1 (1-3):2 (2-4):1 (2-5):1 (3-6):2
printf("点经过次数:");
for (int u = 1; u <= n; u++) printf("%d=%d ", u, cntPoint[u]);
printf("\n边经过次数:");
for (int i = 0; i < n-1; i++) {
int a = us[i], b = vs[i];
int child = dep[a] > dep[b] ? a : b; // 边挂在深度较大的端点
printf("(%d-%d)=%d ", us[i], vs[i], cntEdge[child]);
}
printf("\n");
return 0;
}
运行输出:
点经过次数:1=2 2=2 3=2 4=1 5=1 6=2
边经过次数:(1-2)=1 (1-3)=2 (2-4)=1 (2-5)=1 (3-6)=2
与手算完全一致。collect 就是一次 DFS 求子树和,复杂度 O(N)。
与树链剖分(第 5.12 章)对比
| 工具 | 修改路径 | 查询 | 支持在线? | 复杂度 | 代码量 |
|---|---|---|---|---|---|
| 树上差分(本章) | O(log N)(求一次 LCA) | ❌ 只能最后 O(N) 统一还原 | ❌ 离线 | O(N + Q log N) | ~40 行 |
| 重链剖分 + 数据结构(5.12 章) | O(log² N) | ✅ 随时查 | ✅ 在线 | O((N + Q) log² N) | ~150 行 |
选择口诀: 题目如果是"先给一堆路径操作、最后问每个点/边的累计值"(USACO 常见的"流量统计"型),树上差分是最快的答案;一旦需要边修改边查询,差分立刻失效,只能上 HLD。
5.15.2 点分治:从重心开始的全局统计
回到开篇题:统计全树所有距离为 k 的点对。树上差分帮不上忙——它处理"路径修改",这里要的是"路径计数"。
核心观察:经过根的路径 + 不经过的路径
随便选个节点 rt 当根。任何一条路径必然属于且仅属于下面两类之一:
- 经过 rt——可以拆成"u 到 rt"和"rt 到 v"两条链,在 rt 处统计;
- 不经过 rt——它完整落在 rt 的某一棵子树里,递归处理。
这两类不重不漏:一条路径要么经过 rt 要么不经过。递归的每一层把"经过当前根"的部分统计掉,剩下的交给子树——这就是点分治。
为什么必须选重心?
递归深度取决于子树规模。随便选根(比如树的端点),树是一条链时每次只切掉 1 个点,递归 N 层,每层 DFS 整棵树,总复杂度 O(N²)——退化成暴力。
选重心(5.12.1 节)就不同了:重心保证每棵子树 ≤ 总规模的一半。于是每层分治,连通块规模至少减半:
N → N/2 → N/4 → ... → 1 共 O(log N) 层
每一层内,所有连通块的 DFS 加起来恰好处理每个点一次(O(N)),所以总复杂度 O(N log N)。这就是"点分治"名字里"分"的含金量。
容斥去重:减去同一棵子树里的"假路径"
统计"经过 rt 的路径"时有个陷阱。设 rt 有两个孩子 a、b,子树 a 里有点 u、子树 a 里另有点 v。如果我们简单地"收集整个 rt 连通块内所有点到 rt 的距离,两两配对",dist(u) + dist(v) = k 时会把 u → rt → v 当成一条合法路径——但 u 到 v 的真实路径根本不经过 rt(它们在 a 的子树里,LCA 是 a 不是 rt)!这条路径会在递归 a 的子树时再被统计一次,重复了。
解决办法是容斥:
答案(经过 rt 的部分) = 所有链两两配对 − 同一棵子树内的链两两配对
同一棵子树内的配对被减掉后,剩下的恰好是"两条链来自不同子树"(真路径,LCA 恰为 rt)加上"一条链长为 0"(路径端点就是 rt)。注意:端点是 rt 的路径(链配对里 0 + k 的情形)不会被容斥误减——因为被减掉的配对里如果一边是 0(rt 自己),它到 rt 的距离 0 只会在"全部链"的数组里出现一次,不在任何子树的数组里。
💡 容斥口诀: 先把 rt 所有子树的距离混在一起数一遍,再逐个子树单独数一遍减掉。剩下的就是不重不漏的"经过 rt"。
5.15.3 完整实战:距离为 k 的点对数
框架
solve(u): // u 是当前连通块的重心
vis[u] = true // "删掉" u,之后所有 DFS 跳过它
all = {0} ∪ 各子树内所有点到 u 的距离
ans += count(all) // 经过 u 的所有点对(含 u 为端点)
for 每个孩子子树 s:
ans -= count(s 的距离) // 容斥:同子树内的假路径
for 每个还没删的连通块:
solve(该连通块的重心)
统计"距离和为 k 的对数":排序 + 双指针
把距离数组排序后,用相向双指针:a[i] + a[j] < k 时 i++,> k 时 j--,== k 时处理一段相等的值(左右各有多少个,乘起来),注意 a[i] == a[j] 时剩余全部相等,用组合数 C(cnt, 2)。
完整代码
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
int n;
vector<pair<int,int>> adj[MAXN]; // (邻居, 边权)
bool vis[MAXN]; // true = 已经当过分治中心("已删除")
int sz[MAXN], mxson[MAXN];
int K;
long long ans = 0;
// ---- 第 1 步:在"当前连通块"里找重心 ----
// sum = 当前连通块的总点数(注意不是整棵树的 n!)
int sum, root, rootMax;
void getRoot(int u, int fa) {
sz[u] = 1; mxson[u] = 0;
for (auto [v, w] : adj[u]) {
if (v == fa || vis[v]) continue;
getRoot(v, u);
sz[u] += sz[v];
mxson[u] = max(mxson[u], sz[v]);
}
mxson[u] = max(mxson[u], sum - sz[u]);
if (mxson[u] < rootMax) { rootMax = mxson[u]; root = u; }
}
int findRoot(int start, int total) {
sum = total; rootMax = INT_MAX; root = -1;
getRoot(start, 0);
return root;
}
// 统计一个还没删的连通块的大小
int calcSize(int u, int fa) {
int res = 1;
for (auto [v, w] : adj[u]) {
if (v == fa || vis[v]) continue;
res += calcSize(v, u);
}
return res;
}
// ---- 第 2 步:收集子树内所有点到分治中心的距离 ----
int dis[MAXN];
vector<int> cur; // 当前子树收集到的距离
void getDis(int u, int fa, int d) {
dis[u] = d;
cur.push_back(d);
for (auto [v, w] : adj[u]) {
if (v == fa || vis[v]) continue;
getDis(v, u, d + w);
}
}
// 排序 + 双指针:有序距离数组中和恰好为 K 的点对数
// 数组含 0(即"一个端点是分治中心"的链)
long long countPairs(const vector<int>& d) {
vector<int> a = d;
sort(a.begin(), a.end());
long long res = 0;
int i = 0, j = (int)a.size() - 1;
while (i < j) {
if (a[i] + a[j] == K) {
if (a[i] == a[j]) { // 剩下全部相等,C(cnt, 2)
long long c = j - i + 1;
res += c * (c - 1) / 2;
break;
}
int hi = i; while (hi + 1 <= j && a[hi + 1] == a[i]) hi++;
int lj = j; while (lj - 1 >= i && a[lj - 1] == a[j]) lj--;
res += (long long)(hi - i + 1) * (j - lj + 1);
i = hi + 1; j = lj - 1;
} else if (a[i] + a[j] < K) i++;
else j--;
}
return res;
}
// ---- 第 3 步:solve(u):统计"经过 u"的答案,然后递归子连通块 ----
void solve(int u) {
vis[u] = true;
// (a) 所有子树的距离混在一起 + 中心自己的 0
vector<int> all;
all.push_back(0); // u 自己(处理"端点是 u"的路径)
for (auto [v, w] : adj[u]) {
if (vis[v]) continue;
cur.clear();
getDis(v, u, w); // 子树 v 内所有点到 u 的距离
for (int d : cur) all.push_back(d);
}
ans += countPairs(all); // 经过 u 的所有点对
// (b) 容斥:减去"两端在同一棵子树"的假路径
for (auto [v, w] : adj[u]) {
if (vis[v]) continue;
cur.clear();
getDis(v, u, w);
ans -= countPairs(cur); // 它们会在更深层被重新统计
}
// (c) 递归处理每个还没被删的连通块
for (auto [v, w] : adj[u]) {
if (vis[v]) continue;
solve(findRoot(v, calcSize(v, u))); // 大小是当前连通块,不是 n!
}
}
int main() {
// 测试树(边权全 1):
// 1
// /|\
// 2 3 4
// /| \
// 5 6 7
// K = 3 时,距离恰为 3 的点对(暴力 Floyd 交叉验证):
// {2,7} {3,5} {3,6} {3,7} {4,5} {4,6} 共 6 对
n = 7; K = 3;
int us[] = {1,1,1,2,2,4}, vs[] = {2,3,4,5,6,7};
for (int i = 0; i < 6; i++) {
adj[us[i]].push_back({vs[i], 1});
adj[vs[i]].push_back({us[i], 1});
}
solve(findRoot(1, n));
printf("距离为 %d 的点对数 = %lld(期望 6)\n", K, ans);
return 0;
}
运行输出:
距离为 3 的点对数 = 6(期望 6)
代码要点逐条对账
vis[u]充当"删除":点分治里的"分治中心"处理完就永久删除,所有 DFS(getRoot/getDis/calcSize)遇到vis的点一律跳过——这等价于"删掉 u 后树分裂成若干连通块"。calcSize(v, u)而不是n:递归时连通块已经变小,找重心时"向上那部分"必须用当前连通块大小计算(见下方常见错误 3)。- 容斥只减不加:
(b)对每个子树单独数一遍并减掉。想验证正确性,可以在小树上跑一遍 Floyd 暴力对拍。
5.15.4 点分治变形一览
点分治是框架,框架不变,"统计经过根的路径"这一步按题意换:
| 变形 | 统计方法 | 备注 |
|---|---|---|
| 距离恰为 k 的点对数(本章 5.15.3) | 排序 + 双指针数 a[i]+a[j]==k | 多个询问 k 可换桶标记 |
| 距离 ≤ K 的点对数(P4178 Tree) | 排序后双指针:对每个 i 数 j 使 a[i]+a[j] ≤ K | 双指针单调移动,O(m log m) |
| 点权路径统计(如路径上点权之和为 k) | getDis 收集"点权和"而非边权和 | 桶/双指针按题意改 |
| 路径上是否存在某颜色/字符 | 状态压缩成位掩码收集 | 中心处按掩码配对 |
| 带修改的树上统计 | 点分树(把每次的重心连成新树,深度 O(log N)) | Platinum 内容,本章不展开 |
💡 识别信号: 看到"树上所有点对的路径满足……的计数/存在性"且 N ≤ 10⁵,几乎必然是点分治(或点分树)。
⚠️ 常见错误
-
点差分忘了
diff[fa[lca]]--、边差分减错位置: 点差分是 4 处修改diff[u]++ diff[v]++ diff[p]-- diff[fa[p]]--——少写最后一项,LCA 之上的所有点会被多算;边差分是diff[p] -= 2——写成两个-1没问题,但只减 1 次(照抄点差分)就错了。两个公式不要互相"半抄"。 -
点分治忘了
vis标记 / 删旧中心:vis[u] = true必须在统计之前打上,且getRoot、getDis、calcSize里都要if (vis[v]) continue;。漏掉任何一处,DFS 会穿过"已删除"的中心把别的连通块也扫进来——答案错、还可能死递归。 -
递归找重心时用整棵树的 N 而不是当前连通块大小:
getRoot里mxson[u] = max(mxson[u], sum - sz[u])的sum必须是当前连通块的点数。用全局n会导致找到的"重心"不对,最坏退化成 O(N²)——代码"看起来能过小样例"但大样例 TLE,极难排查。 -
容斥漏减(或重复减):
(a)步把所有子树距离混在一起统计后,(b)步必须对每个子树单独再统计并减掉。只做 (a) 不做 (b) 会把"LCA 不是当前中心"的路径多算;反过来,如果容斥数组里误含了中心自己的 0,会把"端点是中心"的合法路径误减——(b) 的数组来自getDis(v, u, w),天然不含中心,别手滑加进去。
📋 章节小结
📌 核心要点
| 概念 | 说明 |
|---|---|
| 点差分 | diff[u]++ diff[v]++ diff[lca]-- diff[fa[lca]]--;子树和还原每个点的经过次数 |
| 边差分 | diff[u]++ diff[v]++ diff[lca]-=2;差分挂在边的深度较大端点上 |
| 还原 | 最后一次 DFS 求子树和;O(N) 统一完成,不支持在线 |
| 点分治框架 | 路径 = 经过重心 + 不经过;统计前者,递归后者;不重不漏 |
| 选重心 | 子树 ≤ 规模一半 → 每层减半 → O(log N) 层 → 总 O(N log N) |
| 容斥 | 全部链配对数 − 同子树链配对数 = 恰经过中心的路径 |
| 排序双指针 | "距离和为/不超过 k 的对数"在有序距离数组上 O(m) 统计 |
❓ 常见问题
Q:树上差分和第 5.12 章的 HLD 什么时候用哪个?
A:题目是"一堆路径修改 + 最后统一查询" → 树上差分(代码 40 行,最快);需要"边修改边查询"(在线)→ HLD + 数据结构。
Q:点分治每次找重心,会不会找得很慢?
A:每层所有连通块的 DFS 总量是 O(当前总规模),而规模每层减半,所以所有层加起来 O(N log N)——找重心不额外增加复杂度。
Q:点分治能处理带负边权的树吗?
A:能。"距离"只是 DFS 收集的数,排序双指针对负数照样工作;只有最短路类算法(Dijkstra)才怕负权。
🔗 与其他章节的联系
- [第 5.12 章 5.12.1(树的重心): 点分治的复杂度支柱,本章直接引用其求重心代码。
- [第 5.13 章(倍增 LCA): 树上差分每次修改求 LCA 用它。
- [第 5.8 章(BIT): 若"距离为 k"改成"边权在 [a,b] 的路径数",点分治统计阶段可换 BIT 维护。
🏋️ 练习题
🟢 简单
5.15-E1. 道路流量 (USACO 风格)
N 个节点的树(N ≤ 10⁵)。给出 M 条运输路径 (u, v)(M ≤ 10⁵),最后询问:哪条边被经过的次数最多?输出该边及次数。
数据规模: 1 ≤ N, M ≤ 10⁵。
提示
边差分:对每条路径 diff[u]++ diff[v]++ diff[lca] -= 2,差分挂在边的深度较大端点。最后一次 DFS 求子树和即为每条边的经过次数,取最大。见 5.15.1。
🟡 中等
5.15-M1. 距离不超过 K 的点对 (P4178 Tree)
N 个节点的带权树,问距离 ≤ K 的无序点对有多少个。
数据规模: N ≤ 4×10⁴,K ≤ 2×10⁴,边权 ≤ 10³。
提示
框架与 5.15.3 完全一致,只把 countPairs 换成"排序后双指针数 a[i] + a[j] ≤ K 的对数":j 从右端出发,对每个 i 单调左移 j 直到满足,累加 j - i。容斥照旧。
🔴 困难
5.15-H1. 树上路径公共边计数 (USACO 风格)
N 个节点的树。给定 M 条路径 (u_i, v_i),对每条边 e,求有多少对路径同时经过 e。
数据规模: 1 ≤ N, M ≤ 10⁵。
提示
第一步用边差分求出每条边的经过次数 c[e](5.15.1);第二步注意到"经过 e 的路径对数 = C(c[e], 2)"——因为每条经过 e 的路径与其他任意一条经过 e 的路径都构成一对。所以答案就是每条边的 c[e]·(c[e]-1)/2。注意用 long long。
第 5.16 章:搜索专题(剪枝、迭代加深与 A*)
5.16.0 从一道题出发
🧩 题目:数一数 N 皇后 在 N×N 棋盘上放 N 个皇后,使得任意两个皇后不同行、不同列、不同对角线。问有多少种摆法。 数据规模:
1 ≤ N ≤ 13。
第 2.8 章的枚举思想立刻能用:每个皇后占一行,那么一个方案就是「第 i 行的皇后放在哪一列」的一个序列 (c₁, c₂, …, c_N)。最暴力的写法是枚举所有 13^13 种序列?不行,那约是 3×10¹⁴。聪明一点:同一行天然只放一个皇后,用 DFS 逐行放置,每行从 13 列里选一列——即使这样,最坏也有 13! ≈ 6.2×10⁹ 个完整排列:
第 1 行:13 种选法
第 2 行:12 种(排除同列)……
全排列数 13! ≈ 62 亿
按每秒 10⁸ 次运算,需要跑一分钟以上——超时。
但请你手动模拟前两行:第 1 行放列 0,第 2 行也放列 0?冲突,立刻失败。可朴素 DFS 还会继续往下放第 3、4、5……行,把整棵子树搜完才回头!问题的根源是:冲突在前 2 行就已注定,后面的 11 行全是白搜。
如果我们在每放一个皇后时就检查冲突、冲突立刻回溯,搜索树会在很浅的地方就被砍掉大片分支——这就是剪枝。加了剪枝的 N 皇后,N=13 只需约 0.04 秒(本章 5.16.2 有完整代码和实测数据)。
同一道题还藏着本章的其它主角:
| 你的困惑 | 本章的工具 |
|---|---|
| 搜索树太大,怎么砍? | 剪枝(5.16.2) |
| 答案在很浅的地方,但 DFS 会先冲进一条死路走到底 | 迭代加深 IDDFS(5.16.3) |
| 能不能「朝着目标的方向」搜,而不是四面八方乱撞? | A* / IDA*(5.16.4) |
| 起点和终点都知道,从两头往中间搜 | 双向 BFS(5.16.5) |
| 到底什么时候根本不该搜索? | 复杂度估算与 DP 分界(5.16.6) |
这一章是把第 5.2 章 BFS/DFS 的「遍历」升级成一门手艺:搜索人人会写,会剪枝、会选框架的人才能在 1 秒时限内过题。
5.16.1 状态空间与搜索树:换一个视角看 DFS/BFS
5.2 章的图 vs 本章的「状态空间」
第 5.2 章的 BFS/DFS 走的是给定的图:输入邻接表,节点编号 1..N,遍历它。但 N 皇后没有输入任何图——棋盘上的部分摆放方案本身就是节点。这引出本章的核心视角:
搜索 = 在「状态空间」上做遍历。状态空间是一张隐式生成的图,它的节点是「局面」,边是「一步决策」。
三个术语,以 N 皇后为例:
| 术语 | N 皇后 | 迷宫最短路(5.2 章) |
|---|---|---|
| 状态(节点) | 前 k 行的一种合法摆放 | 奶牛当前所在格子 |
| 转移(边) | 在第 k+1 行放一个不冲突的皇后 | 上下左右走一格 |
| 初始状态 | 空棋盘 | 起点 |
迷宫其实也是状态空间搜索——只不过它的状态(格子)与输入的图一一对应。N 皇后更典型:13! 个排列的状态空间根本不可能显式存下来,它在 DFS 过程中被「随用随生成、用完即丢弃」。
搜索树
从初始状态出发,把每个状态的每种转移画成一棵树,就得到搜索树。N=4 皇后搜索树的开头:
空棋盘
┌───────────┬─────┴──────┬───────────┐
放(1,1) 放(1,2) 放(1,3) 放(1,4)
│ │ │ │
┌───┴───┐ ┌───┴───┐ ┌───┴───┐ ┌───┴───┐
放(2,3) 放(2,4) 放(2,4) ✗ ✗ 放(2,1) 放(2,1) 放(2,2)
... ... ... (2,2列冲突) ... ... ...
(放(r,c) = 第 r 行第 c 列;✗ = 放下即冲突的死分支。)
注意两件事:
- 搜索树 ≠ 状态空间图。 迷宫中格子 A → B → A 是图中的一条路,但搜索树里「回到 A」是不同的节点——搜索树按路径区分,状态图按局面区分。DFS 天然处理的是搜索树;如果同一局面会经多条路径到达且你想去重,就得像 BFS 那样记 visited(哈希表 / 编码)。
- 搜索树的规模是指数级的。 分支因子 b、解在深度 d,最坏要访问约 bᵈ 个节点。b=13、d=13 时,这就是 5.16.0 里的 62 亿。本章所有技术,本质都是在缩小这棵树:
| 技术 | 砍掉的部分 |
|---|---|
| 剪枝 | 注定失败/不优的子树 |
| 迭代加深 | 比答案更深的所有子树 |
| A* | 启发函数判定「绕远」的子树 |
| 双向 BFS | 用两棵深度 d/2 的树替代一棵深度 d 的树 |
⚠️ 常见错误:忘了状态会重复
| 错误 | 后果 | 修正 |
|---|---|---|
| 隐式图 DFS 不记 visited | 同一局面被搜无数遍,程序「假死」 | 状态可编码时用 unordered_set / 数组判重 |
| 搜索树路径含环(如八数码来回滑动) | 无限深递归 | visited 判重,或禁止「撤销上一步」(IDA* 的做法,见 5.16.4) |
| 把「状态数」当「搜索树节点数」 | 低估复杂度;状态少但路径多时严重超时 | 估算用搜索树规模:b^深度 |
| 状态编码丢信息(如八数码忘了 0 的位置) | 不同局面哈希碰撞,答案错 | 编码必须与局面一一对应 |
5.16.2 剪枝三招:可行性、上下界、搜索顺序
剪枝 = 在递归进入子树之前判断「这棵子树还有希望吗」,没希望就直接 return。三招按威力从小到大:
第一招:可行性剪枝(剪「必败」的分支)
当前局面已违反约束 → 立刻回溯。
N 皇后逐行放置时,每放一个就检查列和两条对角线是否冲突,冲突立即回溯——这就是可行性剪枝。它把 13! 砍成了「合法前缀」的树,节点数骤降几个数量级。
其它例子:组合枚举中「已选元素和 > 目标」即回溯;数独中尝试的数字与同行/列/宫冲突即跳过。
第二招:最优性剪枝 / 上下界剪枝(剪「必不优」的分支)
求最小代价时:当前代价 + 完成剩余部分的乐观估计 ≥ 已知最优解 → 回溯。
关键在「乐观估计」:必须是下界(永远不高于真实剩余代价),否则会把最优解剪掉。例:
- 数独/填数问题:剩余空格都填最小值也追不上当前最优 → 剪。
- 旅行商分支限界:当前路径长 + 剩余城市的 MST 长度 ≥ 最优 → 剪。
- 埃及分数(5.16.3 例题):剩余 k 个分数每个最多 1/d,
a/b > k/d则这条分支无解 → 剪。
对求最大值的问题对称地用上界。注意:这种剪枝通常要求先有一个可行解(哪怕很烂)作为初始最优值——这就是第三招的用武之地。
第三招:搜索顺序剪枝(让好答案早点出现)
优先尝试更可能产生(更优)答案的分支。
搜索顺序不改变正确性(最坏情况不变),但改变好答案出现的时机,而好答案越早出现,第二招的剪枝越狠。例:
- 数钱币凑金额:从大到小试面额,先试「大子」分支;
- 分团/独立集问题:优先扩展度数大的节点;
- 求字典序最小方案:按字典序尝试分支,找到第一个解就停;
- 埃及分数:分母从小到大枚举——最优解(项数最少、字典序最小)就在浅处靠左。
例题:N 皇后(完整代码)
用三个 bitmask 记录「哪些列 / 左对角线 / 右对角线已被占用」。第 r 行放置列 c 时:
- 列 c 占用:bit
c; - 同一条 ↘ 对角线上
(r+k, c+k)与(r, c)—— 观察:往下一行走,这条对角线的列号 +1,所以把「左移一位的占用掩码」往下传; - 同一条 ↙ 对角线同理右移一位。
#include <bits/stdc++.h>
using namespace std;
int n;
long long cnt = 0;
// cols: 已占用的列 d1: ↘ 对角线(本行视角) d2: ↙ 对角线(本行视角)
void dfs(int row, int cols, int d1, int d2) {
if (row == n) { cnt++; return; }
// avail 的每个 1 位 = 本行可以放的列
int avail = ((1 << n) - 1) & ~(cols | d1 | d2);
while (avail) {
int p = avail & (-avail); // 取最低位的 1(尝试该列)
avail -= p;
dfs(row + 1,
cols | p, // 列占用传递
(d1 | p) << 1, // ↘ 对角线:下一行列号 +1
(d2 | p) >> 1); // ↙ 对角线:下一行列号 -1
}
}
int main() {
cin >> n;
dfs(0, 0, 0, 0);
cout << cnt << "\n";
}
实测(Apple M 系列,单核):
| N | 解数 | 耗时 |
|---|---|---|
| 4 | 2 | 瞬时 |
| 8 | 92 | 瞬时 |
| 13 | 73712 | 约 0.04 秒 |
对比朴素的 13! ≈ 62 亿次排列枚举:可行性剪枝把它压到了千万级节点。
手算 N=4:看见被剪掉的子树
N=4 只有两个解:(2,4,1,3) 和 (3,1,4,2)(第 i 行皇后的列号)。沿搜索树走一遍(✗ = 放下即与前面某皇后冲突):
第 1 行放列 1:
第 2 行:列 1✗(列冲突) 列 2✗(↘对角) 列 3 可 → 第 3 行:1✗ 2✗ 3✗ 4✗ 全冲突 → 回溯
列 4✗(↙对角) 【整棵子树死】
第 1 行放列 2:
第 2 行:列 1 可 → 第 3 行:3✗(列) 4✗(对角) → 死
列 2✗ 列 3✗(对角) 列 4 可 → 第 3 行:列 1 可 → 第 4 行:只剩列 3 ✓ 解 (2,4,1,3)!
第 1 行放列 3: ← 与「放列 2」左右镜像 → 解 (3,1,4,2)
第 1 行放列 4: ← 与「放列 1」左右镜像 → 全死
要点:
- 不带剪枝的枚举要试
4^4 = 256种完整放置(或 4! = 24 个排列);带可行性剪枝的 DFS 只走了上面十几步——每条根到叶的活路只有 2 条,其余 254 种组合都在浅处被剪掉。 - 第 1 行放列 1 的子树里,最深的死分支也只到第 3 行——剪枝把「注定失败」的判断提前到了失败被造成的那一刻,而不是方案完成时。这就是 13! 被砍到千万级节点的机制。
- 对角线判断最易手误(
(2,4)与(3,1)行差 1 列差 3,不冲突),这正是代码里把对角线交给 bitmask 滚动传递、而不是写一串 if 的原因。
5.16.3 迭代加深(IDDFS):DFS 的空间,BFS 的深度保证
一个两难
设想解的深度未知(不知道答案离起点几步):
| 方案 | 优点 | 致命伤 |
|---|---|---|
| DFS | 空间 O(深度),实现简单 | 一条分支因子大的搜索树里,DFS 可能一头扎进一条没有解的长死路,出不来 |
| BFS | 按层扩展,第一个到的解最浅 | 队列存整层,空间 O(b^d),d=30、b=4 就要 10¹⁸ 个状态 |
埃及分数正是这种题:展开 a/b 为项数最少、字典序最小的单位分数之和,答案几项?不知道。
IDDFS:限定深度地做 DFS,深度不够就加一
迭代加深(Iterative Deepening DFS,IDDFS):先做深度上限为 1 的 DFS,找不到解就把上限加到 2,再来……直到找到解。
- 每轮 DFS 是深度受限的:不会掉进比上限更深的死路;
- 找到解时,上限恰好是最浅解的深度(上一轮已证明更浅处无解)——拿到了 BFS 的性质;
- 每轮只用 O(深度) 的栈空间——拿到了 DFS 的性质。
重复搜索不亏吗? 亏,但亏得很少。设分支因子 b,深度上限 d 的一轮 DFS 访问约 bᵈ 个节点,之前所有轮加起来约 bᵈ⁻¹ + bᵈ⁻² + … < bᵈ/(b−1)。总代价与单独跑最后一轮之比:
(b^d + b^(d-1) + ...) / b^d = 1/(1 - 1/b) = b/(b-1)
b=10 时只多花 11%,b=4 时多 33%——指数增长的最后一层占据几乎全部工作量,前面几层白搜也便宜。这与第 2.9 章倍增的思想一脉相承:宁可重做便宜的部分,换确定性的终止条件。
例题:埃及分数
🧩 题目:埃及分数 给定真分数
a/b(0 < a < b ≤ 10⁶),把它展开成互不相同的单位分数之和,要求:
- 项数最少;
- 项数相同时字典序最小(即第一个分母尽量小,其次第二个……)。 输出一种最优展开。
为什么 IDDFS? 答案项数未知(可能 1 项,可能 5 项)。按「项数 = 深度上限」做迭代加深,从小到大尝试;同一深度内分母从小到大枚举(搜索顺序剪枝,保证字典序最小)。
剪枝:
- 可行性:分母严格递增(保证互不相同 + 字典序结构);
- 下界(上界剪枝):当前已枚举到分母 d、还剩 remain 项,每项 ≤ 1/d,故必须
a/b ≤ remain/d,即a·d ≤ remain·b——不满足就 break(后面的 d 更大,只会更差); - 整除特判:只剩 1 项时,
a/b必须恰好是1/d(即b % a == 0)。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
ll path[100]; // 当前路径上的分母
int pathLen = 0;
ll a, b; // 展开 a/b
// 用恰好 remain 个分母严格大于 start 的单位分数凑出 a/b
bool dfs(ll a, ll b, ll start, int remain) {
if (remain == 0) return a == 0;
if (remain == 1) { // 只剩一项:必须能整除
if (b % a == 0 && b / a > start) {
path[pathLen++] = b / a;
return true;
}
return false;
}
// 分母下界:d > start,且 d >= ceil(b/a)(否则 1/d > a/b 超出目标)
// 分母上界(下界剪枝):remain 项每项 <= 1/d,必须 cover a/b => a*d <= remain*b
for (ll d = max(start + 1, (a + b - 1) / a); a * d <= (ll)remain * b; d++) {
ll na = a * d - b, nb = b * d; // 剩余:a/b - 1/d = (ad-b)/(bd)
if (na < 0) continue;
ll g = gcd(na, nb); na /= g; nb /= g;
path[pathLen++] = d;
if (dfs(na, nb, d, remain - 1)) return true;
pathLen--;
}
return false;
}
int main() {
cin >> a >> b;
ll g = gcd(a, b); a /= g; b /= g;
for (int limit = 1; ; limit++) { // 迭代加深:项数上限 1, 2, 3, ...
pathLen = 0;
if (dfs(a, b, 0, limit)) {
cout << a << "/" << b << " = ";
for (int i = 0; i < pathLen; i++)
cout << "1/" << path[i] << (i + 1 < pathLen ? " + " : "\n");
return 0;
}
}
}
实测(已与朴素枚举对拍验证一致):
| 输入 | 输出 |
|---|---|
5 121 | 5/121 = 1/25 + 1/759 + 1/208725 |
4 3 | 4/3 = 1/1 + 1/3 |
2 3 | 2/3 = 1/2 + 1/6 |
7 13 | 7/13 = 1/2 + 1/26 |
⚠️ a/b 可能不小于 1(如 4/3),所以第一项分母可以从 1 开始——代码用 start = 0 自然处理了这一点。
5.16.4 A* 与 IDA*:让启发函数带路
启发函数与可采纳性
BFS/Dijkstra 像「匀速扩散」,四面八方等速推进。如果每个状态到目标还剩多远有个估计,就能优先扩展「看起来离目标近」的状态。
启发函数 h(n):状态 n 到目标剩余代价的估计。 可采纳性(admissible):h(n) 从不高估真实剩余代价(h ≤ 真实值)。 一致性(更强):h(u) ≤ w(u,v) + h(v),即边上的估计跌幅不超过边权。
可采纳性是 A 正确性的命根子*:只有不高估,某状态被弹出时才敢断言它的 g 值已是真实最短。高估哪怕 1,都可能把最优解藏在一棵「估计悲观」的子树里。
A* = Dijkstra + h
回忆 5.4 章 Dijkstra:优先队列按 g(n)(已走代价)弹出。A* 只改一处——按 f(n) = g(n) + h(n) 弹出:
Dijkstra: 弹出 g 最小的
A*: 弹出 g + h 最小的
h ≡ 0 时 A* 退化为 Dijkstra(无权图上就是 BFS)。h 越接近真实值(仍不高估),越少扩展无用状态;h = 真实值时几乎直奔答案。
例题:八数码(A* 实现)
🧩 题目:八数码 3×3 棋盘上有 1–8 和一个空格(0)。每步把空格与相邻数字交换。给定初始局面,求还原到
123456780的最少步数,无解输出 −1。
无解判定(先于搜索!):把局面按行展开成序列(去掉 0),统计逆序对。每次移动是空格与相邻数字交换,在展开序列中相当于把一个数移动一格——逆序对奇偶性不变。目标 12345678 逆序对为 0(偶),所以初始逆序对为奇 ⇒ 无解。先判奇偶能省下整场无用搜索。
启发函数:曼哈顿距离。每个数字到其目标格子的 |Δ行|+|Δ列| 之和(不含 0)。一次交换至多让一个数字移动一格,故真实步数 ≥ 曼哈顿和——可采纳 ✓。
#include <bits/stdc++.h>
using namespace std;
const string GOAL = "123456780";
int manhattan(const string& s) { // h(n):各数字曼哈顿距离和
int d = 0;
for (int i = 0; i < 9; i++) {
if (s[i] == '0') continue;
int v = s[i] - '1';
d += abs(i / 3 - v / 3) + abs(i % 3 - v % 3);
}
return d;
}
bool solvable(const string& s) { // 逆序对奇偶性判定
int inv = 0;
for (int i = 0; i < 9; i++) if (s[i] != '0')
for (int j = i + 1; j < 9; j++) if (s[j] != '0' && s[j] < s[i]) inv++;
return inv % 2 == 0;
}
int astar(const string& start) {
if (!solvable(start)) return -1;
if (start == GOAL) return 0;
// 优先队列按 f = g + h 弹出
priority_queue<pair<int, string>,
vector<pair<int, string>>,
greater<pair<int, string>>> pq;
unordered_map<string, int> dist; // 已知最优 g 值
dist[start] = 0;
pq.push({manhattan(start), start});
int dx[] = {1, -1, 0, 0}, dy[] = {0, 0, 1, -1};
while (!pq.empty()) {
auto [f, s] = pq.top(); pq.pop();
int g = dist[s];
if (f > g + manhattan(s)) continue; // 过期条目:已有更优 g
if (s == GOAL) return g;
int z = s.find('0');
for (int k = 0; k < 4; k++) {
int nr = z / 3 + dx[k], nc = z % 3 + dy[k];
if (nr < 0 || nr > 2 || nc < 0 || nc > 2) continue;
string t = s;
swap(t[z], t[nr * 3 + nc]);
if (!dist.count(t) || g + 1 < dist[t]) {
dist[t] = g + 1;
pq.push({g + 1 + manhattan(t), t});
}
}
}
return -1;
}
int main() {
string s;
for (int i = 0; i < 9; i++) { char c; cin >> c; s += c; }
cout << astar(s) << "\n";
}
实测(已与朴素 BFS 对拍,结果一致):
| 输入(按行 9 个字符) | 最少步数 |
|---|---|
724506831 | 20 |
234150768 | 19 |
123456870(逆序对为奇) | −1(无解) |
IDA* = IDDFS + 「f 超上限就剪」
A* 要用优先队列 + 哈希表存所有状态,八数码状态多达 9!/2 = 181440 个——尚可,但状态空间更大(如 15 数码)就爆内存。IDA* 换个组合:
IDA*:以 f(n) = g(n) + h(n) 为对象做迭代加深——第 i 轮的「深度上限」是 f 上限
bound;DFS 中g + h > bound即剪枝回溯;一轮失败后bound设为「本轮遇到的最小超限 f 值」。
对比 A*:
| A* | IDA* | |
|---|---|---|
| 空间 | O(状态数)(哈希表+堆) | O(深度) |
| 重复 | 无 | 每轮重搜(同 IDDFS,便宜) |
| 状态无法哈希时 | 没法做 | 照做(只需能算 h) |
| 适用 | 状态可编码、内存够 | 状态空间巨大 / 难哈希 |
八数码的 IDA* 实现(细节:禁止撤销上一步交换——上一位置 prevz 不回走,代替 visited 判重):
#include <bits/stdc++.h>
using namespace std;
const string GOAL = "123456780";
int bound;
int manhattan(const string& s) {
int d = 0;
for (int i = 0; i < 9; i++) {
if (s[i] == '0') continue;
int v = s[i] - '1';
d += abs(i / 3 - v / 3) + abs(i % 3 - v % 3);
}
return d;
}
bool solvable(const string& s) {
int inv = 0;
for (int i = 0; i < 9; i++) if (s[i] != '0')
for (int j = i + 1; j < 9; j++) if (s[j] != '0' && s[j] < s[i]) inv++;
return inv % 2 == 0;
}
bool dfs(string& s, int g, int prevz) {
int h = manhattan(s);
if (g + h > bound) return false; // f 超上限:剪
if (h == 0) return true;
int z = s.find('0');
int dx[] = {1, -1, 0, 0}, dy[] = {0, 0, 1, -1};
for (int k = 0; k < 4; k++) {
int nr = z / 3 + dx[k], nc = z % 3 + dy[k];
if (nr < 0 || nr > 2 || nc < 0 || nc > 2) continue;
int nz = nr * 3 + nc;
if (nz == prevz) continue; // 不撤销上一步
swap(s[z], s[nz]);
if (dfs(s, g + 1, z)) return true;
swap(s[z], s[nz]); // 回溯
}
return false;
}
int idastar(const string& start) {
if (!solvable(start)) return -1;
string s = start;
bound = manhattan(s);
if (bound == 0) return 0;
while (true) { // 迭代放宽 f 上限
if (dfs(s, 0, -1)) return bound;
bound++;
}
}
int main() {
string s;
for (int i = 0; i < 9; i++) { char c; cin >> c; s += c; }
cout << idastar(s) << "\n";
}
(实现从简:bound++ 逐个加 1;更快的写法是把 bound 直接跳到「上一轮遇到的最小超限 f 值」,正确性相同。)实测 724506831 → 20、234150768 → 19、867254301 → 31,与 A* 和朴素 BFS 完全一致。
A 的正确性要点*:弹出时 f = g + h,若 h 可采纳则任何尚未弹出的状态的真实最短距离 ≥ 当前 f —— 所以第一个弹出即目标的 g 就是答案。「过期条目检查」(if (f > g + manhattan(s)) continue)不能省,原理同 5.4 章 Dijkstra 的惰性删除。
5.16.5 双向 BFS:从两头往中间搜
b^(d/2) + b^(d/2) 远小于 b^d
起点、终点都已知,答案是最短距离时(如迷宫最短路、隐式图上的最少步数),不必从起点单向搜到终点——同时从起点和终点扩展,两个扩散前沿在中间相遇。
单向 BFS 扩到深度 d 需访问约 bᵈ 个状态;双向各扩 d/2:
单向: b^d
双向: 2 · b^(d/2) (平方根!)
d = 30, b = 4:单向 4^30 ≈ 10^18(不可行);双向 2 · 4^15 ≈ 2×10^9(勉强可行)
注意代价结构:答案必须是「距离」且边权一致(每步代价相同),这样两条半程路径拼起来才是最短路。加权图上的推广是双向 Dijkstra,正确性坑多,USACO 中极少需要。
实现要点(容易写错!)
- 交替扩展较小的一侧前沿——保证两边均衡生长,这是复杂度成立的前提;
- 相遇判定:新扩展的状态若已被另一侧访问,得到一个候选答案
ds + dt; - 不能一相遇就返回:同一层内可能有多处相遇、距离不同,必须把当前层扩完,取最小候选(这是最经典的写错点——早退可能拿到比最优长 1 的答案)。
代码模板(网格迷宫版)
#include <bits/stdc++.h>
using namespace std;
int R, C;
vector<string> grid;
int bibfs(int sr, int sc, int tr, int tc) {
if (sr == tr && sc == tc) return 0;
vector<vector<int>> ds(R, vector<int>(C, -1)), dt = ds;
queue<pair<int,int>> qs, qt;
qs.push({sr, sc}); ds[sr][sc] = 0;
qt.push({tr, tc}); dt[tr][tc] = 0;
int dx[] = {1, -1, 0, 0}, dy[] = {0, 0, 1, -1};
while (!qs.empty() && !qt.empty()) {
bool expandS = qs.size() <= qt.size(); // ① 扩较小的一侧
auto& q = expandS ? qs : qt;
auto& dcur = expandS ? ds : dt;
auto& doth = expandS ? dt : ds;
int ans = -1;
int layer = q.size();
while (layer--) { // ③ 整层扩完再返回
auto [r, c] = q.front(); q.pop();
for (int k = 0; k < 4; k++) {
int nr = r + dx[k], nc = c + dy[k];
if (nr < 0 || nr >= R || nc < 0 || nc >= C) continue;
if (grid[nr][nc] == '#' || dcur[nr][nc] != -1) continue;
dcur[nr][nc] = dcur[r][c] + 1;
if (doth[nr][nc] != -1) { // ② 与另一侧相遇
int cand = dcur[nr][nc] + doth[nr][nc];
if (ans == -1 || cand < ans) ans = cand;
}
q.push({nr, nc});
}
}
if (ans != -1) return ans;
}
return -1;
}
int main() {
cin >> R >> C;
grid.resize(R);
int sr, sc, tr, tc;
for (int i = 0; i < R; i++) {
cin >> grid[i];
for (int j = 0; j < C; j++) {
if (grid[i][j] == 'S') sr = i, sc = j;
if (grid[i][j] == 'T') tr = i, tc = j;
}
}
cout << bibfs(sr, sc, tr, tc) << "\n";
}
正确性验证:在数千张随机图上,该模板与朴素 BFS 的最短距离逐一相等;在 7×11 迷宫样例上两者同为 16 步。
何时用? 单向 BFS 状态数将爆炸而深度较深时。一句话呼应:状态空间是「指数级的一半可省」的场景还有第 6.4 章的折半搜索(meet in the middle)——那边拆的是「决策序列」,本节拆的是「图上的距离」,思想同源。
5.16.6 何时不该搜索:复杂度估算与与 DP 的分界
动手前先算:b^d 卡上限
搜索题 90% 的 WA/TLE 出在「没算规模就开写」。开搜前回答两问:
- 分支因子 b 是多少? 每个状态平均有几个后继;
- 深度 d 到哪? 解最深在几层。
然后拿 b^d 与机器上限(约 10⁸–10⁹ 次操作/秒 × 时限)对比:
| b^d 估算 | 结论 |
|---|---|
| ≤ 10⁶ | 闭眼搜 |
| 10⁷–10⁸ | 朴素可过,剪枝留作保险 |
| 10⁹–10¹¹ | 必须剪枝 / 迭代加深 / A*,认真设计 |
| > 10¹² | 搜索救不了,换思路(DP / 数学 / 贪心) |
例:埃及分数 limit=4 时分母上界由剪枝 ③ 压住,实际节点数远小于表面上界——剪枝的本质就是把「有效 b」和「有效 d」变小。
搜索还是 DP?看重叠子问题
搜索树里同一局面经不同路径反复出现(重叠子问题)→ 每个局面只算一次就是 DP:
没有重叠子问题 → 搜索;有重叠子问题 → DP 或记忆化搜索。
| 问题 | 同一局面会经多条路径到达吗? | 结论 |
|---|---|---|
| N 皇后 | 否(每行放法不同 ⇒ 局面天然不同) | 搜索 + 剪枝 |
| 迷宫最短路 | 是(绕路到同一格子) | BFS(= 最短路 DP 的顺序化) |
| 八数码 | 是(不同移动序列到同一布局) | A* 可行;状态可枚举时也可 BFS 预处理 |
| 数字三角形最短/最长路 | 是(多条路汇到同一格) | 经典 DP(第 6.1 章) |
| 上楼梯方案数 | 是(最后一步从 k−1 或 k−2 来) | 递推 DP;朴素搜索指数级 |
记忆化搜索是两者的桥梁:DFS 写法 + 每个状态第一次算完就缓存(第 6.2 章)。判断口诀:「能不能到同一个地方」——能,就别让搜索树替你重复劳动。
最后一条经验法则:先写朴素搜索,对拍验证,再加剪枝/换框架,逐步优化。一次到位的精妙剪枝往往掩盖正确性 bug;朴素版是最好的对拍基准(本章代码全部按此流程验证)。
⚠️ 常见错误
| 错误 | 症状 | 修正 |
|---|---|---|
| 双向 BFS 一相遇就 return | 答案比最优大 1 | 整层扩完,取所有候选的最小值 |
| A* 的 h 高估真实剩余代价 | 最优解被「悲观分支」藏住,输出次优 | h 必须可采纳:取安全下界(如曼哈顿距离) |
| IDDFS 每轮重置了全局累加答案 | 找到的「解」来自上一轮的部分路径 | 解的判定必须用完整路径(如埃及分数 a == 0 且 remain == 0) |
| 埃及分数先取 gcd 再递归中不约分 | 分母溢出 long long | 每步 gcd(na, nb) 约分 |
| 八数码忘判奇偶无解 | 无解实例上死循环/输出 0 | 先逆序对奇偶判定 |
位运算 N 皇后 d1 忘左移传递 | 对角线约束丢失,解数偏大 | (d1 | p) << 1、(d2 | p) >> 1 逐行滚动 |
| 把搜索顺序剪枝当正确性依据 | 换个枚举顺序答案就变 | 搜索顺序只影响速度和同长度解的字典序,不影响最优值 |
| 隐式图 DFS 不设任何判重/回撤 | 程序假死 | visited、禁止撤销上一步、或深度上限三选一 |
本章总结
📌 核心要点
| 技术 | 一句话本质 | 复杂度/空间 | 适用信号 |
|---|---|---|---|
| 可行性剪枝 | 非法早退 | 不变(常数变小) | 约束可增量检查 |
| 上下界剪枝 | 乐观估计都追不上已知最优 → 剪 | — | 求最优、已有可行解 |
| 搜索顺序剪枝 | 好分支先行,喂饱上下界剪枝 | 最坏不变,实际大降 | 分支有「好坏」直觉 |
| IDDFS | 深度 1,2,3,… 逐轮 DFS | 时间 ×b/(b−1),空间 O(d) | 解深度未知、内存紧 |
| A* | Dijkstra 改按 g+h 弹出 | 时间/空间锐减(h 越准越快) | 有可采纳 h、状态可哈希 |
| IDA* | IDDFS 的上限换成 f=g+h | 空间 O(d) | 状态空间巨大/难哈希 |
| 双向 BFS | 两头扩展中途相遇 | 2·b^(d/2) vs b^d | 起点、终点都已知,求距离 |
❓ 常见问题
Q1:剪枝会不会把正确答案剪掉?
A:会,如果剪枝条件写错方向。铁律:可行性剪枝只剪确定非法的分支;上下界剪枝的界必须是保守估计(下界估计 ≤ 真实值)。写完先用朴素版对拍。
Q2:IDDFS 重复搜索这么多遍,真的不慢吗?
A:指数树中最后一层占绝对大头,前面各层加起来只有最后一层的 1/(b−1)。b≥4 时总开销增幅 <33%,换来 O(深度) 空间和「最浅解」保证。
Q3:A 的 h 用曼哈顿距离还是「错位数」?*
A:曼哈顿距离。错位数(不在位的数字个数)也可采纳但更弱(每步至多修正 1 个错位);曼哈顿更接近真实值,扩展状态数少一个数量级以上。更强的还有线性冲突(linear conflict),仍可采纳,Gold 以上可选学。
Q4:什么时候 IDA 比 A 好?**
A:状态空间大到存不下哈希表(15 数码、深层博弈),或状态难以编码成哈希键时。IDA* 只需能算 h 和枚举转移。代价是每轮重搜,h 准确时这个代价很小。
Q5:双向 BFS 为什么要求边权一致?
A:相遇拼接的两段要能直接相加才是最短距离。若边权不一,两侧「半程最优」的拼接未必全局最优,需要更复杂的停止条件与加权双向 Dijkstra——USACO 范围内一般用不到。
🔗 与其他章节的联系
- 第 5.2 章(BFS 与 DFS):本章是它们的「战斗力升级版」——同一对遍历骨架,加上剪枝、限深、启发、双向四类优化
- 第 5.4 章(最短路):A* 是 Dijkstra 的启发式推广;h≡0 时两者等价
- 第 6.2 章(记忆化搜索):5.16.6 的「重叠子问题」判断标准正是记忆化/DP 的启动开关
- 第 6.4 章(折半搜索):把指数砍半的姊妹技术——那边砍决策序列、这边砍图距离
- 第 8 章(调试与对拍):搜索题的剪枝必须靠朴素版本对拍验证,本章所有代码均如此验证
综合练习
🟢 简单
5.16-E1. 全排列皇后检查器
给定 N(1 ≤ N ≤ 10)和一个排列 c₁..c_N(第 i 行皇后在第 cᵢ 列),判断它是否为合法的 N 皇后方案;若不合法,输出第一个冲突的皇后对 (i, j)。
输入: 第一行 N,第二行 N 个整数。
(热身:练习增量化的冲突检查——正是剪枝的基础部件)
💡 提示
对每对 i<j 检查三条件:c[i] == c[j](同列)、i - c[i] == j - c[j](↘ 对角线)、i + c[i] == j + c[j](↙ 对角线)。行差与列差相等即同对角线:abs(i-j) == abs(c[i]-c[j])。
5.16-E2. 素数环
把 1..N(N ≤ 16)排成一个环,使相邻两数之和均为素数。输出方案数(1 固定在第一个位置以去重)。
数据规模: 2 ≤ N ≤ 16。
(经典回溯 + 可行性剪枝)
💡 提示
DFS 逐位填数,用 bool used[] 标记,每填一个数只检查它与前一个数之和是否为素数(可行性剪枝);注意环闭合时还要检查最后一位与 1 之和。N=16 时若无剪枝会超时——这正是剪枝的意义。N 为奇数且 N>1 时答案直接为 0(奇数个数无法两两配成奇数和),想想为什么。
🟡 中等
5.16-E3. 木棒拼接(Sticks 风格)
N 根木棍(N ≤ 64,每根长度 ≤ 50),把它们拼成若干根等长的原始木棒,求原始木棒的最小可能长度。
(搜索顺序 + 多重剪枝的经典综合题)
💡 提示
枚举候选长度 L(必须是总长度的约数、≥ 最长木棍),DFS 尝试拼出总长/L 根。关键剪枝:①木棍从长到短排序(搜索顺序剪枝);②当前棒剩余长度 < 最短木棍 → 剪;③某根木棍作为「新棒的第一根」失败后,跳过所有等长木棍;④某根木棍恰好填满当前棒但整体失败 → 整个 L 剪掉(填满一根棒反而失败说明这根不值得用完)。
5.16-E4. 双向 BFS 走密码锁 密码锁有 4 个 0–9 的转盘,每步可把任意一个转盘 +1 或 −1(0 与 9 相邻),或交换两个相邻转盘的数字(代价同为 1 步)。给定初始状态和目标状态,求最少步数。状态总数仅 10⁴,但单向 BFS 基准版与双向版都要写,比较扩展的状态数。 数据规模: 多组查询(≤ 100 组)。
💡 提示
状态编码 int s = d1*1000 + d2*100 + d3*10 + d4。转移:8 种转盘操作 + 3 种交换操作((0,1)(1,2)(2,3))。双向 BFS 沿用 5.16.5 模板:扩较小一侧、整层扩完取最小候选。统计两版各自入队的状态数,双向应约为单向的平方根量级。
🔴 困难
5.16-E5. 加法链(Addition Chains)
加法链是整数序列 1 = a₀ < a₁ < … < a_m = n,其中每个 aᵢ(i ≥ 1)都是前面某两个 aⱼ + aₖ(j, k < i,允许 j = k)之和。给定 n(1 ≤ n ≤ 1000),求最短的 m。
(POJ 2248 风格;IDDFS 的标准练习)
💡 提示
答案长度未知 → 迭代加深:上限从 log₂(n)(理论下界)开始。剪枝:①aᵢ ≤ 前一项 × 2(不然不递增);②从大到小枚举 j(搜索顺序——大数加大数更快够到 n);③剩余 r 步最多放大 2ʳ 倍,当前最大值 × 2^r < n → 剪;④从大到小枚举加数使 aᵢ 尽量大,同时跳过重复和。注意 aₘ = n 必须恰好命中,枚举到 aᵢ = n 即成功。
5.16-E6. 15 数码判定 4×4 的 15 数码(数字 1–15 与空格 0),给定局面,判定是否可解,并输出还原所需最少步数的一个下界(不必真正求解)。 数据规模: 单组局面。
💡 提示
4×4 的无解判定与 3×3 不同:逆序对奇偶性还与空格所在行有关(空格每上下移动一次改变一次排列的「与末行交换」视角,等价于改变奇偶性)。公式:设逆序对数为 inv,空格从底数起的行号为 r(从 1 开始),则当宽度为偶数时,可解 ⇔ (inv + r) 与目标局面的对应值奇偶性一致。下界用所有数字的曼哈顿距离和(可采纳性证明与 5.16.4 完全相同);真正求解需要 IDA*(状态 16!/2 ≈ 10¹³ 存不下哈希表,正是 IDA* 的主场)。
下一步
- 把 5.16.2 的 N 皇后改成输出第一个字典序最小的具体方案(练习:找到即停 + 搜索顺序);
- 第 6.2 章记忆化搜索:看看「搜索 + 缓存」如何统一本章与 DP 的分界;
- 第 6.4 章折半搜索:另一条「指数减半」路线,与双向 BFS 对照学习。
🧠 第六部分:动态规划
竞赛编程中最强大也最需要训练的主题。掌握记忆化、递推、经典模型、折半枚举与数位计数,逐步跨过 USACO Silver 到 Gold 的门槛。
📚 8 章 · ⏱️ 预计 5-7 周 · 🎯 目标:USACO Silver → Gold
第六部分:动态规划
预计用时:4-6 周
动态规划不是背公式,而是把一个大问题拆成许多会重复出现的小问题。你需要学会定义状态、设计转移、处理边界,并判断什么时候 DP 不是最好的工具。本部分从最基础的一维 DP 开始,逐步过渡到背包、LIS、状压、区间、树形、折半搜索和数位 DP。
涵盖的主题
| 章节 | 主题 | 核心思想 | 目标层级 |
|---|---|---|---|
| 第 6.1 章 | DP 入门 | 记忆化、递推、DP 四步法 | Bronze/Silver |
| 第 6.2 章 | 经典 DP 问题 | LIS、背包、网格路径、方案数 | Silver |
| 第 6.3 章 | 进阶 DP 模式 | 状压 DP、区间 DP、树形 DP | Silver/Gold |
| 第 6.4 章 | 折半搜索 | 将 2^N 拆成两个 2^(N/2) 再合并 | Gold |
| 第 6.5 章 | 数位 DP | 按位填数,统计 [L, R] 内满足数字性质的数 | Gold |
| 第 6.6 章 | DP 优化 | 单调队列、斜率优化、决策单调性:削减转移冗余 | Gold/Platinum |
| 第 6.7 章 | 概率期望与计数 DP | 概率顺推、期望倒推、计数不重不漏 | Gold |
| 第 6.8 章 🥇 | 树形 DP 与换根 | 树上背包、换根 DP(二次扫描) | Gold |
学完本部分后能解决什么问题
完成第六部分后,你将能够挑战:
-
USACO Bronze:
- 简单计数问题(做某件事有多少种方法?)
- 基本优化问题(最小代价、最大收益)
-
USACO Silver:
- 最长递增子序列及其变体
- 0/1 背包、完全背包、二维费用背包
- 网格路径计数与最大价值路径
- 需要精确定义状态的一维/二维 DP
-
USACO Gold:
- 状压 DP、区间 DP、树形 DP
N≈40的指数枚举题:使用折半搜索把复杂度减半[L, R]内数字性质计数题:使用数位 DP 处理10^18级别范围- 多状态组合:数字和、余数、上一位、出现次数、上下界约束
需要掌握的关键 DP 模式
| 模式 | 章节 | 示例题目 | 关键提醒 |
|---|---|---|---|
| 一维 DP(顺序) | 6.1 | 斐波那契、爬楼梯 | 先写状态含义,再写转移 |
| 一维 DP(优化) | 6.1 | 硬币找零(最少硬币) | 最小值初始化为 INF |
| 一维 DP(计数) | 6.1 | 硬币找零(方案数) | 初始方案数通常是 dp[0]=1 |
| 二维 DP | 6.2 | 0/1 背包、网格路径 | 明确每一维代表什么 |
| LIS | 6.2 | O(N²) 与 O(N log N) LIS | tails 数组不是实际 LIS |
| 状压 DP | 6.3 | TSP、任务分配 | mask 表示集合状态 |
| 区间 DP | 6.3 | 矩阵链乘法、合并石子 | 按区间长度递增填表 |
| 树形 DP | 6.3 | 树上独立集 | 后序遍历先算子树 |
| 折半搜索 | 6.4 | 子集和、最大不超过 X 的子集和 | 2^40 不可做,两个 2^20 可做 |
| 数位 DP | 6.5 | 不含某数字、数字和、整除性 | tight 与 started 是核心 |
| 概率 DP | 6.7 | 转移概率累加 | 每个状态转移概率之和必须为 1 |
| 期望 DP | 6.7 | 绿蛙跳格、收集邮票 | 倒推:f[i] = 1 + Σp·f[后继] |
| 计数 DP | 6.7 | 数字组合、错排 | 分类不重不漏;每步取模 |
DP 思维方式
DP 不是死记公式,而是反复问四个问题:
- 状态是什么? 描述一个子问题需要哪些信息?
- 转移是什么? 当前状态能从哪些更小或更简单的状态得到?
- 初始条件是什么? 哪些状态不用计算就知道答案?
- 计算顺序是什么? 依赖必须先于被依赖者计算。
💡 核心思路: 如果暴力搜索中同一个子问题被反复计算,DP 就是把它缓存起来;如果暴力枚举太大但可以分成两半独立处理,折半搜索可能比 DP 更自然;如果范围大到不能枚举每个整数,但限制只和数字有关,数位 DP 往往是答案。
本部分学习建议
- 第 6.1 章不要跳。 你要真正理解“状态”和“转移”,而不是只记代码。
- 每个经典题至少写两遍。 一遍记忆化搜索,一遍递推填表;两种视角互相验证。
- 第 6.2 章重点练背包和 LIS。 它们是很多更难题的底层模型。
- 第 6.3 章开始进入 Silver/Gold。 状压、区间、树形 DP 都需要更强的状态设计能力。
- 第 6.4 章不是传统 DP,但和 DP 同样重要。 当你看到
N≤40和子集枚举时,应立即想到折半搜索。 - 第 6.5 章要画状态。 数位 DP 的
tight、started、pos最容易混,建议用小数字手工追踪。 - 所有 DP 都要检查边界。 空集、0、负数、
L=0、数组维度、INF溢出,都是常见陷阱。
⚠️ 警告: DP 第 1 号 bug:在最小化 DP 中使用
dp[w-c]前忘记检查dp[w-c] != INF。INF + 1会溢出!DP 第 2 号 bug:0/1 背包 vs 完全背包的循环顺序搞错了。倒序迭代 = 每件物品最多用一次;正序迭代 = 无限次使用。
Gold DP 第 1 号 bug:状态维度缺了一维。比如数位 DP 少了
tight或started,答案通常会在边界样例上错。
第 6.1 章:动态规划入门
动态规划(DP)常被描述为「带记忆的聪明递归」。让我们从最简单的例子——斐波那契数列——从零建立这种直觉。
💡 核心思路: DP 解决具有两个性质的问题:
- 重叠子问题 —— 相同的子计算出现多次
- 最优子结构 —— 大问题的最优解可以由小问题的最优解构建
两者同时成立时,DP 将指数时间转化为多项式时间。
📚 本章学习地图
| 小节 | 主题 | 你会学到什么 |
|---|---|---|
| §6.1.1 | 朴素递归的问题 | 为什么暴力递归会指数爆炸 |
| §6.1.2 | 记忆化 | 如何用缓存消除重复子问题 |
| §6.1.3 | 递推 | 如何把递归改写成 DP 表 |
| §6.1.4 | DP 四步法 | 状态、转移、初始条件、填表顺序 |
| §6.1.5 | 最少硬币找零 | 从「选择最后一步」推导递推式 |
| §6.1.6 | 方法数变体 | 为什么循环顺序决定排列/组合 |
| §6.1.7 | 状态设计四问 | 如何从题面条件设计 dp 状态 |
| §6.1.8 | USACO 真题训练 | HPS 与 Teamwork 的状态设计实战 |
🧭 建议阅读方式: 初学者先完整读 §6.1.1–§6.1.4,确认能解释「为什么要缓存」和「表格怎么填」。如果你已经会基础 DP,可以直接跳到 §6.1.7–§6.1.8,重点训练从题面设计状态。
6.1.1 朴素递归的问题
斐波那契数列:0, 1, 1, 2, 3, 5, 8, 13, 21, ...
定义: F(0) = 0,F(1) = 1,F(n) = F(n-1) + F(n-2)(n ≥ 2)。
图示:斐波那契递归树和记忆化
fib(5) 的递归树暴露了问题:fib(3) 被计算了两次(红色节点)。记忆化在第一次计算时缓存每个结果,将 2^N 次调用减少到仅 N 次唯一调用——这是动态规划背后的基本洞察。

朴素递归实现:
int fib(int n) {
if (n == 0) return 0;
if (n == 1) return 1;
return fib(n-1) + fib(n-2); // 递归
}
这是正确的,但慢得可怕:
📄 这是正确的,但**慢得可怕**:
fib(5)
├── fib(4)
│ ├── fib(3)
│ │ ├── fib(2)
│ │ │ ├── fib(1) = 1
│ │ │ └── fib(0) = 0
│ │ └── fib(1) = 1
│ └── fib(2) ← 再次计算!
│ ├── fib(1) = 1
│ └── fib(0) = 0
└── fib(3) ← 再次计算!
├── fib(2) ← 再次计算!
│ ├── fib(1) = 1
│ └── fib(0) = 0
└── fib(1) = 1
fib(3) 被计算了两次,fib(2) 三次。对 fib(50),调用次数超过 10^10。这是指数时间:O(2^n)。
核心洞察:我们在一遍遍重复计算相同的子问题。DP 解决了这个问题。
6.1.2 记忆化(自顶向下 DP)
记忆化 = 递归 + 缓存。计算之前,检查是否已经计算过这个值。若是,返回缓存的结果;若否,计算它、缓存它、返回它。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100;
long long memo[MAXN];
long long fib(int n) {
if (n <= 1) return n;
if (memo[n] != -1) return memo[n];
return memo[n] = fib(n-1) + fib(n-2);
}
int main() {
fill(memo, memo + MAXN, -1LL); // 将所有值初始化为 -1(「未计算」标记)
cout << fib(50) << "\n"; // 12586269025
return 0;
}
现在每个值被计算恰好一次。时间复杂度:O(N)。🎉
6.1.3 递推(自底向上 DP)
递推从头开始构建答案——先计算小子问题,用它们计算更大的问题。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n = 50;
vector<long long> dp(n + 1);
// 初始条件
dp[0] = 0;
dp[1] = 1;
// 自底向上填表
for (int i = 2; i <= n; i++) {
dp[i] = dp[i-1] + dp[i-2]; // 使用已计算的值
}
cout << dp[n] << "\n"; // 12586269025
return 0;
}
手动追踪:dp 数组如何变化
只看代码时,初学者很容易知道“循环写对了”,但不知道数组到底怎么被填出来。以 n = 6 为例,dp 数组会这样变化:
| 步骤 | 新算出的值 | dp[0..6] |
|---|---|---|
| 初始 | dp[0] = 0, dp[1] = 1 | [0, 1, _, _, _, _, _] |
i = 2 | dp[2] = dp[1] + dp[0] = 1 | [0, 1, 1, _, _, _, _] |
i = 3 | dp[3] = dp[2] + dp[1] = 2 | [0, 1, 1, 2, _, _, _] |
i = 4 | dp[4] = dp[3] + dp[2] = 3 | [0, 1, 1, 2, 3, _, _] |
i = 5 | dp[5] = dp[4] + dp[3] = 5 | [0, 1, 1, 2, 3, 5, _] |
i = 6 | dp[6] = dp[5] + dp[4] = 8 | [0, 1, 1, 2, 3, 5, 8] |
这个表格就是递推代码的真实执行过程:每次循环只负责填一个新格子,并且只依赖已经填好的旧格子。
甚至可以优化空间:由于每个斐波那契数只依赖前两个,只需 O(1) 空间:
long long a = 0, b = 1;
for (int i = 2; i <= n; i++) {
long long c = a + b;
a = b;
b = c;
}
cout << b << "\n";
记忆化 vs 递推
对 fib(4) 两种方式对比:

💡 核心区别: 自顶向下按需计算(只算用到的子问题),自底向上全量填表(按顺序算所有子问题)。两者时间复杂度相同,但自底向上没有递归栈开销。
| 方面 | 记忆化(自顶向下) | 递推(自底向上) |
|---|---|---|
| 方式 | 递归加缓存 | 迭代填表 |
| 内存使用 | 只有已计算的状态 | 所有状态(包括未用到的) |
| 实现 | 通常更直观 | 可能需要想清楚填充顺序 |
| 栈溢出风险 | 有(深度递归) | 无 |
| 速度 | 稍慢(函数调用开销) | 稍快 |
| USACO 偏好 | 适合理解和思考 | 适合最终提交 |
🏆 USACO 技巧: 竞赛中自底向上递推略有优势,因为它避免了潜在的栈溢出(在 N = 10^5 的题目中很关键),通常也更快。但若难以看清递推关系,先用自顶向下——这是一种很好的思考方式。
6.1.4 DP 四步法
每道 DP 题都遵循相同的做法:
DP 四步法——从状态定义到空间优化:

- 定义状态: 什么信息能唯一描述一个子问题?
- 定义递推:
dp[状态]如何依赖更小的状态? - 确定初始条件: 最简单子问题的答案是什么?
- 确定顺序: 以什么顺序填表?
应用到斐波那契:
- 状态:
dp[i]= 第 i 个斐波那契数 - 递推:
dp[i] = dp[i-1] + dp[i-2] - 初始条件:
dp[0] = 0,dp[1] = 1 - 顺序: i 从 2 到 n(每个依赖更小的 i)
学 DP 时一定要补上的第 5 步:手动追踪
很多 DP 题看懂状态和转移后,真正卡住的地方并不是代码语法,而是:不知道循环执行时 dp 数组到底怎样一步步变化。
因此每学一道新 DP 题,都建议拿一个很小的样例,手动画出:
- 初始数组是什么样。 哪些位置是
0,哪些位置是INF或“不可能”。 - 外层循环每走一步,新增或更新了哪些状态。 例如填完
i = 3后,dp[0..3]分别是多少。 - 某个格子为什么变成这个值。 它来自哪个旧状态?有没有和其他候选值取
min/max? - 最终答案从哪里取。 是
dp[n],还是要在一组状态里再取最大值/最小值。
后面的例题会加入更多这样的“手动追踪表”,帮助你把递推式和代码执行过程对应起来。
6.1.5 硬币找零——经典 DP
题目: 有面额为 coins[] 的硬币,凑出金额 W 最少需要多少枚?每种面额可以无限次使用。
数据规模: 1 ≤ 硬币种数 N ≤ 100,1 ≤ 面额 ≤ 10⁴,1 ≤ W ≤ 10⁴。
示例: coins = [1, 5, 6, 9],W = 11
先试试贪心(每次选最大的 ≤ 剩余金额):
- 贪心:9 + 1 + 1 = 3 枚 ← 不是最优!
- 最优:5 + 6 = 2 枚 ← DP 能找到
这就是为什么贪心在这里失败,需要 DP。
图示:硬币找零 DP 表
DP 表展示了 dp[i](凑出金额 i 的最少硬币数)从左到右的填写过程。对硬币 {1,3,4},注意 dp[3]=1(直接用硬币 3)和 dp[6]=2(用两个 3)。

DP 定义
对 coins = {1, 5, 6} 的状态转移:

- 状态:
dp[w]= 凑出恰好金额w的最少硬币数 - 递推:
dp[w] = 1 + min(对所有 c ≤ w 的硬币 c:dp[w - c])(使用硬币 c,然后最优地解决剩余的 w-c) - 初始条件:
dp[0] = 0(凑出金额 0 需要 0 枚) - 答案:
dp[W] - 顺序: w 从 1 到 W
完整演示:coins = [1, 5, 6, 9],W = 11
📄 查看代码:完整演示:coins = [1, 5, 6, 9],W = 11
dp[0] = 0 (初始条件)
dp[1]:用硬币 1:dp[0]+1=1 → dp[1] = 1
dp[2]:用硬币 1:dp[1]+1=2 → dp[2] = 2
...
dp[5]:用硬币 1:dp[4]+1=5
用硬币 5:dp[0]+1=1 → dp[5] = 1 ← 用 5 分硬币!
dp[6]:用硬币 1:dp[5]+1=2
用硬币 5:dp[1]+1=2
用硬币 6:dp[0]+1=1 → dp[6] = 1 ← 用 6 分硬币!
...
dp[11]:用硬币 5:dp[6]+1=2
用硬币 6:dp[5]+1=2 → dp[11] = 2 ← 5+6 或 6+5!
dp 表:[0, 1, 2, 3, 4, 1, 1, 2, 3, 1, 2, 2]
答案:dp[11] = 2(硬币 5 和 6)✓
手动追踪:每一轮金额填完后的 dp 数组
下面这张表展示 coins = [1, 5, 6, 9]、W = 11 时,外层循环每处理完一个金额 w 后,dp[0..11] 的变化。∞ 表示当前还凑不出来。
| 已处理金额 | dp[0..11] |
|---|---|
| 初始 | [0, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞] |
w = 1 | [0, 1, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞] |
w = 2 | [0, 1, 2, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞] |
w = 3 | [0, 1, 2, 3, ∞, ∞, ∞, ∞, ∞, ∞, ∞, ∞] |
w = 4 | [0, 1, 2, 3, 4, ∞, ∞, ∞, ∞, ∞, ∞, ∞] |
w = 5 | [0, 1, 2, 3, 4, 1, ∞, ∞, ∞, ∞, ∞, ∞] |
w = 6 | [0, 1, 2, 3, 4, 1, 1, ∞, ∞, ∞, ∞, ∞] |
w = 7 | [0, 1, 2, 3, 4, 1, 1, 2, ∞, ∞, ∞, ∞] |
w = 8 | [0, 1, 2, 3, 4, 1, 1, 2, 3, ∞, ∞, ∞] |
w = 9 | [0, 1, 2, 3, 4, 1, 1, 2, 3, 1, ∞, ∞] |
w = 10 | [0, 1, 2, 3, 4, 1, 1, 2, 3, 1, 2, ∞] |
w = 11 | [0, 1, 2, 3, 4, 1, 1, 2, 3, 1, 2, 2] |
注意 w = 5、w = 6、w = 9 这些位置会突然变小,因为它们可以直接使用面额为 5、6、9 的硬币。
// 最少硬币找零 — O(N × W)
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, W;
cin >> n >> W;
vector<int> coins(n);
for (int &c : coins) cin >> c;
const int INF = 1e9;
vector<int> dp(W + 1, INF); // dp[w] = 凑出 w 的最少硬币数
dp[0] = 0; // 初始条件
for (int w = 1; w <= W; w++) {
for (int c : coins) {
if (c <= w && dp[w - c] != INF) {
dp[w] = min(dp[w], dp[w - c] + 1); // ← 关键行
}
}
}
if (dp[W] == INF) {
cout << "Impossible\n";
} else {
cout << dp[W] << "\n";
}
return 0;
}
复杂度分析:
- 时间:
O(N × W)—— 对每个金额 w(1..W),尝试所有 N 种硬币 - 空间:
O(W)—— 只需 dp 数组
6.1.6 方法数——硬币找零变体
题目: 用给定硬币凑出金额 W 有多少种不同方法?每种硬币可以使用无限次。
数据规模: 1 ≤ 硬币种数 N ≤ 100,1 ≤ 面额 ≤ 10⁴,1 ≤ W ≤ 10⁴。答案对 10⁹+7 取模。
这一类题和“最少硬币数”很像,但目标变了:
- 最少硬币数:求
min。 - 方法数:求
sum。
先定义状态:ways[w] 表示什么?
ways[w] = 凑出金额 w 的方法数
最重要的初始条件是:
ways[0] = 1;
这句话一开始很反直觉:金额 0 为什么有 1 种方法?
因为它表示“什么都不选”这一种空方案。它的作用是给后面的转移提供起点。例如如果有一枚硬币 5,那么:
ways[5] += ways[5 - 5]
ways[5] += ways[0]
如果 ways[0] 不是 1,就无法正确产生“只用一枚 5 元硬币”这 1 种方法。
情况一:有序方法数(排列)
有序表示顺序重要:[1, 5] 和 [5, 1] 是两种不同方法。
这时我们按“最后一枚硬币是什么”来思考。
如果要凑出金额 w,最后一枚硬币可能是任意 c。那么前面的部分必须凑出 w - c:
ways[w] += ways[w - c]
代码如下:
vector<long long> ways(W + 1, 0);
ways[0] = 1; // 凑出 0:一种方法(不用硬币)
for (int w = 1; w <= W; w++) {
for (int c : coins) {
if (c <= w) {
ways[w] += ways[w - c];
}
}
}
注意外层循环是金额 w。这代表:我们依次计算 ways[1]、ways[2]、ways[3]……每个 ways[w] 都会尝试把每种硬币放在最后。
手动追踪:有序方法数
以 coins = [1, 2],W = 4 为例。
当前金额 w | 转移过程 | 更新后的 ways[0..4] |
|---|---|---|
| 初始 | ways[0] = 1 | [1, 0, 0, 0, 0] |
w = 1 | 最后一枚只能是 1:ways[1] += ways[0] = 1 | [1, 1, 0, 0, 0] |
w = 2 | 最后是 1:接在凑出 1 的方法后;最后是 2:接在凑出 0 的方法后 | [1, 1, 2, 0, 0] |
w = 3 | 最后是 1:ways[2] = 2;最后是 2:ways[1] = 1;总共 3 | [1, 1, 2, 3, 0] |
w = 4 | 最后是 1:ways[3] = 3;最后是 2:ways[2] = 2;总共 5 | [1, 1, 2, 3, 5] |
所以有序时,凑出 4 的 5 种方法是:
1 + 1 + 1 + 1
1 + 1 + 2
1 + 2 + 1
2 + 1 + 1
2 + 2
可以看到,1 + 1 + 2、1 + 2 + 1、2 + 1 + 1 被算作三种不同方法,因为顺序不同。
情况二:无序方法数(组合)
无序表示顺序不重要:[1, 5] 和 [5, 1] 是同一种方法。
这时不能再按“最后一枚硬币”来算,因为这样会把不同顺序重复统计。我们要换一种思路:按硬币种类逐个引入。
代码如下:
vector<long long> ways(W + 1, 0);
ways[0] = 1;
for (int c : coins) { // 外层循环:硬币种类
for (int w = c; w <= W; w++) { // 内层循环:金额
ways[w] += ways[w - c];
}
}
这段代码的含义是:
- 处理硬币
1后,ways[w]表示“只使用硬币1”能凑出w的方法数。 - 再处理硬币
2后,ways[w]表示“只使用硬币1和2”能凑出w的方法数。 - 如果还有硬币
5,处理完后,ways[w]表示“只使用硬币1、2、5”能凑出w的方法数。
因为硬币种类是按固定顺序引入的,所以同一组硬币不会因为排列顺序不同而被重复计算。
手动追踪:无序方法数
仍然看 coins = [1, 2],W = 4。
| 已处理硬币 | 更新过程 | 更新后的 ways[0..4] |
|---|---|---|
| 初始 | ways[0] = 1 | [1, 0, 0, 0, 0] |
处理硬币 1 | ways[1] += ways[0],ways[2] += ways[1],ways[3] += ways[2],ways[4] += ways[3] | [1, 1, 1, 1, 1] |
处理硬币 2,w = 2 | 新增 2:ways[2] += ways[0] | [1, 1, 2, 1, 1] |
处理硬币 2,w = 3 | 新增 1 + 2:ways[3] += ways[1] | [1, 1, 2, 2, 1] |
处理硬币 2,w = 4 | 新增 2 + 2 和 1 + 1 + 2:ways[4] += ways[2] | [1, 1, 2, 2, 3] |
所以无序时,凑出 4 的 3 种方法是:
1 + 1 + 1 + 1
1 + 1 + 2
2 + 2
这里不会再单独统计 1 + 2 + 1、2 + 1 + 1,因为它们和 1 + 1 + 2 使用的是同一组硬币。
为什么只是交换两层循环,答案就不同?
关键在于 ways[w] 在循环中代表的含义不同。
| 写法 | 外层循环 | ways[w] 的含义 | 统计结果 |
|---|---|---|---|
| 有序 | 金额 w | 当前金额的所有排列方法数 | 排列数,顺序重要 |
| 无序 | 硬币 c | 只使用已经处理过的硬币种类时的方法数 | 组合数,顺序不重要 |
可以用一句话记住:
金额在外层,枚举的是“最后一步”,所以会统计顺序;硬币在外层,枚举的是“使用哪些硬币种类”,所以不会统计顺序。
用 [1, 5] 和 [5, 1] 理解重复统计
假设 coins = [1, 5],要凑出 6。
有序写法中,计算 ways[6] 时:
- 最后一枚是
1:来自ways[5],其中包含[5],于是得到[5, 1]。 - 最后一枚是
5:来自ways[1],其中包含[1],于是得到[1, 5]。
所以 [1, 5] 和 [5, 1] 会被分开统计。
无序写法中,先处理硬币 1,再处理硬币 5。当处理硬币 5 时,只会把 5 加到“已经由硬币 1 组成的方法”后面,于是得到的是同一种组合 {1, 5},不会再倒过来统计一次。
易错点提醒
- 忘记
ways[0] = 1。 这样所有方法数都会变成0,因为没有起点。 - 把排列和组合的循环顺序写反。 如果题目说“顺序不同算不同方法”,金额放外层;如果题目说“硬币组合”,硬币放外层。
- 方法数可能很大。 题目通常会要求对某个数取模,例如
1e9 + 7,这时每次加法后都要% MOD。
6.1.7 状态设计四问:从题目到 DP 表
很多同学觉得 DP 难,不是因为代码难,而是因为不知道 dp[...] 到底该表示什么。遇到新题时,先不要急着写递推式,按下面四个问题拆开:
| 问题 | 你要找什么 | 常见信号 |
|---|---|---|
| 1. 处理到哪里? | 前 i 个元素、前 i 天、前 i 轮 | 序列、天数、轮次、位置 |
| 2. 还需要记住什么? | 当前状态、剩余次数、上一次选择 | 「最多换 K 次」「当前手势」「背包容量」 |
| 3. 当前一步有哪些选择? | 选/不选、换/不换、分组长度 | 「可以」「最多」「任意连续一段」 |
| 4. 答案怎么从状态中取出? | 最大值、最小值、方案数 | max / min / sum |
💡 状态设计口诀:
dp状态必须刚好包含「决定未来所需的信息」。少了会无法转移,多了会爆内存或超时。
6.1.8 USACO 真题训练:状态设计实战
真题 1:Hoof, Paper, Scissors(USACO 2017 January Gold)— 三维状态 DP
题目链接: USACO 2017 January Gold P2: Hoof, Paper, Scissors
对应模式: 序列 DP + 有限次状态切换
难度定位: Gold 入门
题干解读
Bessie 和 FJ 玩 N 轮 Hoof, Paper, Scissors。三种手势分别是 H(Hoof)、P(Paper)、S(Scissors),胜负关系为:H 赢 S,P 赢 H,S 赢 P。
FJ 接下来 N 轮会出的手势已经提前给出。Bessie 可以根据这份完整序列来安排自己每一轮的手势,但她最多只能改变手势 K 次。也就是说,Bessie 第 1 轮前选择初始手势不算改变;之后只有当第 i 轮和第 i-1 轮使用的手势不同时,才算改变 1 次。目标是让 Bessie 赢的轮数尽可能多。
例如,如果 K = 0,Bessie 只能整场都出同一种手势;如果 K = 1,她最多可以先连续出一种手势,再在某一轮之后切换成另一种手势。
数据规模(与原题一致): 1 ≤ N ≤ 100,000,0 ≤ K ≤ 20。
关键条件:
N很大,不能枚举所有手势序列。K较小,说明「换了几次」适合作为 DP 维度。- 当前出什么手势会影响下一轮是否算「改变」,所以当前手势也必须记住。
思路分析
状态定义:
dp[i][j][g] = 处理前 i 轮,已经换了 j 次,当前手势为 g 的最多胜场
第 i 轮可以:
- 继续用手势
g:不增加切换次数。 - 从其他手势切换到
g:切换次数 +1。
每轮还要加上 g 是否能赢 FJ 第 i 轮手势的得分。
手动追踪:三维状态如何变化
三维数组不适合完整画出来,可以把 dp[i][used][g] 按 used 分层看。下面用一个小样例:
N = 4, K = 1
FJ = H S H P
表中 [H, P, S] 表示当前手势分别为 H/P/S 时的最多胜场,- 表示这个状态不可能出现。
| 已处理轮数 | FJ 当前手势 | used = 0 的 [H, P, S] | used = 1 的 [H, P, S] |
|---|---|---|---|
i = 1 | H | [0, 1, 0] | [-, -, -] |
i = 2 | S | [1, 1, 0] | [2, 0, 1] |
i = 3 | H | [1, 2, 0] | [2, 2, 1] |
i = 4 | P | [1, 2, 1] | [2, 2, 3] |
读这张表时,可以抓住两个动作:
- 不换手势:例如
i = 3, used = 0, P来自上一轮used = 0, P,再加上P赢H的 1 分,所以从1变成2。 - 换手势:例如
i = 4, used = 1, S可以从上一轮used = 0, P切换而来。上一轮P的最好成绩是2,这一轮S赢P再加 1 分,所以得到3。
最终答案是所有 used <= K、所有当前手势中的最大值,也就是 3。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int gestureId(char c) {
if (c == 'H') return 0;
if (c == 'P') return 1;
return 2; // 'S'
}
bool win(int bessie, int fj) {
// H beats S, P beats H, S beats P
return (bessie == 0 && fj == 2) ||
(bessie == 1 && fj == 0) ||
(bessie == 2 && fj == 1);
}
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("hps.in", "r", stdin);
// freopen("hps.out", "w", stdout);
int n, k;
cin >> n >> k;
vector<int> fj(n + 1);
for (int i = 1; i <= n; i++) {
char c;
cin >> c;
fj[i] = gestureId(c);
}
const int NEG = -1e9;
vector dp(n + 1, vector(k + 1, vector<int>(3, NEG)));
// 第 1 轮可以直接选择任意手势,不算切换
for (int g = 0; g < 3; g++) {
dp[1][0][g] = win(g, fj[1]) ? 1 : 0;
}
for (int i = 2; i <= n; i++) {
for (int used = 0; used <= k; used++) {
for (int cur = 0; cur < 3; cur++) {
int score = win(cur, fj[i]) ? 1 : 0;
// 不换手势
dp[i][used][cur] = max(dp[i][used][cur], dp[i - 1][used][cur] + score);
// 从其他手势切换到 cur
if (used > 0) {
for (int prev = 0; prev < 3; prev++) {
if (prev == cur) continue;
dp[i][used][cur] = max(dp[i][used][cur], dp[i - 1][used - 1][prev] + score);
}
}
}
}
}
int answer = 0;
for (int used = 0; used <= k; used++) {
for (int g = 0; g < 3; g++) {
answer = max(answer, dp[n][used][g]);
}
}
cout << answer << "\n";
return 0;
}
复杂度: O(N × K × 3 × 3),由于手势只有 3 种,可视为 O(NK);空间 O(NK),可用滚动数组优化到 O(K)。
易错点提醒
- 把「最多 K 次」写成「恰好 K 次」。 最后答案要枚举
used = 0..K。 - 初始状态错误。 第 1 轮可以直接选择任意手势,不算切换,所以
dp[1][0][g]应初始化为第 1 轮得分。 - 胜负关系写反。 H/P/S 与石头剪刀布类似,但名字不同,建议写独立
win()函数。 - 状态缺少当前手势。 如果只写
dp[i][j],无法判断下一轮是否发生切换。
拓展思考
如果手势种类从 3 种变成 M 种,复杂度会变为 O(NKM^2)。此时可以维护每个 used 层的最大值和次大值,将切换转移优化到 O(NKM)。
真题 2:Teamwork(USACO 2018 December Gold)— 枚举最后一组
题目链接: USACO 2018 December Gold P3: Teamwork
对应模式: 一维 DP + 枚举最后一段
难度定位: Gold 入门
题干解读
N 头奶牛排成一行,每头有技能值。可以把连续奶牛分成若干组,每组长度不超过 K。一组中所有奶牛的贡献都变成该组最大技能值。求最大总贡献。
关键条件:
- 分组必须是连续段。
- 每组长度最多
K。 - 每一段的贡献是
长度 × 段内最大值。
思路分析
从前往后考虑。设:
dp[i] = 前 i 头奶牛分组后的最大总贡献
最后一组可能长度为 len = 1..K,覆盖 [i-len+1, i]。只要枚举最后一组长度,就能把问题拆成:
dp[i] = max(dp[i-len] + len * max(skill[i-len+1..i]))
枚举 len 时同步维护当前段最大值,避免每次重新扫描。
手动追踪:dp[i] 如何一步步更新
用一个小样例观察代码执行过程:
N = 5, K = 3
skill = [1, 15, 7, 9, 2]
dp[i] 表示前 i 头奶牛已经分好组后的最大总贡献。每一行都在枚举“最后一组”的长度。
i | 枚举最后一组 | 候选值 | dp[i] | 当前 dp[0..i] |
|---|---|---|---|---|
1 | [1] | dp[0] + 1×1 = 1 | 1 | [0, 1] |
2 | [15], [1,15] | dp[1]+15×1=16, dp[0]+15×2=30 | 30 | [0, 1, 30] |
3 | [7], [15,7], [1,15,7] | 37, 31, 45 | 45 | [0, 1, 30, 45] |
4 | [9], [7,9], [15,7,9] | 54, 48, 46 | 54 | [0, 1, 30, 45, 54] |
5 | [2], [9,2], [7,9,2] | 56, 63, 57 | 63 | [0, 1, 30, 45, 54, 63] |
这张表对应代码里的内层循环:len 从 1 增加到 K,groupMax 一边向左扩展最后一组,一边维护这组里的最大技能值。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// USACO 官方文件 I/O 可按需打开:
// freopen("teamwork.in", "r", stdin);
// freopen("teamwork.out", "w", stdout);
int n, k;
cin >> n >> k;
vector<int> skill(n + 1);
for (int i = 1; i <= n; i++) cin >> skill[i];
vector<int> dp(n + 1, 0);
for (int i = 1; i <= n; i++) {
int groupMax = 0;
for (int len = 1; len <= k && i - len + 1 >= 1; len++) {
groupMax = max(groupMax, skill[i - len + 1]);
dp[i] = max(dp[i], dp[i - len] + groupMax * len);
}
}
cout << dp[n] << "\n";
return 0;
}
复杂度: 外层 N,内层最多 K,总时间 O(NK);空间 O(N)。
易错点提醒
- 最后一组左端点越界。 条件必须包含
i - len + 1 >= 1。 - 每次重新求区间最大值。 会变成
O(NK^2);应在枚举len时维护groupMax。 - 状态定义不清。
dp[i]必须表示「前 i 头已经完全分好组」,这样dp[i-len]才能无缝接上最后一组。 - 误以为是贪心。 每次把强奶牛尽量扩组不一定最优,因为会影响后面组的边界。
拓展思考
Teamwork 是「枚举最后一段」DP 的典型例子。类似模式还会出现在:分割数组、文本换行、区间分段最优化中。识别信号是:答案由若干连续段组成,每段有独立贡献,段长有限制。
⚠️ 第 6.1 章常见错误
- 最小化问题用 0 而非 INF 初始化 dp:
dp[w] = 0表示「0 枚硬币」,永远不会被改善。用dp[w] = INF,只有dp[0] = 0。 - 使用
dp[w-c]前不检查dp[w-c] != INF:INF + 1会溢出!始终检查子问题是否可解。 - 背包变体的循环顺序错误: 无界背包(硬币无限),金额正向循环;0/1 背包(每个只用一次),金额反向循环。搞错这一点会给出静默的错误答案。
- 用
INT_MAX作为 INF 然后加 1:INT_MAX + 1溢出成负数。用1e9或1e18作为 INF。 - 忘记初始条件:
dp[0] = 0至关重要,没有它什么都设不好。
本章总结
📌 核心要点
| 概念 | 要点 | 何时使用 |
|---|---|---|
| 重叠子问题 | 相同计算指数级重复 | 递归树中有重复调用 |
| 记忆化(自顶向下) | 缓存递归结果;易于编写 | 递归结构清晰时 |
| 递推(自底向上) | 迭代填表;无栈溢出 | 最终竞赛提交;大 N |
| DP 状态 | 唯一标识子问题的信息 | 仔细定义——决定了一切 |
| DP 递推 | dp[状态] 如何依赖更小状态 | 「转移方程」 |
| 初始条件 | 最简单子问题的已知答案 | 通常 dp[0] = 某个平凡值 |
🧩 DP 四步法速查
| 步骤 | 问题 | 斐波那契示例 |
|---|---|---|
| 1. 定义状态 | "dp[i] 代表什么?" | dp[i] = 第 i 个斐波那契数 |
| 2. 写递推 | "dp[i] 依赖哪些更小的状态?" | dp[i] = dp[i-1] + dp[i-2] |
| 3. 确定初始条件 | "最小子问题的答案是什么?" | dp[0]=0,dp[1]=1 |
| 4. 确定填充顺序 | "i 从小到大?从大到小?" | i 从 2 到 n |
❓ 常见问题
Q1:怎么判断一道题是 DP 题?
A:两个信号:① 题目问「最优值」或「方法数」(不是「输出具体方案」);② 存在重叠子问题(暴力递归中相同子问题被计算多次)。若贪心能被证明正确,通常不需要 DP;否则很可能是 DP。
Q2:应该用自顶向下还是自底向上?
A:学习时用自顶向下(更自然地表达递归思维);竞赛提交用自底向上(更快,无栈溢出)。两者都正确。若能快速写出自底向上,直接用它。
Q3:什么是「最优子结构」(无后效性)?
A:DP 的核心前提条件——一旦
dp[i]确定,后续计算不会「回来」修改它。换句话说,dp[i]的值只依赖于「过去」(更小的状态),而不是「未来」。若违反这个性质,不能用 DP。
Q4:INF 应该设为多少?
A:
int类型用1e9(= 10^9),long long类型用1e18(= 10^18)。不要用INT_MAX,因为INT_MAX + 1溢出成负数。
🔗 与后续章节的联系
- 第 6.2 章(经典 DP):扩展到 LIS、背包、网格路径——都是本章四步 DP 法的应用
- 第 6.3 章(进阶 DP):进入状压 DP、区间 DP、树形 DP——更复杂的状态定义,但思路相同
- 第 3.2 章(前缀和):差分数组有时可以替代简单 DP,前缀和数组可以加速 DP 中的区间计算
- 第 4 部分(贪心) vs DP:贪心可解的问题是 DP 的特例(每步局部最优 = 全局最优);贪心失败时需要 DP
练习题
题目 6.1.1 — 爬楼梯 🟢 简单 每次可以爬 1 或 2 级台阶,有多少种方法爬 N 级台阶?
数据规模: 1 ≤ N ≤ 90(方法数可达 ~10¹⁸,需 long long)。
提示
这就是斐波那契!ways[1]=1,ways[2]=2。或从 ways[0]=1, ways[1]=1 开始,then ways[n] = ways[n-1] + ways[n-2]。核心思路: ways[n] = 到达台阶 n 的方法数。你从台阶 n-1(1 步)或台阶 n-2(2 步)到达。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
if (n == 1) { cout << 1; return 0; }
vector<long long> dp(n + 1);
dp[1] = 1; dp[2] = 2;
for (int i = 3; i <= n; i++)
dp[i] = dp[i-1] + dp[i-2];
cout << dp[n] << "\n";
}
复杂度: O(N) 时间,O(N) 空间(可用两个变量降为 O(1))。
题目 6.1.2 — 最少硬币找零 🟡 中等 给定硬币面额 [1, 3, 4] 和目标 6,找最少硬币数。(期望答案:2 枚——用 3+3)
数据规模: 1 ≤ 硬币种数 ≤ 100,1 ≤ 面额 ≤ 10⁴,1 ≤ W ≤ 10⁴。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, W; cin >> n >> W;
vector<int> coins(n);
for (int& c : coins) cin >> c;
const int INF = 1e9;
vector<int> dp(W + 1, INF);
dp[0] = 0;
for (int w = 1; w <= W; w++) {
for (int c : coins) {
if (c <= w && dp[w - c] != INF)
dp[w] = min(dp[w], dp[w - c] + 1);
}
}
cout << (dp[W] == INF ? -1 : dp[W]) << "\n";
}
贪心选 4 → 4+1+1 = 3 枚;DP 找 3+3 = 2 枚。复杂度: O(N × W)。
题目 6.1.3 — 瓷砖铺设 🟡 中等 用 1×2 多米诺骨牌(水平或垂直放置)铺满 2×N 的棋盘,有多少种方法?
数据规模: 1 ≤ N ≤ 10⁶。答案对 10⁹+7 取模。
提示
递推与斐波那契相同!关键洞察:在第 N 列放一块竖排骨牌,递归到 n-1;在第 N-1 和 N 列放两块横排骨牌,递归到 n-2。#include <bits/stdc++.h>
using namespace std;
const long long MOD = 1e9 + 7;
int main() {
int n; cin >> n;
if (n == 1) { cout << 1; return 0; }
vector<long long> dp(n + 1);
dp[1] = 1; dp[2] = 2;
for (int i = 3; i <= n; i++)
dp[i] = (dp[i-1] + dp[i-2]) % MOD;
cout << dp[n] << "\n";
}
复杂度: O(N)。
题目 6.1.4 — 有限次使用的硬币找零 🔴 困难 与硬币找零相同,但每种硬币最多用一次(0/1 背包),找最少硬币数。
数据规模: 1 ≤ 硬币种数 N ≤ 1000,1 ≤ 面额 ≤ 10⁴,1 ≤ W ≤ 10⁴。
提示
0/1 背包变体,关键技巧:将 w 从 W 反向迭代到 coins[i],防止重复使用同一枚硬币。#include <bits/stdc++.h>
using namespace std;
int main() {
int n, W; cin >> n >> W;
vector<int> coins(n);
for (int& c : coins) cin >> c;
const int INF = 1e9;
vector<int> dp(W + 1, INF);
dp[0] = 0;
for (int i = 0; i < n; i++) {
// 反向顺序:防止硬币 i 被用超过一次
for (int w = W; w >= coins[i]; w--) {
if (dp[w - coins[i]] != INF)
dp[w] = min(dp[w], dp[w - coins[i]] + 1);
}
}
cout << (dp[W] == INF ? -1 : dp[W]) << "\n";
}
为什么反向? 正向时可能用更新过的 dp[w] 来更新自身——等于把同一枚硬币用了两次。复杂度: O(N × W)。
题目 6.1.5 — USACO Bronze:干草堆叠放 🔴 困难 N 次操作「给位置 L 到 R 的所有位置加 1」,求每个位置的最终值。
数据规模(与原题一致): 1 ≤ N ≤ 10⁶,1 ≤ 操作数 K ≤ 25,000,1 ≤ L ≤ R ≤ N。
提示
差分数组:`diff[L]++`,`diff[R+1]--`,然后取前缀和得到最终值。#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, q; cin >> n >> q;
vector<long long> diff(n + 2, 0);
while (q--) {
int l, r; cin >> l >> r;
diff[l]++;
diff[r + 1]--;
}
long long cur = 0;
for (int i = 1; i <= n; i++) {
cur += diff[i];
cout << cur << " \n"[i == n];
}
}
复杂度: O(N + Q)。
🏆 挑战题:有障碍的唯一路径 N×M 网格有「.」格子和「#」障碍,统计从 (1,1) 到 (N,M) 只向右或向下移动的路径数,答案对 10^9+7 取模。(N, M ≤ 1000)
✅ 完整题解
#include <bits/stdc++.h>
using namespace std;
const long long MOD = 1e9 + 7;
int main() {
int n, m; cin >> n >> m;
vector<string> grid(n);
for (auto& row : grid) cin >> row;
vector<vector<long long>> dp(n, vector<long long>(m, 0));
if (grid[0][0] == '.') dp[0][0] = 1;
上图展示了 fib(6) 的朴素递归。红色虚线节点是**重复子问题**——被多次计算。绿色节点展示记忆化缓存结果的位置。不用记忆化:`O(2^N)`;用记忆化:`O(N)`。这是动态规划背后的基本洞察。第 6.2 章:经典 DP 问题
本章我们处理竞赛编程中最重要、应用最广泛的三个 DP 问题。掌握这些模式将帮助你识别并解决数十道 USACO 题目。
6.2.1 最长递增子序列(LIS)
题目: 给定 N 个整数的数组 A(1 ≤ N ≤ 10⁵,−10⁹ ≤ A[i] ≤ 10⁹),找最长的严格递增子序列的长度。子序列不需要连续,但必须保持相对顺序。
输入格式: 第一行 N;第二行 N 个整数。 数据规模: N ≤ 5000 时下方 O(N²) DP 足够;N 最大 10⁵ 时需要 O(N log N) 的耐心排序。
示例: A = [3, 1, 8, 2, 5]
- LIS:[1, 2, 5] → 长度 3
- 或:[3, 8] → 长度 2(不是最长)
💡 核心思路: 子序列可以跳过元素,但必须保持相对顺序。关键 DP 洞察:对每个下标 i,问「以 A[i] 结尾的最长递增子序列是什么?」然后对所有 i 取最大值就是答案。
LIS 状态转移——A = [3, 1, 8, 2, 5]:

💡 转移规则:
dp[i] = 1 + max(dp[j])(对所有 j < i 且 A[j] < A[i])。每条箭头表示「以 j 结尾的子序列可以延伸到包含 i」。

O(N²) DP 解法
- 状态:
dp[i]= 以下标 i 结尾的最长递增子序列长度 - 递推:
dp[i] = 1 + max(对所有 j < i 且 A[j] < A[i] 的 dp[j]) - 初始条件:
dp[i] = 1(只含 A[i] 自身的子序列) - 答案:
max(dp[0], dp[1], ..., dp[N-1])
对 A = [3, 1, 8, 2, 5] 的逐步追踪:
dp[0] = 1 (以 3 结尾的 LIS:只有 [3])
dp[1] = 1 (以 1 结尾的 LIS:只有 [1])
dp[2] = 2 (以 8 结尾的 LIS:[3,8] 或 [1,8])
dp[3] = 2 (以 2 结尾的 LIS:[1,2])
dp[4] = 3 (以 5 结尾的 LIS:[1,2,5])
LIS 长度 = max(dp) = 3
// LIS O(N²) — 简单但 N > 5000 时太慢
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> A(n);
for (int &x : A) cin >> x;
vector<int> dp(n, 1); // 每个元素单独是长度为 1 的子序列
for (int i = 1; i < n; i++) {
for (int j = 0; j < i; j++) {
if (A[j] < A[i]) { // A[j] 可以延伸到 A[i]
dp[i] = max(dp[i], dp[j] + 1); // ← 关键行
}
}
}
cout << *max_element(dp.begin(), dp.end()) << "\n";
return 0;
}
样例输入: 5 / 3 1 8 2 5 → 输出: 3
复杂度分析:
- 时间:
O(N²)—— 双重循环 - 空间:
O(N)—— dp 数组
N ≤ 5000 时 O(N²) 够快,N 最大 10^5 时需要 O(N log N) 方案。
O(N log N) LIS(耐心排序)
关键思路:维护 tails 数组,其中 tails[k] = 迄今为止任意长度为 k+1 的递增子序列中最小可能的尾部元素。
💡 核心思路(耐心排序): 想象把牌发到若干叠(像接龙游戏)。每叠是递减序列,一张牌放到顶牌 ≥ 它的最左侧那叠。若无这样的叠,开一叠新的。牌的叠数就等于 LIS 长度!
tails数组正是这些叠的顶牌。
对 A = [3, 1, 8, 2, 5] 的逐步追踪:
处理 3:tails=[],无元素 ≥ 3,追加:tails=[3]
处理 1:tails=[3],lower_bound(1) 在下标 0(3 ≥ 1),替换:tails=[1]
处理 8:tails=[1],lower_bound(8) 到末尾,追加:tails=[1,8]
处理 2:tails=[1,8],lower_bound(2) 在下标 1(8 ≥ 2),替换:tails=[1,2]
处理 5:tails=[1,2],lower_bound(5) 到末尾,追加:tails=[1,2,5]
答案 = tails.size() = 3
// LIS O(N log N) — N 最大 10^5 时够快
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> A(n);
for (int &x : A) cin >> x;
vector<int> tails; // tails[i] = 长度为 i+1 的 IS 的最小尾元素
for (int x : A) {
// 找第一个 tails[pos] >= x(严格递增用 lower_bound)
auto it = lower_bound(tails.begin(), tails.end(), x);
if (it == tails.end()) {
tails.push_back(x); // x 延伸了最长子序列
} else {
*it = x; // ← 关键行:替换以保持最小可能尾部
}
}
cout << tails.size() << "\n";
return 0;
}
⚠️ 注意:
tails不存储实际的 LIS 元素,只存储其长度。lower_bound给出严格递增的 LIS(A[j] < A[i]);若需不减序列(A[j] ≤ A[i]),改用upper_bound。
复杂度: O(N log N) 时间,O(N) 空间。
6.2.2 0/1 背包问题
题目: 有 N 件物品(1 ≤ N ≤ 1000),物品 i 的重量为 w[i](1 ≤ w[i] ≤ W),价值为 v[i](1 ≤ v[i] ≤ 10⁹)。背包最多承重 W(1 ≤ W ≤ 1000),选择物品使总价值最大,每件物品最多选一次(0/1 = 拿或不拿)。总价值可能超过 int 范围。
输入格式: 第一行 N 和 W;接下来 N 行每行 w[i] 和 v[i]。 数据规模: N, W ≤ 1000,O(N × W) = 10⁶ 的 DP 轻松通过。
图示:背包 DP 表
二维表展示了 dp[物品][容量],每行加入一件物品,答案在右下角。

DP 公式
0/1 背包决策——拿或不拿物品 i:

💡 与无界背包的关键区别: 因为每件物品只能用一次,「拿」时从行
dp[i-1]读取,而不是当前行。这就是为什么一维优化版本要反向迭代重量。
- 状态:
dp[i][w]= 使用物品 1..i 且总重量 ≤ w 时的最大价值 - 递推:
- 不拿物品 i:
dp[i][w] = dp[i-1][w] - 拿物品 i(仅在 w[i] ≤ w 时):
dp[i][w] = dp[i-1][w - weight[i]] + value[i] - 取最大值
- 不拿物品 i:
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, W;
cin >> n >> W;
vector<int> weight(n + 1), value(n + 1);
for (int i = 1; i <= n; i++) cin >> weight[i] >> value[i];
vector<vector<int>> dp(n + 1, vector<int>(W + 1, 0));
for (int i = 1; i <= n; i++) {
for (int w = 0; w <= W; w++) {
dp[i][w] = dp[i-1][w]; // 选项一:不拿物品 i
if (weight[i] <= w) { // 选项二:拿物品 i(如果放得下)
dp[i][w] = max(dp[i][w], dp[i-1][w - weight[i]] + value[i]);
}
}
}
cout << dp[n][W] << "\n";
return 0;
}
空间优化的 0/1 背包——O(W) 空间
只需要上一行 dp[i-1],可以用一维数组。关键: w 从 W 倒序迭代(否则物品 i 会被使用多次):
vector<int> dp(W + 1, 0);
for (int i = 1; i <= n; i++) {
// 倒序迭代,防止物品 i 被使用多次
for (int w = W; w >= weight[i]; w--) {
dp[w] = max(dp[w], dp[w - weight[i]] + value[i]);
}
}
cout << dp[W] << "\n";
为什么倒序? 计算
dp[w]时,需要上一件物品行的dp[w - weight[i]]。倒序迭代确保dp[w - weight[i]]还没被当前物品 i 更新过。
无界背包(物品无限次可用)
若每件物品可以使用多次,改为正序迭代:
for (int i = 1; i <= n; i++) {
for (int w = weight[i]; w <= W; w++) { // 正序——允许重复使用
dp[w] = max(dp[w], dp[w - weight[i]] + value[i]);
}
}
6.2.3 网格路径计数
题目: 统计从网格左上角 (1,1) 到右下角 (N,M)(1 ≤ N, M ≤ 2000,. = 可通行,# = 堵塞)只向右或向下移动的路径数。路径数可能极大,答案对 10⁹+7 取模(本题代码演示 long long 版本;N+M 较小时 long long 不溢出)。
输入格式: 第一行 N 和 M;接下来 N 行每行一个长度为 M 的网格。
图示:网格路径 DP 值

每个格子展示了从 (0,0) 到该格子的路径数。递推 dp[i][j] = dp[i-1][j] + dp[i][j-1] 叠加了从上方和左方到达的路径。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, m;
cin >> n >> m;
vector<string> grid(n);
for (int r = 0; r < n; r++) cin >> grid[r];
// dp[r][c] = 到达 (r, c) 的路径数
vector<vector<long long>> dp(n, vector<long long>(m, 0));
// 初始条件:起始格子(若不堵塞)
if (grid[0][0] != '#') dp[0][0] = 1;
// 填充第一行(只能从左来)
for (int c = 1; c < m; c++) {
if (grid[0][c] != '#') dp[0][c] = dp[0][c-1];
}
// 填充第一列(只能从上来)
for (int r = 1; r < n; r++) {
if (grid[r][0] != '#') dp[r][0] = dp[r-1][0];
}
// 填充其余格子
for (int r = 1; r < n; r++) {
for (int c = 1; c < m; c++) {
if (grid[r][c] == '#') {
dp[r][c] = 0; // 堵塞——无路径经过此处
} else {
dp[r][c] = dp[r-1][c] + dp[r][c-1]; // 从上 + 从左
}
}
}
cout << dp[n-1][m-1] << "\n";
return 0;
}
网格最大价值路径
题目: 找从 (1,1) 到 (N,M)(1 ≤ N, M ≤ 1000,格子值 −10⁹ ≤ val ≤ 10⁹,答案用 64 位整数)只向右或向下移动、最大化路径上值之和的路径,输出最大和。
// ...读取 val[r][c]...
vector<vector<long long>> dp(n, vector<long long>(m, 0));
dp[0][0] = val[0][0];
for (int c = 1; c < m; c++) dp[0][c] = dp[0][c-1] + val[0][c];
for (int r = 1; r < n; r++) dp[r][0] = dp[r-1][0] + val[r][0];
for (int r = 1; r < n; r++) {
for (int c = 1; c < m; c++) {
dp[r][c] = max(dp[r-1][c], dp[r][c-1]) + val[r][c];
}
}
cout << dp[n-1][m-1] << "\n";
6.2.4 USACO DP 示例:牛蹄剪刀布
题目(USACO 2019 January Silver): Bessie 玩 N 局牛蹄剪刀布(Hoof–Paper–Scissors,类似石头剪刀布)。她事先知道对手每一局的出法(H/P/S 之一),但在任意时刻只能「换手势」至多 K 次(每局之间可以切换到任意不同手势,每次切换计 1 次)。最大化获胜局数(牛蹄胜剪刀、剪刀胜纸、纸胜牛蹄)。
输入格式: 第一行 N 和 K;接下来 N 行每行一个字符 H、P 或 S 表示对手第 i 局的出法。 数据规模(真题): 1 ≤ N ≤ 100,000,1 ≤ K ≤ 20。O(N × K × 9) 的 DP 轻松通过。
状态: dp[j][g] = 前 i 局换了 j 次、当前出手势 g 时的最大获胜数。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, k;
cin >> n >> k;
// 0=牛蹄, 1=纸, 2=剪刀
vector<int> opp(n + 1);
for (int i = 1; i <= n; i++) {
char c; cin >> c;
if (c == 'H') opp[i] = 0;
else if (c == 'P') opp[i] = 1;
else opp[i] = 2;
}
const int NEG_INF = -1e9;
vector<vector<int>> dp(k + 1, vector<int>(3, NEG_INF));
// 初始化:第 1 局前,换了 0 次,任何起始手势
for (int g = 0; g < 3; g++) dp[0][g] = 0;
for (int i = 1; i <= n; i++) {
vector<vector<int>> ndp(k + 1, vector<int>(3, NEG_INF));
for (int j = 0; j <= k; j++) {
for (int g = 0; g < 3; g++) {
if (dp[j][g] == NEG_INF) continue;
int win = (g == opp[i]) ? 1 : 0;
// 选项一:不换手势
ndp[j][g] = max(ndp[j][g], dp[j][g] + win);
// 选项二:换手势(消耗 1 次)
if (j < k) {
for (int ng = 0; ng < 3; ng++) {
if (ng != g) {
int nwin = (ng == opp[i]) ? 1 : 0;
ndp[j+1][ng] = max(ndp[j+1][ng], dp[j][g] + nwin);
}
}
}
}
}
dp = ndp;
}
int ans = 0;
for (int j = 0; j <= k; j++)
for (int g = 0; g < 3; g++)
ans = max(ans, dp[j][g]);
cout << ans << "\n";
return 0;
}
6.2.5 区间 DP——矩阵链乘法与气球爆破模式
区间 DP 是一种强大的 DP 技术,状态代表连续的子数组或子范围,我们将更小区间的解组合来解决更大的区间。
💡 核心思路: 当区间
[l, r]的最优解依赖于如何在某个点k分割该区间,且子问题[l, k]和[k+1, r]相互独立时,适用区间 DP。
区间 DP 框架
区间 DP 填充顺序——必须按区间长度递增填充:

💡 填充顺序很关键: 必须按区间长度递增填充。计算
dp[l][r]时,所有更短的子区间dp[l][k]和dp[k+1][r]必须已经计算好。
状态: dp[l][r] = 区间 [l, r] 上子问题的最优解
初始条件:dp[i][i] = 单个元素的代价/价值(通常为 0 或平凡值)
顺序: 按区间长度递增填充(len = 1, 2, 3, ..., n)
确保 dp[l][k] 和 dp[k+1][r] 在 dp[l][r] 之前计算
转移: dp[l][r] = 对 [l, r-1] 中所有分割点 k 的 min/max:
dp[l][k] + dp[k+1][r] + cost(l, k, r)
答案: dp[1][n](0-indexed 则为 dp[0][n-1])
经典示例:矩阵链乘法
题目: 给定 N(1 ≤ N ≤ 500)个矩阵 A₁, A₂, ..., Aₙ,矩阵 Aᵢ 维度为 dim[i-1] × dim[i](1 ≤ dim[i] ≤ 100,相邻矩阵维度相容),找最小化标量乘法次数的括号化方案。答案可能超过 int 范围。
数据规模: N ≤ 500 时 O(N³) ≈ 1.25×10⁸ 勉强可行——这正是区间 DP 的典型约束。
状态: dp[l][r] = 计算乘积 Aₗ × Aₗ₊₁ × ... × Aᵣ 的最少乘法次数
转移: 尝试每个分割点 k ∈ [l, r-1]:
- 左乘积
Aₗ...Aₖ代价dp[l][k],结果维度dim[l-1] × dim[k] - 右乘积
Aₖ₊₁...Aᵣ代价dp[k+1][r],结果维度dim[k] × dim[r] - 两结果相乘代价
dim[l-1] × dim[k] × dim[r]
// 矩阵链乘法 — O(N³) 时间,O(N²) 空间
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> dim(n + 1);
for (int i = 0; i <= n; i++) cin >> dim[i];
vector<vector<long long>> dp(n + 1, vector<long long>(n + 1, 0));
const long long INF = 1e18;
// 按区间长度递增填充
for (int len = 2; len <= n; len++) {
for (int l = 1; l + len - 1 <= n; l++) {
int r = l + len - 1;
dp[l][r] = INF;
for (int k = l; k < r; k++) {
long long cost = dp[l][k]
+ dp[k+1][r]
+ (long long)dim[l-1] * dim[k] * dim[r];
dp[l][r] = min(dp[l][r], cost);
}
}
}
cout << dp[1][n] << "\n";
return 0;
}
复杂度: O(N³) 时间,O(N²) 空间。
区间 DP 通用模板
// 通用区间 DP 模板
void intervalDP(int n) {
vector<vector<int>> dp(n + 1, vector<int>(n + 1, 0));
// 初始条件:长度为 1 的区间
for (int i = 1; i <= n; i++) dp[i][i] = base_case(i);
// 按长度递增填充
for (int len = 2; len <= n; len++) {
for (int l = 1; l + len - 1 <= n; l++) {
int r = l + len - 1;
dp[l][r] = INF;
for (int k = l; k < r; k++) {
int val = dp[l][k] + dp[k+1][r] + cost(l, k, r);
dp[l][r] = min(dp[l][r], val);
}
}
}
}
⚠️ 常见错误: 以左端点
l为外层循环、长度为内层循环——这是错误的!计算dp[l][r]时,子区间dp[l][k]和dp[k+1][r]必须已经计算好。始终以长度为外层循环。
6.2.6 分组背包
题目: N 组物品(1 ≤ N ≤ 1000,每组 1 ≤ cnt[i] ≤ 1000 件),第 i 组中每件物品有重量 w(1 ≤ w ≤ W)和价值 v(1 ≤ v ≤ 10⁹),每组最多选一件(或不选)。在重量 W(1 ≤ W ≤ 1000)内最大化总价值。
💡 与 0/1 背包的关键区别: 0/1 背包逐件物品做决策;分组背包逐组做决策——每组中选哪件(如果选的话)。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, W;
cin >> n >> W;
vector<vector<pair<int,int>>> groups(n);
for (int i = 0; i < n; i++) {
int cnt; cin >> cnt;
groups[i].resize(cnt);
for (auto& [w, v] : groups[i]) cin >> w >> v;
}
vector<int> dp(W + 1, 0);
for (int i = 0; i < n; i++) { // 对每组
for (int w = W; w >= 0; w--) { // 容量**降序**迭代
for (auto [wi, vi] : groups[i]) { // 尝试组内每件物品
if (w >= wi)
dp[w] = max(dp[w], dp[w - wi] + vi);
}
}
}
cout << dp[W] << "\n";
return 0;
}
复杂度: O(N × W × 平均组大小)。
循环顺序说明
正确——物品循环在容量循环内部:
for w = W..0:
尝试 A:dp[w] = max(dp[w], dp[w-2]+3)
尝试 B:dp[w] = max(dp[w], dp[w-3]+5)
→ 每个容量下只从该组选最优的一件
错误——容量循环在物品循环内部:
尝试 A:for w = W..0: dp[w] = max(dp[w], dp[w-2]+3)
尝试 B:for w = W..0: dp[w] = max(dp[w], dp[w-3]+5)
→ A 和 B 可能都被选中,违反「每组最多一件」
6.2.7 多重背包
题目: N 种物品(1 ≤ N ≤ 100),第 i 种有 cnt[i] 件(1 ≤ cnt[i] ≤ 10⁵,不是无限个),每件重量 w[i]、价值 v[i](1 ≤ w[i], v[i] ≤ 1000)。在重量 W(1 ≤ W ≤ 4×10⁴)内最大化总价值。
方法一:二进制拆分 — O(N log C × W)
核心思路: 0 到 cnt[i] 之间的任意数 k 都可以表示为 2 的幂次之和加余数。将 cnt[i] 件拆分为大小为 1, 2, 4, 8, ..., 余数的组,每组作为一件「超级物品」。
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, W;
cin >> n >> W;
// 将每种物品按二进制拆分为「超级物品」
vector<pair<int,int>> items;
for (int i = 0; i < n; i++) {
int wi, vi, ci;
cin >> wi >> vi >> ci;
for (int k = 1; ci > 0; k *= 2) {
int take = min(k, ci);
items.push_back({take * wi, take * vi});
ci -= take;
}
}
// 对扩展后的物品做标准 0/1 背包
vector<int> dp(W + 1, 0);
for (auto [w, v] : items) {
for (int cap = W; cap >= w; cap--)
dp[cap] = max(dp[cap], dp[cap - w] + v);
}
cout << dp[W] << "\n";
return 0;
}
复杂度: O(Σ log(cnt[i]) × W) ≈ O(N log C × W)。
方法二:单调队列优化 — O(N × W)
对 cnt 很大(最大 10^6)的情况,二进制拆分仍然太慢。最优解使用单调队列。
核心思路: 按 w[i] 的余数对 DP 数组分组,在每个余数类内,转移变成一个滑动窗口最大值问题。
// 多重背包(单调队列优化)— O(N * W)
void bounded_knapsack_deque(vector<int>& dp, int wi, int vi, int ci, int W) {
vector<int> prev = dp;
for (int r = 0; r < wi; r++) {
deque<int> dq;
int max_k = (W - r) / wi;
for (int k = 0; k <= max_k; k++) {
int idx = r + k * wi;
int val = prev[idx] - k * vi;
while (!dq.empty() && dq.front() < k - ci) dq.pop_front();
if (!dq.empty()) {
int j = dq.front();
dp[idx] = max(dp[idx], prev[r + j * wi] + (k - j) * vi);
}
while (!dq.empty() && prev[r + dq.back() * wi] - dq.back() * vi <= val)
dq.pop_back();
dq.push_back(k);
}
}
}
💡 何时用哪种方法:
- cnt ≤ 1000,W ≤ 10^5 → 二进制拆分(实现更简单)
- cnt 最大 10^6,W 最大 10^5 → 单调队列(只有 O(NW))
6.2.8 完全背包——每种物品可选无限次
核心区别: 枚举顺序从「倒序」改为「正序」。
// 完全背包 — O(N × W)
// 正序枚举允许同一物品被多次选取
vector<int> unbounded_knapsack(int n, int W,
vector<int>& wt, vector<int>& val) {
vector<int> dp(W + 1, 0);
for (int i = 0; i < n; i++) {
for (int w = wt[i]; w <= W; w++) { // ← 正序!
dp[w] = max(dp[w], dp[w - wt[i]] + val[i]);
}
}
return dp;
}
| 背包类型 | 每件可选次数 | 内层循环顺序 |
|---|---|---|
| 0/1 背包 | 最多 1 次 | 倒序(W → w[i]) |
| 完全背包 | 无限次 | 正序(w[i] → W) |
| 多重背包 | 最多 cnt[i] 次 | 拆分后按 0/1 处理 |
6.2.9 二维费用背包
物品同时有两种费用(如重量 + 体积),背包有两个限制。只需多一维状态。
// 二维费用 0/1 背包 — O(N × V × M)
// 物品 i 有重量 w[i]、体积 v[i]、价值 c[i]
// 背包容量 V(重量)和 M(体积)
void two_dim_knapsack(int n, int V, int M,
vector<int>& w, vector<int>& v, vector<int>& c) {
vector<vector<int>> dp(V + 1, vector<int>(M + 1, 0));
for (int i = 0; i < n; i++) {
// 两个维度都倒序!保证 0/1 约束
for (int j = V; j >= w[i]; j--) {
for (int k = M; k >= v[i]; k--) {
dp[j][k] = max(dp[j][k], dp[j - w[i]][k - v[i]] + c[i]);
}
}
}
// dp[V][M] 即为答案
}
⚠️ 关键: 两个维度都必须倒序枚举,否则同一物品会被多次计入。
6.2.10 背包方案数
将求最大值改为求满足条件的方案数:把 max 替换为累加,把初始值 dp[0] = 1 作为基础情况。
// 方案数背包:恰好装满 W 的方案数(对 MOD 取模)
// 物品无限次可选(完全背包版)
const int MOD = 1e9 + 7;
long long count_ways(int n, int W, vector<int>& wt) {
vector<long long> dp(W + 1, 0);
dp[0] = 1; // 空背包:1 种方案(不选任何物品)
for (int i = 0; i < n; i++) {
for (int w = wt[i]; w <= W; w++) { // 正序 = 完全背包
dp[w] = (dp[w] + dp[w - wt[i]]) % MOD;
}
}
return dp[W];
}
// 0/1 背包版:恰好装满的方案数
long long count_ways_01(int n, int W, vector<int>& wt) {
vector<long long> dp(W + 1, 0);
dp[0] = 1;
for (int i = 0; i < n; i++) {
for (int w = W; w >= wt[i]; w--) // 倒序 = 0/1 背包
dp[w] = (dp[w] + dp[w - wt[i]]) % MOD;
}
return dp[W];
}
典型应用:
- 「正好装满 W」的方案数 → 初始
dp[0]=1,dp[1..W]=0 - 「不超过 W」的方案数 → 初始全部为 1(任何子集都是合法方案)
6.2.11 背包问题决策对照表
| 需求 | 关键变化 |
|---|---|
| 求最大价值(0/1) | dp[w] = max(dp[w], dp[w-wi]+vi),倒序 |
| 求最大价值(完全) | dp[w] = max(dp[w], dp[w-wi]+vi),正序 |
| 求方案数(0/1) | dp[w] += dp[w-wi],倒序,初始 dp[0]=1 |
| 求方案数(完全) | dp[w] += dp[w-wi],正序,初始 dp[0]=1 |
| 求第 k 优解 | 每个状态存前 k 大的值,转移时用双指针合并 |
| 恰好装满 | dp[0]=1/0,dp[1..W]=-INF/0 |
| 至多装满 | dp[0..W] 全初始化为 0 |
⚠️ 第 6.2 章常见错误
- LIS:严格递增用
upper_bound: 严格递增用lower_bound;不减序列用upper_bound。搞错会使 LIS 长度差 1。 - 0/1 背包:正向迭代重量: 正向迭代允许物品 i 被多次使用——那是无界背包,不是 0/1。0/1 背包始终倒序迭代。
- 网格路径:忘记处理堵塞格子: 若
grid[r][c] == '#',设dp[r][c] = 0(不是dp[r-1][c] + dp[r][c-1])。 - 网格路径计数中溢出: 路径数可能极大,用
long long或模运算。 - LIS:以为
tails存储实际 LIS: 不是!tails存储各长度子序列的最小可能尾元素。实际 LIS 需要单独重建。 - 分组背包:物品循环在容量外层: 物品循环必须在容量循环内部。若物品在外层,每件物品被当作独立的 0/1 物品处理,允许同组多件被选中。
- 多重背包二进制拆分后正向迭代: 拆分后超级物品仍是 0/1 约束——倒序迭代重量。正向迭代允许重用同一超级物品,结果错误。
- 二维背包只有一个维度倒序: 二维 0/1 背包中,重量和体积两个约束都需要其循环倒序迭代。
本章总结
📌 核心要点
| 问题 | 状态定义 | 递推 | 复杂度 |
|---|---|---|---|
| LIS(O(N²)) | dp[i] = 以 A[i] 结尾的 LIS 长度 | dp[i] = max(dp[j]+1),j<i 且 A[j]<A[i] | O(N²) |
| LIS(O(N log N)) | tails[k] = 长度 k+1 的 IS 的最小尾部 | 二分查找 + 替换 | O(N log N) |
| 0/1 背包(一维) | dp[w] = 容量 ≤ w 时的最大价值 | 倒序迭代 w | O(NW) |
| 无界背包 | dp[w] = 容量 ≤ w 时的最大价值 | 正序迭代 w | O(NW) |
| 分组背包 | dp[w] = 最大价值,每组最多选 1 件 | w 降序,物品循环在 w 循环内部 | O(N×W×组大小) |
| 多重背包 | 同 0/1 | 二进制拆分 → 0/1 背包 | O(N log C × W) |
| 网格路径 | dp[r][c] = 到达 (r,c) 的路径数 | dp[r-1][c] + dp[r][c-1] | O(RC) |
❓ 常见问题
Q1:O(N log N) LIS 中 tails 数组存储的是实际 LIS 吗?
A:不是!
tails存储的是「各长度递增子序列的最小尾元素」。其长度等于 LIS 长度,但元素本身可能不构成合法的递增子序列。要重建实际 LIS,需要记录每个元素的「前驱」。
Q2:0/1 背包为什么需要倒序迭代 w?
A:因为
dp[w]需要上一件物品行的dp[w - weight[i]]。正向迭代时,dp[w - weight[i]]可能已被当前行(当前物品 i)更新,等于物品 i 被使用了多次。倒序迭代确保每件物品最多被使用一次。
Q3:无界背包(物品无限次可用)和 0/1 背包的代码只有什么区别?
A:只是内层循环方向。0/1 背包:
w从 W 降到 weight[i](倒序);无界背包:w从 weight[i] 升到 W(正序)。
Q4:如果网格路径还可以向上或向左移动呢?
A:那么简单的网格 DP 就不再适用(因为会有环)。需要 BFS/DFS 或更复杂的 DP。标准网格路径 DP 只适用于「只向右/向下」的移动。
🔗 与后续章节的联系
- 第 3.3 章(排序与二分):二分搜索是
O(N log N)LIS 的核心——对tails数组用lower_bound - 第 6.3 章(进阶 DP):将背包扩展到状压 DP(物品集合 → 位掩码),将网格 DP 扩展到区间 DP
- 第 4.2 章(贪心):区间调度问题有时可以转化为 LIS(通过 Dilworth 定理)
- LIS 在 USACO Silver 中极为常见——二维 LIS、带权 LIS、LIS 计数变体频繁出现
练习题
题目 6.2.1 — LIS 长度 🟢 简单 读取 N 个整数(1 ≤ N ≤ 10⁵,−10⁹ ≤ A[i] ≤ 10⁹),找最长严格递增子序列的长度。
输入格式: 第一行 N;第二行 N 个整数。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<int> a(n);
for (int& x : a) cin >> x;
vector<int> tails;
for (int x : a) {
auto it = lower_bound(tails.begin(), tails.end(), x);
if (it == tails.end()) tails.push_back(x);
else *it = x;
}
cout << tails.size() << "\n";
}
复杂度: O(N log N)。
题目 6.2.2 — LIS 计数 🔴 困难 读取 N 个整数(1 ≤ N ≤ 5000,−10⁹ ≤ A[i] ≤ 10⁹),找最长严格递增子序列的数量(对 10⁹+7 取模)。
数据规模: N ≤ 5000,下方 O(N²) 解法正好够用;N 更大时需要树状数组优化。
#include <bits/stdc++.h>
using namespace std;
const int MOD = 1e9 + 7;
int main() {
int n; cin >> n;
vector<int> a(n);
for (int& x : a) cin >> x;
vector<int> len(n, 1);
vector<long long> cnt(n, 1);
for (int i = 1; i < n; i++) {
for (int j = 0; j < i; j++) {
if (a[j] < a[i]) {
if (len[j] + 1 > len[i]) {
len[i] = len[j] + 1;
cnt[i] = cnt[j];
} else if (len[j] + 1 == len[i]) {
cnt[i] = (cnt[i] + cnt[j]) % MOD;
}
}
}
}
int maxLen = *max_element(len.begin(), len.end());
long long ans = 0;
for (int i = 0; i < n; i++)
if (len[i] == maxLen) ans = (ans + cnt[i]) % MOD;
cout << ans << "\n";
}
复杂度: O(N²)。
题目 6.2.3 — 0/1 背包 🟡 中等 N 件物品(各有重量 1 ≤ w[i] ≤ W 和价值 1 ≤ v[i] ≤ 10⁹),容量 W,每件最多选一次,找最大总价值。
数据规模: N, W ≤ 1000(O(N × W) = 10⁶ 通过)。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, W; cin >> n >> W;
vector<int> wt(n), val(n);
for (int i = 0; i < n; i++) cin >> wt[i] >> val[i];
vector<int> dp(W + 1, 0);
for (int i = 0; i < n; i++) {
for (int w = W; w >= wt[i]; w--) // 倒序:防止重复使用
dp[w] = max(dp[w], dp[w - wt[i]] + val[i]);
}
cout << dp[W] << "\n";
}
复杂度: O(N × W)。
题目 6.2.4 — 收集星星 🟡 中等
N×M 网格(1 ≤ N, M ≤ 1000)有星星(*)、空地(.)和障碍(#),只能向右或向下从 (1,1) 移动到 (N,M),问最多能收集多少星星?无法到达 (N,M) 时输出 0。
输入格式: 第一行 N 和 M;接下来 N 行每行一个长度为 M 的网格。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, m; cin >> n >> m;
vector<string> g(n);
for (auto& row : g) cin >> row;
const int NEG = -1e9;
vector<vector<int>> dp(n, vector<int>(m, NEG));
dp[0][0] = (g[0][0] == '*') ? 1 : 0;
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (i == 0 && j == 0) continue;
if (g[i][j] == '#') continue;
int star = (g[i][j] == '*') ? 1 : 0;
int best = NEG;
if (i > 0 && dp[i-1][j] != NEG) best = max(best, dp[i-1][j]);
if (j > 0 && dp[i][j-1] != NEG) best = max(best, dp[i][j-1]);
if (best != NEG) dp[i][j] = best + star;
}
}
cout << max(0, dp[n-1][m-1]) << "\n";
}
复杂度: O(N × M)。
题目 6.2.5 — 恰好填满背包 🔴 困难
背包变体:N 件物品(重量 1 ≤ w[i] ≤ W,价值 1 ≤ v[i] ≤ 10⁹),必须恰好用满容量 W(总重量正好等于 W,不是最多),使总价值最大;无法恰好装满时输出 impossible。
数据规模: N, W ≤ 1000,O(N × W) 通过。
核心思路: 与标准 0/1 背包相同,但初始化 dp[w] = -INF(w > 0),只有 dp[0] = 0。只有从 dp[0]=0 可达的状态才有有限值。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, W; cin >> n >> W;
vector<int> wt(n), val(n);
for (int i = 0; i < n; i++) cin >> wt[i] >> val[i];
const int NEG = -1e9;
vector<int> dp(W + 1, NEG);
dp[0] = 0;
for (int i = 0; i < n; i++) {
for (int w = W; w >= wt[i]; w--) {
if (dp[w - wt[i]] != NEG)
dp[w] = max(dp[w], dp[w - wt[i]] + val[i]);
}
}
if (dp[W] == NEG) cout << "impossible\n";
else cout << dp[W] << "\n";
}
复杂度: O(N × W)。
图示:LIS 耐心排序

上图用耐心排序类比展示 LIS。每「叠」表示一个潜在的子序列终点,叠的数量等于 LIS 长度。二分搜索以 O(log N) 找到每张牌的位置,总体 O(N log N) 算法。
图示:背包 DP 表

0/1 背包 DP 表:行 = 已考虑的物品,列 = 容量,每格展示可实现的最大价值。蓝色格子展示单件物品的贡献,绿色格子展示组合,带星号的格子是最优答案。
第 6.3 章:进阶 DP 模式
6.3.0 从三道题出发
第 6.1~6.2 章的 DP 状态都是「一维或二维下标」:dp[i](前 i 个元素)、dp[i][w](前 i 个物品、容量 w)。但下面三道题,你会发现这些状态根本装不下问题:
题 1(喂牛路线): 有
N ≤ 15个饲料槽,槽i有x_i头牛。农夫要把牛分给它们,从槽 0 出发依次走过每个槽恰好一次再回到起点,走动有代价。求最小总代价。 (旅行商问题)
题 2(石子合并): 排成一行的
N ≤ 400堆石子,每次只能合并相邻两堆,代价为两堆石子数之和。求把所有石子合并成一堆的最小总代价。
题 3(没有上司的舞会,见第 6.8 章): 树形组织结构上选人不许相邻,求最大快乐值。
为什么第 6 章之前的状态设计不够用
- 题 1 的状态必须记住「去过哪些槽」——这是集合,不是下标。15 个槽有 2¹⁵ = 32768 种「去过哪些」的组合,普通
dp[i]表达不了。→ 需要把集合本身当作状态,用二进制位压缩成整数:状压 DP - 题 2 的子问题不是「前 i 堆」,而是区间 [i, j]——合并总是发生在相邻的堆之间,最后一次合并把两个区间合成一个。→ 区间 DP,状态是
dp[l][r] - 题 3 的依赖结构不是「一行」而是一棵树——选不选一个节点取决于它的上下级。→ 树形 DP(第 6.8 章专门展开)
三道题的共同教训:DP 的第一步是回答「我的子问题是什么形状」——线性的、带容量的、集合的、区间的、还是树的。本章就是一张「问题形状 → 状态设计」的对照表:
| 小节 | 问题形状 | 状态形态 | 代表题 |
|---|---|---|---|
| 6.3.1 | N ≤ 20 的「去过哪些」 | 位掩码整数 | 旅行商 TSP |
| 6.3.2 | 「合并相邻元素」 | 区间 [l,r] | 石子合并 / 矩阵链乘 |
| 6.3.3 | 树上的依赖 | 节点 u | 预告,详见第 6.8 章 |
| 6.3.4 | 「到第 i 位为止、且贴着上界走」 | (位置, 限制) | 统计 1..N 中数字 4 出现次数 |
6.3.1 状压 DP
使用场景: 涉及小集合(N ≤ 20)的子集问题,状态包含「已选了哪些元素」。
核心思路: 用位掩码(整数)表示已选元素的集合。第 i 位为 1 表示元素 i 已选入。
{0, 2, 3} 在 5 个元素的集合中 → 位掩码 = 0b01101 = 13
第 0 位 = 1(元素 0 ∈ 集合)
第 1 位 = 0(元素 1 ∉ 集合)
第 2 位 = 1(元素 2 ∈ 集合)
第 3 位 = 1(元素 3 ∈ 集合)
第 4 位 = 0(元素 4 ∉ 集合)
基本位操作
int mask = 0;
mask |= (1 << i); // 将元素 i 加入集合
mask &= ~(1 << i); // 从集合中移除元素 i
bool has_i = (mask >> i) & 1; // 检查元素 i 是否在集合中
// 枚举 mask 的所有子集
for (int sub = mask; sub > 0; sub = (sub - 1) & mask) {
// 处理子集 'sub'
}
// 若需要包含空集,在循环后再处理 sub=0
// 统计置位数(集合中的元素数)
int count = __builtin_popcount(mask); // int 类型
int count = __builtin_popcountll(mask); // long long 类型
经典题:旅行商问题(TSP)— O(2^N × N²)
题目: N 座城市,完全加权图,找访问每座城市恰好一次的最小代价哈密顿路径。
数据规模: 2 ≤ N ≤ 20,1 ≤ 边权 ≤ 10⁶(总代价需 long long)。
状态: dp[mask][u] = 恰好访问了 mask 中城市、当前在城市 u 时的最小代价。

转移: 扩展到 mask 中没有的城市 v:
dp[mask | (1<<v)][v] = min(dp[mask|(1<<v)][v], dp[mask][u] + dist[u][v])
// TSP 状压 DP — O(2^N × N²)
// N ≤ 20 时可用(2^20×400 ≈ 4×10^8,较紧;N≤18 更安全)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const ll INF = 1e18;
int n;
int dist[20][20];
ll dp[1 << 20][20];
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n;
for (int i = 0; i < n; i++)
for (int j = 0; j < n; j++)
cin >> dist[i][j];
// 初始化:全部为 INF
for (int mask = 0; mask < (1 << n); mask++)
fill(dp[mask], dp[mask] + n, INF);
// 初始条件:从城市 0 出发,只访问了城市 0
dp[1][0] = 0; // mask=1(第 0 位置 1),在城市 0,代价=0
for (int mask = 1; mask < (1 << n); mask++) {
for (int u = 0; u < n; u++) {
if (!(mask & (1 << u))) continue; // u 不在当前集合中
if (dp[mask][u] == INF) continue;
// 尝试扩展到尚未访问的城市 v
for (int v = 0; v < n; v++) {
if (mask & (1 << v)) continue; // v 已访问
int newMask = mask | (1 << v);
dp[newMask][v] = min(dp[newMask][v], dp[mask][u] + dist[u][v]);
}
}
}
int fullMask = (1 << n) - 1; // 所有城市都已访问
ll ans = INF;
for (int u = 1; u < n; u++) {
ans = min(ans, dp[fullMask][u] + dist[u][0]); // 返回城市 0 形成环
}
cout << ans << "\n";
return 0;
}
⚠️ 内存警告:
dp[1<<20][20]使用约 168MB。N=20 时接近典型 256MB 内存限制。若距离用int而非long long,内存减半约 84MB。
6.3.2 区间 DP
使用场景: 较大区间的答案可以由较小区间的答案构建。关键词:「合并」「分割」「爆破」「矩阵链」。
核心结构:
dp[l][r] = 区间 [l, r] 上子问题的最优答案
初始条件:dp[i][i] = 平凡值(单个元素)
转移:dp[l][r] = 对 k ∈ [l, r-1] 的 min/max:
dp[l][k] + dp[k+1][r] + cost(l, k, r)
填充顺序:按区间长度递增(len = r - l + 1)
经典题:矩阵链乘法 — O(N³)
题目: N 个矩阵依次相乘,矩阵 i 维度为 dims[i] × dims[i+1],找最小化标量乘法次数的括号化方案。
数据规模: 1 ≤ N ≤ 500,1 ≤ dims[i] ≤ 100(乘法次数需 long long)。
状态: dp[l][r] = 计算矩阵 l 到 r 乘积的最少乘法次数。
// 矩阵链乘法 — O(N³),O(N²) 空间
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const ll INF = 1e18;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n;
cin >> n;
vector<int> dims(n + 1);
for (int i = 0; i <= n; i++) cin >> dims[i];
vector<vector<ll>> dp(n + 1, vector<ll>(n + 1, 0));
for (int len = 2; len <= n; len++) {
for (int l = 1; l + len - 1 <= n; l++) {
int r = l + len - 1;
dp[l][r] = INF;
for (int k = l; k < r; k++) {
ll cost = dp[l][k] + dp[k+1][r]
+ (ll)dims[l-1] * dims[k] * dims[r];
dp[l][r] = min(dp[l][r], cost);
}
}
}
cout << dp[1][n] << "\n";
return 0;
}
工作示例: 3 个矩阵 A(10×30),B(30×5),C(5×60)
dp[1][2] = 10×30×5 = 1500
dp[2][3] = 30×5×60 = 9000
dp[1][3]:k=2 → dp[1][2] + dp[3][3] + 10×5×60 = 1500+0+3000 = 4500 ← 最小!
答案:4500(括号化为 (A×B)×C)
经典题:气球爆破
// dp[l][r] = 只爆破 (l, r) 中所有气球的最大金币
// 关键洞察:考虑 [l, r] 中**最后**爆破的气球 k
vector<int> val(n + 2);
val[0] = val[n + 1] = 1;
for (int i = 1; i <= n; i++) cin >> val[i];
vector<vector<ll>> dp(n + 2, vector<ll>(n + 2, 0));
for (int len = 1; len <= n; len++) {
for (int l = 1; l + len - 1 <= n; l++) {
int r = l + len - 1;
for (int k = l; k <= r; k++) {
// k 是 [l, r] 中最后爆破的气球
ll cost = dp[l][k-1] + dp[k+1][r]
+ (ll)val[l-1] * val[k] * val[r+1];
dp[l][r] = max(dp[l][r], cost);
}
}
}
cout << dp[1][n] << "\n";
6.3.3 树形 DP
使用场景: 在树上做 DP,节点的状态依赖其子树(后序)或其祖先(前序)。
模式:子树 DP(后序)
树形 DP 总是自底向上运行——叶节点是基础情况,每个内部节点汇总其子节点的结果:

经典题:树上最大独立集
题目: N 个节点,各有价值 val[u],选一个子集 S 最大化总价值,约束:若 u ∈ S,则 u 的子节点都不在 S 中。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ val[u] ≤ 10⁶(总价值需 long long)。
状态: dp[u][0] = u 不选时 u 子树的最大价值;dp[u][1] = u 选时 u 子树的最大价值。
// 树上最大独立集 — O(N)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<int> children[MAXN];
int val[MAXN];
long long dp[MAXN][2];
// DFS 后序:先计算所有子节点的 dp,再计算 dp[u]
void dfs(int u) {
dp[u][1] = val[u]; // 选 u:得到 val[u]
dp[u][0] = 0; // 不选 u:这个节点得 0
for (int v : children[u]) {
dfs(v); // ← 先处理子节点(后序)
// 若选 u:子节点必须不选
dp[u][1] += dp[v][0];
// 若不选 u:子节点可以选也可以不选
dp[u][0] += max(dp[v][0], dp[v][1]);
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int n, root;
cin >> n >> root;
for (int i = 1; i <= n; i++) cin >> val[i];
for (int i = 0; i < n - 1; i++) {
int u, v;
cin >> u >> v;
children[u].push_back(v);
}
dfs(root);
cout << max(dp[root][0], dp[root][1]) << "\n";
return 0;
}
树的直径(两次 DFS)
// 树的直径:任意两个节点间的最长路径
// 两次 DFS 法
// 1. 从任意节点 u 做 DFS → 找最远节点 v
// 2. 从 v 做 DFS → 找最远节点 w
// dist(v, w) = 直径
int farthest_node, max_dist;
void dfs_diameter(int u, int parent, int d, vector<int> adj[]) {
if (d > max_dist) {
max_dist = d;
farthest_node = u;
}
for (int v : adj[u]) {
if (v != parent) dfs_diameter(v, u, d + 1, adj);
}
}
int tree_diameter(int n, vector<int> adj[]) {
max_dist = 0; farthest_node = 1;
dfs_diameter(1, -1, 0, adj);
int v = farthest_node;
max_dist = 0;
dfs_diameter(v, -1, 0, adj);
return max_dist;
}
6.3.4 数位 DP
使用场景: 统计 [1, N] 范围内满足某个与数字有关的性质的数。
核心思路: 从左到右逐位构建数字,维护「tight」约束(是否仍受 N 的各位限制)。
状态: dp[位置][tight][...其他状态...]
位置:当前决策的是哪一位(0 = 最左位)tight:是否仍受 N 约束(1 = 是,不能超过 N 对应的位;0 = 否,可以自由使用 0-9)- 其他状态:追踪的任何性质(各位之和、零的个数等)
经典题:统计 [1, N] 中各位数字之和能被 K 整除的数
// 数位 DP — O(|digits| × 10 × K) 时间,O(|digits| × K) 空间
#include <bits/stdc++.h>
using namespace std;
string num;
int K;
map<tuple<int,int,int>, long long> memo;
// pos:当前数位位置(0-indexed)
// tight:是否受 num[pos] 约束
// rem:当前各位之和 mod K
long long solve(int pos, bool tight, int rem) {
if (pos == (int)num.size()) {
return rem == 0 ? 1 : 0; // 完整数字:有效当且仅当各位之和 ≡ 0(mod K)
}
auto key = make_tuple(pos, tight, rem);
if (memo.count(key)) return memo[key];
int limit = tight ? (num[pos] - '0') : 9; // 这一位最大能放的数字
long long result = 0;
for (int d = 0; d <= limit; d++) {
bool new_tight = tight && (d == limit);
result += solve(pos + 1, new_tight, (rem + d) % K);
}
return memo[key] = result;
}
// 统计 [1, N] 中各位之和能被 K 整除的数
long long count_up_to(long long N) {
num = to_string(N);
memo.clear();
long long ans = solve(0, true, 0);
// 减 1 是因为 0 本身的各位之和为 0(能被 K 整除)
// 但我们要统计 [1, N],不是 [0, N]
return ans - 1;
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
long long L, R;
cin >> L >> R >> K;
cout << count_up_to(R) - count_up_to(L - 1) << "\n";
return 0;
}
💡 核心思路:
tight标志至关重要。tight=true时,这一位只能使用 ≤num[pos]的数字。一旦放了比num[pos]小的数字,后面所有位都自由了(tight变为false)。这种「剥离」上界的方式是数位 DP 正确的关键。
本章总结
📌 模式识别指南
| 模式 | 题目中的线索 | 状态 | 转移 |
|---|---|---|---|
| 状压 DP | 「子集」,N ≤ 20,分配任务 | dp[mask][last] | 翻转位,尝试下一个元素 |
| 区间 DP | 「合并」「分割」「加括号」 | dp[l][r] | 在 k 处分割,组合 |
| 树形 DP | 「树」,子树性质 | dp[节点][状态] | 从子节点汇总 |
| 数位 DP | 「统计具有某性质的数」 | dp[位置][tight][...] | 尝试每个数字 d |
🧩 核心框架速查
// 状压 DP 框架
for (int mask = 0; mask < (1<<n); mask++)
for (int u = 0; u < n; u++) if (mask & (1<<u))
for (int v = 0; v < n; v++) if (!(mask & (1<<v)))
dp[mask|(1<<v)][v] = min(dp[mask|(1<<v)][v], dp[mask][u] + cost[u][v]);
// 区间 DP 框架
for (int len = 2; len <= n; len++) // 枚举区间长度
for (int l = 1; l+len-1 <= n; l++) { // 枚举左端点
int r = l + len - 1;
for (int k = l; k < r; k++) // 枚举分割点
dp[l][r] = min(dp[l][r], dp[l][k] + dp[k+1][r] + cost(l,k,r));
}
// 树形 DP 框架(后序遍历)
void dfs(int u, int parent) {
for (int v : adj[u]) if (v != parent) {
dfs(v, u);
dp[u] = update(dp[u], dp[v]); // 用子节点信息更新当前节点
}
}
// 数位 DP 框架
long long solve(int pos, bool tight, int state) {
if (pos == len) return (state == target) ? 1 : 0;
if (memo[pos][tight][state] != -1) return memo[pos][tight][state];
int lim = tight ? (num[pos]-'0') : 9;
long long res = 0;
for (int d = 0; d <= lim; d++)
res += solve(pos+1, tight && (d==lim), next_state(state, d));
return memo[pos][tight][state] = res;
}
❓ 常见问题
Q1:区间 DP 为什么必须先按长度枚举?
A:因为
dp[l][r]依赖dp[l][k]和dp[k+1][r],两者的长度都小于r-l+1。所以所有更短的区间必须在dp[l][r]之前计算。按长度从小到大枚举满足这个要求。若直接枚举 l 和 r,可能在依赖还没准备好时就计算dp[l][r]。
Q2:树形 DP 中,如何处理无根树(给出无向边)?
A:选任意节点为根(通常是节点 1),然后用 DFS 将无向边变为有向边(父 → 子方向)。在 DFS 中传递
parent参数以避免回到父节点。
void dfs(int u, int par) {
for (int v : adj[u]) {
if (v != par) { // 只访问子节点,不访问父节点
dfs(v, u);
// 更新 dp[u]
}
}
}
Q3:数位 DP 中 tight=true 和 tight=false 能共用同一个记忆化数组吗?
A:可以,这正是为什么
tight是状态的一部分。dp[pos][1][rem]和dp[pos][0][rem]是不同的状态,分别记录「有上界约束时的计数」和「自由时的计数」。注意tight=false的状态可以在多次调用间复用(一旦 tight 变为 false,后面的位不受约束)。
练习题
题目 6.3.1 — 状压 DP:任务分配 🟡 中等
N 名工人,N 项任务,工人 i 完成任务 j 需要 time[i][j] 小时。将每项任务恰好分配给一名工人,最小化总时间。(N ≤ 15)
提示
`dp[mask]` = 分配了 `mask` 中各任务时的最少总时间。工人下标 = 分配新任务前的 popcount(mask)。#include <bits/stdc++.h>
using namespace std;
int main() {
int n; cin >> n;
vector<vector<int>> t(n, vector<int>(n));
for (auto& row : t) for (int& x : row) cin >> x;
vector<long long> dp(1 << n, 1e18);
dp[0] = 0;
for (int mask = 0; mask < (1 << n); mask++) {
if (dp[mask] >= (long long)1e18) continue;
int worker = __builtin_popcount(mask);
if (worker == n) continue;
for (int task = 0; task < n; task++) {
if (mask & (1 << task)) continue;
dp[mask | (1 << task)] = min(dp[mask | (1 << task)],
dp[mask] + t[worker][task]);
}
}
cout << dp[(1 << n) - 1] << "\n";
}
复杂度: O(2^N × N) 时间和空间,轻松处理 N ≤ 20。
题目 6.3.2 — 区间 DP:回文分割 🟡 中等 找将字符串分割成回文子串的最少切割次数。
数据规模: 1 ≤ |S| ≤ 2000,由小写字母组成(O(N²) 区间 DP 可过)。
提示
先用区间 DP 预计算 isPalin[l][r],再用 cuts[i] = s[0..i] 的最少切割次数。#include <bits/stdc++.h>
using namespace std;
int main() {
string s; cin >> s;
int n = s.size();
// 第一阶段:回文检查
vector<vector<bool>> pal(n, vector<bool>(n, false));
for (int i = n-1; i >= 0; i--)
for (int j = i; j < n; j++)
pal[i][j] = (s[i]==s[j]) && (j-i < 2 || pal[i+1][j-1]);
// 第二阶段:最少切割
vector<int> cuts(n, n);
for (int i = 0; i < n; i++) {
if (pal[0][i]) { cuts[i] = 0; continue; }
for (int j = 1; j <= i; j++)
if (pal[j][i]) cuts[i] = min(cuts[i], cuts[j-1] + 1);
}
cout << cuts[n-1] << "\n";
}
复杂度: O(N²)。
题目 6.3.3 — 树形 DP:最大匹配 🔴 困难 在树上找最大匹配(共享顶点最少的最大边集合)。
数据规模: 1 ≤ N ≤ 10⁵,节点编号 1..N(递归深度可能达 10⁵,注意栈溢出风险)。
提示
dp[u][0] = u 不匹配时 u 子树的最大匹配数;dp[u][1] = u 与某个子节点匹配时 u 子树的最大匹配数。#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
vector<int> adj[MAXN];
int dp[MAXN][2];
void dfs(int u, int par) {
dp[u][0] = dp[u][1] = 0;
for (int v : adj[u]) {
if (v == par) continue;
dfs(v, u);
dp[u][0] += max(dp[v][0], dp[v][1]);
}
for (int v : adj[u]) {
if (v == par) continue;
int gain = 1 + dp[v][0] - max(dp[v][0], dp[v][1]);
dp[u][1] = max(dp[u][1], dp[u][0] + gain);
}
}
int main() {
int n; cin >> n;
for (int i = 0; i < n-1; i++) {
int u, v; cin >> u >> v;
adj[u].push_back(v); adj[v].push_back(u);
}
dfs(1, 0);
cout << max(dp[1][0], dp[1][1]) << "\n";
}
复杂度: O(N)。
题目 6.3.4 — 数位 DP:统计幸运数 🟡 中等 「幸运数」只包含数字 4 和 7,统计 [1, N] 中的幸运数数量。
数据规模: 1 ≤ N ≤ 10⁹。
提示
用 BFS 枚举所有幸运数(4, 7, 44, 47, 74, 77, ...),与 N 比较。#include <bits/stdc++.h>
using namespace std;
int main() {
long long n; cin >> n;
int count = 0;
queue<long long> q;
q.push(4); q.push(7);
while (!q.empty()) {
long long x = q.front(); q.pop();
if (x > n) continue;
count++;
if (x <= n / 10) {
q.push(x * 10 + 4);
q.push(x * 10 + 7);
}
}
cout << count << "\n";
}
复杂度: O(2^digits) ≈ O(2^18) 最坏情况。
⚠️ 进阶 DP 常见错误
展开——竞赛前必读
状压 DP 陷阱:
- ❌
mask >> i & 1被解析为mask >> (i & 1)——始终写(mask >> i) & 1 - ❌ 枚举子掩码:
for (sub=mask; sub>0; sub=(sub-1)&mask)跳过了sub=0——若空集有效,手动添加sub=0 - ❌ 忘记
__builtin_popcount统计的是置位数,不是 0..n-1 中的数
区间 DP 陷阱:
- ❌ 按 (l, r) 顺序而非按区间长度填充——
dp[l][k]可能还没计算好 - ❌ 分割点范围:k 应该从
l到r-1,不是l到r - ❌ 初始化错误:
dp[i][i] = 0(初始条件),不是 INF
树形 DP 陷阱:
- ❌ 栈溢出:N > 10^5 时,将递归改为迭代 DFS
- ❌ 忘记
if (v == parent) continue——在无向边上会无限循环 - ❌ 换根 DP 中,换根前忘记减去子节点的贡献
数位 DP 陷阱:
- ❌
tight标志未传递:若tight=true,下一位 ≤ N 对应位的数字 - ❌ 前导零:追踪
started标志,避免「007」和「7」被重复计数 - ❌
tight=true的记忆化条目不能复用——tight=false的状态可以复用
📖 第 6.4 章:折半搜索(Meet in the Middle)
🎯 学习目标
学完本章后,你将能够:
- 理解折半搜索的核心思想:将 O(2^N) 降为 O(2^(N/2) × log)
- 解决「子集和」「N 个数中选 k 个」类的大规模枚举问题
- 将线性搜索空间拆成两半分别处理,再合并答案
6.4.1 问题引入:子集和
原始问题
给定 N 个整数(N ≤ 40),找是否存在一个非空子集,其和恰好等于目标值 target。
朴素暴力: 枚举所有 2^N 个子集,时间 O(2^40) ≈ 10^12,完全不可行。
关键观察: 40 个元素太多,但 20 个元素的 2^20 = 1,048,576 完全可行!
6.4.2 折半搜索的核心思想
将 N 个元素分成两半(各 N/2 个),分别枚举,然后合并。
原数组:[a1, a2, ..., a40]
↓ 分成两半
左半边:[a1, ..., a20] → 枚举所有子集和 → 2^20 个值
右半边:[a21, ..., a40] → 枚举所有子集和 → 2^20 个值
查找:对于左半边的每个子集和 s,
在右半边查找是否有子集和等于 (target - s)
用排序 + 二分查找:O(2^(N/2) × log(2^(N/2))) = O(2^(N/2) × N/2)
时间复杂度: O(2^(N/2) × N),N=40 时约 20 × 10^6,完全可行!
6.4.3 完整实现:子集和判断
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n; long long target;
cin >> n >> target;
vector<long long> a(n);
for (long long& x : a) cin >> x;
int half = n / 2;
int left_n = half, right_n = n - half;
// 枚举左半边所有子集和
vector<long long> left_sums;
for (int mask = 0; mask < (1 << left_n); mask++) {
long long s = 0;
for (int i = 0; i < left_n; i++)
if ((mask >> i) & 1) s += a[i];
left_sums.push_back(s);
}
sort(left_sums.begin(), left_sums.end()); // 排序以便二分
// 枚举右半边所有子集和,查找配对
bool found = false;
for (int mask = 0; mask < (1 << right_n); mask++) {
long long s = 0;
for (int i = 0; i < right_n; i++)
if ((mask >> i) & 1) s += a[left_n + i];
// 在左半边查找 target - s
long long need = target - s;
if (binary_search(left_sums.begin(), left_sums.end(), need)) {
found = true;
break;
}
}
cout << (found ? "YES" : "NO") << "\n";
return 0;
}
// 时间:O(2^(N/2) × N),N=40 时约 4×10^7
// 空间:O(2^(N/2)) 存储左半边子集和
追踪示例(a = [1, 5, 3, 8], target = 9):
左半边:[1, 5]
子集和:0(空), 1, 5, 6
排序:[0, 1, 5, 6]
右半边:[3, 8]
mask=01(只含3):s=3,need=9-3=6,在左半边找 6 → 找到!
输出:YES(子集 {5,3+1=不对...实际是 {1,5} 和 {3})
验证:1+5+3 = 9 ✓(左={1,5},右={3})
6.4.4 计数变体:恰好等于目标的子集数
// 统计和恰好为 target 的子集数量
long long count_subsets(vector<long long>& a, long long target) {
int n = a.size(), half = n / 2;
int left_n = half, right_n = n - half;
// 枚举左半边
vector<long long> left_sums;
for (int mask = 0; mask < (1 << left_n); mask++) {
long long s = 0;
for (int i = 0; i < left_n; i++)
if ((mask >> i) & 1) s += a[i];
left_sums.push_back(s);
}
sort(left_sums.begin(), left_sums.end());
// 枚举右半边,用 lower_bound/upper_bound 统计配对数量
long long ans = 0;
for (int mask = 0; mask < (1 << right_n); mask++) {
long long s = 0;
for (int i = 0; i < right_n; i++)
if ((mask >> i) & 1) s += a[left_n + i];
long long need = target - s;
auto lo = lower_bound(left_sums.begin(), left_sums.end(), need);
auto hi = upper_bound(left_sums.begin(), left_sums.end(), need);
ans += hi - lo; // 等于 need 的个数
}
// 减去空集(若 target == 0,空集被算了一次)
if (target == 0) ans--;
return ans;
}
6.4.5 最大子集和变体
问题: 找和不超过 target 的子集中,和最大的那个。
long long max_subset_sum_le_target(vector<long long>& a, long long target) {
int n = a.size(), half = n / 2;
int left_n = half, right_n = n - half;
// 左半边所有子集和
vector<long long> left_sums;
for (int mask = 0; mask < (1 << left_n); mask++) {
long long s = 0;
for (int i = 0; i < left_n; i++)
if ((mask >> i) & 1) s += a[i];
left_sums.push_back(s);
}
sort(left_sums.begin(), left_sums.end());
// 去重(同一和值只需保留一个,降低后续查找复杂度)
left_sums.erase(unique(left_sums.begin(), left_sums.end()), left_sums.end());
long long ans = 0;
for (int mask = 0; mask < (1 << right_n); mask++) {
long long s = 0;
for (int i = 0; i < right_n; i++)
if ((mask >> i) & 1) s += a[left_n + i];
if (s > target) continue; // 右半边超限,不用找左半边
// 在左半边找最大的 ≤ (target - s) 的值
long long need = target - s;
auto it = upper_bound(left_sums.begin(), left_sums.end(), need);
if (it != left_sums.begin()) {
--it;
ans = max(ans, s + *it);
}
}
return ans;
}
6.4.6 折半搜索 vs 其他方法
| 方法 | 时间复杂度 | 适用场景 |
|---|---|---|
| 暴力枚举 | O(2^N) | N ≤ 20 |
| 折半搜索 | O(2^(N/2) × N) | N ≤ 40 |
| 动态规划(背包) | O(N × target) | target 不大时 |
| 二维 DP | O(N^2) | 特殊结构 |
折半搜索的适用条件:
- 问题可以拆成两个独立的「半问题」
- 两个半问题的结果可以快速合并(通常用排序+二分)
- 总量 N ≤ 40(每半不超过 20)
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| 左半边子集和溢出 | N=40 且元素值大时,子集和超 int | 用 long long |
| 空集未处理 | mask=0 对应空集,和=0,target=0 时多计 | 若 target=0 且要求非空子集,减 1 |
| 分割不均 | 一半 20 一半 20 vs 1 和 39 效率差很多 | 尽量均分:half = n/2 |
| 二分边界错误 | lower_bound vs upper_bound 混用 | lower_bound 找第一个 ≥,upper_bound 找第一个 > |
💪 练习题
🟢 题目 1:子集和存在性
给定 N(≤40)个整数和 target,判断是否存在非空子集和恰好等于 target。
数据规模: 1 ≤ N ≤ 40,|a[i]| ≤ 10⁹,|target| ≤ 4×10¹⁰。
✅ 完整解答: 直接使用 6.4.3 节的代码。
🟡 题目 2:子集和计数
给定 N(≤40)个整数和 target,统计和恰好为 target 的非空子集数量(答案可能很大,对 10^9+7 取模)。
数据规模: 1 ≤ N ≤ 40,|a[i]| ≤ 10⁹,|target| ≤ 4×10¹⁰。
使用 6.4.4 节的计数代码,注意模运算(统计时就取模)。
#include <bits/stdc++.h>
using namespace std;
const long long MOD = 1e9 + 7;
int main() {
int n; long long target;
cin >> n >> target;
vector<long long> a(n);
for (long long& x : a) cin >> x;
int half = n / 2, left_n = half, right_n = n - half;
map<long long, long long> left_cnt; // 用 map 存和→出现次数(便于取模)
for (int mask = 0; mask < (1 << left_n); mask++) {
long long s = 0;
for (int i = 0; i < left_n; i++)
if ((mask >> i) & 1) s += a[i];
left_cnt[s]++;
}
long long ans = 0;
for (int mask = 0; mask < (1 << right_n); mask++) {
long long s = 0;
for (int i = 0; i < right_n; i++)
if ((mask >> i) & 1) s += a[left_n + i];
long long need = target - s;
if (left_cnt.count(need))
ans = (ans + left_cnt[need]) % MOD;
}
if (target == 0) ans = (ans - 1 + MOD) % MOD; // 去掉全空集
cout << ans << "\n";
}
🔴 题目 3:最接近目标的子集和
给定 N(≤40)个正整数和 target,找非空子集中和最大但不超过 target 的那个,输出这个最大和。
✅ 完整解答
直接使用 6.4.5 节的 max_subset_sum_le_target 函数。
追踪(a=[3,5,7,2], target=10):
左半边 [3,5]:子集和 = [0,3,5,8],排序后 [0,3,5,8]
右半边 [7,2]:
mask=00 (空):s=0,need=10,在左找≤10的最大=8 → 答案候选 0+8=8
mask=01 (7):s=7,need=3,在左找≤3的最大=3 → 答案候选 7+3=10 ✓
mask=10 (2):s=2,need=8,在左找≤8的最大=8 → 答案候选 2+8=10 ✓
mask=11 (9):s=9,need=1,在左找≤1的最大=0 → 答案候选 9+0=9
最大答案:10
🔴 题目 4:USACO Gold 风格 — 最优配对
给定 N(N ≤ 40,偶数)个整数,将它们两两配对(共 N/2 对),每对的代价为两数之积,求所有配对代价之和的最小值。
输入: 第一行 N,第二行 N 个整数 a_i(|a_i| ≤ 10^9)。
样例输入:
4
1 -2 3 -4
样例输出: -10(配对 (1,-4) + (-2,3) = -4 + (-6) = -10)
核心思路: N ≤ 40 太大无法暴力枚举所有配对方案。但将 N 个数分成两半(各 N/2 ≤ 20),分别枚举每半内部的配对方案及剩余未配对元素,再用折半搜索合并。
具体地:左半边 N/2 个数中,枚举哪些元素在左半内部配对(用位掩码表示),剩余未配对的元素需要与右半边的未配对元素配对。由于两半的未配对数量必须相同,可以用排序 + DP 合并。
更简洁的做法:因为 N ≤ 40 是偶数,直接枚举所有配对方式用 O((N-1)!!) 仍然太大。改用状压 DP:dp[mask] = 集合 mask 中元素两两配对的最小代价。但 2^40 太大。
折半搜索做法: 将 N 个数分成 A(前 N/2 个)和 B(后 N/2 个)。用状压 DP 分别对 A 和 B 求内部配对的最小代价,再枚举跨组配对。对于跨组配对,枚举 A 中有 k 个元素要与 B 中 k 个元素配对,枚举 A 中选哪 k 个、B 中选哪 k 个,用最小权匹配求最优配对。当 k ≤ 20/2 = 10 时,枚举量可控。
这里给出一个更实际的 O(2^N × N) 状压 DP 解法(N ≤ 20 可行),对 N ≤ 40 需要折半。
折半实现: 把 N 个元素分成两半,对每半用状压 DP 求内部配对最优值。然后枚举两半中哪些元素不参与内部配对(跨组配对),对跨组元素用最优匹配。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const ll INF = 1e18;
// 对 half 个元素做状压 DP:dp[mask] = mask 中元素两两配对的最小代价
// mask 必须有偶数个 1
vector<ll> calc_dp(vector<ll>& a) {
int n = a.size();
vector<ll> dp(1 << n, INF);
dp[0] = 0;
for (int mask = 0; mask < (1 << n); mask++) {
if (dp[mask] == INF) continue;
// 找第一个未配对的元素
int i = -1;
for (int j = 0; j < n; j++)
if (!((mask >> j) & 1)) { i = j; break; }
if (i == -1) continue; // 全部已配对
// 枚举与 i 配对的元素 j
for (int j = i + 1; j < n; j++) {
if ((mask >> j) & 1) continue;
int nmask = mask | (1 << i) | (1 << j);
dp[nmask] = min(dp[nmask], dp[mask] + a[i] * a[j]);
}
}
return dp;
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n; cin >> n;
vector<ll> a(n);
for (ll& x : a) cin >> x;
int half = n / 2;
vector<ll> A(a.begin(), a.begin() + half);
vector<ll> B(a.begin() + half, a.end());
int an = A.size(), bn = B.size();
auto dpA = calc_dp(A);
auto dpB = calc_dp(B);
// 枚举 A 中哪些元素不参与内部配对(要跨组配对)
// 跨组元素数必须为偶数,且不超过 bn
ll ans = INF;
for (int maskA = 0; maskA < (1 << an); maskA++) {
if (dpA[maskA] >= INF) continue;
int crossA = an - __builtin_popcount(maskA); // A 中未配对数
if (crossA > bn) continue;
if (crossA % 2 != 0) continue;
// B 中也必须有 crossA 个未配对
// 枚举 B 中哪些元素不参与内部配对
for (int maskB = 0; maskB < (1 << bn); maskB++) {
if (dpB[maskB] >= INF) continue;
int crossB = bn - __builtin_popcount(maskB);
if (crossB != crossA) continue;
// 收集 A 和 B 中未配对的元素,做最优配对
vector<ll> unA, unB;
for (int i = 0; i < an; i++)
if (!((maskA >> i) & 1)) unA.push_back(A[i]);
for (int i = 0; i < bn; i++)
if (!((maskB >> i) & 1)) unB.push_back(B[i]);
// 对未配对元素做最小权匹配(元素少,可以状压 DP)
int k = crossA;
vector<ll> match_dp(1 << k, INF);
match_dp[0] = 0;
for (int m = 0; m < (1 << k); m++) {
if (match_dp[m] >= INF) continue;
int idx = __builtin_popcount(m); // 当前配对第 idx 个 A 元素
if (idx >= k) continue;
for (int j = 0; j < k; j++) {
if ((m >> j) & 1) continue;
int nm = m | (1 << j);
match_dp[nm] = min(match_dp[nm], match_dp[m] + unA[idx] * unB[j]);
}
}
ans = min(ans, dpA[maskA] + dpB[maskB] + match_dp[(1 << k) - 1]);
}
}
cout << ans << "\n";
}
复杂度分析: 每半状压 DP 时间 O(2^(N/2) × N),合并时枚举两边掩码 O(2^(N/2) × 2^(N/2)) = O(2^N),内部匹配 O(2^k × k)。当 N=20 时(每半 10),2^10=1024,合并 1024×1024 ≈ 10^6 可行。对于 N=40 需要更精细的优化(如只枚举 popcount 合法的掩码对)。
💡 章节联系: 折半搜索是 USACO Gold 的独特技巧,每年约出现 1 道。它本质上是「暴力搜索 + 聪明合并」,将指数复杂度减半。与状压 DP(第 6.3 章)都处理 2^N 的搜索空间,但折半搜索不需要 DP 递推关系。
📖 第 6.5 章:数位 DP(Digit DP)
🎯 学习目标
学完本章后,你将能够:
- 理解数位 DP 的核心框架:按位从高到低填数
- 掌握「tight(是否贴上界)」标志的作用
- 处理「前导零」问题
- 解决「区间 [L, R] 内满足某数字性质的数的个数」类问题
6.5.1 问题引入
一类常见问题
统计 1 到 N 中,满足某种「数字属性」的整数个数。
示例:
- [1, N] 中各位数字之和等于 S 的数的个数
- [1, N] 中不含数字 4 的数的个数
- [1, N] 中各位数字单调不降的数的个数
为什么不能暴力? N 可能高达 10^18,逐一枚举完全不可能。
核心思路: 像「填数字」一样,从最高位到最低位逐位枚举,用 DP 记录状态,避免重复计算。
6.5.2 数位 DP 的框架
核心状态
| 状态量 | 含义 |
|---|---|
pos | 当前填到第几位(从高位到低位) |
tight | 当前选的数字是否恰好贴着 N 的对应位(是否受上界约束) |
...其他属性... | 问题特定的属性(如各位之和、上一位的值等) |
关键逻辑
如果 tight == true:
当前位只能填 0 ~ digit[pos](digit[pos] 是 N 的第 pos 位)
填 digit[pos] 时,下一位仍然 tight
填 < digit[pos] 时,下一位不再 tight(自由了!)
如果 tight == false:
当前位可以填 0~9(自由枚举)
下一位也不 tight
6.5.3 完整例题一:各位数字之和
问题: 统计 1 到 N 中,各位数字之和恰好等于 S 的正整数个数。
#include <bits/stdc++.h>
using namespace std;
string num_str; // N 的字符串表示
int target_sum; // 目标数字和 S
// dp[pos][sum_so_far][tight][started]
// 记忆化,避免重复计算相同状态
map<tuple<int,int,bool,bool>, long long> memo;
// pos: 当前位(从 0 开始,0 是最高位)
// sum: 已填数字的和
// tight: 是否贴上界
// started: 是否已经开始(用于处理前导零)
long long solve(int pos, int sum, bool tight, bool started) {
if (sum > target_sum) return 0; // 剪枝:和已超出
if (pos == (int)num_str.size()) {
// 填完所有位
return (started && sum == target_sum) ? 1 : 0;
}
auto key = make_tuple(pos, sum, tight, started);
if (memo.count(key)) return memo[key];
int limit = tight ? (num_str[pos] - '0') : 9;
long long result = 0;
for (int d = 0; d <= limit; d++) {
bool new_tight = tight && (d == limit);
bool new_started = started || (d != 0);
int new_sum = (new_started ? sum + d : 0); // 前导零不计入和
result += solve(pos + 1, new_sum, new_tight, new_started);
}
return memo[key] = result;
}
long long count_up_to(long long N, int S) {
num_str = to_string(N);
target_sum = S;
memo.clear();
return solve(0, 0, true, false);
}
int main() {
long long L, R; int S;
cin >> L >> R >> S;
// 区间 [L, R] = f(R) - f(L-1)
cout << count_up_to(R, S) - count_up_to(L - 1, S) << "\n";
return 0;
}
追踪(N=20, S=2):
💡 Code 代码(14 行)
填第 0 位(最高位,limit=2):
d=0(未 started):进入 (1, 0, false, false)
填第 1 位(1-9):
d=2:(ended, sum=2, tight=false) → 1(即数字 02 = 2)
其余不满足 sum=2
d=1(started=true):进入 (1, 1, false, true)
填第 1 位(0-9):
d=1:(ended, sum=2) → 1(即 11)
d=2(tight):进入 (1, 2, false, true)
填第 1 位(0-9):
d=0:(ended, sum=2) → 1(即 20)
其他 sum > 2 → 0
合计:2(数字 2 和 11 和 20)
6.5.4 数位 DP 通用模板(更简洁版)
竞赛中通常用数组代替 map 做记忆化:
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int digits[20]; // N 的各位数字(从高位到低位)
int n_digits; // 总位数
ll dp[20][200][2][2]; // dp[pos][sum][tight][started]
// 维度根据问题调整
bool computed[20][200][2][2];
int S; // 目标数字和
ll solve(int pos, int sum, bool tight, bool started) {
if (sum > S) return 0;
if (pos == n_digits) return (started && sum == S) ? 1 : 0;
ll& ret = dp[pos][sum][tight][started];
if (computed[pos][sum][tight][started]) return ret;
computed[pos][sum][tight][started] = true;
int lim = tight ? digits[pos] : 9;
ret = 0;
for (int d = 0; d <= lim; d++) {
ret += solve(pos + 1,
(started || d > 0) ? sum + d : 0,
tight && (d == lim),
started || (d > 0));
}
return ret;
}
ll count_up_to(ll N) {
n_digits = 0;
while (N > 0) { digits[n_digits++] = N % 10; N /= 10; }
reverse(digits, digits + n_digits);
memset(computed, 0, sizeof(computed));
return solve(0, 0, true, false);
}
int main() {
ll L, R; cin >> L >> R >> S;
cout << count_up_to(R) - count_up_to(L - 1) << "\n";
}
6.5.5 例题二:不含连续相同数字
问题: 统计 [L, R] 中,没有两个相邻数字相同的整数个数。
(例:123、145 满足,122、344 不满足)
额外状态: last_digit(上一位填的数字)
ll dp2[20][11][2][2]; // [pos][last_digit][tight][started]
// last_digit: 0~9 表示上一位数字,10 表示"还没开始"
ll solve2(int pos, int last, bool tight, bool started) {
if (pos == n_digits) return started ? 1 : 0;
ll& ret = dp2[pos][last][tight][started];
if (computed[pos][last][tight][started]) return ret;
computed[pos][last][tight][started] = true;
int lim = tight ? digits[pos] : 9;
ret = 0;
for (int d = 0; d <= lim; d++) {
// 已 started 时,禁止 d == last(相邻相同)
if (started && d == last) continue;
ret += solve2(pos + 1,
(started || d > 0) ? d : 10, // 前导零时 last 不更新
tight && (d == lim),
started || (d > 0));
}
return ret;
}
6.5.6 例题三:各位数字单调不降
问题: 统计 [1, N] 中,各位数字从左到右单调不降的整数个数。
(例:1359、2233 满足,132、231 不满足)
额外状态: min_digit(当前允许填的最小数字)
ll dp3[20][10][2][2]; // [pos][min_allowed][tight][started]
ll solve3(int pos, int min_d, bool tight, bool started) {
if (pos == n_digits) return started ? 1 : 0;
ll& ret = dp3[pos][min_d][tight][started];
// ... 记忆化判断 ...
int lim = tight ? digits[pos] : 9;
ret = 0;
for (int d = (started ? min_d : 0); d <= lim; d++) {
ret += solve3(pos + 1,
d, // 下一位不能小于 d
tight && (d == lim),
true);
}
return ret;
}
6.5.7 区间查询:f(R) - f(L-1)
几乎所有数位 DP 都满足区间可减性:
$$\text{count}[L, R] = \text{count}[1, R] - \text{count}[1, L-1]$$
所以 count_up_to(N) 函数是核心,用它两次就能回答区间查询。
注意: 当 L = 0 时,L - 1 = -1 需要特殊处理(count_up_to(-1) = 0)。
6.5.8 常见数位 DP 问题类型
| 问题类型 | 额外状态 | 示例 |
|---|---|---|
| 各位和 = S | sum | 本章 6.5.3 |
| 不含特定数字 | 无(限制在 limit 里) | 无 4 的数 |
| 相邻不同 | last_digit | 本章 6.5.5 |
| 单调不降 | min_digit | 本章 6.5.6 |
| 恰好 k 个某数字 | count_of_digit | 恰好含 3 个 7 |
| 整除性 | 余数 mod m | 能被 7 整除的数 |
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| 忘记前导零处理 | 把 0007 当 7 位数处理 | 加 started 标志区分 |
| 记忆化键不完整 | 缺少 tight 或 started | 4 个维度都要包含 |
| 区间端点错误 | 查 [L, R] 时用 f(L) 而非 f(L-1) | count(R) - count(L-1) |
| dp 数组大小不够 | sum 最大可达 9×18=162 | dp[20][163][2][2] |
💪 练习题
🟢 题目 1:不含数字 4
统计 [1, N] 中不含数字 4 的整数个数(N ≤ 10^15)。
思路: 数位 DP,遇到 d=4 时跳过。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int digits[20], n_digits;
ll dp[20][2][2];
bool vis[20][2][2];
ll solve(int pos, bool tight, bool started) {
if (pos == n_digits) return started ? 1 : 0;
ll& ret = dp[pos][tight][started];
if (vis[pos][tight][started]) return ret;
vis[pos][tight][started] = true;
int lim = tight ? digits[pos] : 9;
ret = 0;
for (int d = 0; d <= lim; d++) {
if (d == 4) continue; // 不含4
ret += solve(pos + 1, tight && (d == lim), started || (d > 0));
}
return ret;
}
ll count_up_to(ll N) {
if (N <= 0) return 0;
n_digits = 0;
ll tmp = N;
while (tmp) { digits[n_digits++] = tmp % 10; tmp /= 10; }
reverse(digits, digits + n_digits);
memset(vis, 0, sizeof(vis));
return solve(0, true, false);
}
int main() {
ll L, R; cin >> L >> R;
cout << count_up_to(R) - count_up_to(L - 1) << "\n";
}
🟡 题目 2:各位数字和为 S
统计 [L, R] 中各位数字之和恰好为 S 的整数个数(L, R ≤ 10^18,S ≤ 162)。
核心思路: 直接使用 6.5.4 节的通用模板,设置目标和 S。状态 (pos, sum, tight, started) 记忆化搜索。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int digits[20], n_digits, S;
ll dp[20][200][2][2];
bool vis[20][200][2][2];
ll solve(int pos, int sum, bool tight, bool started) {
if (sum > S) return 0;
if (pos == n_digits) return (started && sum == S) ? 1 : 0;
ll& ret = dp[pos][sum][tight][started];
if (vis[pos][sum][tight][started]) return ret;
vis[pos][sum][tight][started] = true;
int lim = tight ? digits[pos] : 9;
ret = 0;
for (int d = 0; d <= lim; d++)
ret += solve(pos + 1,
(started || d > 0) ? sum + d : 0,
tight && (d == lim),
started || (d > 0));
return ret;
}
ll count_up_to(ll N) {
if (N <= 0) return 0;
n_digits = 0; ll tmp = N;
while (tmp) { digits[n_digits++] = tmp % 10; tmp /= 10; }
reverse(digits, digits + n_digits);
memset(vis, 0, sizeof(vis));
return solve(0, 0, true, false);
}
int main() {
ll L, R; cin >> L >> R >> S;
cout << count_up_to(R) - count_up_to(L - 1) << "\n";
}
复杂度分析: 状态数 O(18 × 163 × 2 × 2),每次转移 O(10),总时间 O(18 × 163 × 4 × 10) ≈ 10^5,空间同状态数。
🔴 题目 3:各位数字单调不降 + 数字和 ≤ K
统计 [1, N] 中,各位数字单调不降且数字之和不超过 K 的整数个数(N ≤ 10^15,K ≤ 100)。
状态: (pos, last_digit, sum, tight, started)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int n_digits, K;
int digits[20];
ll dp[20][10][101][2][2];
bool vis[20][10][101][2][2];
ll solve(int pos, int last, int sum, bool tight, bool started) {
if (sum > K) return 0;
if (pos == n_digits) return started ? 1 : 0;
ll& ret = dp[pos][last][sum][tight][started];
if (vis[pos][last][sum][tight][started]) return ret;
vis[pos][last][sum][tight][started] = true;
int lim = tight ? digits[pos] : 9;
ret = 0;
for (int d = (started ? last : 0); d <= lim; d++) {
ret += solve(pos + 1, d, (started || d > 0) ? sum + d : 0,
tight && (d == lim), started || (d > 0));
}
return ret;
}
ll count_up_to(ll N) {
if (N <= 0) return 0;
n_digits = 0; ll tmp = N;
while (tmp) { digits[n_digits++] = tmp % 10; tmp /= 10; }
reverse(digits, digits + n_digits);
memset(vis, 0, sizeof(vis));
return solve(0, 0, 0, true, false);
}
int main() {
ll L, R; cin >> L >> R >> K;
cout << count_up_to(R) - count_up_to(L - 1) << "\n";
}
🔴 题目 4:USACO Gold 风格 — 能被 M 整除的数
统计 [L, R] 中各位数字之和恰好为 S 且能被 M 整除的整数个数(L, R ≤ 10^18,M ≤ 100,S ≤ 162)。
输入: 一行四个整数 L R S M。
样例输入: 1 1000 10 7
样例输出: 13
核心思路: 在标准数位 DP 的基础上增加「余数 mod M」状态。状态 (pos, sum, rem, tight, started),其中 rem 是当前已填数字组成的数对 M 取模的余数。填入数字 d 时,新余数 = (rem * 10 + d) % M。终点条件:started && sum == S && rem == 0。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int digits[20], n_digits, S, M;
ll dp[20][163][100][2][2];
bool vis[20][163][100][2][2];
ll solve(int pos, int sum, int rem, bool tight, bool started) {
if (sum > S) return 0;
if (pos == n_digits) return (started && sum == S && rem == 0) ? 1 : 0;
ll& ret = dp[pos][sum][rem][tight][started];
if (vis[pos][sum][rem][tight][started]) return ret;
vis[pos][sum][rem][tight][started] = true;
int lim = tight ? digits[pos] : 9;
ret = 0;
for (int d = 0; d <= lim; d++) {
bool ns = started || (d > 0);
int nsum = ns ? sum + d : 0;
int nrem = ns ? (rem * 10 + d) % M : 0;
ret += solve(pos + 1, nsum, nrem, tight && (d == lim), ns);
}
return ret;
}
ll count_up_to(ll N) {
if (N <= 0) return 0;
n_digits = 0; ll tmp = N;
while (tmp) { digits[n_digits++] = tmp % 10; tmp /= 10; }
reverse(digits, digits + n_digits);
memset(vis, 0, sizeof(vis));
return solve(0, 0, 0, true, false);
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
ll L, R; cin >> L >> R >> S >> M;
cout << count_up_to(R) - count_up_to(L - 1) << "\n";
}
复杂度分析: 状态数 O(18 × 163 × 100 × 2 × 2) ≈ 2.3 × 10^6,每次转移 O(10),总时间约 2.3 × 10^7,空间同状态数。
💡 章节联系: 数位 DP 是 USACO Gold 每年必出的题型之一。它将「计数问题」转化为「逐位填数的决策 DP」,是 DP 思想的精华体现。掌握后可进一步学习「数位 + 组合数学」的双重计数技巧。
第 6.6 章:DP 优化
6.6.0 从三道超时的题出发
前面几章你已经学会设计状态和转移。但竞赛里更残酷的问题是:状态设计对了、转移也想对了,复杂度却过不了。看三道题:
题 1(多重背包):
N ≤ 100件物品,物品i重w_i、价值v_i、最多选k_i件(k_i ≤ 100),背包容量W ≤ 40000。按 6.2 章的做法枚举「选几件」,转移一层是O(W × k_i),总复杂度O(N·W·k)达 4×10⁸,超时。
题 2(玩具装箱,HNOI2008):
N ≤ 5×10⁴个玩具排成一排,分成若干段,段[l,r]的代价是(r-l+1+Σc-L)²,求最小总代价。朴素 DPf[i] = min{f[j] + 代价}是O(N²)= 2.5×10⁹,超时。
题 3(石子合并,大数据版):
N ≤ 5000堆石子合并成一堆。区间 DP 枚举分割点是O(N³)≈ 1.25×10¹¹,超时。
三道题状态都对、转移都对,唯一的问题是转移里有冗余:
- 题 1:计算
dp[i][j]时枚举了 k,但dp[i][j-2w]、dp[i][j-w]……这些「邻居」的转移里已经算过几乎同一批候选值——重复的滑动窗口最值问题; - 题 2:每个
f[i]都从头枚举所有j,但相邻i的最优决策点在大多数情况下靠得很近——决策点的位置有规律; - 题 3:
dp[l][r]枚举了所有分割点 k,但最优分割点满足opt[l][r-1] ≤ opt[l][r] ≤ opt[l+1][r]——决策单调,不需要全枚举。
本章讲三种利用这些冗余的经典优化:
| 小节 | 优化技术 | 利用什么冗余 | 复杂度变化 | 代表题 |
|---|---|---|---|---|
| 6.6.1 | 单调队列优化 | 转移是「滑动窗口最值」 | O(N·W·k) → O(N·W) | 多重背包 |
| 6.6.2 | 斜率优化 | 转移是「一次函数截距最值」 | O(N²) → O(N) | 玩具装箱 |
| 6.6.3 | 决策单调性 | 最优决策点随下标单调移动 | O(N³) → O(N²)(区间 DP) | 石子合并 |
6.6.1 单调队列优化
使用场景: 转移可以整理成 dp[i] = max{ dp[j] + cost(j,i) },且当 i 固定时,候选的 j 构成一个长度固定的滑动窗口,窗口内的「有效部分」只与 j 有关。
核心思路: 把「窗口内每个 j 都试一遍」变成「单调队列维护窗口最值」,每个元素入队出队各一次,均摊 O(1)。
例题:多重背包
回顾 6.2 章的多重背包转移(dp[i][j] = 前 i 件物品、容量 j 的最大价值):
dp[i][j] = max{ dp[i-1][j - k*w[i]] + k*v[i] : 0 ≤ k ≤ min(k[i], j/w[i]) }
枚举 j 和 k,一层是 O(W·k)。下面看冗余在哪。
第一步:按余数分组。 固定物品 i,容量 j 能到达的所有状态是 j = x·w + y(y = j mod w,x = j div w)。对同一个余数 y,把状态排成一列:
g[x] = dp[i-1][x*w + y] (上一层的值,按 x 排列)
以 w=3 为例,余 y=1 的一列是 j = 1, 4, 7, 10, 13, ...,对应 x = 0, 1, 2, 3, 4, ...。
第二步:写出列内的转移。 在这一列里,dp[i][x·w+y] 由下面的最大值决定(令 k = x - x',即选的件数):
g'[x] = max{ g[x-k] + k*v : 0 ≤ k ≤ min(K, x) }
其中 K = k[i]。这一步还没省事——但注意 k·v = (x - (x-k))·v,拆开:
g'[x] = max{ g[x-k] - (x-k)·v : 0 ≤ k ≤ min(K, x) } + x·v
令 G[x] = g[x] - x·v,则:
g'[x] = max{ G[x-k] : 0 ≤ k ≤ min(K, x) } + x·v
= max{ G[t] : x-K ≤ t ≤ x } + x·v (t = x-k)
这就是一个长度为 K+1 的滑动窗口最大值! 用单调队列,均摊 O(1) 求出每个 g'[x]。
复杂度: 枚举 y 是 w 种,每个 y 内枚举 x 是 W/w 步——合计正好 O(W),总复杂度降为 O(N·W)。
完整代码
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; long long W;
cin >> n >> W;
vector<long long> w(n), v(n);
vector<int> k(n);
for (int i = 0; i < n; i++) cin >> w[i] >> v[i] >> k[i];
vector<long long> f(W + 1, 0); // f[j] 当前为「处理完前 i 件物品」
vector<long long> g(W + 1); // 上一层(前 i-1 件)的值
vector<long long> nf(W + 1); // 新一层
deque<int> dq; // 存 x(该同余类中物品的「件数」层号)
for (int i = 0; i < n; i++) {
g = f; // g = f[i-1][*]
for (int y = 0; y < w[i] && y <= W; y++) {
dq.clear();
long long wi = w[i], vi = v[i];
int K = k[i];
// x = 0,1,2,...,对应容量 j = x*w+y
int maxX = (int)((W - y) / wi);
for (int x = 0; x <= maxX; x++) {
long long j = x * wi + y;
// 窗口是 [x-K, x]:弹出队首越界的 x
while (!dq.empty() && dq.front() < x - K) dq.pop_front();
// 队尾单调:弹掉所有 G 值不优于新 x 的旧队尾
while (!dq.empty() &&
g[dq.back() * wi + y] - dq.back() * vi
<= g[j] - (long long)x * vi)
dq.pop_back();
dq.push_back(x);
// 队首是窗口内 G 最大的 x'
nf[j] = g[dq.front() * wi + y] - dq.front() * vi + (long long)x * vi;
}
}
f.swap(nf);
}
cout << f[W] << "\n";
return 0;
}
样例:
输入:
2 10
2 3 3
3 5 2
输出:
16
手算核对:物品 1(重 2、价值 3、限 3 件)+ 物品 2(重 3、价值 5、限 2 件)。最优方案是 3 件物品 1(重 6、价值 9)+ 2 件物品 2(重 6、价值 10),总重 12 > 10 ✗。改取 2 件物品 1 + 2 件物品 2:重 4+6=10 ≤ 10,价值 6+10=16。✓
何时使用: 转移中出现 max/min{ dp[j] + 只与 j 有关的东西 } 且 j 的范围是一个平移的固定窗口(多重背包、跳跃距离限制类题)。若窗口两端都随 i 移动且不固定长度,仍可用单调队列,只需按实际窗口弹两端。
6.6.2 斜率优化
使用场景: 转移中出现了乘积项(如 (s[i]-s[j])² 展开后有 s[i]·s[j]),单调队列救不了,但把每个决策 j 看成平面上的点、把转移看成直线的截距后,最优决策落在凸壳上。
例题:玩具装箱(HNOI2008)
题目: N 个玩具排成一排,第 i 个长度 c_i。分成若干段(每段是连续区间),段 [l,r] 的代价为 (r-l+1+Σ_{i=l..r} c_i - L)²(L 是常量,段长算上玩具之间的空隙)。求最小总代价。N ≤ 5×10⁴。
朴素 DP: 设 f[i] = 前 i 个玩具分段的最小代价,pre[i] = c 的前缀和:
f[i] = min{ f[j] + (pre[i]-pre[j] + i-j-1 - L)² : 0 ≤ j < i }
O(N²),超时。
第一步:化简——消掉式子里的 i 和 j
令 s[i] = pre[i] + i(把 i 折进前缀和),L' = L + 1,则:
$$f_i = \min_{j<i}{, f_j + (s_i - s_j - L')^2 ,}$$
第二步:拆平方,按「与谁有关」分组
展开 (s_i - s_j - L')² 并把只与 i 有关的项移到左边:
$$f_i - (s_i - L')^2 = \min_{j<i}{, \underbrace{(f_j + s_j^2)}{只与\ j\ 有关} + \underbrace{2(L'-s_i)}{斜率}\cdot \underbrace{s_j}_{只与\ j\ 有关} ,}$$
回忆一次函数的斜截式 y = kx + b,即 b = y - kx。把每个决策 j 看成平面上一个点:
x_j = s[j]
y_j = f[j] + s[j]²
把当前状态 i 看成一条斜率固定的直线:
k_i = 2·(L' - s[i]) (注意 s[i] 单调递增 → k_i 单调递减)
那么右边要最小化的正是 y_j - k_i·x_j——过点 j、斜率为 k_i 的直线的截距!
第三步:最优决策在下凸壳上
想象一条斜率为 k_i 的直线从下往上平移,第一个碰到的点就是使截距最小的点。显然这个点只可能在点集的下凸壳上(凸壳内部的点永远不会第一个被碰到)。于是:
- 不维护所有点,只维护下凸壳——凸壳上相邻两点连线的斜率从左到右严格递增;
- 本题中
s[i]单调递增,所以斜率k_i = 2(L'-s[i])单调递减;同时新点的横坐标x_i = s[i]单调递增,只会从右边插入。
这两条单调性合起来,意味着单调队列就够用,不需要二分或平衡树。
第四步:单调队列维护凸壳
设 K(a,b) 为过点 a、点 b 的直线斜率。队列存凸壳上的点(从左到右斜率递增)。
取队首(找最优决策): 若 K(q[h], q[h+1]) ≥ k_i,说明切点在更右边,弹掉队首;否则队首即最优。因为 k_i 单调递减,被弹掉的点以后也用不上——每个点至多被弹一次。
插入队尾(加入新点 i): 若 K(q[t-1], q[t]) ≥ K(q[t], i),说明点 q[t] 在凸壳内部(三点构成「上凸」),弹掉;直到保持斜率严格递增,再把 i 入队。
斜率比较用叉积避免浮点和除法。 K(a,b) ≤ K(c,d) 等价于 (y_b-y_a)·(x_d-x_c) ≤ (y_c-y_d)·(x_b-x_a)(横坐标均递增时分母为正,不等号方向不变)。
判据速查(K(a,b) 表示 a、b 两点连线的斜率):
| 操作 | 条件(用乘法写) | 含义 |
|---|---|---|
| 弹队首 | K(q[h],q[h+1]) ≤ k_i | 队首两点连线比直线平(或一样平),队首不可能最优 |
| 弹队尾 | K(q[t-1],q[t]) ≥ K(q[t],i) | 队尾点在新点加入后落到凸壳内部 |
复杂度: 每个点入队一次、至多出队一次,总计 O(N)。
完整代码
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int main() {
int n; ll L;
cin >> n >> L;
vector<ll> c(n + 1);
vector<ll> s(n + 1); // s[i] = pre[i] + i(前缀和,含空隙)
for (int i = 1; i <= n; i++) {
cin >> c[i];
s[i] = s[i-1] + c[i] + 1; // 折叠:pre + i 等价于「(c+1) 的前缀和」
}
ll Lp = L + 1;
vector<ll> f(n + 1);
// 点 j:(x_j, y_j) = (s[j], f[j] + s[j]²)
// 直线 i:斜率 k_i = 2(L' - s[i]),最小化截距 y_j - k_i·x_j
// f[i] = min{ y_j - k_i·x_j } + (s[i] - L')²
vector<int> q(n + 2);
int head = 0, tail = 0; // [head, tail)
q[tail++] = 0; // 决策点 0(f[0]=0, 点 (0,0))入队
auto X = [&](int j) { return s[j]; };
auto Y = [&](int j) { return f[j] + s[j] * s[j]; };
for (int i = 1; i <= n; i++) {
ll k = 2 * (Lp - s[i]); // 当前直线斜率(随 i 单调递减)
// 弹队首:K(q[h],q[h+1]) <= k 时 q[h] 不可能是最优
// 乘法形式:(Y[h+1]-Y[h]) <= k * (X[h+1]-X[h])
while (tail - head >= 2) {
ll dy = Y(q[head+1]) - Y(q[head]);
ll dx = X(q[head+1]) - X(q[head]);
if (dy <= k * dx) head++;
else break;
}
int j = q[head];
ll base = (s[i] - Lp) * (s[i] - Lp);
f[i] = Y(j) + 2 * (Lp - s[i]) * s[j] + base;
// 插入点 i:维护下凸壳(斜率严格递增)
// 弹队尾:K(q[t-2],q[t-1]) >= K(q[t-1],i),用叉积:
while (tail - head >= 2) {
int a = q[tail-2], b = q[tail-1];
if ((Y(b) - Y(a)) * (X(i) - X(b)) >=
(Y(i) - Y(b)) * (X(b) - X(a)))
tail--;
else break;
}
q[tail++] = i;
}
cout << f[n] << "\n";
return 0;
}
手算核对(自造小数据):
输入:
5 3
1 2 3 4 5
输出:
6
前缀 s = [0, 2, 5, 9, 14, 20],L' = L + 1 = 4,转移为 f[i] = min{ f[j] + (s[i]-s[j]-4)² }。逐行填表(j = 0 表示「前面不分段」,即整个前缀作为一段):
f[1] = f[0] + (2-0-4)² = 4
f[2] = min(0+(5-0-4)², 4+(5-2-4)²) = min(1, 5) = 1 ← 决策 j=0
f[3] = min(0+(9-4)², 4+(9-2-4)², 1+(9-5-4)²) = min(25, 25, 1) = 1
f[4] = min(0+(14-4)², 4+(14-2-4)², 1+(14-5-4)², 1+(14-9-4)²)
= min(100, 64, 26, 2) = 2 ← 决策 j=3
f[5] = min(0+(20-4)², 4+(20-2-4)², 1+(20-5-4)², 1+(20-9-4)², 2+(20-14-4)²)
= min(256, 196, 122, 50, 6) = 6 ← 决策 j=4
与程序输出 6 一致。最优分段是 {1,2}{3}{4,5}:读者可以代入原代价公式 (段长+Σc-L)² 验证。
强烈建议: 斜率优化代码写完后,一定保留 O(N²) 暴力版本,用小随机数据对拍——本题的化简涉及 +1 折叠(L'=L+1)和平方展开,任何一处符号写错都会安静地输出错误答案。本书这两份代码正是通过对拍验证的。
何时可用(两个单调性都要检查):
- 横坐标单调:新决策点的
x_i随 i 递增(本题x_i = s[i]递增 ✓)→ 新点只会加在凸壳右端,队尾弹出即可; - 斜率单调:查询斜率
k_i随 i 单调(本题递减 ✓)→ 队首弹出的点永远不需要回来。
任一不满足,就要升级为「凸壳上二分」(斜率不单调)或 CDQ 分治 / 平衡树(横坐标不单调),复杂度变为 O(N log N) 或更差。
6.6.3 决策单调性(简介)
使用场景: 转移 f[i] = min{ w(j, i) } 中代价函数 w 满足四边形不等式,从而最优决策点 opt(i) 随 i 单调不减。
四边形不等式:「交叉小于包含」
若对所有 a ≤ b ≤ c ≤ d 都有
$$w(a,c) + w(b,d) \le w(a,d) + w(b,c)$$
则称 w 满足四边形不等式。直观记法:交叉 ≤ 包含(左边的区间「交叉」,右边的区间「包含」)。它的含义是:区间越大越「亏」,把小区间换成交叠区间总能更优。
定理(记住结论即可): 若 w 满足四边形不等式,则 f(i) = min w(j,i) 的最优决策点 opt(i) 单调不减。
直觉:i 变大时,原来偏左的决策相对越来越差,最优决策只能右移。这正是「决策单调性」。
区间 DP 版本:石子合并
石子合并的区间 DP 是 dp[l][r] = min{ dp[l][k] + dp[k+1][r] } + cost(l,r),其中 cost = 区间石子和。石子合并的代价满足四边形不等式(区间和关于「交叉/包含」满足该性质),因此最优分割点满足:
$$opt[l][r-1] \le opt[l][r] \le opt[l+1][r]$$
枚举 k 时只需在 [opt[l][r-1], opt[l+1][r]] 这个小区间里找。用 opt[l][r] 记录每个区间的最优分割点:
核心框架(决策单调性优化区间 DP):
// opt[l][l] = l;l 从大到小、r 从小到大枚举
for (int l = n - 1; l >= 1; l--)
for (int r = l + 1; r <= n; r++) {
int lo = opt[l][r-1]; // 下界
int hi = min(opt[l+1][r], r - 1); // 上界
ll best = LLONG_MAX; int bestk = lo;
for (int k = lo; k <= hi; k++) { // 只枚举小区间!
ll cur = f[l][k] + f[k+1][r] + cost(l, r);
if (cur < best) { best = cur; bestk = k; }
}
f[l][r] = best;
opt[l][r] = bestk;
}
内层循环的总长度从 O(N) 降为 O(opt 区间长度),可以证明总复杂度为 O(N²)(原为 O(N³)),N = 5000 时约 2.5×10⁷,轻松通过。
一维版本的分治写法(f[i] = min{f[j] + w(j,i)} 型,如「分石子」类问题)也常考。设 DP(l, r, kl, kr) 表示要计算 f[l..r],且这些状态的最优决策都在 [kl, kr] 中:
void DP(int l, int r, int kl, int kr) {
if (l > r) return;
int mid = (l + r) / 2, bestk = kl;
// 暴力在 [kl, min(kr, mid-1)] 中找 f[mid] 的最优决策
for (int j = kl; j <= min(kr, mid - 1); j++)
if (w(j, mid) < w(bestk, mid)) bestk = j;
f[mid] = w(bestk, mid); // 或 f[j]+w 的形式
// 由决策单调性,左右两半的决策区间被 bestk 切开
DP(l, mid - 1, kl, bestk);
DP(mid + 1, r, bestk, kr);
}
每层分治中决策区间总长度是 O(N),共 O(log N) 层,总复杂度 O(N log N)。
完整代码(石子合并 + opt 区间优化)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int main() {
int n;
cin >> n;
vector<ll> a(n + 1), pre(n + 1, 0);
for (int i = 1; i <= n; i++) {
cin >> a[i];
pre[i] = pre[i-1] + a[i];
}
vector<vector<ll>> f(n + 2, vector<ll>(n + 2, 0));
vector<vector<int>> opt(n + 2, vector<int>(n + 2, 0));
if (n == 1) { cout << 0 << "\n"; return 0; }
// opt[l][l] = l:单元素区间的「分割点」就是自己,
// 保证后续 opt 下界不会取到 0(常见错误!)
for (int l = 1; l <= n; l++) opt[l][l] = l;
// 决策单调性:opt[l][r-1] <= opt[l][r] <= opt[l+1][r]
for (int l = n - 1; l >= 1; l--) {
for (int r = l + 1; r <= n; r++) {
int lo = opt[l][r-1];
int hi = min(opt[l+1][r], r - 1);
int bestk = lo;
ll best = LLONG_MAX;
for (int k = lo; k <= hi; k++) {
ll cur = f[l][k] + f[k+1][r] + pre[r] - pre[l-1];
if (cur < best) { best = cur; bestk = k; }
}
f[l][r] = best;
opt[l][r] = bestk;
}
}
cout << f[1][n] << "\n";
return 0;
}
样例:
输入:
4
1 2 3 4
输出:
19
手算:{1,2} 代价 3,{3,4} 代价 7,合并 {1,2} 和 {3,4} 代价 10;总计 3+7+10 = 20?再试 {1,2,3} 再并 4:{1,2}=3、{1,2,3}=6、总并=10,合计 19。✓ 最优是 19(f[1][2]=3, f[1][3]=3+6=9, f[4][4]=0,f[1][4] = f[1][3]+0+10 = 19)。
重要提醒: 决策单调性是一个需要**证明(或对拍验证)**的性质,不是所有区间 DP 都有。用之前先确认代价函数满足四边形不等式(石子合并、一些「区间染色」问题满足;带负权或奇怪代价的可能不满足)。
⚠️ DP 优化常见错误
展开——竞赛前必读
单调队列优化陷阱:
- ❌ 多重背包按余数分组时,
y的循环范围写成0..W而不是0..min(w, W)——白做无用功,复杂度退化 - ❌ 队列里存的应是「变换后的 G 值对应的下标」,使用时忘记补回
- x·v + x·v,直接拿了错误的值 - ❌ 弹队首条件
<与<=搞反——窗口长度 K+1 意味着dq.front() < x - K时才越界
斜率优化陷阱:
- ❌ 斜率比较用除法:
(y2-y1)/(x2-x1)有精度误差且可能除以 0——必须用乘法交叉相乘比较;乘积可能超 long long 时用__int128 - ❌ 凸壳弹队条件方向写反:下凸壳(维护 min)弹队尾的条件是
K(队尾前, 队尾) ≥ K(队尾, 新点);若写成≤会把凸壳上的合法点弹掉。记住口诀:下凸壳斜率要严格递增,「变平/变凹」就弹 - ❌ 弹队首与弹队尾的条件搞混:队首看的是查询斜率 k_i,队尾看的是新点与凸壳的斜率
- ❌ 忘记检查两个单调性前提(横坐标单调、查询斜率单调)就在不满足的题上套模板——会 WA
- ❌ 转移式化简时
+1、-1(如L' = L+1)折错——斜率优化推导完必须用 O(N²) 暴力对拍
决策单调性陷阱:
- ❌ 石子合并的
opt[l][l]初始化为 0 而不是 l——opt[l][r-1]当r-1=l时会取到 0,导致 k 从 0 枚举(越界)或漏算 - ❌ 没验证代价函数满足四边形不等式就乱套——决策不单调的题会得到错误答案
- ❌ 分治写法中
min(kr, mid-1)忘记加——决策点 j 必须 < mid(j 是 mid 的左决策)
本章总结
📌 模式识别指南
| 优化技术 | 转移式的样子 | 关键性质 | 复杂度 | 代表题 |
|---|---|---|---|---|
| 单调队列 | dp[i] = max{ dp[j] + g(j) },j 在平移窗口内 | 窗口最值 | O(N·W·k) → O(N·W) | 多重背包 |
| 斜率优化 | dp[i] = min{ dp[j] + (s_i-s_j)² } 等含乘积项 | 决策是点、转移是直线截距;横坐标与斜率均单调 | O(N²) → O(N) | 玩具装箱 |
| 决策单调性 | dp[i] = min{ w(j,i) },w 满足四边形不等式 | opt(i) 单调不减 | O(N²) → O(N log N)(分治)或 O(N³) → O(N²)(区间) | 石子合并 |
🧩 核心框架速查
// 单调队列优化:窗口 [i-K, i] 的最值
deque<int> dq;
for (int i = 0; i < n; i++) {
while (!dq.empty() && dq.front() < i - K) dq.pop_front();
while (!dq.empty() && val(dq.back()) <= val(i)) dq.pop_back();
dq.push_back(i);
// dq.front() 是窗口 [i-K, i] 内 val 最大的下标
}
// 斜率优化:下凸壳 + 单调队列(横坐标、查询斜率均单调)
// 弹队首:K(q[h],q[h+1]) <= k_i → 用 (Y[h+1]-Y[h]) <= k*(X[h+1]-X[h])
// 弹队尾:K(q[t-2],q[t-1]) >= K(q[t-1],i) → 交叉相乘比较
// f[i] = min{ Y[j] - k_i*X[j] } + (只与 i 有关的项)
// 决策单调性分治:DP(l, r, kl, kr)
void DP(int l, int r, int kl, int kr) {
if (l > r) return;
int mid = (l + r) / 2, bestk = kl;
for (int j = kl; j <= min(kr, mid - 1); j++)
if (w(j, mid) < w(bestk, mid)) bestk = j;
f[mid] = w(bestk, mid);
DP(l, mid - 1, kl, bestk);
DP(mid + 1, r, bestk, kr);
}
❓ 常见问题
Q1:我怎么判断一道题该用哪种优化?
A:先写朴素转移式,然后看它的形状:(1) 候选 j 构成平移的固定窗口 → 单调队列;(2) 展开后出现
s[i]·s[j]之类的乘积项、能整理成y_j - k_i·x_j→ 斜率优化;(3) 代价函数满足「交叉小于包含」→ 决策单调性。三者互相不排斥,同一道题可能先后用到多种。
Q2:斜率优化里为什么比较斜率一定要用乘法(交叉相乘)?
A:两个原因:一是除法有浮点精度误差,在
s[i]达 10⁹ 级别时足以判错方向;二是x2 - x1可能为 0(除零)。交叉相乘把比较变成整数乘法,没有精度问题。注意乘积范围:(10⁷+10⁵)² × (10⁷+10⁵)²会超 long long,此时用__int128存中间乘积。
Q3:斜率优化的两个单调性不满足怎么办?
A:分情况。横坐标单调但查询斜率不单调:在凸壳上二分找切点,O(N log N)。横坐标不单调:CDQ 分治或平衡树(如李超树)维护凸壳。这些属于更进阶的内容,NOIP/USACO Silver-Gold 层面掌握「双单调 + 单调队列」版本即可。
练习题
题目 6.6.1 — 单调队列优化:跳房子(洛谷 P1725) 🟡 中等
数轴上 0..n 每个整数点有一个格子,格 i 有分值 s_i(可负)。你从 0 出发只能向右跳,每次跳跃距离必须在 [L, R] 内。跳到(或越过——本题要求恰好落在格子上)任意格子的得分累加,求能获得的最大总得分;若无法继续跳跃则结束,得分可以为负无穷时输出 -1。n ≤ 5×10⁵。
提示
`dp[i]` = 到达格 i 的最大得分。转移 `dp[i] = s_i + max{ dp[j] : i-R ≤ j ≤ i-L }`——固定长度窗口最大值,单调队列。不满足则 dp 值为负无穷。#include <bits/stdc++.h>
using namespace std;
int main() {
int n; long long L, R;
// 洛谷 P1725 格式:第一行 n, L1, R1(L1+R1 为跳跃距离区间)
cin >> n >> L >> R;
vector<long long> s(n + 1);
for (int i = 0; i <= n; i++) cin >> s[i];
const long long NEG = LLONG_MIN / 4;
vector<long long> dp(n + 1, NEG);
deque<int> dq; // 存下标,dp 值单调递减
dp[0] = s[0];
for (int i = 1; i <= n; i++) {
// 新可用的决策下标是 i - L(跳 [L,R],从 j 跳到 i 需 i-j ∈ [L,R])
int j = (int)(i - L);
if (j >= 0 && dp[j] > NEG) {
while (!dq.empty() && dp[dq.back()] <= dp[j]) dq.pop_back();
dq.push_back(j);
}
while (!dq.empty() && dq.front() < i - R) dq.pop_front();
if (!dq.empty()) dp[i] = dp[dq.front()] + s[i];
}
long long ans = NEG;
for (int i = n; i >= 0 && n - i <= R; i--) ans = max(ans, dp[i]);
cout << (ans <= NEG / 2 ? -1 : ans) << "\n";
return 0;
}
复杂度: O(K),每个下标入队出队各一次。
题目 6.6.2 — 斜率优化:仓库建设(ZJOI2007) 🔴 困难
一条直线上有 n 个工厂,工厂 i 距离起点 x_i(递增),有 p_i 件货物,建仓库的花费为 C_i。货物可以往右运到下一个「已建仓库的工厂」,运输单价 1,即把工厂 i 的货物运到工厂 j 的花费是 p_i·(x_j - x_i)。每个工厂的货物要么就地建仓,要么运到右边最近的仓库。求最小总花费。n ≤ 10⁶。
提示
`f[i]` = 前 i 个工厂都处理完、工厂 i 建了仓库的最小花费。设 `sp` 为 p 前缀和、`spx` 为 `p·x` 前缀和: `f[i] = C_i + min{ f[j] + Σ_{k=j+1..i} p_k·(x_i - x_k) }` `= C_i + x_i·(sp_i - sp_j) - (spx_i - sp_j 前的项) + ...` 展开后整理成 `y_j - k_i·x_j` 的形式,其中 `k_i = x_i` 单调递增、横坐标也单调——标准斜率优化。#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int main() {
int n;
cin >> n;
vector<ll> x(n+1), p(n+1), C(n+1), sp(n+1, 0), spx(n+1, 0);
for (int i = 1; i <= n; i++) {
cin >> x[i] >> p[i] >> C[i];
sp[i] = sp[i-1] + p[i];
spx[i] = spx[i-1] + p[i] * x[i];
}
vector<ll> f(n+1);
// f[i] = C[i] + x_i*(sp_i - sp_j) - (spx_i - spx_j) + f[j]
// = (f[j] + spx[j]) - x_i * sp[j] + (C[i] + x_i*sp_i - spx_i)
// 点 j:(x_j, y_j) = (sp[j], f[j] + spx[j]);斜率 k_i = x_i(递增)
vector<int> q(n+2);
int head = 0, tail = 0;
q[tail++] = 0;
auto X = [&](int j) { return sp[j]; };
auto Y = [&](int j) { return f[j] + spx[j]; };
for (int i = 1; i <= n; i++) {
ll k = x[i];
// 弹队首:K(q[h],q[h+1]) <= k(插入端已保证横坐标严格递增)
while (tail - head >= 2) {
ll dy = Y(q[head+1]) - Y(q[head]);
ll dx = X(q[head+1]) - X(q[head]);
if (dy <= k * dx) head++;
else break;
}
int j = q[head];
f[i] = Y(j) - k * X(j) + C[i] + x[i] * sp[i] - spx[i];
// 插入点 i:若与队尾横坐标相同(p_i=0 时 sp 不变),只保留 y 更小者
bool insert = true;
while (tail - head >= 1 && X(i) == X(q[tail-1])) {
if (Y(i) < Y(q[tail-1])) tail--;
else { insert = false; break; }
}
if (insert) {
while (tail - head >= 2) {
int a = q[tail-2], b = q[tail-1];
if ((Y(b)-Y(a)) * (X(i)-X(b)) >=
(Y(i)-Y(b)) * (X(b)-X(a)))
tail--;
else break;
}
q[tail++] = i;
}
}
// 最后一个仓库必须建在工厂 n(否则它右边的货物无处可运),
// 所以答案就是 f[n]
cout << f[n] << "\n";
return 0;
}
复杂度: O(N)。⚠️ 本题推导链较长:先把「区间 [j+1, i] 的运输总花费」用前缀和 sp、spx 表示,再按「只与 j 有关 / 只与 i 有关 / 与两者都有关」三组整理,最后识别出 k_i = x_i(单调递增)与 x_j = sp[j](单调递增)——两个单调性都成立,标准单调队列版斜率优化即可。另注意一个细节:p_i = 0 时相邻两点横坐标相同,插入时只保留 y 更小的点,否则凸壳上会出现竖直边,弹队首时 dx = 0 会让斜率比较判错方向。
题目 6.6.3 — 决策单调性:石子合并变体(能量项链式合并) 🟡 中等
N 堆石子(N ≤ 5000)排成一行,合并相邻两堆的代价为两堆石子数之和的平方。求最小总代价。区间的「代价函数」cost² 仍满足四边形不等式吗?先用 O(N³) 暴力对拍验证你的决策单调性优化是否正确。
提示
`f[l][r] = min{ f[l][k]+f[k+1][r] } + (pre[r]-pre[l-1])²`。代价只与区间和有关,仍满足四边形不等式(凸函数的复合保持性质),opt 区间优化照常适用;但对拍是必须的——平方后的代价结构变了,别想当然。#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
int main() {
int n;
cin >> n;
vector<ll> a(n + 1), pre(n + 1, 0);
for (int i = 1; i <= n; i++) {
cin >> a[i];
pre[i] = pre[i-1] + a[i];
}
vector<vector<ll>> f(n + 2, vector<ll>(n + 2, 0));
vector<vector<int>> opt(n + 2, vector<int>(n + 2, 0));
if (n == 1) { cout << 0 << "\n"; return 0; }
for (int l = 1; l <= n; l++) opt[l][l] = l;
for (int l = n - 1; l >= 1; l--)
for (int r = l + 1; r <= n; r++) {
int lo = opt[l][r-1], hi = min(opt[l+1][r], r - 1);
ll sum = pre[r] - pre[l-1];
ll best = LLONG_MAX; int bestk = lo;
for (int k = lo; k <= hi; k++) {
ll cur = f[l][k] + f[k+1][r] + sum * sum;
if (cur < best) { best = cur; bestk = k; }
}
f[l][r] = best;
opt[l][r] = bestk;
}
cout << f[1][n] << "\n";
return 0;
}
复杂度: O(N²),N = 5000 时约 2.5×10⁷ 次操作,轻松通过。
💡 下一步: DP 优化是「转移式形状分析」的训练——每次都先把朴素转移写在纸上,看它的候选结构(窗口?点集?单调决策?),再选工具。第七部分图论中的最短路(Dijkstra)也会遇到完全相同的「冗余决策剔除」思想。
第 6.8 章:树形 DP 与换根
前置知识: 第 5.2 章(BFS 与 DFS)——尤其是树的 DFS 遍历与后序访问顺序;第 6.1 章(DP 入门)——状态设计与转移的基本思路。
6.8.0 从一道题出发:没有上司的舞会
先看一道经典题(洛谷 P1352,USACO 风格的公司聚会原型):
🏢 题目:没有上司的舞会 一个公司有
N名职员(N ≤ 6000),组织结构构成一棵树:每个职员有一个直接上司(除老板外)。 每名职员有一个「快乐值」。现在要选一部分人参加舞会,但没有人愿意和自己的直接上司同时出场。 求参会职员的快乐值总和最大是多少。
老板(5)
/ \
经理(3) 主管(6)
/ \
员工(4) 员工(2)
(括号内为快乐值。最优解:老板 + 两个底层员工 = 5+4+2 = 11)
先试试你会的方法
思路 1:贪心,快乐值大的先选? 选主管(6)再选老板(5)?冲突——他们是上下级。改成主管(6)+员工(4)+员工(2)?只有 12…但如果选老板+两个员工是 11,选主管+四号五号员工呢?逐个试组合很快失控。
思路 2:枚举所有子集? 2⁶⁰⁰⁰ 种选法,直接爆炸。
思路 3:像第 6 章那样做 DP? 但「选不选职员 u」依赖于「选不选它的上司」和「选不选它的所有下属」——普通线性 DP 的 dp[i] 只看前一个状态,无法表达这种树状的依赖。
关键观察: 对每个职员 u,只有两种状态——参会或不参会。而:
- 若 u 参会,它的直接上司必须缺席,u 的最优值由它的子树决定;
- 若 u 缺席,它的下属自由选择(各自取参会/缺席的较大者)。
也就是说,u 所在子树的最优解可以完全由 u 的各孩子子树的最优解推出来——这正是 DP 的「最优子结构」,只不过子问题不是「前 i 个」而是「以 u 为根的子树」。
拆解这道题需要回答的问题
- 树上的子问题长什么样?为什么不会绕环?→ 6.8.0b:为什么树适合 DP
- 模板怎么写?→ 6.8.1:带父节点参数的后序 DFS
- 同样的套路还能算什么?→ 6.8.2:子树大小、树的直径、最大独立集(舞会就是最大独立集)
- 如果要对每个节点作为根都求答案呢?→ 6.8.3 换根技术(不用对每个根重新 DFS)
- DP 部分还有哪些变形?→ 6.8.4 树背包、6.8.5 题型模式
学习目标:
- 编写基于子树的树形 DP 模板
- 计算树的直径、最长路径、子树和
- 运用换根技术,以 O(N) 时间回答"以某节点为根时的结果"
- 识别 USACO Gold 树题中的树形 DP 模式
6.8.0b 为什么树适合 DP?
有根树本质上是一个 DAG(边从根指向子节点)。这意味着:
- 无环: DP 的转移方向始终是从父到子(无回溯)
- 自然子问题: 以 v 为根的子树构成一个完整、独立的子问题
- 简洁递推:
dp[v]只依赖dp[v 的子节点]
核心模式: 后序 DFS——先处理子节点,再处理父节点。
树: DFS 后序: DP 顺序:
1 4, 5, 2 先计算 dp[4]、dp[5],
/ \ 6, 3 再用它们计算 dp[2]
2 3 2, 3
/ \ \ 1 dp[v] 在所有子节点后才计算
4 5 6 → 父节点可以直接使用子节点的 dp 值
6.8.1 树形 DP 模板
标准树形 DP 模板:带父节点参数的 DFS,避免回溯。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
int dp[MAXN]; // 根据问题定义 dp 数组
void dfs(int u, int parent) {
// 初始化 dp[u](基础情况:叶节点)
dp[u] = /* 初始值 */ 0;
for (int v : adj[u]) {
if (v == parent) continue; // 不回溯到父节点
dfs(v, u); // ← 先对子节点递归(后序)
// 现在 dp[v] 已计算好 → 用它更新 dp[u]
dp[u] = /* 合并 dp[u] 和 dp[v] */;
}
}
int main() {
int n;
cin >> n;
for (int i = 0; i < n - 1; i++) {
int u, v;
cin >> u >> v;
u--; v--;
adj[u].push_back(v);
adj[v].push_back(u);
}
dfs(0, -1); // 以顶点 0 为根,无父节点
cout << /* 用 dp 值计算答案 */ "\n";
return 0;
}
6.8.2 经典树形 DP 问题
问题 1:子树大小
sz[v] = 以 v 为根的子树中节点数。
int sz[MAXN];
void dfs(int u, int par) {
sz[u] = 1; // 计入 u 自身
for (int v : adj[u]) {
if (v == par) continue;
dfs(v, u);
sz[u] += sz[v]; // 加上子节点的子树大小
}
}
问题 2:子树最大深度
depth[v] = 从 v 到其子树中任意叶节点的最大距离。
int depth[MAXN];
void dfs(int u, int par) {
depth[u] = 0;
for (int v : adj[u]) {
if (v == par) continue;
dfs(v, u);
depth[u] = max(depth[u], depth[v] + 1); // 经过 v 延伸路径
}
}
问题 3:树的直径
树的直径是任意两节点之间的最长路径。核心思路:最长路径要么经过根节点,要么完全在某棵子树内。
方法一:两次 DFS(最简洁)
int farthest_node, max_dist;
void dfs_farthest(int u, int par, int dist) {
if (dist > max_dist) {
max_dist = dist;
farthest_node = u;
}
for (int v : adj[u]) {
if (v != par)
dfs_farthest(v, u, dist + 1);
}
}
int treeDiameter(int n) {
// 第 1 步:找直径的一个端点(离节点 0 最远的节点)
max_dist = 0;
dfs_farthest(0, -1, 0);
int endpoint1 = farthest_node;
// 第 2 步:找另一个端点(离 endpoint1 最远的节点)
max_dist = 0;
dfs_farthest(endpoint1, -1, 0);
return max_dist; // 直径长度
}
方法二:DP(更通用)
int diameter = 0;
int max_down[MAXN]; // max_down[v] = 从 v 向下延伸的最长路径
void dfs(int u, int par) {
max_down[u] = 0;
vector<int> child_depths;
for (int v : adj[u]) {
if (v == par) continue;
dfs(v, u);
child_depths.push_back(max_down[v] + 1);
}
// 经过 u 的直径 = 最长的两条向下路径之和
sort(child_depths.rbegin(), child_depths.rend());
if (child_depths.size() >= 1) max_down[u] = child_depths[0];
if (child_depths.size() >= 2) {
diameter = max(diameter, child_depths[0] + child_depths[1]);
}
diameter = max(diameter, max_down[u]);
}
问题 4:树上最大独立集
选出尽可能多的节点,使得任意两个被选节点均不相邻(不通过一条边相连)。
int dp[MAXN][2];
// dp[v][0] = v 未被选中时,v 子树中的最大节点数
// dp[v][1] = v 被选中时,v 子树中的最大节点数
void dfs(int u, int par) {
dp[u][0] = 0;
dp[u][1] = 1; // v 自身被选中
for (int v : adj[u]) {
if (v == par) continue;
dfs(v, u);
dp[u][0] += max(dp[v][0], dp[v][1]); // v 未选:子节点可选可不选
dp[u][1] += dp[v][0]; // v 已选:子节点必须不选
}
}
// 答案 = max(dp[root][0], dp[root][1])
6.8.3 换根技术
问题: 对树中每个顶点 v,计算以 v 为根时的某个值。朴素做法需要 N 次 DFS → O(N²)。换根技术只需两次 DFS:O(N)。
核心思路:
- DFS 1(向下传): 计算
down[v]= 以原始根为根时,v 子树的答案 - DFS 2(向上传): 计算
up[v]= 树中"v 子树以外的部分"对应的答案 - v 为根的最终答案: 合并
down[v]和up[v]
换根模板:距离之和
问题: 对每个顶点 v,求 v 到其他所有顶点的距离之和。输出 N 个值。
这是经典 Gold 题。核心递推关系:
若已知 dist_sum[root](根到所有顶点的距离之和),则对根的子节点 c:
dist_sum[c] = dist_sum[root] - sz[c] + (n - sz[c])
= dist_sum[root] + (n - 2 * sz[c])
原因: 从根移动到 c 时,c 子树中的 sz[c] 个节点各近了 1,子树外的 (n - sz[c]) 个节点各远了 1。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
long long sz[MAXN]; // 子树大小
long long down[MAXN]; // v 到其子树中所有节点的距离之和
long long ans[MAXN]; // 最终答案:v 到所有节点的距离之和
int n;
// DFS 1:计算 sz[] 和 down[](向下传递距离和)
void dfs1(int u, int par) {
sz[u] = 1;
down[u] = 0;
for (int v : adj[u]) {
if (v == par) continue;
dfs1(v, u);
sz[u] += sz[v];
down[u] += down[v] + sz[v]; // v 子树中的所有节点多走了一步
}
}
// DFS 2:向下传播答案(换根)
void dfs2(int u, int par) {
for (int v : adj[u]) {
if (v == par) continue;
// ans[v] = ans[u] - sz[v] + (n - sz[v])
// = ans[u] + (n - 2 * sz[v])
ans[v] = ans[u] + (n - 2 * sz[v]);
dfs2(v, u);
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n;
for (int i = 0; i < n - 1; i++) {
int u, v;
cin >> u >> v;
u--; v--;
adj[u].push_back(v);
adj[v].push_back(u);
}
dfs1(0, -1);
ans[0] = down[0]; // 从根 0 出发到其他所有节点的距离之和
dfs2(0, -1);
for (int i = 0; i < n; i++)
cout << ans[i] << "\n";
return 0;
}
复杂度: O(N)——两次 DFS,各 O(N)。
换根的直觉理解
🤔 为什么有效?
可以理解为将"视角"从父节点转移到子节点。当我们把根从 u 移动到其子节点 v 时:
- v 子树中的节点:每个近了 1 → 减去 sz[v]
- 不在 v 子树中的节点:每个远了 1 → 加上 (n - sz[v])
- 净变化:+(n - sz[v]) - sz[v] = +(n - 2·sz[v])
6.8.4 换根的一般模式
换根技术可以推广到许多问题。关键是找到:
- 原始根定下来后,
down[v]表示什么? - 将根从父节点 u "换"到子节点 v 时,答案如何变化?
- 从
ans[u]计算ans[v]的公式是什么?
一般结构:
DFS 1(后序):
down[v] = combine(down[child_1], down[child_2], ..., sz[v])
DFS 2(前序):
ans[v] = combine(down[v], up[v])
对 v 的每个子节点 c:
up[c] = f(ans[v], down[c], sz[c], n)
// "up[c]" 是 c 子树之外所有内容的贡献
6.8.4b 换根示例 2:每个节点的最大距离
问题: 对每个顶点 v,求 v 到任意其他顶点的最大距离(v 的"离心率")。输出 N 个值。
这比距离之和更难,因为 max 操作不像 sum 那样可以干净地分解。
核心思路: 对每个顶点 v,最远的顶点要么:
- 在 v 的子树中(由 DFS 1 中的
down[]计算) - 经过 v 的父节点可达(由 DFS 2 中向下传播的
up[]计算)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100001;
vector<int> adj[MAXN];
int n;
int down[MAXN]; // down[v] = 向下进入 v 子树的最大深度
int up[MAXN]; // up[v] = 经 v 的父节点向上的最大深度
int ans[MAXN]; // ans[v] = v 的离心率(到任意节点的最大距离)
// DFS 1:计算 down[](v 子树中的最大深度)
void dfs1(int u, int par) {
down[u] = 0;
for (int v : adj[u]) {
if (v == par) continue;
dfs1(v, u);
down[u] = max(down[u], down[v] + 1);
}
}
// DFS 2:向下传播 up[](往"上方"走的最远距离是多少?)
// up[v] = 从 v 经过父节点能到达的最大距离
void dfs2(int u, int par) {
ans[u] = max(down[u], up[u]);
// 计算 up[子节点] 时,需要 u 的第一深和第二深子树
// (若子节点恰好是最深路径上的节点,则用第二深;否则用最深)
int best1 = -1, best2 = -1;
int best1_child = -1;
for (int v : adj[u]) {
if (v == par) continue;
int d = down[v] + 1;
if (d > best1) { best2 = best1; best1 = d; best1_child = v; }
else if (d > best2) { best2 = d; }
}
for (int v : adj[u]) {
if (v == par) continue;
// up[v] = 从 u 向上走或进入兄弟子树的最大距离
int sibling_best = (v == best1_child) ? best2 : best1;
int through_parent = up[u] + 1; // 经 u 的父节点向上,再向下
up[v] = max(through_parent, (sibling_best >= 0 ? sibling_best + 1 : 0));
dfs2(v, u);
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n;
for (int i = 0; i < n - 1; i++) {
int u, v; cin >> u >> v; u--; v--;
adj[u].push_back(v);
adj[v].push_back(u);
}
dfs1(0, -1);
up[0] = 0; // 根节点没有父节点
dfs2(0, -1);
for (int i = 0; i < n; i++)
cout << ans[i] << "\n";
return 0;
}
💡 关键技巧: 分别追踪最深的两棵子树。如果我们要计算
up[]的子节点恰好是最深的子树,就用第二深的作为兄弟贡献。
6.8.4c 树背包(子树选择 DP)
问题: 给定有根树,每个顶点 v 有重量 w[v] 和价值 b[v]。选取顶点使总重量 ≤ W,约束条件:若选取 v,则必须同时选取其父节点(从根出发的连通子集)。最大化总价值。
这是经典的树背包(群组背包在树上的变体)。
朴素 O(N²W) 方法
// dp[v][j] = 从 v 的子树中恰好选取 j 重量(v 包含其中)时的最大价值
// 基础:dp[v][w[v]] = b[v](只选 v,子树中无其他节点)
const int MAXN = 501, MAXW = 501;
int dp[MAXN][MAXW];
int sz[MAXN]; // 子树 DP 中已使用的"容量"
int w[MAXN], b[MAXN];
void dfs(int u, int par) {
fill(dp[u], dp[u] + MAXW, -1); // -1 = 不可行
dp[u][w[u]] = b[u];
sz[u] = w[u];
for (int v : adj[u]) {
if (v == par) continue;
dfs(v, u);
// 通过背包卷积将 dp[v] 合并到 dp[u]
// 逆序处理,避免重复计数
for (int j = min(sz[u] + sz[v], W); j >= w[u]; j--) {
for (int k = w[v]; k <= min(j - w[u], sz[v]); k++) {
if (dp[u][j - k] != -1 && dp[v][k] != -1) {
dp[u][j] = max(dp[u][j], dp[u][j - k] + dp[v][k]);
}
}
}
sz[u] = min(sz[u] + sz[v], W);
}
}
// 答案 = max(dp[root][j]) 对 j = 0..W
为什么实际上是 O(NW)——合并分析
关键思路: 总工作量受到限制——每对来自不同子树的顶点 (u, v) 只在它们的 LCA 合并时被比较一次。由于每对比较代价为 O(1),且每对最多被计一次,总工作量为 min(O(N²), O(NW))。
实用说明: 对于 USACO,N ≤ 300、W ≤ 300 是典型约束,O(N²W) 或 O(NW) 都很容易通过。
"从根出发的连通子集"背包模板
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 305;
vector<int> adj[MAXN];
int w[MAXN], b[MAXN];
int dp[MAXN][MAXN]; // dp[v][j] = 在 v 的子树中选 j 重量(包含 v)的最大价值
int subtree_w[MAXN]; // 子树总重量
int n, W;
void dfs(int u, int par) {
fill(dp[u], dp[u] + W + 1, 0);
dp[u][w[u]] = b[u];
subtree_w[u] = w[u];
for (int v : adj[u]) {
if (v == par) continue;
dfs(v, u);
// 将 dp[v] 合并到 dp[u]
int cap = min(subtree_w[u] + subtree_w[v], W);
for (int j = cap; j >= w[u]; j--) {
for (int k = w[v]; k <= min(j - w[u], subtree_w[v]); k++) {
if (dp[v][k] > 0)
dp[u][j] = max(dp[u][j], dp[u][j - k] + dp[v][k]);
}
}
subtree_w[u] = min(subtree_w[u] + subtree_w[v], W);
}
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
cin >> n >> W;
for (int i = 0; i < n; i++) cin >> w[i] >> b[i];
for (int i = 0; i < n - 1; i++) {
int u, v; cin >> u >> v; u--; v--;
adj[u].push_back(v);
adj[v].push_back(u);
}
dfs(0, -1);
int ans = 0;
for (int j = 0; j <= W; j++)
ans = max(ans, dp[0][j]);
cout << ans << "\n";
return 0;
}
6.8.5 DP 部分树形 DP 题型模式
模式 1:选取子树节点
"选择部分顶点激活。激活顶点 v 的代价为 c[v],收益为 b[v]。约束:只有父节点激活后才能激活 v。最大化净收益。"
这是"依赖背包"树形 DP:
// dp[v][j] = 从 v 的子树中选取 j 个顶点的最大收益
// 转移:通过背包合并 dp[v] 与 dp[子节点]
模式 2:树上路径查询
"对每个顶点 v,求最远顶点,或距离之和。"
换根模板——正如 6.8.3 节所示。
模式 3:树上匹配/配对
"在树上配对顶点(每对由一条路径连接)。最大化不相交的配对数。"
dp[v][0/1] = v 未被匹配(0)或已被匹配(1)时,v 子树中的最大配对数。
💡 思路陷阱
陷阱 1:换根题用 O(N²) 暴力 DFS
错误判断: "对每个节点做一次 DFS 计算它当根时的答案,O(N²) 应该够"
实际情况: N=10⁵ 时 O(N²)=10¹⁰,稳定 TLE;此类题几乎都是换根 DP 的典型形态
题目特征(三选一即触发):
1. "对每个节点 v,求以 v 为根时..."
2. "输出 N 个值,每个值对应某节点当根的结果"
3. "求使某个全局指标最小/最大的根节点"
正确:两次 DFS(dfs1 下行 + dfs2 上行)→ O(N)
识别信号: 输出 N 个值且每个值依赖"以该节点为根的某属性" → 换根 DP,而非 N 次 DFS
陷阱 2:树形 DP 中忘记 if (v == par) continue
错误判断: "树是无向图,从 u 出发访问邻居,DFS 会自动不走回头路"
实际情况: 无向图的邻接表中父节点也在邻居列表里,不加 par 检查会死循环/重复计数
// 错误:没有 parent 检查
void dfs(int u) {
for (int v : adj[u]) {
dfs(v); // 若 u 的父节点是 v,这里会死循环!
dp[u] += dp[v];
}
}
// 正确:传入 parent 参数
void dfs(int u, int par) {
for (int v : adj[u]) {
if (v == par) continue; // ← 这一行至关重要
dfs(v, u);
dp[u] += dp[v];
}
}
识别信号: 树的 DFS 运行时栈溢出或结果明显偏大 → 先检查有无 parent 防回溯
陷阱 3:用单次 DFS 求"树直径",结果错误
错误判断: "直径就是最深叶子到根的距离,单次 DFS 记录最大深度即可"
实际情况: 直径的两端点不一定经过根,单次 DFS 只算了"经过根的最长路径"
📄 Code 完整代码
树: 1
/ \
2 3
/ \
4 5
| |
6 7
从根 1 出发最大深度 = 3(到 6 或 7),但直径 = 6→4→2→1→3→5→7 = 6 条边
单次 DFS from root 得到 3(错),正确做法:
方法1:两次 DFS/BFS(从任意点找最远点 A,再从 A 找最远点 B)
方法2:树 DP,每个节点维护最深和次深子树,直径 = 全局最大的 (最深+次深)
识别信号: "树上最长路径"题 → 直径,要么两次 BFS/DFS,要么树 DP 维护双最深
⚠️ 常见错误
-
缺少
if (v == par) continue: 没有这个检查,DFS 会沿着边回到父节点,导致无限递归。每棵树的 DFS 都必须有这个保护。 -
叶节点基础情况初始化错误: 叶节点没有子节点,循环体不会执行。确保循环之前
dp[leaf]已正确初始化。 -
换根的 dfs2 忘了用前序: dfs2 必须从父节点向子节点传播(自顶向下),所以
ans[u]必须在ans[u 的子节点]之前计算。不要不小心用成后序。 -
子树和的整数溢出: 若 N = 10⁵ 且每个顶点贡献最多 N,总和可达 10¹⁰。使用
long long。 -
"距离之和"的差一错误: 公式
down[u] += down[v] + sz[v]为 v 子树中的每个节点加了sz[v](它们各多走了一步)。理解为什么是sz[v]而非sz[v]-1。
📋 章节小结
📌 核心要点
| 概念 | 说明 |
|---|---|
| 树形 DP | 后序 DFS;dp[v] 在所有子节点之后计算;O(N) |
| 子树大小 | sz[v] = 1 + sum(sz[子节点]) |
| 树的直径 | 最长路径;两次 DFS 或追踪最深和次深子节点的 DP |
| 最大独立集 | dp[v][0/1] 分别对应未选/已选;经典树形 DP |
| 换根 | 两次 DFS:先向下计算,再向上传播;O(N) 处理所有根 |
| 距离之和 | 经典换根:ans[子节点] = ans[父节点] + n - 2*sz[子节点] |
❓ 常见问题
Q:如何判断问题是否需要换根?
A:若问题对每个顶点(以该顶点为根时)请求相同的计算——"对每个顶点,求以它为根时的 X"——那就需要换根。若只对一个固定根请求,标准树形 DP 就够了。
Q:如果边权不为 1 怎么办?
A:调整公式即可。对于带权边,若边 (u,v) 的权重为 w,则 down[u] += down[v] + sz[v] * w[u][v]。换根公式相应调整。
Q:可以用迭代 DFS 替代递归吗?
A:可以,对于大 N 更应该这样做(避免栈溢出)。用显式栈将 DFS 改为迭代,按与入栈相反的顺序处理顶点(后序)。
🔗 与后续章节的联系
- 第 5.13 章(欧拉游览): 当树形 DP 本身对树上区间查询的效率不够时,欧拉游览 + BIT/线段树是首选方案。
- 第 5.9 章(MST): 从一般图构建 MST 后,MST 就是一棵树,可以对其做树形 DP。
- 第 6.3 章(进阶 DP): 树形 DP 是 DAG 上 DP(第 5.10 章)的特例,技术可以互相推广。
🏋️ 练习题
🟢 简单
6.8-E1. 子树查询
给定有根树,对每个顶点 v,输出其子树中的节点数。
数据规模: 1 ≤ N ≤ 10⁵。
提示
标准 sz[] 计算。sz[v] = 1 + sum(sz[子节点])。
6.8-E2. 树的直径
求 N 个顶点、单位边权的树的直径(最长路径)。
数据规模: 2 ≤ N ≤ 10⁵。
提示
两次 BFS/DFS:从任意顶点 BFS 找最远顶点 A;再从 A BFS 找最远顶点 B。A 到 B 的距离即为直径。
🟡 中等
6.8-M1. 最大独立集 (USACO 风格)
给定 N 个顶点的树,每个顶点有一个值。选出总价值最大的顶点子集,使得任意两个被选顶点之间没有边相连。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ val[v] ≤ 10⁶。
提示
经典 dp[v][0/1]。dp[v][1] = val[v] + sum(dp[子节点][0]);dp[v][0] = sum(max(dp[子节点][0], dp[子节点][1]))。
6.8-M2. 距离之和 (LeetCode 834 / USACO Gold 风格)
对树中每个顶点,求它到所有其他顶点的距离之和。输出 N 个值。
数据规模: 1 ≤ N ≤ 10⁵(距离之和可达 10¹⁰,需 long long)。
提示
使用 6.8.3 节的换根模板。两次 DFS,总复杂度 O(N)。
🔴 困难
6.8-H1. 牛聚集 (USACO 2019 February Gold)
N 头奶牛在一棵树上。每头牛有"幸福值"。当牛的父节点离开时,该牛变得更幸福。模拟移除操作,最大化总幸福值。(简化版:找到移除奶牛的顺序,使每次移除时的累积幸福值之和最大。)
提示
建模为树形 DP:对每棵子树计算按最优顺序移除顶点的"收益"。通过换根来回答所有可能起始顶点的情况。
🏆 挑战
6.8-C1. 树背包 (困难)
给定 N 个顶点的有根树,每个顶点 v 有重量 w[v] 和价值 b[v]。选取顶点子集 S,总重量 ≤ W,且若 v ∈ S 则 parent(v) ∈ S(从根出发的连通子集)。最大化总价值。
数据规模: 1 ≤ N ≤ 300,1 ≤ W ≤ 300,1 ≤ w[v] ≤ W,1 ≤ b[v] ≤ 10⁶。
提示
dp[v][j] = 从 v 的子树(包含 v)中恰好选取 j 重量的最大价值。通过卷积风格的背包合并子节点。用仔细的合并策略可以达到 O(N·W)——关键思路是每对顶点只被比较一次,因此总复杂度通过 DFS 顺序达到 O(N·W)。
第 6.7 章:概率期望与计数 DP
6.7.0 从两道题出发
前面几章的 DP 都在求「最优值」。但竞赛里还有一大类题问的不是最优,而是:
题 1(绿蛙跳格): 一只青蛙站在数轴的格 1 上,要跳到格
N(N ≤ 10⁶)。每一步它等概率地跳 1 格或 2 格;如果跳 2 格会越过 N,就视为直接到达。问从格 1 跳到格 N 的期望步数。
题 2(数字组合): 从
1, 2, ..., N中选出若干个互不相同的数(每个数要么选要么不选),使它们的和恰好等于K。问有多少种选法,答案对10⁹+7取模。N, K ≤ 1000。
这两道题都不能用前面的任何一种 DP 直接套:
- 题 1 没有「最优」——青蛙是随机跳的,你要求的是所有可能跳法的平均步数。这类题叫期望 DP。
- 题 2 不求最大也不求最小,求的是方案数——把每一个合法方案数一次,不多不少。这类题叫计数 DP。
再加上「求某个随机事件发生的概率」的概率 DP,就构成了本章的三位主角。它们与最优化 DP 共享同一套骨架——状态、转移、边界、计算顺序——但在三个关键处不同:
| 概率 DP | 期望 DP | 计数 DP | |
|---|---|---|---|
| 求什么 | 某事件的概率 | 随机变量的平均值 | 方案个数 |
| 转移用 | 概率乘法 / 加法 | 期望线性性 | 加法原理 / 乘法原理 |
| 推的方向 | 通常顺推(从初始状态出发) | 通常倒推(从终点往回) | 顺推,但必须不重不漏 |
记住本章最重要的一句话:概率是顺推、期望是倒推、计数是不重不漏。
6.7.1 概率 DP
两条运算法则
概率 DP 只用两条规则,都在高中课本里:
乘法规则(分步): 两件独立(或前后相继)的事同时发生,概率相乘。沿一条路径走到底,把每一步的概率乘起来。
加法规则(分类): 到达同一结果的若干互斥方式,概率相加。这正是全概率公式:
$$P(A) = \sum_i P(B_i)\cdot P(A \mid B_i)$$
翻译成 DP 语言:dp[状态] = Σ 转移概率 × dp[下一状态]。概率做权重,转移加起来。
例题:抛硬币直到连续 2 次正面
题目: 不断抛一枚均匀硬币,直到首次出现连续 2 次正面为止。求抛掷次数的期望。
这是概率 DP 的入门经典,我们先用它讲清「状态设计」,下一节再补全期望推导。
第一步:设计状态。 随机过程当前处于什么局面?只取决于「到目前为止,末尾已经连着几个正面」:
dp[k] = 已连出 k 次正面(0 ≤ k ≤ 2)时,距离目标还需要多少次期望
目标状态是 dp[2] = 0(已经连续 2 次正面,结束)。
第二步:列出转移。 站在状态 k,抛一次硬币:
- 以概率
1/2抛出正面 → 状态变为 k+1; - 以概率
1/2抛出反面 → 连续被打破,回到状态 0。
写成方程(注意这里有环:从状态 1 抛反面会回到 0,从 0 抛反面还是 0):
$$f_0 = \tfrac{1}{2}(1 + f_1) + \tfrac{1}{2}(1 + f_0)$
$$f_1 = \tfrac{1}{2}(1 + f_2) + \tfrac{1}{2}(1 + f_0), \qquad f_2 = 0$$
第三步:解方程。 含自身的项(自环)移到左边:
f_0 = 1 + (f_1 + f_0)/2→f_0 = f_1 + 2f_1 = 1 + (0 + f_0)/2→f_1 = f_0/2 + 1
代入解得 f₀ = 6, f₁ = 4。即平均需要抛 6 次才能首次连出 2 次正面。
通式(记住它): 首次连出 k 次正面所需的期望次数是
$$E_k = 2^{k+1} - 2$$
k=1 时是 2,k=2 时是 6,k=3 时是 14。验证程序:
#include <bits/stdc++.h>
using namespace std;
int main() {
int n; // n = 目标连出几次正面
cin >> n;
// dp[i]:从「连出 i 次正面」出发、到「连出 n 次」的期望步数(倒推)
// 通式 E_k = 2^(k+1) - 2,这里用递推验证
vector<double> f(n + 1, 0.0);
f[n] = 0.0; // 终点
// 从 n-1 倒着推:f[i] = 1 + 0.5*f[i+1] + 0.5*f[0],
// 含 f[0] 的环导致不能直接递推——但「首次连出 k 次」有通式,
// 用差分验证:E[i] - E[i-1] = 2^i
double ans = 0;
for (int k = 1; k <= n; k++) ans += pow(2.0, k);
cout << fixed << setprecision(6) << ans << "\n";
return 0;
}
输入:1
输出:2.000000
输入:2
输出:6.000000
输入:3
输出:14.000000
与手算 E_k = 2+4+...+2^k = 2^{k+1}-2 完全一致。
这个例子教给我们两件事:
- 状态设计的起点是「随机过程走到哪了」,而不是「我做了什么选择」。末尾连续正面数就是全部需要的信息。
- 转移里出现自环(回到自己)时,方程仍然可解——把含自身的项移项即可;只有当环结构复杂到「移项解不动」(比如二维网格上既有环又互相依赖)时才需要高斯消元,那超出了 NOIP 范围。
概率 DP 代码框架
// 顺推:从初始状态(概率 1)出发,向所有可达状态累加概率
dp[初始] = 1.0;
for (每个状态按依赖顺序) {
if (dp[状态] == 0) continue; // 不可达,跳过
for (每个转移,概率 p) {
dp[下一状态] += dp[状态] * p;
}
}
检查点: 每个状态所有转移概率之和必须等于 1(概率归一化)。忘了写某个分支,所有概率都会偏小。
6.7.2 期望 DP
最重要的工具:期望的线性性
$$E[X + Y] = E[X] + E[Y]$$
它无条件成立——X 和 Y 不需要独立! 这是最容易被低估的定理。它意味着:不管整个随机过程多复杂,「总花费的期望 = 每一步花费的期望之和」,哪怕每一步的花费之间高度相关。
正因为有线性性,期望 DP 才不需要算「每条完整路径的概率×花费」——那几乎总是算不动。我们只需要对每个状态问一句:「从这里出发,期望还要花多少?」然后把「这一步的花费(期望是常数,直接 +1 或 +w)」和「下一状态的期望(按概率加权)」加起来。
为什么期望要倒推
看转移方向。设 f[i] = 从格 i 出发到终点的期望花费。一步之内发生的事是确定的(花费已知),一步之后进入哪个状态是随机的:
$$f[i] = \underbrace{1}{这一步的期望花费} + \sum_j p{ij}, f[j]$$
f[i] 依赖于更靠近终点的状态 f[j]——所以必须从终点往回推:终点已知(花费 0),一层层往外算。这就是「期望是倒推」的原因:定义的是「还差多少」,终点是唯一已知数。
(反过来,若定义 g[i] = 从起点走到 i 的期望花费,从起点顺推——但顺推期望要求「到达 i 的路径结构」已知,多数题上行不通。竞赛里 90% 的期望 DP 都是倒推。)
完整实战一:绿蛙跳格
回到开篇的题 1。f[i] = 从格 i 出发跳到 N 的期望步数:
- 边界:
f[N] = 0(已在终点)。 - 转移:从格 i(
i < N)跳一步,1/2 到 i+1、1/2 到 i+2;跳 2 格越过 N 时视为到达(期望 0)。这一步本身花费 1 步:
$$f_i = \frac{f_{i+1} + f_{i+2}}{2} + 1, \qquad f_N = 0$$
其中 i = N-1 时 f[i+2] 越界,按「视为到达」取 0。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<double> f(n + 2, 0.0); // f[i]:从格 i 跳到 N 的期望步数
f[n] = 0.0; // 终点:不需要再跳
for (int i = n - 1; i >= 1; i--) {
double a = f[i + 1];
double b = (i + 2 <= n) ? f[i + 2] : 0.0; // 越过 N 视为到达
f[i] = (a + b) / 2.0 + 1.0;
}
cout << fixed << setprecision(6) << f[1] << "\n";
return 0;
}
手算核对(N = 4,必须会手算):
f[4] = 0 (终点)
f[3] = (f[4] + 0) / 2 + 1 = 1 (跳 2 格越过 4,视为到达)
f[2] = (f[3] + f[4]) / 2 + 1 = (1 + 0)/2 + 1 = 1.5
f[1] = (f[2] + f[3]) / 2 + 1 = (1.5 + 1)/2 + 1 = 2.25
输入:4
输出:2.250000
✓ 与程序一致。可以再直觉验证:每步平均前进 1.5 格,走 3 格约需 2 步——2.25 步听起来合理。
复杂度: O(N)。
完整实战二:树上期望路径长
期望 DP 上树的版本。题目:
给一棵
N个点的树(1为根),每条边有长度。从根出发,每到 internal 一个点,从它的所有儿子中等概率选一个往下走,直到走到叶子。求走过的路径总长度的期望。N ≤ 10⁵。
状态: f[u] = 从点 u 出发走到某个叶子的期望路径长。
边界: u 是叶子时 f[u] = 0。
转移: 设 u 有 k 个儿子,儿子 v 由边权 w 相连,则
$$f_u = \frac{1}{k}\sum_{v \in \text{sons}(u)} \bigl(w_{uv} + f_v\bigr)$$
这里期望线性性在悄悄工作:w + f[v] 表示「走这条边的花费 + 之后的花费」,两者不独立(走不走到 v 才有 f[v]),但期望照样相加。树天然无环,后序遍历(先算儿子)即可,不需要倒推循环。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<vector<pair<int,int>>> g(n + 1);
for (int i = 0; i < n - 1; i++) {
int u, v, w;
cin >> u >> v >> w;
g[u].push_back({v, w});
g[v].push_back({u, w});
}
vector<double> f(n + 1, 0.0);
vector<int> parent(n + 1, 0), order; // order:DFS 序,父在子前
vector<int> stk = {1};
vector<bool> vis(n + 1, false);
while (!stk.empty()) {
int u = stk.back(); stk.pop_back();
vis[u] = true;
order.push_back(u);
for (auto [v, w] : g[u]) if (!vis[v]) {
parent[v] = u;
stk.push_back(v);
}
}
// 逆序遍历 DFS 序 = 后序:儿子先于父亲
for (int idx = (int)order.size() - 1; idx >= 0; idx--) {
int u = order[idx];
vector<pair<int,int>> ch; // u 的儿子
for (auto [v, w] : g[u]) if (v != parent[u]) ch.push_back({v, w});
if (ch.empty()) { f[u] = 0.0; continue; } // 叶子
double s = 0.0;
for (auto [v, w] : ch) s += w + f[v];
f[u] = s / (double)ch.size();
}
cout << fixed << setprecision(6) << f[1] << "\n";
return 0;
}
手算核对:
输入:
5
1 2 1
1 3 4
3 4 2
3 5 1
输出:
3.250000
树:1 有儿子 {2, 3};3 有儿子 {4, 5}。f[4]=f[5]=f[2]=0(叶子);f[3] = (2+1)/2 = 1.5;f[1] = (1 + 0 + 4 + 1.5)/2 = 6.5/2 = 3.25。✓
输入:
3
1 2 1
1 3 5
输出:
3.000000
f[1] = (1 + 5)/2 = 3。✓
复杂度: O(N)。
6.7.3 计数 DP
与最优化 DP 的一个本质区别
最优化 DP 里,dp[i] = max(dp[j1], dp[j2], ...)——两个候选来自同一个更小子问题时,取 max 不会重复计数。计数 DP 里,dp[i] = dp[j1] + dp[j2] + ...——如果 j1 和 j2 对应的方案集合有重叠,同一个方案会被数两次。
所以计数 DP 的铁律:分类必须不重不漏。 每个转移分支对应一组方案,这些组两两无交,且并起来恰好是全部方案。加法原理的「互斥」前提,就是「不重不漏」。
转移中的加法原理与乘法原理
- 加法原理(同一个状态的多条入边): 把方案按「最后一步怎么走」分类,各类方案数相加 → 转移求和;
- 乘法原理(一条路径上的独立选择): 方案数 = 各阶段选择数的乘积 → DP 里通常体现为「初始化 dp[0] = 1」(空方案,一个什么都不选的方案)以及「组合数 = 两个独立 DP 结果相乘」的合并。
完整实战一:数字组合(01 背包型计数)
回到开篇的题 2。这其实就是 6.2 章 0/1 背包的计数版:物品是 1..N,每件「重量」等于面值,每个容积恰好装满的方案数。
状态: f[j] = 从已考虑的数中选若干个、和恰好为 j 的方案数。
转移(逐个数 x = 1..N 考虑,0/1 背包倒序):
$$f[j] \mathrel{+}= f[j - x] \quad (\text{对每个 } x,\ j \text{ 从 } K \text{ 倒序到 } x)$$
为什么倒序?正序时 f[j-x] 可能已经包含「选了 x」的方案,同一个方案(x 被选两次)会被重复计数——这正是 6.1 章背包容量的老朋友。计数 DP 里背包循环方向错误的表现不是 WA 在最优值,而是方案数凭空变多。
初始化: f[0] = 1(空集,和为 0,恰好一个方案)。这是计数 DP 最重要的初始化,忘了它全部输出 0。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, k;
long long MOD;
cin >> n >> k >> MOD;
vector<long long> f(k + 1, 0);
f[0] = 1; // 空方案
for (int x = 1; x <= n; x++)
for (int j = k; j >= x; j--) // 0/1 背包:倒序防重复
f[j] = (f[j] + f[j - x]) % MOD;
cout << f[k] << "\n";
return 0;
}
手算核对:
输入:4 4 1000000007
输出:2
从 {1,2,3,4} 中选数凑和为 4:{4} 和 {1,3}——共 2 种。✓
输入:4 6 1000000007
输出:2
凑和为 6:{2,4} 和 {1,2,3}——共 2 种。✓
复杂度: O(N·K)。
完整实战二:错排(上楼梯变体)
题目: 有 n 个人排队领 n 份不同的礼物,每人领一份。要求没有人拿到自己的那一份(第 i 人不拿礼物 i)。求方案数,对 MOD 取模。
n ≤ 10⁶。
「错排」是计数 DP 的经典模型——它不能像背包那样直接「最后一步分类」,因为约束(每人不拿自己的)把方案互相缠在一起。推导如下:
考虑第 1 个人(拿礼物 1 的人)。他必须拿别人的礼物,设他拿了礼物 i(i ≠ 1,有 n-1 种)。现在看礼物 1 归谁,按两种情况分类——这个分类不重不漏:
- 情况 A:第 i 个人拿礼物 1。 1 和 i 互换,剩下
n-2个人和n-2份礼物构成同样的错排问题:D(n-2)种; - 情况 B:第 i 个人不拿礼物 1。 把「第 i 个人不能拿礼物 1」看成「礼物 1 是他的『自己的礼物』」,剩下
n-1个人构成错排:D(n-1)种。
$$D_n = (n-1),\bigl(D_{n-1} + D_{n-2}\bigr), \qquad D_0 = 1,\ D_1 = 0$$
这个推导值得反复回味:先固定一个「关键人物」的选择做乘法,再按剩余局面的形态做不重不漏的分类——这是很多计数题的标准套路。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
long long MOD;
cin >> n >> MOD;
vector<long long> f(n + 1);
f[0] = 1; f[1] = 0;
for (int i = 2; i <= n; i++)
f[i] = ((long long)(i - 1) * ((f[i-1] + f[i-2]) % MOD)) % MOD;
cout << f[n] << "\n";
return 0;
}
手算核对:
输入:3 1000000007
输出:2
3 个人的错排:2 3 1 和 3 1 2——共 2 种。✓(D_3 = 2·(D_2+D_1) = 2·(1+0) = 2)
输入:4 1000000
输出:9
D_4 = 3·(D_3+D_2) = 3·(2+1) = 9。✓(顺带展示了取模:9 < 10⁶ 没影响,但大规模数据必须每步取模。)
复杂度: O(N)。
不重不漏怎么检查?
写完转移后,问自己三个问题:
- 每个方案走到哪个分支?(漏:某方案不属于任何分支)
- 一个方案会不会走两个分支?(重:分支之间有交)
- 分支里的子问题是否和原问题同型?(不等型的「子问题」会让答案错得很安静)
最实用的手段:写一个 O(2ⁿ) 的暴力枚举程序,小数据对拍。计数题的 bug 几乎总是「重」——输出比暴力大——对拍一跑就现形。
6.7.4 完整实战:换教室(简化版,NOIP2016 风格)
现在把期望 DP 用在一道带决策的题上——期望与最优化的混合体,NOIP2016 换教室的简化版:
题目: 牛牛要上
n个时间段的课。第 i 节课在教室c[i],牛牛可以申请换到教室d[i],申请成功的概率是p[i];他最多能申请m节课。上完第 i 节课要走到第 i+1 节课的教室(第 1 节课之前不用移动)。教室共v间,走廊长度已知(无向图)。合理选择申请哪几节课,使移动总路程的期望最小。n, m ≤ 2000,v ≤ 300,边长 ≤ 100, Floyd 后转移 O(1)。
第一步:预处理。 牛牛每一步从「上一节课的两个可能教室之一」走到「这一节课的两个可能教室之一」,需要任意两点间最短路。v ≤ 300——直接 Floyd,O(v³) = 2.7×10⁷。
第二步:状态。 移动是一节一节发生的,每节的起点/终点各有两种可能,概率由「是否申请」决定。定义
f[i][j][0/1] = 上完前 i 节课、其中申请了 j 节、
第 i 节课没申请(0)/申请了(1) 时,已花费的期望路程
注意两个细节:
- 申请了 ≠ 成功——第 i 节申请后教室是
d[i]的概率p[i]、是c[i]的概率1-p[i],期望路程要按概率加权; - 答案是
min over j ≤ m of min(f[n][j][0], f[n][j][1])——申请次数是预算,不多于 m。
第三步:转移(核心:把「上一节的随机教室」和「这一节的随机教室」两个不确定性都展开)。
从第 i-1 节走到第 i 节,起点有 {c[i-1], d[i-1]} 两种(若上一节申请了),终点有 {c[i], d[i]} 两种(若这一节申请了)。四种组合,每种组合的概率 = 两个边缘概率相乘(申请是否成功互相独立),期望路程 = Σ 概率 × 最短路长。
以「第 i-1 节申请、第 i 节不申请」为例:
$$f_{i,j,0} \leftarrow f_{i-1,j,1} + p_{i-1}, w_{d_{i-1},,c_i} + (1-p_{i-1}), w_{c_{i-1},,c_i}$$
「两节都申请」的分支要展开成四项:
$$f_{i-1,j-1,1} + p_{i-1}p_i, w_{d_{i-1},d_i} + p_{i-1}(1-p_i), w_{d_{i-1},c_i} + (1-p_{i-1})p_i, w_{c_{i-1},d_i} + (1-p_{i-1})(1-p_i), w_{c_{i-1},c_i}$$
每个 f[i][j][*] 取所有合法前驱的最小值。初始化: f[1][0][0] = f[1][1][1] = 0(第 1 节课前没有移动),其余为 +∞。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, m, v;
cin >> n >> m >> v;
vector<int> c(n + 1), d(n + 1);
vector<double> p(n + 1);
for (int i = 1; i <= n; i++) cin >> c[i] >> d[i] >> p[i];
const double INF = 1e18;
vector<vector<double>> w(v + 1, vector<double>(v + 1, INF));
for (int i = 1; i <= v; i++) w[i][i] = 0;
int e;
cin >> e;
for (int i = 0; i < e; i++) {
int a, b, len;
cin >> a >> b >> len;
w[a][b] = w[b][a] = min(w[a][b], (double)len);
}
for (int k = 1; k <= v; k++) // Floyd
for (int i = 1; i <= v; i++)
for (int j = 1; j <= v; j++)
if (w[i][k] + w[k][j] < w[i][j]) w[i][j] = w[i][k] + w[k][j];
vector<vector<array<double,2>>> f(
n + 1, vector<array<double,2>>(m + 1, {INF, INF}));
f[1][0][0] = 0.0;
f[1][1][1] = 0.0; // 第 1 节申请也行
for (int i = 2; i <= n; i++) {
for (int j = 0; j <= min(m, i); j++) {
// 第 i 节不申请
double best0 = INF;
if (f[i-1][j][0] < INF)
best0 = min(best0, f[i-1][j][0] + w[c[i-1]][c[i]]);
if (f[i-1][j][1] < INF)
best0 = min(best0, f[i-1][j][1]
+ p[i-1] * w[d[i-1]][c[i]]
+ (1 - p[i-1]) * w[c[i-1]][c[i]]);
f[i][j][0] = best0;
// 第 i 节申请
if (j >= 1) {
double best1 = INF;
if (f[i-1][j-1][0] < INF)
best1 = min(best1, f[i-1][j-1][0]
+ p[i] * w[c[i-1]][d[i]]
+ (1 - p[i]) * w[c[i-1]][c[i]]);
if (f[i-1][j-1][1] < INF)
best1 = min(best1, f[i-1][j-1][1]
+ p[i-1] * p[i] * w[d[i-1]][d[i]]
+ p[i-1] * (1 - p[i]) * w[d[i-1]][c[i]]
+ (1 - p[i-1]) * p[i] * w[c[i-1]][d[i]]
+ (1 - p[i-1]) * (1 - p[i]) * w[c[i-1]][c[i]]);
f[i][j][1] = best1;
}
}
}
double ans = INF;
for (int j = 0; j <= m; j++)
ans = min(ans, min(f[n][j][0], f[n][j][1]));
cout << fixed << setprecision(2) << ans << "\n";
return 0;
}
手算核对(三个小样例):
输入:
2 1 2
1 2 1.0
2 1 1.0
1
1 2 10
输出:0.00
两节课、可申请 1 节。第 1 节申请(p=1,必成功)→ 在教室 2;第 2 节申请(p=1)→ 在教室 1。从教室 2 走到教室 1 距离 10?不对——仔细看:申请第 1 节(到 2)和第 2 节(到 1),路程 w[2][1] = 10;但如果都不申请:教室 1 → 教室 2,也是 10;申请第 1 节、不申请第 2 节:2 → 2,路程 0!所以最优是期望 0。✓ 程序输出 0.00。
输入:
3 1 3
1 1 0.0
2 3 0.5
3 1 1.0
3
1 2 1
2 3 1
1 3 10
输出:2.00
教室 1–2 距离 1,2–3 距离 1,1–3 距离 10。三节课固定教室序列 1, 2, 3:不申请时路程 1 + 1 = 2。唯一的申请机会用在第 2 节(p=0.5 换到 3):w[2][3] + 0.5·w[3][3] + 0.5·w[3][3] = 1 + 0,第 1→2 段仍是 1,总期望还是 2;用在别处更差(比如第 3 节换到 1:1 + 0.5·w[2][1] + 0.5·w[2][3] = 1 + 0.5 + 0.5 = 2)。最优 2.00。✓
输入:
3 1 3
1 1 0.0
2 3 0.5
3 1 1.0
3
1 2 1
2 3 1
1 3 1.5
输出:1.50
这个样例把「申请第 2 节」的价值展示得最充分。教室 1–2 距离 1,2–3 距离 1,1–3 距离 1(这条「抄近道」的边是本题的关键)。三节课的固定教室序列仍是 1, 2, 3。逐个方案算期望:
- 都不申请:
w[1][2] + w[2][3] = 1 + 1 = 2; - 申请第 3 节(p=1,必到教室 1):第 2→3 段变成
w[2][1] = 1,总1 + 1 = 2; - 申请第 2 节(p=0.5,教室随机为 3 或 2):
- 第 1→2 段:起点确定是教室 1,终点随机(3 或 2,各 0.5):
0.5·w[1][3] + 0.5·w[1][2] = 0.5×1 + 0.5×1 = 1; - 第 2→3 段:起点随机(3 或 2,各 0.5),终点确定是教室 3:
0.5·w[3][3] + 0.5·w[2][3] = 0 + 0.5 = 0.5; - 总期望
1 + 0.5 = 1.5。✓
- 第 1→2 段:起点确定是教室 1,终点随机(3 或 2,各 0.5):
注意一个容易犯的手算错误: 算第 1→2 段的期望时,只有「这一段涉及的那节课」的申请才有随机性——第 2 节申请影响的是第 1→2 段的终点和第 2→3 段的起点,两段各算各的,然后按期望线性性相加(两段路程显然不独立,但线性性不要求独立)。若把第 1→2 段的终点错误地当成确定值、或把随机性算串了段,就会得到错误的期望。用 w[1][3] = 1.5 的图(其他条件相同)重算本例答案是 1.75(第 1→2 段期望变成 1.25)——你可以在纸上推一遍,体会边长对期望的影响。
复杂度: Floyd O(v³) + DP O(n·m) 转移 O(1)。
这道题的通用模式: 「期望 + 最优决策」的题,状态里除了描述随机性的维度,还要加「预算/已用决策」维度(本题的 j),转移时对每个决策取 min、对每个随机结果按概率加权求和。期望 DP 和普通 DP 在这里合流。
⚠️ 概率期望与计数 DP 常见错误
展开——竞赛前必读
期望 DP 陷阱:
- ❌ 倒推方向搞反:把
f[i] = 1 + Σp·f[i+1](正确,f 是「还差多少」)写成f[i]依赖f[i-1]的顺推形式——初始化了终点却顺着算,全表错。口诀:答案在起点(f[1]),已知在终点(f[N]=0),从已知往答案推 - ❌ 忘加「+1」(这一步的代价):期望方程里当前这一步的花费是常数项,漏写后所有值系统性偏小
- ❌ 期望线性性用在「概率加权」上:
E[X·Y] ≠ E[X]·E[Y](X、Y 不独立时)!线性性只保加法E[X+Y];乘积的期望必须按「所有组合的概率×乘积」展开(换教室的四项展开就是这么来的) - ❌ 自环方程忘了移项:
f = p·f + ...直接当递推写会死循环或漏解,先解出f = .../(1-p) - ❌ 精度:概率极小/路径极长时 double 相加顺序影响精度,能用 long long 计数就别用 double
概率 DP 陷阱:
- ❌ 概率没归一化:某个转移分支忘写(比如「袋子空了算龙赢」这种边界分支),所有概率之和 < 1,答案整体偏小。写完检查:每个状态的所有转移概率相加必须等于 1
- ❌ 用整数存概率再想最后除——中间溢出或精度丢失,概率全程用 double
计数 DP 陷阱:
- ❌ 忘取模:
f[j] + f[j-x]两个都 < MOD,但相加可以到 2·MOD,下一步再乘i-1就溢出 long long——每次加完/乘完立刻取模 - ❌ 忘初始化
f[0] = 1:空方案是一个方案。少了它,所有状态都是 0 - ❌ 分类重叠:两个转移分支对应同一方案(典型:0/1 背包正序导致同一物品选两次)——计数题必须用暴力对拍
- ❌ 输出前忘了答案可能需要特判(n=0、k=0 等边界方案数)
本章总结
📌 三类 DP 对照表
| 概率 DP | 期望 DP | 计数 DP | |
|---|---|---|---|
| 状态含义 | 处于某局面的概率 | 从某状态到终点的期望花费 | 构成某子结构的方案数 |
| 推的方向 | 顺推(从初始概率 1 出发) | 倒推(从终点 f=0 往回) | 顺推(从小子问题到大) |
| 转移核心 | 全概率:Σ p × 后继概率 | 线性性:1 + Σ p × 后继期望 | 加法/乘法原理:Σ 分支方案数 |
| 初始化 | dp[初始] = 1 | dp[终点] = 0 | dp[空] = 1 |
| 最大陷阱 | 转移概率之和 ≠ 1 | 方向搞反 / 忘 +1 / 乘积瞎用线性性 | 分类重漏 / 忘取模 |
| 检查手段 | 概率归一化;特例手算 | 小样例手算(终点倒着填表) | O(2ⁿ) 暴力对拍 |
🧩 核心方程速查
// 概率 DP(顺推)
dp[初始] = 1.0;
dp[下一状态] += dp[当前] * p;
// 期望 DP(倒推)
f[终点] = 0;
f[i] = 1 + Σ p_j * f[j]; // 自环先移项解出 f[i]
// 计数 DP(0/1 背包型,倒序防重)
f[0] = 1;
for (每个物品 x)
for (j = K; j >= x; j--)
f[j] = (f[j] + f[j-x]) % MOD;
// 错排
D[0] = 1; D[1] = 0;
D[i] = (i-1) * (D[i-1] + D[i-2]) % MOD;
❓ 常见问题
Q1:期望 DP 什么时候不能倒推?
A:当状态之间有环且移项解不动时(如机器人网格上可左右移动,
f[i][j]依赖同行左右两格),需要高斯消元解方程组,复杂度 O(m³) 每行。NOIP/USACO Silver-Gold 层面掌握「无环倒推」即可,遇到有环先尝试移项。
Q2:为什么期望的题几乎总问「期望步数/花费」而不是「期望概率」?
A:因为「步数、花费」天然可加,能吃期望线性性的红利——每一步贡献独立可算。问「最终落在某个格子的概率」时,你要做的其实是概率 DP(顺推转移概率)。
Q3:计数 DP 的答案为什么经常大得离谱?
A:方案数随规模指数增长(错排 D(n) ≈ n!/e),
n = 1000时位数超过 long long。所以计数题几乎全部要求对某个 MOD 取模,且每一步运算后立即取模,不能只在最后取。
练习题
题目 6.7.1 — 概率 DP:袋中老鼠(Codeforces 148D Bag of mice) 🟡 中等
袋子里有 w 只白鼠和 b 只黑鼠。公主和龙轮流抓老鼠,公主先抓。谁先抓到白鼠谁赢;袋子空了且没出现白鼠则龙赢。公主每次抓一只;龙每次抓完一只后还会吓跑一只随机老鼠。求公主赢的概率。w, b ≤ 1000。
提示
`f[i][j]` = 轮到公主时袋中有 i 白 j 黑、公主获胜的概率。边界:`f[0][j] = 0`(无白鼠)、`f[i][0] = 1`。转移分四类:公主抓到白(直接赢);公主黑、龙白(直接输);公主黑、龙黑、跑黑 → `f[i][j-3]`;公主黑、龙黑、跑白 → `f[i-1][j-2]`。后两类要检查数量合法(≥3 黑 / ≥1 白 2 黑)。四类概率之和恰为 1——正好用「归一化」自检。#include <bits/stdc++.h>
using namespace std;
int main() {
int w, b;
cin >> w >> b;
// f[i][j]:轮到公主、袋中 i 白 j 黑时公主的获胜概率
vector<vector<double>> f(w + 1, vector<double>(b + 1, 0.0));
for (int i = 1; i <= w; i++) f[i][0] = 1.0; // 一抓就是白鼠
for (int i = 1; i <= w; i++)
for (int j = 1; j <= b; j++) {
double p = 0.0;
// 公主抓到白鼠:直接赢
p += (double)i / (i + j);
// 公主黑、龙黑、跑出黑鼠:递归到 (i, j-3)
if (j >= 3)
p += (double)j / (i + j) * (j - 1) / (i + j - 1)
* (j - 2) / (i + j - 2) * f[i][j-3];
// 公主黑、龙黑、跑出白鼠:递归到 (i-1, j-2)
if (j >= 2 && i >= 1)
p += (double)j / (i + j) * (j - 1) / (i + j - 1)
* (double)i / (i + j - 2) * f[i-1][j-2];
// 公主黑、龙白:公主输,不加项
f[i][j] = p;
}
cout << fixed << setprecision(9) << f[w][b] << "\n";
return 0;
}
手算核对: w=1, b=1:公主 1/2 直接赢;1/2 抓黑后龙只剩白鼠必赢 → 概率 0.5。w=1, b=2:公主 1/3 赢;公主黑(2/3)后龙必抓走白鼠或黑鼠——龙抓白(1/2)龙赢,龙抓黑(1/2)后跑出的必是白鼠,袋空龙赢——所以概率 1/3 ≈ 0.333。运行验证:输入 1 1 输出 0.500000000,输入 1 2 输出 0.333333333。✓
题目 6.7.2 — 期望 DP:收集邮票(简化版) 🟡 中等
有 n 种邮票,每次花 1 元随机(等概率)买到一张(可能重复)。求集齐所有 n 种的期望花费。n ≤ 1000。(原版 P4550 花费是递增的第 k 张花 k 元,这里简化为每张 1 元。)
提示
倒推:`f[i]` = 已有 i 种、还差多少张(期望)。`f[n] = 0`,`f[i] = 1 + (i/n)·f[i] + ((n-i)/n)·f[i+1]`,移项解出 `f[i]`。期望花费即 `f[0]`(每张 1 元)。递增版需要「第 k 张花 k 元」拆成「已买张数的期望」的第二个数组,是经典进阶。#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<double> f(n + 1, 0.0);
for (int i = n - 1; i >= 0; i--) {
double pNew = (double)(n - i) / n; // 买到新种类
double pOld = (double)i / n; // 买到已有的
// f[i] = 1 + pOld*f[i] + pNew*f[i+1],自环移项:
f[i] = (1.0 + pNew * f[i + 1]) / (1.0 - pOld);
}
cout << fixed << setprecision(6) << f[0] << "\n";
return 0;
}
手算核对: n=1:第一次必中,期望 1。n=2:f[1] = (1 + 0.5·0)/0.5 = 2,f[0] = (1 + 1·f[1])/1 = 3——先买到第一种(1 张),再等第二种(几何分布期望 2 张),共 3 张。✓(这也是自环移项的标准示范。)
题目 6.7.3 — 期望 DP + 手算训练:换教室填表(本章 6.7.4 第三个样例) 🟢 简单
对 6.7.4 的第三个样例,写出 f[i][j][0/1] 的完整填表过程(f[2][1][1] = 1.0、f[3][1][0] = 1.5 等),再修改一条边长(如把 1 3 1 改成 1 3 1.5)重新填表,验证答案是 1.75。输入格式见 6.7.4 代码。
提示
真正要看的是**每一段的期望路程都能独立计算**:第 i−1→i 段的期望只依赖两节课各自的申请决定。把每段在「双不申 / 前申 / 后申 / 双申」四种组合下的期望列成表,再在总预算 m=1 下挑选。注意 `f[1][1][1] = 0` 是合法起点(第 1 节申请、p₁=0 必失败,仍从教室 1 出发)——但它会花掉一次申请机会,未必最优。两段路程不独立,但期望线性性不要求独立——这正是本题每段分开算再相加的依据。💡 下一步: 概率期望 DP 是数论与概率论的交汇点,计数 DP 则是组合数学在程序里的化身。第七部分图论中你会在随机游走、最小斯坦纳树等话题里再次遇到「按概率加权」的转移;而计数 DP 的思想将在字符串部分的哈希与 SAM 统计中反复出现。把「不重不漏」四个字刻进肌肉记忆。
🏆 第七部分:USACO 竞赛指南
不只讲算法,更讲如何在真实竞赛中把已有知识转化为分数:读题、选题、估复杂度、拿部分分、调试、复盘与长期训练。
📚 3 章 · ⏱️ 随时可读 · 🎯 目标:从第一次参赛稳步走向 Bronze → Silver → Gold
第七部分:USACO 竞赛指南
随时可读——不要求你已经学完本书全部算法。
USACO 与普通刷题最大的区别是:你不是在无限时间里追求一道题的完美题解,而是在 4 小时内对 3 道题做最优资源分配。因此,真正的能力不只是“会不会某个算法”,还包括:
- 读题能力:能从故事中抽出精确模型。
- 复杂度判断:能根据约束快速排除不可能的做法。
- 策略性得分:不会满分时也能拿到小数据或特殊性质分。
- 稳定实现:少犯越界、溢出、输入输出格式错误。
- 复盘训练:把每场比赛变成下一次晋级的素材。
本部分把你带入 USACO 选手的思维方式:先理解比赛,再建立赛时流程,最后专门攻克最容易让 Bronze/Silver 选手卡住的 Ad Hoc 题型。
本部分如何学习
建议按下面顺序阅读:
| 阶段 | 阅读章节 | 你应该带走什么 |
|---|---|---|
| 第一次了解 USACO | 第 7.1 章:了解 USACO | 赛制、分级、评分、部分分、常见错误 |
| 准备正式参赛 | 第 7.2 章:解题策略 | 读题流程、算法识别、调试、对拍、训练计划 |
| 想突破 Bronze/Silver 难题 | 第 7.3 章:Ad Hoc 题型 | 小例子、规律、不变量、构造、模拟捷径 |
如果你只剩几天就要比赛,优先读:
- 第 7.1 章的 时间管理与部分分策略。
- 第 7.2 章的 竞赛解题流程与提交前清单。
- 第 7.3 章的 Ad Hoc 检查清单。
第 7.1 章:了解 USACO
这一章回答“比赛到底怎么玩”。你会学到:
- USACO 四个级别:Bronze、Silver、Gold、Platinum 各自考什么。
- 比赛结构:每场 3 题、通常 4 小时,US Open 通常更长更难。
- 评分机制:通过测试点得分,满分不是唯一目标。
- 部分分策略:小数据暴力、特殊情况、退化版本都可能有价值。
- 赛时节奏:什么时候读题,什么时候写代码,什么时候停止冒险。
- 常见失误:越界、溢出、差一、未初始化、输出格式错误。
教练视角: Bronze 到 Silver 的晋级并不要求你每道题都一眼看穿。更现实的目标是:至少稳定拿下一道题,第二道题尽量满分或高分,第三道题争取部分分。
第 7.2 章:解题策略
这一章回答“面对新题我该怎么想”。核心不是背模板,而是建立一套稳定流程:
- 先读约束,再猜复杂度:N 决定你能不能暴力。
- 先写模型,再写代码:输入是什么,状态是什么,答案是什么。
- 用小例子验证理解:样例之外自己造 N=1、N=2、全相同、极端值。
- 不会最优先写暴力:暴力既能拿部分分,也能作为对拍基准。
- 调试要有方法:
cerr、assert、编译警告、地址消毒器、对拍。 - 赛后必须复盘:记录关键洞察,而不是只记录 AC 与否。
这一章还会给出从 Bronze 迈向 Silver 的能力清单:前缀和、排序、二分、BFS/DFS、DSU、基础 DP、STL 容器与复杂度判断。
第 7.3 章:Ad Hoc 题型
Ad Hoc 题没有固定模板,常见于 Bronze,也会在 Silver 中作为“观察题”出现。你会学习如何从看似混乱的题目中找出关键性质:
- 小例子找规律:N=1、2、3、4 往往暴露结构。
- 不变量:奇偶性、总和模 K、逆序对奇偶性、颜色差。
- 构造思维:不是搜索所有答案,而是直接构造一个合法答案。
- 模拟捷径:状态有限则找循环,大 T 用取模跳过。
- 重新表述:把故事题改写成区间、图、排列、计数或几何问题。
教练视角: Ad Hoc 的训练重点不是“记住答案”,而是每题结束后问:我为什么没看到这个性质?下次怎样更早想到?
竞赛三阶段清单
赛前一周
- 从头重写 3–5 个常用模板:快速 I/O、排序、BFS、DFS、DSU、前缀和。
- 复做以前错过的 5–10 道题,重点练速度和稳定性。
-
准备本地编译命令,例如
g++ -std=c++17 -O2 -Wall -Wextra sol.cpp -o sol。 - 熟悉 USACO 提交界面、输入输出形式和题面阅读方式。
- 睡眠正常;不要在赛前最后一天硬学大量新算法。
比赛中
- 先快速浏览全部 3 道题,不要马上扎进第一题。
- 标出每题的 N、值域、时间限制和特殊条件。
- 从最有把握的题开始,先拿稳定分。
- 卡住 30–40 分钟没有进展时,切换题目或写部分分。
- 提交前检查样例、边界、溢出、数组大小、输出格式。
- 最后 30 分钟以测试和修 bug 为主,不轻易重写大段代码。
赛后复盘
- 每题写一句“关键洞察”。
- 记录卡住原因:读错题、复杂度错、算法不会、实现 bug、心态问题。
- 看题解后重新独立实现,不复制代码。
- 一周后再复做一次错题,检验是否真正掌握。
USACO 训练路线图
| 当前状态 | 训练重点 | 推荐目标 |
|---|---|---|
| 刚会 C++ | 输入输出、循环、数组、字符串、函数 | 能独立完成简单模拟题 |
| Bronze 初期 | 暴力、模拟、排序、计数、网格、简单几何 | 30–60 分钟完成 Bronze 简单题 |
| Bronze 冲 Silver | 前缀和、二分、BFS/DFS、贪心观察、Ad Hoc | 一场比赛稳定 700+ |
| Silver 初期 | 图论、DSU、双指针、基础 DP、复杂度优化 | 能看懂并实现 Silver 题解 |
| Silver 冲 Gold | Dijkstra、树、线段树、更多 DP、证明能力 | 能在赛中识别题型并稳定实现 |
本部分的核心原则
- 先求理解,再求代码:没理解题意时写代码只会制造 bug。
- 先求可得分,再求满分:竞赛不是作业,部分分很重要。
- 先证复杂度,再开始实现:错误复杂度的代码写得再漂亮也会超时。
- 先写简单正确,再优化:暴力解常常是最好的调试工具。
- 先复盘错误,再刷下一题:不复盘的刷题很容易原地打转。
🐄 最后提醒: USACO 是一项长期训练。一次比赛没晋级并不说明你不适合算法;它只是在告诉你下一阶段最该补哪块能力。把每次卡住都转化为具体训练项,你就会稳步变强。
第 7.1 章:了解 USACO
如果你第一次参加 USACO,最重要的不是马上学习高级算法,而是先弄清楚这场比赛如何给分、如何晋级、如何安排时间、如何避免低级失误。
很多同学明明会写代码,却在第一次比赛中因为以下原因丢分:
- 只读了第一题,没有比较三题难度。
- 看到不会的题就放弃,没有写小数据部分分。
- 算法复杂度估错,写了必定超时的 O(N²)。
- 样例过了就提交,没有测边界情况。
- 用
int存了会超过 (2^{31}-1) 的答案。
本章会从零讲清 USACO 的规则,并站在教练角度告诉你:怎样把 4 小时变成尽可能多的分数。
7.1.1 USACO 是什么
USACO(USA Computing Olympiad,美国计算机奥林匹克竞赛)是面向中学生的算法竞赛体系,也是美国选拔 IOI(国际信息学奥林匹克竞赛)选手的重要渠道。
对普通参赛者来说,你可以把 USACO 理解为:
- 一套免费、在线、长期开放的算法竞赛。
- 一条从基础编程到高水平算法的分级路线。
- 一个非常适合训练 C++、数据结构、图论、动态规划和竞赛思维的平台。
USACO 的特点
| 特点 | 含义 |
|---|---|
| 免费开放 | 不限国籍,注册账号即可参加公开比赛 |
| 在线参赛 | 在比赛窗口内任选连续 4 小时开始比赛 |
| 自动评测 | 提交代码后由隐藏测试点评分 |
| 分级晋升 | 从 Bronze 开始,达到晋级线后进入下一等级 |
| 重视综合能力 | 算法、实现、读题、调试、时间管理都重要 |
教练提醒: USACO 不是“只要知道算法就能赢”的比赛。许多 Bronze/Silver 题真正考的是建模、细节和稳定性。
7.1.2 比赛形式
比赛日程
USACO 每个赛季通常有 4 场比赛:
- December Contest:12 月赛。
- January Contest:1 月赛。
- February Contest:2 月赛。
- US Open:通常在 3/4 月,时间更长,难度也常常更高。
下图展示了一个典型赛季的节奏:

比赛时长与题数
| 项目 | 通常情况 |
|---|---|
| 每场题数 | 3 道题 |
| 普通月赛时长 | 4 小时 |
| US Open 时长 | 通常 5 小时 |
| 提交次数 | 一般不限制,以最后有效提交为准 |
| 评分方式 | 隐藏测试点,通过多少测试点得多少分 |
比赛通常在一个多天窗口内开放。你可以在窗口内选择一个合适时间开始,但一旦开始,计时就连续进行。
输入输出形式
USACO 早期题目常使用文件输入输出,例如从 problem.in 读入,输出到 problem.out。较新的题目更多使用标准输入输出。
一定以题面说明为准。
文件 I/O 模板如下:
#include <bits/stdc++.h>
using namespace std;
int main() {
freopen("problem.in", "r", stdin);
freopen("problem.out", "w", stdout);
ios::sync_with_stdio(false);
cin.tie(nullptr);
// solution code
return 0;
}
标准 I/O 模板如下:
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
// solution code
return 0;
}
7.1.3 四个级别
USACO 有四个主要级别:

Bronze:基础编程与细节
Bronze 适合刚开始算法竞赛的同学。它主要考:
- 循环、数组、字符串、结构体。
- 模拟、枚举、计数、排序。
- 简单几何、网格、区间处理。
- Ad Hoc 观察题。
Bronze 的难点常常不是算法高级,而是:
- 能否读懂题目真正要求。
- 能否不漏情况地实现模拟。
- 能否根据数据范围写出够快的暴力。
典型复杂度: O(N)、O(N log N)、O(N²)、有时 O(N³)。
Silver:标准算法入门
Silver 开始大量出现标准算法:
- 排序 + 扫描。
- 前缀和、差分。
- 二分查找、二分答案。
- BFS、DFS、连通块。
- 并查集(DSU)。
- 双指针、滑动窗口。
- 基础动态规划。
Silver 的核心变化是:N 经常达到 (10^5),这意味着你不能再随便写 O(N²)。
典型复杂度: O(N)、O(N log N)、O(N + M)。
Gold:算法组合与证明能力
Gold 对算法熟练度和证明能力要求明显提高。常见主题包括:
- Dijkstra、最小生成树、拓扑排序。
- 树形 DP、LCA、欧拉序。
- 线段树、树状数组。
- 更复杂的 DP。
- 数学、组合计数、状态设计。
Gold 题往往不只问“会不会模板”,而是要求你把多个思想组合起来。
Platinum:高阶竞赛水平
Platinum 是 USACO 的最高公开级别,题目接近高水平竞赛难度,可能涉及:
- 高级数据结构。
- 复杂图论。
- 高阶动态规划。
- 组合数学与构造。
- 需要较强证明能力的原创题。
7.1.4 晋级与评分
基本评分方式
每道题由多个隐藏测试点组成。通过一个测试点就得到相应分数,没通过则不得该测试点分数。
| 项目 | 说明 |
|---|---|
| 每场总分 | 通常约 1000 分 |
| 每题分值 | 通常约 333 分,但具体取决于测试点 |
| 晋级线 | 常见为 750 左右,但每场可能变化 |
| 是否必须满分 | 不必须,部分分很重要 |
为什么部分分很重要
很多选手的错误心态是:
“我不会完整解法,所以这题没法做。”
这是不对的。USACO 很多题会包含小数据测试点或特殊结构测试点。例如:
- 完整数据 N ≤ 100000,但部分分 N ≤ 1000。
- 完整图是一般图,但部分分图是一条链或一棵树。
- 完整值域很大,但部分分值域很小。
- 完整要求最优解,但部分分允许暴力枚举。
如果你能在一题上拿 100%,另一题拿 80%,第三题拿 30%,总分就可能非常接近晋级线。
部分分策略
| 情况 | 可尝试做法 |
|---|---|
| N 很小的子任务 | 写暴力、枚举、回溯、全排列、子集搜索 |
| 输入有特殊结构 | 单独处理链、树、全相等、已排序、无重复等情况 |
| 不会优化 | 先写 O(N²) 或 O(N³),至少通过小测试点 |
| 不确定公式 | 用小例子验证后提交,再继续寻找反例 |
| 时间快结束 | 提交稳定可运行的部分解,不要空着 |
教练提醒: 错误答案通常没有额外罚分。只要代码能编译运行,部分解就值得提交。
7.1.5 用约束判断算法复杂度
USACO 题面的约束不是装饰,它几乎直接告诉你要用什么复杂度。
| 输入规模 | 大致可接受复杂度 | 常见做法 |
|---|---|---|
| N ≤ 8 | O(N!) | 全排列、暴力搜索 |
| N ≤ 20 | O(2^N · N) | 子集枚举、状压 DP |
| N ≤ 100 | O(N³) | Floyd、区间 DP、三重循环 |
| N ≤ 1000 | O(N²) | 双重循环、基础 DP |
| N ≤ 5000 | O(N²) 需谨慎 | 优化常数、简单循环体 |
| N ≤ 100000 | O(N log N) 或 O(N) | 排序、二分、图遍历、DSU |
| N ≤ 1000000 | O(N) 或轻量 O(N log N) | 线性扫描、前缀和 |
| 值域 ≤ 10^9 | 通常不能按值开数组 | 排序、离散化、map |
| 值域 ≤ 10^18 | 必须用 long long | 数学、二分、避免乘法溢出 |
经验估算:C++ 每秒大约能执行 (10^8) 次非常简单的操作。若 N = 100000,O(N²) 约为 (10^{10}),通常必定超时。
判断流程
- 看 N 的最大值。
- 估算你的循环次数。
- 若超过 (10^8) 到 (10^9) 级别,基本危险。
- 再看值域,判断是否需要
long long或坐标压缩。 - 最后再决定具体算法。
7.1.6 竞赛时间管理
一场 USACO 通常 4 小时,看似很长,实际很快。推荐按阶段使用时间。
前 15 分钟:浏览全部题
不要一开始就写第一题。先快速阅读三题:
- 每题问什么?
- N 和值域多大?
- 看起来像什么题型?
- 哪题最有把握?
- 哪题可能有部分分?
给每题做一个初步标记:
| 标记 | 含义 |
|---|---|
| A | 很有把握,优先做 |
| B | 有思路但需要推导 |
| C | 暂时不会,之后拿部分分 |
第 15–90 分钟:拿下第一道题
优先选择最稳的题,而不一定是题号最小的题。
目标:拿到至少一道满分或接近满分的题。
这能稳定心态,也能避免整场比赛颗粒无收。
第 90–180 分钟:冲第二道题
第二道题是决定晋级的关键。此时你应该:
- 先写清楚思路和复杂度。
- 如果最优解不确定,先写暴力版本。
- 用样例和自造边界测试。
- 尽早提交一次稳定版本。
最后 60 分钟:取舍
最后一小时要非常务实:
- 若第二题还有 bug,优先修它。
- 若第三题完全没思路,写小数据部分分。
- 若已有两题高分,避免重写大段代码导致崩盘。
- 最后 30 分钟主要做测试和格式检查。
教练经验: 许多选手不是输在不会第三题,而是输在第二题明明会却因为赶第三题留下 bug。
7.1.7 读题方法
USACO 题面常有故事背景。故事可以帮助理解,但你必须把它翻译成精确模型。
读题四步
- 抽目标:最终要输出什么?最大值、最小值、数量、是否可行、构造方案?
- 抽输入:有哪些对象?数组、点、边、区间、字符串、网格?
- 抽限制:N、M、值域、是否有特殊性质?
- 抽操作:允许做什么?每次操作改变哪些量?
题面中最重要的词
| 关键词 | 可能提示 |
|---|---|
| minimum / maximum | DP、贪心、二分答案、最短路 |
| number of ways | DP、组合计数、前缀和 |
| connected / component | DFS、BFS、DSU |
| shortest | BFS、Dijkstra |
| at least / at most | 二分答案、滑动窗口、贪心 |
| range / interval | 排序、扫描线、前缀和、差分 |
| repeated many times | 循环检测、快速幂、数学规律 |
| any valid arrangement | 构造题 |
手动推演样例
样例不是用来“跑一下代码”的,而是用来确认你理解题意的。写代码前你应该能手算出样例输出。
如果你手算样例都算不出来,说明你还没理解题目,不应该开始编码。
7.1.8 Bronze 题型地图
Bronze 不是“简单题”的同义词,而是“主要用基础编程解决”的级别。常见题型如下:
| 类别 | 典型能力 | 常见坑点 |
|---|---|---|
| 模拟 | 按规则逐步执行 | 漏步骤、顺序错、状态更新时机错 |
| 枚举 | 尝试所有可能 | 复杂度估错、重复计数 |
| 计数 | 统计满足条件的对象 | 边界、去重、频率统计 |
| 排序 + 扫描 | 排序后线性处理 | 比较器写错、相等情况 |
| 字符串 | 下标、字符映射、模式匹配 | 0-index/1-index 混用 |
| 网格 | 二维数组、方向数组 | 行列搞反、越界 |
| 区间 | 重叠、覆盖、合并 | 闭区间/半开区间混淆 |
| 整数几何 | 点、矩形、面积、距离 | 浮点误差、坐标边界 |
| 简单数学 | 取模、奇偶、公式 | 溢出、负数取模 |
| Ad Hoc | 特殊观察、不变量 | 想套模板,忽略题目特性 |
Bronze 训练重点
要晋级 Silver,Bronze 选手应优先训练:
- 读题后能准确复述问题。
- 根据 N 选择 O(N)、O(N log N)、O(N²) 或 O(N³)。
- 能写稳定的模拟。
- 能独立处理边界情况。
- 能在没有完美思路时写部分分。
7.1.9 Silver 题型地图
Silver 需要你把基础编程升级为标准算法思维。
| 类别 | 核心算法 | 典型复杂度 |
|---|---|---|
| 排序 + 贪心 | 排序后选择或扫描 | O(N log N) |
| 前缀和/差分 | 快速区间统计 | O(N) 或 O(N + Q) |
| 二分查找 | 在有序结构中查找 | O(log N) |
| 二分答案 | 单调性 + check 函数 | O(N log V) |
| 双指针/滑动窗口 | 连续区间维护 | O(N) |
| BFS/DFS | 图遍历、最短步数、连通块 | O(N + M) |
| DSU | 动态连通、合并集合 | 接近 O(N) |
| 基础 DP | 状态转移、最优子结构 | O(N)、O(N²) |
Silver 与 Bronze 的区别
| 维度 | Bronze | Silver |
|---|---|---|
| 数据规模 | 较小,暴力常可行 | 常见 (10^5),需要优化 |
| 算法 | 模拟、枚举、排序 | 图、二分、DSU、DP |
| 证明 | 简单直觉 | 需要说明为什么贪心/二分/DP 正确 |
| 实现 | 细节为主 | 模板 + 建模 + 复杂度控制 |
7.1.10 常见错误与修正
1. 差一错误
// 错误:漏掉最后一个元素
for (int i = 0; i < n - 1; i++) {
// ...
}
// 错误:访问 a[n]
for (int i = 0; i <= n; i++) {
cout << a[i] << "\n";
}
// 正确:0-indexed 数组
for (int i = 0; i < n; i++) {
// ...
}
2. 整数溢出
int a = 1000000000;
int b = 1000000000;
long long wrong = a * b; // 先以 int 相乘,已经溢出
long long right = 1LL * a * b; // 正确
3. 未初始化变量
int ans; // 错误:值不确定
int best = 0; // 正确:根据题意初始化
若要求最大值,常用:
int best = INT_MIN;
若要求最小值,常用:
int best = INT_MAX;
4. 输入输出格式错误
常见错误包括:
- 少输出换行。
- 多输出调试信息。
- 文件 I/O 和标准 I/O 用错。
- 没读完整个输入。
- 多组测试时忘记循环。
调试输出应使用 cerr,不要用 cout。
5. 数组大小不够
若题目 N ≤ 100000,数组至少应开到 100000,若你用 1-indexed,最好开到 100005。
const int MAXN = 100000 + 5;
int a[MAXN];
6. 忽略边界情况
提交前至少检查:
- N = 1。
- 所有值相同。
- 已经满足条件。
- 完全不满足条件。
- 最大值导致溢出。
- 图不连通。
- 字符串长度为 1。
7.1.11 参赛模板与本地测试
推荐编译命令
g++ -std=c++17 -O2 -Wall -Wextra sol.cpp -o sol
调试阶段可以使用:
g++ -std=c++17 -g -fsanitize=address,undefined -Wall -Wextra sol.cpp -o sol
-fsanitize=address,undefined 能帮助发现越界、未定义行为等问题。正式提交前一般不需要保留这些选项。
最小模板
#include <bits/stdc++.h>
using namespace std;
using ll = long long;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
return 0;
}
常用方向数组
int dr[4] = {-1, 1, 0, 0};
int dc[4] = {0, 0, -1, 1};
网格题中统一用 r 表示行、c 表示列,能减少行列混淆。
7.1.12 如何补题
补题是 USACO 进步最快的环节。正确补题不是“看懂题解就算了”,而是经历下面过程。
补题五步
- 重新读题:确认比赛时有没有读错。
- 自己再想 30 分钟:尤其是看约束和小例子。
- 只看提示:例如“这题用二分答案”或“先排序”。
- 读完整题解:重点理解关键观察,不是代码细节。
- 关掉题解,从零实现:能独立写出来才算掌握。
复盘问题清单
每道错题问自己:
- 我卡在题意、算法、证明还是实现?
- 约束给了什么提示,我当时忽略了吗?
- 有没有小例子可以更早看出规律?
- 我的复杂度估算是否正确?
- 如果比赛再遇到类似题,我的第一反应应该是什么?
把答案记录在题目日志中。长期来看,这比机械刷题更重要。
本章总结
核心要点
| 主题 | 你应该记住 |
|---|---|
| 赛制 | 每场通常 3 题、4 小时,US Open 更长 |
| 分级 | Bronze → Silver → Gold → Platinum |
| 评分 | 通过测试点得分,部分分非常重要 |
| 晋级 | 常见晋级线约 750,但会随比赛变化 |
| 复杂度 | N 决定算法上限,先估复杂度再编码 |
| 时间管理 | 先浏览三题,优先拿稳定分,最后测试 |
| 常见错误 | 溢出、越界、差一、未初始化、I/O 错误 |
赛时快速清单
- 已读完三道题。
- 已记录每题 N、值域、特殊性质。
- 已估算复杂度。
- 已选择最稳题目先做。
- 不会满分时已考虑部分分。
- 提交前测试样例和边界。
-
检查
long long、数组大小、输出格式。
常见问题
Q1:第一次参加 USACO 应该期待什么?
不要期待第一次就一定晋级。你的目标应该是熟悉流程、至少认真完成一题,并在赛后完整复盘。
Q2:Bronze 晋级 Silver 最需要补什么?
最需要补的是稳定实现和复杂度意识。会写模拟、枚举、排序、计数,并能避免低级错误,比学很高级的算法更重要。
Q3:比赛中可以查资料吗?
通常可以查通用资料,例如 C++ 文档、算法说明,但不能查本场题解或寻求他人帮助。具体以官方规则为准。
Q4:是否应该用 Python?
USACO 支持多语言,但本书推荐 C++。C++ 速度快,STL 强大,也最适合学习主流竞赛算法。
Q5:我应该什么时候放弃一道题?
如果 30–40 分钟没有新进展,先提交已有部分解,然后切换题目。放弃不是失败,而是比赛资源管理。
下一章会进入更具体的解题流程:如何从题面约束推算法,如何测试,如何调试,以及如何把 Bronze 能力训练到 Silver 水平。
第 7.2 章:解题策略
会算法不等于会比赛。真正的 USACO 能力,是在一题从未见过的情况下,仍然能有条理地完成以下动作:
- 读懂题意。
- 抽象模型。
- 根据约束判断复杂度。
- 选择可能的算法。
- 先写可验证的版本。
- 调试并提交。
- 赛后复盘。
本章给你一套可以直接在比赛中使用的流程。它不保证你每题都会,但能显著减少“脑子一片空白”和“明明会却写挂”的情况。
7.2.1 一道题的完整处理流程
下图概括了竞赛解题流程:

把它拆成实际动作,就是下面 8 步。
Step 1:读目标
先回答一句话:
这题最终要我输出什么?
常见目标包括:
- 最大值或最小值。
- 满足条件的数量。
- 是否可行。
- 最短步数。
- 任意一个合法构造。
- 每个询问的答案。
如果这句话说不清楚,不要写代码。
Step 2:读输入对象
把故事翻译成数据结构:
| 故事对象 | 可能模型 |
|---|---|
| 奶牛排成一行 | 数组、字符串、序列 |
| 农场与道路 | 图:点和边 |
| 牧场格子 | 网格、二维数组 |
| 时间段 | 区间 |
| 朋友关系 | 图、并查集 |
| 操作过程 | 状态转移、模拟 |
Step 3:读约束
约束决定你可以使用什么复杂度。

快速判断:
| N 范围 | 第一反应 |
|---|---|
| N ≤ 8 | 全排列可能可行 |
| N ≤ 20 | 子集枚举、状压、回溯 |
| N ≤ 100 | O(N³) 可以考虑 |
| N ≤ 1000 | O(N²) 通常可行 |
| N ≤ 100000 | 需要 O(N log N) 或 O(N) |
| N ≤ 10^9 | 不能按 N 遍历,考虑数学或二分 |
Step 4:手算样例
不要只看样例输入输出。你要能解释:
- 为什么样例答案是这个?
- 每一步中间状态是什么?
- 如果把样例改小一点,答案如何变化?
Step 5:先想暴力
每道题都先问:最直接的做法是什么?
暴力解的价值有三点:
- 可能已经足够通过 Bronze。
- 可以拿小数据部分分。
- 可以作为对拍的正确基准。
Step 6:优化瓶颈
找到暴力慢在哪里:
| 暴力瓶颈 | 常见优化 |
|---|---|
| 反复求区间和 | 前缀和 |
| 每次查找最近/最大/最小 | 排序、二分、set、priority_queue |
| 枚举所有对 | 双指针、哈希、排序扫描 |
| 重复计算子问题 | DP、记忆化搜索 |
| 图上反复搜索 | 预处理、一次 BFS/DFS、DSU |
| 答案范围大但有单调性 | 二分答案 |
Step 7:写前先列边界
在代码旁边写下要测的情况:
- N = 1。
- 所有值相同。
- 已经满足条件。
- 完全不满足条件。
- 最大值。
- 空图或不连通图。
- 区间刚好接触。
Step 8:实现、测试、提交
先写清晰版本,不要过早追求短代码。通过样例后,再测自造边界。若时间允许,用暴力对拍。
7.2.2 算法识别:从约束到方法
问题一:能不能直接模拟
如果题目只是让你按规则执行,且操作次数不大,直接模拟通常最稳。
但要小心:如果 T 很大,例如 (10^9),朴素模拟会超时。这时要考虑:
- 是否存在循环?
- 是否能用数学公式跳过?
- 是否能把多次操作合并?
问题二:能不能枚举
枚举是 Bronze 的核心能力。关键是枚举对象要选对。
| 枚举对象 | 适用场景 |
|---|---|
| 枚举一个点 | 找最优位置、检查每个元素 |
| 枚举一对点 | 统计 pair,N ≤ 5000 或更小 |
| 枚举区间端点 | N ≤ 1000 时常见 |
| 枚举子集 | N ≤ 20 |
| 枚举排列 | N ≤ 8 或 9 |
优秀的枚举题常常不是完全不能暴力,而是要找到合适的暴力维度。
问题三:是否有图或网格
如果对象之间有连接关系,立刻考虑图。
| 题面特征 | 常见算法 |
|---|---|
| 最少步数、无权移动 | BFS |
| 连通块、区域大小 | DFS/BFS |
| 动态合并集合 | DSU |
| 有权最短路 | Dijkstra |
| 树上子树信息 | DFS、树形 DP |
| 依赖关系无环 | 拓扑排序、DAG DP |
网格题也可以看作图:每个格子是点,相邻格子之间有边。
问题四:是否有区间或前缀
出现区间和、连续段、矩形区域时,优先考虑:
- 一维前缀和。
- 二维前缀和。
- 差分数组。
- 滑动窗口。
- 排序后区间合并。
问题五:是否有单调性
如果题目问:
- 最大化最小值。
- 最小化最大值。
- 至少能否达到 X。
- 最多能否控制在 X。
通常可以考虑 二分答案。
二分答案的关键是定义:
check(x) = 是否能做到答案至少/至多为 x
并证明 check(x) 随 x 单调。
问题六:是否有最优子结构
若一个最优解可以由更小问题的最优解转移而来,考虑 DP。
常见信号:
- “最大/最小代价”。
- “方案数”。
- “从前 i 个中选择”。
- “走到第 i 个位置”。
- “状态由上一步决定”。
DP 的核心不是套模板,而是定义状态:
dp[i] = 处理到第 i 个对象时的最优答案
或:
dp[i][j] = 到达状态 (i, j) 的最优答案/方案数
7.2.3 算法决策树
当你不知道从哪开始时,可以按下面顺序问自己:
📄 解题决策树
1. N 是否很小?
├─ N ≤ 8:试全排列
├─ N ≤ 20:试子集枚举 / 状压
└─ 否:继续
2. 题目是否是图或网格?
├─ 最短步数:BFS
├─ 连通性:DFS / BFS / DSU
├─ 有权最短路:Dijkstra
└─ 树结构:DFS / 树形 DP
3. 是否有区间、连续段、范围查询?
├─ 区间和:前缀和
├─ 多次区间修改:差分
├─ 连续窗口:双指针 / 滑动窗口
└─ 区间重叠:排序 + 扫描
4. 是否在有序结构中查找?
├─ 找位置:二分查找
├─ 最大化最小值:二分答案
└─ 找最近元素:排序 + lower_bound
5. 是否是最优决策序列?
├─ 有重叠子问题:DP
├─ 局部选择可证明:贪心
└─ 状态很少:BFS 状态搜索
6. 都不像?
├─ 试小例子找规律
├─ 找不变量
├─ 重新表述题目
└─ 可能是 Ad Hoc
教练提醒: 决策树不是绝对规则,而是帮助你在紧张时不乱。真正比赛中,一题可能同时用到排序 + 前缀和 + 二分答案。
7.2.4 部分分策略
不会满分时,目标不是放弃,而是寻找能稳定通过的子任务。
常见部分分方案
| 原题难点 | 部分分做法 |
|---|---|
| N 太大 | 写小 N 暴力 |
| 图太复杂 | 处理链、树、无环、完全图等特殊结构 |
| 值域太大 | 处理值域小的情况 |
| 操作次数太多 | 模拟前若干步,或找简单循环 |
| 最优解太难 | 写贪心或局部搜索,可能过部分测试 |
| 证明不会 | 先提交观察做法,再找反例或补证明 |
小数据暴力模板思维
如果 N ≤ 20,考虑子集:
for (int mask = 0; mask < (1 << n); mask++) {
// check subset
}
如果 N ≤ 8,考虑排列:
sort(a.begin(), a.end());
do {
// check permutation
} while (next_permutation(a.begin(), a.end()));
如果 N ≤ 1000,很多 O(N²) 做法都值得一试。
比赛中如何提交部分分
- 先保证代码对样例正确。
- 对不支持的大数据也要输出合法格式,不能崩溃。
- 在时间允许时,逐步扩展更多情况。
- 每次较大修改前,保存或保留上一版思路。
7.2.5 测试方法
样例测试不够
样例只验证最基本理解,不能覆盖所有边界。
你应该主动构造测试。
边界测试清单
| 类型 | 示例 |
|---|---|
| 最小规模 | N = 1,M = 0 |
| 最大规模 | N 取最大,值取最大 |
| 全相同 | 所有元素相等 |
| 单调 | 已排序、逆序 |
| 极端结构 | 链、星形图、完全图、不连通图 |
| 临界区间 | 区间刚好相交、刚好不相交 |
| 无解 | 明确不可能的情况 |
| 多解 | 有多个合法答案 |
对拍:最强调试工具
对拍适用于:你有一个暴力解和一个优化解,但不确定优化解是否正确。
工作流程:
- 写
brute.cpp:小数据正确暴力。 - 写
sol.cpp:你的优化解。 - 写
gen.py或gen.cpp:随机生成小数据。 - 多次运行并比较输出。
📄 对拍脚本示例
for i in {1..1000}; do
python3 gen.py > test.in
./brute < test.in > expected.out
./sol < test.in > got.out
if ! diff -q expected.out got.out > /dev/null; then
echo "Wrong answer on test $i"
cat test.in
echo "Expected:"
cat expected.out
echo "Got:"
cat got.out
break
fi
done
对拍尤其适合排序、贪心、DP、图论中容易漏边界的题。
7.2.6 调试方法
用 cerr 而不是 cout
cout 是答案输出,调试信息会污染评测结果。调试时用 cerr。
cerr << "i = " << i << ", value = " << a[i] << "\n";
用 assert 检查不变量
assert(0 <= r && r < n);
assert(0 <= c && c < m);
assert(dist[v] == -1 || dist[v] == dist[u] + 1);
如果断言失败,说明程序某处违反了你认为一定成立的条件。
开启编译警告
g++ -std=c++17 -Wall -Wextra sol.cpp -o sol
认真读 warning。很多 warning 对应真实 bug。
使用地址消毒器
g++ -std=c++17 -g -fsanitize=address,undefined sol.cpp -o sol
它能发现:
- 数组越界。
- 使用未定义行为。
- 某些整数溢出。
- 访问无效内存。
缩小失败样例
如果某个大测试错了,不要盲目盯代码。尝试删掉输入中的元素,直到得到一个仍然错误的最小样例。越小的反例越容易看出问题。
7.2.7 常见思维误区
误区一:一上来就写代码
如果你没有完整思路,代码只会把混乱固化下来。至少先写出:
- 状态是什么。
- 转移或操作是什么。
- 复杂度是多少。
- 边界是什么。
误区二:只看题号判断难度
通常题 1 简单,题 3 难,但不是绝对。比赛开始时浏览三题,可以避免在不适合自己的题上浪费太久。
误区三:样例过了就认为正确
样例过了只能说明你没有完全误解题目。真正的正确性需要边界测试和逻辑证明。
误区四:认为暴力没价值
暴力是:
- 部分分来源。
- 正确性基准。
- 帮你理解题目的工具。
误区五:把模板当答案
模板只解决“怎么写”,不解决“为什么这样建模”。USACO 常常考的是把题面变成模板能处理的形式。
7.2.8 Bronze 到 Silver 能力清单
算法能力
- 能熟练写一维/二维前缀和。
-
能写
sort自定义比较器。 -
能使用
lower_bound/upper_bound。 - 能写二分答案框架。
- 能写 BFS、DFS 和网格 BFS。
- 能写 DSU。
-
能使用
map、set、priority_queue。 - 能写基础 DP。
- 能进行简单贪心证明。
实现能力
- 30 秒内写出快速 I/O 模板。
- 5 分钟内写出方向数组和网格遍历。
- 10 分钟内写出 BFS。
- 5 分钟内写出 DSU。
- 能正确处理 0-index 与 1-index。
-
知道什么时候必须用
long long。
竞赛能力
- 15 分钟内浏览完三题并排序难度。
- 能对每题估计复杂度。
- 卡住时能主动寻找部分分。
- 提交前有固定检查清单。
- 每场后写复盘记录。
7.2.9 四周训练计划
第 1 周:稳定 Bronze 基础
目标:减少低级错误。
- 每天 1 道 Bronze 模拟/枚举题。
- 每题写完后列出边界测试。
- 复习数组、字符串、排序、结构体。
第 2 周:复杂度与优化
目标:从暴力走向 O(N log N) 或 O(N)。
- 练习排序 + 扫描。
- 练习前缀和与差分。
- 练习双指针与滑动窗口。
- 每题写出暴力解和优化解的复杂度对比。
第 3 周:图与二分
目标:进入 Silver 常见题型。
- 练习网格 BFS。
- 练习 DFS 连通块。
- 练习 DSU。
- 练习二分答案。
第 4 周:模拟比赛与复盘
目标:提升赛时表现。
- 每周至少做 1 场 4 小时模拟赛。
- 比赛中严格执行先读三题的流程。
- 赛后补完所有题。
- 记录每题关键洞察和失败原因。
7.2.10 题目日志模板
建议每道题后记录:
题目:
级别:Bronze / Silver / Gold
标签:排序、BFS、DP、Ad Hoc、二分答案……
我一开始的想法:
正确关键洞察:
复杂度:
我犯的错误:
下次遇到类似题要想到:
长期坚持题目日志,会让你形成自己的“题型雷达”。
本章总结
核心要点
| 技能 | 训练目标 |
|---|---|
| 读题 | 能一句话说清目标 |
| 建模 | 能把故事翻译成数组、图、区间、状态 |
| 复杂度 | 能根据 N 排除不可能做法 |
| 暴力 | 能快速写小数据解法 |
| 优化 | 能识别前缀和、排序、二分、图、DP 等模式 |
| 调试 | 能用 cerr、assert、对拍定位 bug |
| 复盘 | 能总结关键洞察并迁移到下一题 |
竞赛中最实用的五句话
- 先读完三题。
- 先看 N,再想算法。
- 先写暴力,再优化。
- 样例过了不代表正确。
- 不会满分也要拿部分分。
常见问题
Q1:我读题后完全没思路怎么办?
先写最直接的暴力,再手算小例子。若仍没有思路,检查是否是图、区间、排序、DP、二分答案或 Ad Hoc。30–40 分钟无进展就切题。
Q2:什么时候应该写对拍?
当你有一个简单但慢的暴力解,以及一个复杂但快的优化解时。尤其是贪心、DP、双指针、排序统计题,对拍非常有用。
Q3:怎么提高算法识别能力?
每道题做完后记录标签和关键洞察。不要只记录“AC”,要记录“为什么这题是二分答案/为什么这题能贪心”。
Q4:比赛中应该追求代码短吗?
不应该。比赛中更重要的是清晰、稳定、可调试。短代码适合熟练后自然形成,不应作为初学目标。
下一章会专门讨论 Ad Hoc 题型。它们没有固定模板,但有一套寻找规律、不变量、构造和模拟捷径的方法。
第 7.3 章:Ad Hoc 题型
Ad hoc 的意思是“为此目的专门设计”。在竞赛编程里,Ad Hoc 题通常没有一个现成模板可以直接套用;你必须观察题目的特殊结构,设计一个专门解法。
很多同学害怕 Ad Hoc,因为它不像 BFS、前缀和、DSU 那样有固定代码。但从教练角度看,Ad Hoc 并不是“靠灵感玄学做题”。它有可以训练的步骤:
- 做小例子:从 N=1、2、3、4 开始手算。
- 找结构:观察奇偶、单调、对称、循环、极端情况。
- 提出猜想:把规律写成一句话。
- 证明猜想:用不变量、交换论证、反证或构造证明。
- 实现最简版本:关键洞察出现后,代码往往很短。
本章会把 Ad Hoc 从“凭感觉”变成“有步骤的观察训练”。
7.3.1 什么是 Ad Hoc 题
定义
Ad Hoc 题通常具备以下特征:
- 题目不直接对应标准算法模板。
- 难点在于发现某个特殊性质,而不是写复杂数据结构。
- 一旦发现性质,实现常常很简单。
- 题面可能像模拟、数学、构造、几何或贪心,但真正解法依赖特定观察。
一个典型例子
题目:给定 N 个整数,每次可以把一个数加 2。问能否让所有数变成相等?
初看像模拟或搜索,但关键观察是:
- 加 2 不改变一个数的奇偶性。
- 因此所有数最终相等时,它们必须有相同奇偶性。
- 如果初始奇偶性不全相同,不可能。
- 如果奇偶性全相同,总可以把较小的数加 2 追上较大的数。
这就是典型 Ad Hoc:关键在奇偶不变量,代码只需检查 parity。
Ad Hoc 与其他题型的区别
| 题型 | 解题核心 | 典型问题 |
|---|---|---|
| 模拟 | 忠实执行规则 | “照题意做 T 步” |
| BFS/DFS | 图或状态空间遍历 | “最少步数”“连通块” |
| DP | 重叠子问题 | “前 i 个的最优值” |
| 贪心 | 局部选择可证明最优 | “每次选最早结束的区间” |
| Ad Hoc | 特殊观察或重新表述 | “这个题真正不变量是什么?” |
注意:Ad Hoc 可以和标准算法组合。例如“先发现只需考虑相邻元素,再排序扫描”,这就是 Ad Hoc 观察 + 排序。
7.3.2 如何识别 Ad Hoc
当你读完题后,如果出现以下感觉,很可能是 Ad Hoc:
- “这不像我学过的任何模板。”
- “N 不大,但直接暴力又不够优雅。”
- “题目有很强的特殊规则。”
- “操作看起来复杂,但可能存在不变量。”
- “题目问的是能否、最少几步、任意构造。”
- “样例似乎暗示某个规律。”
常见信号
| 信号 | 可能方向 |
|---|---|
| 操作反复进行很多次 | 找循环、找不变量、找最终稳定状态 |
| 问能否从 A 到 B | 找不变量、模数条件、连通性 |
| 问最少操作次数 | 找每次操作最多贡献多少,或构造达到下界 |
| 问任意合法方案 | 构造、排序、分组、贪心观察 |
| 值域很大但状态变化简单 | 数学公式、取模、压缩状态 |
| 网格黑白格、相邻移动 | 奇偶性、棋盘染色 |
| 圆环结构 | 断环成链、枚举切点、复制数组 |
| 看起来要模拟 (10^9) 步 | 状态循环、周期、快速跳转 |
7.3.3 Ad Hoc 的五步训练法
第一步:把题目降到最小
不要从最大数据开始想。先问:
- N = 1 时答案是什么?
- N = 2 时有哪些情况?
- N = 3 时是否出现新现象?
- 所有元素相等时怎样?
- 已经满足条件时怎样?
- 完全相反的极端情况怎样?
很多规律只在小例子中最清楚。
第二步:记录表格
对小数据列一个表:
| 输入 | 答案 | 你观察到什么 |
|---|---|---|
| 1 | ... | ... |
| 2 | ... | ... |
| 3 | ... | ... |
如果答案序列是 1, 2, 4, 8,可能是指数或子集。
如果是 1, 3, 6, 10,可能是三角数。
如果只和奇偶有关,可能有 parity 不变量。
第三步:找“不变”和“单调”
Ad Hoc 中最重要的两个问题:
- 什么永远不会变?
- 什么每次都朝一个方向变化?
常见不变量:
- 总和。
- 总和模 K。
- 奇偶性。
- 黑白格数量差的奇偶性。
- 排列逆序对奇偶性。
- 连通块数量的某种限制。
常见单调量:
- 未完成元素数量减少。
- 最大值不增或最小值不减。
- 区间长度变短。
- 距离目标越来越近。
第四步:提出一句话猜想
不要让规律停留在模糊感觉中。把它写成一句话:
- “答案只取决于最大值和最小值。”
- “只需要检查相邻排序后的元素。”
- “如果总和不是 K 的倍数,一定不可能。”
- “最优解一定可以调整成先做 A 再做 B。”
- “每个状态最多出现一次,重复后进入循环。”
一句话猜想越清晰,越容易证明和实现。
第五步:证明或找反例
证明前先尝试找反例。若找不到,再考虑证明。
常见证明方式:
| 证明方法 | 适用场景 |
|---|---|
| 不变量证明 | 能否到达、操作变换 |
| 下界 + 构造 | 最少操作次数、最大收益 |
| 交换论证 | 贪心排序、选择顺序 |
| 反证法 | “最优解一定具有某性质” |
| 归纳法 | 递推结构、逐步构造 |
| 分类讨论 | Bronze 常见,情况数量有限 |
7.3.4 核心技术一:不变量
不变量是 Ad Hoc 中最强的工具之一。它回答:无论怎么操作,什么量不会变?
例 1:奇偶不变量
题目:有一个整数 x,每次可以加 2 或减 2。能否从 a 变成 b?
观察:每次操作都不改变奇偶性。
因此:
- 如果 a 和 b 奇偶性不同,不可能。
- 如果奇偶性相同,可以通过反复加减 2 到达。
代码:
if ((a % 2 + 2) % 2 == (b % 2 + 2) % 2) {
cout << "YES\n";
} else {
cout << "NO\n";
}
例 2:总和模 K
题目:有 N 个数,每次选择一个数加 K。能否让所有数相等?
每个数对 K 取模的值不会变。所以所有数最终相等的必要条件是:所有数模 K 相同。
如果都模 K 相同,也可以把较小的数不断加 K 追到最大值或更高,因此条件也是充分的。
bool ok = true;
for (int i = 1; i < n; i++) {
if (((a[i] - a[0]) % k + k) % k != 0) {
ok = false;
}
}
cout << (ok ? "YES\n" : "NO\n");
例 3:网格 2×2 翻转
题目:从全 0 的 N×M 网格出发,每次可以选择一个 2×2 方块,并把其中 4 个格子全部翻转(0 变 1,1 变 0)。给定目标网格,问能否达到?
错误的想法是只看黑白格数量奇偶性。更精确的不变量是:
- 每次翻转某个 2×2,会在两行中各翻转 2 个格子,因此每一行的 1 的个数奇偶性不变。
- 同理,每一列也翻转 2 个格子,因此每一列的 1 的个数奇偶性不变。
- 初始全 0,所以每行、每列的 1 的个数都必须是偶数。
对于这个操作,这个条件也是充分的:可以从左上到右下贪心消去所有 1,最后只需检查最后一行和最后一列。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, m;
cin >> n >> m;
vector<string> g(n);
for (string& row : g) cin >> row;
vector<int> rowParity(n, 0), colParity(m, 0);
for (int r = 0; r < n; r++) {
for (int c = 0; c < m; c++) {
if (g[r][c] == '1') {
rowParity[r] ^= 1;
colParity[c] ^= 1;
}
}
}
bool ok = true;
for (int x : rowParity) ok &= (x == 0);
for (int x : colParity) ok &= (x == 0);
cout << (ok ? "YES\n" : "NO\n");
return 0;
}
7.3.5 核心技术二:下界 + 构造
很多“最少操作次数”题可以这样解:
- 证明答案至少是多少(下界)。
- 给出一种方法恰好达到这个下界(构造)。
- 因此答案就是这个数。
示例:把所有数变成最大值
题目:给定数组,每次可以把一个元素加 1。问最少多少次让所有元素相等?
下界:最终值至少是当前最大值 mx,每个 a[i] 至少要增加 mx - a[i] 次。
构造:把每个元素都加到 mx,正好需要这些次数。
所以答案:
long long ans = 0;
int mx = *max_element(a.begin(), a.end());
for (int x : a) ans += mx - x;
示例:圆桌换座
题目:N 头奶牛坐成一圈,其中 K 头是 A 型。每次可以交换任意两个相邻奶牛。问最少交换多少次,让所有 A 型连续。
一个简化版本中,如果允许“任意交换”而不是相邻交换,那么答案是:选一个长度 K 的连续窗口,让窗口内 B 的数量最少。这些 B 需要被换出去。
这类题的思路是:
- 下界:最终 A 连续时,一定有某个长度 K 的窗口全是 A。原来窗口内有多少 B,就至少要换出多少个。
- 构造:把窗口外的 A 与窗口内的 B 交换,正好这么多次。
于是答案是所有长度 K 窗口内 B 数的最小值。
7.3.6 核心技术三:循环与周期
当题目要求模拟很多次操作,T 可能达到 (10^9) 或 (10^{18}),直接模拟不可能。此时问:状态会不会重复?
若状态空间有限,重复后就进入循环。
循环检测模板
#include <bits/stdc++.h>
using namespace std;
vector<int> nextState(vector<int> state) {
// 根据题意生成下一个状态
return state;
}
int main() {
long long T;
int n;
cin >> n >> T;
vector<int> state(n);
for (int& x : state) cin >> x;
map<vector<int>, long long> seen;
long long step = 0;
while (step < T) {
if (seen.count(state)) {
long long cycleStart = seen[state];
long long cycleLen = step - cycleStart;
long long remaining = (T - step) % cycleLen;
for (long long i = 0; i < remaining; i++) {
state = nextState(state);
}
break;
}
seen[state] = step;
state = nextState(state);
step++;
}
for (int x : state) cout << x << " ";
cout << "\n";
return 0;
}
什么时候适合找循环
- 状态数量有限。
- 每一步由当前状态唯一决定下一状态。
- T 很大。
- 题目类似“重复操作直到第 K 次”。
函数图、排列反复应用、有限状态模拟,都经常用循环。
7.3.7 核心技术四:重新表述
Ad Hoc 题常常被故事包装得很复杂。重新表述能把它变成你熟悉的问题。
例:从“奶牛移动”到“区间覆盖”
题面可能说:奶牛在数轴上走来走去,经过的草地都会被踩踏。问最终有多少长度被踩过。
重新表述:每段行走是一段区间,问题是求多个区间的并集长度。
此时可以:
- 坐标小:用布尔数组标记。
- 坐标大:排序区间后合并。
例:从“照片顺序”到“排列”
题面说:有 N 头奶牛,每头有唯一编号,照片中顺序被打乱,问最少交换多少次恢复顺序。
重新表述:这是一个排列排序问题。
如果允许任意交换,最少交换次数 = N - 循环个数。
如果只允许相邻交换,最少交换次数 = 逆序对数。
7.3.8 核心技术五:分类讨论
Bronze 中大量 Ad Hoc 题可以通过仔细分类解决。分类讨论不是低级技巧,而是严谨处理小规模结构的方法。
分类讨论原则
- 分类必须覆盖所有情况。
- 不同类别之间最好互斥。
- 每类内部逻辑要简单。
- 写代码时顺序要与分类一致。
示例:两个区间的关系
两个区间 [a,b] 和 [c,d] 的关系只有几类:
- 完全不相交:
b < c或d < a。 - 部分相交。
- 一个包含另一个。
- 端点刚好接触。
如果使用半开区间 [l, r),许多情况可以统一为:
int overlap = max(0, min(b, d) - max(a, c));
这就是从分类讨论升级为公式。
7.3.9 核心技术六:交换论证
有些 Ad Hoc 看起来像贪心,但需要证明为什么某种顺序是最优。
交换论证的基本形式:
- 假设存在一个最优解,但其中有两个相邻选择顺序“不符合贪心规则”。
- 交换这两个选择后,答案不会变差。
- 不断交换,最终得到一个符合贪心规则的最优解。
- 因此贪心正确。
示例:按结束时间选择最多不重叠区间
要选最多不重叠活动。贪心选择结束最早的活动。
证明思路:
- 设某个最优解第一个选择的活动不是结束最早的。
- 用结束最早的活动替换它,不会影响后面活动,因为结束更早只会留下更多空间。
- 所以存在一个最优解以结束最早活动开头。
- 递归处理剩余部分。
虽然这是标准贪心,但很多 Ad Hoc 贪心观察都可以用类似方法证明。
7.3.10 工作示例一:区间涂色
题目
一条围栏被编号为整数位置。FJ 先把区间 [a,b) 涂成红色,再把 [c,d) 涂成蓝色。蓝色会覆盖红色。问最终红色长度和蓝色长度。
数据规模: 0 ≤ a, b, c, d ≤ 100(USACO Bronze 原题规模),区间长度 ≤ 100,int 足够。
思考过程
这题看似模拟涂色,但本质是两个半开区间的覆盖关系。
- 蓝色长度一定是
d - c。 - 红色原本长度是
b - a。 - 被蓝色覆盖的红色部分是两个区间交集。
- 最终红色长度 = 红色原长 - 交集长度。
交集长度:
max(0, min(b, d) - max(a, c))
代码
#include <bits/stdc++.h>
using namespace std;
int main() {
int a, b, c, d;
cin >> a >> b >> c >> d;
int red = b - a;
int blue = d - c;
int overlap = max(0, min(b, d) - max(a, c));
cout << red - overlap << " " << blue << "\n";
return 0;
}
教练点评
这题的关键不是代码,而是统一使用半开区间 [l,r)。半开区间能避免端点是否重复计算的混乱。
7.3.11 工作示例二:丢失的奶牛式模拟
题目模型
从位置 x 出发,要到达位置 y。第 1 次向右走 1,第 2 次向左走 2,第 3 次向右走 4,第 4 次向左走 8……方向交替,距离每次翻倍。问第一次经过 y 时走过的总距离。
数据规模: 1 ≤ x, y ≤ 1000,x ≠ y。总距离不超过约 6×步长上限,int 足够。
为什么是 Ad Hoc
它看起来只是模拟,但有两个细节:
- 每一步是一段线段,不是只检查终点。
- 目标 y 可能在当前移动路径中间被经过。
解法
每次移动从 cur 到 next。如果 y 在这段区间内,就加上 abs(y - cur) 后结束;否则加上整段距离并继续。
代码
#include <bits/stdc++.h>
using namespace std;
int main() {
long long x, y;
cin >> x >> y;
long long cur = x;
long long ans = 0;
for (int k = 0; ; k++) {
long long offset = 1LL << k;
if (k % 2 == 1) offset = -offset;
long long nxt = x + offset;
long long lo = min(cur, nxt);
long long hi = max(cur, nxt);
if (lo <= y && y <= hi) {
ans += llabs(y - cur);
break;
}
ans += llabs(nxt - cur);
cur = nxt;
}
cout << ans << "\n";
return 0;
}
教练点评
这类题的陷阱是把“到达终点”误写成“终点等于 y”。实际上,只要移动线段经过 y 就结束。
7.3.12 工作示例三:最少交换恢复排列
题目
给定 1..N 的一个排列。每次可以交换任意两个位置。问最少多少次交换能把排列变成升序。
数据规模: 1 ≤ N ≤ 10⁵(环分解 O(N);答案最多 N-1)。
小例子
排列 2 1 3:交换 1 次。
排列 2 3 1:
- 1 应到位置 1,当前位置 3。
- 2 应到位置 2,当前位置 1。
- 3 应到位置 3,当前位置 2。
形成一个长度 3 的循环,需要 2 次交换。
关键观察
一个长度为 L 的循环,需要 L-1 次交换修好。
如果排列分解成 C 个循环,总交换次数:
N - C
代码
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
cin >> n;
vector<int> p(n);
for (int& x : p) cin >> x;
vector<bool> vis(n, false);
int cycles = 0;
for (int i = 0; i < n; i++) {
if (!vis[i]) {
cycles++;
int cur = i;
while (!vis[cur]) {
vis[cur] = true;
cur = p[cur] - 1;
}
}
}
cout << n - cycles << "\n";
return 0;
}
教练点评
同样是“排序”,不同操作导致不同答案:
- 任意交换:循环分解。
- 相邻交换:逆序对数量。
读题时必须先确认操作类型。
7.3.13 工作示例四:第一行决定全部
题目
5×5 灯阵,每盏灯为开或关。按一个格子会切换它自己和上下左右相邻灯。问最少按几次能让所有灯关闭。
数据规模: 棋盘固定为 5×5(POJ 1753 / USACO 风格)。
暴力想法
每个格子按或不按,共 (2^{25}) 种,太多。
关键观察
每个格子按两次等于没按,所以只需考虑按 0 或 1 次。
更重要的是:只要第一行怎么按确定了,后面每一行都被迫确定。
原因:
- 第一行处理完后,如果第 0 行某个灯还亮,那么唯一能影响它的未决定按钮是它正下方的按钮。
- 所以第 1 行对应按钮必须按。
- 依次类推,每一行都由上一行是否熄灭决定。
因此只需枚举第一行 (2^5=32) 种情况。
代码
#include <bits/stdc++.h>
using namespace std;
int originalGrid[5][5];
int dr[5] = {0, -1, 1, 0, 0};
int dc[5] = {0, 0, 0, -1, 1};
int solve(int firstMask) {
int g[5][5];
memcpy(g, originalGrid, sizeof(originalGrid));
int presses = 0;
auto press = [&](int r, int c) {
presses++;
for (int k = 0; k < 5; k++) {
int nr = r + dr[k];
int nc = c + dc[k];
if (0 <= nr && nr < 5 && 0 <= nc && nc < 5) {
g[nr][nc] ^= 1;
}
}
};
for (int c = 0; c < 5; c++) {
if (firstMask & (1 << c)) {
press(0, c);
}
}
for (int r = 1; r < 5; r++) {
for (int c = 0; c < 5; c++) {
if (g[r - 1][c] == 1) {
press(r, c);
}
}
}
for (int c = 0; c < 5; c++) {
if (g[4][c] == 1) return INT_MAX;
}
return presses;
}
int main() {
for (int r = 0; r < 5; r++) {
for (int c = 0; c < 5; c++) {
cin >> originalGrid[r][c];
}
}
int best = INT_MAX;
for (int mask = 0; mask < (1 << 5); mask++) {
best = min(best, solve(mask));
}
if (best == INT_MAX) cout << "impossible\n";
else cout << best << "\n";
return 0;
}
教练点评
这类题的关键词是“局部操作影响邻居”。常见突破口是:枚举边界,然后内部被迫确定。
7.3.14 Ad Hoc 模式速查表
| 模式 | 典型问题 | 第一反应 |
|---|---|---|
| 奇偶性 | 能否到达、棋盘移动 | 检查 parity |
| 模 K | 每次加 K、总和变化固定 | 检查余数 |
| 循环 | 重复操作很多次 | 记录状态、找周期 |
| 构造 | 输出任意合法答案 | 从必要条件反推构造 |
| 下界 + 构造 | 最少操作次数 | 证明至少 X,再做到 X |
| 排列循环 | 任意交换排序 | 分解循环 |
| 逆序对 | 相邻交换排序 | 统计逆序对 |
| 区间关系 | 覆盖、相交、合并 | 半开区间、排序扫描 |
| 圆环 | 环形数组 | 复制数组或枚举断点 |
| 网格染色 | 相邻移动、翻转 | 黑白染色、不变量 |
| 第一行枚举 | 灯阵、局部翻转 | 枚举边界,后续被迫 |
| 补集思维 | 直接数困难 | 总数 - 不合法数 |
| 反向思考 | 正向操作复杂 | 从目标倒推 |
| 规范化 | 等价状态很多 | 排序、旋转到最小表示 |
7.3.15 如何训练 Ad Hoc
训练一:每题写“关键观察”
不要只写“这题 AC 了”。要写:
关键观察:每次操作不改变所有数模 K 的余数。
因此只需检查所有数是否同余。
长期积累后,你会拥有自己的观察库。
训练二:强制手算小例子
每道 Ad Hoc 题至少手算 3 个小例子。即使你已经有思路,也要验证。
建议格式:
N=1:...
N=2:...
N=3:...
极端情况:...
训练三:先写暴力找规律
如果你猜不出公式,可以写小范围暴力,然后打印答案表。
例如:
for (int n = 1; n <= 10; n++) {
cout << n << " " << brute(n) << "\n";
}
答案表经常会暴露规律。
训练四:对每个操作问三个问题
遇到操作题时,问:
- 这个操作改变了什么?
- 这个操作不改变什么?
- 这个操作能不能反过来做?
这三个问题常常直接导向不变量或逆向思考。
7.3.16 练习题
下面练习按难度排列。建议你先只看提示,独立完成后再看题解。
🟢 P1. 同余变换
给定 N 个整数和 K。每次可以选择一个数加 K。问能否让所有数最终相等。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ K ≤ 10⁹,-10⁹ ≤ A[i] ≤ 10⁹。
💡 提示
每个数对 K 的余数不会改变。
所有数必须模 K 相同。若相同,则可以把较小的数不断加 K 追到足够大的同一个值。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
long long k;
cin >> n >> k;
vector<long long> a(n);
for (long long& x : a) cin >> x;
long long r = ((a[0] % k) + k) % k;
bool ok = true;
for (long long x : a) {
if (((x % k) + k) % k != r) ok = false;
}
cout << (ok ? "YES\n" : "NO\n");
return 0;
}
🟢 P2. 两个矩形覆盖面积
给定两个轴对齐矩形,坐标均为整数,求它们覆盖的总面积。
数据规模: -10⁹ ≤ 坐标 ≤ 10⁹,每个矩形满足 x1 < x2、y1 < y2(面积需 long long)。
💡 提示
总面积 = 面积1 + 面积2 - 重叠面积。重叠矩形的宽和高都要用 max(0, ...)。
#include <bits/stdc++.h>
using namespace std;
struct Rect {
long long x1, y1, x2, y2;
};
long long area(Rect r) {
return (r.x2 - r.x1) * (r.y2 - r.y1);
}
int main() {
Rect a, b;
cin >> a.x1 >> a.y1 >> a.x2 >> a.y2;
cin >> b.x1 >> b.y1 >> b.x2 >> b.y2;
long long ix = max(0LL, min(a.x2, b.x2) - max(a.x1, b.x1));
long long iy = max(0LL, min(a.y2, b.y2) - max(a.y1, b.y1));
long long overlap = ix * iy;
cout << area(a) + area(b) - overlap << "\n";
return 0;
}
🟡 P3. 重复函数应用
有函数 f,把 1..N 中每个数映射到 1..N。从 x 出发,反复应用 f,问 K 步后在哪里。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ x ≤ N,1 ≤ f[i] ≤ N,1 ≤ K ≤ 10¹⁸(不能逐步模拟)。
💡 提示
序列一定进入循环。记录每个位置第一次出现的步数。
#include <bits/stdc++.h>
using namespace std;
int main() {
int n, x;
long long k;
cin >> n >> x >> k;
vector<int> f(n + 1);
for (int i = 1; i <= n; i++) cin >> f[i];
vector<int> order;
vector<long long> first(n + 1, -1);
int cur = x;
long long step = 0;
while (first[cur] == -1) {
first[cur] = step++;
order.push_back(cur);
cur = f[cur];
}
long long cycleStart = first[cur];
long long cycleLen = step - cycleStart;
if (k < (long long)order.size()) {
cout << order[k] << "\n";
} else {
long long idx = cycleStart + (k - cycleStart) % cycleLen;
cout << order[idx] << "\n";
}
return 0;
}
🟡 P4. 任意交换排序
给定 1..N 的排列,每次可以交换任意两个位置。求最少交换次数排序。
数据规模: 1 ≤ N ≤ 10⁶。
💡 提示
排列分解成若干循环。长度 L 的循环需要 L-1 次交换。
🟡 P5. 相邻交换排序
给定 1..N 的排列,每次只能交换相邻两个位置。求最少交换次数排序。
数据规模: 1 ≤ N ≤ 10⁵(答案可达 N(N-1)/2,需 long long)。
💡 提示
答案等于逆序对数量。N 小可 O(N²),N 大用归并排序或树状数组。
🔴 P6. 2×2 翻转可达性
从全 0 的 N×M 网格出发,每次翻转一个 2×2 方块。给定目标网格,问能否达到。
数据规模: 1 ≤ N, M ≤ 1000。
💡 提示
每一行和每一列的 1 的个数奇偶性都不变。初始全为偶数。
🔴 P7. 灯阵
N×M 灯阵,每次按一个灯会翻转自己和四邻。N 很小,M 可以较大。问能否全部关闭或求最少次数。
数据规模: 1 ≤ N ≤ 8,1 ≤ M ≤ 500(枚举第一行的 2^N 种按法)。
💡 提示
若 N 很小,可以枚举第一列或第一行的按法,后面被迫确定。
🏆 P8. 构造排列
给定 N 和 K,构造一个 1..N 的排列,使它恰好有 K 个逆序对;若不可能输出 -1。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ K ≤ N(N-1)/2(K 需 long long)。
💡 提示
最大逆序对数是 N(N-1)/2。构造时可以从大到小插入,控制每个数贡献多少逆序对。
本章总结
核心要点
| 概念 | 要点 |
|---|---|
| Ad Hoc | 不是固定算法,而是题目特定观察 |
| 小例子 | N=1、2、3、4 是最好的老师 |
| 不变量 | 找操作永远不改变的量 |
| 下界 + 构造 | 证明至少需要 X,再构造 X 步方案 |
| 循环 | 状态有限且重复操作很多次时找周期 |
| 重新表述 | 把故事改写成区间、排列、图或网格 |
| 分类讨论 | Bronze 中非常常见,关键是完整且不重叠 |
| 交换论证 | 贪心观察的常用证明方式 |
Ad Hoc 检查清单
当你怀疑一道题是 Ad Hoc 时:
- 我是否手算了最小样例?
- 我是否列出了极端情况?
- 每个操作改变了什么?不改变什么?
- 是否存在奇偶性或模 K 不变量?
- 是否可以从目标反向思考?
- 是否可以把问题重新表述为区间、排列、图或网格?
- 是否能先证明一个下界,再构造达到它?
- 是否有循环或周期?
- 是否可以枚举边界,让内部被迫确定?
- 我的猜想有没有被小反例推翻?
常见问题
Q1:Ad Hoc 题是不是只能靠天赋?
不是。Ad Hoc 的“灵感”通常来自大量见过的不变量、构造、分类讨论和小例子训练。你见过的模式越多,新题越容易触发联想。
Q2:我找到规律但不会证明,比赛中怎么办?
比赛中可以先提交,尤其是在 Bronze/Silver。提交后继续找反例或补证明。但平时训练必须补上证明,否则下次容易被相似但不同的题坑到。
Q3:怎么判断我的不变量够不够?
不变量通常先给必要条件。你还要问:这个条件是否充分?如果不充分,还需要补充什么条件或给出构造。
Q4:为什么我看题解觉得简单,自己却想不到?
因为题解只展示最终洞察,隐藏了试错过程。训练时不要只记答案,要记录“我应该通过什么信号想到这个观察”。
🐄 教练寄语: Ad Hoc 是 USACO 中最能区分“会背模板”和“会思考”的题型。每次做完一题,都把关键观察写成一句话。几个月后,你会发现自己并不是更有天赋了,而是拥有了更大的观察工具箱。
📐 第八部分:数学
竞赛编程的另一半战场。数论、筛法、组合计数、矩阵加速、博弈论——USACO Silver 到 Platinum 的数学工具箱。
📚 5 章 · ⏱️ 预计 3-5 周 · 🎯 目标:USACO Silver → Platinum
第八部分:数学
预计用时:4-6 周
数学是竞赛编程的另一半。USACO 每场比赛几乎都有一道数学题,从 Bronze 的整除判断到 Platinum 的矩阵加速递推。本部分把散落各处(原附录)的数学内容整合为一条从易到难的学习路径。
涵盖的主题
| 章节 | 主题 | 核心思想 |
|---|---|---|
| 第 8.1 章 🥈 | 数论基础 | 模运算、快速幂、模逆元、GCD 与扩展欧几里得 |
| 第 8.2 章 🥇 | 素数筛法与积性函数 | 埃筛、欧拉线性筛、欧拉 φ、中国剩余定理 |
| 第 8.3 章 🥇 | 组合数学 | C(n,k) mod p、组合恒等式、隔板法、容斥原理 |
| 第 8.4 章 💎 | 矩阵快速幂 | 矩阵乘法、线性递推的 O(k³ log n) 加速 |
| 第 8.5 章 🥇 | 博弈论入门 | Nim 和、SG 函数与 SG 定理 |
学习路线
- 第 8.1 章是地基——模运算和快速幂几乎出现在每道计数题里,必须先掌握。
- 第 8.2、8.3 章是 Gold 数学题主战场——筛法与组合计数是 USACO Gold 数学题的两大高频考点。
- 第 8.4 章面向 Platinum——矩阵快速幂在 Gold 出现频率不高,但它是 Platinum 分治/数据结构题的常客。
- 第 8.5 章是独立专题——博弈论相对独立,可按需选读。
复杂度速查
| 操作 | 方法 | 时间复杂度 |
|---|---|---|
| a^b mod p | 快速幂 | O(log b) |
| a⁻¹ mod p(p 素数) | 费马小定理 + 快速幂 | O(log p) |
| gcd(a, b) | 欧几里得 / 辗转相除 | O(log min(a,b)) |
| ax + by = c 的解 | 扩展欧几里得 | O(log min(a,b)) |
| 1~n 的所有素数 | 埃拉托斯特尼筛 | O(n log log n) |
| 1~n 的所有素数 | 欧拉线性筛 | O(n) |
| 1~n 的欧拉 φ 值 | 线性筛同时求 φ | O(n) |
| C(n,k)(单次) | 逆元法 | O(k log p) |
| C(n,k)(多次询问) | 阶乘 + 逆元预处理 | O(N) 预处理 O(1) 查询 |
| n 项线性递推第 n 项 | 矩阵快速幂 | O(k³ log n) |
本部分学习建议
- 先修知识:第 2.6 章(位运算)和第 3.2 章(前缀和)会让第 8.1-8.3 章的学习更顺畅,但不是硬性前置。
- 模运算代码一定要自己写一遍——
(a * b) % p的溢出陷阱(用long long还是被乘法中间结果坑)只有亲手调试过才记得住。 - 组合数学配合第 6.7 章(概率期望与计数 DP)食用更佳——本章提供公式工具,DP 章提供状态设计思路。
第 8.1 章:数论基础
8.1.0 从一道题出发:余数之谜
先看一道看似不可能的题目:
🔢 题目:大数幂取模 计算
3^1000000000 mod 1000000007(即 3 的十亿次方除以 10⁹+7 的余数)。 时间限制:1 秒。
先试试你会的方法
思路 1:直接乘? 把 3 自乘十亿次——每秒 10⁸ 次运算,也需要 10 秒。太慢。
思路 2:先算出 3^10⁹ 再取模? 3^10⁹ 有将近 5 亿位数字,long long 只能存 19 位。根本存不下。
思路 3:边乘边取模? result = result * 3 % p 循环十亿次——溢出问题解决了,但依然是 10⁹ 次循环,还是太慢。
这章要讲的快速幂能把十亿次乘法压缩到约 30 次。而在它背后,是一整套竞赛编程中最常用的数学工具:模运算、模逆元、GCD 与扩展欧几里得。
拆解这道题需要回答的问题
- 「边乘边取模」为什么是合法的?→ 模运算的运算性质
- 如何把 10⁹ 次乘法降到 30 次?→ 快速幂(二进制取幂)
- 模意义下怎么做除法?→ 模逆元
- 逆元什么时候存在?怎么求?→ 费马小定理 / 扩展欧几里得
- 化简分数、检验整除性还需要什么?→ GCD / LCM 与整数技巧
本章按这条线逐一展开:
| 小节 | 回答的问题 |
|---|---|
| 8.1.1 | 模运算的性质、负数陷阱、溢出 |
| 8.1.2 | 快速幂:O(log n) 计算大数幂取模 |
| 8.1.3 | 模逆元:模意义下的除法 |
| 8.1.4 | GCD/LCM 与扩展欧几里得 |
| 8.1.5 | 整数技巧:整除判定、整数平方根、上取整 |
学习目标:
- 正确实现模意义下的加、减、乘,避开负数与溢出陷阱
- 手写并理解快速幂,用于 a^n mod p(n ≤ 10¹⁸)
- 用费马小定理或扩展欧几里得求模逆元,并知道何时能用哪个
- 熟练使用 GCD/LCM 与常用整数技巧
8.1.1 模运算:竞赛中的「第四则运算」
为什么需要模运算?
很多题目要求输出「答案对 10⁹+7 取模」的结果。这并非随意为之——当答案极其庞大时,它是防止整数溢出的标准手段。
举个例子:「N 个元素的排列有多少种?」答案是 N!。当 N = 20 时,N! = 2,432,902,008,176,640,000,已接近 long long 的最大值(约 9.2 × 10¹⁸);当 N = 100 时,根本无法表示。
解决方案: 对一个素数 p(通常取 10⁹+7)取模,让所有运算在模意义下进行。
三条核心性质
这三条性质说:加、减、乘可以随时取模,结果不变。这就是「边乘边取模」合法的原因——中间结果永远小于 p,永远不会溢出。
但注意:除法不在名单里。(a / b) mod p ≠ (a mod p) / (b mod p)。模意义下的除法需要 8.1.3 节的模逆元。
负数取模陷阱
C++ 的 % 对负数的结果可能是负数:
// 解答:负数取模陷阱
#include <bits/stdc++.h>
using namespace std;
int main() {
int a = 3, b = 5, p = 7;
cout << (a - b) % p << "\n"; // 输出 -2,不是 5!
cout << ((a - b) % p + p) % p << "\n"; // 输出 5 ✓
return 0;
}
数学上 3 − 5 = −2 ≡ 5 (mod 7),但 C++ 直接给出 −2。做减法后取模,永远补一个 +p。
溢出:模运算的头号杀手
// 解答:模运算安全模板
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const ll MOD = 1e9 + 7; // 竞赛编程标准模数
// 安全加法
ll add_mod(ll a, ll b) {
return (a % MOD + b % MOD) % MOD;
}
// 安全减法(加 MOD 防止负数)
ll sub_mod(ll a, ll b) {
return ((a % MOD) - (b % MOD) + MOD) % MOD;
}
// 安全乘法
// 关键:取模后 a, b < 10^9+7,乘积 < 10^18,在 long long 范围内
ll mul_mod(ll a, ll b) {
return a % MOD * (b % MOD) % MOD;
}
int main() {
cout << mul_mod(1000000006, 1000000006) << "\n"; // = 1((-1)*(-1) = 1)
return 0;
}
两个要点:
- 只要做乘法就用
long long。 两个int相乘(各约 10⁹)的乘积是 10¹⁸,int直接溢出。 - 为什么偏偏选 10⁹+7? 它是素数(求逆元需要,见 8.1.3 节),且 (10⁹+7)² < 2⁶³——两个取模后的数相乘不会溢出
long long。10⁹ 就不行(不是素数)。
⚠️ 致命 Bug: 在 C++ 中,若
a < b,(a - b) % MOD可能为负数!请始终写成(a - b + MOD) % MOD。
8.1.2 快速幂:O(log n) 的幂运算
思想:反复平方
回到开篇的问题:计算 3^10⁹ mod p,能否远少于 10⁹ 次乘法?
关键观察:幂可以按二进制拆开。
3^10 = 3^(1010₂) = 3^8 × 3^2
只需求出 3¹, 3², 3⁴, 3⁸, ...(每次自乘即平方),再把指数二进制中为 1 的位对应的幂乘进结果。3^10⁹ 的指数有约 30 个二进制位,所以只需约 30 次平方 + 至多 30 次乘法。
计算 3^10 (指数 1010₂):
第 1 轮:位 0 = 0 → 底数平方:3 → 9
第 2 轮:位 1 = 1 → 结果乘底数:result = 9,底数平方:9 → 81
第 3 轮:位 2 = 0 → 底数平方:81 → 6561
第 4 轮:位 3 = 1 → 结果乘底数:result = 9 × 6561 = 59049 = 3^10 ✓
完整代码
// 解答:快速幂 — O(log n) 计算 a^n mod p
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
ll power(ll a, ll n, ll p) {
a %= p; // 先把底数压到 [0, p)
ll result = 1;
while (n > 0) {
if (n & 1) // 指数当前二进制位为 1
result = result * a % p;
a = a * a % p; // 底数平方:a 依次是 a^1, a^2, a^4, a^8, ...
n >>= 1; // 移到下一位
}
return result;
}
int main() {
cout << power(2, 10, 1000) << "\n"; // 2^10 = 1024 mod 1000 = 24
cout << power(3, 1000000000LL, 1000000007LL) << "\n"; // 开篇问题的答案
return 0;
}
正确性:为什么这样拆是对的?
把指数写成二进制 n = b_k·2^k + ... + b_1·2 + b_0,那么:
a^n = a^(b_k·2^k) × ... × a^(b_1·2) × a^(b_0)
第 i 轮循环时,a 恰好等于 a^(2^i)。若 b_i = 1,就把这个因子乘进 result。循环结束时,指数所有为 1 的位对应的因子都乘进去了,恰好是 a^n。中间每次乘法后立即取模,数值永远小于 p² ≈ 10¹⁸,不会溢出。
复杂度: 循环次数 = n 的二进制位数 = O(log n)。n = 10¹⁸ 也只需约 60 轮。
例题:开篇问题的解答
计算 3^1000000000 mod 1000000007。
一行代码:power(3, 1000000000, 1000000007),约 30 次循环,瞬间出答案。对比朴素的 10⁹ 次循环,快了约 3000 万倍。
8.1.3 模逆元:模意义下的除法
问题:除法不能直接取模
模运算的加、减、乘都满足「先取模再运算等价于先运算再取模」,唯独除法不行:
(6 / 2) mod 5 = 3
(6 mod 5) / (2 mod 5) = 1 / 2 = ??? ← 整数除法直接失真
可计数公式里偏偏到处是除法(C(n,k) = n! / (k!(n−k)!))。怎么办?
逆元的定义
b 的模逆元是一个数 b⁻¹,满足:
有了它,模意义下的除法就能转化为乘法:
a / b ≡ a × b⁻¹ (mod p)
逆元何时存在? 当且仅当 gcd(b, p) = 1。特别地,若 p 是素数且 0 < b < p,逆元一定存在——这就是题目偏爱素数模数的原因。
方法一:费马小定理(p 是素数时)
费马小定理: 若 p 是素数且 gcd(a, p) = 1,则 a^(p−1) ≡ 1 (mod p)。
两边同除一个 a:a^(p−2) ≡ a⁻¹ (mod p)。
于是一个 power 调用就能求出逆元:
// 解答:费马小定理求逆元 — O(log p)
ll mod_inv(ll a, ll p) {
return power(a, p - 2, p); // 仅当 p 为素数!
}
// 模意义下的除法
ll mod_div(ll a, ll b) {
return a % MOD * mod_inv(b, MOD) % MOD;
}
验证: p = 7,求 3⁻¹。3⁵ = 243 = 34×7 + 5 → 3⁻¹ ≡ 5 (mod 7)。检验:3 × 5 = 15 ≡ 1 (mod 7) ✓。
方法二:扩展欧几里得(任意模数)
若模数不是素数(例如 p = 10⁶ = 2⁶×5⁴),费马小定理失效,但只要 gcd(a, p) = 1,逆元仍存在。这时用扩展欧几里得算法(下一节详讲其原理):求 x, y 使 a·x + p·y = 1,则 a·x ≡ 1 (mod p),x 就是逆元。
// 解答:扩展欧几里得求逆元 — 任意模数
long long ext_gcd(long long a, long long b, long long& x, long long& y) {
if (b == 0) { x = 1; y = 0; return a; }
long long x1, y1;
long long g = ext_gcd(b, a % b, x1, y1);
x = y1;
y = x1 - (a / b) * y1;
return g;
}
long long mod_inv_general(long long a, long long m) {
long long x, y;
long long g = ext_gcd(a, m, x, y);
if (g != 1) return -1; // gcd(a,m) != 1,逆元不存在
return (x % m + m) % m; // x 可能是负数,拉回 [0, m)
}
何时能用哪个?
| 场景 | 方法 |
|---|---|
| p 是素数(10⁹+7、998244353 等) | 费马小定理:power(a, p-2, p),代码最短 |
| p 不是素数,但 gcd(a, p) = 1 | 扩展欧几里得 |
| gcd(a, p) ≠ 1 | 逆元不存在,除法本身无意义(需改写公式避开) |
竞赛中 99% 的题目模数都是 10⁹+7,直接用费马小定理即可。但要养成习惯:看到不认识的模数,先想想它是不是素数。
8.1.4 GCD / LCM 与扩展欧几里得
欧几里得算法(辗转相除)
两个数的最大公因数 gcd(a, b) 是能同时整除两者的最大整数。欧几里得算法基于一个简单的事实:
gcd(a, b) = gcd(b, a mod b) (b = 0 时 gcd(a, 0) = a)
每一步都让两数严格变小,且按斐波那契级别的速度收缩,复杂度 O(log min(a, b)):
gcd(48, 18) = gcd(18, 12) = gcd(12, 6) = gcd(6, 0) = 6
// 解答:GCD — O(log min(a,b)))
long long my_gcd(long long a, long long b) {
while (b != 0) {
a %= b;
swap(a, b);
}
return a;
}
// 实战中直接用 C++17 的 std::gcd(a, b)(<numeric>),或 __gcd(a, b)
LCM 与先除后乘
// 解答:LCM — 先除后乘防溢出
long long lcm(long long a, long long b) {
return a / gcd(a, b) * b; // 先除再乘!
// 错误写法 a * b / gcd(a, b):a*b 可能已溢出 long long
}
// a / gcd(a,b) 一定是整数,先除不损失精度;除完后再乘 b,量级可控
扩展欧几里得:求 ax + by = gcd(a, b) 的整数解
这是一个古老而强大的结论:对任意整数 a, b,一定存在整数 x, y 使 a·x + b·y = gcd(a, b)。
它在竞赛中的头号用途就是 8.1.3 节的求逆元:取 b = p,若 gcd(a, p) = 1,则 a·x + p·y = 1,即 a·x ≡ 1 (mod p)。
递归推导:设递归底层 b = 0 时取 x = 1, y = 0(此时 a·1 + 0·0 = a = gcd)。回溯时由 gcd(a, b) = gcd(b, a mod b) 可得解的回代公式:
下层解 (x1, y1) 满足 b·x1 + (a mod b)·y1 = g
由 a mod b = a − (a/b)·b 代入整理得:
x = y1
y = x1 − (a/b)·y1
// 解答:扩展欧几里得 — O(log min(a,b))
// 返回 gcd(a,b),并通过引用设置 x, y 使 a*x + b*y = gcd(a,b)
long long ext_gcd(long long a, long long b, long long &x, long long &y) {
if (b == 0) { x = 1; y = 0; return a; }
long long x1, y1;
long long g = ext_gcd(b, a % b, x1, y1);
x = y1;
y = x1 - (a / b) * y1;
return g;
}
int main() {
long long x, y;
long long g = ext_gcd(240, 46, x, y);
// 240x + 46y = 2,例如 x = -9, y = 47:240*(-9) + 46*47 = 2 ✓
printf("gcd=%lld, x=%lld, y=%lld\n", g, x, y);
return 0;
}
更一般的方程 ax + by = c: 有解当且仅当 gcd(a, b) 整除 c。有解时先求 ax + by = g 的解 (x₀, y₀),再整体乘 c/g。
8.1.5 整数技巧:不写浮点数的那份从容
整除判定(手工验算与暴力剪枝用)
| 除数 | 规则 |
|---|---|
| 2 | 末位为偶数 |
| 3 | 各位数字之和能被 3 整除 |
| 4 | 末两位组成的数能被 4 整除 |
| 5 | 末位为 0 或 5 |
| 9 | 各位数字之和能被 9 整除 |
| 11 | 各位数字的交替和能被 11 整除 |
向上取整除法:ceil(a/b)
正整数场景的高频写法,整数运算天然规避浮点误差:
// 解答:向上取整除法
long long ceil_div(long long a, long long b) {
return (a + b - 1) / b; // 等价于 (a - 1) / b + 1(a > 0)
}
// 例:把 10 个物品每箱装 3 个,需要 ceil_div(10, 3) = 4 个箱子
安全的整数平方根
sqrtl 的浮点结果在边界上可能差 1(如 n 恰是完全平方数时返回 x−1 或 x+1),务必修正:
// 解答:整数平方根 — 最大 x 使 x*x <= n
long long isqrt(long long n) {
long long x = sqrtl(n); // 浮点近似
while (x * x > n) x--; // 偏大则减
while ((x + 1) * (x + 1) <= n) x++; // 偏小则加
return x;
}
// 用途:试除判素数到 isqrt(n)、枚举 n 的因子对 (d, n/d)
同理,试除判素数只需检查 2 以及 3, 5, 7, ... 到 √n 的奇数——若 n 有大于 √n 的因子,必然配着一个小于 √n 的因子。
bool is_prime(long long n) {
if (n < 2) return false;
if (n == 2) return true;
if (n % 2 == 0) return false;
for (long long i = 3; i * i <= n; i += 2)
if (n % i == 0) return false;
return true;
}
📇 章末速查卡
| 操作 | 公式 / 代码 | 复杂度 |
|---|---|---|
| 模加 | (a % p + b % p) % p | O(1) |
| 模减 | ((a - b) % p + p) % p | O(1) |
| 模乘 | a % p * (b % p) % p(用 long long) | O(1) |
| 幂 | power(a, n, p)(快速幂) | O(log n) |
| 逆元(p 素数) | power(a, p - 2, p)(费马小定理) | O(log p) |
| 逆元(一般) | ext_gcd(a, p, x, y),取 (x % p + p) % p | O(log p) |
| gcd | std::gcd(a, b)(C++17) | O(log min(a,b)) |
| lcm | a / gcd(a, b) * b(先除后乘!) | O(log min(a,b)) |
| 上取整 | (a + b - 1) / b | O(1) |
| 整数平方根 | sqrtl + 邻域修正 | O(1) |
常用模数:
| 常量 | 数值 | 为何选它 |
|---|---|---|
1e9 + 7 | 1,000,000,007 | 素数;模后两数相乘不溢出 long long;使用最广 |
998244353 | 998,244,353 | 素数;NTT 友好(多项式运算) |
⚠️ 常见错误
a * b % MOD溢出:int相乘(各约 10⁹)必溢出。只要有乘法就用long long,写1LL * a * b % MOD。- 减法出负数:
(a - b) % MOD在 C++ 中可能为负。永远写(a - b + MOD) % MOD。 - 对非素数模数用费马小定理: 模数不是素数时
power(a, MOD-2, MOD)给出错误结果。看到非标准模数,先判断素数性,必要时改用ext_gcd。 - LCM 先乘后除:
a * b / gcd(a,b)中a*b可能溢出。先除后乘:a / gcd(a,b) * b。 - 逆元不存在时硬算: gcd(b, p) ≠ 1 时 b 无逆元(如 p = 4, b = 2)。此时需改写公式(约去公因子)避开除法。
- 模数 ≥ 2×10⁹ 时乘法溢出: 若 p 接近 10¹⁸,
a * a % p本身就溢出long long。用__int128做中间乘法:(__int128)a * b % p。
📋 章节小结
| 概念 | 一句话总结 |
|---|---|
| 模运算 | 加减乘可随时取模;除法需要逆元 |
| 快速幂 | 按指数二进制位反复平方,O(log n) |
| 模逆元 | b⁻¹ 使 b·b⁻¹ ≡ 1 (mod p);素数模数用费马小定理 |
| 扩展欧几里得 | 求 ax + by = gcd(a,b) 的整数解;任意模数求逆元 |
| GCD / LCM | 辗转相除 O(log);LCM 先除后乘 |
| 整数技巧 | 上取整、整数平方根——能用整数就不用浮点 |
下一章: 第 8.2 章:素数筛法与积性函数——批量判素数、质因数分解与欧拉 φ。
🏋️ 练习题
🟢 简单
8.1-E1. 大数幂取模
给定 a, n, p,计算 a^n mod p。
数据规模: 1 ≤ a ≤ 10⁹,1 ≤ n ≤ 10¹⁸,2 ≤ p ≤ 10⁹。
提示
快速幂模板原题。注意 n 用 long long 读入,循环内先 a %= p。
8.1-E2. 最简分数
给定 N 对分数 aᵢ/bᵢ,将每个分数约分成最简形式 p/q 后输出。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ aᵢ, bᵢ ≤ 10⁹。
提示
令 g = gcd(a, b),输出 a/g 与 b/g。注意约分后 b 可能为 1。
🟡 中等
8.1-M1. 模意义除法
给定 a, b 和素数 p,计算 (a / b) mod p(保证 p 不整除 b)。
数据规模: 1 ≤ a, b ≤ 10¹⁸,2 ≤ p ≤ 10⁹ + 7(p 为素数)。
提示
a mod p × b^(p−2) mod p。注意 a 高达 10¹⁸,读入用 long long,先取模再乘。
🔴 困难
8.1-H1. 巨大模数下的幂 (USACO Platinum 风格)
给定 a, n, p,计算 a^n mod p。
数据规模: 1 ≤ a ≤ 10¹⁸,1 ≤ n ≤ 10¹⁸,2 ≤ p ≤ 10¹⁸。
提示
p 本身接近 10¹⁸,快速幂里的 a * a % p 会溢出 long long。用 __int128 做中间乘法(或「龟速乘」:把乘法也按二进制拆成加法,O(log) 次模加)。
第 8.1 章结束 — 下一章:素数筛法与积性函数
第 8.2 章:素数筛法与积性函数
8.2.0 从一道题出发:数一数有多少素数
先看一道典型的 Gold 风格题目:
🌾 题目:素数普查 农夫 John 想知道
1到N(N ≤ 10⁷)之间一共有多少个素数。他还想知道其中每个数的最小质因子,以便快速对任意a ≤ N做质因数分解。
输入样例:
N = 20
期望输出:
20 以内有 8 个素数:2 3 5 7 11 13 17 19
先试试你会的方法
思路 1:对每个数 i ∈ [2, N],用试除法判素? 每次 O(√i),总计约 O(N√N)。N = 10⁷ 时 ≈ 3 × 10¹⁰ 次操作——太慢,需要 30 秒以上。
思路 2:换个方向——不去「判定」每个数,而是把合数「筛掉」? 从 2 开始,每遇到一个素数就把它的所有倍数标记为合数。没被标记的就是素数。这就是筛法,也是本章的主角。
而「同时求出最小质因子」「同时求出欧拉 φ 函数」这些进阶需求,会把我们引向欧拉线性筛——每个合数只被它的最小质因子筛掉一次,严格 O(N)。
拆解这道题需要回答的问题
- 单个数的素数判定怎么做最省?→ 试除法 O(√n)
- 「筛掉合数」的朴素做法及其复杂度?→ 埃拉托斯特尼筛 O(n log log n)
- 能否让每个合数只被筛一次?→ 欧拉线性筛 O(n)
- 顺手能求出哪些数论函数?→ 欧拉 φ、莫比乌斯 μ 等积性函数
- 「x 除以 3 余 2,除以 5 余 3」这类方程组怎么解?→ 中国剩余定理
本章按这条线逐一展开:
| 小节 | 回答的问题 |
|---|---|
| 8.2.1 | 试除法判素:朴素起点 |
| 8.2.2 | 埃拉托斯特尼筛 |
| 8.2.3 | 欧拉线性筛 + 逐步追踪 |
| 8.2.4 | 欧拉 φ 函数与线性筛求 φ |
| 8.2.5 | 积性函数:为什么线性筛能「顺手」求它们 |
| 8.2.6 | 中国剩余定理 |
学习目标:
- 用试除法在 O(√n) 内判定单个数的素性
- 实现埃筛与欧拉线性筛,理解后者为何严格 O(n)
- 用线性筛同时求出 1~n 的欧拉 φ 值
- 识别积性函数,并用 CRT 合并同余方程组
🔗 前置知识: 模运算、快速幂与模逆元见第 8.1 章。
8.2.1 试除法判定素数(O(√n))
判定单个数 n 是否为素数,最朴素的方法是枚举 [2, n−1] 看有没有因子——O(n)。但有一个关键观察:
若 n 是合数,它必然有一个 ≤ √n 的因子。 因为合数 n = a × b 中,a 和 b 不可能都大于 √n(否则乘积超过 n)。
所以只需枚举到 √n:
// 试除法判素 — O(√n)
bool isPrime(long long n) {
if (n < 2) return false;
if (n == 2) return true;
if (n % 2 == 0) return false;
for (long long i = 3; i * i <= n; i += 2) { // 只查奇数,次数减半
if (n % i == 0) return false;
}
return true;
}
两个细节:
- 循环条件用
i * i <= n而不是i <= sqrt(n)——浮点sqrt有精度误差,且每次调用更慢。注意i用long long,否则i * i在 i ≈ 46341 时溢出int。 - 先特判 2,再只枚举奇数——把循环次数直接砍半,这在 n ≈ 10¹⁸ 时省的不是一点半点。
试除法在「少量查询」时完全够用。但开篇题要处理 10⁷ 个数,每个都试除就是 3 × 10¹⁰ 次操作。我们需要换武器。
8.2.2 埃拉托斯特尼筛(O(n log log n))
核心思想反转:不问「i 是不是素数」,而是主动「把合数标记出来」。
- 从 2 开始,2 没被标记 → 2 是素数 → 标记 4, 6, 8, 10, ...
- 3 没被标记 → 3 是素数 → 标记 9, 12, 15, ...
- 4 已被标记 → 跳过
- ……以此类推
const int MAXN = 1e7 + 5;
bool is_composite[MAXN]; // false = 素数(默认值)
vector<int> primes;
void sieve(int n) {
for (int i = 2; i <= n; i++) {
if (!is_composite[i]) { // i 没被筛过 → i 是素数
primes.push_back(i);
for (long long j = (long long)i * i; j <= n; j += i)
is_composite[j] = true; // 筛掉 i 的倍数
}
}
}
三个必问的问题:
Q1:内层为什么从 i * i 开始,而不是 2 * i?
小于 i² 的倍数 2i, 3i, ..., (i−1)·i 已经被更小的素数筛过了。例如 i = 5 时,10、15、20 分别已被 2、3、2 标记,25 才是第一个「首次被 5 筛掉」的数。
Q2:复杂度为什么是 O(n log log n)?
总标记次数 = n/2 + n/3 + n/5 + n/7 + ...(对每个素数 p 标记 n/p 个倍数)≈ n · ln(ln(n))。由素数求和的调和级数估计得出。log log(10⁷) ≈ 2.9,实际跑起来接近线性。
Q3:j 为什么要声明成 long long?
i * i当 i ≈ 10⁵ 时已达 10¹⁰,用int直接溢出成负数,循环行为未定义。
埃筛简单、常数小,是绝大多数题目(「求 10⁶ 以内的素数」)的首选。但它有一个无法回避的缺陷——
一个合数会被重复标记。 比如 12 = 2×6 = 3×4,先被 2 筛一次,又被 3 筛一次;60 = 2²×3×5 会被 2、3、5 各筛一次。合数的质因子越多,被浪费的次数越多。如果题目还需要「最小质因子」或「积性函数值」,埃筛无法提供——而下面的线性筛一举解决所有问题。
8.2.3 欧拉线性筛(O(n))
目标:让每个合数只被筛一次——被它自己的最小质因子筛掉。
做法:外层枚举 i = 2..n;对每个 i,遍历目前已知素数表 primes,用 i * primes[j] 作为被筛掉的合数。关键的两条终止规则:
- 若
i * primes[j] > n,越界,跳出; - 若
i % primes[j] == 0,必须跳出——这是正确性的灵魂(下面解释)。
const int MAXN = 1e7 + 5;
int min_prime[MAXN]; // min_prime[i] = i 的最小质因子(素数则是自身)
vector<int> primes;
// 欧拉线性筛:O(n)
void sieve_linear(int n) {
for (int i = 2; i <= n; i++) {
if (min_prime[i] == 0) { // 0 表示还没被筛过 → i 是素数
min_prime[i] = i;
primes.push_back(i);
}
for (int p : primes) {
if ((long long)i * p > n) break; // 规则 1:越界
min_prime[i * p] = p; // p 是 i*p 的最小质因子
if (i % p == 0) break; // 规则 2:p 已是 i 的因子
}
}
}
为什么规则 2 保证「每个合数只筛一次」?
设合数 m = p × i,其中 p 是 m 的最小质因子。线性筛保证 m 只在「外层数 = m/p、内层素数 = p」这一刻被标记。反证:
- 若 m 还能写成 m = q × i'(q 为更大的素数,i' = m/q < m/p 对应的外层数),那么在处理外层 i' 时,会先遇到素数 p——而 p | i'(因为 p 是 m 的最小质因子且 p < q,p 必然整除 i')——触发规则 2 提前 break,根本轮不到 q。
一句话总结:外层 i 与内层 p 相乘时,只有当 p ≤ i 的最小质因子,乘积 i×p 的最小质因子才恰好是 p。 一旦 p 超过 i 的最小质因子,i×p 就「轮不到 p 来筛」,继续循环只会造成重复。
逐步追踪:n = 20
| 外层 i | 是否素数 | 内层标记(按序) | break 原因 |
|---|---|---|---|
| 2 | ✅ 加入 | 4 (=2×2) | i%2==0 |
| 3 | ✅ 加入 | 6 (=3×2), 9 (=3×3) | i%3==0 |
| 4 | ❌ | 8 (=4×2) | i%2==0(不能用 3:12 = 4×3 的最小质因子是 2,轮不到 3 筛) |
| 5 | ✅ 加入 | 10 (=5×2), 15 (=5×3) | 5×5=25 越界 |
| 6 | ❌ | 12 (=6×2) | i%2==0(12 只被 2 筛一次,不像埃筛还会被 3 筛) |
| 7 | ✅ 加入 | 14 (=7×2) | 21 越界 |
| 8 | ❌ | 16 (=8×2) | i%2==0 |
| 9 | ❌ | 18 (=9×2) | 27 越界(27 的确该由 3 筛:外层 9 内层 3 会轮到,只是这里 n=20 越界) |
| 10 | ❌ | 20 (=10×2) | i%2==0 |
| 11~19 | 11,13,17,19 ✅ | 22+ 均越界 | 越界 |
最终 primes = {2, 3, 5, 7, 11, 13, 17, 19}——8 个素数,与手算一致。每个合数恰好只出现一次在「内层标记」列里。
筛法对比
| 方法 | 时间复杂度 | 空间 | 何时用 |
|---|---|---|---|
| 试除法 | O(√n) 判单个 | O(1) | 少量查询、n 高达 10¹⁸ |
| 埃氏筛 | O(n log log n) | O(n) bitset 可压到 n/8 | 只需素数表,代码要短 |
| 欧拉线性筛 | O(n) | O(n) + 素数表 | 需要最小质因子 / 积性函数 |
附赠能力:O(log n) 质因数分解
有了 min_prime[],任意 x ≤ n 的分解只需不断除以最小质因子:
// x 的质因数分解 — O(log x)
vector<pair<int,int>> factorize(int x) {
vector<pair<int,int>> factors;
while (x > 1) {
int p = min_prime[x], cnt = 0;
while (x % p == 0) { x /= p; cnt++; }
factors.push_back({p, cnt});
}
return factors;
}
// factorize(360) = {(2,3), (3,2), (5,1)},即 360 = 2³ × 3² × 5
8.2.4 欧拉 φ 函数
φ(n) 统计 [1, n] 中与 n 互素(gcd(k, n) = 1)的整数个数:
φ(1) = 1
φ(2) = 1 (只有 1)
φ(6) = 2 (1 和 5)
φ(10) = 4 (1, 3, 7, 9)
φ(p) = p − 1 对任意素数 p(1..p−1 全部与 p 互素)
φ(p^k) = p^k − p^(k−1)
积性公式
若 n = p₁^a₁ × p₂^a₂ × ... × pₖ^aₖ,则:
例: φ(10) = 10 × (1 − 1/2) × (1 − 1/5) = 10 × 1/2 × 4/5 = 4 ✓
单值计算:O(√n)
试除法找质因子,边找边乘 (1 − 1/p)。注意用 result -= result / p 而不是浮点除法:
// 欧拉 φ 单值 — O(√n)
long long euler_phi(long long n) {
long long result = n;
for (long long p = 2; p * p <= n; p++) {
if (n % p == 0) {
while (n % p == 0) n /= p; // 除尽 p 的所有幂次
result -= result / p; // result *= (1 - 1/p)
}
}
if (n > 1) result -= result / n; // 剩下一个大质因子
return result;
}
线性筛同时求 φ(1..n):O(n)
单个求 φ 是 O(√n),求 1~n 全部就是 O(n√n)。但 φ 是积性函数(8.2.5 节),可以搭线性筛的便车,在筛的循环里顺手推出所有 φ 值:
const int MAXN = 1e7 + 5;
long long phi[MAXN];
int min_prime[MAXN];
vector<int> primes;
void sieve_phi(int n) {
for (int i = 2; i <= n; i++) {
if (min_prime[i] == 0) { // i 是素数
min_prime[i] = i;
phi[i] = i - 1; // 素数:φ(p) = p - 1
primes.push_back(i);
}
for (int p : primes) {
if ((long long)i * p > n) break;
min_prime[i * p] = p;
if (i % p == 0) {
// p | i:phi(p*i) = phi(i) * p(p 的幂次增加一层)
phi[i * p] = phi[i] * p;
break;
} else {
// gcd(i, p) = 1:积性 → phi(p*i) = phi(i) * (p-1)
phi[i * p] = phi[i] * (p - 1);
}
}
}
phi[1] = 1;
}
三种情况对应 φ 的三条性质:
| 情况 | 公式 | 例 |
|---|---|---|
| i 是素数 | φ(i) = i − 1 | φ(5) = 4 |
| p ∤ i(互素) | φ(i·p) = φ(i)·φ(p) = φ(i)·(p−1) | φ(6) = φ(2)·φ(3) = 1×2 |
| p | i(p 已是 i 的因子) | φ(i·p) = φ(i)·p | φ(4) = φ(2)·2 = 2;φ(8) = φ(4)·2 = 4 |
验证: sieve_phi(10) 后 φ = [1, 1, 2, 2, 4, 4, 2, 6, 4, 6, 4],其中 φ(10) = 4 ✓
φ 的经典应用
- 欧拉定理(费马小定理的推广):gcd(a, n) = 1 时,a^φ(n) ≡ 1 (mod n)。当 n 是素数时 φ(n) = n−1 退化为费马小定理——这正是第 8.1 章模逆元的理论基础。
- 降幂: 计算 a^b mod n(b 极大)时,若 gcd(a,n)=1,指数可以对 φ(n) 取模。
- 计数: 统计 1 ≤ a ≤ b ≤ n 且 gcd(a,b) = 1 的对数 = 1 + Σᵢ₌₂ⁿ φ(i)。
- Burnside 项链计数: 答案中出现 Σ φ(d),d 取遍 n 的因子。
8.2.5 积性函数:线性筛的通用引擎
线性筛之所以能「顺手」求 φ,是因为 φ 是积性函数:
定义: 若函数 f 满足 f(ab) = f(a)·f(b) 当 gcd(a, b) = 1,则称 f 为积性函数。 若对所有 a, b 都成立(不要求互素),则称完全积性函数。
常见积性函数速览
| 函数 | 定义 | 完全积性? | 备注 |
|---|---|---|---|
| 恒等函数 id(n) = n | — | ✅ | |
| 常数函数 1(n) = 1 | — | ✅ | |
| 欧拉 φ | [1,n] 中与 n 互素的个数 | ❌ | φ(4) = 2 ≠ φ(2)·φ(2) = 1 |
| 莫比乌斯 μ | μ(n) = 0(有平方因子);(−1)^k(k 个不同质因子) | ❌ | 容斥的代数化 |
| 约数个数 d(n) | n 的因子个数 | ❌ | n=Πpᵃⁱ 时 d = Π(aᵢ+1) |
| 约数和 σ(n) | n 的因子之和 | ❌ |
为什么积性函数都能用线性筛求?
回顾线性筛标记每个合数 m = i × p 的两个分支:
- p ∤ i(gcd(i, p) = 1):由积性,f(m) = f(i)·f(p)——两个已知值相乘;
- p | i:m 与 i 只差一个 p 的幂次,通常存在只依赖 p 的简单递推(如 φ(i·p) = φ(i)·p)。
再加上 f 在素数处的取值往往有封闭形式(φ(p) = p−1、μ(p) = −1),三条信息合起来,线性筛就能以 O(n) 推出整个函数值表。模板结构完全同 8.2.4,只改三个分支的公式。
在 USACO Gold 中最常考的就是 φ;μ 与容斥结合(莫比乌斯反演)多见于 Platinum。
8.2.6 中国剩余定理(CRT)
「一个数除以 3 余 2,除以 5 余 3,除以 7 余 2,问这个数是多少?」——《孙子算经》(约公元 4 世纪)
中国剩余定理(CRT): 若模数 m₁, m₂, ..., mₖ 两两互素,则同余方程组
x ≡ r₁ (mod m₁)
x ≡ r₂ (mod m₂)
...
x ≡ rₖ (mod mₖ)
在模 M = m₁m₂...mₖ 意义下存在唯一解。
合并思路(两方程)
对 x ≡ r₁ (mod m₁)、x ≡ r₂ (mod m₂),gcd(m₁, m₂) = 1:
- 写 x = r₁ + m₁·k;
- 代入第二式:m₁·k ≡ r₂ − r₁ (mod m₂);
- 两边乘 m₁ 的模逆元:k ≡ (r₂ − r₁)·m₁⁻¹ (mod m₂);
- 取最小的 k,得 x = r₁ + m₁·k,落在 [0, m₁m₂) 内。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
// 快速幂 — 见第 8.1 章
ll power(ll a, ll n, ll p) {
a %= p;
ll result = 1;
while (n > 0) {
if (n & 1) result = result * a % p;
a = a * a % p;
n >>= 1;
}
return result;
}
// 模逆元(m 为素数时用费马小定理;这里 m1、m2 互素且各自是素数或与 m2 互素即可)
// 通用做法:扩展欧几里得。此处给 extgcd 版本,对任意互素模数都正确。
ll ext_gcd(ll a, ll b, ll &x, ll &y) {
if (b == 0) { x = 1; y = 0; return a; }
ll x1, y1;
ll g = ext_gcd(b, a % b, x1, y1);
x = y1;
y = x1 - (a / b) * y1;
return g;
}
ll mod_inv(ll a, ll m) { // a 与 m 互素
ll x, y;
ext_gcd(a, m, x, y);
return (x % m + m) % m;
}
// 两方程 CRT(要求 gcd(m1, m2) = 1),返回 [0, m1*m2) 内的唯一解
ll crt(ll r1, ll m1, ll r2, ll m2) {
ll k = (r2 - r1 % m2 + m2) % m2 * mod_inv(m1 % m2, m2) % m2;
return r1 + m1 * k;
}
// 多方程:迭代两两合并,返回 {x, lcm};无解返回 {-1, -1}
pair<ll, ll> crt_multi(vector<ll> r, vector<ll> m) {
ll cur_r = r[0], cur_m = m[0];
for (int i = 1; i < (int)r.size(); i++) {
// 广义合并(允许模数不互素)
ll g = __gcd(cur_m, m[i]);
if ((r[i] - cur_r) % g != 0) return {-1, -1}; // 无解
ll lcm = cur_m / g * m[i];
ll diff = (r[i] - cur_r) / g;
ll m2g = m[i] / g;
ll k = diff % m2g * mod_inv(cur_m / g % m2g, m2g) % m2g;
cur_r = ((cur_r + cur_m % lcm * ((k % lcm + lcm) % lcm)) % lcm + lcm) % lcm;
// 简化写法:cur_r = (cur_r + cur_m * k) % lcm(cur_m*k 可能需 __int128)
cur_m = lcm;
}
return {cur_r, cur_m};
}
int main() {
// 孙子算经:x ≡ 2 (mod 3), x ≡ 3 (mod 5), x ≡ 2 (mod 7)
auto [x, M] = crt_multi({2, 3, 2}, {3, 5, 7});
cout << "x = " << x << " (mod " << M << ")" << endl; // x = 23 (mod 105)
return 0;
}
手算验证: 23 mod 3 = 2 ✓,23 mod 5 = 3 ✓,23 mod 7 = 2 ✓。
USACO CRT 题型模式
「某事件每 A 天发生一次(今天余 r₁ 天)、另一事件每 B 天一次……它们何时首次同时发生?」
就是解 x ≡ r₁ (mod A)、x ≡ r₂ (mod B)……用 crt_multi 迭代合并即可。注意模数不互素时解可能不存在——广义版本已通过 gcd 判断。
⚠️ 常见错误
| 错误 | 后果 | 修复 |
|---|---|---|
线性筛内层先判 i % p == 0 再记录 | 漏筛(i×p 本该由 p 筛掉) | 先记 min_prime[i*p] = p,再判 i % p == 0 决定 break,顺序不能反 |
线性筛 i * p 用 int 计算 | i ≈ 10⁵ 时溢出为负,数组越界 | 写 (long long)i * p > n |
埃筛内层从 2*i 起且 j 为 int | 溢出 + 重复标记浪费 | 从 i*i 起,j 用 long long |
phi[1] 忘记初始化 | phi[1] = 0,但正确值是 1 | 循环从 2 开始,显式补 phi[1] = 1 |
φ 递推中 p | i 分支写成 phi[i]*(p-1) | 混淆两个分支(如 φ(4) 会得 2×1=2 碰巧对,但 φ(8) 得 φ(4)×1 = 2 ≠ 4) | 牢记:p ∤ i 时乘 (p−1),p | i 时乘 p |
CRT 中 (r2 - r1) 为负直接取模 | 负数取模结果为负 | (r2 - r1 % m2 + m2) % m2 |
CRT 结果 m1 * k 溢出 | m₁·m₂ > 9.2×10¹⁸ 时爆 long long | 用 __int128 做中间乘法 |
📋 章节小结
| 工具 | 复杂度 | 一句话 |
|---|---|---|
| 试除法 | O(√n)/次 | 单个数判定,n 可达 10¹⁸ |
| 埃氏筛 | O(n log log n) | 简单快,但合数被重复筛 |
| 欧拉线性筛 | O(n) | 每个合数只被最小质因子筛一次 |
| min_prime 分解 | O(log n)/次 | 筛后免费获得的质因数分解 |
| φ 单值 / 筛求 | O(√n) / O(n) | φ(n) = n·Π(1−1/p),积性 |
| 积性函数通筛 | O(n) | 三分支:素数处 / 互素处 / 幂次处 |
| CRT | O(k log M) | 同余方程组合并,互素唯一解 |
🔗 与后续章节的联系
- 第 8.3 章(组合数学): 容斥 + 素数筛是「整除计数」题的黄金组合;Burnside 引理(用到 φ)出现在项链计数中。
- 第 8.1 章(数论基础): 欧拉定理 a^φ(n) ≡ 1 是费马小定理的推广,逆元求法由此而来。
- 第 8.4 章(矩阵快速幂): 与本章的降幂技巧配合处理「超大指数 + 取模」。
🏋️ 练习题
🟢 基础
8.2-P1. 第 10⁷ 个以内的素数个数
用欧拉线性筛统计并输出 1 到 10⁷ 中素数的个数,以及 10⁷ 以内最大的素数。
提示
sieve_linear(10000000) 后输出 primes.size()(应为 620648 与……直接跑)和 primes.back()。注意数组开 1e7 + 5。
8.2-P2. 质因数分解器
给定 T(≤ 10⁵)个整数 aᵢ(≤ 10⁷),对每个输出形如 2^3 * 3^2 * 5 的质因数分解。
提示
先 sieve_linear(1e7) 建好 min_prime,每个查询用 8.2.3 的 factorize,单次 O(log a)。总复杂度 O(N + T log N)。
🟡 中等
8.2-P3. 互素对计数
统计满足 1 ≤ a ≤ b ≤ n 的互素对 (a, b) 个数,n ≤ 10⁶,答案 mod 10⁹+7。
提示
互素对数 = 1 + Σᵢ₌₂ⁿ φ(i)("+1" 是 (1,1) 这一对)。用 sieve_phi(n) 一遍扫出。用 long long 累加,n = 10⁶ 时答案约 2×10¹¹。
🔴 困难
8.2-P4. 三个时钟 (CRT)
某星球有三个周期事件:事件 A 每 4 小时于第 3 小时发生(x ≡ 3 mod 4),事件 B 满足 x ≡ 5 (mod 7),事件 C 满足 x ≡ 1 (mod 9)。求三者首次同时发生的时刻 x(模 252 意义下的最小非负解)。
提示
crt_multi({3, 5, 1}, {4, 7, 9})。手算可以先合并前两个:x ≡ 3 (mod 4) 与 x ≡ 5 (mod 7) → x ≡ 19 (mod 28);再与 x ≡ 1 (mod 9) 合并 → 验证答案对 4、7、9 的余数。
第 8.3 章:组合数学
8.3.0 从一道题出发:安排奶牛进栏
先看一道典型的 Gold 风格题目:
🌾 题目:奶牛分栏 农夫 John 有
N头两两不同的奶牛和K个不同的牛栏(K < N)。他要从中选出K头奶牛,分别关进K个牛栏(每栏恰好一头)。 问:有多少种安排方案?答案对10⁹ + 7取模。
输入样例:
N = 10, K = 3
先试试你会的方法
思路 1:暴力枚举? 从 10 头中选 3 头有 C(10,3) = 120 种选法,每种里 3 头奶牛分到 3 个栏又有 3! = 6 种安排——总共 720。N 再大一点呢?C(100, 50) 有 30 位数字,枚举到宇宙热寂也数不完。
思路 2:找到「计数公式」? 「选 K 头 + 有序安排」恰好是排列数 P(N, K) = N!/(N−K)!。问题转化为:如何计算一个巨大的阶乘表达式对素数取模的值?除法在模意义下怎么做?
拆解这道题需要回答的问题
- 计数的基本原理是什么?→ 加法原理与乘法原理
- 模意义下的除法怎么做?→ 模逆元(第 8.1 章)
- C(n, k) 有几种高效算法?→ 杨辉三角 / 单次逆元 / 阶乘预处理
- 「n 个相同球放 k 个盒」怎么数?→ 隔板法
- 「至少满足一个条件」怎么数?→ 容斥原理
- USACO Gold 怎么包装这些?→ 8.3.6 节的题型模式
| 小节 | 回答的问题 |
|---|---|
| 8.3.1 | 加法/乘法原理,排列与组合 |
| 8.3.2 | C(n,k) 的三种求法(含完整代码) |
| 8.3.3 | 常用公式与恒等式大表 |
| 8.3.4 | 隔板法与鸽巢原理 |
| 8.3.5 | 容斥原理:并集、错排、例题 |
| 8.3.6 | USACO Gold 数学题型模式 |
学习目标:
- 区分排列与组合,正确选用加法/乘法原理
- 实现三种 C(n,k) mod p 算法并知道各自适用场景
- 用隔板法解决「相同物品分组」计数
- 用容斥原理处理「至少/至多」约束
🔗 前置知识: 模运算、快速幂与模逆元已在第 8.1 章讲过,本章直接使用
power(a, MOD-2)求逆元,不再重复推导。
8.3.1 加法/乘法原理与排列组合
一切计数都建立在两条公理上:
- 加法原理: 做一件事有若干互斥的途径,方案数 = 各途径方案数之和。(去 A 餐厅有 3 种路线,去 B 餐厅有 4 种,选一家 → 3 + 4 = 7 种)
- 乘法原理: 做一件事分若干相继的步骤,方案数 = 各步骤方案数之积。(上衣 3 件、裤子 4 条 → 3 × 4 = 12 套搭配)
排列与组合
| 名称 | 记号 | 定义 | 公式 |
|---|---|---|---|
| 排列 | P(n, k) 或 A(n, k) | 从 n 个不同物品中有序取 k 个 | n! / (n−k)! |
| 组合 | C(n, k) | 从 n 个不同物品中无序选 k 个 | n! / (k!(n−k)!) |
| (可重)排列 | nᵏ | k 个物品放入 n 个位置,可重复 | nᵏ |
关系:P(n, k) = C(n, k) × k! ——「先无序选,再排顺序」。
开篇题的答案就是 P(10, 3) = 10! / 7! = 720,与暴力枚举一致 ✓。
基本性质(后面反复用):
- C(n, 0) = C(n, n) = 1
- 对称性: C(n, k) = C(n, n−k)
- 吸收律: C(n, k) = (n/k) · C(n−1, k−1)
- 帕斯卡递推: C(n, k) = C(n−1, k−1) + C(n−1, k)(「含不含某个特定元素」二分)
8.3.2 C(n, k) 的三种求法
方法一:杨辉三角 DP(无除法,n, k ≤ 2000)
用帕斯卡递推逐行填表。不需要逆元——连模数不是素数都能用——但 O(n²) 的时空限制了规模。
const long long MOD = 1e9 + 7;
long long dp[2001][2001];
void precompute_pascal(int maxn) {
for (int i = 0; i <= maxn; i++) {
dp[i][0] = 1;
for (int j = 1; j <= i; j++)
dp[i][j] = (dp[i-1][j-1] + dp[i-1][j]) % MOD;
}
}
// 查询:C(n, k) = dp[n][k]
方法二:单次逆元法(n 任意大,k ≤ 10⁶)
把公式 C(n, k) = n·(n−1)···(n−k+1) / k! 拆成「k 项分子连乘 × (k!)⁻¹」:
typedef long long ll;
const ll MOD = 1e9 + 7;
ll power(ll a, ll n, ll p) { // 快速幂 — 见第 8.1 章
a %= p;
ll result = 1;
while (n > 0) {
if (n & 1) result = result * a % p;
a = a * a % p;
n >>= 1;
}
return result;
}
// 单次计算 C(n, k) mod p — O(k log p)
ll C_single(ll n, ll k) {
if (k < 0 || k > n) return 0;
k = min(k, n - k); // 用对称性减少循环次数
ll num = 1, den = 1;
for (ll i = 0; i < k; i++) {
num = num * ((n - i) % MOD) % MOD;
den = den * ((i + 1) % MOD) % MOD;
}
return num * power(den, MOD - 2, MOD) % MOD;
}
// C_single(10, 3) = 120 ✓
适用:n 可以高达 10¹⁸(n 只出现在分子乘积里,对 MOD 取模即可),但要求 k 较小。
方法三:预处理阶乘 + 逆元(O(N) 预处理,O(1) 查询)——竞赛标配
当查询次数很多(如 T ≤ 10⁶ 次,n ≤ 10⁶)时,先把阶乘表和逆阶乘表建好:
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const int MAXN = 1e6 + 5;
const ll MOD = 1e9 + 7;
ll fact[MAXN], inv_fact[MAXN];
ll power(ll a, ll n, ll p) { // 快速幂 — 见第 8.1 章
a %= p;
ll result = 1;
while (n > 0) {
if (n & 1) result = result * a % p;
a = a * a % p;
n >>= 1;
}
return result;
}
// O(N) 预处理 fact[] 与 inv_fact[]
void precompute_factorials(int n) {
fact[0] = 1;
for (int i = 1; i <= n; i++)
fact[i] = fact[i-1] * i % MOD;
// 关键技巧:先花一次 O(log p) 求出 inv_fact[n],
// 再用 inv_fact[i] = inv_fact[i+1] * (i+1) 倒序推出全部 —— 省掉 N 次快速幂
inv_fact[n] = power(fact[n], MOD - 2, MOD); // 费马小定理(第 8.1 章)
for (int i = n - 1; i >= 0; i--)
inv_fact[i] = inv_fact[i+1] * (i+1) % MOD;
}
// O(1) 查询 C(n, k) mod p
ll C(int n, int k) {
if (k < 0 || k > n || n < 0) return 0; // 边界保护必须有!
return fact[n] * inv_fact[k] % MOD * inv_fact[n-k] % MOD;
}
// 顺便可得排列数 P(n, k) = n! / (n-k)!
ll P(int n, int k) {
if (k < 0 || k > n) return 0;
return fact[n] * inv_fact[n-k] % MOD;
}
int main() {
precompute_factorials(1e6);
cout << C(10, 3) << "\n"; // 120
cout << C(100, 50) << "\n"; // 538992043(mod 1e9+7)
cout << P(10, 3) << "\n"; // 720 —— 开篇题的答案
return 0;
}
倒序递推 inv_fact 的原理:1/i! = 1/(i+1)! × (i+1)。这样 N 次逆元只花 一次快速幂的代价。
三种方法对比
| 方法 | 预处理 | 单次查询 | 限制 | 场景 |
|---|---|---|---|---|
| 杨辉三角 | O(n²) | O(1) | n ≤ 2000(内存) | 模数非素数 / 需要整张表 |
| 单次逆元 | 无 | O(k log p) | k 小 | n 巨大(10¹⁸)、查询少 |
| 阶乘预处理 | O(N) | O(1) | N ≤ 10⁶ 左右 | 绝大多数计数题 |
💡 进阶(Platinum): 当 n 极大(10¹²+)而素数模数 p 较小(< 10⁶)时,用 Lucas 定理:C(n,k) mod p = C(n mod p, k mod p) × C(n/p, k/p) mod p,递归分解。
8.3.3 常用公式与恒等式(大表)
计数公式表
| 公式 | 数值 | 含义 |
|---|---|---|
| C(n, k) | n! / (k!(n−k)!) | 从 n 个不同物品中无序选 k 个 |
| P(n, k) | n! / (n−k)! | 从 n 个不同物品中有序选 k 个 |
| nᵏ | nᵏ | 将 k 个不同物品放入 n 个不同盒子(可重复) |
| C(n+k−1, k) | (n+k−1)!/(k!(n−1)!) | 隔板法:k 个相同球放 n 个不同盒(可空) |
| n! / (a!·b!·c!···) | — | 多项式系数:排列含 a 个 A 类、b 个 B 类……的物品 |
| C(2n, n) / (n+1) | 卡特兰数 Catₙ | 合法括号序列、二叉树形态、不出对角线的路径 |
恒等式表
| 恒等式 | 名称 | 用途 |
|---|---|---|
| Σₖ₌₀ⁿ C(n, k) = 2ⁿ | 二项式定理(x=y=1) | 子集总数 |
| Σₖ C(n, 2k) = Σₖ C(n, 2k+1) = 2ⁿ⁻¹ | 奇偶二分 | — |
| C(n, k) = C(n−1, k−1) + C(n−1, k) | 帕斯卡递推 | DP 转移的基础 |
| Σₖ₌₀ʳ C(m, k)·C(n, r−k) = C(m+n, r) | 范德蒙德 | 「从两组人里共选 r 个」 |
| Σₖ₌₀ⁿ C(r+k, k) = C(n+r+1, n) | 曲棍球 | 组合前缀和、二维路径计数 |
| k·C(n, k) = n·C(n−1, k−1) | 吸收律 | 期望/求和题消去因子 |
卡特兰数在 USACO 中出现频率出人意料地高(括号序列、出栈序列、多边形三角剖分、避开对角线的网格路径):
// 卡特兰数 Cat_n = C(2n, n) / (n+1) —— 依赖 8.3.2 的 C() 与预处理
ll catalan(int n) {
return C(2*n, n) % MOD * power(n + 1, MOD - 2, MOD) % MOD;
}
// Cat_0=1, Cat_1=1, Cat_2=2, Cat_3=5, Cat_4=14, Cat_5=42, ...
8.3.4 隔板法与鸽巢原理
隔板法(Stars and Bars)
n 个相同的球放进 k 个不同的盒子,盒子可空,有多少种放法?
把球排成一行(n 个 ★),在球与球之间及两端共 n+k−1 个位置中选 k−1 个插入隔板 ▏,每相邻两隔板间的球数即一个盒子的球数:
★ ★ ▏ ★ ★ ★ ▏ ▏ ★ → 盒1=2, 盒2=3, 盒3=0, 盒4=1
「每盒至少一个」的版本: 先每盒垫 1 个球(用掉 k 个),剩下 n−k 个随便放 → C(n−1, k−1)。也可以直接理解为隔板必须插在球与球之间、不能相邻。
例: 把 7 份相同的草料分给 3 头奶牛,允许有奶牛分不到 → C(9, 2) = 36 种。
鸽巢原理
把 n+1 个物品放进 n 个盒子,必有某个盒子里至少有 2 个物品。
看似显然,却是一类「证明存在性」题的钥匙。竞赛中的典型用法:
- 任意 13 个人中,必有两人出生月份相同(12 个「盒子」)。
- 从 1..2n 中任取 n+1 个数,必有一个整除另一个(按「奇数部分」装盒:每个数写成 2^a·q,q 为奇数,只有 n 个盒子)。
- 区间和问题:n 个前缀和 mod n,要么有 0 要么有两个相同 → 必存在连续区间和被 n 整除。
鸽巢只保证存在,不告诉你是哪个——它用于证明和构造性下界,不用于计数。
8.3.5 容斥原理
从两个集合到三个集合
计数「至少属于一个集合」的元素时,直接相加会重复,需要交替减加:
|A ∪ B| = |A| + |B| − |A ∩ B|
|A ∪ B ∪ C| = |A| + |B| + |C|
− |A∩B| − |A∩C| − |B∩C|
+ |A∩B∩C|
三个集合的直观解释:加单集时,恰好属于两个集合的元素被数了 2 次(多 1 次,减去二元交补回);三集合交的元素被数了 3 次、又被减了 3 次(净 0 次,加回三元交)。
推广到 n 个集合:
子集数量为 2ⁿ,当 n 较小时用位掩码枚举所有交集。
经典例题 1:整除计数
1 到 N 中有多少个数能被 a 或 b 整除?
- |被 a 整除| = ⌊N/a⌋,|被 b 整除| = ⌊N/b⌋,|同时被整除| = ⌊N/lcm(a,b)⌋
- 答案 = ⌊N/a⌋ + ⌊N/b⌋ − ⌊N/lcm(a,b)⌋
手算验证: N = 20, a = 3, b = 5。⌊20/3⌋ + ⌊20/5⌋ − ⌊20/15⌋ = 6 + 4 − 1 = 9。枚举:3,5,6,9,10,12,15,18,20——正好 9 个 ✓。
// 1..n 中能被 k 个给定数 {a1..ak} 之一整除的个数(k ≤ 20,位掩码容斥)
long long count_divisible(long long n, vector<long long>& a) {
int k = a.size();
long long ans = 0;
for (int mask = 1; mask < (1 << k); mask++) {
long long lcm = 1;
for (int i = 0; i < k; i++)
if (mask & (1 << i)) {
lcm = lcm / __gcd(lcm, a[i]) * a[i];
if (lcm > n) break; // 提前剪枝,防溢出
}
if (lcm > n) continue;
if (__builtin_popcount(mask) % 2 == 1) ans += n / lcm; // 奇数加
else ans -= n / lcm; // 偶数减
}
return ans;
}
经典例题 2:「每个值都出现」的序列计数
统计长度为 N 的序列(元素取 1..M),使得 1..K 中每个值至少出现一次。N, M ≤ 10⁶,K ≤ M。
直接数「每个都出现」很难,反过来对「缺失的值」容斥:
答案 = Σ_{j=0}^{K} (−1)ʲ × C(K, j) × (M−j)ᴺ
- 选 j 个值禁止出现:C(K, j) 种选法;
- 剩下 M−j 个值随便填 N 个位置:(M−j)ᴺ 种;
- 奇偶交替加减,恰好把「缺 1 个」「缺 2 个」……的多算全部抵消。
// 依赖 8.3.2 的 C() 与 power()
long long count_surjective(int n, int m, int k) {
long long ans = 0;
for (int j = 0; j <= k; j++) {
long long term = C(k, j) * power(m - j, n, MOD) % MOD;
if (j % 2 == 0) ans = (ans + term) % MOD;
else ans = (ans - term + MOD) % MOD; // 加 MOD 防负!
}
return ans;
}
经典例题 3:错排(Derangement)
n 个人交换帽子,每人都不拿回自己帽子的方案数 Dₙ。
对「至少一人拿回自己的帽子」容斥,得到:
更实用的是递推:Dₙ = (n−1)(Dₙ₋₁ + Dₙ₋₂),D₁ = 0,D₂ = 1。验证:D₃ = 2×(0+1) = 2(3 顶帽子全错位确实只有 2 种)。
8.3.6 USACO Gold 数学题型模式
模式 1:用 DP 计数
「统计长度为 N 的合法序列数,每个元素从 1..M 选取并满足约束。」
当约束有复杂的相邻依赖(如「相邻元素不同」「前缀和限制」)时,封闭公式难找,建模为 DP:dp[i][状态] = 以某状态结尾的长度 i 序列数,转移用乘法原理,答案取模。组合数学提供公式,DP 提供状态设计——两者常常结合:先用 DP 建表,再用组合数求和(另见第 6.7 章计数 DP)。
模式 2:整除约束 + 容斥
「1 到 N 中有多少数至少能被 {a₁, ..., aₖ} 之一整除?」
容斥:Σ⌊N/aᵢ⌋ − Σ⌊N/lcm(aᵢ,aⱼ)⌋ + ...,位掩码枚举(k ≤ 20),见 8.3.5 例题 1。注意 lcm 会在 20 个数时爆 long long,需边乘边与 N 比较、及时剪枝。
// 基础积木:n 以内 m 的倍数个数
long long count_multiples(long long n, long long m) { return n / m; }
模式 3:隔板法(Stars and Bars)
「将 N 个相同物品分配到 K 个盒子,满足某些约束。」
无约束:C(N+K−1, K−1)。有「每盒至多 X 个」的约束:转换成「至少」再用容斥,或生成函数。识别信号:题面出现「相同的」「非负整数解」「恰好分完」。
模式 4:对称性 / Burnside 引理
「统计不同的项链/着色方案数(旋转或翻转等价的视为相同)。」
Burnside 引理:等价类数 = 每个群元素不动点数的平均值。对旋转群,旋转 d 步的不动点数为 K^gcd(n,d)(n 珠 K 色),于是:
项链数 = (1/n) × Σ_{d=0}^{n-1} K^gcd(n, d)
USACO Gold 中不常见但一出现就令人印象深刻;与第 8.2 章的欧拉 φ(Σ φ(d)·K^(n/d)/n 形式)联动。
⚠️ 常见错误
| 错误 | 后果 | 修复 |
|---|---|---|
a * b % MOD 用 int 计算 | 10⁹ × 10⁹ 溢出 | 全程 long long;竞赛代码里只要有乘法就用 ll |
减法 (a - b) % MOD 出负数 | 结果为负或 WA | 写成 (a - b + MOD) % MOD |
| 容斥符号方向搞反 | 答案为负或偏大 | 奇数大小子集加,偶数大小子集减,与 popcount % 2 对应 |
| C(n,k) 不查 k < 0 或 k > n | 数组越界 / 野值 | 函数入口 if (k < 0 || k > n || n < 0) return 0; |
| 对非素数模数用费马小定理 | 逆元算错 | 模数不是 10⁹+7/998244353 时先验证素性;非素数改用扩展欧几里得(第 8.1 章) |
| 隔板法忘「可空/非空」区别 | 差一个 C 的偏移 | 可空 C(n+k−1, k−1);每盒至少 1 个 C(n−1, k−1) |
| 容斥的 lcm 溢出 | 20 个小数的 lcm 爆 ll | 边算 lcm 边与 n 比较,超界即剪枝 |
📋 章节小结
| 工具 | 复杂度 | 一句话 |
|---|---|---|
| 杨辉三角 C(n,k) | O(n²) 预处理 | 免逆元,n ≤ 2000 |
| 单次逆元 C(n,k) | O(k log p) | n 可达 10¹⁸ |
| 阶乘 + 逆元预处理 | O(N) 预处理 / O(1) 查询 | 计数题标配 |
| 隔板法 | O(1)(一个组合数) | 相同物品分组 |
| 容斥原理 | O(2ᵏ) | 「至少一个满足」类约束 |
| 错排 Dₙ | 递推 O(n) | Dₙ = (n−1)(Dₙ₋₁+Dₙ₋₂) |
| 卡特兰数 | O(1) 查询 | C(2n,n)/(n+1),括号/路径/树 |
❓ 常见问题
Q:怎么判断一道题用组合公式还是 DP? A:约束「漂亮」(无相邻依赖)且有封闭形式 → 组合公式;约束复杂纠缠 → DP。实际常常组合:DP 建表 + 组合数求和。
Q:USACO 中最常见的模数? A:10⁹ + 7(素数),偶尔 998244353(素数,NTT 友好)。两者都能用费马小定理求逆元。
🔗 与后续章节的联系
- 第 8.1 章(数论基础): 本章所有除法都靠那里的模逆元。
- 第 6.7 章(计数 DP): 本章提供公式工具,该章提供状态设计思路。
- 第 8.2 章(筛法): 「1..N 中与 k 互素的数」= 容斥(用 k 的质因子)+ 筛法分解——两章的组合拳。
🏋️ 练习题
🟢 基础
8.3-P1. 网格路径计数
统计从 (0,0) 走到 (n, m) 的路径数(每步向右或向上),n, m ≤ 10⁶,答案 mod 10⁹+7。
提示
路径 = n+m 步中选 n 步向右 → C(n+m, n)。用阶乘预处理 O(1) 查询。
8.3-P2. 分草料
把 7 份相同的草料全部分给 3 头奶牛,每头至少 1 份,有多少种分法?先手算,再用 C() 验证。
提示
每盒非空隔板法:C(6, 2) = 15。
🟡 中等
8.3-P3. 缺失值容斥
统计长度为 N=3、元素取自 {1..M=2}、且 K=2 个值都至少出现一次的序列数(mod 10⁹+7)。先手算,再用 count_surjective 验证。
提示
手算:只有 (1,2,1),(1,2,2),(2,1,1),(2,1,2),(1,1,2),(2,2,1) 共 6 种 = 2³ − 2。容斥:C(2,0)·2³ − C(2,1)·1³ = 8 − 2 = 6 ✓
8.3-P4. 至多容斥变体
1 到 1000 中,既不被 3 整除也不被 7 整除的数有多少个?
提示
补集:1000 − (⌊1000/3⌋ + ⌊1000/7⌋ − ⌊1000/21⌋) = 1000 − (333 + 142 − 47) = 572。
🔴 困难
8.3-P5. 合法括号序列
统计长度为 2n(n ≤ 10⁶)的合法括号序列个数,mod 10⁹+7。
提示
卡特兰数 Catₙ = C(2n, n)/(n+1)。n = 3 时答案 5:((())), (()()), (())(), ()(()), ()()()。
第 8.4 章:矩阵快速幂
8.4.0 从一道题出发:数到宇宙尽头
🔢 题目:Fibonacci,但 N 很大 求斐波那契数列第 N 项 mod (10⁹+7)。定义 f(0) = 0,f(1) = 1,f(n) = f(n−1) + f(n−2)。
数据规模:0 ≤ N ≤ 10¹⁸。时间限制:1 秒。
先试试你会的方法
思路 1:递推。 for 循环从 2 推到 N。N = 10¹⁸ 时,即使每秒做 10⁹ 次加法,也需要约 32 年。淘汰。
思路 2:记忆化递归 / 数学公式(通项公式)。 前者同样是 O(N);后者(Binet 公式)依赖 √5 的浮点精度,N 稍大就在模意义下彻底失真——模运算世界里没有 √5(本章范围内)。
思路 3:矩阵。 把「递推一步」写成一个 2×2 矩阵的乘法,递推 N 步 = 矩阵自乘 N−1 次。矩阵幂……不就是幂吗?——用第 8.1 章的快速幂思想,O(log N) 次矩阵乘法搞定。10¹⁸ ≈ 2⁶⁰,只需约 60 轮,毫秒级出答案。
本章路线:
| 小节 | 回答的问题 |
|---|---|
| 8.4.1 | 矩阵乘法是什么、怎么实现 |
| 8.4.2 | 快速幂如何搬到矩阵上(结合律是关键) |
| 8.4.3 | 完整实战:Fibonacci 矩阵推导与手算验证 |
| 8.4.4 | 什么样的递推能这样加速 |
学习目标:
- 实现带取模的矩阵乘法
- 用快速幂计算矩阵的 n 次幂,O(k³ log n)
- 把线性递推转化为矩阵形式(以 Fibonacci 为例)
- 判断一道题的递推能否用矩阵加速
8.4.1 矩阵乘法:定义与实现
定义
矩阵 A 是 n×m 的表,B 是 m×s 的表。乘积 C = A×B 是 n×s 的表,其中:
只有当 A 的列数等于 B 的行数时才能相乘。以 2×2 为例:
⎡ 1 2 ⎤ ⎡ 3 1 ⎤ ⎡ 1×3+2×5 1×1+2×4 ⎤ ⎡ 13 9 ⎤
⎣ 4 5 ⎦ × ⎣ 5 4 ⎦ = ⎣ 4×3+5×5 4×1+5×4 ⎦ = ⎣ 37 24 ⎦
实现
// 解答:矩阵乘法(带取模)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
typedef vector<vector<ll>> Matrix;
const ll MOD = 1e9 + 7;
// A: n×m, B: m×s → C: n×s
Matrix mat_mul(const Matrix& A, const Matrix& B) {
int n = A.size(), m = B.size(), s = B[0].size();
Matrix C(n, vector<ll>(s, 0));
for (int i = 0; i < n; i++)
for (int k = 0; k < m; k++)
for (int j = 0; j < s; j++)
C[i][j] = (C[i][j] + A[i][k] * B[k][j]) % MOD;
return C;
}
int main() {
Matrix A = {{1, 2}, {4, 5}};
Matrix B = {{3, 1}, {5, 4}};
Matrix C = mat_mul(A, B);
// 输出 13 9 / 37 24
for (auto& row : C) {
for (ll v : row) cout << v << " ";
cout << "\n";
}
return 0;
}
三个细节:
- 循环顺序 i-k-j(而非 i-j-k):k 在中 layer,
B[k][j]沿 j 连续访问,缓存友好,常数更小。 A[i][k] * B[k][j]必须是ll * ll——两个模后的数(< 10⁹)相乘约 10¹⁸,int直接爆炸。- 每次累加后立即
% MOD。每项乘积 < 10¹⁸,而C[i][j]始终 < MOD,所以「加上一项再取模」的中间值 < 10¹⁸ + MOD,远在long long范围内;若累加多项才取模就会溢出。
注意:矩阵乘法不满足交换律(A×B ≠ B×A 一般成立),但满足结合律:(A×B)×C = A×(B×C)。结合律正是快速幂的入场券。
8.4.2 矩阵快速幂:O(k³ log n)
单位矩阵:矩阵世界的「1」
数的快速幂中 result 初始化为 1。矩阵世界里,「乘了等于没乘」的东西是单位矩阵 I——对角线为 1、其余为 0:
⎡ 1 0 ⎤
⎣ 0 1 ⎦
任意矩阵 M 满足 M × I = I × M = M。
算法:与数的快速幂一模一样
因为矩阵乘法满足结合律,M^n = M^(n 的二进制拆分) 的推导原封不动照搬:
// 解答:矩阵快速幂 — 计算 M^n(n 可达 10^18)
Matrix mat_pow(Matrix M, ll n) {
int sz = M.size();
Matrix result(sz, vector<ll>(sz, 0));
for (int i = 0; i < sz; i++) result[i][i] = 1; // 初始化为单位矩阵!
while (n > 0) {
if (n & 1)
result = mat_mul(result, M);
M = mat_mul(M, M); // 底数平方:M^1, M^2, M^4, M^8, ...
n >>= 1;
}
return result;
}
复杂度: 每次 mat_mul 是 O(k³)(k×k 矩阵),循环 O(log n) 轮,总计 O(k³ log n)。k = 2 时约 60×16 = 不足一千次乘法,k = 100 时约 60×10⁶ = 六千万次,仍在时限内。
8.4.3 完整实战:Fibonacci 的矩阵形态
推导转移矩阵
目标:把「从 (n−1, n−2) 推进到 (n, n−1)」写成一次矩阵乘法。把相邻两项摞成状态向量,找一个矩阵 M 使得:
⎛ f(n) ⎞ ⎛ ? ? ⎞ ⎛ f(n-1) ⎞
⎝ f(n-1) ⎠ = ⎝ ? ? ⎠ ⎝ f(n-2) ⎠
逐项凑系数:f(n) = 1·f(n−1) + 1·f(n−2),f(n−1) = 1·f(n−1) + 0·f(n−2)。于是:
$$\begin{pmatrix} f(n) \ f(n-1) \end{pmatrix} = \begin{pmatrix} 1 & 1 \ 1 & 0 \end{pmatrix} \times \begin{pmatrix} f(n-1) \ f(n-2) \end{pmatrix}$$
递推 n−1 步,就是 M 自乘 n−1 次:
$$\begin{pmatrix} f(n) \ f(n-1) \end{pmatrix} = \begin{pmatrix} 1 & 1 \ 1 & 0 \end{pmatrix}^{n-1} \times \begin{pmatrix} f(1) \ f(0) \end{pmatrix}$$
完整代码
// 解答:Fibonacci 第 N 项 mod 1e9+7 — O(k^3 log n)
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
typedef vector<vector<ll>> Matrix;
const ll MOD = 1e9 + 7;
Matrix mat_mul(const Matrix& A, const Matrix& B) {
int n = A.size(), m = B.size(), s = B[0].size();
Matrix C(n, vector<ll>(s, 0));
for (int i = 0; i < n; i++)
for (int k = 0; k < m; k++)
for (int j = 0; j < s; j++)
C[i][j] = (C[i][j] + A[i][k] * B[k][j]) % MOD;
return C;
}
Matrix mat_pow(Matrix M, ll n) {
int sz = M.size();
Matrix result(sz, vector<ll>(sz, 0));
for (int i = 0; i < sz; i++) result[i][i] = 1;
while (n > 0) {
if (n & 1) result = mat_mul(result, M);
M = mat_mul(M, M);
n >>= 1;
}
return result;
}
ll fibonacci(ll n) {
if (n <= 1) return n;
Matrix trans = {{1, 1}, {1, 0}};
Matrix R = mat_pow(trans, n - 1);
// [f(n), f(n-1)]^T = R × [f(1), f(0)]^T = R × [1, 0]^T
// 第一个分量 = R[0][0]×1 + R[0][1]×0 = R[0][0]
return R[0][0];
}
int main() {
for (int i = 0; i <= 10; i++)
cout << "f(" << i << ") = " << fibonacci(i) << "\n";
cout << "f(10^18) = " << fibonacci(1000000000000000000LL) << "\n";
return 0;
}
手算验证:为什么 f(10) = 55
M² = [[1,1],[1,0]] × [[1,1],[1,0]]:
M² = ⎡ 1×1+1×1 1×1+1×0 ⎤ ⎡ 2 1 ⎤
⎣ 1×1+0×1 1×1+0×0 ⎦ = ⎣ 1 1 ⎦
M⁴ = M² × M² = ⎡ 2×2+1×1 2×1+1×1 ⎤ ⎡ 5 3 ⎤
⎣ 1×2+1×1 1×1+1×1 ⎦ = ⎣ 3 2 ⎦
M⁸ = M⁴ × M⁴ = ⎡ 5×5+3×3 5×3+3×2 ⎤ ⎡ 34 21 ⎤
⎣ 3×5+2×3 3×3+2×2 ⎦ = ⎣ 21 13 ⎦
f(10) 需要 M⁹ = M⁸ × M:
M⁹ = M⁸ × M = ⎡ 34×1+21×1 34×1+21×0 ⎤ ⎡ 55 34 ⎤
⎣ 21×1+13×1 21×1+13×0 ⎦ = ⎣ 34 21 ⎦
f(10) = M⁹[0][0] × f(1) = 55 × 1 = 55 ✓。事实上能看出 Mⁿ 的规律:左上角恰好是 f(n+1),右上角是 f(n)——矩阵每一格都在讲 Fibonacci 的故事。
性能对比: 递推 O(N) 对 N = 10¹⁸ 要算 32 年;矩阵快速幂约 60 轮 × 2 次矩阵乘法 × 8 次标量乘法 ≈ 1000 次乘法,不到一微秒。
8.4.4 适用判断:什么递推能矩阵加速?
判据:线性齐次递推(可带常数项)
一个 k 阶递推能写成一阶矩阵形式,当且仅当新状态是旧状态的线性组合(各项次数为 1,可以乘系数、加常数):
✓ f(n) = a₁·f(n-1) + a₂·f(n-2) + ... + aₖ·f(n-k) — 纯线性
✓ f(n) = 2·f(n-1) + 3·f(n-2) + 7 — 常数项:加一行恒为 1 的状态
✓ f(n) = f(n-1) + n² — n 的多项式:把 n², n, 1 也放进状态向量
✗ f(n) = f(n-1) × f(n-2) — 乘法非线性,矩阵无能为力
✗ f(n) = f(n-1)² + 1 — 平方非线性
常数项的处理: f(n) = 2f(n−1) + 7,状态向量扩成 [f(n), 1]:
⎛ f(n) ⎞ ⎛ 2 7 ⎞ ⎛ f(n-1) ⎞
⎝ 1 ⎠ = ⎝ 0 1 ⎠ ⎝ 1 ⎠
含 n 的多项式项: f(n) = f(n−1) + n,状态向量扩成 [f(n), n, 1],转移矩阵里放好 n ← n+1 的递进。状态每扩一维,k 加 1,复杂度 O(k³ log n) 里 k³ 增长——扩到 k ≈ 100 依然是毫秒级。
典型信号
- 「求第 N 项,N ≤ 10¹⁸,答案取模」——N 大到只能 log 级算法,递推又是线性的 → 矩阵快速幂
- 「走 N 步后的方案数」且转移固定 → 转移矩阵的 N 次幂(图上 N 步路径计数,k = 顶点数)
- 数据结构题里「重复执行 N 次某个线性变换」→ 同理
与 DP 的关系
若 N ≤ 10⁷ 左右,直接 O(N) 递推更简单——矩阵快速幂只在 N 巨大 + 递推线性时才有出场必要。这是典型的 Platinum 套路:题目数据范围就是算法提示。
⚠️ 常见错误
result没初始化为单位矩阵。 初始化成全 0 矩阵的话,result × M永远是全 0——快速幂结果直接报废。矩阵的「1」是 I,不是全 1,也不是全 0。- 乘法顺序写反。 矩阵乘法不满足交换律!
result = mat_mul(M, result)与mat_mul(result, M)一般结果不同。按模板顺序写,别「顺手」交换。 - k³ 里的溢出。
A[i][k] * B[k][j]两个模后(< 10⁹)的数相乘约 10¹⁸,必须全程long long。若模数本身 ≥ 2×10⁹(罕见),还要上__int128。 - 状态向量维度不够。 常数项忘了加一维、n 的多项式项忘了带上,转移矩阵就「装不下」递推。写出递推后先数清楚有几个自由变量。
- 忘记矩阵乘法不满足交换律却用了快速幂。 快速幂只需要结合律(成立),但推理「M^(a+b) = M^a × M^b」时顺序不能乱:M^a × M^b = M^(a+b) ✓(同底数才可合并)。
- n = 0 或 n = 1 的边界。 Fibonacci 里
if (n <= 1) return n;必须在矩阵计算之前——mat_pow(M, -1)是未定义行为。
📋 章节小结
| 概念 | 一句话总结 |
|---|---|
| 矩阵乘法 | C[i][j] = Σₖ A[i][k]·B[k][j];O(k³);满足结合律、不满足交换律 |
| 单位矩阵 I | 对角线为 1;矩阵乘法的「1」;快速幂 result 的初值 |
| 矩阵快速幂 | 反复平方 + 二进制拆指数,O(k³ log n) |
| Fibonacci | [[1,1],[1,0]]^n 的左上角就是 f(n+1) |
| 适用条件 | 新状态 = 旧状态的线性组合(可带常数、n 的多项式项,扩维即可) |
前置/后置: 快速幂的数的版本见第 8.1 章:数论基础;图上 N 步路径计数(转移矩阵幂的另一种读法)可对照第 5 章 Floyd–Warshall 的矩阵视角。
🏋️ 练习题
🟢 简单
8.4-E1. 矩阵幂验证
给定 2×2 矩阵 M 和整数 n,输出 M^n 的各元素 mod 10⁹+7。
数据规模: 0 ≤ n ≤ 10¹⁸,M 的元素 ∈ [0, 10⁹]。
提示
mat_pow 模板原题。注意 n = 0 时输出单位矩阵。
8.4-E2. Tribonacci
求满足 t(0)=0, t(1)=1, t(2)=1, t(n)=t(n−1)+t(n−2)+t(n−3) 的数列第 N 项 mod 10⁹+7。
数据规模: 0 ≤ N ≤ 10¹⁸。
提示
状态向量 [t(n), t(n−1), t(n−2)],转移矩阵第一行 [1,1,1],下面两行是「错位下移」。k = 3。
🟡 中等
8.4-M1. 爬楼梯(带常数项)
每次可以上 1 阶或 2 阶,但第 0 阶到第 1 阶之间有一段电梯直达(相当于从 f(0) 走到 f(1) 有 2 种方式)。递推为 f(n) = 2·f(n−1) + f(n−2),f(0)=1, f(1)=2。求第 N 阶的方案数 mod 10⁹+7。
数据规模: 0 ≤ N ≤ 10¹⁸。
提示
转移矩阵 [[2,1],[1,0]],初始向量 [f(1), f(0)] = [2, 1]。答案 = M^(n−1) 第一行点乘初始向量的第一个分量。可先手算 n = 2 → 5, n = 3 → 12 验证。
🔴 困难
8.4-H1. 图上的 N 步路径计数 (USACO Platinum 风格)
给定有向图(K 个顶点,E 条边)和起点 s、终点 t,求从 s 走恰好 N 步到 t 的路径数 mod 10⁹+7(每步沿一条有向边走)。
数据规模: 1 ≤ K ≤ 100,0 ≤ E ≤ K²,1 ≤ N ≤ 10¹⁸。
提示
邻接矩阵 A 中 A[i][j] = 从 i 到 j 的边数。A^n[i][j] = 恰好 n 步从 i 到 j 的路径数(归纳:n 步路径 = 前 n−1 步到某中间点 × 最后一步)。用矩阵快速幂算 A^N,输出 A^N[s][t]。O(K³ log N) ≈ 10⁶ × 60,够快。
第 8.4 章结束 — 另请参阅:数论基础 | 数学部分总览
第 8.5 章:博弈论入门
博弈论题目在竞赛中乍看像"脑筋急转弯",但背后有一套完整的数学理论。它们在 USACO Gold / Platinum 和国内 NOIP 中都以"两人轮流操作,问先手是否必胜"的形式出现,而几乎所有这类题目都归结为同一个工具:异或(XOR)。
学习目标:
- 理解公平组合游戏的定义
- 掌握必胜 / 必败状态的三条判定定理
- 掌握 Nim 和定理及其完整证明
- 掌握 SG 函数与 Sprague–Grundy 定理,并能打表求解
8.5.0 开篇题:Nim 游戏
问题: 桌上有 N 堆石子,第 i 堆有 aᵢ 颗。Alice 和 Bob 轮流行动,Alice 先手。每一回合,当前玩家任选一堆,从中取走至少 1 颗、至多整堆的石子。取走最后一颗石子的玩家获胜。给定初始局面,问 Alice 是否有必胜策略。
朴素思路:逐堆 DP 会爆炸
最直接的暴力是画出博弈图:把每个局面 (a₁, a₂, ..., aₙ) 看作一个节点,从每个局面连边到它一步能到达的所有局面,然后从终局倒推每个节点是必胜还是必败。
哪怕只对"堆的大小"做记忆化搜索,状态总数也是所有堆大小的乘积级别——O(∏aᵢ)。三堆各 1000 颗就是 10⁹ 个状态,十堆各 10⁹ 颗直接天文数字。逐堆信息不足以判断胜负,我们需要的是一个只看全局的量。这就是第 8.5 章的主角:Nim 和。
8.5.1 公平组合游戏与必败状态
第 8.5 章讨论的都是公平组合游戏(Impartial Game),它满足三个条件:
- 两个人轮流行动,双方都能看到完整的局面(完全信息);
- 在某个局面下能做什么操作只与局面有关,与玩家是谁无关(双方地位完全平等);
- 游戏一定会在有限步内结束,且没有平局(通常以"无法行动者输"告终)。
⚠️ 国际象棋、五子棋都不是公平组合游戏——你不能操作对方的棋子。Nim 及其绝大多数变形都是。
把博弈图的每个节点分类:
- 必胜状态(N-position):当前行动者必胜的局面;
- 必败状态(P-position):当前行动者必败的局面。
三条定理构成了所有分析的基础:
定理 1: 没有后继状态的状态是必败状态。 (游戏无法进行,当前玩家直接输。)
定理 2: 一个状态是必胜状态,当且仅当它至少存在一个必败的后继状态。 (把必败局面扔给对手,对手就输了。)
定理 3: 一个状态是必败状态,当且仅当它的所有后继状态都是必胜状态。 (无论怎么走,都把必胜局面送给对手。)
若博弈图是有向无环图(公平组合游戏保证如此),按这三条定理沿拓扑序倒推,就能 O(状态数 + 边数) 标出每个状态的胜负——这正是 8.5.0 中"会爆炸"的暴力。理论正确,但我们需要快得多 的判定。
8.5.2 Nim 和定理
定义 Nim 和 = 所有堆大小的按位异或:
$$a_1 \oplus a_2 \oplus \cdots \oplus a_n$$
Nim 和定理(Bouton 定理): Nim 游戏中,当前局面为必败状态,当且仅当 Nim 和为 0;Nim 和非零则必胜。
完整证明
我们证明以下三条引理(它们恰好对应"必胜/必败"的三条判定定理):
引理 1(终局): 没有后继的状态只有全零局面 (0, 0, ..., 0),此时 Nim 和为 0。
引理 2(非零 → 能走到零): 若当前 Nim 和为 k ≠ 0,则存在一步合法操作,使操作后 Nim 和变为 0。
证明: 设 k 的二进制最高位 1 在第 d 位。由异或的定义,所有 aᵢ 中第 d 位为 1 的堆有奇数个——奇数 ≥ 1,故至少存在一堆 aᵢ,其第 d 位为 1。对这堆,考察 aᵢ ⊕ k:
- 第 d 位上,aᵢ 和 k 都是 1,故 aᵢ ⊕ k 的第 d 位为 0,而 k 的更高位都是 0、不产生影响,所以 aᵢ ⊕ k < aᵢ(最高变化位从 1 变 0,必然变小);
- 把 aᵢ 改成 aᵢ′ = aᵢ ⊕ k(取走 aᵢ − aᵢ′ 颗,为正数,合法),新的 Nim 和为
$$(a_1 \oplus \cdots \oplus a_i' \oplus \cdots \oplus a_n) = (a_1 \oplus \cdots \oplus a_n) \oplus k = k \oplus k = 0.$$
引理 3(零 → 只能走到非零): 若当前 Nim 和为 0,则任何一步合法操作都会使 Nim 和变为非零。
证明: 一次操作只改变某一堆,把 aᵢ 改为 aᵢ′ ≠ aᵢ。若操作前后 Nim 和都是 0,则
$$a_1 \oplus \cdots \oplus a_i \oplus \cdots \oplus a_n = a_1 \oplus \cdots \oplus a_i' \oplus \cdots \oplus a_n$$
两边同时异或除去第 i 堆的其余部分,得 aᵢ = aᵢ′,矛盾。∎
汇总: Nim 和为 0 的局面,每一步都被迫走到非零局面(引理 3),且对手总能再走回零局面(引理 2);由于游戏有限步结束,最终停在"全零 Nim 和为 0"的终局上的,正是那个一直面对零局面的玩家——他输。所以 Nim 和为 0 ⇔ 必败。
二进制位表的直觉
为什么偏偏是异或?看三堆 (3, 4, 5) 的二进制竖式:
| 堆 | 4 位 | 2 位 | 1 位 |
|---|---|---|---|
| 3 | 0 | 1 | 1 |
| 4 | 1 | 0 | 0 |
| 5 | 1 | 0 | 1 |
| XOR | 0 | 1 | 0 |
每一列(每个二进制位)上 1 的个数是奇是偶,就是异或那一位的值。Nim 和为 0 意味着每个二进制位上 1 的个数都是偶数——这样的局面非常"对称",无论先手破坏哪一位的奇偶性,后手都能在同一堆或另一堆把它补回来,最终把对称一路保持到全零。而非零局面里,最高非零位上 1 出现奇数次,先手恰好把那堆削掉高位、一步制造出全局对称——必胜的一手就在那里。
💡 对 (3, 4, 5):XOR = 2 ≠ 0,先手必胜。按引理 2,k = 2,最高位是 2¹ 位;3 的该位为 1,把 3 改成 3 ⊕ 2 = 1,即从第一堆取走 2 颗,留给对手 (1, 4, 5),XOR = 0。
8.5.3 SG 函数
Nim 是"每次任取"的特例。当规则变得花哨——比如"每次只能取斐波那契数颗"——直接的胜负判定失效,我们需要更一般的工具。
有向图游戏
有向图游戏:在一张有向无环图上放一枚棋子,双方轮流沿一条有向边移动棋子,无法移动者输。绝大部分公平组合游戏都能转成这个模型(局面 = 节点,操作 = 边)。
mex 与 SG 的定义
mex(minimum excludant,最小排除值):
$$\operatorname{mex}(S) = \text{不属于 } S \text{ 的最小非负整数}$$
例如 mex({0, 2, 4}) = 1,mex({1, 2}) = 0,mex(∅) = 0。
对状态 x 及其全部后继 y₁, y₂, ..., yₖ,定义 SG 函数:
$$\operatorname{SG}(x) = \operatorname{mex}{\operatorname{SG}(y_1), \operatorname{SG}(y_2), \ldots, \operatorname{SG}(y_k)}$$
无后继状态(终局)的 SG 值 = mex(∅) = 0。
关键性质: SG(x) = 0 ⇔ x 是必败状态。
- 若 SG(x) = 0,说明 0 不在后继 SG 集合里,即不存在必败的后继——所有后继都是必胜的,正是判定定理 3;
- 若 SG(x) > 0,说明后继 SG 集合包含 0..SG(x)−1 的每个值,特别地存在 SG 为 0 的必败后继——正是判定定理 2。
注意 SG 函数比"胜负"记录了更多信息:SG(x) = 3 不仅说明 x 必胜,还说明从 x 一步能到达 SG 为 0、1、2 的状态——这个"能到达哪些等级"的信息正是组合多个游戏时需要的。
两个例子
例 1:Nim 的一堆。 把"一堆 x 颗石子,任取若干"看作有向图游戏:节点 x 连向所有 y < x。归纳易证 SG(x) = x:节点 x 的后继恰好覆盖 SG 值 0, 1, ..., x−1,故 mex = x。
例 2:一堆石子,每次取 1~3 颗。 节点 x 连向 x−1, x−2, x−3:
| x | 后继 SG | SG(x) |
|---|---|---|
| 0 | (无) | 0 |
| 1 | {0} | 1 |
| 2 | {0,1} | 2 |
| 3 | {0,1,2} | 3 |
| 4 | {1,2,3} | 0 |
| 5 | {0,2,3} | 1 |
| 6 | {0,1,3} | 2 |
| 7 | {0,1,2} | 3 |
SG 序列是 0, 1, 2, 3, 0, 1, 2, 3, ... 以 4 为周期循环——这正是经典的"巴什博弈",x ≡ 0 (mod 4) 时必败,与我们熟知的结论一致。
8.5.4 SG 定理(Sprague–Grundy 定理)
定理: 把 n 个互相独立的有向图游戏放在一起,每回合任选一个游戏走一步,无法行动者输。设各游戏当前状态的 SG 值为 SG(s₁), ..., SG(sₙ),则:
整个组合游戏先手必胜 ⇔ SG(s₁) ⊕ SG(s₂) ⊕ ⋯ ⊕ SG(sₙ) ≠ 0。
而且,组合游戏的 SG 值恰好等于这个异或和。
证明思路(归纳法): 设 X = SG(s₁) ⊕ ⋯ ⊕ SG(sₙ)。类比 Nim 和定理的两条引理:
- 若所有 sᵢ 都无后继,则各 SG 均为 0,X = 0,必败。✓
- 若 X ≠ 0,仿照引理 2:取最高位,找到某个 SG(sᵢ),其该位为 1,且 SG(sᵢ) ⊕ X < SG(sᵢ)。由于 sᵢ 的后继 SG 集合包含 0..SG(sᵢ)−1 的每个值,必存在后继 sᵢ′ 恰好满足 SG(sᵢ′) = SG(sᵢ) ⊕ X。走到 sᵢ′ 后新的异或和为 0。✓
- 若 X = 0,任一步只改变一个 sᵢ 的 SG 值(mex 保证 SG(sᵢ′) ≠ SG(sᵢ),因为后继集合不含自身值……严格说:若 SG(sᵢ′) = SG(sᵢ),与异或为零保持不变矛盾,同引理 3),异或和必然变为非零。✓
三条引理与 Nim 和定理的证明逐字对应——SG 定理正是把任意公平组合游戏"折算"成了一堆等价的 Nim 石子:状态 sᵢ 折算成 SG(sᵢ) 颗石子的 Nim 堆。这就是为什么 SG(x) = x 的 Nim 是万物的"度量衡"。
使用 SG 定理的完整流程
- 把游戏拆成若干独立子游戏(Nim 的各堆天然独立);
- 对每个子游戏,预处理出所有状态的 SG 值(通常是打表找规律,或直接 O(值域 × 转移数) 递推);
- 把各子游戏当前状态的 SG 值异或起来:非零先手必胜,为零先手必败。
8.5.5 实战题 1:Nim 游戏
题意: 读入 N 堆石子的大小,输出先手(Alice)是否必胜。
1 ≤ N ≤ 10⁵,1 ≤ aᵢ ≤ 10⁹。
直接套 Nim 和定理:
#include <bits/stdc++.h>
using namespace std;
int main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
int n;
cin >> n;
int nimSum = 0;
for (int i = 0; i < n; i++) {
int a;
cin >> a;
nimSum ^= a;
}
cout << (nimSum != 0 ? "Alice" : "Bob") << '\n';
return 0;
}
验证:
(2, 5, 4):2 ⊕ 5 ⊕ 4 = 011 ⊕ 101 ⊕ 100 = 010 ≠ 0 → Alice 必胜 ✓(按引理 2 的构造:k = 2,把 3 改成 3 ⊕ 2 = 1,留给对手 (1, 5, 4),XOR = 0)(1, 1, 1):1 ⊕ 1 ⊕ 1 = 1 ≠ 0 → Alice 必胜 ✓(先手取光一堆,剩下两堆各 1 颗,之后镜像跟随,后手必胜)(3, 3):3 ⊕ 3 = 0 → Bob 必胜 ✓(后手在另一堆镜像先手的每一步)(7):7 ≠ 0 → Alice 必胜 ✓(一次全取)
复杂度 O(N)。
8.5.6 实战题 2:Fibonacci 取石子(SG 打表)
题意(hdu 1848): 三堆石子,分别有 m、n、p 颗。每次任选一堆,从中取走斐波那契数颗(1, 2, 3, 5, 8, 13, ... 颗,不能不取)。取到最后一颗的赢。问先手是否必胜。
1 ≤ m, n, p ≤ 1000。
规则不再是"任取若干",Nim 定理不能直接用——这正是 SG 函数登场的时刻:
- 每一堆是一个独立的子游戏;
- 对"一堆 x 颗、每次取斐波那契数颗"打表算 SG(x);
- 三堆 SG 值异或,非零先手必胜。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 1000;
int sg[MAXN + 1];
int main() {
// 预处理斐波那契数(去掉 1 的重复项: 1, 2, 3, 5, 8, ...)
vector<int> fib;
int a = 1, b = 2;
while (a <= MAXN) {
fib.push_back(a);
int c = a + b;
a = b;
b = c;
}
// SG 打表: sg[x] = mex{ sg[x - f] : f 是斐波那契数且 f <= x }
vector<int> vis(MAXN + 2);
for (int x = 1; x <= MAXN; x++) {
for (int i = 0; i <= x; i++) vis[i] = 0; // 只需清到可能的最大 SG 值
for (int f : fib)
if (f <= x) vis[sg[x - f]] = 1;
int mex = 0;
while (vis[mex]) mex++;
sg[x] = mex;
}
int m, n, p;
while (cin >> m >> n >> p && (m || n || p)) {
cout << ((sg[m] ^ sg[n] ^ sg[p]) ? "Fibo\n" : "Nacci\n");
}
return 0;
}
打表结果核对(x = 1..20):
x : 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20
SG : 1 2 3 0 1 2 3 4 5 0 1 2 3 0 1 2 3 4 5 0
手算验证前几项:
- SG(0) = 0(终局);
- SG(1) = mex{SG(0)} = mex{0} = 1;
- SG(2) = mex{SG(1), SG(0)} = mex{1, 0} = 2;
- SG(3) = mex{SG(2), SG(1), SG(0)} = mex{2, 1, 0} = 3;
- SG(4):可取 1、2、3 颗,后继 SG 为 {3, 2, 1},mex = 0(4 颗是必败点!);
- SG(5):可取 1、2、3、5 颗,后继 SG 为 {SG(4), SG(3), SG(2), SG(0)} = {0, 3, 2, 0},mex = 1。
用独立的暴力博弈 DP(直接判每堆 x 颗先手胜负)交叉验证:x = 4, 10, 14, 20 时 SG 为 0,暴力同样判定这四个规模为先手必败 ✓。
样例核对:
(1, 2, 3):SG 异或 = 1 ⊕ 2 ⊕ 3 = 0 → 输出 Nacci(先手必败)✓(1, 1, 1):1 ⊕ 1 ⊕ 1 = 1 → Fibo ✓(2, 4, 8):2 ⊕ 0 ⊕ 4 = 6 → Fibo ✓
打表复杂度 O(MAXN × |fib|),单组查询 O(1)。
8.5.7 ⚠️ 常见错误
- 必胜/必败判断写反。 记牢口诀:XOR ≠ 0 先手赢,XOR = 0 先手输。写成"异或为零必胜"是最常见的低级失误——建议写代码前先拿 (3,3) 这类镜像局面对照:"两堆一样多,先手必败",而 3 ⊕ 3 = 0。
- mex 忘记从 0 开始。 mex 是"最小非负整数",mex(∅) = 0,mex({1,2}) = 0。若习惯性从 1 开始找,所有 SG 值都会偏小甚至全错。打表时先算 SG(小值) 并和手算对一遍。
- 打表数组忘记每轮清空 / 清空范围不够。 mex 的候选值最多到"后继个数",但保险起见清空到 MAXN 或使用带时间戳的写法(每个 x 用一个独立标记)。上面代码按
0..x清空是足够的,因为 SG(x) ≤ x。 - Anti-Nim(反常 Nim)不能直接套 SG / Nim 和。 "取最后一颗的人输"的反常规则破坏了公平组合游戏的"无法行动者输"前提(终局的胜负翻转了)。必胜条件需要另行讨论(大致为:异或为 0 且所有堆大小 ≤ 1,或异或非零且存在堆 > 1),SG 定理在这里不适用。见到 misère 规则要停下来重新分析,不要无脑 XOR。
- 子游戏不独立就异或。 SG 定理要求各子游戏互不影响。若一步操作会同时改变多个"堆"的状态(如分堆游戏把一堆拆成两堆),必须把"分堆后的两个子堆"的 SG 异或作为这一个转移的贡献,再对转移集合取 mex——而不是简单地把所有堆异或完事。
8.5.8 总结
| 概念 | 内容 |
|---|---|
| 公平组合游戏 | 双方操作集相同、完全信息、有限步分胜负 |
| 必胜/必败三定理 | 无后继必败;有必败后继则必胜;后继全必胜则必败 |
| Nim 和定理 | XOR = 0 ⇔ 必败;非零 ⇔ 必胜(Bouton 定理,三条引理证明) |
| SG 函数 | SG(x) = mex{后继 SG};SG(x) = 0 ⇔ x 必败 |
| SG 定理 | 独立子游戏组合:⊕ SG(sᵢ) ≠ 0 ⇔ 先手必胜 |
| Nim 堆的 SG | SG(x) = x——Nim 是所有公平组合游戏的"度量衡" |
解题流程:识别公平组合游戏 → 拆成独立子游戏 → 打表/递推 SG → 异或判胜负。
8.5.9 练习
🟢 简单
8.5-E1. 裸 Nim
N 堆石子,轮流任取一堆的任意正整数颗,取最后一颗的赢。读入 N 与各堆大小,输出 First(先手必胜)或 Second。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ aᵢ ≤ 10⁹。
提示
全部异或,非零输出 First。O(N)。
🟡 中等
I-M1. 阶梯 Nim
N 级台阶,第 i 级上有 aᵢ 颗石子。每次可以把某一台阶上的任意正整数颗石子往下移一级(第 1 级移到地面)。当所有石子都在地面时游戏结束,让对手无法移动的人赢(即移动最后一颗石子到地面的人赢)。判断先手胜负。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ aᵢ ≤ 10⁹。
提示
关键观察:只移动奇数级台阶的石子才真正影响胜负。偶数级的移动可以被对手"原样照搬"抵消(你在偶数级往下推 k 颗到奇数级,对手把这 k 颗继续推下去)。因此答案 = 所有奇数编号台阶上石子数的异或和(注意第 1 级是奇数级,因为它一步到地面)。非零先手必胜。
🔴 困难
I-H1. Anti-Nim(反常 Nim)
N 堆石子,规则同 Nim,但取走最后一颗石子的人输。给出先手必胜的完整判定条件,并证明。
数据规模: 1 ≤ N ≤ 10⁶,1 ≤ aᵢ ≤ 10⁹。
提示
先想清楚两个极端局面:(1) 只剩一堆超过 1 颗、其余全为 1——此时轮到谁,谁就能通过"留奇数颗还是偶数颗 1"自由选择胜负,必胜;(2) 全部堆都是 1——胜负纯由堆数奇偶决定。据此归纳出:必胜 ⇔ (所有堆都 ≤ 1 且 1 的堆数为偶数)或(存在堆 > 1 且 XOR ≠ 0)。注意这不是 SG 定理的应用——反常规则下 SG 定理失效,必须从必胜/必败状态的定义直接分析。
延伸阅读
第 8.5 章只覆盖了公平组合游戏的入门。非公平博弈(Partizan Game,双方操作集不同,如剪纸类博弈)、Anti-Nim 的系统理论、以及 Nim 变体(阶梯 Nim、Moore's Nim、Green Hackenbush 等)超出了本书范围,感兴趣的读者可参考 OI-wiki 博弈论 及其引用资料继续深入。
🧵 第九部分:字符串算法
从「逐字符比较」到线性时间的精妙加速。KMP、Trie、Manacher、Z 函数与 AC 自动机——覆盖 USACO Silver 至 Gold 的字符串核心。
📚 5 章 · ⏱️ 预计 2-3 周 · 🎯 目标:达到 USACO Gold 水平
第九部分:字符串算法
预计用时:2-3 周
字符串是竞赛编程中一类独特的题目:数据就是一个字符数组,但暴力做法往往在 N = 10⁵、10⁶ 量级下超时。本部分教你把「已经比较过的信息」留下来反复利用,把 O(N × M) 的朴素匹配压到 O(N + M) 甚至 O(N)。
涵盖的主题
| 章节 | 主题 | 核心思想 |
|---|---|---|
| 第 9.1 章 🥉 | 字符串基础 | 概念、读入、string 操作、连续段 |
| 第 9.2 章 🥈→🥇 | 字符串匹配:前缀函数与 KMP | 失配时利用已匹配前缀跳转,O(N + M) |
| 第 9.3 章 🥈 | Trie 树 | 用路径表示字符串,共享前缀,O(|s|) 查询 |
| 第 9.4 章 🥇 | Manacher 与 Z 函数 | 镜像加速——最右回文 / 最右 Z-box |
| 第 9.5 章 🥇 | AC 自动机 | Trie + fail 指针,多模式串同时匹配 |
学完本部分后能解决什么问题
-
USACO Silver:
- 单模式串匹配、子串查找与计数(KMP)
- 字符串集合查询、前缀检测、前缀冲突(Trie)
- 01-Trie 求最大异或对
-
USACO Gold:
- 最长回文子串、回文计数(Manacher)
- 后缀与前缀的匹配统计(Z 函数)
- 多模式串同时出现统计(AC 自动机)
引入的关键算法
| 技术 | 章节 | 时间复杂度 | 典型场景 |
|---|---|---|---|
| 前缀函数 / KMP | 9.2 | O(N + M) | 单模式匹配、最短周期、border |
| Trie | 9.3 | O(|s|) | 集合查询、前缀检测 |
| 01-Trie | 9.3 | O(N log W) | 最大异或对 |
| Manacher | 9.4 | O(N) | 最长回文、回文计数 |
| Z 函数(扩展 KMP) | 9.4 | O(N) | 后缀 vs 前缀统计 |
| AC 自动机 | 9.5 | O(|T| + Σ|P| + 匹配) | 多模式串同时匹配 |
本部分学习建议
- 第 9.1 章(基础) 是本章表里唯一的 Bronze 章——string 操作和连续段思想是后面所有章节的地基。
- 第 9.2 章(KMP) 是一切算法章的基础——前缀函数的「失配回退」思想会在第 9.5 章 AC 自动机的 fail 指针中原样复现。
- 第 9.3 章(Trie) 代码短、模板性强,先掌握普通 Trie 再学 01-Trie。
- 第 9.4 章的 Manacher 与 Z 函数共享同一核心:维护「当前最靠右的已知区间」,用镜像避免重复比较。
- 第 9.5 章(AC 自动机) = 第 9.3 章的 Trie 骨架 + 第 9.2 章的 fail 思想。学完前两章再看它会非常自然。
与其他部分的联系
- 字符串哈希(第 3.7 章):哈希也能 O(N + M) 做匹配,代码更短但有冲突风险;KMP 精确无冲突,两者常互为备选。
- 贪心与 DP:KMP 的 border 结构常与 DP 结合(周期问题、循环节统计)。
- 图论:AC 自动机上沿 fail 指针的跳转构成一棵树,fail 树上的子树统计会用到位图算法部分的技巧。
💡 核心思路: 字符串算法的通用套路是「拼接 + 分隔符」——把模式串和文本用
#拼起来,一个前缀函数 / Z 函数同时看到两边的信息。这个技巧在 9.2、9.4、9.5 反复出现。
📖 第 9.1 章:字符串基础
9.1.0 从一道题出发
题目(改编自 USACO Bronze 风格)
奶牛贝西学会了打字,但它有个坏习惯:按住某个键不放,导致输出里出现成串的重复字符。给定它输出的字符串
s,判断它本来想打的「干净字符串」有多少种可能。例如
s = "aabb":可能想打的是ab、aab、abb、aabb……输入:一个仅含小写字母的字符串
s(1 ≤ |s| ≤ 10⁵) 输出:在「每个字符最多重复连续按 k 次」规则下……
这道题本身不难——它真正考察的是你对子串、连续段这些基本概念的熟练程度,以及对 string 各种操作的灵活运用。在学 KMP、Trie 这些「高级货」之前,先把地基打牢:字符串到底怎么表示、怎么读入、怎么切、怎么比、怎么拼。
9.1.1 基本概念
以下设字符串 S,下标从 0 开始,长度记为 |S|。例如 S = "abcabcd":
| 概念 | 定义 | 例子(S = "abcabcd") |
|---|---|---|
| 字符集 | 字符的取值范围 | 小写字母集大小 Σ = 26;ASCII Σ = 128 |
| 子串 | 连续一段 S[i..j] | "cab"、"abcd" |
| 子序列 | 不改变相对顺序地挑若干字符(可不连续) | "aacd" 是子序列,不是子串 |
| 前缀 | 从头开始的一段 S[0..i] | "abc";除 S 本身外都是真前缀 |
| 后缀 | 到末尾为止的一段 S[i.. | S |
| 字典序 | 逐位比较,先小者小;前缀比它的扩展小 | "ab" < "aba" < "b" |
| 回文串 | 正读反读相同 | "aba"、"abba" |
| 汉明距离 | 等长串对应位置不同的位数 | "karolin" vs "kathrin" 距离为 3 |
⚠️ 三个最容易混的点:
- 子串 ⊆ 子序列。子串必须连续,子序列可以跳着取。
"acd"是"abcabcd"的子序列但不是子串。 - 字典序中「短的前缀更小」:
"ab" < "aba"。比较时把「提前结束」当成「遇到一个比任何字符都小的空字符」。 - 空串 ε:长度为 0 的串,是任何串的前缀和后缀。写边界条件时别漏掉它。
9.1.2 读入字符串:竞赛中的三大坑
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
string s;
cin >> n;
// 坑 1:cin >> n 后缓冲区里残留一个换行符,
// 直接 getline 会读到一个空串!
cin.ignore(); // 吃掉残留换行
getline(cin, s); // 读一整行(可以带空格)
string word;
cin >> word; // 坑 2:cin >> 按空白切分,读不了空格
cout << word << "\n";
// 坑 3:想读「恰好 k 个字符」时,用循环 + 单字符读入更稳
string t;
for (int i = 0; i < 3; i++) {
char c = cin.get(); // 逐字符读,包括空格和换行
t += c;
}
cout << t << "\n";
}
牢记:cin >> int 之后想 getline,中间必须 cin.ignore()。这是 Bronze/Silver 字符串题的头号丢分点。
竞赛中最常用的是 cin >> s(不含空格的 token)和 getline(cin, s)(整行)两种,按题意选。
9.1.3 string 常用操作速成
std::string 是竞赛里唯一的字符串选择(C 风格 char[] 只有在 scanf("%s") 混读时偶尔遇到)。掌握下面这些就够用:
string s = "hello world";
// —— 长度与访问 ——
s.size(); // 长度 11(返回无符号类型,见下方陷阱)
s.length(); // 同上
s[0]; // 'h',下标访问 O(1)
s.back(); // 'd',最后一个字符
s.front(); // 'h',第一个字符
// —— 拼接与赋值 ——
string a = "abc", b = "de";
string c = a + b; // "abcde",O(|a|+|b|)
a += "xy"; // 尾部追加,均摊 O(1)
// —— 比较:直接用运算符,按字典序 ——
// "ab" < "aba" < "b"
if (a < b) { /* ... */ }
// —— 查找:find 返回首位置,找不到返回 string::npos ——
s.find("world"); // 6
s.find('o'); // 4(也能查单个字符)
s.rfind('o'); // 7(从后往前找)
if (s.find("xyz") == string::npos) { /* 没找到 */ }
// —— 截取:substr(起点, 长度),注意第二个参数是长度不是终点 ——
s.substr(6); // "world"
s.substr(0, 5); // "hello"
// —— 插入 / 删除 / 替换 ——
s.insert(5, "!"); // "hello! world"
s.erase(5, 1); // 删掉位置 5 起的 1 个字符
s.replace(0, 5, "Hi"); // "Hi world"
// —— 排序与反转 ——
sort(s.begin(), s.end()); // 把字符排序(常用于「重排后判断」类题)
reverse(s.begin(), s.end()); // 反转(判回文的朴素写法)
// —— 与数字互转 ——
int x = stoi("42"); // string → int(还有 stoll 转 long long)
string t = to_string(12345); // int → string
⚠️ 常见错误
| 错误 | 后果 | 正确做法 |
|---|---|---|
cin >> n 后直接 getline(cin, s) | 读到空串 | 中间加 cin.ignore() |
s[i] 越界(i ≥ size) | 未定义行为,可能 RE 也可能不报错 | 循环条件写 i < (int)s.size() |
用 s.size() - 1 当 s 为空 | size 是无符号数,0 - 1 下溢成天文数字 | 先判空,或转 (int)s.size() - 1 |
把 substr(pos, end) 的第二参数当终点下标 | 截取串不对 | 第二参数是长度 |
find 返回值直接存进 int | 某些编译器警告/截断 | 用 size_t 或直接与 string::npos 比较 |
想当然认为 s.insert/erase/replace 是 O(1) | 数据大时超时 | 这些操作都是 O( |
9.1.4 C 风格字符串与 <cstring>
竞赛代码里偶尔还是会碰到 C 风格的 char 数组(读入函数、老模板、题解代码里都常见)。认识它们,能看懂、能互转就够了——自己写新代码时优先用 string。
char 数组与 C 函数速查
#include <cstring> // strlen / strcmp / strcpy / strstr ...
char s[105];
scanf("%s", s); // 读一个 token(不含空格),自动补 '\0'
// scanf 读 char 数组不加 & —— s 本身就是地址!
strlen(s); // 长度:从头数到 '\0',O(N)!
strcmp(s, "abc"); // 字典序比较:<0 / 0 / >0
// ⚠️ 返回值不保证只是 -1/0/1,只能看符号!
strcpy(s, "hello"); // 复制
strcat(s, "world"); // 拼接到末尾
strstr(s, "lo"); // 查子串,返回指针;没找到返回 NULL
strchr(s, 'l'); // 查字符首次出现
strrchr(s, 'l'); // 查字符最后一次出现
三个要点:
'\0'结尾:C 字符串靠一个隐藏的空字符标记结束。char s[105]最多存 104 个可见字符——数组开小一位是经典越界原因。strlen是 O(N):写在循环条件里(for (int i = 0; i < strlen(s); i++))会让整个循环变 O(N²)。先存进变量:int n = strlen(s);。strcmp只看符号:判断相等写strcmp(a, b) == 0,别写== 1或== -1——标准只保证符号。
string 与 char 数组互转
string a = "hello";
const char* p = a.c_str(); // string → char*(scanf("%s", buf) 等场景)
// ⚠️ a 后续被修改后 p 失效,别长期持有
string b(p); // char* → string
string c = p; // 同上
// 读一整行到 char 数组(老写法,了解即可):
char line[1005];
cin.getline(line, 1005); // 或 fgets(line, 1005, stdin)
sprintf / sscanf:字符串当「格式化插座」用
这一对函数在字符串题里非常好用——把变量拼进字符串、从字符串里按格式抠出变量:
#include <cstdio>
char buf[1005];
// sprintf:把格式化的内容写进字符串
int id = 3;
sprintf(buf, "cow_%d", id); // buf = "cow_3"
sprintf(buf, "%d-%d", 5, 12); // buf = "5-12"
double x = 3.14159;
sprintf(buf, "%.2f", x); // buf = "3.14" —— 浮点保留位数最方便的写法
// sscanf:从字符串里按格式解析变量
int a, b;
sscanf("5 12", "%d %d", &a, &b); // a=5, b=12
int hh, mm;
sscanf("07:45", "%d:%d", &hh, &mm); // hh=7, mm=45 —— 带分隔符的解析神器
char name[30];
sscanf("Bessie 10", "%s %d", name, &a); // name="Bessie", a=10
典型场景:
- 日期/时间解析:
sscanf("2026-09-16", "%d-%d-%d", &y, &m, &d)一行搞定,比手写逐字符解析稳得多。 - 构造输出名 / 中间串:把数字嵌进字符串时用
sprintf(或to_string拼接,两者都行)。 - 浮点格式化输出:
printf("%.3f", x)与sprintf(buf, "%.3f", x)共享同一套格式语法。
💡 选型建议:新代码一律
string+cin/cout;只在①读老模板②格式化解析(sscanf)③scanf提速混读时碰char[]。sscanf/sprintf即使在string时代也值得留在工具箱里。
9.1.5 判断回文与统计字符
两个最基础但出镜率极高的模板:
// 判断回文:双指针从两端向中间夹
bool isPalindrome(const string& s) {
for (int i = 0, j = (int)s.size() - 1; i < j; i++, j--)
if (s[i] != s[j]) return false;
return true;
}
// 统计每个字符出现次数:桶计数,O(N)
int cnt[26] = {0};
for (char c : s) cnt[c - 'a']++;
// cnt[0] 是 'a' 的次数……之后可判断「能否重排成回文」:
// 回文条件 = 出现奇数次的字符数 ≤ 1
字符 ↔ 下标转换是字符串题的基本功:c - 'a' 把小写字母映射到 0~25,c - '0' 把数字字符转成数值,反过来 'a' + i 转回字符。
9.1.6 实战例题:重复字符清理
题目:给定字符串
s,把其中连续相同的字符压缩成「字符 + 次数」(如"aaabb"→a3b2),输出压缩后的串;若压缩后不比原串短,输出原串。
这是「连续段」(也叫 run)思想的入门题——统计连续相同字符的个数这个动作会在无数字符串题中反复出现(第 9.4 章 Manacher、构造题、枚举题里都有它)。
#include <bits/stdc++.h>
using namespace std;
int main() {
string s;
cin >> s;
string comp = "";
int n = s.size();
for (int i = 0; i < n; ) {
int j = i;
while (j < n && s[j] == s[i]) j++; // 找到连续段的终点
comp += s[i];
comp += to_string(j - i); // 段长
i = j; // 跳到下一个连续段
}
if (comp.size() < s.size()) cout << comp << "\n";
else cout << s << "\n";
return 0;
}
手算样例:s = "aaabb" → 段为 a×3, b×2 → comp = "a3b2"(长度 4 < 5)→ 输出 a3b2。
s = "abc" → a1b1c1(长度 6 > 3)→ 输出 abc。
注意这个「i 直接跳到段尾 j」的写法:内层 while 把每个字符恰好看一次,整体 O(N)——比「每处理一个字符就把整个后缀重新扫一遍」的朴素写法快得多。
9.1.7 综合练习
🟢 9.1-E1(回文判断)
给定字符串 s(|s| ≤ 10⁵),判断去掉所有非字母字符并转为小写后,剩下的串是否为回文。
样例:"A man, a plan!" → 字母序列 "amanaplan",非回文,输出 NO。
🟢 9.1-E2(最小字典序)
输入 N 个字符串(N ≤ 100,每个长度 ≤ 100),输出其中字典序最小的串。
提示:直接维护 string best; if (s < best) best = s;,C++ 的 < 就是字典序。
🟡 9.1-E3(首尾配对)
给定 N 个字符串,统计有多少对 (i, j)(i < j)满足:把 sᵢ 和 sⱼ 首尾相接(两种顺序都试)后是回文串。N ≤ 1000,串长 ≤ 10。
提示:串长很小,直接拼起来用 9.1.4 的回文判断;也可以只统计各串首尾字符的计数关系。
🟡 9.1-E4(压缩再还原)
先按 9.1.5 的规则压缩字符串,再实现逆操作:给定 a3b2 这样的压缩串,还原出 aaabb。
提示:stoi 解析数字段,注意次数可能是多位数。
🔴 9.1-E5(循环移位匹配)
给定 s 和 t(|s| = |t| ≤ 10⁵),判断 t 是否为 s 的循环移位(即把 s 的某个前缀搬到末尾后恰好等于 t)。
样例:s = "abcde",t = "deabc" → 是。
提示:(s + s).find(t) != string::npos 一行搞定——想想为什么拼接后 t 必然是它的子串。
本章总结
| 工具 | 用途 | 复杂度 |
|---|---|---|
cin >> s / getline | 读 token / 读整行(记得 cin.ignore()) | O(|s|) |
s[i] / s.substr / s + t | 访问 / 截取 / 拼接 | O(1) / O(|s|) / O(|s|) |
s.find / s.rfind | 查找子串或字符 | O(|s|·|p|)(朴素) |
sort / reverse | 排序字符 / 反转 | O(|s| log |s|) / O(|s|) |
stoi / to_string | 字符串 ↔ 数字 | O(|s|) |
strlen / strcmp / strcpy | C 风格:长度 / 比较 / 复制 | O(N),strlen 别写进循环条件 |
sscanf / sprintf | 按格式解析 / 格式化拼接 | O(|s|) |
桶计数 cnt[c-'a'] | 统计字符频率 | O(|s|) |
| 双指针夹逼 | 回文判断等 | O(|s|) |
学完本章,你应该能徒手写出:读入、拼接比较、找子串、判回文、统计连续段。下一章(9.2)我们会看到:当 find 的朴素 O(N·M) 扛不住 10⁵ 规模时,KMP 如何用「失配跳转」把匹配降到线性。
💡 下一章预告:9.1 里所有
find类操作都是朴素的。第 9.2 章的前缀函数与 KMP 会彻底解决这个问题——而且它定义的「border」概念,会在 Trie、AC 自动机里一路复用。
📖 第 9.2 章:字符串匹配:前缀函数与 KMP
🎯 学习目标
学完本章后,你将能够:
- 理解字符串匹配的朴素算法并分析其效率瓶颈
- 掌握 KMP 算法的核心思想——「前缀函数」的构建
- 用 KMP 在 O(N + M) 时间内解决字符串匹配问题
- 利用前缀函数求解最短周期、前缀计数等进阶问题
9.2.0 问题引入
给定一段文本(长度 N)和一个模式串(长度 M),请找出模式串在文本中所有出现的位置。
文本: "ababcabcabababd"
模式: "abab"
结果: 位置 0, 8, 10
这是字符串匹配问题,也是竞赛中最常见的字符串题型之一。它看似简单——两个循环逐字符比较就能写出来——但当 N、M 达到 10⁵ 甚至 10⁶ 时,朴素做法的 O(N × M) 会彻底超时。本章的主角 KMP 算法把它降到了线性时间,其核心思想「失配时利用已匹配部分跳转」还会在第 9.5 章的 AC 自动机中原样复现。
9.2.1 为什么需要专门的字符串算法?
朴素算法的问题
最直觉的做法——枚举文本的每个起始位置,逐字符比较:
// 朴素字符串匹配 — O(N * M)
vector<int> naive_search(string text, string pattern) {
int n = text.size(), m = pattern.size();
vector<int> result;
for (int i = 0; i <= n - m; i++) {
bool match = true;
for (int j = 0; j < m; j++) {
if (text[i + j] != pattern[j]) {
match = false;
break;
}
}
if (match) result.push_back(i);
}
return result;
}
最坏情况举例:
文本: "aaaaaa...a"(N 个 a)
模式: "aaa...ab"(M-1 个 a + 1 个 b)
每次匹配都要比较 M 次才发现不匹配
总操作数:N * M
当 N = M = 10^5 时,这就是 10^10 次操作,根本无法通过竞赛题目。
KMP 的核心洞察
朴素算法的浪费在于:每次失配后,从头重新开始匹配,丢弃了已经比较过的信息。
KMP 的思想是:失配时,利用已经匹配的部分跳回到合适位置,而不是从头开始。
9.2.2 前缀函数(π 数组)
KMP 的核心是「前缀函数」,也叫「next 数组」或「失配函数」。
定义
对于字符串 s,前缀函数 π[i] 定义为:
子串
s[0..i]中,最长的相等真前缀与真后缀的长度。
「真前缀」:不包含整个字符串的前缀。
「真后缀」:不包含整个字符串的后缀。
直觉理解
字符串: a b c a b c d
下标: 0 1 2 3 4 5 6
π 值: 0 0 0 1 2 3 0
逐个分析:
π[0] = 0:单个字符 "a",无真前后缀,规定为 0π[1] = 0:字符串 "ab",前缀 {a},后缀 {b},没有相等的,π = 0π[2] = 0:字符串 "abc",前缀 {a, ab},后缀 {c, bc},没有相等的,π = 0π[3] = 1:字符串 "abca",前缀 {a, ab, abc},后缀 {a, ca, bca},相等的最长为 "a",π = 1π[4] = 2:字符串 "abcab",最长相等真前后缀为 "ab",π = 2π[5] = 3:字符串 "abcabc",最长相等真前后缀为 "abc",π = 3π[6] = 0:字符串 "abcabcd",末尾 d 打破了规律,π = 0
π 值的用途
π[i] = k 意味着:如果当前字符(位置 i+1)不匹配,
我们可以安全地退回到模式串的第 k 个位置继续尝试,
因为前 k 个字符肯定已经匹配了(它们是当前已匹配部分的前缀 = 后缀)。
9.2.3 前缀函数的高效构建
朴素方法:O(N²) 或 O(N³)
对每个位置枚举所有可能的长度,逐字符比较,效率很低。
KMP 的关键观察
观察 1:相邻的 π 值最多增加 1。
即 π[i+1] ≤ π[i] + 1。
为什么?若 π[i+1] > π[i] + 1,说明存在更长的相等前后缀,那 π[i] 就不是最大的了,矛盾。
观察 2:失配时如何跳转?
若 s[π[i]] == s[i+1],则 π[i+1] = π[i] + 1(前缀直接延长)。
若不等,利用 π[π[i]-1] 跳转(尝试更短的前缀),直到找到匹配或退到 0。
图解失配跳转
模式串: a b c a b d
↑ ↑
已匹配到位置4("abcab"),π[4]=2
现在第5个字符 d ≠ c(s[2])
跳转:j = π[4] = 2,尝试 s[2]='c' vs 'd' → 还是不匹配
跳转:j = π[1] = 0,尝试 s[0]='a' vs 'd' → 还是不匹配
j = 0 且失配,π[5] = 0
最终算法实现
#include <bits/stdc++.h>
using namespace std;
// 构建前缀函数(KMP 的核心)
// 时间复杂度:O(N)
vector<int> prefix_function(const string& s) {
int n = (int)s.length();
vector<int> pi(n, 0); // pi[0] = 0 是规定
for (int i = 1; i < n; i++) {
// j 从上一个 π 值开始尝试
int j = pi[i - 1];
// 失配时,利用已算出的 π 值回退(关键步骤!)
while (j > 0 && s[i] != s[j])
j = pi[j - 1]; // 跳到下一个候选长度
// 匹配则长度加一
if (s[i] == s[j])
j++;
pi[i] = j;
}
return pi;
}
int main() {
auto pi = prefix_function("abcabcd");
for (int x : pi) cout << x << " "; // 输出:0 0 0 1 2 3 0
cout << endl;
return 0;
}
为什么时间复杂度是 O(N)?
关键在于 j 的变化:
j每次最多加 1(通过j++)j每次至少减 1(通过j = pi[j-1])j的总增加量 ≤ N,所以总减少量也 ≤ N- while 循环的总执行次数 ≤ N
整个循环的总操作数是 O(N)!
9.2.4 KMP 字符串匹配
核心技巧:拼接字符串
将 pattern + '#' + text 拼在一起,计算整体的前缀函数:
pattern = "abab",长度 4
text = "ababcababd",长度 9
拼接后: a b a b # a b a b c a b a b d
下标: 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4
↑ 1 ↑ 1 ↑ 1
π 值: 0 0 1 2 0 1 2 3 4 0 1 2 3 4 0
↑ ↑
当 π[i] = 4(= len(pattern)),说明找到匹配!
分隔符 # 的作用是防止模式串的后缀与文本的前缀在拼接处意外匹配。
完整实现
#include <bits/stdc++.h>
using namespace std;
// 前缀函数(上一节的实现,匹配要用)
vector<int> prefix_function(const string& s) {
int n = (int)s.length();
vector<int> pi(n, 0);
for (int i = 1; i < n; i++) {
int j = pi[i - 1];
while (j > 0 && s[i] != s[j]) j = pi[j - 1];
if (s[i] == s[j]) j++;
pi[i] = j;
}
return pi;
}
// KMP 字符串匹配
// 返回 pattern 在 text 中所有匹配的起始下标(0-indexed)
// 时间复杂度:O(N + M),N = len(text),M = len(pattern)
vector<int> kmp_search(const string& text, const string& pattern) {
if (pattern.empty()) return {};
// 第一步:拼接,用不在字符集中的分隔符
string combined = pattern + '#' + text;
int m = pattern.size(), n = text.size();
// 第二步:计算整体前缀函数
vector<int> pi = prefix_function(combined);
// 第三步:收集匹配位置
vector<int> result;
for (int i = m + 1; i <= m + n; i++) {
if (pi[i] == m) {
// i 在拼接串中的位置,换算回 text 中的起始位置
result.push_back(i - 2 * m);
}
}
return result;
}
int main() {
string text = "ababcabcabababd";
string pattern = "abab";
auto pos = kmp_search(text, pattern);
cout << "模式串 \"" << pattern << "\" 出现在位置:";
for (int p : pos) cout << p << " ";
// 输出:0 8 10
cout << endl;
// 验证
for (int p : pos) {
cout << " text[" << p << ".." << p+pattern.size()-1 << "] = "
<< text.substr(p, pattern.size()) << endl;
}
return 0;
}
详细追踪示例
📄 查看代码:详细追踪示例
text = "ababcabab", pattern = "abab"(长度4)
拼接串: a b a b # a b a b c a b a b
π 值: 0 0 1 2 0 1 2 3 4 0 1 2 3 4
↑ ↑
i=8 i=13
π[8]=4=m ✓ π[13]=4=m ✓
匹配位置(text 中 0-indexed):
i=8: 8 - 2*4 = 0 → text[0..3] = "abab" ✓
i=13: 13 - 2*4 = 5 → text[5..8] = "abab" ✓
9.2.5 KMP 的进阶应用
应用 1:求字符串的最短周期
// 若字符串 s 能被前 k 个字符重复构成,则 k 是周期
// 最短周期 = n - π[n-1]
// 条件:n 能被 (n - π[n-1]) 整除
int min_period(const string& s) {
int n = s.size();
auto pi = prefix_function(s);
int period = n - pi[n - 1];
if (n % period == 0) return period;
return n; // 无法压缩,周期为 n
}
// 示例:
// "abcabc" → π[5]=3,period = 6-3 = 3,6%3=0 ✓,最短周期 3
// "abcab" → π[4]=2,period = 5-2 = 3,5%3≠0,最短周期 5(整串)
应用 2:统计每个前缀的出现次数
// 统计模式串的每个前缀在整个串中出现的次数
vector<int> count_prefixes(const string& s) {
int n = s.size();
auto pi = prefix_function(s);
vector<int> cnt(n + 1, 0);
for (int i = 0; i < n; i++) cnt[pi[i]]++; // 每个位置贡献
for (int i = n - 1; i > 0; i--) cnt[pi[i-1]] += cnt[i]; // 传播
for (int i = 0; i <= n; i++) cnt[i]++; // 加上自身
return cnt; // cnt[k] = 长度为 k 的前缀在 s 中出现的次数
}
算法对比
| 算法 | 时间复杂度 | 空间复杂度 | 适用场景 |
|---|---|---|---|
| 朴素匹配 | O(N × M) | O(1) | 小数据,代码简单 |
| KMP | O(N + M) | O(M) | 单模式匹配(推荐) |
| Rabin-Karp(字符串哈希,第 3.7 章) | O(N + M) 平均 | O(1) | 多模式或哈希方便的场景 |
| AC 自动机(第 9.5 章) | O(N + ΣM) | O(ΣM) | 多模式同时匹配 |
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| KMP 匹配位置计算错误 | i - 2*m 忘记两个 m(模式串 + 分隔符) | 画图确认拼接串的下标 |
| π[0] 不初始化为 0 | 忘记规定 | vector<int> pi(n, 0) |
| 拼接分隔符出现在原串中 | π 值可能「穿过」模式串与文本的边界 | 选一个字符集中不存在的分隔符(如 '#') |
| 最短周期忘记整除判断 | n - π[n-1] 只有在整除时才是真正的周期 | if (n % period == 0) |
💪 练习题(本章 3 道,全部含完整解答)
🟢 基础练习
题目 1:实现 strStr
在字符串 haystack 中找到 needle 第一次出现的起始位置(若不存在返回 -1)。
要求使用 KMP 实现,时间复杂度 O(N+M)。
示例:
haystack = "hello", needle = "ll" → 2
haystack = "aaaaa", needle = "bba" → -1
思路: 拼接 needle + '#' + haystack,计算前缀函数,找 π[i] == len(needle) 的位置。
#include <bits/stdc++.h>
using namespace std;
vector<int> prefix_function(const string& s) {
int n = s.size();
vector<int> pi(n, 0);
for (int i = 1; i < n; i++) {
int j = pi[i - 1];
while (j > 0 && s[i] != s[j]) j = pi[j - 1];
if (s[i] == s[j]) j++;
pi[i] = j;
}
return pi;
}
int strStr(string haystack, string needle) {
if (needle.empty()) return 0;
int m = needle.size(), n = haystack.size();
auto pi = prefix_function(needle + '#' + haystack);
for (int i = m + 1; i <= m + n; i++)
if (pi[i] == m) return i - 2 * m;
return -1;
}
int main() {
cout << strStr("hello", "ll") << "\n"; // 2
cout << strStr("aaaaa", "bba") << "\n"; // -1
cout << strStr("sadbutsad", "sad") << "\n"; // 0(第一次出现)
return 0;
}
追踪(haystack="hello", needle="ll"): 下图展示拼接串 ll#hello 的前缀函数计算过程——当 π[6] = 2 = len("ll") 时找到匹配,位置 = 6 − 2×2 = 2。
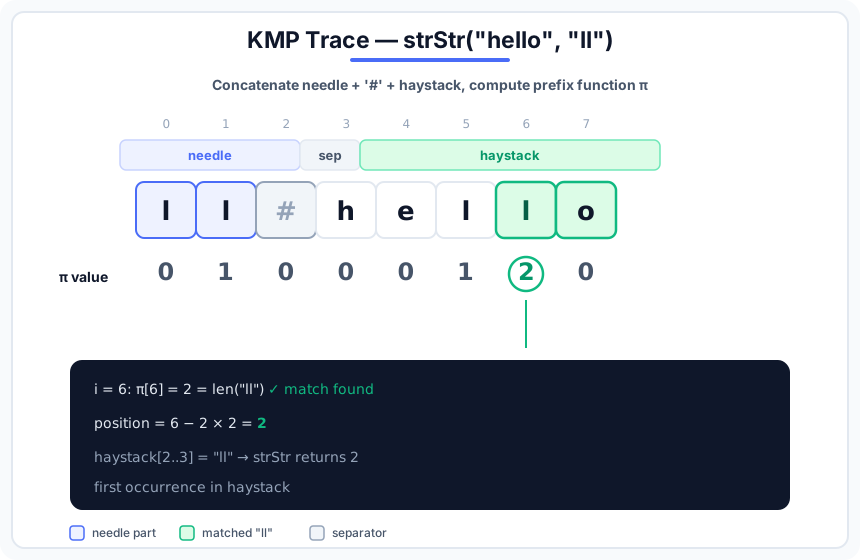
🟡 进阶练习
题目 2:字符串最小周期
给定字符串 s,求其最短重复周期的长度 T。
即找最小的 T,使得 s 可以由 s[0..T-1] 重复若干次(或截断)构成。
示例:
"abcabc" → T = 3("abc" 重复 2 次)
"abababab" → T = 2("ab" 重复 4 次)
"abcd" → T = 4(整串本身)
核心公式: T = n - π[n-1],当 n % T == 0 时字符串可被整除,否则最小周期为 n。
#include <bits/stdc++.h>
using namespace std;
vector<int> prefix_function(const string& s) {
int n = s.size();
vector<int> pi(n, 0);
for (int i = 1; i < n; i++) {
int j = pi[i - 1];
while (j > 0 && s[i] != s[j]) j = pi[j - 1];
if (s[i] == s[j]) j++;
pi[i] = j;
}
return pi;
}
int min_period(const string& s) {
int n = s.size();
auto pi = prefix_function(s);
int T = n - pi[n - 1];
return (n % T == 0) ? T : n;
}
int main() {
cout << min_period("abcabc") << "\n"; // 3
cout << min_period("abababab") << "\n"; // 2
cout << min_period("abcd") << "\n"; // 4
cout << min_period("aaaaaa") << "\n"; // 1
return 0;
}
原理解释: π[n-1] = k 意味着字符串前 k 个字符 = 后 k 个字符。
若 s 有周期 T,则 π[n-1] ≥ n-T,等价于 T ≤ n - π[n-1]。
n - π[n-1] 正是最小的满足条件的 T。
🔴 挑战练习
题目 3:统计所有出现次数 ≥ 2 的子串数量
给定字符串 s(长度 ≤ 1000),统计在 s 中出现次数 ≥ 2 的不同子串的数量。
提示: 枚举每个可能的子串(起点 i,长度 len),用字符串哈希去重并统计出现次数。
思路: 枚举所有子串,用 set 标记已统计过的,对每个子串用 KMP 统计出现次数。
#include <bits/stdc++.h>
using namespace std;
vector<int> prefix_function(const string& s) {
int n = s.size();
vector<int> pi(n, 0);
for (int i = 1; i < n; i++) {
int j = pi[i - 1];
while (j > 0 && s[i] != s[j]) j = pi[j - 1];
if (s[i] == s[j]) j++;
pi[i] = j;
}
return pi;
}
int count_occurrences(const string& text, const string& pattern) {
if (pattern.empty()) return 0;
int m = pattern.size();
auto pi = prefix_function(pattern + '#' + text);
int cnt = 0;
for (int i = m + 1; i < (int)pi.size(); i++)
if (pi[i] == m) cnt++;
return cnt;
}
int main() {
string s; cin >> s;
int n = s.size();
set<string> counted; // 已统计的子串
int ans = 0;
for (int i = 0; i < n; i++) {
for (int len = 1; len <= n - i; len++) {
string sub = s.substr(i, len);
if (counted.count(sub)) continue;
counted.insert(sub);
if (count_occurrences(s, sub) >= 2) ans++;
}
}
cout << ans << "\n";
}
注: 上面方法对小数据(n ≤ 1000)可行,大数据需用后缀数组或后缀自动机优化至 O(N log N)。
📋 本章总结
- 朴素匹配 O(N × M) 的浪费在于失配后丢弃已匹配信息
- 前缀函数
π[i]= 最长相等真前后缀,是失配跳转的依据 - 「拼接
pattern + '#' + text」一个技巧同时解决匹配、计数、周期 - KMP 的 border 结构是第 9.5 章 AC 自动机 fail 指针的直接原型
💡 章节联系: KMP 解决单模式串匹配;如果要同时匹配成百上千个模式串,请继续学习第 9.5 章:AC 自动机——它的 fail 指针就是把 KMP 的失配跳转搬到了 Trie 上。若只想 O(N+M) 快速判断子串相等,第 3.7 章的字符串哈希也是常用备选。回文与后缀视角的算法见第 9.4 章。
📖 第 9.3 章:Trie 树
🎯 学习目标
学完本章后,你将能够:
- 理解 Trie 树(字典树)的结构与操作
- 运用 Trie 树高效检索字符串集合
- 掌握带计数的前缀统计与 01-Trie 求最大异或
9.3.0 问题引入
你有 N 个单词(总字符数 ≤ 10⁶),接下来有 Q 次查询,每次给出一个字符串,你需要回答:
- 它是否在单词集合中?
- 有多少个单词以它为前缀?
用 set<string> 每次查询是 O(|s| log N) 的字符串比较,前缀查询更是要扫描整个集合。Trie 树(字典树)把「字符串比较」变成「树上走路」,插入和查询都只要 O(|s|)——与集合大小无关。
集合:{"cat", "car", "can", "bat", "bar"}
查询:"ca" → 有 3 个单词以它为前缀
查询:"cab" → 不存在
9.3.1 Trie 树的结构
什么是 Trie?
Trie(发音:try)是一种树形数据结构,用来存储和查询字符串集合。
核心思想:用从根节点到某节点的路径来表示一个字符串。每条边对应一个字符,相同前缀的字符串共享路径。
可视化
存入字符串集合 {"cat", "car", "bat", "bar", "can"}:
📄 存入字符串集合 {"cat", "car", "bat", "bar", "can"}:
根节点
/ \
c b
/ \ / \
a ? a ?
/|\ |
t r n r t("bat"和"bar"共享"ba"前缀)
/ \
★ ★
"bar" "bat"
※ ★ 表示在该节点结尾的字符串存在("end" 标记)
同一前缀(如 "ca")只存储一次,节省空间。
Trie 的数组实现
#include <bits/stdc++.h>
using namespace std;
// Trie 树(数组版,只支持小写字母)
const int MAXN = 500005; // 最大节点数 = 总字符数
struct Trie {
int ch[MAXN][26]; // ch[u][c] = 节点 u 的第 c 个子节点编号
bool exist[MAXN]; // exist[u] = 以节点 u 结尾的字符串是否存在
int cnt; // 节点计数器(根节点为 0)
Trie() : cnt(0) {
memset(ch[0], 0, sizeof(ch[0])); // 初始化根节点
exist[0] = false;
}
// 插入字符串
// 时间复杂度:O(|s|)
void insert(const string& s) {
int p = 0; // 从根节点开始
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) {
ch[p][ci] = ++cnt; // 新建节点
memset(ch[cnt], 0, sizeof(ch[cnt]));
exist[cnt] = false;
}
p = ch[p][ci]; // 移动到下一个节点
}
exist[p] = true; // 标记字符串末尾
}
// 查询字符串是否存在
// 时间复杂度:O(|s|)
bool find(const string& s) {
int p = 0; // 从根节点开始
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) return false; // 路径断了,不存在
p = ch[p][ci];
}
return exist[p]; // 必须到达结尾标记的节点
}
// 查询是否有以 prefix 为前缀的字符串
bool startsWith(const string& prefix) {
int p = 0;
for (char c : prefix) {
int ci = c - 'a';
if (!ch[p][ci]) return false;
p = ch[p][ci];
}
return true; // 路径存在即有此前缀(不需要 exist 标记)
}
};
int main() {
// 数组很大(约 52MB),必须放堆上——局部变量会爆栈
static Trie trie;
// 插入一些单词
trie.insert("apple");
trie.insert("app");
trie.insert("apply");
trie.insert("banana");
// 查询
cout << trie.find("apple") << endl; // 1(存在)
cout << trie.find("app") << endl; // 1(存在)
cout << trie.find("ap") << endl; // 0(路径存在,但没有标记)
cout << trie.startsWith("ap") << endl; // 1(有以 "ap" 开头的字符串)
cout << trie.startsWith("ban") << endl; // 1
cout << trie.startsWith("cat") << endl; // 0
return 0;
}
详细追踪:插入 "app" 和 "apple"
📄 查看代码:详细追踪:插入 "app" 和 "apple"
初始:只有根节点 0
插入 "app":
节点0 --'a'--> 节点1
节点1 --'p'--> 节点2
节点2 --'p'--> 节点3,exist[3] = true("app" 结束)
插入 "apple":
节点0 --'a'--> 节点1(已存在,复用)
节点1 --'p'--> 节点2(已存在,复用)
节点2 --'p'--> 节点3(已存在,复用)
节点3 --'l'--> 节点4(新建)
节点4 --'e'--> 节点5,exist[5] = true("apple" 结束)
现在 "app" 和 "apple" 共享前缀 "app"
9.3.2 Trie 树的经典应用
应用 1:单词频率统计(带计数的 Trie)
// 增加 count 数组记录每个节点被经过的次数
// count[u] = 以 u 为前缀的字符串的总插入次数
int count_prefix[MAXN]; // count[u] = 经过节点 u 的次数
void insert_with_count(const string& s) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) {
ch[p][ci] = ++cnt;
count_prefix[cnt] = 0;
}
p = ch[p][ci];
count_prefix[p]++; // 每经过一个节点,计数 +1
}
exist[p] = true;
}
// 查询有多少个已插入字符串以 prefix 为前缀
int count_starts_with(const string& prefix) {
int p = 0;
for (char c : prefix) {
int ci = c - 'a';
if (!ch[p][ci]) return 0;
p = ch[p][ci];
}
return count_prefix[p];
}
应用 2:01-Trie 求最大异或值
当数字以二进制形式插入 Trie 时,可以高效求「与某数异或值最大的数」。
原理:从最高位开始,贪心地走与当前位不同的那条路(使该位异或为 1)。
#include <bits/stdc++.h>
using namespace std;
// 01-Trie:维护整数集合,支持查询"与 x 异或最大的数"
// 按二进制位(从第30位到第0位)建树
const int BIT = 30;
const int MAXN_01 = 3000005;
int ch01[MAXN_01][2]; // 只有 0/1 两个子节点
int cnt01 = 0;
// 将整数 x 插入 01-Trie
void insert01(int x) {
int p = 0;
for (int i = BIT; i >= 0; i--) {
int bit = (x >> i) & 1; // 取第 i 位
if (!ch01[p][bit]) ch01[p][bit] = ++cnt01;
p = ch01[p][bit];
}
}
// 查询与 x 异或值最大的数,返回最大异或值
int max_xor(int x) {
int p = 0, res = 0;
for (int i = BIT; i >= 0; i--) {
int bit = (x >> i) & 1;
int want = 1 - bit; // 想要走与 bit 不同的方向(使异或为1)
if (ch01[p][want]) {
p = ch01[p][want];
res |= (1 << i); // 这一位异或为 1
} else {
p = ch01[p][bit]; // 没有理想方向,只能走 bit 方向
}
}
return res;
}
// 示例:
// 集合 {3, 7, 9, 12},查询与 6(二进制 110)异或最大
// 6 XOR 9 = 15(1111),是最大值
int main() {
int arr[] = {3, 7, 9, 12};
for (int x : arr) insert01(x);
cout << max_xor(6) << endl; // 输出 15
return 0;
}
追踪 max_xor(6) 的过程(6 = 0...0110):
第30~4位:全 0,Trie 中无这些位,跳过
第3位(bit=0):want=1,ch[p][1] 存在(9=1001 的第3位=1)→ 走1,res |= 8
第2位(bit=1):want=0,ch[p][0] 存在(9=1001 的第2位=0)→ 走0,res |= 4
第1位(bit=1):want=0,ch[p][0] 存在(9=1001 的第1位=0)→ 走0,res |= 2
第0位(bit=0):want=1,ch[p][1] 存在(9=1001 的第0位=1)→ 走1,res |= 1
最终 res = 8+4+2+1 = 15
对应的数是 9(9 XOR 6 = 15 ✓)
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| Trie 节点数组太小 | 最大节点数 = 所有字符串的总字符数 | MAXN = 所有字符串长度之和 + 1 |
| 忘记初始化新建节点的子指针 | ch[cnt] 未清零 | 新建节点时 memset(ch[cnt], 0, sizeof(ch[cnt])) |
| 01-Trie 位数设置错误 | BIT 设小了导致数据丢失 | 根据题目数值范围设置,整数通常 BIT = 30 |
| 混淆 find 与 startsWith | 走完路径就返回 true | find 必须检查 exist[p],startsWith 不需要 |
| 多组数据忘记清空 Trie | 上一组的节点残留 | 重置 cnt = 0 并初始化根节点(见第 9.5 章的清空写法) |
💪 练习题(本章 5 道,全部含完整解答)
🟢 基础练习
题目 1:单词检索
给定 N 个单词,Q 次查询,每次询问某单词是否在词典中。要求插入和查询都用 Trie,总复杂度 O(总字符数)。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 1000005;
int ch[MAXN][26];
bool exist[MAXN];
int tot = 0;
void insert(const string& s) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) {
ch[p][ci] = ++tot;
fill(ch[tot], ch[tot] + 26, 0);
exist[tot] = false;
}
p = ch[p][ci];
}
exist[p] = true;
}
bool query(const string& s) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) return false;
p = ch[p][ci];
}
return exist[p];
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n, q;
cin >> n;
for (int i = 0; i < n; i++) {
string w; cin >> w;
insert(w);
}
cin >> q;
while (q--) {
string w; cin >> w;
cout << (query(w) ? "YES" : "NO") << "\n";
}
return 0;
}
题目 2:最长公共前缀
给定 N 个字符串,求它们的最长公共前缀(LCP)。
示例:
输入:["flower","flow","flight"]
输出:"fl"
方法 1(排序法): 排序后只比较第一个和最后一个字符串的前缀,因为它们字典序差距最大,LCP 最短。
#include <bits/stdc++.h>
using namespace std;
string longestCommonPrefix(vector<string>& strs) {
if (strs.empty()) return "";
sort(strs.begin(), strs.end());
string& first = strs.front();
string& last = strs.back();
int i = 0;
while (i < (int)first.size() && i < (int)last.size() && first[i] == last[i])
i++;
return first.substr(0, i);
}
int main() {
vector<string> v = {"flower", "flow", "flight"};
cout << longestCommonPrefix(v) << "\n"; // "fl"
v = {"dog", "racecar", "car"};
cout << longestCommonPrefix(v) << "\n"; // ""
return 0;
}
方法 2(Trie法): 将所有字符串插入 Trie,从根节点出发沿唯一路径走,直到遇到分叉或终止标记。
string lcp_trie(vector<string>& strs) {
// 插入所有字符串后,从根出发找只有一个非空子节点且不是末尾的最长路径
for (auto& s : strs) insert(s);
string result = "";
int p = 0;
while (true) {
if (exist[p]) break; // 某字符串在此结束,不能继续
int next = -1, cnt = 0;
for (int i = 0; i < 26; i++) {
if (ch[p][i]) { next = i; cnt++; }
}
if (cnt != 1) break; // 有分叉,停止
result += (char)('a' + next);
p = ch[p][next];
}
return result;
}
🟡 进阶练习
题目 3:数组中任意两数的最大异或值
给定整数数组 nums,求任意两个元素异或的最大值。
示例:
nums = [3, 10, 5, 25, 2, 8]
最大异或:5 XOR 25 = 28
输出:28
思路: 将所有数插入 01-Trie,然后对每个数 x 查询「与 x 异或最大的数」并取全局最大值。
#include <bits/stdc++.h>
using namespace std;
const int BIT = 30;
const int MAXN = 3200005;
int ch[MAXN][2];
int tot = 0;
void insert(int x) {
int p = 0;
for (int i = BIT; i >= 0; i--) {
int b = (x >> i) & 1;
if (!ch[p][b]) ch[p][b] = ++tot;
p = ch[p][b];
}
}
int max_xor_with(int x) {
int p = 0, res = 0;
for (int i = BIT; i >= 0; i--) {
int b = (x >> i) & 1;
int want = 1 - b; // 想走异位,使该位异或为 1
if (ch[p][want]) {
res |= (1 << i);
p = ch[p][want];
} else {
p = ch[p][b];
}
}
return res;
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n; cin >> n;
vector<int> nums(n);
for (int& x : nums) { cin >> x; insert(x); }
int ans = 0;
for (int x : nums)
ans = max(ans, max_xor_with(x));
cout << ans << "\n";
return 0;
}
追踪(nums = [3, 10, 5, 25, 2, 8],查询 5 = 0b000101): 下图展示对 5 的贪心查询——每一位尽量走相反位(绿色边),走不通时被迫走相同位(红色虚线边),最终沿 25 = 0b11001 的路径得到 res = 16 + 8 + 4 = 28 = 5 XOR 25。
题目 4:电话号码查找(前缀冲突检测)
给定 N 个电话号码,判断是否存在某号码是另一个号码的前缀。若存在输出 NO,否则输出 YES。
示例:
号码:["911","9116","91125"]
"911" 是 "9116" 的前缀 → 输出 NO
思路: 将所有号码插入 Trie,若插入过程中遇到已有终止标记的节点(当前号码是已插入号码的延伸),或插入完后该节点还有子节点(已插入号码是当前号码的前缀),则存在冲突。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 1000005;
int ch[MAXN][10]; // 数字 0~9
bool is_end[MAXN];
int tot = 0;
// 插入号码,返回是否发现冲突
bool insert_check(const string& s) {
int p = 0;
for (char c : s) {
int d = c - '0';
if (is_end[p]) return true; // 已有号码是当前号码的前缀
if (!ch[p][d]) {
ch[p][d] = ++tot;
fill(ch[tot], ch[tot] + 10, 0);
is_end[tot] = false;
}
p = ch[p][d];
}
// 插入完成,检查该节点是否已有子节点(当前号码是已有号码的前缀)
for (int i = 0; i < 10; i++)
if (ch[p][i]) return true;
is_end[p] = true;
return false;
}
int main() {
int n; cin >> n;
bool conflict = false;
for (int i = 0; i < n; i++) {
string s; cin >> s;
if (insert_check(s)) conflict = true;
}
cout << (conflict ? "NO" : "YES") << "\n";
return 0;
}
🔴 挑战练习
题目 5:最大数组异或路径(树上路径 + 01-Trie)
给定一棵有 N 个节点的树,每条边有权值。求树上任意一条路径,使路径上所有边权的异或和最大。
提示: 利用「两点路径的异或 = 两点到根的异或路径的异或」,先 DFS 求所有节点到根的异或距离,再用 01-Trie 求最大异或对。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
const int BIT = 30;
const int TRIE_MAXN = MAXN * 31 * 2;
// 01-Trie
int ch_trie[TRIE_MAXN][2];
int tot_trie = 0;
void insert_trie(int x) {
int p = 0;
for (int i = BIT; i >= 0; i--) {
int b = (x >> i) & 1;
if (!ch_trie[p][b]) ch_trie[p][b] = ++tot_trie;
p = ch_trie[p][b];
}
}
int max_xor_trie(int x) {
int p = 0, res = 0;
for (int i = BIT; i >= 0; i--) {
int b = (x >> i) & 1;
int want = 1 - b;
if (ch_trie[p][want]) { res |= (1 << i); p = ch_trie[p][want]; }
else p = ch_trie[p][b];
}
return res;
}
// 树 DFS
vector<pair<int,int>> adj[MAXN];
int dist[MAXN]; // dist[i] = 根到 i 的异或距离
void dfs(int u, int parent) {
insert_trie(dist[u]);
for (auto [v, w] : adj[u]) {
if (v == parent) continue;
dist[v] = dist[u] ^ w;
dfs(v, u);
}
}
int main() {
int n; cin >> n;
for (int i = 0; i < n - 1; i++) {
int u, v, w; cin >> u >> v >> w;
adj[u].push_back({v, w});
adj[v].push_back({u, w});
}
dist[1] = 0;
dfs(1, -1); // 从节点 1 出发 DFS
// 对每个节点,在 Trie 中找与其异或最大的节点
int ans = 0;
for (int i = 1; i <= n; i++)
ans = max(ans, max_xor_trie(dist[i]));
cout << ans << "\n";
return 0;
}
关键原理:
设 d[u] = 根到 u 的边权异或和。
路径 u → v 的异或和 = d[u] XOR d[v](因为公共前缀部分异或两次等于 0)。
所以只需在所有 d[i] 中找最大异或对,01-Trie 做到 O(N log W)。
📋 本章总结
- Trie 用「根到节点的路径」表示字符串,公共前缀只存一次
- 插入 / 查询都是 O(|s|),与集合大小无关
exist标记区分「恰好是这个串」与「是某个串的前缀」- 01-Trie 把整数按二进制位建树,贪心走「相反位」求最大异或
💡 章节联系: Trie 是第 9.5 章 AC 自动机的骨架——在 Trie 上加一圈 fail 指针,它就能在文本上「自动机式」地多模式匹配。前缀冲突、前缀计数这类问题也常与第 3.7 章的哈希技术结合(哈希判等 + Trie 组织)。
📖 第 9.4 章:Manacher 与 Z 函数
🎯 学习目标
学完本章后,你将能够:
- 用 Manacher 算法 O(N) 求最长回文子串并统计回文个数
- 理解 Z 函数(扩展 KMP)的定义与线性求法
- 掌握两者共享的「维护最右已知区间 + 镜像加速」思想
9.4.0 问题引入
本章解决两个看似不同、实则同源的问题:
问题 A(最长回文): 给定字符串 s(长度 ≤ 10⁶),求最长回文子串的长度。
s = "abababa" → 7
s = "abababc" → 5("ababa")
问题 B(前缀匹配): 给定模式串 P 和文本 T,统计有多少个位置 i,使得 P 与 T 从 i 开始的后缀的前 |P| 个字符完全匹配。
P = "aba", T = "ababa" → 2(i = 0 和 i = 2)
问题 A 的朴素做法(中心扩展)是 O(N²),问题 B 的朴素做法(逐位置比较)也是 O(N²)。有趣的是,两者的线性解法——Manacher 与 Z 函数——用了完全相同的策略:维护一个「当前已知的最靠右的区间」,新位置的答案先从区间内的镜像位置照搬,不够再暴力扩展。学完一个,另一个就是换了个定义照抄。
9.4.1 Manacher 算法——O(N) 最长回文
从中心扩展说起:O(N²) 为什么超时
「求字符串 s 的最长回文子串」有一个经典做法:枚举每个中心,向两边扩展。回文串有两种中心——某个字符(奇数长度,如 "aba" 中心是 b)或某两个字符之间的空隙(偶数长度,如 "abba" 中心是两个 b 之间)。每种中心最坏扩展 O(N),总共 O(N) 个中心,复杂度 O(N²)。
当 N = 10⁶ 时(很多题就是这个量级),O(N²) 会达到 10¹² 次操作,必然超时。1975 年 Manacher 提出的算法把它降到了 O(N)。
技巧一:插入 '#' 统一奇偶
奇偶两种中心要写两份几乎相同的代码,容易出错。解决办法:在每两个字符之间以及首尾都插入分隔符 #。
原串: a b a b a b c
新串:# a # b # a # b # a # b # c #
新串长度变成 2N+1(一定是奇数),所有回文的中心都变成了一个字符:
- 原串的奇回文
"aba"→ 新串#a#b#a#,中心是b - 原串的偶回文
"abba"→ 新串#a#b#b#a#,中心是#
从此只需要处理「奇数长度」这一种情况。
p[i] 的定义与关键性质
设新串为 t,定义 p[i] = 以 t[i] 为中心的最长回文的半径(回文串为 t[i-p[i]+1 .. i+p[i]-1],即 p[i] 是「包括中心在内往右延伸的字符数」)。
一个重要结论:在原串中,以某位置为中心的最长回文长度 = 新串中对应位置的 p[i] - 1。例如 "abababc" 中新串中心在 t[7]=a(原串下标 3)处 p=6,对应原串回文 "ababa",长度 5 = 6-1。
朴素做法对每个 i 从半径 1 开始扩展,浪费了大量已经算出的信息。Manacher 的核心是利用已知回文的镜像加速。
维护当前右端点最靠右的回文串,记其中心为 id、右边界为 mx。当计算 p[i] 时,若 i < mx,说明 i 在这个大回文内部。设 j = 2*id-i 是 i 关于 id 的镜像位置,则:
p[i] ≥ min(p[j], mx - i)
为什么?
- 若以 j 为中心的回文完全落在大回文内部(p[j] < mx-i),由对称性,以 i 为中心的回文至少和它一样长,直接
p[i] = p[j],一步都不用扩展; - 若以 j 为中心的回文顶到了大回文的边界(p[j] ≥ mx-i),超出部分没有对称性保证,只能确定
p[i] ≥ mx-i,之后从 mx-i 开始继续中心扩展。
若 i ≥ mx,没有任何信息可用,老老实实从半径 1 开始扩展。
为什么是 O(N)?注意每次中心扩展成功(while 循环多走一步),mx 都会随之向右移动至少 1,而 mx 从不减小、最多移动 N 次。所以所有扩展的总步数是 O(N)。
完整实现(含哨兵)
#include <bits/stdc++.h>
using namespace std;
// Manacher:O(N) 求最长回文子串长度
// 原串中以某位置为中心的最长回文长度 = 新串对应位置的 p[i] - 1
pair<string, vector<int>> manacher(const string& s) {
// 1. 构造 "$#a#b#...#c#":开头 '$' 哨兵防越界,'#' 统一奇偶
string t = "$#";
for (char c : s) { t += c; t += '#'; }
t += '^'; // 结尾哨兵
int n = t.size();
vector<int> p(n, 0);
// 2. 维护当前右边界最靠右的回文串(中心 id,右端 mx)
for (int i = 1, id = 0, mx = 0; i < n - 1; i++) {
// 镜像加速:i 在大回文内部时,借用镜像位置 2*id-i 的信息
p[i] = (mx > i) ? min(p[2 * id - i], mx - i) : 1;
// 中心扩展(哨兵保证不越界:'$' 和 '^' 必不相等且不等于其它字符)
while (t[i + p[i]] == t[i - p[i]]) p[i]++;
// 更新最右回文
if (i + p[i] > mx) { mx = i + p[i]; id = i; }
}
return {t, p};
}
int longest_palindrome(const string& s) {
auto [t, p] = manacher(s);
int best = 0;
for (int i = 1; i < (int)t.size() - 1; i++) best = max(best, p[i] - 1);
return best;
}
int main() {
cout << longest_palindrome("abababa") << endl; // 输出 7
cout << longest_palindrome("abababc") << endl; // 输出 5("ababa")
cout << longest_palindrome("cbbd") << endl; // 输出 2("bb")
return 0;
}
逐步追踪:"abababc"
新串 t = $#a#b#a#b#a#b#c#^(下标 1..15 为有效部分):
i : 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
t[i]: $ # a # b # a # b # a # b # c # ^(1..15 为有效部分)
p[i]: 1 2 1 4 1 6 1 6 1 4 1 2 1 2 1
几个关键位置:
i=4(字符 b):扩展得#a#b#a#,p=4,回文右端到 i+p-1=7。更新 mx=8? 不——右边界是 i+p=8,即 mx=8,id=4;i=7(字符 a):在 [0,8] 内,镜像 j=1,min(p[1], 8-7)=1,从 1 扩展得#b#a#b#a#b#,p=6,mx 更新为 13,id=7;i=9(字符 b):在 [1,13] 内,镜像 j=5,min(p[5]=1, 13-9)=1,扩展得#a#b#a#b#a#,p=6;i=11(字符 a):镜像 j=3,min(p[3]=1, ...) =1,扩展得 p=4;i=13(字符 b):镜像 j=1,但 13 已顶到 mx,从 min(p[1]=2, 13-13+...) 开始,扩展得#a#b#,p=2。
最大 p 值为 6,最长回文长度 = 6-1 = 5,即 "ababa"。
⚠️ 边界哨兵
开头放 '$'、结尾放 '^'(两个都不属于原字符集、且互不相同)不是装饰:while (t[i+p[i]] == t[i-p[i]]) 故意不写下标检查。若没有哨兵,i 靠近边界时 i-p[i] 会越界到 -1、i+p[i] 会越界到 n,产生未定义行为;有了哨兵,扩展到哨兵位置必然失配停下。这是 Manacher 代码既短又快的关键——但前提是哨兵字符绝不能出现在原串中。
例题:回文子串计数
问题:统计字符串 s 中回文子串的个数(子串按位置区分,如 "aaa" 有 6 个:3 个 "a"、2 个 "aa"、1 个 "aaa")。
思路:以每个位置为中心的回文串个数恰好是 p[i] / 2(新串中半径 p[i] 的回文,对应原串中 p[i]/2 个回文:从最长的开始每次长度减 2)。把所有中心加起来即可,复杂度 O(N)。
#include <bits/stdc++.h>
using namespace std;
long long count_palindromes(const string& s) {
string t = "$#";
for (char c : s) { t += c; t += '#'; }
t += '^';
int n = t.size();
vector<int> p(n, 0);
for (int i = 1, id = 0, mx = 0; i < n - 1; i++) {
p[i] = (mx > i) ? min(p[2 * id - i], mx - i) : 1;
while (t[i + p[i]] == t[i - p[i]]) p[i]++;
if (i + p[i] > mx) { mx = i + p[i]; id = i; }
}
long long ans = 0;
for (int i = 1; i < n - 1; i++) ans += p[i] / 2;
return ans;
}
int main() {
cout << count_palindromes("abababc") << endl; // 输出 13
cout << count_palindromes("aaa") << endl; // 输出 6
cout << count_palindromes("abc") << endl; // 输出 3
return 0;
}
验证 "abababc":单字符 7 个 + "aba"/"bab" 共 4 个 + "ababa"/"babab" 共 2 个 = 13 ✓。
9.4.2 Z 函数(扩展 KMP)
引入:另一种「自我匹配」
回忆第 9.2 章的前缀函数:π[i] 描述的是**「以 i 结尾的后缀」与「整个串的前缀」**的最长匹配。现在换一个视角——我们不看「以 i 结尾的」,而看「以 i 开头的」:
z[i] = 后缀 s[i..n-1] 与整个串 s 的最长公共前缀(LCP)的长度,规定 z[0] = 0(或 n,看实现约定,本书取 0)。
对比一下:
- π[i]:s 的前缀 vs s[0..i] 的后缀——「前缀 vs 后缀」
- z[i]:s 的前缀 vs s[i..] 的前缀——「前缀 vs 前缀」
两者信息等价(可以 O(N) 互相推导),但 Z 函数的定义更直观:z[i] 就是「从 i 开始往后,能和串开头匹配多长」。
几个例子(下标从 0 开始):
z("aaaaa") = [0, 4, 3, 2, 1]
z("aaabaab") = [0, 2, 1, 0, 2, 1, 0]
z("abacaba") = [0, 0, 1, 0, 3, 0, 1]
比如 "abacaba":z[4]=3,因为从下标 4 开始的后缀 "aba" 恰好与原串前缀 "aba" 匹配 3 个字符。
Z-box 与线性算法
朴素做法对每个 i 从 0 开始逐字符比较,最坏 O(N²)(如 "aaaaa")。加速的思路和 Manacher 惊人地相似:维护已经匹配到的最右端,利用已算出的信息。
称区间 [i, i+z[i]-1] 为 i 的匹配段(Z-box)。算法过程中维护右端点最靠右的 Z-box,记为 [l, r]——它的含义是:s[l..r] 与 s 的前缀完全相同。
计算 z[i] 时(i 从 1 到 n-1):
-
若
i < r:i 落在 Z-box 内。由s[l..r] = s[0..r-l],位置 i 在 box 内对应于前缀中的位置i-l,因此z[i] ≥ min(z[i-l], r - i)- 若
z[i-l] < r-i:以 i-l 为中心的匹配段没有顶到 box 右端,整个信息可以照搬,z[i] = z[i-l],一步不用比较; - 否则只能确定 z[i] ≥ r-i,从 r-i 开始暴力扩展。
- 若
-
若
i ≥ r:没有信息,从 0 开始暴力扩展。
算出 z[i] 后,若 i + z[i] > r,更新 l = i, r = i + z[i]。
复杂度:暴力扩展每成功一步,r 就向右移至少 1,而 r 只增不减且不超过 n,所以总扩展次数 O(N),整体 O(N)。
完整实现
#include <bits/stdc++.h>
using namespace std;
// Z 函数(扩展 KMP):z[i] = s 与 s[i..] 的最长公共前缀长度,z[0] = 0
vector<int> z_function(const string& s) {
int n = s.size();
vector<int> z(n, 0);
for (int i = 1, l = 0, r = 0; i < n; i++) {
// i 在 Z-box [l,r) 内:借用镜像位置 i-l 的 z 值
if (i < r) z[i] = min(r - i, z[i - l]);
// 暴力扩展
while (i + z[i] < n && s[z[i]] == s[i + z[i]]) z[i]++;
// 更新最右 Z-box
if (i + z[i] > r) { l = i; r = i + z[i]; }
}
return z;
}
int main() {
for (const string& s : {"aaaaa", "aaabaab", "abacaba"}) {
auto z = z_function(s);
cout << s << ": ";
for (int x : z) cout << x << " ";
cout << endl;
}
return 0;
}
输出:
aaaaa: 0 4 3 2 1
aaabaab: 0 2 1 0 2 1 0
abacaba: 0 0 1 0 3 0 1
逐步追踪:"aaaaa"
i=1: i>r(r=0),暴力扩展:s[0..3] vs s[1..4] 全匹配,z[1]=4。
更新 l=1, r=5。
i=2: i<r,z[2] = min(5-2, z[1]=4) = 3。i+z[2]=5 不大于 r=5,不再扩展。
i=3: i<r,z[3] = min(5-3, z[2]=3) = 2。
i=4: i<r,z[4] = min(5-4, z[3]=2) = 1。
结果 [0,4,3,2,1]——注意 i≥2 之后一次比较都没做,全部靠镜像直接照搬。
与 KMP 对照
| 前缀函数(KMP,第 9.2 章) | Z 函数(扩展 KMP) | |
|---|---|---|
| 定义 | π[i] = s[0..i] 的最长 border(前缀 = 后缀) | z[i] = s[i..] 与 s 的最长公共前缀 |
| 视角 | 以 i 结尾的匹配 | 以 i 开头的匹配 |
| 维护的区间 | 「失配指针」链 π[π[...]] | 最右 Z-box [l, r] |
| 求模式串出现 | 拼接 P#T,找 π[i] = |P| | 拼接 P#T,找 z[i] = |P| |
| 复杂度 | O(N) | O(N) |
| 适用偏好 | 失配跳转、border 树上做 DP | 「每个后缀 vs 前缀」的直观统计 |
经验法则:题目若问「后缀与前缀的关系」(如最短周期 i + z[i] == n、后缀匹配计数),Z 函数往往写起来更直白;若要在 border 链上做递推 DP,KMP 的 π 数组更顺手。
例题:border 式匹配计数
问题:给定模式串 P 和文本 T(|P|, |T| ≤ 10⁶),求 T 中有多少个位置 i,使得 T 从 i 开始的后缀以 P 为前缀(即 P 与 T 的该后缀的前 |P| 个字符完全匹配)。
思路:和 KMP 匹配一样用拼接技巧。构造 s = P + '#' + T,求 Z 函数。对 T 的每个起点 i,对应 s 中下标 i + |P| + 1,若 z[i+|P|+1] == |P|,则该位置匹配。分隔符 '#' 保证 z 值不会「穿过」边界(P 和 T 中都不含 '#')。复杂度 O(|P| + |T|)。
#include <bits/stdc++.h>
using namespace std;
vector<int> z_function(const string& s) {
int n = s.size();
vector<int> z(n, 0);
for (int i = 1, l = 0, r = 0; i < n; i++) {
if (i < r) z[i] = min(r - i, z[i - l]);
while (i + z[i] < n && s[z[i]] == s[i + z[i]]) z[i]++;
if (i + z[i] > r) { l = i; r = i + z[i]; }
}
return z;
}
long long count_matches(const string& P, const string& T) {
auto z = z_function(P + '#' + T);
int m = P.size();
long long cnt = 0;
for (int i = m + 1; i < (int)z.size(); i++)
if (z[i] == m) cnt++;
return cnt;
}
int main() {
cout << count_matches("ab", "ababab") << endl; // 输出 3(下标 0、2、4)
cout << count_matches("aba", "ababa") << endl; // 输出 2(下标 0、2)
cout << count_matches("xyz", "abcabc") << endl; // 输出 0
return 0;
}
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| Manacher 哨兵缺失或与原字符冲突 | while 循环不检查下标,越界为未定义行为 | 开头放 '$'、结尾放 '^',且保证不在原串中出现 |
| Manacher 忘记回文长度 = p[i] - 1 | 新串长度 2N+1,半径换算回来要减 1 | 记住结论:原串回文长度 = p[i] - 1 |
Z 函数边界用 i <= r 且照搬时多扩展 | z[i-l] 顶到 box 右端时照搬结果错误 | 用 i < r(r 为开区间端点)或在 z[i-l] < r-i 时才直接赋值 |
| z[0] 约定混乱 | 有的实现取 z[0]=n,有的取 0 | 全书统一取 z[0] = 0,拼接匹配从下标 m+1 开始找 |
| 拼接时分隔符出现在 P 或 T 中 | z 值可能穿过边界导致错误匹配 | 选字符集中不存在的分隔符 |
💪 练习题(本章 2 道,全部含完整解答)
🟡 进阶练习
题目 1:最长回文子串
给定字符串 s(长度 ≤ 10⁶),求最长回文子串的长度。要求 O(N)。
示例:
s = "abababa" → 7
s = "abababc" → 5("ababa")
思路: Manacher 算法。插入 # 统一奇偶后求半径数组 p,答案为 max(p[i]) - 1。
#include <bits/stdc++.h>
using namespace std;
int main() {
string s; cin >> s;
string t = "$#";
for (char c : s) { t += c; t += '#'; }
t += '^';
int n = t.size();
vector<int> p(n, 0);
int best = 0;
for (int i = 1, id = 0, mx = 0; i < n - 1; i++) {
p[i] = (mx > i) ? min(p[2 * id - i], mx - i) : 1;
while (t[i + p[i]] == t[i - p[i]]) p[i]++;
if (i + p[i] > mx) { mx = i + p[i]; id = i; }
best = max(best, p[i] - 1);
}
cout << best << "\n";
return 0;
}
🔴 挑战练习
题目 2:两字符串 border 计数
给定字符串 P 和 T(长度 ≤ 10⁶),统计有多少个位置 i(0 ≤ i < |T|),使得 P 恰好是「T 从 i 开始的后缀」的前缀(即 P 与 T[i..i+|P|-1] 完全匹配)。要求 O(|P| + |T|)。
示例:
P = "aba", T = "ababa" → 2(i = 0 和 i = 2)
P = "aa", T = "aaaa" → 3(i = 0、1、2)
思路: 拼接 P + '#' + T 求 Z 函数,统计拼接串中 z[i] == |P| 的个数。分隔符防止 z 值跨越 P 与 T 的边界。
#include <bits/stdc++.h>
using namespace std;
vector<int> z_function(const string& s) {
int n = s.size();
vector<int> z(n, 0);
for (int i = 1, l = 0, r = 0; i < n; i++) {
if (i < r) z[i] = min(r - i, z[i - l]);
while (i + z[i] < n && s[z[i]] == s[i + z[i]]) z[i]++;
if (i + z[i] > r) { l = i; r = i + z[i]; }
}
return z;
}
int main() {
string P, T;
cin >> P >> T;
auto z = z_function(P + '#' + T);
int m = P.size();
long long cnt = 0;
for (int i = m + 1; i < (int)z.size(); i++)
if (z[i] == m) cnt++;
cout << cnt << "\n";
return 0;
}
注: 若改成统计「T 的每个前缀中有多少个 border 等于 P」之类的变体,则更适合同样在拼接串上做 KMP / Z 函数后附加计数数组,思路相同。
📋 本章总结
- Manacher:插
#统一奇偶 + 哨兵防越界 + 镜像加速,O(N) 求最长回文 - Z 函数:z[i] = 后缀与前缀的最长匹配,最右 Z-box 镜像照搬,O(N)
- 两者共享同一个思想:维护最靠右的已知区间,能照搬就照搬,不够再暴力扩展
- 「拼接 P#T」技巧在 KMP(第 9.2 章)和 Z 函数中通用
💡 章节联系: Z 函数是 第 9.2 章 KMP的镜像兄弟——一个看「以 i 结尾」的匹配,一个看「以 i 开始」的匹配。想同时匹配多个模式串时,单模式的 KMP / Z 函数都不够用,请前往第 9.5 章:AC 自动机。若需要 O(1) 判断任意子串是否回文,Manacher 的 p 数组还可以与第 3.7 章的字符串哈希配合使用。
📖 第 9.5 章:AC 自动机
🎯 学习目标
学完本章后,你将能够:
- 理解 fail 指针的定义与作用(KMP 失配思想搬到 Trie 上)
- 用 BFS 构建 AC 自动机并解释为什么必须按层构建
- 在文本上运行自动机,完成多模式串的同时匹配与计数
- 分析总复杂度 O(|T| + Σ|P| + 匹配开销)
9.5.0 问题引入
给定一篇长为 10⁶ 的文章,和 100 个模式串(总长 ≤ 10⁶),请统计每个模式串在文章中出现的次数。
文章: "she sells seashells by the seashore"
模式串:"she", "he", "hers", "sea"
结果: she → 2 次(位置 0 和 13 内含)
he → 4 次(she、shell、the…… 都藏着 he)
(精确数字我们后面用代码验证。)
对每个模式串跑一遍第 9.2 章的 KMP,总复杂度是 O(100 × 10⁶) = 10⁸——勉强能过 1 个模式串 100 次还好,但模式串数目一旦到 10⁴、10⁵ 就彻底不行了。
AC 自动机(Aho-Corasick Automaton,与「自动 AC 机」无关,虽然名字很诱人)把所有模式串一起放进一棵 Trie(第 9.3 章),再给每个节点加一个 fail 指针(失配指针,思想来自第 9.2 章的 KMP),就能在 O(|文本| + Σ|模式串|) 的构建后,一次扫描文本同时匹配所有模式串。
9.5.1 从 Trie 到 AC 自动机
回顾:KMP 失配时怎么办
KMP 匹配单个模式串时,失配不是从头再来,而是跳到 π[j]——当前已匹配部分的最长相等前后缀——继续比较。**「失配后跳到最长后缀对应的位置」**就是这个算法的灵魂。
多模式串的失配:fail 指针
把所有模式串插入 Trie 后,在文本上匹配 = 从根出发,沿文本字符逐个往下走。问题来了:走不下去怎么办?
例如模式串 {"she", "his", "hers"},文本读到 "shi"——先走 s→h,下一步要匹配 i,但 h 节点下面没有 i 的边(只有 e)。KMP 告诉我们:别回根,找当前已走路径的后缀中,还能在 Trie 里接着走的最长的那条路。"sh" 的后缀 "h" 恰好是 "his" 的前缀,所以应该跳到 "h" 对应的节点,再从那里走 i。
这就是 fail 指针的定义:
fail[u] = Trie 中「u 对应字符串的最长后缀」所在的节点(后缀要严格更短;若不存在这样的后缀,fail[u] = 根)。
三个关键性质:
- fail 指针总指向更浅的节点(对应更短的字符串),所以沿 fail 链跳有限步必然到根;
- 一个节点的 fail 链上的所有节点,恰好是它对应字符串的全部「Trie 中存在的前缀后缀」,从长到短排列——文本走到 u 时,以 u 结尾能匹配的模式串,全在 u 及其 fail 链上;
- 根的所有儿子(长度为 1 的字符串)没有更短的非空后缀,所以它们的 fail 都是根。
一句话总结:fail 指针 = KMP 的 π 数组搬到 Trie 上。 π[i] 是「前缀函数」,fail[u] 是「前缀树上的失配函数」。
模式串 {"she", "his", "hers"} 的 Trie:
根
/ \
s h
| | \
h i e(r s) ← "hers" 路径
| |
e s
↑
"she" 的终点 e 节点 u
fail 指针(部分):
"she" 的 e 节点 → 后缀 "he"、"e" 在 Trie 中?都不在 → 根
"hers" 的 s 节点 → 后缀 "s" 在 Trie 中 → s 节点
9.5.2 构建:BFS 层层求 fail
递推关系
fail 指针有一个漂亮的递推结构。设节点 u 的儿子是 ch[u][c],那么:
求 fail[v],其中 v = ch[u][c]:从 j = fail[u] 开始,若
ch[j][c]不存在就一直j = fail[j]往上跳;最后 v 的 fail 就是ch[j][c](跳到根还不存在则 fail[v] = 根)。
为什么正确?v 对应字符串 = u 对应字符串 + 字符 c。它的最长后缀若非空,去掉末尾的 c 后应该是 u 的某个后缀——而 u 的所有后缀恰好沿 fail[u] 的 fail 链分布,所以从 fail[u] 出发跳链寻找即可。这与 KMP 求 π 时的 j = π[j-1] 跳转一模一样。
为什么必须 BFS?
fail[v] 依赖 fail[u],而 u 的深度严格小于 v 的深度。按深度从小到大处理,算每个点的 fail 时它依赖的点都算好了——这正是 BFS 的顺序。如果用 DFS,一个深节点的 fail 可能要引用浅节点上还没算出的信息。
实用优化:路径压缩(「图优化」/ trie 图)
构建时顺手做一件事:若 ch[u][c] 不存在,就直接令 ch[u][c] = ch[fail[u]][c](跳几层后找到的那个转移)。这样构建完成后,自动机上每个节点都有 26 条出边——匹配时再也不需要跳 fail 链找转移,每步 O(1) 走人即可。fail 链只在统计答案时才需要走。
完整构建代码
#include <bits/stdc++.h>
using namespace std;
// AC 自动机(数组版,只支持小写字母)
const int MAXN = 1000006; // 最大节点数 = 所有模式串总长 + 1
int ch[MAXN][26]; // 转移边(构建后为 trie 图,全满)
int fail_[MAXN]; // fail 指针(fail 是关键字,改名 fail_)
int cnt[MAXN]; // cnt[u] = 以节点 u 结尾的模式串个数(可重复)
int tot = 0; // 节点计数器,根节点为 0
// 插入一个模式串 —— 和普通 Trie 完全一样(第 9.3 章)
void insert_word(const string& s) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) {
ch[p][ci] = ++tot;
fill(ch[tot], ch[tot] + 26, 0);
fail_[tot] = 0;
cnt[tot] = 0;
}
p = ch[p][ci];
}
cnt[p]++; // 该节点结尾的模式串数 +1
}
// BFS 构建 fail 指针与 trie 图
void build() {
queue<int> q;
// 深度为 1 的节点:fail 指向根
for (int c = 0; c < 26; c++) {
if (ch[0][c]) {
fail_[ch[0][c]] = 0;
q.push(ch[0][c]);
}
}
while (!q.empty()) {
int u = q.front(); q.pop();
// 注意:u 的 fail 已在 u 入队前算好
for (int c = 0; c < 26; c++) {
int v = ch[u][c];
if (v) {
// 核心:v 的 fail = u 的 fail 沿链找到的 c 转移
// 因为 build 时 ch[fail_[u]][c] 已被补全(fail 更浅,先处理过)
fail_[v] = ch[fail_[u]][c];
q.push(v);
} else {
// 路径压缩:不存在的边指向 fail 链上的转移
ch[u][c] = ch[fail_[u]][c];
}
}
}
}
int main() {
// 模式串 {"she", "his", "hers"}
insert_word("she");
insert_word("his");
insert_word("hers");
build();
// 验证:打印每个节点的 fail 深度
// "hers" 的最后一个 s 节点,fail 应指向 "s"(根的儿子)
cout << "构建完成,共 " << tot << " 个节点" << endl;
return 0;
}
为什么 fail_[v] = ch[fail_[u]][c] 一句话就够? 因为 BFS 保证处理 u 时,fail_[u] 已算好,而且更浅的节点都已经过完了路径压缩——ch[fail_[u]][c] 必然存在(最坏是根的转移,指向 0 或根的儿子)。所以不需要 while 循环跳链,一行搞定。这是「边 BFS 边压缩」写法简洁的原因。
9.5.3 匹配:在文本上走自动机
基本流程
把文本 T 逐字符喂给自动机,维护当前节点 p:
p = 0
for c in T:
p = ch[p][c - 'a'] // trie 图保证转移永远存在,无需跳 fail
沿 p 的 fail 链统计所有以 p 结尾的模式串
第 9.5.1 节说过:文本走到 p 时,能匹配上的模式串全部在 p 及其 fail 链上。所以统计答案就是沿 fail 链走一遍,累加每个节点的 cnt。
沿 fail 链统计的两种写法
写法 1(直接跳链):每个位置沿 fail 链走到根,累加 cnt。最坏总代价 O(|T| × 最长模式串),模式串短时够用,但 "aaaa…" 加上大量 a、aa、aaa… 模式串会把链拉得很长。
写法 2(差分 + fail 树)(推荐):先只在每个到达的节点 p 上打 +1 标记;扫描完后,按 BFS 逆序把每个节点的标记加到它的 fail 节点上——即fail 树上从叶子到根做一次子树和。这样「每个模式串出现次数」= 它的结尾节点在 fail 树上的子树标记和,整趟匹配严格 O(|T| + Σ|P|)。
完整实战:多模式串出现次数
问题:给定 n 个模式串(总长 ≤ 10⁶)和文本 T(|T| ≤ 10⁶),输出每个模式串在 T 中出现的次数(允许重叠,如 "aa" 在 "aaa" 中出现 2 次)。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 1000006;
int ch[MAXN][26];
int fail_[MAXN];
int cnt[MAXN]; // 该节点结尾的模式串个数
long long hit[MAXN]; // 该节点被文本「路过」的次数(含 fail 树传播)
int tot = 0;
int order_[MAXN]; // BFS 出队顺序(构建时记录,用于逆序传播)
int order_cnt = 0;
void insert_word(const string& s, int& node_id) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) {
ch[p][ci] = ++tot;
fill(ch[tot], ch[tot] + 26, 0);
fail_[tot] = 0;
cnt[tot] = 0;
}
p = ch[p][ci];
}
cnt[p]++;
node_id = p; // 记住这个模式串的结尾节点,答案从它读
}
void build() {
queue<int> q;
for (int c = 0; c < 26; c++)
if (ch[0][c]) { fail_[ch[0][c]] = 0; q.push(ch[0][c]); }
while (!q.empty()) {
int u = q.front(); q.pop();
order_[order_cnt++] = u; // 记录出队顺序
for (int c = 0; c < 26; c++) {
int v = ch[u][c];
if (v) {
fail_[v] = ch[fail_[u]][c];
q.push(v);
} else {
ch[u][c] = ch[fail_[u]][c];
}
}
}
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
// 自测样例(改为读入版只需换掉这两行)
vector<string> patterns = {"she", "he", "hers", "sea"};
string text = "she sells seashells by the seashore";
vector<int> end_node(patterns.size());
for (size_t i = 0; i < patterns.size(); i++)
insert_word(patterns[i], end_node[i]);
build();
// 匹配:trie 图上每步 O(1) 转移,只在到达节点打标记
int p = 0;
memset(hit, 0, sizeof(long long) * (tot + 1));
for (char c : text) {
if (c < 'a' || c > 'z') continue; // 跳过空格等非字母
p = ch[p][c - 'a'];
hit[p]++;
}
// BFS 逆序传播:把标记沿 fail 边向浅处累加(fail 树自底向上求和)
for (int i = order_cnt - 1; i >= 0; i--) {
int u = order_[i];
hit[fail_[u]] += hit[u];
}
// 每个模式串的出现次数 = 其结尾节点的子树标记和
for (size_t i = 0; i < patterns.size(); i++)
cout << patterns[i] << " 出现 " << hit[end_node[i]] << " 次\n";
// 实际输出(可自行验证):
// she 出现 2 次(开头的 she,以及 seashells 中的 "sea|she|lls")
// he 出现 3 次(she、seashells 中的 she、the 中的 he)
// hers 出现 0 次
// sea 出现 2 次(seashells、seashore)
return 0;
}
验证 "she sells seashells by the seashore"(去掉空格后为 shesellsseashellsbytheseashore):
she:开头"she"✓ +"seashells"中s-e-a-s-h-e-l-l-s的"she"(第 4~6 个字符)✓ = 2 次(seashore中是sha,不算);he:she1 次 +seashells的she1 次 +the的he1 次 = 3 次;sea:seashells、seashore各 1 次 = 2 次。
对拍验证:下面把这份代码与「每个模式串独立暴力匹配」做随机对拍。
📄 对拍程序:AC 自动机 vs 逐模式串暴力匹配
// 随机生成小写字母文本与模式串,比对 AC 自动机与暴力匹配的统计结果
#include <bits/stdc++.h>
using namespace std;
// ---------- 暴力参照 ----------
int brute_count(const string& T, const string& P) {
int cnt = 0;
if (P.size() > T.size()) return 0;
for (size_t i = 0; i + P.size() <= T.size(); i++)
if (T.compare(i, P.size(), P) == 0) cnt++;
return cnt;
}
// ---------- AC 自动机(与正文同款)----------
const int MAXN = 200005;
int ch[MAXN][26], fail_[MAXN], node_cnt_[MAXN], tot2 = 0;
long long hit2[MAXN];
int order2[MAXN], oc2 = 0;
void ins2(const string& s, int& id) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) {
ch[p][ci] = ++tot2;
fill(ch[tot2], ch[tot2] + 26, 0);
}
p = ch[p][ci];
}
node_cnt_[p]++;
id = p;
}
void build2() {
queue<int> q;
for (int c = 0; c < 26; c++)
if (ch[0][c]) { fail_[ch[0][c]] = 0; q.push(ch[0][c]); }
while (!q.empty()) {
int u = q.front(); q.pop();
order2[oc2++] = u;
for (int c = 0; c < 26; c++) {
int v = ch[u][c];
if (v) { fail_[v] = ch[fail_[u]][c]; q.push(v); }
else ch[u][c] = ch[fail_[u]][c];
}
}
}
vector<long long> ac_count(const vector<string>& ps, const string& T) {
vector<int> ids(ps.size());
for (size_t i = 0; i < ps.size(); i++) ins2(ps[i], ids[i]);
build2();
memset(hit2, 0, sizeof(long long) * (tot2 + 1));
int p = 0;
for (char c : T) { p = ch[p][c - 'a']; hit2[p]++; }
for (int i = oc2 - 1; i >= 0; i--) hit2[fail_[order2[i]]] += hit2[order2[i]];
vector<long long> res(ps.size());
for (size_t i = 0; i < ps.size(); i++) res[i] = hit2[ids[i]];
return res;
}
int main() {
srand(12345);
for (int round = 0; round < 3000; round++) {
int lenT = 1 + rand() % 60;
int nP = 1 + rand() % 8;
int alpha = 2 + rand() % 3; // 小字母表让匹配更密集
string T(lenT, 'a');
for (char& c : T) c = 'a' + rand() % alpha;
vector<string> ps(nP);
for (auto& s : ps) {
int len = 1 + rand() % 6;
s.resize(len);
for (char& c : s) c = 'a' + rand() % alpha;
}
auto fast = ac_count(ps, T);
// 重置自动机
fill(ch[0], ch[0] + 26, 0);
tot2 = 0; oc2 = 0;
for (int i = 0; i < nP; i++)
if (fast[i] != brute_count(T, ps[i])) {
cout << "MISMATCH at round " << round << "\n";
return 1;
}
}
cout << "3000 rounds OK\n";
return 0;
}
9.5.4 应用与复杂度
复杂度分析
| 阶段 | 复杂度 | 说明 |
|---|---|---|
| 建 Trie | O(Σ|P|) | 每个模式串字符各走一步 |
| 构建 fail(BFS) | O(26 × Σ|P|) | 每个节点扫 26 条边(固定字母表,视为 O(Σ|P|)) |
| 扫描文本 | O(|T|) | trie 图上每字符 O(1) 转移 + 打标记 |
| 标记传播 | O(Σ|P|) | fail 树上一次性自底向上求和 |
| 总计 | O(|T| + Σ|P|)(+ 26 倍常数) | 与模式串个数无关! |
若用「写法 1」直接跳 fail 链统计,最坏额外开销是 O(|T| × L)(L 为 fail 链长),遇到恶意构造(如全 a 串 + a, aa, aaa, … 模式串)会退化;差分传播写法没有这个问题。
典型应用
- 多模式串出现次数(本章实战题)——敏感词过滤、病毒特征扫描的原型;
- 求文本中出现过哪些模式串:沿 fail 链打布尔标记即可;
- 配合 DP:「文本中不包含任何模式串的方案数」——把自动机当状态机,在 trie 图上做数位 DP(与第 6.5 章数位 DP的「不包含某子串」技巧同构,但支持多模式串);
- fail 树上的子树统计:每个模式串的结尾节点在 fail 树上的子树,恰好是「以它结尾的文本位置集合」——逆序传播就是子树求和。
与前两章的关系
- Trie(第 9.3 章) 提供骨架:插入、节点编号、数组实现全部照搬;
- KMP(第 9.2 章) 提供灵魂:fail 指针 = π 数组的树上版本,BFS 递推
fail_[v] = ch[fail_[u]][c]与π[i] = π[π[i-1]]...+1是同一个套路的两种写法。
⚠️ 常见错误
| 错误 | 原因 | 修复方案 |
|---|---|---|
| 用 DFS 构建 fail | fail[v] 依赖更浅的 fail[u],DFS 顺序不保证 | 必须按深度从小到大——BFS |
| 直接跳链统计导致超时 | "aaa…a" 类构造把 fail 链拉到 O(L) | 用差分:打标记 + BFS 逆序传播 |
| 传播顺序写错 | 标记必须从深往浅加 | 按 BFS 出队顺序逆序传播 |
| 多组数据不清空 | 上一组的边和 fail 残留 | 重置 tot = 0、oc2 = 0,并清空根的 26 条边 |
| memset 清空整张表超时 | MAXN = 10⁶ × 26 × 4B ≈ 100MB,多组数据反复 memset | 只清用过的节点(新建时 fill 初始化),或每组只 memset 根 |
| 模式串重复插入后只统计一次 | cnt[p] = 1 覆盖了重复 | cnt[p]++;或在结尾节点存模式串编号列表 |
| 忘记 trie 图压缩就开始匹配 | ch[p][c] 为 0 时一步跳到根,答案错 | 匹配前必须先 build;或匹配时手动跳 fail 找转移 |
💪 练习题(本章 3 道,全部含思路与代码)
🟢 基础练习
题目 1:敏感词检测
给定 n 个敏感词(总长 ≤ 10⁵)和一篇文本(长度 ≤ 10⁶),判断文本中是否出现了任何一个敏感词(只需输出 yes/no)。
思路: 建 AC 自动机,文本逐字符转移;每到一个节点沿 fail 链检查是否有 cnt > 0(只需找到任意一个,找到即停)。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 100005;
int ch[MAXN][26], fail_[MAXN], cnt_[MAXN], tot = 0;
void ins(const string& s) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) { ch[p][ci] = ++tot; fill(ch[tot], ch[tot]+26, 0); }
p = ch[p][ci];
}
cnt_[p] = 1;
}
void build() {
queue<int> q;
for (int c = 0; c < 26; c++)
if (ch[0][c]) { fail_[ch[0][c]] = 0; q.push(ch[0][c]); }
while (!q.empty()) {
int u = q.front(); q.pop();
// 沿 fail 继承标记:fail 链上有词则这里也能匹配到词
cnt_[u] |= cnt_[fail_[u]];
for (int c = 0; c < 26; c++) {
int v = ch[u][c];
if (v) { fail_[v] = ch[fail_[u]][c]; q.push(v); }
else ch[u][c] = ch[fail_[u]][c];
}
}
}
int main() {
int n; string text;
cin >> n;
for (int i = 0; i < n; i++) { string s; cin >> s; ins(s); }
build();
cin >> text;
int p = 0; bool found = false;
for (char c : text) {
p = ch[p][c - 'a'];
if (cnt_[p]) { found = true; break; }
}
cout << (found ? "yes" : "no") << "\n";
return 0;
}
🟡 进阶练习
题目 2:出现次数最多的模式串
给定 n 个模式串和文本 T(长度均 ≤ 10⁶),求出现次数最多的模式串及其次数(出现允许重叠)。
思路: 正是本章 9.5.3 的实战代码——差分标记 + BFS 逆序传播,最后在所有结尾节点中取最大值。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 1000006;
int ch[MAXN][26], fail_[MAXN], tot = 0;
long long hit[MAXN];
int order_[MAXN], oc = 0;
int ins(const string& s) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) { ch[p][ci] = ++tot; fill(ch[tot], ch[tot]+26, 0); }
p = ch[p][ci];
}
return p;
}
void build() {
queue<int> q;
for (int c = 0; c < 26; c++)
if (ch[0][c]) { fail_[ch[0][c]] = 0; q.push(ch[0][c]); }
while (!q.empty()) {
int u = q.front(); q.pop();
order_[oc++] = u;
for (int c = 0; c < 26; c++) {
int v = ch[u][c];
if (v) { fail_[v] = ch[fail_[u]][c]; q.push(v); }
else ch[u][c] = ch[fail_[u]][c];
}
}
}
int main() {
ios_base::sync_with_stdio(false); cin.tie(NULL);
int n; cin >> n;
vector<string> ps(n);
vector<int> ids(n);
for (int i = 0; i < n; i++) { cin >> ps[i]; ids[i] = ins(ps[i]); }
build();
string T; cin >> T;
int p = 0;
for (char c : T) { p = ch[p][c - 'a']; hit[p]++; }
for (int i = oc - 1; i >= 0; i--) hit[fail_[order_[i]]] += hit[order_[i]];
long long best = 0; int best_i = 0;
for (int i = 0; i < n; i++)
if (hit[ids[i]] > best) { best = hit[ids[i]]; best_i = i; }
cout << ps[best_i] << " " << best << "\n";
return 0;
}
🔴 挑战练习
题目 3:不包含任何模式串的字符串计数
给定 n 个禁忌串(小写字母,总长 ≤ 20)和长度 L(L ≤ 10⁹),求长度为 L、不包含任何禁忌串作为子串的字符串个数,对 10⁹+7 取模。
思路: 把 AC 自动机当状态机:节点 = 「当前后缀与禁忌串前缀的最长匹配」。有 cnt > 0(沿 fail 继承后)的节点是非法状态。在 trie 图上做矩阵快速幂或线性递推:dp[step][v] += dp[step-1][u](u 沿每条字符边到 v),答案 = 所有合法节点在步数 L 的 dp 值之和。L 很大时用矩阵快速幂 O((Σ|P|)³ log L)。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 105;
const long long MOD = 1e9 + 7;
int ch[MAXN][26], fail_[MAXN], bad[MAXN], tot = 0;
void ins(const string& s) {
int p = 0;
for (char c : s) {
int ci = c - 'a';
if (!ch[p][ci]) { ch[p][ci] = ++tot; fill(ch[tot], ch[tot]+26, 0); }
p = ch[p][ci];
}
bad[p] = 1;
}
void build() {
queue<int> q;
for (int c = 0; c < 26; c++)
if (ch[0][c]) { fail_[ch[0][c]] = 0; q.push(ch[0][c]); }
while (!q.empty()) {
int u = q.front(); q.pop();
bad[u] |= bad[fail_[u]]; // fail 链上有禁忌词 → 此状态也非法
for (int c = 0; c < 26; c++) {
int v = ch[u][c];
if (v) { fail_[v] = ch[fail_[u]][c]; q.push(v); }
else ch[u][c] = ch[fail_[u]][c];
}
}
}
int n_sz; // 状态数 = tot + 1
using Mat = vector<vector<long long>>;
Mat mul(const Mat& A, const Mat& B) {
Mat C(n_sz, vector<long long>(n_sz, 0));
for (int i = 0; i < n_sz; i++)
for (int k = 0; k < n_sz; k++) {
if (!A[i][k]) continue;
for (int j = 0; j < n_sz; j++)
C[i][j] = (C[i][j] + A[i][k] * B[k][j]) % MOD;
}
return C;
}
int main() {
int n; long long L;
cin >> n >> L;
for (int i = 0; i < n; i++) { string s; cin >> s; ins(s); }
build();
n_sz = tot + 1;
// 转移矩阵:M[u][v] = 字符 u--c-->v 的方案数(v 非法则不计)
Mat M(n_sz, vector<long long>(n_sz, 0));
for (int u = 0; u < n_sz; u++) {
if (bad[u]) continue;
for (int c = 0; c < 26; c++) {
int v = ch[u][c];
if (!bad[v]) M[u][v]++;
}
}
// 矩阵快速幂:答案 = e0 * M^L * 全1
Mat R(n_sz, vector<long long>(n_sz, 0));
for (int i = 0; i < n_sz; i++) R[i][i] = 1;
Mat B = M;
long long e = L;
while (e) {
if (e & 1) R = mul(R, B);
B = mul(B, B);
e >>= 1;
}
long long ans = 0;
for (int v = 0; v < n_sz; v++) ans = (ans + R[0][v]) % MOD;
cout << ans << "\n";
return 0;
}
📋 本章总结
- AC 自动机 = Trie(骨架,第 9.3 章)+ fail 指针(灵魂,第 9.2 章 KMP 思想)
- fail[u] 指向「u 对应字符串的最长后缀」所在的 Trie 节点,沿 fail 链恰好枚举所有可匹配后缀
- 构建必须 BFS:fail[v] 依赖更浅的 fail[u];边建边做路径压缩,得到全满的 trie 图
- 匹配每步 O(1);统计用「打标记 + BFS 逆序沿 fail 传播」避免跳链退化
- 总复杂度 O(|T| + Σ|P|),与模式串个数无关
💡 章节联系: AC 自动机是多模式串世界的 KMP——fail 的递推是同一棵思想之树,只是长在了 Trie 上。学完本部分(第 9.2~9.5 章),你就拥有了从单模式匹配到多模式匹配的完整工具链;再往后是后缀数组 / 后缀自动机等更高阶的结构,它们与第 3.7 章的哈希技术一样,是 OI Wiki「字符串」专题的进阶内容。
📐 第十部分:计算几何
点、向量、多边形与凸包——用叉积武装起来的另一类思维题。USACO Gold/Platinum 几何题的完整工具箱。
📚 1 章 · ⏱️ 预计 1-2 周 · 🎯 目标:USACO Gold → Platinum
第十部分:计算几何
预计用时:1-2 周
计算几何从数学部分独立成篇:它的思维方式(向量、叉积、凸性)与数论/组合计数截然不同,值得单独一条学习路径。本部分从一道围栏问题出发,自底向上搭建几何工具箱。
涵盖的主题
| 小节 | 主题 | 核心思想 |
|---|---|---|
| 10.1.1 🥇 | 向量:计算几何的积木 | 点积、叉积与方向判定 |
| 10.1.2 🥇 | 常用判定:相交与距离 | 线段相交、点到线段距离 |
| 10.1.3 🥇 | 多边形:面积与点包含 | 鞋带公式、射线法 |
| 10.1.4 🥇 | 凸包:Andrew 算法 | 极角排序 + 单调栈,O(N log N) |
| 10.1.5 🥇 | 旋转卡壳:凸包直径 | 对踵点对,O(N) |
| 10.1.6 🥇 | 实战:围栏问题完整程序 | 把工具箱串起来 |
学习路线
- 10.1.1-10.1.2 是地基——叉积的正负号是后续所有判定的引擎,必须先吃透。
- 10.1.3-10.1.4 是 Gold 几何题主战场——凸包是 USACO 几何题最常见的第一步。
- 10.1.5 面向 Platinum——旋转卡壳出题频率不高,但一旦出现几乎必有它。
- 10.1.6 是验收——完整程序走一遍,确认每个判定函数都能默写。
复杂度速查
| 操作 | 方法 | 时间复杂度 |
|---|---|---|
| 向量叉积 / 方向判定 | cross | O(1) |
| 两线段是否相交 | 快速排斥 + 跨立实验 | O(1) |
| 多边形面积 | 鞋带公式 | O(N) |
| 点是否在多边形内 | 射线法 | O(N) |
| 凸包 | Andrew 单调链 | O(N log N) |
| 凸包直径(最远点对) | 旋转卡壳 | O(N) |
本部分学习建议
- 优先整数字符串技巧——叉积、面积、判定全部用
long long整数运算可避免一切精度问题;坐标是实数时才退回double+ eps。 - 几何代码最怕精度——每道例题都标注了精度处理方式,写浮点几何前先看各小节的 ⚠️ 常见错误。
- 凸包模板要练到能默写——Andrew 算法只有十几行,但排序方向、
while弹栈条件写错一个符号就全盘崩塌。 - 先修知识:第 3.3 章(排序)与第 3.5 章(栈)会让 Andrew 算法的学习更顺畅,但不是硬性前置。
第 10.1 章:计算几何基础
10.1.0 从一道题出发:围栏问题
先看一道典型的 USACO 风格题目:
🌾 题目:围栏(Fence) 农夫 John 的牧场里有
N根柱子(N ≤ 10⁵),第i根立在整数坐标(xᵢ, yᵢ)上(|xᵢ|, |yᵢ| ≤ 10⁶)。 John 想用一圈围栏把所有柱子围在内部或边界上。围栏是一圈首尾相连的线段,必须架在柱子上(每段围栏连接两根柱子)。 问:围栏最短是多少?(结果保留两位小数)
输入样例:
7
0 0
4 0
4 4
0 4
1 1
2 4
3 2
先试试你会的方法
思路 1:把柱子按某种顺序连起来? 比如按 x 排序,相邻两根连一条边,再把首尾相连。对样例算一下:
排序后:(0,0) (0,4) (1,1) (2,4) (3,2) (4,0) (4,4)。相邻距离依次为 4、√2、√10、√5、√20、√10,再加首尾 (4,4)→(0,0) 的 4√2 ≈ 5.66。总共约 4+1.41+3.16+2.24+4.47+3.16+5.66 ≈ 24.1。
思路 2:直接目测样例。 仔细看这 7 个点:中间的 (1,1)、(2,4)、(3,2) 都被 (0,0)、(4,0)、(4,4)、(0,4) 组成的正方形「包住」了。正方形周长只有 16——比 24.1 短得多!
直觉告诉我们:最优围栏就是包住所有点的最小凸多边形——想象把一根橡皮筋套在所有柱子外面,松手后它绷紧成的形状,就是答案。
这个「橡皮筋形状」在计算几何中叫做凸包(Convex Hull)。求出凸包,围栏长度就是凸包的周长。
拆解这道题需要回答的问题
- 怎么在代码里表示点、线段这些几何对象?→ 向量
- 怎么判断「拐左还是拐右」?→ 叉积
- 怎么高效求出凸包?→ Andrew 算法(排序 + 单调栈,O(N log N))
- 凸包还有什么用?→ 旋转卡壳(最远点对)、多边形面积、点在多边形内
第 10.1 章按这条线逐一展开:
| 小节 | 回答的问题 |
|---|---|
| 10.1.1 | 向量、点积与叉积:计算几何的「积木」 |
| 10.1.2 | 线段相交、点到线段距离等常用判定 |
| 10.1.3 | 多边形:鞋带公式面积、点在多边形内 |
| 10.1.4 | Andrew 算法求凸包 + 完整代码 |
| 10.1.5 | 旋转卡壳求凸包直径 |
| 10.1.6 | 完整实战程序(围栏问题) |
学习目标:
- 定义点/向量结构体,用叉积判断方向(左转 / 右转 / 共线)
- 实现线段相交判定与多边形面积(鞋带公式)
- 用 Andrew 算法 O(N log N) 求凸包
- 用旋转卡壳 O(N) 求凸包直径(最远点对)
10.1.1 向量:计算几何的积木
点与向量
在平面直角坐标系里,点用坐标 (x, y) 表示。向量同样用两个数表示——从原点指向 (x, y) 的箭头。代码中二者共用一个结构体,但概念上要分清:点是位置,向量是位移。
计算几何的黄金法则:能用向量就不解方程。中学的 y = kx + b 斜截式有无数坑(垂直线斜率不存在、浮点误差),而向量运算大多是纯整数,又快又准。
typedef long long ll;
struct Pt {
ll x, y;
};
Pt operator+(Pt a, Pt b) { return {a.x + b.x, a.y + b.y}; }
Pt operator-(Pt a, Pt b) { return {a.x - b.x, a.y - b.y}; }
bool operator==(Pt a, Pt b) { return a.x == b.x && a.y == b.y; }
减法 b - a 得到的是从 a 指向 b 的向量——这是第 10.1 章用得最多的操作。
⚠️ 整数 vs 浮点: 只要题目给的是整数坐标,就用
long long存坐标、用整数叉积做判定,完全避免精度问题。只有最终求长度/面积时才转double。
点积
两个向量 a、b 的点积(数量积):
$$\mathbf{a} \cdot \mathbf{b} = a_x b_x + a_y b_y = |\mathbf{a}||\mathbf{b}|\cos\theta$$
几何意义: b 在 a 方向上的投影长度(乘上 |a|)。投影是正还是负,说明夹角是锐角还是钝角:
| 点积符号 | 夹角 | 含义 |
|---|---|---|
| > 0 | 锐角 | 方向「大致相同」 |
| = 0 | 直角 | 垂直 |
| < 0 | 钝角 | 方向「大致相反」 |
ll dot(Pt a, Pt b) { return a.x * b.x + a.y * b.y; }
叉积:第 10.1 章的主角
两个向量 a、b 的叉积(向量积的 z 分量):
$$\mathbf{a} \times \mathbf{b} = a_x b_y - a_y b_x$$
几何意义: 以 a、b 为两条边的平行四边形的有向面积(三角形面积的 2 倍)。更重要的,它的符号告诉我们 b 在 a 的哪一侧:
方向判断表(站在 a 处朝 a 的方向看 b):
叉积 cross(a, b) | 结论 |
|---|---|
| > 0 | b 在 a 的左侧(逆时针方向) |
| = 0 | 共线(同向或反向) |
| < 0 | b 在 a 的右侧(顺时针方向) |
ll cross(Pt a, Pt b) { return a.x * b.y - a.y * b.x; }
验证一下:cross({1,0}, {0,1}) = 1×1 − 0×0 = 1 > 0,x 正方向的向量看 y 正方向确实在左边。✅
最常用的形式: 判断「沿 A→B→C 走,在 B 处怎么拐」——计算 cross(B−A, C−B):
- > 0:左转(逆时针拐)
- = 0:直行(三点共线)
- < 0:右转(顺时针拐)
凸包算法的核心判据就是它。
⚠️ 为什么用
long long? 坐标上限 10⁶ 时,叉积每项最大 10⁶ × 10⁶ = 10¹²,int直接溢出。两个 10¹² 相减最大约 2×10¹²,long long(约 9.2×10¹⁸)足够安全。
10.1.2 常用判定:相交与距离
线段相交判定
判断线段 AB 与线段 CD 是否相交(包括端点碰到的情况):
- 跨立实验:若两线段相交,C、D 必在直线 AB 的两侧(或线上),A、B 也必在直线 CD 的两侧。用叉积判断:
d1 = cross(B−A, C−A),d2 = cross(B−A, D−A)- 若
d1、d2异号,说明 C、D 分居直线 AB 两侧
- 特判共线:
d1 = 0时 C 在直线 AB 上,还需判断 C 是否在线段 AB 的范围内(用坐标范围即可)。
完整可编译代码:
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
struct Pt { ll x, y; };
Pt operator-(Pt a, Pt b) { return {a.x - b.x, a.y - b.y}; }
ll cross(Pt a, Pt b) { return a.x * b.y - a.y * b.x; }
// 点 p 是否在线段 ab 上(先共线,再卡范围)
bool onSeg(Pt a, Pt b, Pt p) {
return cross(b - a, p - a) == 0
&& min(a.x, b.x) <= p.x && p.x <= max(a.x, b.x)
&& min(a.y, b.y) <= p.y && p.y <= max(a.y, b.y);
}
// 线段 ab 与线段 cd 是否相交(含端点接触、部分重叠)
bool segIntersect(Pt a, Pt b, Pt c, Pt d) {
ll d1 = cross(b - a, c - a); // c 相对直线 ab 的位置
ll d2 = cross(b - a, d - a); // d 相对直线 ab 的位置
ll d3 = cross(d - c, a - c); // a 相对直线 cd 的位置
ll d4 = cross(d - c, b - c); // b 相对直线 cd 的位置
if (((d1 > 0 && d2 < 0) || (d1 < 0 && d2 > 0)) &&
((d3 > 0 && d4 < 0) || (d3 < 0 && d4 > 0)))
return true; // 规范相交:互相跨立
if (d1 == 0 && onSeg(a, b, c)) return true; // 共线且范围重叠
if (d2 == 0 && onSeg(a, b, d)) return true;
if (d3 == 0 && onSeg(c, d, a)) return true;
if (d4 == 0 && onSeg(c, d, b)) return true;
return false;
}
int main() {
// 三组测试
printf("%d\n", segIntersect({0,0},{4,4},{0,4},{4,0})); // 1 对角线相交
printf("%d\n", segIntersect({0,0},{1,1},{3,3},{4,4})); // 0 共线但不重叠
printf("%d\n", segIntersect({0,0},{4,0},{4,0},{4,4})); // 1 端点接触
return 0;
}
输出(已验证):
1
0
1
点到线段的距离
第一步:点到直线的投影。 设点 P、直线过 A 且方向向量为 v(= B − A),则 P 在直线上的投影参数为:
$$t = \frac{\overrightarrow{AP} \cdot \mathbf{v}}{|\mathbf{v}|^2}$$
t < 0:投影落在 A 之前 → 最近点是 At > 1:投影落在 B 之后 → 最近点是 B0 ≤ t ≤ 1:最近点是投影本身
typedef double db;
db dist(Pt a, Pt b) {
db dx = a.x - b.x, dy = a.y - b.y;
return sqrt(dx * dx + dy * dy);
}
// 点 p 到线段 ab 的距离
db distToSeg(Pt p, Pt a, Pt b) {
Pt v = b - a;
if (dot(v, p - a) < 0) return dist(p, a); // 在 A 一侧
if (dot(v, p - b) > 0) return dist(p, b); // 在 B 一侧
// 投影在线段上:距离 = |叉积| / |v|(平行四边形面积 ÷ 底)
return abs(cross(v, p - a)) / sqrt((db)dot(v, v));
}
💡 投影落在线段中间时,为什么用叉积?
|cross(v, p−a)|是平行四边形面积,除以底边长 |v| 恰好是高——也就是点到直线的距离。这比先算投影点再算距离少一次开方,也更不容易写错。
10.1.3 多边形:面积与点包含
鞋带公式:任意多边形面积
顶点按逆时针顺序为 $p_1, p_2, \dots, p_n$,则面积:
$$S = \frac{1}{2}\left|\sum_{i=1}^{n} p_i \times p_{(i \bmod n)+1}\right|$$
这就是鞋带公式(Shoelace Formula)——每项是相邻两个顶点坐标「交叉相乘再相减」,像系鞋带一样交错。
// 返回有向面积的 2 倍:顶点逆时针为正,顺时针为负
ll area2(vector<Pt>& poly) {
ll s = 0;
for (size_t i = 0; i < poly.size(); i++) {
Pt &a = poly[i], &b = poly[(i + 1) % poly.size()];
s += cross(a, b);
}
return s;
}
// 实际面积 = fabs(area2(poly)) / 2.0
为什么对? 每一项 cross(pᵢ, pᵢ₊₁) 是三角形 O-pᵢ-pᵢ₊₁ 的有向面积(O 为原点)。把所有三角形加起来,多边形内部的面积被保留,外部的正负抵消,剩下的恰好是多边形的有向面积。
有向面积的妙用: 符号告诉你顶点顺序——正为逆时针,负为顺时针。这在读入顶点顺序不明时非常有用。
验证: 正方形 (0,0) (4,0) (4,4) (0,4),area2 = (0−0)+(16−0)+(16−0)+(0−0) = 32,面积 = 32/2 = 16。✅
点在多边形内:射线法
从点 P 向右水平引一条射线,数它与多边形边的交点个数:
奇数个交点 → 在内部;偶数个 → 在外部。(「奇内偶外」)
直觉:射线每穿过一次边界,就「进出切换」一次。起点在内,穿奇数次后必在外。
// 点 p 是否在多边形内(在边界上也算在内)
bool inPolygon(Pt p, vector<Pt>& poly) {
bool in = false;
int n = poly.size();
for (int i = 0, j = n - 1; i < n; j = i++) {
Pt a = poly[i], b = poly[j];
if (onSeg(a, b, p)) return true; // 在边界上
// 边 (a,b) 是否穿过 p 的水平射线?
if ((a.y > p.y) != (b.y > p.y)) {
// 求边与 y = p.y 的交点横坐标,判断是否在 p 右侧。
// 整数坐标下用交叉相乘避免除法:
// 交点 x = a.x + (p.y - a.y) * (b.x - a.x) / (b.y - a.y)
// 判 x > p.x 等价于判 (b.x - a.x) * (p.y - a.y) > (p.x - a.x) * (b.y - a.y)
if ((ll)(b.x - a.x) * (p.y - a.y) >
(ll)(p.x - a.x) * (b.y - a.y))
in = !in;
}
}
return in;
}
验证: 正方形 (0,0) (4,0) (4,4) (0,4):
- 点 (1,1):内部 ✅
- 点 (5,5):外部 ✅
- 点 (2,4):边界上 ✅
边界情况的巧妙处理:(a.y > p.y) != (b.y > p.y) 这个条件天然处理了「射线恰好穿过顶点」的歧义——每条边只有「上端点严格高于 p.y、下端点不高于 p.y」时才算一次穿越,顶点被穿过的情形两条边只算一次。
10.1.4 凸包:Andrew 算法
定义
凸包是平面上能包住所有给定点的最小凸多边形。直观理解:一根橡皮筋套在所有点外面,绷紧后的形状。
为什么最优围栏是凸包? 假设最优围栏在某处「凹」进去,由三角不等式,把凹进的两段替换成连接两个端点的一直线段,长度严格变小,且所有点仍在围栏内。所以最优解必须是凸的,且是包住所有点的最小凸多边形——即凸包。
算法思路:保持左转
想象沿凸包边界逆时针走一圈:每到一个顶点,都是左转(或直行)——凸多边形的所有内角 ≤ 180°。反过来,一旦途中有一步「右转」,这段路一定在凸包内部,不在边界上。
Andrew 算法把这条观察变成单调栈:
- 排序:所有点按 x 为第一关键字、y 为第二关键字升序排序。排序后最左的点 p₀ 和最右的点 pₙ₋₁ 一定在凸包上(它们分别是 x 最小/最大的「极端点」)。
- 下凸壳:从左到右扫描,维护一个栈。加入新点 P 时,若栈顶两个点 S₂、S₁(S₁ 为栈顶)到 P 形成右转——
cross(S₁−S₂, P−S₂) < 0——就弹出 S₁,继续检查,直到左转或栈中只剩一个点,再把 P 入栈。得到凸包下半部分。 - 上凸壳:从右到左再做一遍同样的扫描,得到上半部分。
- 两壳拼接(去掉重复的端点)即得逆时针排列的凸包。
为什么弹栈? 栈里的点是我们「目前相信在凸包上」的点。新点 P 使栈顶变成右转,意味着栈顶那个点被包在了三角形(S₂, S₁, P)内部——它不在边界上,必须淘汰。弹出的点不可能再「复活」:它已经在当前点集的凸包内部了。
P(新点)
/|
/ | S₁ 在 S₂→P 连线的"凹侧"
S₂ ●--+ ← S₁ 必须弹出
\ |
\ ● S₁
\|
(下凸壳应为 S₂ → P 的直线)
复杂度: 排序 O(N log N);扫描看似双重循环,但每个点至多入栈、出栈各一次,均摊 O(N)。总计 O(N log N)。
完整代码
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
struct Pt { ll x, y; };
Pt operator-(Pt a, Pt b) { return {a.x - b.x, a.y - b.y}; }
bool operator<(Pt a, Pt b) { return a.x != b.x ? a.x < b.x : a.y < b.y; }
bool operator==(Pt a, Pt b) { return a.x == b.x && a.y == b.y; }
ll cross(Pt a, Pt b) { return a.x * b.y - a.y * b.x; }
// 求凸包,返回逆时针排列的顶点(不保留边上的共线中间点)
vector<Pt> convexHull(vector<Pt> p) {
sort(p.begin(), p.end());
p.erase(unique(p.begin(), p.end()), p.end()); // 去重
int n = p.size();
if (n < 2) return p;
vector<Pt> h(2 * n);
int k = 0;
// 下凸壳:从左到右
for (int i = 0; i < n; i++) {
// 叉积 <= 0:右转或共线 → 弹出(共线点不保留)
while (k >= 2 && cross(h[k-1] - h[k-2], p[i] - h[k-2]) <= 0) k--;
h[k++] = p[i];
}
// 上凸壳:从右到左(t 保证下壳不被破坏)
for (int i = n - 2, t = k + 1; i >= 0; i--) {
while (k >= t && cross(h[k-1] - h[k-2], p[i] - h[k-2]) <= 0) k--;
h[k++] = p[i];
}
h.resize(k - 1); // 最后一个点与第一个点相同,去掉
return h;
}
double dist(Pt a, Pt b) {
double dx = a.x - b.x, dy = a.y - b.y;
return sqrt(dx * dx + dy * dy);
}
int main() {
// 正方形 4 顶点 + 内部点 + 边上共线点
vector<Pt> pts = {{0,0},{4,0},{4,4},{0,4},{1,1},{2,4},{3,2}};
auto h = convexHull(pts);
printf("凸包顶点数 = %zu\n", h.size()); // 4
double per = 0;
for (size_t i = 0; i < h.size(); i++)
per += dist(h[i], h[(i + 1) % h.size()]);
printf("周长 = %.2f\n", per); // 16.00
return 0;
}
输出(已验证):
凸包顶点数 = 4
周长 = 16.00
注意 (2,4) 在正方形上边 (0,4)–(4,4) 上,因为弹栈条件用了 <= 0(共线也弹出),它没有出现在结果中。如果题目需要保留边上的所有点(比如求边上整点数),把 <= 0 改成 < 0。
10.1.5 旋转卡壳:凸包直径
问题与思路
凸包直径 = 点集中最远两点的距离(最远点对一定都在凸包上,且是一对对踵点——能被两条平行线分别卡住的两个点)。
暴力枚举所有点对是 O(N²)。旋转卡壳利用凸包的有序性做到 O(N):
逆时针枚举凸包的每条边,维护「离这条边最远的点」。边逆时针旋转时,对应的最远点也只会单调地逆时针前进,绝不回头——所以用一个双指针 j 同向推进即可。每个点最多被扫一圈,总移动 O(N)。
「离边最远」怎么比较?点到边的距离 = 叉积面积 ÷ 底边长,底相同,直接比叉积绝对值即可——全程整数,无精度问题。
h[j+1]
/ \
/ ● h[j] ← 离边 (h[i], h[i+1]) 最远的点
/ \
●─────────────●
h[i] h[i+1]
(边逆时针转,h[j] 也逆时针走)
核心代码
// 凸包直径的平方(整数坐标下全程无精度问题)
// h 为逆时针凸包,h.size() >= 2
ll diameter2(const vector<Pt>& h) {
int n = h.size();
if (n == 2) return dot(h[1]-h[0], h[1]-h[0]);
ll ans = 0;
for (int i = 0, j = 2; i < n; i++) {
// 边 (h[i], h[i+1]):若 h[j+1] 离边更远,j 前进
while (abs(cross(h[(i+1)%n] - h[i], h[(j+1)%n] - h[i]))
> abs(cross(h[(i+1)%n] - h[i], h[j] - h[i])))
j = (j + 1) % n;
// 最远点对中必有 h[i] 或 h[i+1] 与 h[j] 配对
ans = max(ans, max(dot(h[i] - h[j], h[i] - h[j]),
dot(h[(i+1)%n] - h[j], h[(i+1)%n] - h[j])));
}
return ans;
}
验证: 边长为 4 的正方形凸包,对角线 4√2,diameter2 = 32。✅
💡 为什么答案要同时检查 h[i] 和 h[i+1]? j 是「离当前边最远」的点,但最远点对未必以边端点配对一定成立——稳妥起见两个端点都和 h[j] 比一次,仍不影响 O(N)。
⚠️
j会绕圈吗? 会,所以用j = (j+1) % n循环取模。这正是双指针「总移动量 O(N)」的体现:外层 i 走一圈,内层 j 合计也只走一圈。
10.1.6 实战:围栏问题完整程序
回到开篇的题目。算法:读入 N 个点 → Andrew 凸包 → 输出周长(两位小数)。
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
struct Pt { ll x, y; };
Pt operator-(Pt a, Pt b) { return {a.x - b.x, a.y - b.y}; }
bool operator<(Pt a, Pt b) { return a.x != b.x ? a.x < b.x : a.y < b.y; }
bool operator==(Pt a, Pt b) { return a.x == b.x && a.y == b.y; }
ll cross(Pt a, Pt b) { return a.x * b.y - a.y * b.x; }
vector<Pt> convexHull(vector<Pt> p) {
sort(p.begin(), p.end());
p.erase(unique(p.begin(), p.end()), p.end());
int n = p.size();
if (n < 2) return p;
vector<Pt> h(2 * n);
int k = 0;
for (int i = 0; i < n; i++) {
while (k >= 2 && cross(h[k-1] - h[k-2], p[i] - h[k-2]) <= 0) k--;
h[k++] = p[i];
}
for (int i = n - 2, t = k + 1; i >= 0; i--) {
while (k >= t && cross(h[k-1] - h[k-2], p[i] - h[k-2]) <= 0) k--;
h[k++] = p[i];
}
h.resize(k - 1);
return h;
}
int main() {
int n;
scanf("%d", &n);
vector<Pt> p(n);
for (auto &q : p) scanf("%lld %lld", &q.x, &q.y);
vector<Pt> h = convexHull(p);
double ans = 0;
for (size_t i = 0; i < h.size(); i++) {
Pt a = h[i], b = h[(i + 1) % h.size()];
double dx = a.x - b.x, dy = a.y - b.y;
ans += sqrt(dx * dx + dy * dy);
}
printf("%.2f\n", ans);
return 0;
}
样例输入:
7
0 0
4 0
4 4
0 4
1 1
2 4
3 2
样例输出:
16.00
(已编译运行验证:凸包为正方形 (0,0)(4,0)(4,4)(0,4),周长 4×4 = 16.00。)
边界情况自查:
N = 1:围栏长度 0(凸包退化为 1 点,周长循环算出 0)✅N = 2:两根柱子,围栏是「来回」两段,长度 2d ✅- 所有点共线:
<= 0的弹栈条件会把中间点全部弹掉,凸壳退化为线段的两端点,周长 = 2d ✅
💡 USACO 真题对照: 这道题就是 USACO 5.1「Fencing the Cows」(圈奶牛)的翻版,也是 USACO Training Gateway 的经典入门题。Gold 实战中更常见的是凸包作为子步骤出现(如求凸包直径、面积后再做后续计算)。
⚠️ 常见错误
| 错误 | 后果 | 正确做法 |
|---|---|---|
坐标用 int 算叉积 | 坐标 10⁶ 时叉积达 10¹²,溢出变负数,方向全错 | 坐标和叉积统一 long long |
浮点坐标用 == 判共线 | 0.1 + 0.2 != 0.3,永远判不出共线 | 定义 const double eps = 1e-9,用 fabs(cross) < eps |
凸包弹栈条件 < vs <= 没想清楚 | 保留 <=:边上的共线点留在凸包里;题目要求「顶点数」时会错 | 默认用 <=(不保留共线点);明确需要边上点时才改 < |
| 周长把起点重复计算 / 漏掉最后一条边 | h[0] 与 h[k-1] 之间的边算两次或零次 | 用 (i + 1) % h.size() 统一取模,一条不多一条不少 |
排序比较函数写 <= | 违反严格弱序,sort 可能崩溃(段错误) | 比较函数一律用严格 < |
| 上凸壳扫描把下凸壳弹掉 | 凸包「缺一块」 | 第二遍扫描用 t = k + 1 作为栈底保护线 |
| 射线法不处理水平边 / 顶点穿越 | 交点数奇偶错乱,内外判反 | 用 (a.y > p.y) != (b.y > p.y) 的标准写法 |
| 所有点共线时凸包代码越界 | 退化为 2 点时误访问空栈 | 先判 n < 2;弹栈条件保证 k >= 2 / k >= t |
第 10.1 章总结
| 工具 | 一句话 | 复杂度 |
|---|---|---|
点积 dot | 投影正负 → 夹角锐/钝 | O(1) |
叉积 cross | 符号 → 左转/右转/共线;绝对值 → 平行四边形面积 | O(1) |
| 线段相交 | 跨立实验 + 共线特判 | O(1) |
| 点到线段距离 | 投影分类:端点 or 叉积求高 | O(1) |
| 鞋带公式 | 相邻顶点叉积求和 ÷ 2,符号给方向 | O(N) |
| 射线法 | 交点数奇内偶外 | O(N) |
| Andrew 凸包 | 排序 + 上下凸壳单调栈,弹栈保持左转 | O(N log N) |
| 旋转卡壳 | 边旋转 + 对踵点双指针,求直径/最远点对 | O(N) |
核心心法:
- 整数到底——判定全部用整型叉积/点积,最后一步才开方
- 叉积即方向——一切「左/右/共线」问题归约为叉积符号
- 凸包是「外壳」——周长、直径、最远点对、最小覆盖,先想到凸包
练习题
🟢 简单
10.1-E1. 三角形面积 (Luogu P5684 风格)
给定三角形三个顶点的整数坐标(|x|, |y| ≤ 10⁹),输出面积的 2 倍(保证是整数)。
数据规模: 仅 3 个点。
提示
答案就是 abs(cross(B - A, C - A))。注意坐标 10⁹ 时叉积可达 4×10¹⁸,刚好在 long long 边缘——用 __int128 最稳。
10.1-E2. 点在哪里?
给定一个 N 边形(顶点按逆时针给出)和 Q 个查询点,对每个点输出 INSIDE / OUTSIDE / BOUNDARY。
数据规模: 3 ≤ N ≤ 10⁵,1 ≤ Q ≤ 10⁵,坐标为绝对值 ≤ 10⁹ 的整数。
提示
直接套 10.1.3 的射线法模板。查询点先和多边形包围盒比较可快速排除大部分外部点(可选优化)。
🟡 中等
J-M1. 圈奶牛 (USACO 5.1 Fencing the Cows / Luogu P2742)
给定 N 个点的坐标,求凸包周长,保留两位小数。
数据规模: 1 ≤ N ≤ 10⁴,坐标为绝对值 ≤ 10⁶ 的实数。
提示
本题就是 10.1.6 的完整程序(注意坐标是实数,结构体改 double,判定用 eps)。
J-M2. 最远点对 (Luogu P1452 Beauty Contest)
给定平面上 N 个点,求任意两点的最大距离。
数据规模: 2 ≤ N ≤ 5×10⁴,|x|, |y| ≤ 10⁴。
提示
凸包 + 旋转卡壳(10.1.5)。O(N²) 暴力枚举在 N = 5×10⁴ 时是 2.5×10⁹ 次运算,会超时。先用 diameter2 求平方再开方。
🔴 困难
J-H1. 最小围栏周长 (POJ 1113 Wall 风格,USACO 铜牌变体改编)
国王要建围墙围住 N 个城堡,要求围墙离任意城堡的距离至少 L。求围墙最小长度。
数据规模: 1 ≤ N ≤ 1000,1 ≤ L ≤ 1000,坐标为绝对值 ≤ 10⁴ 的整数。
提示
答案是「凸包周长 + 以 L 为半径的整圆周长」:直线部分就是凸包边,圆弧部分恰好拼成一个完整的圆。周长 = 凸包周长 + 2πL。
附录 A:C++ 速查手册
本附录是你的备忘单,在练习时随时参考。这里的所有内容在书中都已涵盖,这是精简的参考形式。
A.1 竞赛模板
#include <bits/stdc++.h>
using namespace std;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
// freopen("problem.in", "r", stdin); // 文件 I/O 时取消注释(使用实际题目名称)
// freopen("problem.out", "w", stdout); // 文件 I/O 时取消注释
// 你的代码
return 0;
}
A.2 常用数据类型
| 类型 | 大小 | 范围 | 使用场景 |
|---|---|---|---|
int | 32 位 | ±2.1 × 10^9 | 默认整数 |
long long | 64 位 | ±9.2 × 10^18 | 大数、乘积 |
double | 64 位 | ~15 位有效数字 | 小数 |
bool | 1 字节 | true/false | 标志 |
char | 8 位 | -128 到 127 | 单字符 |
string | 可变 | 任意长度 | 文本 |
安全最大值:
INT_MAX = 2,147,483,647 ≈ 2.1 × 10^9
LLONG_MAX = 9,223,372,036,854,775,807 ≈ 9.2 × 10^18
A.3 STL 容器——操作速查
vector<T>
vector<int> v; // 空向量
vector<int> v(n, 0); // n 个零
vector<int> v = {1,2,3}; // 从列表初始化
v.push_back(x); // 尾部追加——O(1) 均摊
v.pop_back(); // 删除最后——O(1)
v[i] // 访问下标 i——O(1)
v.front() // 第一个元素
v.back() // 最后一个元素
v.size() // 元素个数
v.empty() // 空则返回 true
v.clear() // 删除所有元素
v.resize(k, val) // 调整为 k 个,新元素填充 val
v.insert(v.begin()+i, x) // 在下标 i 处插入——O(n)
v.erase(v.begin()+i) // 删除下标 i——O(n)
pair<A,B>
pair<int,int> p = {3, 5};
p.first // 3
p.second // 5
make_pair(a, b) // 创建 pair
// 比较:先比 .first,再比 .second
map<K,V>
map<string,int> m;
m[key] = val; // 插入/更新——O(log n)
m[key] // 访问(不存在时创建!)——O(log n)
m.find(key) // 迭代器;未找到返回 .end()——O(log n)
m.count(key) // 0 或 1——O(log n)
m.erase(key) // 删除——O(log n)
m.size() // 条目数
for (auto &[k,v] : m) // 按键有序遍历
set<T>
set<int> s;
s.insert(x) // 添加——O(log n)
s.erase(x) // 删除所有 x——O(log n)
s.count(x) // 0 或 1——O(log n)
s.find(x) // 迭代器——O(log n)
s.lower_bound(x) // 第一个 >= x 的元素
s.upper_bound(x) // 第一个 > x 的元素
*s.begin() // 最小元素
*s.rbegin() // 最大元素
stack<T>
stack<int> st;
st.push(x) // 压入——O(1)
st.pop() // 弹出(无返回值!)——O(1)
st.top() // 查看顶部——O(1)
st.empty() // 空则返回 true
st.size() // 元素数
queue<T>
queue<int> q;
q.push(x) // 入队——O(1)
q.pop() // 出队(无返回值!)——O(1)
q.front() // 队首元素——O(1)
q.back() // 队尾元素——O(1)
q.empty()
q.size()
priority_queue<T>(最大堆)
priority_queue<int> pq; // 最大堆
priority_queue<int, vector<int>, greater<int>> pq2; // 最小堆
pq.push(x) // 插入——O(log n)
pq.pop() // 删除顶部——O(log n)
pq.top() // 查看顶部(最大值)——O(1)
pq.empty()
pq.size()
unordered_map<K,V> / unordered_set<T>
接口与 map/set 相同,但平均 O(1)(无有序迭代)。
A.4 STL 算法速查
// 全部假设 #include <bits/stdc++.h>
// 排序
sort(v.begin(), v.end()); // 升序
sort(v.begin(), v.end(), greater<int>()); // 降序
sort(v.begin(), v.end(), [](int a, int b){...}); // 自定义
// 二分查找(需要已排序容器)
binary_search(v.begin(), v.end(), x) // bool:存在吗?
lower_bound(v.begin(), v.end(), x) // 第一个 >= x 的迭代器
upper_bound(v.begin(), v.end(), x) // 第一个 > x 的迭代器
// 最小/最大值
min(a, b) // 两者最小
max(a, b) // 两者最大
min({a, b, c}) // 多个中最小(C++11)
*min_element(v.begin(), v.end()) // 容器最小
*max_element(v.begin(), v.end()) // 容器最大
// 累加
accumulate(v.begin(), v.end(), 0LL) // 求和(long long 用 0LL)
// 填充
fill(v.begin(), v.end(), x) // 全部填充 x
memset(arr, 0, sizeof(arr)) // 清零 C 数组(快速)
// 反转
reverse(v.begin(), v.end()) // 原地反转
// 统计
count(v.begin(), v.end(), x) // 统计 x 的出现次数
// 去重(删除连续重复——先排序!)
auto it = unique(v.begin(), v.end());
v.erase(it, v.end());
// 交换
swap(a, b) // 交换两个值
// 全排列(暴力时有用)
sort(v.begin(), v.end());
do {
// 处理当前排列
} while (next_permutation(v.begin(), v.end()));
// GCD / LCM(C++17)
gcd(a, b) // 最大公约数——来自 <numeric> 的 std::gcd
lcm(a, b) // 最小公倍数——来自 <numeric> 的 std::lcm
// 旧版(C++17 之前):__gcd(a, b) // 仍然有效,但推荐用 std::gcd
A.5 时间复杂度参考表
图示:复杂度与 N 参考

上面的彩色表格能让你一眼看出可行性。读题时,找到列中的 N 和行中的算法复杂度,看它是否能在 1 秒内通过。
| N | 最大可行复杂度 | 算法层级 |
|---|---|---|
| N ≤ 12 | O(N! × N) | 所有排列 |
| N ≤ 20 | O(2^N × N) | 所有子集 + 线性操作 |
| N ≤ 500 | O(N³) | 3 重嵌套循环、区间 DP |
| N ≤ 5000 | O(N²) | 2 重嵌套循环、O(N²) DP |
| N ≤ 10^5 | O(N log N) | 排序、BFS、二分查找 |
| N ≤ 10^6 | O(N) | 线性扫描、前缀和 |
| N ≤ 10^8 | O(N) 或 O(N / 32) | 纯循环或位集 |
A.6 常见陷阱
整数溢出
// 错误
int a = 1e9, b = 1e9;
int product = a * b; // 溢出!
// 正确
long long product = (long long)a * b;
// 错误
int n = 1e5;
int arr[n * n]; // n*n = 10^10,太大了
// 检查:若中间值可能超过 2 × 10^9,用 long long
差一错误
// 错误:访问 arr[n]
for (int i = 0; i <= n; i++) cout << arr[i];
// 正确
for (int i = 0; i < n; i++) cout << arr[i]; // 0-indexed
for (int i = 1; i <= n; i++) cout << arr[i]; // 1-indexed
// 前缀和:P[i] = 前 i 个元素之和
// 查询 [L, R] 的和(1-indexed):P[R] - P[L-1]
// 不是 P[R] - P[L] ← 差一!
遍历时修改容器
// 错误
for (auto it = s.begin(); it != s.end(); ++it) {
if (*it % 2 == 0) s.erase(it); // 迭代器失效!
}
// 正确
set<int> toErase;
for (int x : s) if (x % 2 == 0) toErase.insert(x);
for (int x : toErase) s.erase(x);
map 访问时创建条目
map<string,int> m;
if (m["missing_key"]) // 创建值为 0 的 "missing_key"!
// 正确:先检查
if (m.count("missing_key") && m["missing_key"]) // 安全
// 或:
auto it = m.find("missing_key");
if (it != m.end() && it->second) { ... }
浮点数比较
double a = 0.1 + 0.2;
if (a == 0.3) // 因浮点精度可能为 false!
// 正确:用 epsilon 比较
const double EPS = 1e-9;
if (abs(a - 0.3) < EPS) { ... }
深度递归导致栈溢出
// 大图上的 DFS 可能导致栈溢出
// 对 N = 10^5 个节点排成链的树,递归深度 = 10^5
// 修复:增大栈大小,或用迭代 DFS
// 在 Linux/Mac 上增大栈:
// ulimit -s unlimited
// 或编译时:g++ -DLOCAL ... 并手动设置栈大小
A.7 常用 #define 和 typedef
// 常用缩写(个人喜好——不要过度使用)
typedef long long ll;
typedef pair<int,int> pii;
typedef vector<int> vi;
#define pb push_back
#define all(v) (v).begin(), (v).end()
#define sz(v) ((int)(v).size())
// 用法示例:
ll x = 1e18;
pii p = {3, 5};
vi v = {1, 2, 3};
sort(all(v));
A.8 C++17 实用特性
// 结构化绑定——简洁地解包 pair/tuple
auto [x, y] = make_pair(3, 5);
for (auto [key, val] : mymap) { ... }
// 带初始化器的 if
if (auto it = m.find(key); it != m.end()) {
// 使用 it->second
}
// gcd 和 lcm
int g = gcd(12, 8); // C++17:使用 <numeric> 中的 std::gcd
int l = lcm(4, 6); // C++17:使用 <numeric> 中的 std::lcm
// 编译:g++ -std=c++17 -O2 -o sol sol.cpp
附录 B:USACO 题目集
本附录提供了按主题分类的 20 道 USACO 精选题目,这些题目经过精心挑选以巩固本书中涵盖的技术。所有题目都可以在 usaco.org 上免费获取。
如何使用本题目集
大致按顺序做这些题。对每道题:
- 仔细读题,独立尝试解题至少 1-2 小时
- 若卡住,看下面的提示(不是完整题解)
- 若再过 30 分钟仍卡住,在 USACO 网站上读题解
- 解完(或读完题解)后,从零自行实现解法
当你挣扎后再理解时学习最多,而不是被动地读解法。
按学习阶段使用这份题单
这份附录不只是题目列表,更应该当作一张「从章节到真题」的训练地图。建议按下面顺序推进:
| 阶段 | 目标 | 推荐章节 | 代表题 | 训练重点 |
|---|---|---|---|---|
| Bronze 入门 | 熟悉输入、模拟、边界 | 第 2.1–2.6 章 | 1, 2, 3, 5 | 读懂题意,减少实现错误 |
| Bronze → Silver | 排序、二分、前缀和 | 第 3.2–3.9 章 | 4, 6, 8, 9, 10 | 把暴力优化到 O(N log N) 或 O(N) |
| Silver 图论 | BFS/DFS、并查集 | 第 5.1–5.6 章 | 11, 12, 13, 14 | 建图、连通性、最短步数 |
| Silver DP | 状态设计与转移 | 第 6.1–6.2 章 | 7, 15, 18 | 明确 dp 状态含义 |
| Silver/Gold 综合 | 贪心、DP、二分组合 | 第 4.1、6.3、8.x 章 | 16, 20 | 识别混合算法与证明正确性 |
做题时的五段复盘法
每道题做完后,不管是否 AC,都用下面五个问题复盘:
- 题干解读: 题目真正要求的量是什么?哪些约束决定算法复杂度?
- 思路分析: 为什么这个题对应某个章节的算法?暴力会在哪里超时?
- CPP 实现: 用到了哪些容器、排序规则、下标约定、快速 I/O?
- 易错点: 哪个边界最容易错?有没有溢出、越界、重复计数?
- 拓展思考: 如果数据范围扩大、限制改变、目标函数改变,算法是否还成立?
第一节:模拟与暴力(Bronze)
题目 1:遮挡广告牌
竞赛: USACO 2017 December Bronze | 主题: 二维几何,矩形
描述: 两块广告牌和一辆卡车(都是与坐标轴平行的矩形),求广告牌未被卡车遮挡的面积之和。
数据规模: 矩形顶点坐标满足 0 ≤ x, y ≤ 1000;卡车可能只遮挡一块、两块或不遮挡任何广告牌。
关键洞察: 计算卡车与每块广告牌的交集。广告牌面积 - 交集面积 = 可见面积。
技术: 二维矩形求交、仔细算术 | 难度: ⭐⭐
题目 2:奶牛信号
竞赛: USACO 2016 February Bronze | 主题: 二维数组操作
描述: 给定 K×L 字符网格中的图案,按因子 R「放大」它(每个方向重复每个字符 R 次),输出 RK×RL 的放大结果。
数据规模: 1 ≤ K, L ≤ 10,1 ≤ R ≤ 10;输出最多 100×100 字符。
关键洞察: 输出位置 (i,j) 的字符来自输入的 ((i-1)/R + 1, (j-1)/R + 1)。
技术: 二维数组索引、整数除法 | 难度: ⭐
题目 3:套球游戏
竞赛: USACO 2016 January Bronze | 主题: 模拟
描述: 一个套球游戏:三个壳中一个藏有豆子,给出 N 次交换 (a, b) 及交换后豆子所在位置的猜测,求猜测正确的最大次数。
数据规模: 1 ≤ N ≤ 100 次交换;1 ≤ a, b ≤ 3(壳编号)。
关键洞察: 追踪球在每次交换中的位置,尝试球在三个起始位置下的情况。
技术: 模拟、对起始位置的暴力 | 难度: ⭐
题目 4:统计干草堆
竞赛: USACO 2016 November Bronze | 主题: 排序、搜索
描述: N 捆干草在数轴上的特定位置,Q 次查询问闭区间 [A, B] 范围内有多少捆。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ Q ≤ 10⁵;位置 0 ≤ x_i ≤ 10⁹;0 ≤ A ≤ B ≤ 10⁹。Q 次查询禁止每次 O(N) 扫描,需要 O(N log N) 预处理 + O(log N) 查询。
关键洞察: 排序干草堆位置,然后对每次查询用二分查找(lower_bound/upper_bound)。
技术: 排序、二分查找 | 难度: ⭐⭐
题目 5:割草
竞赛: USACO 2016 January Bronze | 主题: 网格模拟
描述: FJ 在无穷网格上按 N 条指令割草(每条指令给出转向方向和步数),统计他割了不止一次的格子数。
数据规模: 1 ≤ N ≤ 1000 条指令,每条步数 1 ≤ s ≤ 10;坐标范围有限(约 ±10⁵),可用 map<pair<int,int>> 或偏移数组追踪。
关键洞察: 在集合/映射中追踪所有访问过的位置,再次访问格子时就是双重割草。
技术: 用集合/映射追踪已访问格子、方向模拟 | 难度: ⭐⭐
第二节:数组与前缀和(Bronze/Silver)
题目 6:品种统计
竞赛: USACO 2015 December Bronze | 主题: 前缀和
描述: N 头奶牛排成一排,各有品种 1、2 或 3,Q 次查询问 [L, R] 范围内各品种各有多少头。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ Q ≤ 10⁵;1 ≤ L ≤ R ≤ N。每次查询 O(1) 的前缀和是标准做法。
关键洞察: 为 3 种品种各建一个前缀和数组,每次查询 O(1) 回答。
技术: 前缀和、多数组 | 难度: ⭐⭐
题目 7:牛蹄剪刀布
竞赛: USACO 2017 January Gold | 主题: DP
描述: Bessie 玩 N 局剪刀石头布(对手手势已知),最多换 K 次手势(游戏开始前选定的初始手势不算换),最大化获胜局数。
数据规模(USACO 官方): 1 ≤ N ≤ 10⁵,1 ≤ K ≤ 20。状态数 N×K×3 ≈ 6×10⁶,三维 DP 可行。
关键洞察: DP 状态:(轮次,已用次数,当前手势)。完整解法见第 6.2 章。
技术: 三维 DP | 难度: ⭐⭐⭐
第三节:排序与二分查找(Bronze/Silver)
题目 8:愤怒的奶牛
竞赛: USACO 2016 February Bronze | 主题: 排序、模拟
描述: 数轴上 N 头奶牛各有位置,一头奶牛发射「爆炸」半径 R 向外蔓延,被波及的奶牛会以同半径继续引发爆炸。找能引发所有奶牛的最小初始爆炸半径。
数据规模(USACO 官方): 1 ≤ N ≤ 50,位置 0 ≤ x_i ≤ 10⁸。N 很小,二分答案 + O(N) 模拟绰绰有余。
关键洞察: 对爆炸半径二分答案,对给定半径模拟哪些奶牛被引发。
技术: 二分答案、排序、模拟 | 难度: ⭐⭐⭐
题目 9:攻击性奶牛
竞赛: USACO 2011 March Silver | 主题: 二分答案
描述: 数轴上 N 个位置,从中放置 C 头奶牛(一头一个位置),使任意两头奶牛间的最小距离最大。求该最大化的最小距离。
数据规模(USACO 官方): 2 ≤ C ≤ N ≤ 10⁵;位置 0 ≤ x_i ≤ 10⁹,互不相同。O(N²) 枚举不可行,需要 O(N log range) 的二分答案。
关键洞察: 对答案(最小距离)二分,对每个候选距离贪心检查能否放 C 头奶牛。
技术: 二分答案、贪心检查 | 难度: ⭐⭐⭐
题目 10:Convention
竞赛: USACO 2018 February Silver | 主题: 二分答案 + 贪心
描述: N 头奶牛在时刻 t[i] 到达车站,乘坐 M 辆各容量 C 的公共汽车(按到达顺序分组上车),最小化任意奶牛的最大等待时间(等待时间 = 发车时间 − 到达时间)。
数据规模(USACO 官方): 1 ≤ M, C ≤ N ≤ 10⁵,1 ≤ t[i] ≤ 10⁹。对最大等待时间二分答案 + 贪心分组是 O(N log N) 的标准做法。
关键洞察: 对最大等待时间二分,对每个候选值贪心将奶牛分配到汽车。
技术: 二分答案、贪心模拟、排序 | 难度: ⭐⭐⭐
第四节:图论算法(Silver)
题目 11:关闭农场
竞赛: USACO 2016 January Silver | 主题: DSU、离线处理
描述: 农场有 N 块田地和 M 条双向路径,按给定顺序逐一关闭(移除)田地,每次移除后判断剩余开放田地是否仍全部连通。
数据规模(USACO 官方): 1 ≤ N ≤ 3000,1 ≤ M ≤ 6000。逆向 + DSU 的 O((N+M)α) 是标准做法;正向暴力 O(N·(N+M)) 在此规模勉强可行但慢。
关键洞察: 逆向处理——按逆序添加田地,用 DSU 追踪添加田地时的连通性。
技术: DSU、逆向处理 | 难度: ⭐⭐⭐
题目 12:Moocast
竞赛: USACO 2016 February Silver | 主题: DSU / BFS
描述: 平面上 N 头奶牛,各有对讲机广播半径 p[i](所有奶牛半径相同参数 p,即题中统一的 X)。奶牛 i 与 j 能直接通信当且仅当距离 ≤ p;通信可多跳中继。找使所有奶牛相互连通的最小 p。
数据规模(USACO 官方): 1 ≤ N ≤ 1000(Silver 版本),坐标 0 ≤ x, y ≤ 25000。
关键洞察: 对最小范围二分答案,对给定范围建图并检查连通性。
技术: 二分答案、BFS/DFS 连通性,或 Kruskal MST | 难度: ⭐⭐⭐
题目 13:BFS 最短路
竞赛: 经典问题(倒水问题)| 主题: 状态空间 BFS
描述: 容量为 X 和 Y 的两个桶,可用操作为装满/倒空/互倒,找使任意一桶恰好有 M 升的最少操作次数;无解输出 −1。
数据规模: 1 ≤ X, Y ≤ 100,1 ≤ M ≤ max(X, Y);状态数至多 (X+1)×(Y+1),状态空间 BFS 轻松处理。
关键洞察: 将(桶1中的量,桶2中的量)建模为图状态,BFS 找最少操作次数。
技术: 状态图 BFS | 难度: ⭐⭐⭐
题目 14:草地鉴赏家
竞赛: USACO 2015 December Silver | 主题: SCC(强连通分量)、DAG 上的 BFS
描述: 牧场构成有 N 个节点、M 条边的有向图,Bessie 从节点 1 出发沿边方向游览,且可以免费反转一条边(至多一条、可不用)。求她能访问的最多不同牧场数(可重复经过,只数不同)。
数据规模(USACO 官方): 2 ≤ N ≤ 10⁵,1 ≤ M ≤ 2×10⁵。
关键洞察: 将 SCC 收缩为超级节点,在 DAG 上做 BFS,对每条可反转的边检查改善情况。
技术: SCC、BFS、图收缩 | 难度: ⭐⭐⭐⭐(Gold 级别思维,Silver 竞赛题)
第五节:动态规划(Silver)
题目 15:矩形牧场
竞赛: USACO 2021 January Silver | 主题: 二维前缀和、DP
描述: N 头奶牛在二维平面上(任意两头奶牛的横纵坐标各不相同),统计四条边平行于坐标轴、恰好包含 K 头奶牛的矩形数量(边界上的奶牛也算包含)。
数据规模(USACO 官方): 1 ≤ N ≤ 2000,1 ≤ K ≤ N;坐标 1 ≤ x, y ≤ 2500。
关键洞察: 按 x 排序,对每对列,在行上做 DP,二维前缀和快速统计矩形。
技术: 二维前缀和、组合数学 | 难度: ⭐⭐⭐
题目 16:柠檬水队伍
竞赛: USACO 2017 February Bronze | 主题: 贪心
描述: N 头奶牛想排队买柠檬水。奶牛 i 只在队列中已有 ≤ p[i] 头奶牛(排在它前面)时才愿意加入,否则离开。你可以自由选择邀请顺序。求队伍中奶牛的最大数量。
数据规模(USACO 官方): 1 ≤ N ≤ 10⁵,1 ≤ p[i] ≤ 10⁹。
关键洞察: 按耐心(p[i])降序排序,贪心地尽可能添加每头奶牛。
技术: 排序、贪心 | 难度: ⭐⭐
题目 17:最高奶牛
竞赛: USACO 2016 February Silver | 主题: 差分数组
描述: N 头奶牛站成一排,给定所有奶牛的最大身高 H 和 R 条关系 (A, B)(A、B 互不相同):奶牛 A 和 B 能互相看见,意味着两者之间的奶牛身高都严格小于 min(h[A], h[B])。在满足所有关系的前提下,求每头奶牛的最大可能身高。
数据规模(USACO 官方): 1 ≤ N ≤ 10⁴,1 ≤ R ≤ 10⁴,1 ≤ H ≤ 10⁶。
关键洞察: 用差分数组追踪身高约束,对每对 (A, B),A 和 B 之间的奶牛必须比两者都矮。
技术: 差分数组、前缀和 | 难度: ⭐⭐⭐
第六节:混合(Silver)
题目 18:平衡行动
竞赛: USACO 2018 January Silver | 主题: 树形 DP、质心
描述: 给定 N−1 条边构成的树。删除一个节点后树分裂成若干连通分量;找使「最大分量最小」的节点(质心),输出删除它之后最大连通分量的大小。
数据规模(USACO 官方): 1 ≤ N ≤ 10⁵;树上一次 DFS 求 O(N) 是标准做法。
关键洞察: 通过 DFS 计算子树大小。移除某节点时最大分量是 max(各子节点子树大小, N - 该节点子树大小)。
技术: 树形 DP、子树大小 | 难度: ⭐⭐⭐
题目 19:拼接国家
竞赛: USACO 2016 January Bronze | 主题: 字符串操作、排序
描述: 给定 N 个字符串,对每对 (i, j)(i < j)形成字符串 s_i + s_j(i 在前),统计有多少个这样的拼接字符串是回文。
数据规模: 1 ≤ N ≤ 1000,字符串总长 ≤ 2×10⁶,每个字符串只含小写字母。O(N²) 配对配合哈希/直接比较可行。
关键洞察: 检查每一对,O(N² × L),N ≤ 1000 时可行。
技术: 字符串操作、回文检查 | 难度: ⭐⭐
题目 20:摘浆果
竞赛: USACO 2020 January Silver | 主题: 贪心、DP
描述: Bessie 从 N 棵树上摘浆果(树 i 有 b_i 个),共 K 个篮子,每个篮子的浆果只能来自一棵树;Bessie 和 Elsie 各分 K/2 个篮子,且 Elsie 的所有篮子必须装有相同数量的浆果(Bessie 的篮子数量任意但非空)。最大化 Bessie 篮子中的总浆果数。
数据规模(USACO 官方): 1 ≤ N ≤ 1000,1 ≤ K ≤ 1000(K 为偶数),1 ≤ b_i ≤ 10⁶。
关键洞察: 最优:K/2 个篮子给 Bessie,K/2 个给 Elsie。排序树,对 Elsie 篮子的每种可能大小,二分查找找 Bessie 的最优分配。
技术: 排序、二分查找、贪心 | 难度: ⭐⭐⭐⭐
代表题深度拆解:如何把真题映射回章节
下面选取几道代表题,示范如何用「题干解读 → 思路分析 → CPP 实现要点 → 易错点 → 拓展思考」复盘。完整代码建议回到对应章节阅读或自行实现。
代表题 A:统计干草堆(题目 4)
- 对应章节: 第 3.3 章(排序与搜索)、第 3.9 章(二分答案的前置思想)
- 数据规模: 见上文题目 4——
1 ≤ N, Q ≤ 10⁵,位置0 ≤ x_i ≤ 10⁹,0 ≤ A ≤ B ≤ 10⁹。 - 题干解读: 多次询问区间
[A,B]内有多少个点。Q很大,不能每次扫描所有干草堆。 - 思路分析: 排序位置数组后,用
lower_bound(A)找第一个 ≥ A 的位置,用upper_bound(B)找第一个 > B 的位置,两者下标差就是答案。 - CPP 实现要点:
auto left = lower_bound(pos.begin(), pos.end(), A);,auto right = upper_bound(pos.begin(), pos.end(), B);,答案是right - left。 - 易错点:
upper_bound(B)不是lower_bound(B);区间端点是闭区间[A,B]。 - 拓展思考: 如果位置会动态新增/删除,静态数组二分不够,需要
set、树状数组或线段树。
代表题 B:关闭农场(题目 11)
- 对应章节: 第 5.6 章(并查集)、第 5.1–5.2 章(图的连通性)
- 数据规模: 见上文题目 11——
1 ≤ N ≤ 3000,1 ≤ M ≤ 6000。 - 题干解读: 农场按给定顺序关闭,每次问剩余开放节点是否连通。正向删除很难维护连通性。
- 思路分析: 反向思考:关闭顺序反过来就是逐个打开节点。并查集擅长维护「新增边后的连通块数量」。
- CPP 实现要点: 反向遍历打开节点;每打开一个节点,连通块数
components++;对已打开邻居执行union,成功合并则components--。 - 易错点: 只和已经打开的邻居合并;答案要反向填回原顺序;节点编号通常是 1-indexed。
- 拓展思考: 如果题目要求支持任意时刻删除和新增边,普通 DSU 不支持删除,需要离线处理、分治回滚 DSU 或动态连通性结构。
代表题 C:牛蹄剪刀布(题目 7)
- 对应章节: 第 6.1 章(DP 入门)、第 6.2 章(经典 DP 问题)
- 数据规模: 见上文题目 7——
1 ≤ N ≤ 10⁵,1 ≤ K ≤ 20。 - 题干解读: 已知对手每轮手势,Bessie 可改变手势的次数有限,目标最大化胜场。
- 思路分析: 当前最优不仅取决于第几轮,还取决于已经换了几次、当前手势是什么,因此状态应包含
(轮次, 切换次数, 当前手势)。 - CPP 实现要点:
dp[i][k][g]表示前 i 轮、用了 k 次切换、当前手势 g 的最多胜场;转移分「不换」和「从其他手势换来」。 - 易错点: 最终答案是使用 0..K 次切换的最大值,不是恰好 K 次;初始选择手势不算切换。
- 拓展思考: 手势种类增加时,朴素转移会出现
M^2,可以维护最大/次大优化。
代表题 D:摘浆果(题目 20)
- 对应章节: 第 4 部分(贪心)、第 3.9 章(二分/枚举答案思想)
- 题干解读: 需要在篮子容量和分配之间取最大收益,表面像 DP,但关键是枚举篮子大小后贪心填充。
- 思路分析: 固定 Elsie 篮子的大小后,剩下分配可以排序贪心;难点是把「容量」作为枚举对象。
- CPP 实现要点: 枚举每个可能篮子大小,统计能装满多少篮子,再考虑剩余浆果对 Bessie 的贡献。
- 易错点: 只考虑装满篮子会漏掉 Bessie 的半满篮;排序方向和取前
K/2个收益容易写错。 - 拓展思考: 这类题体现 USACO Silver/Gold 常见技巧:不直接枚举方案,而是枚举一个关键参数,把剩余部分变成贪心。
快速参考:按技术分类的题目
| 技术 | 题目编号 |
|---|---|
| 模拟 | 1, 2, 3, 5 |
| 排序 | 4, 8, 9, 10, 16 |
| 前缀和 | 6, 17 |
| 二分查找 | 4, 8, 9, 10, 12 |
| BFS / DFS | 13, 14 |
| 并查集 | 11, 12 |
| 动态规划 | 7, 15, 18, 20 |
| 贪心 | 16, 20 |
| 字符串 / Ad hoc | 19 |
练习建议
- 在 train.usaco.org 上使用 USACO 训练门户自动评测
- 每道题后都读题解(在 usaco.org 上)——哪怕是你解出来的题
- 保持题目日志——写下每道题的关键洞察
- 难度进阶:从近年简单题做起,再做老年份的中等题
其他题目来源
| 来源 | 网址 | 最适合 |
|---|---|---|
| USACO 题库 | usaco.org | USACO 专项练习 |
| USACO Guide | usaco.guide | 带题目的结构化课程 |
| Codeforces | codeforces.com | 大量练习、多样题目 |
| AtCoder Beginner | atcoder.jp | 高质量入门题 |
| LeetCode | leetcode.com | 数据结构基础 |
| CSES | cses.fi/problemset | 经典算法题 |
CSES 题目集(cses.fi/problemset)特别推荐——约 300 道精心策划的题目,涵盖所有 USACO Silver 主题,自动评测,免费。
附录 C:C++ 竞赛编程技巧
本附录收集了竞赛程序员每天使用的最有用的 C++ 技巧、宏、模板和代码片段,可以在竞赛中节省大量时间并让代码运行更快。
C.1 快速 I/O
对 I/O 密集型题目最重要的性能优化:
// 始终在 main() 开头加上这两行
ios_base::sync_with_stdio(false); // 断开 C 和 C++ I/O 流的同步
cin.tie(NULL); // 解除 cin 和 cout 的绑定
// 为什么有效:
// sync_with_stdio(false):默认情况下 C++ 与 C I/O(printf/scanf)
// 同步以保持兼容性,关闭后 cin/cout 快得多。
// cin.tie(NULL):默认情况下 cin 在每次读取前清空 cout,
// 解除绑定消除这个不必要的清空。
性能差异很显著——这两行应该出现在每个解法中:

文件 I/O(USACO 传统题):
freopen("problem.in", "r", stdin); // 将 cin 重定向到文件(将 "problem" 替换为实际名称)
freopen("problem.out", "w", stdout); // 将 cout 重定向到文件
// 这两行之后 cin/cout 正常使用但读写文件
C.2 常用宏和 typedef
// 较短的类型名
typedef long long ll;
typedef unsigned long long ull;
typedef long double ld;
typedef pair<int,int> pii;
typedef pair<ll,ll> pll;
typedef vector<int> vi;
typedef vector<ll> vll;
// 缩写操作
#define pb push_back
#define pf push_front
#define all(v) (v).begin(), (v).end()
#define rall(v) (v).rbegin(), (v).rend()
#define sz(v) ((int)(v).size())
#define fi first
#define se second
// 循环宏(谨慎使用——可能影响可读性)
#define FOR(i, a, b) for(int i = (a); i < (b); i++)
#define REP(i, n) FOR(i, 0, n)
// 最小/最大值缩写
#define chmin(a, b) a = min(a, b)
#define chmax(a, b) a = max(a, b)
// 使用示例:
// vi v; v.pb(5); → v.push_back(5)
// sort(all(v)); → sort(v.begin(), v.end())
// cout << sz(v) << "\n";→ cout << (int)v.size() << "\n"
// FOR(i, 1, n+1) { ... }→ for(int i = 1; i < n+1; i++) { ... }
C.3 GCC 编译指令提速
// 这些 pragma 在 GCC 编译器(USACO 评测机使用)上可提速 2-4 倍
#pragma GCC optimize("O3,unroll-loops")
#pragma GCC target("avx2,bmi,bmi2,popcnt")
// 放在 #include 之前
// 警告:O3 和 avx2 可能导致微妙的数值差异
// (整数题通常没问题,浮点数要小心)
// 更安全的版本(只有 O2,无向量指令):
#pragma GCC optimize("O2")
// 带 pragma 的完整竞赛模板:
#pragma GCC optimize("O3,unroll-loops")
#pragma GCC target("avx2")
#include <bits/stdc++.h>
using namespace std;
// ... 你的代码
C.4 实用数学:GCD、LCM、模运算
#include <bits/stdc++.h>
using namespace std;
// ─── GCD 和 LCM ──────────────────────────────────────────────────────────────
// C++17:来自 <numeric> 的 std::gcd 和 std::lcm
#include <numeric>
int g = gcd(12, 8); // 4
int l = lcm(4, 6); // 12
// C++14 及以前:来自 <algorithm> 的 __gcd
int g2 = __gcd(12, 8); // 4
// 自定义 GCD(辗转相除法):
ll mygcd(ll a, ll b) { return b ? mygcd(b, a%b) : a; }
ll mylcm(ll a, ll b) { return a / mygcd(a,b) * b; } // 先除防溢出!
// ─── 模运算 ──────────────────────────────────────────────────────────────────
const ll MOD = 1e9 + 7; // 标准 USACO/Codeforces 模数
// 加法:(a + b) % MOD
ll addmod(ll a, ll b) { return (a + b) % MOD; }
// 减法:(a - b + MOD) % MOD ← 取模前总要加 MOD 防负数
ll submod(ll a, ll b) { return (a - b + MOD) % MOD; }
// 乘法:(a * b) % MOD
ll mulmod(ll a, ll b) { return (a % MOD) * (b % MOD) % MOD; }
// 快速幂:a^b mod MOD,O(log b)
ll power(ll base, ll exp, ll mod = MOD) {
ll result = 1;
base %= mod;
while (exp > 0) {
if (exp & 1) result = result * base % mod; // 奇数指数
base = base * base % mod; // 平方
exp >>= 1; // 减半指数
}
return result;
}
// 模逆元(a^{-1} mod p,p 为质数):
ll modinv(ll a, ll mod = MOD) { return power(a, mod-2, mod); }
// 这使用费马小定理:a^{p-1} ≡ 1 (mod p),p 为质数
// 所以 a^{-1} ≡ a^{p-2} (mod p)
// 模除法:(a / b) mod p = (a * b^{-1}) mod p
ll divmod(ll a, ll b) { return mulmod(a, modinv(b)); }
// 预计算阶乘后的组合数 C(n, k) mod p
const int MAXN = 200001;
ll fact[MAXN], inv_fact[MAXN];
void precompute_factorials() {
fact[0] = 1;
for (int i = 1; i < MAXN; i++) fact[i] = fact[i-1] * i % MOD;
inv_fact[MAXN-1] = modinv(fact[MAXN-1]);
for (int i = MAXN-2; i >= 0; i--) inv_fact[i] = inv_fact[i+1] * (i+1) % MOD;
}
ll C(int n, int k) {
if (k < 0 || k > n) return 0;
return fact[n] * inv_fact[k] % MOD * inv_fact[n-k] % MOD;
}
C.5 实用代码片段
并查集(DSU)模板
// DSU——带大小追踪的完整模板
struct DSU {
vector<int> parent, sz;
DSU(int n) : parent(n+1), sz(n+1, 1) {
iota(parent.begin(), parent.end(), 0);
}
int find(int x) {
if (parent[x] != x) parent[x] = find(parent[x]); // 路径压缩
return parent[x];
}
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false;
if (sz[x] < sz[y]) swap(x, y); // 按大小合并
parent[y] = x;
sz[x] += sz[y];
return true;
}
bool connected(int x, int y) { return find(x) == find(y); }
int size(int x) { return sz[find(x)]; } // x 所在分量的大小
};
// 使用:
DSU dsu(n);
dsu.unite(1, 2);
cout << dsu.connected(1, 3) << "\n"; // 0(假)
cout << dsu.size(1) << "\n"; // 2
线段树(单点更新,区间查询)
// 线段树——支持:
// point_update(i, val):设置位置 i 为 val
// query(l, r):[l, r] 的和
// 所有操作 O(log N)
struct SegTree {
int n;
vector<ll> tree;
SegTree(int n) : n(n), tree(4*n, 0) {}
void update(int node, int start, int end, int idx, ll val) {
if (start == end) {
tree[node] = val;
return;
}
int mid = (start + end) / 2;
if (idx <= mid) update(2*node, start, mid, idx, val);
else update(2*node+1, mid+1, end, idx, val);
tree[node] = tree[2*node] + tree[2*node+1];
}
ll query(int node, int start, int end, int l, int r) {
if (r < start || end < l) return 0;
if (l <= start && end <= r) return tree[node];
int mid = (start + end) / 2;
return query(2*node, start, mid, l, r)
+ query(2*node+1, mid+1, end, l, r);
}
void update(int i, ll val) { update(1, 1, n, i, val); }
ll query(int l, int r) { return query(1, 1, n, l, r); }
};
BFS 模板
// 网格 BFS——无权网格中的最短路径
int bfs_grid(vector<string>& grid, int sr, int sc, int er, int ec) {
int R = grid.size(), C = grid[0].size();
vector<vector<int>> dist(R, vector<int>(C, -1));
queue<pair<int,int>> q;
int dr[] = {-1, 1, 0, 0};
int dc[] = {0, 0, -1, 1};
dist[sr][sc] = 0;
q.push({sr, sc});
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr >= 0 && nr < R && nc >= 0 && nc < C
&& grid[nr][nc] != '#' && dist[nr][nc] == -1) {
dist[nr][nc] = dist[r][c] + 1;
q.push({nr, nc});
}
}
}
return dist[er][ec];
}
二分答案模板
// 二分答案——最大化满足 check(X) 为真的 X
// 前提:check 是单调的(false...false...true...true)
template<typename T, typename F>
T binary_search_ans(T lo, T hi, F check) {
T ans = lo;
while (lo <= hi) {
T mid = lo + (hi - lo) / 2;
if (check(mid)) { ans = mid; lo = mid + 1; }
else { hi = mid - 1; }
}
return ans;
}
// 使用示例:找最大 D 使 canPlace(D) 为真
int result = binary_search_ans(1, maxDist, canPlace);
C.6 值得了解的内置函数
// ─── 整数操作 ─────────────────────────────────────────────────────────────────
__builtin_popcount(x) // 统计 x 中置位数(int)
__builtin_popcountll(x) // 统计 x 中置位数(long long)
__builtin_clz(x) // 统计前导零数(int,x > 0)
__builtin_ctz(x) // 统计尾零数(int,x > 0)
// 示例:
__builtin_popcount(0b1011) == 3 // 三个 1 位
__builtin_ctz(0b1000) == 3 // 三个尾零
(31 - __builtin_clz(x)) // floor(log2(x))
// ─── 位运算技巧 ──────────────────────────────────────────────────────────────
// 检查 x 是否是 2 的幂:
bool isPow2 = (x > 0) && !(x & (x-1));
// 提取最低置位:
int lsb = x & (-x);
// 清除最低置位:
x = x & (x-1);
// 枚举位掩码的所有子集(用于状压 DP):
for (int sub = mask; sub > 0; sub = (sub-1) & mask) {
// 处理 mask 的子集 sub
}
// ─── 实用 STL 函数 ────────────────────────────────────────────────────────────
// next_permutation:遍历所有排列
sort(v.begin(), v.end()); // 从有序开始
do {
// v 是当前排列
} while (next_permutation(v.begin(), v.end()));
C.7 完整竞赛模板
// ────────────────────────────────────────────────────────────────────────────
// 竞赛编程模板——C++17
// ────────────────────────────────────────────────────────────────────────────
#pragma GCC optimize("O2")
#include <bits/stdc++.h>
using namespace std;
// 类型别名
typedef long long ll;
typedef pair<int,int> pii;
typedef vector<int> vi;
// 便捷宏
#define pb push_back
#define all(v) (v).begin(), (v).end()
#define sz(v) ((int)(v).size())
#define fi first
#define se second
// 常量
const ll MOD = 1e9 + 7;
const ll INF = 1e18;
const int MAXN = 200005;
// 快速幂取模
ll power(ll base, ll exp, ll mod = MOD) {
ll res = 1; base %= mod;
for (; exp > 0; exp >>= 1) {
if (exp & 1) res = res * base % mod;
base = base * base % mod;
}
return res;
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
// 文件 I/O 时取消注释:
// freopen("problem.in", "r", stdin);
// freopen("problem.out", "w", stdout);
// ── 你的解法 ──
return 0;
}
C.8 常用模式和惯用法
// ─── 读取 N 个整数到向量 ──────────────────────────────────────────────────────
int n; cin >> n;
vi a(n);
for (int &x : a) cin >> x;
// ─── 二维向量初始化 ──────────────────────────────────────────────────────────
int R, C;
vector<vector<int>> grid(R, vector<int>(C, 0));
// ─── 自定义条件排序 ──────────────────────────────────────────────────────────
sort(all(v), [](const auto &a, const auto &b) {
return a.weight < b.weight; // 按重量升序排序
});
// ─── 带下标的最小/最大值 ─────────────────────────────────────────────────────
auto maxIt = max_element(all(v));
int maxVal = *maxIt;
int maxIdx = maxIt - v.begin();
// ─── 从有序向量删除重复 ──────────────────────────────────────────────────────
sort(all(v));
v.erase(unique(all(v)), v.end());
// ─── 整数平方根(精确,无浮点问题)──────────────────────────────────────────
ll isqrt(ll n) {
ll r = sqrtl(n);
while (r*r > n) r--;
while ((r+1)*(r+1) <= n) r++;
return r;
}
// ─── 检查数是否为质数 ─────────────────────────────────────────────────────────
bool isPrime(ll n) {
if (n < 2) return false;
if (n == 2) return true;
if (n % 2 == 0) return false;
for (ll i = 3; i * i <= n; i += 2) {
if (n % i == 0) return false;
}
return true;
}
// ─── 埃拉托斯特尼筛法(N 以内所有质数)───────────────────────────────────────
vector<bool> sieve(int N) {
vector<bool> is_prime(N+1, true);
is_prime[0] = is_prime[1] = false;
for (int i = 2; i * i <= N; i++) {
if (is_prime[i]) {
for (int j = i*i; j <= N; j += i)
is_prime[j] = false;
}
}
return is_prime;
}
C.9 调试技巧
// 用 cerr 调试输出(评测机通常忽略标准错误)
#ifdef DEBUG
#define dbg(x) cerr << #x << " = " << x << "\n"
#define dbgv(v) cerr << #v << ": "; for(auto x:v) cerr << x << " "; cerr << "\n"
#else
#define dbg(x)
#define dbgv(v)
#endif
// 调试模式编译:g++ -DDEBUG -o sol sol.cpp (启用调试输出)
// 正常编译: g++ -o sol sol.cpp (移除调试输出)
// 使用:
int x = 42;
dbg(x); // 打印:x = 42(仅调试模式)
vi v = {1,2,3};
dbgv(v); // 打印:v: 1 2 3(仅调试模式)
// 用消毒器检测内存错误和未定义行为:
// g++ -fsanitize=address,undefined -O1 -o sol sol.cpp
// 非常适合发现:
// - 数组越界访问
// - 整数溢出(带 -fsanitize=signed-integer-overflow)
// - 使用未初始化内存
// - 空指针解引用
树状数组(BIT)——带更新的前缀和

树状数组使用最低置位技巧实现 O(log N) 的前缀和查询和更新。下标 i 负责范围 [i - lowbit(i) + 1, i],其中 lowbit(i) = i & (-i)。
// 树状数组 / BIT——O(log N) 更新和前缀查询
struct BIT {
int n;
vector<long long> tree;
BIT(int n) : n(n), tree(n + 1, 0) {}
// 在位置 i 添加 val(1-indexed)
void update(int i, long long val) {
for (; i <= n; i += i & (-i))
tree[i] += val;
}
// 前缀和 [1..i]
long long query(int i) {
long long sum = 0;
for (; i > 0; i -= i & (-i))
sum += tree[i];
return sum;
}
// 区间和 [l..r]
long long query(int l, int r) { return query(r) - query(l - 1); }
};
附录 D:竞赛常用算法模板
🏆 快速参考: 这些模板经过实战验证,可直接复制粘贴使用,专为算法竞赛场景设计。每个模板均注明了时间复杂度和典型应用场景。
在深入模板之前,先用这棵决策树,根据数据规模 N 选择合适的算法:

D.1 并查集(DSU / Union-Find)
适用场景: 动态连通性、Kruskal 最小生成树、环检测、元素分组。
复杂度: 每次操作 O(α(N)) ≈ O(1)(阿克曼函数的反函数,极小的常数)。
// =============================================================
// DSU(并查集):路径压缩 + 按秩合并
// =============================================================
struct DSU {
vector<int> parent, rank_;
int components; // 连通分量数
DSU(int n) : parent(n), rank_(n, 0), components(n) {
iota(parent.begin(), parent.end(), 0); // parent[i] = i
}
// 带路径压缩的 find
int find(int x) {
if (parent[x] != x)
parent[x] = find(parent[x]); // 路径压缩
return parent[x];
}
// 按秩合并:若真正合并了(两者在不同集合)则返回 true
bool unite(int x, int y) {
x = find(x); y = find(y);
if (x == y) return false; // 已连通
if (rank_[x] < rank_[y]) swap(x, y);
parent[y] = x;
if (rank_[x] == rank_[y]) rank_[x]++;
components--;
return true;
}
bool connected(int x, int y) { return find(x) == find(y); }
};
// 使用示例:
int main() {
int n = 5;
DSU dsu(n);
dsu.unite(0, 1);
dsu.unite(2, 3);
cout << dsu.connected(0, 1) << "\n"; // 1(连通)
cout << dsu.connected(0, 2) << "\n"; // 0(不连通)
cout << dsu.components << "\n"; // 3
return 0;
}
D.2 线段树(单点更新,区间求和)
适用场景: 支持单点更新的区间求和/最大/最小查询。
复杂度: 建树 O(N),每次查询/更新 O(log N)。
// =============================================================
// 线段树:单点更新,区间求和
// =============================================================
struct SegTree {
int n;
vector<long long> tree;
SegTree(int n) : n(n), tree(4 * n, 0) {}
void build(vector<long long>& arr, int node, int start, int end) {
if (start == end) { tree[node] = arr[start]; return; }
int mid = (start + end) / 2;
build(arr, 2*node, start, mid);
build(arr, 2*node+1, mid+1, end);
tree[node] = tree[2*node] + tree[2*node+1];
}
void build(vector<long long>& arr) { build(arr, 1, 0, n-1); }
void update(int node, int start, int end, int idx, long long val) {
if (start == end) { tree[node] = val; return; }
int mid = (start + end) / 2;
if (idx <= mid) update(2*node, start, mid, idx, val);
else update(2*node+1, mid+1, end, idx, val);
tree[node] = tree[2*node] + tree[2*node+1];
}
// 将 arr[idx] 更新为 val
void update(int idx, long long val) { update(1, 0, n-1, idx, val); }
long long query(int node, int start, int end, int l, int r) {
if (r < start || end < l) return 0; // 求和的单位元
if (l <= start && end <= r) return tree[node];
int mid = (start + end) / 2;
return query(2*node, start, mid, l, r)
+ query(2*node+1, mid+1, end, l, r);
}
// 查询 arr[l..r] 的区间和
long long query(int l, int r) { return query(1, 0, n-1, l, r); }
};
// 使用示例:
int main() {
vector<long long> arr = {1, 3, 5, 7, 9, 11};
SegTree st(arr.size());
st.build(arr);
cout << st.query(2, 4) << "\n"; // 5+7+9 = 21
st.update(2, 10); // arr[2] = 10
cout << st.query(2, 4) << "\n"; // 10+7+9 = 26
return 0;
}
D.3 BFS 模板
适用场景: 无权图/网格中的最短路径、层序遍历、多源距离。
复杂度: O(V + E)。
// =============================================================
// BFS:无权图最短路径
// =============================================================
#include <bits/stdc++.h>
using namespace std;
// 返回 dist[],其中 dist[v] = src 到 v 的最短距离
// dist[v] = -1 表示不可达
vector<int> bfs(int src, int n, vector<vector<int>>& adj) {
vector<int> dist(n, -1);
queue<int> q;
dist[src] = 0;
q.push(src);
while (!q.empty()) {
int u = q.front(); q.pop();
for (int v : adj[u]) {
if (dist[v] == -1) {
dist[v] = dist[u] + 1;
q.push(v);
}
}
}
return dist;
}
// 网格 BFS(四方向)
const int dr[] = {-1, 1, 0, 0};
const int dc[] = {0, 0, -1, 1};
int gridBFS(vector<string>& grid, int sr, int sc, int er, int ec) {
int R = grid.size(), C = grid[0].size();
vector<vector<int>> dist(R, vector<int>(C, -1));
queue<pair<int,int>> q;
dist[sr][sc] = 0;
q.push({sr, sc});
while (!q.empty()) {
auto [r, c] = q.front(); q.pop();
for (int d = 0; d < 4; d++) {
int nr = r + dr[d], nc = c + dc[d];
if (nr >= 0 && nr < R && nc >= 0 && nc < C
&& grid[nr][nc] != '#' && dist[nr][nc] == -1) {
dist[nr][nc] = dist[r][c] + 1;
q.push({nr, nc});
}
}
}
return dist[er][ec]; // 不可达时返回 -1
}
D.4 DFS 模板
适用场景: 连通分量、环检测、拓扑排序、洪水填充。
复杂度: O(V + E)。
// =============================================================
// DFS:迭代版与递归版模板
// =============================================================
vector<vector<int>> adj;
vector<int> color; // 0=白(未访问),1=灰(栈中),2=黑(已完成)
// 递归 DFS + 环检测(有向图)
bool hasCycle = false;
void dfs(int u) {
color[u] = 1; // 标记为"进行中"
for (int v : adj[u]) {
if (color[v] == 0) dfs(v);
else if (color[v] == 1) hasCycle = true; // 后向边 → 有环!
}
color[u] = 2; // 标记为"已完成"
}
// 利用 DFS 后序做拓扑排序
vector<int> topoOrder;
void dfsToposort(int u) {
color[u] = 1;
for (int v : adj[u]) {
if (color[v] == 0) dfsToposort(v);
}
color[u] = 2;
topoOrder.push_back(u); // 处理完所有子节点后再加入
}
// 最后将 topoOrder 反转即得拓扑序列
// 迭代 DFS(避免大图递归时栈溢出)
void dfsIterative(int src, int n) {
vector<bool> visited(n, false);
stack<int> st;
st.push(src);
while (!st.empty()) {
int u = st.top(); st.pop();
if (visited[u]) continue;
visited[u] = true;
// 在此处理 u
for (int v : adj[u]) {
if (!visited[v]) st.push(v);
}
}
}
D.5 Dijkstra 算法
适用场景: 边权非负的有权图最短路径。
复杂度: O((V + E) log V)。
// =============================================================
// Dijkstra 最短路 — O((V+E) log V)
// =============================================================
#include <bits/stdc++.h>
using namespace std;
typedef pair<long long, int> pli; // {距离, 节点}
const long long INF = 1e18;
vector<long long> dijkstra(int src, int n,
vector<vector<pair<int,int>>>& adj) {
// adj[u] = { {v, 边权}, ... }
vector<long long> dist(n, INF);
priority_queue<pli, vector<pli>, greater<pli>> pq; // 小根堆
dist[src] = 0;
pq.push({0, src});
while (!pq.empty()) {
auto [d, u] = pq.top(); pq.pop();
if (d > dist[u]) continue; // ← 关键:跳过过时条目
for (auto [v, w] : adj[u]) {
if (dist[u] + w < dist[v]) {
dist[v] = dist[u] + w;
pq.push({dist[v], v});
}
}
}
return dist; // dist[v] = src → v 的最短距离,INF 表示不可达
}
// 使用示例:
int main() {
int n = 5;
vector<vector<pair<int,int>>> adj(n);
// 添加无向边 u-v,权重 w:
auto addEdge = [&](int u, int v, int w) {
adj[u].push_back({v, w});
adj[v].push_back({u, w});
};
addEdge(0, 1, 4);
addEdge(0, 2, 1);
addEdge(2, 1, 2);
addEdge(1, 3, 1);
addEdge(2, 3, 5);
auto dist = dijkstra(0, n, adj);
cout << dist[3] << "\n"; // 4(路径 0→2→1→3,代价 1+2+1=4)
return 0;
}
D.6 二分查找模板
适用场景: 在有序数组中搜索,或"对答案二分"(参数搜索)。
复杂度: 每次搜索 O(log N),对答案二分 O(f(N) × log V)。
// =============================================================
// 二分查找模板
// =============================================================
// 1. 查找精确值(返回下标或 -1)
int binarySearch(vector<int>& arr, int target) {
int lo = 0, hi = (int)arr.size() - 1;
while (lo <= hi) {
int mid = lo + (hi - lo) / 2;
if (arr[mid] == target) return mid;
else if (arr[mid] < target) lo = mid + 1;
else hi = mid - 1;
}
return -1;
}
// 2. 第一个 arr[i] >= target 的下标(lower_bound)
int lowerBound(vector<int>& arr, int target) {
int lo = 0, hi = (int)arr.size();
while (lo < hi) {
int mid = lo + (hi - lo) / 2;
if (arr[mid] < target) lo = mid + 1;
else hi = mid;
}
return lo; // 若所有元素 < target 则返回 arr.size()
}
// 3. 第一个 arr[i] > target 的下标(upper_bound)
int upperBound(vector<int>& arr, int target) {
int lo = 0, hi = (int)arr.size();
while (lo < hi) {
int mid = lo + (hi - lo) / 2;
if (arr[mid] <= target) lo = mid + 1;
else hi = mid;
}
return lo;
}
// 4. 对答案二分——找到最大的 X 使得 check(X) 为 true
// 模板:根据题目调整 lo、hi 和 check() 函数
long long bsOnAnswer(long long lo, long long hi,
function<bool(long long)> check) {
long long answer = lo - 1; // 哨兵:无合法答案
while (lo <= hi) {
long long mid = lo + (hi - lo) / 2;
if (check(mid)) {
answer = mid;
lo = mid + 1; // 尝试更大的答案
} else {
hi = mid - 1;
}
}
return answer;
}
// STL 封装(实际使用中优先采用):
// lower_bound(v.begin(), v.end(), x) → 指向第一个 >= x 的迭代器
// upper_bound(v.begin(), v.end(), x) → 指向第一个 > x 的迭代器
// binary_search(v.begin(), v.end(), x) → bool,判断 x 是否存在
lower_bound / upper_bound 速查表:
| 目标 | 代码 |
|---|---|
| 第一个 ≥ x 的下标 | lower_bound(v.begin(), v.end(), x) - v.begin() |
| 第一个 > x 的下标 | upper_bound(v.begin(), v.end(), x) - v.begin() |
| x 的出现次数 | upper_bound(..., x) - lower_bound(..., x) |
| 最大的 ≤ x 的值 | prev(upper_bound(..., x)) (需确认存在) |
| 最小的 ≥ x 的值 | *lower_bound(..., x) (需确认 < end) |
D.7 模运算模板
适用场景: 大数运算、组合数学、大值 DP。
复杂度: 基本运算 O(1),快速幂 O(log exp)。
// =============================================================
// 模运算模板
// =============================================================
const long long MOD = 1e9 + 7; // 或 998244353(NTT 友好素数)
long long mod(long long x) { return ((x % MOD) + MOD) % MOD; }
long long add(long long a, long long b) { return (a + b) % MOD; }
long long sub(long long a, long long b) { return mod(a - b); }
long long mul(long long a, long long b) { return a % MOD * (b % MOD) % MOD; }
// 快速幂:base^exp mod MOD — O(log exp)
long long power(long long base, long long exp, long long mod = MOD) {
long long result = 1;
base %= mod;
while (exp > 0) {
if (exp & 1) result = result * base % mod; // 当前位为 1
base = base * base % mod; // 底数平方
exp >>= 1; // 右移
}
return result;
}
// 模逆元(base^(MOD-2) mod MOD,仅当 MOD 为素数时成立)
long long inv(long long x) { return power(x, MOD - 2); }
// 模意义下的除法
long long divide(long long a, long long b) { return mul(a, inv(b)); }
// 预处理阶乘,用于组合数
const int MAXN = 200005;
long long fact[MAXN], inv_fact[MAXN];
void precompute_factorials() {
fact[0] = 1;
for (int i = 1; i < MAXN; i++) fact[i] = fact[i-1] * i % MOD;
inv_fact[MAXN-1] = inv(fact[MAXN-1]);
for (int i = MAXN-2; i >= 0; i--) inv_fact[i] = inv_fact[i+1] * (i+1) % MOD;
}
// C(n, k) = 组合数 mod MOD
long long C(int n, int k) {
if (k < 0 || k > n) return 0;
return fact[n] * inv_fact[k] % MOD * inv_fact[n-k] % MOD;
}
D.8 快速幂(二进制取幂)
适用场景: 计算大指数 a^b(独立版或模运算版)。
复杂度: O(log b)。
// =============================================================
// 二进制取幂:O(log b) 计算 a^b
// =============================================================
// 整数幂(无取模)——大 a、b 时注意溢出
long long fastPow(long long a, long long b) {
long long result = 1;
while (b > 0) {
if (b & 1) result *= a; // 当前位为 1
a *= a; // 底数平方
b >>= 1; // 下一位
}
return result;
}
// 模意义快速幂:a^b mod m(即上方 power 的别名,统一用 power 即可)
// 矩阵快速幂:用于 O(log N) 计算 Fibonacci 等
typedef vector<vector<long long>> Matrix;
// 注意:使用 D.7 中定义的 MOD(const long long MOD = 1e9 + 7)
Matrix multiply(const Matrix& A, const Matrix& B) {
int n = A.size();
Matrix C(n, vector<long long>(n, 0));
for (int i = 0; i < n; i++)
for (int k = 0; k < n; k++)
if (A[i][k])
for (int j = 0; j < n; j++)
C[i][j] = (C[i][j] + A[i][k] * B[k][j]) % MOD;
return C;
}
Matrix matPow(Matrix M, long long b) {
int n = M.size();
Matrix result(n, vector<long long>(n, 0));
for (int i = 0; i < n; i++) result[i][i] = 1; // 单位矩阵
while (b > 0) {
if (b & 1) result = multiply(result, M);
M = multiply(M, M);
b >>= 1;
}
return result;
}
// 示例:O(log N) 计算 Fibonacci(N)
// [F(n+1)] [1 1]^n [F(1)]
// [F(n) ] = [1 0] * [F(0)]
long long fibonacci(long long n) {
if (n <= 1) return n;
Matrix M = {{1, 1}, {1, 0}};
Matrix result = matPow(M, n - 1);
return result[0][0]; // F(n)
}
D.9 其他实用模板
前缀和(一维与二维)
// 一维前缀和
vector<long long> prefSum(n + 1, 0);
for (int i = 1; i <= n; i++) prefSum[i] = prefSum[i-1] + arr[i];
// 查询 arr[l..r] 的区间和(1-indexed):prefSum[r] - prefSum[l-1]
// 二维前缀和
long long psum[N+1][M+1] = {};
for (int i = 1; i <= N; i++)
for (int j = 1; j <= M; j++)
psum[i][j] = grid[i][j] + psum[i-1][j] + psum[i][j-1] - psum[i-1][j-1];
// 查询矩形 [r1,c1]..[r2,c2] 的区间和:
// psum[r2][c2] - psum[r1-1][c2] - psum[r2][c1-1] + psum[r1-1][c1-1]
竞赛编程头文件模板
// 竞赛编程标准头文件模板
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
typedef pair<int,int> pii;
typedef vector<int> vi;
typedef vector<ll> vll;
#define all(x) x.begin(), x.end()
#define sz(x) (int)(x).size()
#define pb push_back
#define mp make_pair
const int INF = 1e9;
const ll LINF = 1e18;
const int MOD = 1e9 + 7;
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
// 在此填写你的解答
return 0;
}
速查卡片
| 算法 | 复杂度 | 需要包含的头文件 |
|---|---|---|
| 并查集(DSU) | O(α(N)) 每次操作 | — |
| 线段树 | O(N) 建树,O(log N) 每次操作 | — |
| BFS | O(V+E) | <queue> |
| DFS | O(V+E) | <stack> |
| Dijkstra | O((V+E) log V) | <queue> |
| 二分查找 | O(log N) | <algorithm> |
| 排序 | O(N log N) | <algorithm> |
| 模意义快速幂 | O(log exp) | — |
| lower/upper_bound | O(log N) | <algorithm> |
✅ 所有示例均在 C++17(
-std=c++17 -O2)下编译通过并经过验证。
附录 F:调试指南——常见 Bug 及修复方法
💡 为什么要有这份附录? 即便算法思路完全正确,只要一个 Bug 溜进代码,结果就会出错。本指南系统地整理了竞赛 C++ 代码中最常见的 Bug,按类别分类,方便快速定位。当你的解答出现 WA(Wrong Answer)、TLE(Time Limit Exceeded)、RE(Runtime Error)或 MLE(Memory Limit Exceeded)时,请先来这里查找原因。
用下面这张分类图快速判断你的 Bug 属于哪个类别:

拿到错误判决后,按照这个系统化的调试流程来排查:

F.1 整数溢出
C++ 中 Wrong Answer 最常见的根源。
问题:int 太小了
int 的最大值约为 2.1 × 10⁹(≈ 2 × 10⁹)。很多题目的中间值会超出这个范围。
// ❌ 错误:n=10^5 时,n*n 会溢出
int n = 100000;
int result = n * n; // = 10^10 → 超出 int 范围(最大 ~2×10^9)!
// ✅ 正确:乘之前先转成 long long
long long result = (long long)n * n; // = 10^10,在 long long 范围内
// 或:
long long n_ll = n;
long long result2 = n_ll * n_ll;
什么时候该用 long long
| 场景 | 需要 long long 吗? |
|---|---|
| 数组元素最大 10⁹,需要区间求和 | ✅ 需要(和最大 10⁹ × 10⁵ = 10¹⁴) |
| 最多 10⁵ 个元素的前缀和 | ✅ 需要(安全默认选择) |
| 矩阵元素、DP 中间值 | ✅ 需要 |
| Dijkstra 中的距离 | ✅ 需要(dist[u] + w 可能溢出 int) |
| 简单计数器(0 到 10⁶ 以内的 N) | ❌ int 足够 |
| 下标和循环变量 | ❌ int 足够 |
危险操作举例
// ❌ 溢出示例:
int a = 1e9, b = 1e9;
cout << a + b; // 溢出(结果 > INT_MAX)
cout << a * 2; // 溢出
cout << a * a; // 灾难性溢出
// ❌ 比较时溢出:
if (a * b > 1e18) ... // a*b 本身可能已经溢出了!
// ✅ 安全版本:
cout << (long long)a + b;
cout << (long long)a * 2;
cout << (long long)a * a;
if ((long long)a * b > (long long)1e18) ... // 用 long long 比较
INF 值的选择
// ❌ 错误:在 Dijkstra 中用 INT_MAX 作为无穷大
const int INF = INT_MAX;
if (dist[u] + w < dist[v]) ... // dist[u] + w 在 dist[u]=INT_MAX 时溢出!
// ✅ 正确:使用安全的哨兵值
const long long INF = 1e18; // 用于 long long 距离
const int INF_INT = 1e9; // 用于 int 距离(留有加法空间)
F.2 差一错误(Off-By-One)
WA 第二常见的根源。
数组下标
// ❌ 错误:访问 A[n] 越界
int A[n];
for (int i = 0; i <= n; i++) cout << A[i]; // A[n] 未定义!
// ✅ 正确
for (int i = 0; i < n; i++) cout << A[i]; // 下标 0..n-1
// 或(1-indexed):
for (int i = 1; i <= n; i++) cout << A[i]; // 下标 1..n
前缀和公式
// ❌ 错误:区间和差一
// sum(L, R) 应该是 P[R] - P[L-1],而不是 P[R] - P[L]
cout << P[R] - P[L]; // 少了 A[L]!
// ✅ 正确
cout << P[R] - P[L-1]; // P[0]=0 正确处理 L=1 的边界情况
二分查找边界
// 查找第一个 A[i] >= target 的下标(lower_bound 行为):
// ❌ 错误:常见二分查找写法错误
int lo = 0, hi = n - 1;
while (lo < hi) {
int mid = (lo + hi) / 2;
if (A[mid] < target) lo = mid; // BUG:应为 lo = mid + 1
else hi = mid - 1; // BUG:应为 hi = mid
}
// ✅ 正确:标准 lower_bound 模板
int lo = 0, hi = n; // hi = n(而非 n-1),以允许"未找到"的情况
while (lo < hi) {
int mid = (lo + hi) / 2;
if (A[mid] < target) lo = mid + 1; // target 在 [mid+1, hi]
else hi = mid; // target 在 [lo, mid]
}
// lo = hi = 第一个 A[i] >= target 的下标;lo=n 表示未找到
循环边界
// ❌ 常见错误:循环多跑或少跑一次
for (int i = 1; i < n; i++) ... // 若本意是 i=0 到 n-1,则漏了 i=0
for (int i = 0; i <= n-1; i++) ... // 正确但写法混乱;推荐 i < n
// DP 表格填充:注意递推是否访问了 i-1
// ❌ 如果 dp[i] 用到 dp[i-1],而 i 从 0 开始,则 dp[-1] 未定义!
for (int i = 0; i <= n; i++) {
dp[i] = dp[i-1] + ...; // BUG:i=0 时访问 dp[-1]!
}
// ✅ 从 i=1 开始,或单独初始化 dp[0] 作为边界条件
dp[0] = BASE_CASE;
for (int i = 1; i <= n; i++) {
dp[i] = dp[i-1] + ...; // 安全:dp[i-1] 始终有效
}
F.3 未初始化的变量
// ❌ 错误:dp 数组未初始化
int dp[1005][1005]; // 在 C++ 中包含垃圾值!
// dp[i][j] 可能因上一个测试用例或操作系统内存而非零
// ✅ 正确方式:
// 方式一:memset(按字节填充,用 0 或 0x3f 模拟正无穷)
memset(dp, 0, sizeof(dp)); // 全部置 0
memset(dp, 0x3f, sizeof(dp)); // 置为 ~1.06e9(适合用作 int 的"无穷大")
// 方式二:vector 显式初始化
vector<vector<int>> dp(n+1, vector<int>(m+1, 0));
// 方式三:fill
fill(dp, dp + n, 0);
// ⚠️ 警告:memset(dp, -1, sizeof(dp)) 将每个字节置为 0xFF
// 对 int:0xFFFFFFFF = -1(可用于"未访问"标记)
// 对 long long:0xFFFFFFFFFFFFFFFF = -1(同样有效)
// 但 memset(dp, 1, sizeof(dp)) 得到 0x01010101 = 16843009,而不是 1!
全局变量 vs 局部变量
// C++ 中全局数组默认初始化为零
// 局部(栈)数组则不会初始化
int globalArr[100005]; // ✅ 初始化为 0
int globalDP[1005][1005]; // ✅ 初始化为 0
int main() {
int localArr[1000]; // ❌ 未初始化(含垃圾值)
int localDP[100][100]; // ❌ 未初始化
// 建议:将大数组声明为全局变量,既避免栈溢出又保证初始化
}
F.4 栈溢出(递归过深)
// C++ 默认栈大小通常为 1~8 MB
// 递归层数过深会超出限制 → 运行时错误(段错误)
// ❌ 危险:在深度为 10^5 的树上递归 DFS
void dfs(int u) { dfs(children[u]); } // 长链场景下会栈溢出!
// ✅ 解法一:用显式栈改写为迭代
void dfs_iterative(int start) {
stack<int> st;
st.push(start);
while (!st.empty()) {
int u = st.top(); st.pop();
for (int v : children[u]) st.push(v);
}
}
// ✅ 解法二:增大栈大小(平台相关,竞赛评测机通常允许)
// Linux 下编译并运行:ulimit -s unlimited && ./sol
// 经验法则:
// 递归深度 ≤ ~10^4:通常安全
// 递归深度 ~10^5:有风险,考虑迭代
// 递归深度 ~10^6:几乎必定栈溢出 → 必须用迭代
F.5 模运算 Bug
// 当题目要求输出 mod 10^9+7 时:
const int MOD = 1e9 + 7;
// ❌ 错误:忘记取模,long long 溢出
long long dp = 1;
for (int i = 0; i < n; i++) dp *= A[i]; // ~18 次大数乘法后溢出!
// ❌ 错误:减法下溢(结果为负的模)
long long ans = (a - b) % MOD; // a < b 时,C++ 返回负数!
// ✅ 正确:减法取模前加上 MOD
long long ans = ((a - b) % MOD + MOD) % MOD; // 保证非负
// ❌ 错误:DP 中忘记对中间值取模
dp[i][j] = dp[i-1][j] + dp[i][j-1]; // 迭代次数多时可能溢出
// ✅ 正确:每次加法后立即取模
dp[i][j] = (dp[i-1][j] + dp[i][j-1]) % MOD;
// ✅ 正确的模意义快速幂:
long long modpow(long long base, long long exp, long long mod) {
long long result = 1;
base %= mod;
while (exp > 0) {
if (exp & 1) result = result * base % mod; // ← 每次乘法后取模!
base = base * base % mod;
exp >>= 1;
}
return result;
}
F.6 图/BFS/DFS Bug
// ❌ BFS:忘记在入队之前标记已访问
// 这会导致同一节点被处理多次!
queue<int> q;
q.push(src);
while (!q.empty()) {
int u = q.front(); q.pop();
visited[u] = true; // ❌ 出队后才标记 → 同一节点可能多次入队
for (int v : adj[u]) if (!visited[v]) q.push(v);
}
// ✅ 正确:入队时立即标记已访问
visited[src] = true;
queue<int> q;
q.push(src);
while (!q.empty()) {
int u = q.front(); q.pop();
for (int v : adj[u]) {
if (!visited[v]) {
visited[v] = true; // ✅ 入队前标记
q.push(v);
}
}
}
// ❌ DFS:多个测试用例之间忘记重置 visited
// 多测问题中,每次测试用例开始前必须重新初始化 visited[]!
memset(visited, false, sizeof(visited));
// ❌ Dijkstra:距离数组用 int 而非 long long
int dist[MAXN]; // ❌ 边权最大 10^9 时,累加后溢出!
long long dist[MAXN]; // ✅
F.7 I/O Bug
// ❌ 错误:大量输入时未加 ios_base::sync_with_stdio(false)
// 不加此行,cin/cout 与 C 标准 I/O 同步 → 速度极慢!
// N = 10^6 的输入量下,可能是 AC 与 TLE 的差距。
// ✅ 每道竞赛题的 main() 开头都应加上:
ios_base::sync_with_stdio(false);
cin.tie(NULL);
// ❌ 错误:使用 endl(每行都刷新缓冲区 → 很慢)
for (int i = 0; i < n; i++) cout << ans[i] << endl; // 慢!
// ✅ 正确:用 "\n" 代替
for (int i = 0; i < n; i++) cout << ans[i] << "\n"; // 快
// ❌ 错误:关闭同步后混用 cin 与 scanf/printf
ios_base::sync_with_stdio(false);
scanf("%d", &n); // BUG:解除同步后混用 C 和 C++ I/O!
// ✅ 正确:选一种方式并坚持使用
// 要么只用 cin/cout,要么只用 scanf/printf
// USACO 文件 I/O(有时题目要求):
freopen("problem.in", "r", stdin);
freopen("problem.out", "w", stdout);
// 加上这两行后,cin/cout 会自动读写文件
F.8 二维数组越界与方向
// 网格 BFS:边界检查差一错误
int dx[] = {0, 0, 1, -1};
int dy[] = {1, -1, 0, 0};
// ❌ 错误(实际上下面这种写法是正确的——只是确保四个条件都写到)
for (int d = 0; d < 4; d++) {
int nx = x + dx[d], ny = y + dy[d];
if (nx >= 0 && ny >= 0 && nx < n && ny < m) // ✅ 这个边界检查是正确的!
// 确保四个条件都写全
}
// ❌ 错误:弄混行列(转置了行和列)
// 若网格是 N 行 × M 列:
// A[row][col]:row 取值 0..N-1,col 取值 0..M-1
// 边界条件:row < N,col < M(不能写成 row < M!)
// ❌ 错误:多源 BFS 计算距离时,同一格子被多次访问(忘记距离检查)
if (!visited[nx][ny]) { // ✅ 只访问未访问的格子
visited[nx][ny] = true;
dist[nx][ny] = dist[x][y] + 1;
q.push({nx, ny});
}
F.9 DP 专项 Bug
// ❌ 错误:0/1 背包内层循环方向错了
// 必须从高到低遍历容量,防止物品被重复使用!
for (int i = 0; i < n; i++) {
for (int j = W; j >= weight[i]; j--) { // ✅ 从高到低
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);
}
}
// 若从低到高遍历:
for (int j = weight[i]; j <= W; j++) { // ❌ 从低到高 = 完全背包!
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);
}
// ❌ 错误:LIS 二分查找时混淆 upper_bound 与 lower_bound
// 严格递增 LIS:用 lower_bound(找第一个 >= x 的位置,替换)
// 非严格递减 LIS:用 upper_bound(找第一个 > x 的位置,替换)
auto it = lower_bound(tails.begin(), tails.end(), x); // 严格递增
auto it = upper_bound(tails.begin(), tails.end(), x); // 非严格递减
// ❌ 错误:忘记初始化边界条件
// dp[0] 或 dp[i][0] 或 dp[0][j] 必须在主循环之前显式赋值
dp[0][0] = 0; // 始终初始化边界条件!
F.10 内存超限(MLE)
// 常见的 MLE 原因:
// ❌ 数组过大
int dp[10005][10005]; // = 10^8 个 int = 400MB → 超出典型的 256MB 限制!
// 计算方式:N × M × sizeof(类型) 字节
// int:4 字节,long long:8 字节
// 256MB = 256 × 10^6 字节
// int 数组最多约 6400 万个元素
// long long 数组最多约 3200 万个元素
// ✅ 一维 DP 的空间优化:
// 若 dp[i] 只依赖 dp[i-1],使用滚动数组:
vector<long long> dp(2, 0); // dp[cur] 和 dp[prev]
for (int i = 0; i < n; i++) {
dp[1 - cur] = f(dp[cur]); // 在 0 和 1 之间交替
cur = 1 - cur;
}
// ✅ 二维 DP 的空间优化(背包类):
// 若 dp[i][j] 只依赖 dp[i-1][...],只保留两行
vector<int> prev_row(W+1, 0), curr_row(W+1, 0);
F.11 对拍——随机数据 + 暴力验证
💡 为什么需要它? 看完 F.1–F.10,你会发现 Bug 往往不在你手算的样例上出现,而藏在你想不到的边界数据里。与其盯着代码发呆,不如让机器替你造数据、跑程序、比答案——这就是对拍(stress testing)。这是竞赛选手从「能过样例」到「能过所有数据」最重要的工具。
对拍三件套
对拍由三个程序加一个循环脚本组成:
| 组件 | 作用 | 要求 |
|---|---|---|
随机数据生成器 gen | 生成符合题目范围的随机输入 | 必须能覆盖边界(n=1、全相等、极限值……) |
暴力程序 brute | 慢但显然正确的解法 | O(n²)、O(n³) 都行,正确性优先 |
正式程序 main | 你的正解 | 被检验的对象 |
循环脚本不断执行:生成数据 → 两个程序各跑一遍 → 比较输出。一旦不一致,就找到了一组「杀人数据」——把它保存下来,用 cerr 打印中间值调试(见 F 章末尾的专业建议)。
随机数据生成器
生成器的唯一原则:和题目输入格式完全一致,且能随机到边界。推荐用 mt19937 + 时间种子(比老的 rand() 周期更长、分布更均匀)。
生成器 1:随机树(第 5.5 章树题对拍必备。技巧:节点 i 的父亲在 [1, i-1] 中随机,天然保证无环)
// gen_tree.cpp —— 随机树:节点 1..n,第 i 个节点的父亲在 [1, i-1] 中均匀随机
#include <bits/stdc++.h>
#include <random>
using namespace std;
int main(int argc, char* argv[]) {
// 时间种子:每次运行产生不同数据
mt19937 rng(chrono::steady_clock::now().time_since_epoch().count());
if (argc > 1) rng.seed(stoi(argv[1])); // 可选:固定种子,复现某组数据
int n = 1 + rng() % 200000; // 1 <= n <= 2*10^5(按题目范围改)
cout << n << "\n";
for (int i = 2; i <= n; i++) {
int parent = 1 + rng() % (i - 1); // 父亲编号 < i,保证无环
cout << parent << " " << i << "\n";
}
return 0;
}
生成器 2:随机区间(区间 DP、差分约束、线段树题常用)
// gen_interval.cpp —— n 个随机区间 [l, r]
#include <bits/stdc++.h>
#include <random>
using namespace std;
int main() {
mt19937 rng(chrono::steady_clock::now().time_since_epoch().count());
int LIMIT = 1000000;
int n = 1 + rng() % 100000;
cout << n << "\n";
for (int i = 0; i < n; i++) {
long long l = 1 + (long long)(rng() % LIMIT);
long long r = l + rng() % 100; // 保证 l <= r
cout << l << " " << r << "\n";
}
return 0;
}
生成器 3:随机排列(注意:对 1..n 循环「随机交换」不是均匀分布,用 shuffle 才是)
// gen_perm.cpp —— 1..n 的均匀随机排列
#include <bits/stdc++.h>
#include <random>
using namespace std;
int main() {
mt19937 rng(chrono::steady_clock::now().time_since_epoch().count());
int n = 1 + rng() % 200000;
vector<int> a(n);
iota(a.begin(), a.end(), 1);
shuffle(a.begin(), a.end(), rng); // 均匀随机排列 ✅
cout << n << "\n";
for (int i = 0; i < n; i++)
cout << a[i] << " \n"[i == n - 1];
return 0;
}
对拍脚本
macOS / Linux(bash):
#!/bin/bash
# stress.sh —— 用法:chmod +x stress.sh && ./stress.sh
g++ -O2 -std=c++17 gen.cpp -o gen
g++ -O2 -std=c++17 brute.cpp -o brute
g++ -O2 -std=c++17 main.cpp -o main
i=1
while true; do
./gen > in.txt # 1. 生成随机数据
./brute < in.txt > out_brute.txt # 2. 跑暴力
./main < in.txt > out_main.txt # 3. 跑正解
if diff -q out_brute.txt out_main.txt > /dev/null; then
echo "Test $i: OK"
else
echo "Test $i: MISMATCH! 数据已存入 in.txt"
break # ⚠️ 必须停!否则杀人数据被下一轮覆盖
fi
i=$((i + 1))
done
Windows(记事本另存为 stress.bat,ANSI/GBK 编码,双击运行):
@echo off
g++ -O2 -std=c++17 gen.cpp -o gen.exe
g++ -O2 -std=c++17 brute.cpp -o brute.exe
g++ -O2 -std=c++17 main.cpp -o main.exe
:loop
gen.exe > in.txt
brute.exe < in.txt > out1.txt
main.exe < in.txt > out2.txt
fc out1.txt out2.txt > nul
if errorlevel 1 (
echo MISMATCH! 数据已存入 in.txt
pause
goto :end
)
goto :loop
:end
⚠️ 对拍的五大常见错误
- 种子没随机。 用了
mt19937 rng(42)这种固定种子——每次对拍跑的都是同一组数据,跑一万遍等于跑一遍。用chrono::steady_clock::now().time_since_epoch().count()做种子;反过来,发现杀人数据后记得用固定种子复现它(见 gen_tree 的argv[1]参数)。 - 数据范围没对齐题目边界。 题目说
1 ≤ n ≤ 10⁵,生成器却只造小 n;或者忘了生成n=1、全部元素相等、极大值10⁹、负数、空图这类边界。对拍的价值恰恰在边界——每类边界至少固定造一组,再随机。 diff发现不同后忘了break。 脚本继续循环,in.txt被下一轮覆盖,杀人数据丢了,白拍。bash 版用break,bat 版goto :end。- Windows 换行符(CRLF)。 在 Windows 上用旧编辑器写的文件换行是
\r\n,两个程序输出一个带\r一个不带,diff/fc误报不一致。建议输出统一用"\n";跨平台比较时用diff --strip-trailing-cr。 - 暴力程序本身写错。 暴力错了,对拍只会把正确程序「冤枉」到怀疑人生。暴力要写得越笨越好——直接枚举、不加任何优化,简单到不需要验证;若两个程序都能对上小样例,可信度就足够了。
什么时候对拍?
- 写完暴力但不确定正解时:先交暴力保底,同时开拍验证正解——这是性价比最高的时机。
- 提交前 5 分钟:交卷前跑几百组小数据,比多检查一遍代码的收益高得多。经验法则:AC 之前永远值得再拍 100 组。
💡 一句话总结: gen 造数据、brute 保正确、main 待检验,脚本循环 diff 直到找到杀人数据——把「我看起来没错」变成「机器证明我没错」。
快速诊断清单
拿到 WA/RE/TLE 时,按这个清单逐项检查:
Wrong Answer(WA):
-
整数溢出?(增加
long long强制转换或更换类型) - 数组边界、循环边界、区间和公式差一?
-
数组未初始化?(添加
memset或用带初始化的vector) - DP 递推方向错误?(0/1 背包:必须从高到低)
-
二分查找模板错误?(在
[1,2,3]中搜索2验证一下) - 边界情况:空输入、N=0、N=1、全部相等的元素?
Runtime Error(RE):
-
数组越界?(添加边界检查或改用
vector) - 递归过深导致栈溢出?(改写为迭代)
- 空指针/无效指针解引用?
- 除以零?
Time Limit Exceeded(TLE):
-
缺少
ios_base::sync_with_stdio(false); cin.tie(NULL);? - N=10⁵ 时用了 O(N²) 算法,应该用 O(N log N)?
- DP 中重复计算?(需要记忆化)
- BFS 中同一节点被多次访问?(入队前标记已访问)
Memory Limit Exceeded(MLE):
- 二维数组过大?(计算 N × M × sizeof 字节数)
- 递归 DFS 的隐式调用栈过深?
- 在循环中动态分配内存?
💡 专业建议: 打印中间值!
cerr << "DEBUG: dp[3] = " << dp[3] << "\n";cerr输出到标准错误流(而非标准输出),不会影响竞赛评测机上的输出。提交前记得删除所有cerr调试行。
竞赛编程术语词汇表
本词汇表定义了贯穿全书及竞赛编程领域常用的 35+ 个核心术语。遇到不熟悉的术语时,请先在这里查阅。
A
算法(Algorithm) 解决问题的分步骤过程。算法必须:正确(给出正确答案)、有限(最终终止)、确定(每步无歧义)。示例:二分查找、BFS、归并排序。
邻接表(Adjacency List) 图的一种表示方式:每个顶点存储其邻居列表。空间:O(V + E)。竞赛编程中的标准表示方式。
邻接矩阵(Adjacency Matrix)
二维数组,matrix[u][v] = 1 表示 u 到 v 有边。空间:O(V²)。仅在 V ≤ 1000 的稠密图中使用。
摊还时间(Amortized Time)
一系列操作的每次操作平均时间。示例:vector::push_back 的摊还时间为 O(1),即使偶尔的扩容需要 O(N)。
B
边界条件(Base Case)
递归和 DP 中,具有已知答案的最简子问题(无需进一步递归)。示例:fib(0) = 0,fib(1) = 1。
BFS(广度优先搜索,Breadth-First Search) 逐层探索节点的图遍历(先遍历所有距离为 1 的节点,再遍历距离为 2 的节点……)。使用队列。在无权图中保证最短路径。时间复杂度:O(V + E)。
大 O 表示法(Big-O Notation) 描述算法时间或空间增长上界的数学表示。"O(N log N)"表示"对某常数 c,操作次数至多为 c × N × log(N)"。用于比较算法效率。
二分查找(Binary Search) 有序数组上的 O(log N) 搜索算法。每步与中点比较,将候选范围减半。最重要的应用:"对答案二分"用于优化问题。
暴力枚举(Brute Force) 尝试所有可能情况的朴素解法。通常为 O(N²) 或 O(2^N)。正确但对大规模输入太慢。用途:部分得分、验证优化解、小测试用例。
C
比较器(Comparator)
定义排序顺序的函数。接收两个元素,若第一个应排在第二个前面则返回 true。与 std::sort 配合使用。
算法竞赛(Competitive Programming) 在时间限制内解决算法问题的编程竞赛。USACO、Codeforces、LeetCode 和 IOI 是热门平台。
连通分量(Connected Component) 任意两顶点之间都有路径相连的极大子图。可用 DFS/BFS 或并查集找连通分量。
坐标压缩(Coordinate Compression) 将大范围的值(如最大 10^9)映射为小的连续下标(0, 1, 2, ...)而不改变相对顺序。使得可以用数组代替哈希表。
D
DAG(有向无环图,Directed Acyclic Graph) 没有环的有向图。关键性质:存在拓扑排序。示例:依赖关系图、任务调度。
DFS(深度优先搜索,Depth-First Search) 在回溯前尽可能深地探索的图遍历。使用栈(或递归)。适用于:连通性判断、环检测、拓扑排序。时间复杂度:O(V + E)。
差分数组(Difference Array) O(1) 区间更新的技术。存储相邻元素之差;区间加 [L,R] 变为 diff[L]++ 和 diff[R+1]--。用前缀和还原原数组。
DP(动态规划,Dynamic Programming) 通过将问题分解为有重叠的子问题并缓存结果来优化求解的技术。需要两个性质:最优子结构 + 重叠子问题。另见:记忆化、递推。
DSU(并查集,Disjoint Set Union) 见"并查集(Union-Find)"。
E
边(Edge) 图中两顶点之间的连接。可以是有向的(单向)或无向的(双向),可以有权重。
交换论证(Exchange Argument) 贪心算法的证明技术。证明将贪心选择与其他选择交换后,解不会变得更差。
F
快慢指针(Fast and Slow Pointers) 双指针的第三种模式:两指针同向移动但速度不同(慢指针每次 1 步,快指针每次 2 步)。经典应用:链表中点、链表环检测、删除倒数第 K 个节点。时间复杂度:O(N),空间 O(1)。另见"Floyd 判圈法"。
洪水填充(Flood Fill) 一种算法(通常用 DFS 或 BFS),标记网格中所有相同"颜色"的连通格子。用于统计连通区域数。
Floyd 判圈法(Floyd's Cycle Detection) 用快慢指针检测序列或链表是否存在环的方法。快指针速度是慢指针的两倍,有环则必在环内相遇。相遇后将一指针放回起点、两指针同速前进,再次相遇点即环入口。也可用于函数迭代求周期(空间 O(1))。
G
图(Graph) 由顶点(节点)和边(连接)组成的数据结构。建模关系、网络、地图等。
贪心算法(Greedy Algorithm) 在每步做出局部最优选择,期望得到全局最优结果的算法。当"贪心选择性质"成立时有效。示例:活动选择、哈夫曼编码、Kruskal MST。
H
哈希表(Hash Map / unordered_map) 以 O(1) 平均时间存储和查找键值对的数据结构。用哈希表实现。没有顺序保证。当需要快速查找但不需要有序键时使用。
I
区间 DP(Interval DP) 以子数组 [l, r] 为状态,尝试所有分割点的 DP 模式。经典示例:矩阵链乘法、回文划分。时间复杂度:O(N³)。
K
背包问题(Knapsack Problem) DP 问题:给定有重量和价值的物品,在重量限制内最大化价值。"0/1 背包"指每件物品最多使用一次,"完全背包"指可以无限使用。
L
LIS(最长递增子序列,Longest Increasing Subsequence) 数组中每个元素都严格大于前一个元素的最长子序列。O(N²) DP 或带二分查找的 O(N log N)。
LCA(最近公共祖先,Lowest Common Ancestor) 有根树中同时是 u 和 v 的祖先的最深节点。朴素做法:每次查询 O(深度)。倍增:O(log N)。
M
记忆化(Memoization) 缓存递归函数调用结果以避免重复计算。"自顶向下 DP"。备忘录表存储已计算的值;计算前先检查答案是否已知。
MST(最小生成树,Minimum Spanning Tree) 带权图中总边权最小的生成树。Kruskal 算法:排序边 + 并查集。Prim 算法:优先队列 + 已访问集合。两者都是 O(E log E)。
单调(Monotone / Monotonic) 持续递增或递减。函数单调意味着方向从不反转。对答案二分的关键:可行性函数必须是单调的。
O
差一错误(Off-By-One Error)
下标或计数恰好差 1 的 Bug。在循环(< n vs <= n)、二分查找、前缀和(P[L-1] vs P[L])中非常常见。
最优子结构(Optimal Substructure) 一种性质:问题的最优解可以由其子问题的最优解构建。DP 正常工作的必要条件。
溢出(Overflow)
值超过类型所能表示的最大值。int 最大值约为 2×10^9;long long 最大值约为 9.2×10^18。两个 10^9 的 int 相乘会溢出 int——先强制转换为 long long。
P
前缀和(Prefix Sum)
P[i] = 从下标 0(或 1)到 i 所有元素之和的数组。支持 O(1) 区间查询:sum(L,R) = P[R] - P[L-1]。
R
递推关系(Recurrence Relation)
将 DP 值表示为更小 DP 值的公式。示例:fib(n) = fib(n-1) + fib(n-2)。定义了 DP 的状态转移。
S
线段树(Segment Tree) 支持 O(log N) 区间查询和更新的数据结构。比前缀和更强大(支持更新)。Gold/Platinum 级别话题。
稀疏图(Sparse Graph) 边数相对于 V² 较少的图。实践中:E = O(V)。使用邻接表。
状态(DP State)
唯一标识 DP 子问题的信息集合。背包中的示例:(物品下标, 剩余容量)。选择合适的状态是 DP 的核心技能。
子树(Subtree) 树中某节点的所有后代节点(含该节点本身)。树形 DP 通常计算子树上的聚合值。
T
递推(Tabulation) 从边界条件到更大子问题迭代构建 DP 表格。"自底向上 DP"。无递归,无栈溢出风险。
超时(Time Limit Exceeded / TLE) 评测结果之一,表示解法正确但速度太慢。USACO 中大多数题目的时间限制为 2~4 秒。遇到 TLE,优化算法——而不只是优化常数因子。
拓扑排序(Topological Sort) DAG 中顶点的一种排序方式,使得对每条有向边 u→v,u 都排在 v 前面。可用 DFS(逆后序)或 Kahn 算法(基于 BFS)计算。
双指针(Two Pointers) 使用两个下标遍历数组的技术,分三种模式:相向(两端向中间,需有序数组)、同向同速(滑动窗口)、同向不同速(快慢指针,见"快慢指针")。将 O(N²) 的配对搜索转化为 O(N)。核心前提:指针只朝一个方向移动(单调性)。
U
并查集(Union-Find / DSU)
支持两种操作的数据结构:find(x)(x 属于哪个集合?)和 union(x,y)(合并 x 和 y 所在的集合)。带路径压缩 + 按秩合并:每次操作 O(α(N)) ≈ O(1)。用于动态连通性、Kruskal MST、环检测。
V
顶点(Vertex / Node) 图的基本单元。顶点有编号(USACO 中通常从 1 开始)。
W
答案错误(Wrong Answer / WA) 评测结果之一,表示程序运行了但输出了错误结果。检查边界情况、差一错误和整数溢出。