第 4.4 章:进阶贪心与 USACO 真题
普通贪心「选了就不回头」,进阶贪心要么允许后悔(撤销之前的选择)、要么换视角扫描(前后缀、逐位)、要么对抗博弈。本章讲这三个进阶模式,然后用 5 道 USACO Silver 真题把整个第四部分的模型串起来。
📌 前置: [第 4.1–4.3 章] 的基础贪心模型与交换论证。
4.4.1 后悔贪心
后悔贪心是最强大也最容易被忽视的贪心技术。核心思路:
做出贪心决策,但同时保留「撤销」它的能力——如果该决策后来不是最优的,用堆(优先队列)以 O(log N) 时间撤销它。
经典题:K 次操作获得最大利润(支持撤销)
题目: N 个数各有一个收益 x[i](可能为负),从中选数做恰好至多 K 次「操作」;每次操作取一个收益 x,之后可以花 −x 的代价撤销它(等于换成另一个数)。最大化总收益。(1 ≤ N, K ≤ 2×10⁵,|x[i]| ≤ 10⁹,答案用 long long。)
样例输入:
5 3
4 2 10 5 1
(格式:第一行 N 和 K,第二行 N 个收益值)
样例输出:
19
(第一次取 10,撤销后可再取 5:10 + 5 + 4 = 19。撤销机制等价于「允许重复取前 K 大的数」)
贪心 + 后悔做法:
- 维护最大堆
- 每步:取堆顶 x(最大收益),然后插入
-x(「后悔节点」——撤销此操作的代价) - 若之后从堆中取出
-x,相当于「取消」之前的操作
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n, k;
    cin >> n >> k;

    priority_queue<long long> pq;  // 最大堆
    for (int i = 0; i < n; i++) {
        long long x; cin >> x;
        pq.push(x);
    }

    long long total = 0;
    for (int i = 0; i < k; i++) {
        long long top = pq.top(); pq.pop();
        if (top <= 0) break;  // 取该元素会损失——停止
        total += top;
        pq.push(-top);        // 插入后悔节点:撤销此操作的代价
    }

    cout << total << "\n";
    return 0;
}
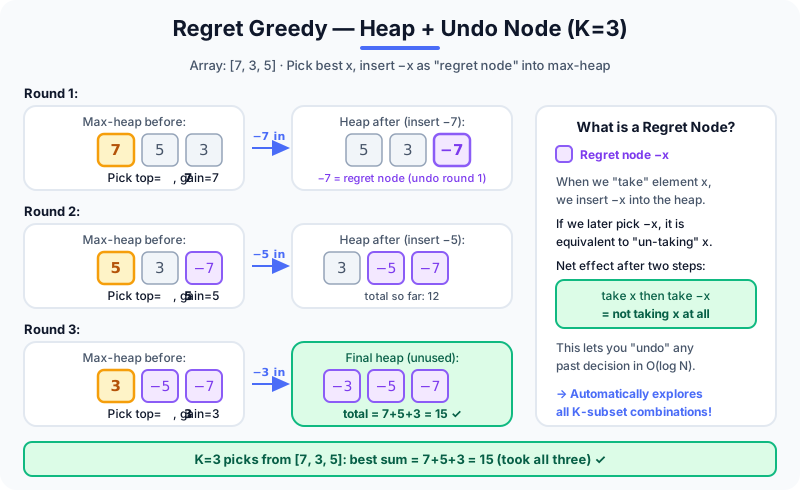
后悔的魔力: 取出 x 并插入 -x 后,若堆顶变为 y,我们可以选择:
- 取 y(正常贪心)
- 取
-x(相当于「取消 x,用下一个可用元素替换」)
这自动找到了 K 次操作的最优序列。
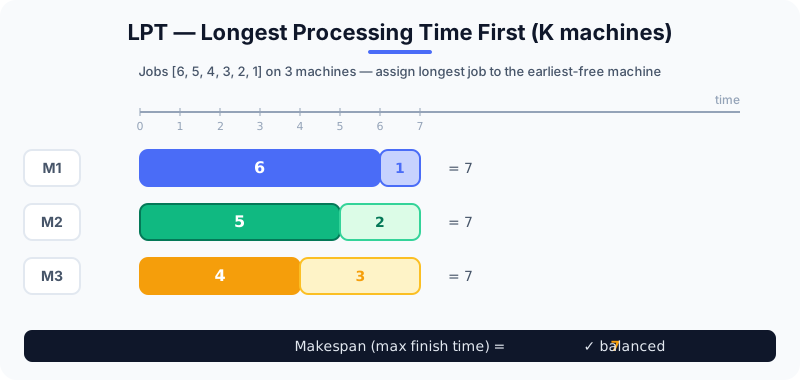
最小化 K 台机器的最大完工时间(LPT)
题目: N 个作业分配到 K 台机器上(每台机器顺序运行分到的作业),目标是让最晚完工的机器尽早完工。求该最小化后的最大完工时间。(1 ≤ N ≤ 2×10⁵,1 ≤ K ≤ N,1 ≤ t[i] ≤ 10⁹。)
样例输入:
6 3
7 2 5 1 9 4
(格式:第一行 N 和 K,第二行 N 个作业时长)
样例输出:
10
(降序排列 9,7,5,4,2,1,依次分给最早空闲的机器:机器 A 得 9,机器 B 得 7,机器 C 得 5+4+1=10——最大完工时间为 10)
贪心:最长处理时间优先(LPT)
按降序排列处理时间,将每个作业分配给完成时间最早的机器(用最小堆维护)。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n, k;
    cin >> n >> k;

    vector<int> t(n);
    for (int &x : t) cin >> x;

    sort(t.begin(), t.end(), greater<int>());  // 降序:最长作业优先

    // 最小堆:存储每台机器的当前完成时间(初始全为 0)
    priority_queue<long long, vector<long long>, greater<long long>> machines;
    for (int i = 0; i < k; i++) machines.push(0);

    for (int i = 0; i < n; i++) {
        long long earliest = machines.top(); machines.pop();
        machines.push(earliest + t[i]);  // 将作业分配给最早空闲的机器
    }

    long long makespan = 0;
    while (!machines.empty()) {
        makespan = max(makespan, machines.top());
        machines.pop();
    }

    cout << makespan << "\n";
    return 0;
}
// 时间复杂度:O(N log N + N log K)
4.4.2 对抗匹配(田忌赛马)
经典的**「田忌赛马」**问题是对抗贪心匹配的原型:双方各有 N 匹马;你可以自由选择出场顺序,对手顺序已知。每场比赛速度更快的一方获胜(相同速度算平局,不计数)。最大化你赢得的比赛数。(1 ≤ N ≤ 2×10⁵,1 ≤ 马的速度 ≤ 10⁹。)
样例输入:
3
1 3 5
2 4 6
(格式:第一行 N,第二行你的马速度,第三行对手的马速度——与下方 adversarial_matching.svg 图中数据一致)
样例输出:
2
(A 最强 5 打不过 B 最强 6,用最弱的 1 消耗 6;随后 3 > 2 赢一场,5 > 4 再赢一场)
策略(双指针,O(N)):
对你的马 A(升序)和对手的马 B(升序)排序:
- 若你最强的马 A[hi] > 对手最强的马 B[bhi] → 用自己最强的打对手最强的(赢一场)
- 若你最强的 A[hi] ≤ 对手最强的 B[bhi] → 用自己最弱的消耗对手最强的(策略性认输,保留更强的马)

#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<int> A(n), B(n);
    for (int &x : A) cin >> x;
    for (int &x : B) cin >> x;

    sort(A.begin(), A.end());
    sort(B.begin(), B.end());

    int wins = 0;
    int lo = 0, hi = n - 1;    // A 的双端指针(弱端和强端)
    int blo = 0, bhi = n - 1;  // B 的双端指针

    while (lo <= hi) {
        if (A[hi] > B[bhi]) {
            // A 最强打赢 B 最强——赢一场
            wins++;
            hi--;
            bhi--;
        } else {
            // A 最强打不赢 B 最强——用 A 最弱消耗 B 最强
            lo++;
            bhi--;
        }
    }

    cout << wins << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
4.4.3 前缀/后缀贪心与位运算贪心
前缀/后缀贪心
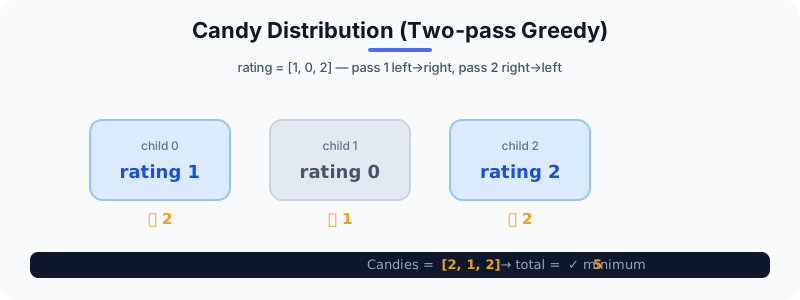
许多问题可以通过**一次从左扫描(前缀)和一次从右扫描(后缀)**来解决,然后合并结果。
经典应用:分发糖果(双遍扫描)
题目: N 个孩子站成一排,各有评分 rating[i]。要求:① 每个孩子至少分到 1 颗糖;② 评分比相邻孩子高的孩子必须分到更多糖。求最少需要的总糖数。(1 ≤ N ≤ 2×10⁵,0 ≤ rating[i] ≤ 2×10⁴;结果用 long long。)
样例输入:
5
1 3 2 2 1
样例输出:
7
(糖数为 [1,2,1,1,1]:评分 3 比左右邻居都高,得 2 颗,其余各 1 颗)
#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;
    vector<int> rating(n);
    for (int &x : rating) cin >> x;

    vector<int> candy(n, 1);  // 每人至少 1 颗糖

    // 第一遍:满足「比左邻居评分高则多拿」
    for (int i = 1; i < n; i++) {
        if (rating[i] > rating[i - 1])
            candy[i] = candy[i - 1] + 1;
    }

    // 第二遍:满足「比右邻居评分高则多拿」
    for (int i = n - 2; i >= 0; i--) {
        if (rating[i] > rating[i + 1])
            candy[i] = max(candy[i], candy[i + 1] + 1);
    }

    cout << accumulate(candy.begin(), candy.end(), 0) << "\n";
    return 0;
}
// 时间复杂度:O(N)
位运算贪心
经典题:最大化数组中两个元素的异或值
题目: 给定 N 个非负整数,选出其中两个数(不同位置),使它们的异或值最大。(1 ≤ N ≤ 2×10⁵,0 ≤ a[i] < 2³¹。O(N²) 两两枚举会超时,需要字典树。)
样例输入:
3
3 10 5
样例输出:
15
(10 XOR 5 = 1010₂ XOR 0101₂ = 1111₂ = 15;从高位到低位,字典树每层都走到了使 XOR 位为 1 的分支)
贪心(字典树): 将所有数字插入二进制字典树。对每个数字 x,在字典树中每层贪心地走「对立」分支(从高位到低位),逐位最大化 XOR 值。
#include <bits/stdc++.h>
using namespace std;

const int MAXBIT = 30;

struct Trie {
    int ch[2];
    Trie() { ch[0] = ch[1] = -1; }
};

vector<Trie> trie(1);

void insert(int x) {
    int node = 0;
    for (int i = MAXBIT; i >= 0; i--) {
        int bit = (x >> i) & 1;
        if (trie[node].ch[bit] == -1) {
            trie[node].ch[bit] = trie.size();
            trie.push_back(Trie());
        }
        node = trie[node].ch[bit];
    }
}

int maxXOR(int x) {
    int node = 0, res = 0;
    for (int i = MAXBIT; i >= 0; i--) {
        int bit = (x >> i) & 1;
        int want = 1 - bit;  // 贪心:尝试对立位使 XOR = 1
        if (trie[node].ch[want] != -1) {
            res |= (1 << i);
            node = trie[node].ch[want];
        } else {
            node = trie[node].ch[bit];
        }
    }
    return res;
}

int main() {
    int n;
    cin >> n;
    vector<int> nums(n);
    for (int &x : nums) cin >> x;

    for (int x : nums) insert(x);

    int ans = 0;
    for (int x : nums) ans = max(ans, maxXOR(x));

    cout << ans << "\n";
    return 0;
}
// 时间复杂度:O(N × MAXBIT) = O(32N)
💡 通用位运算贪心模式: 从高位到低位处理。在每一位,贪心地选择使结果该位等于 1(或 0,取决于目标)的分支。字典树支持每次查询 O(MAXBIT) 时间。
4.4.4 USACO 真题训练:从题面识别贪心
本节把前面的贪心模式放进真实 USACO 题目中。做真题时不要先问「这是不是贪心」,而要先问:
- 排序依据是什么? 题目是否给了时间、价格、产量、资历、结束点等天然优先级?
- 局部选择是否安全? 当前最优选择会不会破坏未来更优选择?
- 如果局部选择错了,能否后悔? 若需要撤销,通常要用堆维护「后悔节点」。
真题 1:Convention II(USACO 2018 December Silver)— 排队中的「资历优先」
题目链接: USACO 2018 December Silver P2: Convention II
对应模式: 排序 + 优先队列贪心
难度定位: Silver 中等
题干解读
有 N 头奶牛,每头奶牛有:
- 到达时间
arrival - 吃草所需时间
duration - 资历
seniority:输入越早,资历越高
同一时刻只有一头奶牛能吃草。如果草地空闲且有奶牛等待,就选择资历最高的等待奶牛。要求输出所有奶牛中的最大等待时间。
数据规模(USACO 官方): 1 ≤ N ≤ 10⁵,1 ≤ arrival ≤ 10⁶,1 ≤ duration ≤ 10⁴。时间总和可能很大,用 long long。
样例输入(USACO 官方):
5
25 3
105 30
20 12
6 5
70 7
(格式:第一行 N,随后每行 arrival duration,输入顺序即资历顺序)
样例输出:
7
(时间线:奶牛 4 在 6 到达即开吃(等待 0),吃到 11;奶牛 3 在 20 到达开吃(等待 0),吃到 32;奶牛 1 在 25 到达,等 32−25=7;……最大等待来自奶牛 1 的 7)
关键点是:
- 到达顺序由
arrival决定,所以要先按到达时间排序。 - 等待队列中的选择由
seniority决定,所以要用优先队列按输入编号最小者优先。 - 当前没有等待奶牛时,时间要直接跳到下一头奶牛的到达时间,不能一秒一秒模拟。
思路分析
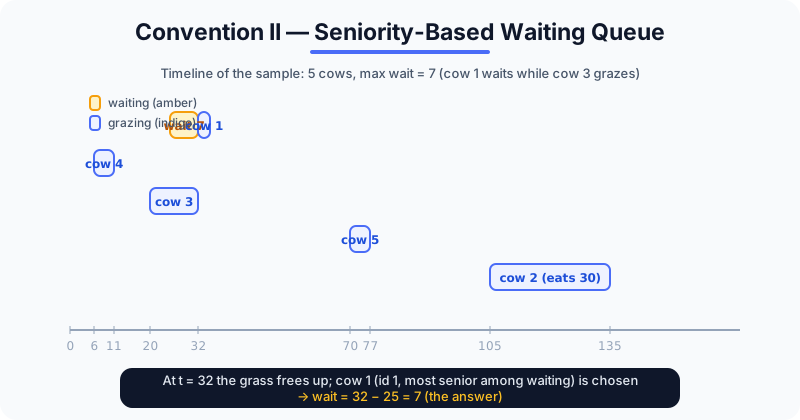
思路分析
这不是普通的「先来先服务」。如果多头奶牛都已经到达,USACO 规则要求资历最高者先吃草。因此需要两个顺序:
| 事件 | 依据 | 数据结构 |
|---|---|---|
| 下一头奶牛何时进入等待队列 | 到达时间升序 | 排序数组 |
| 当前从等待队列选谁吃草 | 输入编号升序 | 最小堆 |
贪心的安全性来自题目规则本身:当草地空闲时,所有已经到达的奶牛中,资历最高者必须被选择;其他选择都会违反规则。我们只需要高效模拟这个规则。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;

struct Cow {
    long long arrive;
    long long eat;
    int id;  // 输入顺序,id 越小资历越高
};

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    // USACO 官方文件 I/O 可按需打开:
    // freopen("convention2.in", "r", stdin);
    // freopen("convention2.out", "w", stdout);

    int n;
    cin >> n;
    vector<Cow> cows(n);
    for (int i = 0; i < n; i++) {
        cin >> cows[i].arrive >> cows[i].eat;
        cows[i].id = i;
    }

    sort(cows.begin(), cows.end(), [](const Cow& a, const Cow& b) {
        if (a.arrive != b.arrive) return a.arrive < b.arrive;
        return a.id < b.id;
    });

    // 等待队列:资历最高者优先,也就是 id 最小者优先
    priority_queue<pair<int, int>, vector<pair<int, int>>, greater<pair<int, int>>> waiting;

    long long currentTime = 0;
    long long maxWait = 0;
    int nextCow = 0;

    while (nextCow < n || !waiting.empty()) {
        // 如果没人等待,时间直接跳到下一头奶牛到达时刻
        if (waiting.empty() && currentTime < cows[nextCow].arrive) {
            currentTime = cows[nextCow].arrive;
        }

        // 把所有已经到达的奶牛加入等待队列
        while (nextCow < n && cows[nextCow].arrive <= currentTime) {
            waiting.push({cows[nextCow].id, nextCow});
            nextCow++;
        }

        auto [id, idx] = waiting.top();
        waiting.pop();

        maxWait = max(maxWait, currentTime - cows[idx].arrive);
        currentTime += cows[idx].eat;
    }

    cout << maxWait << "\n";
    return 0;
}
复杂度: 排序 O(N log N),每头奶牛进出堆一次,总复杂度 O(N log N),空间 O(N)。
易错点提醒
- 把等待队列按到达时间排序。 到达时间只决定「能否进入队列」,进入后选择谁取决于资历。
- 忘记时间跳跃。 如果当前没有等待奶牛,应令
currentTime = next arrival,否则会错误地处理空闲时间。 - 等待时间计算位置错。 奶牛开始吃草前计算
currentTime - arrive;吃完后再算会多加自己的吃草时间。 - 使用
int存时间。 到达时间与吃草时间相加可能较大,建议用long long。
拓展思考
如果规则改成「等待时间最长者优先」,优先队列的键就会变为等待时长;但等待时长随时间变化,堆中键会动态改变,模拟会更复杂。这类题常提示你:优先级必须是静态或可懒更新的,才能直接用堆贪心。
真题 2:Rental Service(USACO 2018 January Silver)— 「高产牛卖奶,低产牛出租」
题目链接: USACO 2018 January Silver P2: Rental Service
对应模式: 排序 + 前缀收益 + 枚举分界点
难度定位: Silver 进阶
题干解读
有 N 头奶牛,每头每天产若干加仑牛奶。每头牛只能做一件事:
- 卖牛奶给商店:商店有购买上限和单价。
- 出租整头牛:邻居给定固定租金。
目标是最大化总收入。
数据规模(USACO 官方): 1 ≤ N ≤ 10⁵(奶牛数),1 ≤ M ≤ 10⁵(商店数),1 ≤ R ≤ 10⁵(租客数);每头牛产量 1 ≤ c_i ≤ 10⁹;每个商店 1 ≤ 数量 ≤ 10⁹ 加仑、1 ≤ 单价 ≤ 1000;每个租金 1 ≤ r_i ≤ 10⁹。
样例输入(USACO 官方):
5 3 4
4 6 2 1 8
4 10
3 5
2 3
15 10 8 2
(格式:第一行 N M R;第二行 N 头牛的产量;随后 M 行每行「数量 单价」;最后一行 R 个租金)
样例输出:
94
(产量降序 8,6,4,2,1。最优分界:前 2 头高产牛卖奶,后 3 头低产牛出租。牛 8 卖给商店:4 加仑@10=40、3 加仑@5=15、1 加仑@3=3,共 58;牛 6 只能再卖 1 加仑@3=3。卖奶共 61。出租牛 4、2、1 得 15+10+8=33。总收益 61+33=94)
题目隐藏的关键结构是:高产牛更适合卖奶,低产牛更适合出租。我们不需要枚举每头牛的所有选择,只要枚举「前 k 头高产牛卖奶,其余低产牛出租」。
思路分析
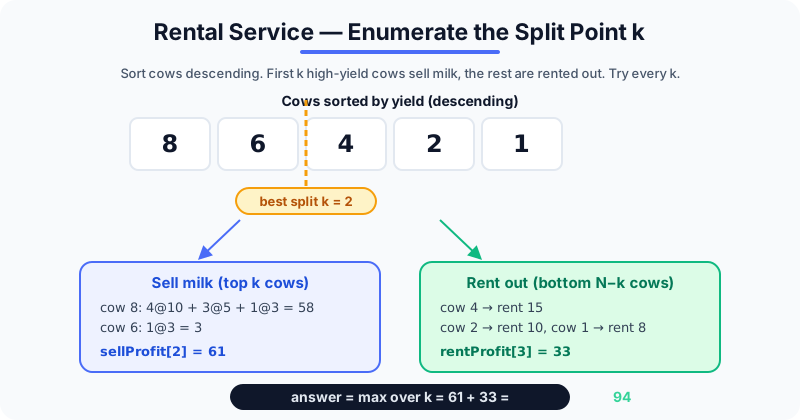
思路分析
先排序:
- 奶牛产量降序:高产牛排前面。
- 商店价格降序:先卖给单价最高的商店。
- 租金降序:低产牛若出租,也优先拿最高租金。
然后预处理两个数组:
| 数组 | 含义 |
|---|---|
sellProfit[k] | 前 k 头高产牛全部卖奶的最大收入 |
rentProfit[x] | 后 x 头低产牛全部出租的最大收入 |
最后枚举 k:卖奶 k 头,出租 N-k 头,答案是 max(sellProfit[k] + rentProfit[N-k])。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;

using ll = long long;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    // USACO 官方文件 I/O 可按需打开:
    // freopen("rental.in", "r", stdin);
    // freopen("rental.out", "w", stdout);

    int n, m, r;
    cin >> n >> m >> r;

    vector<ll> cows(n);
    for (ll &x : cows) cin >> x;

    vector<pair<ll, ll>> stores(m);  // {价格, 数量}
    for (int i = 0; i < m; i++) {
        ll quantity, price;
        cin >> quantity >> price;
        stores[i] = {price, quantity};
    }

    vector<ll> rent(r);
    for (ll &x : rent) cin >> x;

    sort(cows.rbegin(), cows.rend());      // 高产牛优先卖奶
    sort(stores.rbegin(), stores.rend());  // 高价商店优先购买
    sort(rent.rbegin(), rent.rend());      // 高租金优先出租

    vector<ll> sellProfit(n + 1, 0);
    int shop = 0;
    ll remaining = (m > 0 ? stores[0].second : 0);

    for (int i = 1; i <= n; i++) {
        sellProfit[i] = sellProfit[i - 1];
        ll milk = cows[i - 1];

        while (milk > 0 && shop < m) {
            ll take = min(milk, remaining);
            sellProfit[i] += take * stores[shop].first;
            milk -= take;
            remaining -= take;

            if (remaining == 0) {
                shop++;
                if (shop < m) remaining = stores[shop].second;
            }
        }
    }

    vector<ll> rentProfit(n + 1, 0);
    for (int x = 1; x <= n; x++) {
        rentProfit[x] = rentProfit[x - 1];
        if (x <= r) rentProfit[x] += rent[x - 1];
    }

    ll answer = 0;
    for (int sellCount = 0; sellCount <= n; sellCount++) {
        int rentCount = n - sellCount;
        answer = max(answer, sellProfit[sellCount] + rentProfit[rentCount]);
    }

    cout << answer << "\n";
    return 0;
}
复杂度: 排序 O((N+M+R) log(N+M+R)),预处理和枚举 O(N+M),空间 O(N)。
易错点提醒
- 商店输入顺序是数量再价格。 代码中转成
{price, quantity}是为了按价格降序排序。 - 出租的是低产牛。 若把高产牛出租、低产牛卖奶,会破坏贪心结构。
- 收益必须用
long long。N、产量、价格都可能很大,int会溢出。 - 枚举分界点时不要超过租客数量。
rentProfit[x]中超过R的部分收益为 0。
拓展思考
这道题的本质是「排序后枚举分界点」。如果题目要求每头牛还带有不同的出租限制,简单分界点就不再成立,可能需要 DP 或最小费用流。看到 Silver 题中同时出现「排序 + 两种收益方式」时,优先尝试这种前缀收益模型。
真题 3:Rest Stops(USACO 2018 February Silver)— 从右往左选「未来最高价值」
题目链接: USACO 2018 February Silver P1: Rest Stops
对应模式: 后缀最大值 + 贪心选择
难度定位: Silver 中等
题干解读
FJ 和 Bessie 沿一条长度为 L 的路前进。Bessie 走得慢一些,但可以在休息站吃草获得快乐值。每个休息站有位置 x 和美味值 c。FJ 不停走,Bessie 可以停留吃草,问最大快乐值。
数据规模(USACO 官方): 1 ≤ L ≤ 10⁹,1 ≤ N ≤ 10⁵(休息站数),1 ≤ rB < rF ≤ 10⁹(每单位距离 Bessie/FJ 走的时间),1 ≤ x_i ≤ L,1 ≤ c_i ≤ 10⁹。答案可达 10¹⁸ 以上,必须用 long long。
样例输入(USACO 官方):
10 2 4 3
7 2
8 1
(格式:第一行 L N rF rB;随后 N 行每行「位置 美味值」)
样例输出:
15
(rF−rB = 1,Bessie 每走 1 单位距离攒下 1 单位吃草时间。两个站从右往左看都是后缀最大值(位置 8 的 1、位置 7 的 2),都值得停留:在位置 7 停留 7×1=7 单位时间得 7×2=14;再走到位置 8 时又攒下 1 单位时间,得 1×1=1。总快乐值 14+1=15)
关键条件:
- Bessie 比 FJ 慢,因此每走一段距离都会产生「可用于吃草的时间差」。
- 如果后面有一个更美味的休息站,当前较低美味值的站通常不值得停。
- 应只在从右往左看时美味值创新高的休息站停留。
思路分析
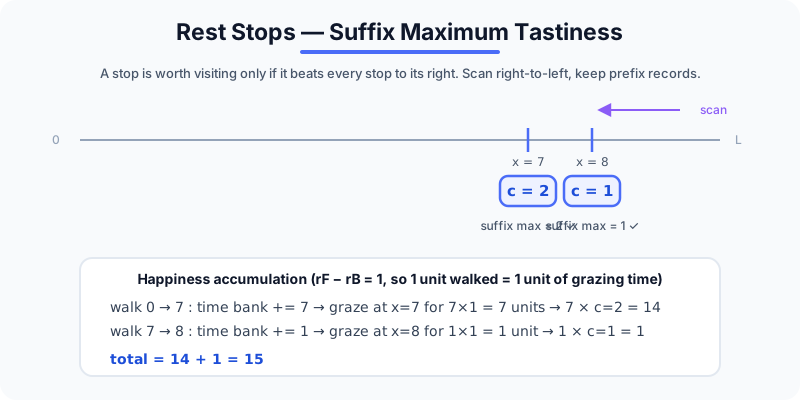
思路分析
把休息站按位置升序。若某个休息站右侧存在更高美味值的站,那么把时间留到右侧更高美味值处吃草一定不差。因此真正需要停的站,是从右往左扫描时遇到的「后缀最大美味值」站。
算法步骤:
- 从右往左标记所有
c大于右侧最大值的休息站。 - 再从左到右经过这些被选中的站。
- 上一个停留点到当前停留点的距离为
delta。 - Bessie 比 FJ 多出来的可吃草时间是
delta * (rF - rB)。 - 快乐值增加
time * c。
CPP 完整代码
#include <bits/stdc++.h>
using namespace std;

using ll = long long;

struct Stop {
    ll position;
    ll tastiness;
};

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    // USACO 官方文件 I/O 可按需打开:
    // freopen("reststops.in", "r", stdin);
    // freopen("reststops.out", "w", stdout);

    ll trailLength, n, farmerSpeed, bessieSpeed;
    cin >> trailLength >> n >> farmerSpeed >> bessieSpeed;

    vector<Stop> stops(n);
    for (auto &s : stops) cin >> s.position >> s.tastiness;

    vector<bool> chosen(n, false);
    ll bestTastiness = -1;

    // 从右往左选出所有「比右侧都更好」的休息站
    for (int i = n - 1; i >= 0; i--) {
        if (stops[i].tastiness > bestTastiness) {
            chosen[i] = true;
            bestTastiness = stops[i].tastiness;
        }
    }

    ll answer = 0;
    ll lastPosition = 0;
    ll speedGap = farmerSpeed - bessieSpeed;

    for (int i = 0; i < n; i++) {
        if (!chosen[i]) continue;
        ll distance = stops[i].position - lastPosition;
        ll extraTime = distance * speedGap;
        answer += extraTime * stops[i].tastiness;
        lastPosition = stops[i].position;
    }

    cout << answer << "\n";
    return 0;
}
复杂度: 两次线性扫描,O(N);空间 O(N)。如果输入不保证按位置升序,先排序,复杂度为 O(N log N)。
易错点提醒
- 从左往右贪心选当前最高。 这会错过后面更高美味值的站;正确视角是从右往左看后缀最大。
- 把速度差写反。 可吃草时间来自
farmerSpeed - bessieSpeed,因为 FJ 更快。 - 忘记更新
lastPosition。 每一段额外时间只来自上一次停留点到当前停留点的距离。 - 使用
int存答案。 距离、速度差、美味值相乘可能很大,必须用long long。
拓展思考
Rest Stops 是「未来更优选择支配当前选择」的典型题。只要当前选择的收益率低于未来某个选择,并且时间资源可以转移到未来,就应该跳过当前选择。这类题常用后缀最大值预处理。
真题 4:Convention(USACO 2018 February Silver)——二分答案 + 贪心检查
题目(USACO 2018 February Silver): N 头奶牛在时间 t[1..N] 到达公共汽车站。有 M 辆公共汽车,每辆最多容纳 C 头奶牛。将奶牛分配给公共汽车,最小化任意奶牛的最大等待时间(等待时间 = 发车时刻 − 到达时刻;发车时刻自定,一辆车装的所有牛一起出发)。
输入格式: 第一行 N, M, C;第二行 N 个到达时间。 数据规模(真题): 1 ≤ N ≤ 10⁵,1 ≤ M ≤ 10⁵,1 ≤ C ≤ N,0 ≤ t[i] ≤ 10⁹。时间限制 4 秒——O(N log N) 的二分 + 贪心检查轻松通过。
做法:二分答案 + 贪心检查。

#include <bits/stdc++.h>
using namespace std;

int n, m, c;
vector<long long> cows;   // 按到达时间排序

// 最大等待时间 <= maxWait 时能否调度所有奶牛?
bool canDo(long long maxWait) {
    int busesUsed = 0;
    int i = 0;  // 当前奶牛下标

    while (i < n) {
        busesUsed++;
        if (busesUsed > m) return false;  // 公共汽车不够用了

        // 该车从奶牛 i 开始服务
        // 车必须在 cows[i] + maxWait 之前出发
        long long depart = cows[i] + maxWait;

        // 尽量多地装奶牛(容量 c,到达时间 ≤ 出发时间)
        int count = 0;
        while (i < n && count < c && cows[i] <= depart) {
            i++;
            count++;
        }
    }

    return true;
}

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    cin >> n >> m >> c;
    cows.resize(n);
    for (long long &x : cows) cin >> x;
    sort(cows.begin(), cows.end());

    // 对最大等待时间二分
    long long lo = 0, hi = 1e14;
    while (lo < hi) {
        long long mid = lo + (hi - lo) / 2;
        if (canDo(mid)) hi = mid;
        else lo = mid + 1;
    }

    cout << lo << "\n";
    return 0;
}
真题 5:放牧(USACO Bronze)——小数据贪心观察
题目: 三头奶牛站在数轴上不同的整数位置 a、b、c(0 ≤ a, b, c ≤ 10⁹)。每次移动可以选任意一头奶牛,将它传送到任意空的整数位置。找让三头奶牛处于三个连续整数位置(如 {k, k+1, k+2})所需的最少移动次数。
输入格式: 一行三个整数 a、b、c。
样例输入: 4 7 9 → 输出: 1(将 9 移到 5 或 6,或将 4 移到 8:{7,8,9})
样例输入 2: 1 10 100 → 输出: 2
贪心洞察: 排序后 a ≤ b ≤ c:
- 0 次移动当且仅当
c - a == 2(已是连续) - 2 次移动始终够用(上界)
- 1 次移动可行当以下任一成立:
c - b == 1或c - b == 2(b 和 c 相邻或差 1)b - a == 1或b - a == 2(a 和 b 相邻或差 1)c - a == 3(移动 b 到 a+1 或 c-1 使三者连续)
#include <bits/stdc++.h>
using namespace std;

int main() {
    long long a, b, c;
    cin >> a >> b >> c;

    long long pos[3] = {a, b, c};
    sort(pos, pos + 3);
    a = pos[0]; b = pos[1]; c = pos[2];

    // 0 次移动:已是连续
    if (c - a == 2) { cout << 0; return 0; }

    // 1 次移动:检查各情况
    bool one_move = false;

    // (b,c) 对保留:移动 a
    if (c - b == 1 || c - b == 2) one_move = true;
    // (a,b) 对保留:移动 c
    if (b - a == 1 || b - a == 2) one_move = true;
    // (a,c) 对保留:移动 b(需 c-a==3)
    if (c - a == 3) one_move = true;

    if (one_move) { cout << 1; return 0; }

    cout << 2;
    return 0;
}
练习题
| 题目 | 关键技术 | 难度 |
|---|---|---|
| 4.4.1 跳跃游戏 | 可达性贪心 | 🟡 中等 |
| 4.4.2 Convention II(USACO Silver) | 资历优先队列模拟 | 🔴 困难 |
| 4.4.3 加权工作调度 | 贪心失败 → DP | 🔴 困难 |
题目 4.4.1 — 跳跃游戏 🟡 中等
题目: 给定非负整数数组 A,从索引 0 出发,在位置 i 可以向前跳最多 A[i] 步。判断是否能到达最后一个索引(n-1)。
数据规模: 1 ≤ N ≤ 2×10⁵,0 ≤ A[i] ≤ 10⁵。O(N) 单次扫描即可。
示例:
A = [2, 3, 1, 1, 4] → true  (0→1→4)
A = [3, 2, 1, 0, 4] → false (过不了位置 3)
💡 提示
维护 farthest = 目前可到达的最远下标。扫描每个可达位置,更新 farthest。若某时刻 i > farthest,位置 i 不可达——返回 false。
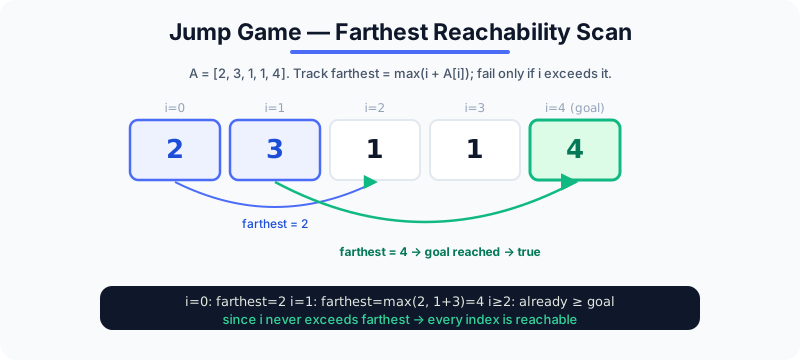
#include <bits/stdc++.h>
using namespace std;

bool canJump(vector<int>& A) {
    int n = A.size();
    int farthest = 0;

    for (int i = 0; i < n; i++) {
        if (i > farthest) return false;
        farthest = max(farthest, i + A[i]);
        if (farthest >= n - 1) return true;
    }
    return true;
}

int main() {
    int n;
    cin >> n;
    vector<int> A(n);
    for (int &x : A) cin >> x;
    cout << (canJump(A) ? "true" : "false") << "\n";
}
为什么贪心正确: 每步不选具体跳跃——只是追踪从当前所有可达位置出发,所有可能跳跃的并集。这等价于同时考虑所有可能的跳跃路径。
题目 4.4.2 — USACO 2018 February Silver:Convention II 🔴 困难
题目: N(1 ≤ N ≤ 10⁵)头奶牛按资历排序(下标越小资历越高)。奶牛 i 在时间 a[i] 到达饮水处(0 ≤ a[i] ≤ 10⁶),喝水需要 t[i](1 ≤ t[i] ≤ 10⁶)个时间单位(设备每次服务一头奶牛)。设备空闲时,等待的奶牛中资历最高(下标最小)的先喝水。求所有奶牛中最大等待时间。
输入格式: 第一行 N;接下来 N 行每行 a[i] 和 t[i]。 数据规模(真题): 1 ≤ N ≤ 10⁵,0 ≤ a[i] ≤ 10⁶,1 ≤ t[i] ≤ 10⁶。优先队列模拟 O(N log N) 通过。
💡 提示
用优先队列(按资历下标最小堆)模拟。维护已到达但未喝水的奶牛的「等待队列」。每次设备空闲时,从等待队列中取资历最高(下标最小)的奶牛。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    // {到达时间, 原始下标(资历), 喝水时长}
    vector<tuple<int,int,int>> cows(n);
    for (int i = 0; i < n; i++) {
        int a, t;
        cin >> a >> t;
        cows[i] = {a, i, t};  // 原始下标 i = 资历(0 = 最高资历)
    }

    sort(cows.begin(), cows.end());  // 按到达时间排序

    // 最小堆:{资历下标, 到达时间, 喝水时长}——下标最小优先级最高
    priority_queue<tuple<int,int,int>, vector<tuple<int,int,int>>, greater<>> waiting;

    int curTime = 0;  // 设备下次空闲的时间
    int maxWait = 0;
    int idx = 0;

    while (idx < n || !waiting.empty()) {
        // 将所有在 curTime 之前到达的奶牛加入等待队列
        while (idx < n && get<0>(cows[idx]) <= curTime) {
            auto [a, seniority, t] = cows[idx];
            waiting.push({seniority, a, t});
            idx++;
        }

        if (waiting.empty()) {
            curTime = get<0>(cows[idx]);
            continue;
        }

        // 服务资历最高(下标最小)的等待奶牛
        auto [seniority, arrTime, drinkTime] = waiting.top();
        waiting.pop();

        int waitTime = curTime - arrTime;
        maxWait = max(maxWait, waitTime);
        curTime += drinkTime;
    }

    cout << maxWait << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
题目 4.4.3 — 加权工作调度 🔴 困难(贪心失败→用 DP)
题目: N(1 ≤ N ≤ 2×10⁵)个工作,各有开始时间 s[i]、结束时间 e[i](0 ≤ s[i] < e[i] ≤ 10⁹)和利润 p[i](1 ≤ p[i] ≤ 10⁹)。选择一组不重叠的工作(区间 [s[i], e[i]) 两两不相交)以最大化总利润。总利润可能超过 int 范围。
输入格式: 第一行 N;接下来 N 行每行 s[i]、e[i]、p[i]。
示例:
N=4
工作:(s=1,e=3,p=50), (s=2,e=5,p=10), (s=4,e=6,p=40), (s=6,e=7,p=70)
输出:160(工作 1 + 3 + 4)
为什么贪心失败?
- 按利润排序取最大值?不行。反例:(s=1,e=10,p=100) vs (s=1,e=3,p=50)+(s=4,e=7,p=60)——后者总计 110。
- 按最早结束时间?不行。贪心可能选利润为 1 的短工作,错过利润 100 的长工作。
- 贪心无法同时优化「早结束」和「最大利润」。这是加权区间调度——DP 问题。
DP 做法:
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<tuple<int,int,int>> jobs(n);  // {结束时间, 开始时间, 利润}
    for (int i = 0; i < n; i++) {
        int s, e, p;
        cin >> s >> e >> p;
        jobs[i] = {e, s, p};
    }

    sort(jobs.begin(), jobs.end());  // 按结束时间排序

    vector<int> ends;
    for (auto [e, s, p] : jobs) ends.push_back(e);

    vector<long long> dp(n + 1, 0);  // dp[i]:前 i 个工作的最大利润(1-indexed)

    for (int i = 1; i <= n; i++) {
        auto [e, s, p] = jobs[i - 1];

        // 二分搜索:找最后一个结束时间 <= s[i] 的工作(不重叠)
        int lo = 0, hi = i - 1;
        while (lo < hi) {
            int mid = (lo + hi + 1) / 2;
            if (ends[mid - 1] <= s) lo = mid;
            else hi = mid - 1;
        }

        dp[i] = max(dp[i - 1], dp[lo] + p);  // 跳过 vs 选取
    }

    cout << dp[n] << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
教训: 选择不重叠区间时,若区间有权重(利润),贪心不起作用——用 DP。只有当所有权重相等(最大化数量)时,才能简化为贪心。