第 4.2 章:区间与调度
区间和调度是贪心最经典的两大战场——USACO Silver 的「排序 + 扫描」题大多落在这一类。本章用三个模型吃透它们:区间调度的三种变体、最早截止时间优先(EDF)、Huffman 合并。
📌 前置: 第 4.1 章的交换论证法和活动选择问题是本章的地基——这里每个策略的正确性都靠它证明。
4.2.1 区间调度:最大化 vs 最小化变体
本节涵盖三个相关的区间问题,看起来相似但需要微妙不同的贪心策略。
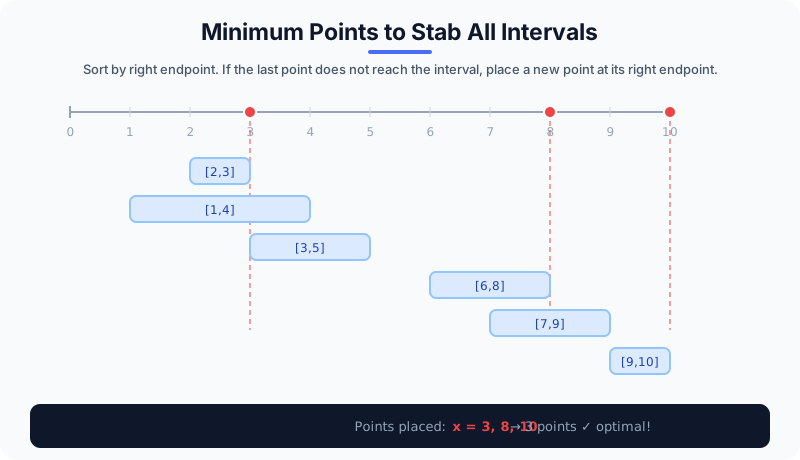
图示:数轴上的区间调度

最大化:最多不重叠区间
这正是第 4.1 章的活动选择问题。按结束时间排序,贪心选择如上所述。
最小化:「刺穿」所有区间所需最少点数
题目: 给定数轴上 N 个区间,找最少数量的「点」(每个点是一个实数),使每个区间至少包含一个点。仅共享端点的两个区间都被视为包含该端点。
数据规模: 1 ≤ N ≤ 10⁵,−10⁹ ≤ l[i] ≤ r[i] ≤ 10⁹。
样例输入:
6
1 4
2 3
3 5
6 8
7 9
9 10
(格式:第一行 N,随后每行 l[i] r[i],与上方 stabbing_points.svg 图中的 6 个区间一致)
样例输出:
3
(在 3、8、10 处放点即可覆盖全部区间;右端点排序后贪心放置的第一个点 3 落在 [1,4] 的右端)
贪心策略: 按右端点升序排序。维护 lastPoint(最后放置的点)。对每个区间:
- 若
lastPoint已在该区间内(lastPoint >= l[i]):该区间已被覆盖,跳过。 - 否则:在
r[i]放一个新点(尽量靠右,最大化对后续区间的覆盖),计数加一。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;
    vector<pair<int,int>> intervals(n);  // {右端点, 左端点}
    for (auto &[r, l] : intervals) cin >> l >> r;

    sort(intervals.begin(), intervals.end());  // 按右端点排序

    int points = 0;
    long long lastPoint = LLONG_MIN;

    for (auto [r, l] : intervals) {
        if (lastPoint < l) {          // 当前点不覆盖该区间
            lastPoint = r;            // 在右端放新点
            points++;
        }
    }

    cout << points << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
最小化:最少区间覆盖一段范围
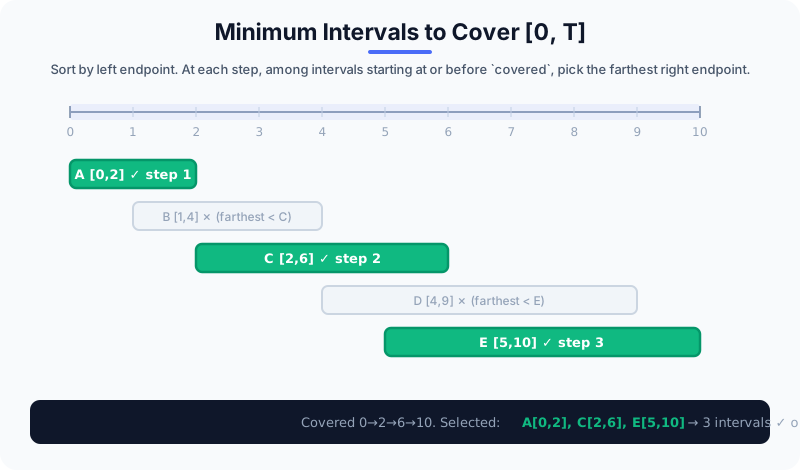
题目: 给定 N 个区间和目标范围 [0, T],从集合中选最少数量的区间使其并集完全覆盖 [0, T]。不可能时输出「Impossible」。
数据规模: 1 ≤ T ≤ 10⁹,1 ≤ N ≤ 10⁵,−10⁹ ≤ l[i] ≤ r[i] ≤ 10⁹。
样例输入:
10 5
0 2
1 4
2 6
4 9
5 10
(格式:第一行 T 和 N,随后每行 l[i] r[i])
样例输出:
3
(选 [0,2]→[2,6]→[4,9] 延伸至 [5,10]:贪心依次推进 covered 0→6→10,3 个区间即可覆盖 [0,10])
反例样例(输出 Impossible):
10 3
0 2
1 4
2 6
(最多推进到 6 < 10,无法覆盖 [0,10])
贪心策略: 按左端点升序排序。维护 covered(当前已覆盖到的位置,初始为 0)。每步在所有满足 l[i] ≤ covered 的区间中(它们可以延伸覆盖),选右端点最大的(farthest)。将 covered 推进到 farthest,计数加一。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int T, n;
    cin >> T >> n;

    vector<pair<int,int>> intervals(n);
    for (auto &[l, r] : intervals) cin >> l >> r;

    sort(intervals.begin(), intervals.end());  // 按左端点排序

    int covered = 0;    // 当前已覆盖到 'covered'
    int count = 0;
    int i = 0;

    while (covered < T) {
        int farthest = covered;

        // 在左端点 <= covered 的所有区间中,找最远的右端点
        while (i < n && intervals[i].first <= covered) {
            farthest = max(farthest, intervals[i].second);
            i++;
        }

        if (farthest == covered) {
            // 没有区间能延伸覆盖——不可能
            cout << "Impossible\n";
            return 0;
        }

        covered = farthest;
        count++;
    }

    cout << count << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
⚠️ 与刺穿的关键区别: 刺穿按右端点排序(尽量宽地覆盖当前区间);覆盖按左端点排序(从停下的地方尽量向右延伸覆盖)。
4.2.2 调度问题:最小化最大延迟(EDF)
题目: 一台机器,N 个作业。作业 i 有:
- 处理时间
t[i]——运行所需时长 - 截止时间
d[i]——理想上应完成的时间
机器按顺序运行作业(无重叠,无空闲)。作业 i 的延迟量是 max(0, 完成时间[i] − d[i])——超出截止时间的量(按时完成则为 0)。最小化所有作业中最大延迟量。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ t[i] ≤ 10⁹,1 ≤ d[i] ≤ 10⁹。完成时间之和可能超出 int,注意溢出。
样例输入:
4
3 6
2 8
1 4
4 9
样例输出:
1
解释: 按截止时间升序排序:job3(t=1,d=4), job1(t=3,d=6), job2(t=2,d=8), job4(t=4,d=9)。
作业 3:运行 [0,1],  完成于 1。延迟量 = max(0, 1-4)  = 0
作业 1:运行 [1,4],  完成于 4。延迟量 = max(0, 4-6)  = 0
作业 2:运行 [4,6],  完成于 6。延迟量 = max(0, 6-8)  = 0
作业 4:运行 [6,10],完成于 10。延迟量 = max(0, 10-9) = 1
最大延迟量 = 1 ✓
贪心策略:最早截止日期优先(EDF)
规则: 按截止时间升序排列作业,按该顺序无间隙运行。
为什么 EDF 最优——交换论证:
设最优调度中两个相邻作业 A 和 B,d[A] > d[B](A 截止更晚但先运行)。设 S 是这两个作业之前所有作业的完成时间:
| 调度 | A 的延迟量 | B 的延迟量 |
|---|---|---|
| A → B | max(0, S + t[A] − d[A]) | max(0, S + t[A] + t[B] − d[B]) |
| B → A | max(0, S + t[B] − d[B]) | max(0, S + t[B] + t[A] − d[A]) |
由于 d[A] > d[B],B 更紧迫。A→B 顺序中:B 在 S + t[A] + t[B] 完成,与 B→A 顺序相同——但 B 的截止时间更早,可能延迟更多。交换到 B→A 永远不会增加最大延迟量。因此,任何非 EDF 调度都可以通过交换改善或维持,EDF 是最优的。

#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;

    vector<pair<int,int>> jobs(n);  // {截止时间, 处理时间}
    for (int i = 0; i < n; i++) cin >> jobs[i].second >> jobs[i].first;

    sort(jobs.begin(), jobs.end());  // 按截止时间排序

    int time = 0;
    int maxLateness = 0;

    for (auto [deadline, proc] : jobs) {
        time += proc;                          // 该作业的完成时间
        int lateness = max(0, time - deadline); // 延迟多久?
        maxLateness = max(maxLateness, lateness);
    }

    cout << maxLateness << "\n";
    return 0;
}
4.2.3 Huffman 编码(贪心建树)
题目: 有 N 个符号,每个出现频率为 freq[i]。想为每个符号分配一个二进制码字(0 和 1 的字符串),使没有码字是另一个的前缀(前缀无关码)。总编码代价 = 所有符号的 freq[i] × depth[i] 之和,其中 depth[i] 是符号 i 码字的长度。最小化总代价。
数据规模: 2 ≤ N ≤ 10⁵,1 ≤ freq[i] ≤ 10⁹。总代价可达 10¹⁵ 以上,必须用 long long。
贪心规则: 始终合并频率最小的两个节点(用最小堆)。
样例输入:
5
5 7 10 15 20
(格式:第一行 N,第二行 N 个频率——与下方 huffman.svg 图中的 5 个符号一致)
样例输出:
126
(依次合并:5+7=12(代价 12),10+12=22(代价 22),15+20=35(代价 35),22+35=57(代价 57);总代价 12+22+35+57=126)
#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;

    priority_queue<long long, vector<long long>, greater<long long>> pq;  // 最小堆
    for (int i = 0; i < n; i++) {
        long long f; cin >> f;
        pq.push(f);
    }

    long long totalCost = 0;
    while (pq.size() > 1) {
        long long a = pq.top(); pq.pop();
        long long b = pq.top(); pq.pop();
        totalCost += a + b;  // 合并 a 和 b 的代价
        pq.push(a + b);      // 合并后的组频率为 a+b
    }

    cout << totalCost << "\n";
    return 0;
}
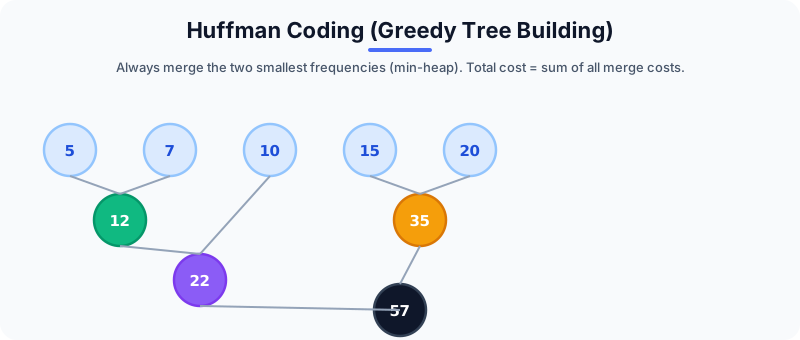
为什么总是合并最小的两个? 频率最低的两个符号应该在树中最深(码字最长),因为罕见符号的长码字对总代价的贡献较小。通过总是合并当前最小的两个,确保使用最频繁的符号保留在根附近。
USACO 中的实际应用: Huffman 算法出现在「最小代价合并 N 堆」问题中。每次需要合并两堆,支付合并后大小之和,答案就是所有合并操作的总和——由 Huffman 贪心算法计算。
4.2.4 二分答案 + 贪心检查——「最小化最大值」的标准解法
USACO Silver 出现频率最高的组合技:题面问「最小化最大值」或「最大化最小值」(最长等待最短多少?每段至少多大?),直接构造最优方案很难,但验证一个给定答案很简单——那就把「求解」换成「判定」,让二分搜索去找答案。
为什么可行(单调性论证——必写): 若最大等待 ≤ T 可行,则 ≤ T+1 也可行(限制更宽松只会更容易满足)。「可行性」随 T 单调变化,所以能在 T 的值域上二分。
模板:
// 对答案 X 二分;check(X) 用贪心 O(N) 验证
long long lo = 0, hi = 最大可能答案;
while (lo < hi) {
    long long mid = lo + (hi - lo) / 2;
    if (check(mid)) hi = mid;      // mid 可行 → 答案 ≤ mid
    else lo = mid + 1;             // mid 不可行 → 答案 > mid
}
// lo 即最小可行答案
check() 怎么写(贪心): 按天然顺序扫描(通常先排序),每一步做「局部最紧」的选择——只要能塞就塞、只要不超就攒。注意 check 只需要判断可行性,不需要真的最优。
📌 完整真题演示: 第 4.4 章真题 4:Convention——「N 头奶牛、M 辆容量 C 的班车,最小化最长等待」就是用这个模式解决的:
check(T)按到达时间排序后贪心装车。此外第 3 章的二分答案有更多不带贪心的纯二分变体。
识别信号: 题面出现「最小化最大的……」「最大化最小的……」,且给定一个候选答案后能 O(N)/O(N log N) 验证 → 二分答案 + 贪心检查。
练习题
| 题目 | 关键技术 | 难度 |
|---|---|---|
| 4.2.1 最少站台数 | 事件扫描 | 🟡 中等 |
| 4.2.2 加油站 | 环形贪心 + 前缀和 | 🔴 困难 |
题目 4.2.1 — 最少站台数 🟡 中等
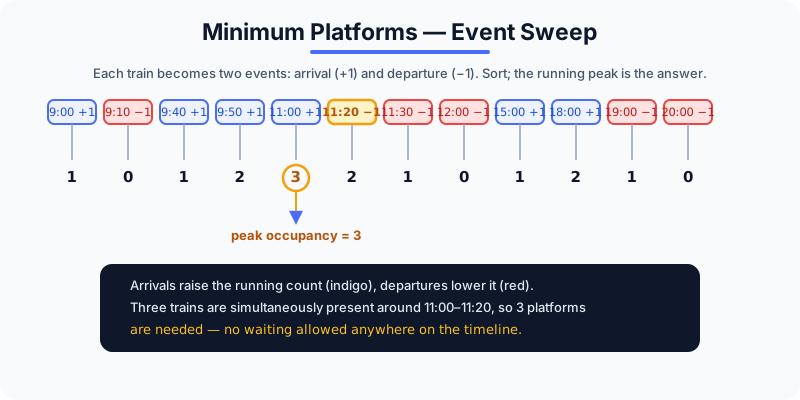
题目: N 辆火车,各有到达时间 arr[i] 和离开时间 dep[i]。若火车到达时所有站台都被占用,它必须等待。找最少需要多少个站台使没有火车需要等待。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ arr[i] < dep[i] ≤ 10⁶。
示例:
arr = [9:00, 9:40, 9:50, 11:00, 15:00, 18:00]
dep = [9:10, 12:00, 11:20, 11:30, 19:00, 20:00]
输出:3
💡 提示
双指针/事件扫描:将所有到达(+1)和出发(-1)事件合并为一个排序列表,扫描时维护当前站台数。峰值就是答案。注意:相同时间时,出发事件先于到达事件处理(离开的火车先让出站台再占用)。
方法一:事件扫描(推荐)
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<pair<int,int>> events;  // {时间, 类型}:类型=0 出发,类型=1 到达
    for (int i = 0; i < n; i++) {
        int a, d;
        cin >> a >> d;
        events.push_back({a, 1});   // 到达
        events.push_back({d, 0});   // 出发(类型=0 < 1,相同时间出发先处理)
    }

    sort(events.begin(), events.end());

    int platforms = 0, maxPlatforms = 0;
    for (auto [time, type] : events) {
        if (type == 1) platforms++;   // 火车到达
        else platforms--;             // 火车出发
        maxPlatforms = max(maxPlatforms, platforms);
    }

    cout << maxPlatforms << "\n";
    return 0;
}
方法二:双指针(经典)
#include <bits/stdc++.h>
using namespace std;

int main() {
    int n;
    cin >> n;

    vector<int> arr(n), dep(n);
    for (int &x : arr) cin >> x;
    for (int &x : dep) cin >> x;

    sort(arr.begin(), arr.end());
    sort(dep.begin(), dep.end());

    int platforms = 1, maxPlatforms = 1;
    int i = 1, j = 0;

    while (i < n && j < n) {
        if (arr[i] <= dep[j]) {
            platforms++;
            i++;
        } else {
            platforms--;
            j++;
        }
        maxPlatforms = max(maxPlatforms, platforms);
    }

    cout << maxPlatforms << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
题目 4.2.2 — 加油站 🔴 困难
题目: N 个加油站排成圆圈。加油站 i 有 gas[i] 升油;从 i 到 i+1 消耗 cost[i] 升。油箱初始为空、容量无限。能否完成整圈?如果能,输出起始站下标(答案唯一);否则输出 −1。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ gas[i], cost[i] ≤ 10⁴。O(N) 单次扫描是期望做法。
示例:
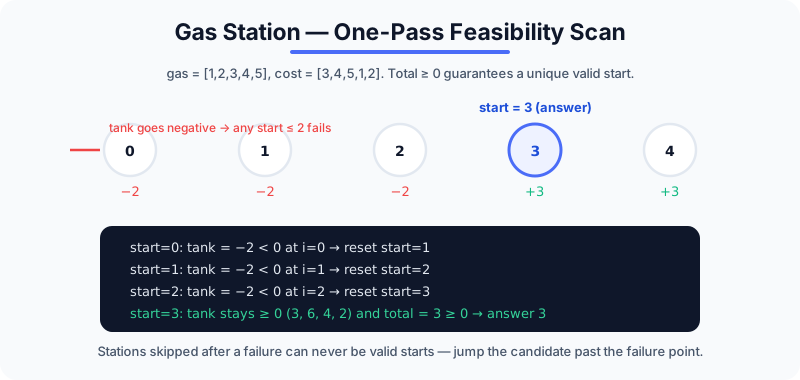
gas  = [1, 2, 3, 4, 5]
cost = [3, 4, 5, 1, 2]
输出:3(从第 3 站出发可以完成整圈)
💡 提示
核心思路:若总油量 ≥ 总耗油量,则恰好存在一个有效起始站。贪心扫描:每当累计油箱降至零以下,将起始站重置为下一站。
两个关键定理:
- 可行性: 若
sum(gas) < sum(cost),无解。 - 唯一起始站定理: 若有解,每当从站 s 出发的运行油箱变为负数,s 到故障点之间的任何站都不是有效起始点。因此下一个候选站必须紧接在故障点之后。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<int> gas(n), cost(n);
    for (int &x : gas) cin >> x;
    for (int &x : cost) cin >> x;

    int totalTank = 0;  // 总净油量(决定可行性)
    int tank = 0;       // 从 'start' 出发的当前油量
    int start = 0;      // 当前候选起始站

    for (int i = 0; i < n; i++) {
        int gain = gas[i] - cost[i];
        tank += gain;
        totalTank += gain;

        if (tank < 0) {
            // 从 'start' 无法到达 i+1 — 重置
            start = i + 1;
            tank = 0;
        }
    }

    if (totalTank < 0) {
        cout << -1 << "\n";  // 无解
    } else {
        cout << start << "\n";
    }
    return 0;
}
// 时间复杂度:O(N)——单次扫描