第 4.1 章:贪心基础
4.1.0 从一道题出发:能用几场活动
先看一道生活化的经典题:
📅 题目:活动选择 会议室只有一间。今天有
N(N ≤ 10⁵)场活动,第i场从时刻s_i开始、e_i结束。一场活动一结束下一场就能立刻开始。问:最多能安排多少场不冲突的活动?
活动:A[1,4]  B[2,3]  C[3,5]  D[0,6]  E[5,7]  F[6,8]
不冲突的选择:B(2-3) → C(3-5) → E(5-7) → F(6-8)……最多 3 场?
先试试你会的方法
思路 1:暴力枚举所有组合? 每场活动只有「选」或「不选」两种可能,N 场活动就有 2^N 种组合——N = 20 时约一百万种还扛得住,N = 10⁵ 时想都别想。暴力行不通,得找更聪明的办法。
思路 2:直觉贪心? 「先结束的活动先选」——选 B(2,3),跳过和它冲突的,再选 C(3,5),再选 E(5,7)……三场。这种「只看眼前最优」的策略竟然是对的?
思路 3:但贪心总对吗? 换一道题:用硬币 {1,5,6,9} 凑 11 分,「每次拿最大硬币」得到 9+1+1 = 3 枚,而最优是 6+5 = 2 枚——贪心错了。
这就是贪心的微妙之处:同一个「每步取局部最优」策略,在活动选择里是定理,在硬币找零里是反例。本章的全部任务就是搞清楚:
- 贪心什么时候对?(贪心选择性质 + 最优子结构)
- 怎么证明它对?(交换论证——把任何最优解逐步换成贪心解而不变差)
- 贪心错了怎么办?(换一种更通用的方法,或者用「后悔贪心」拿堆撤销选择)
- USACO 里怎么快速识别贪心题?
4.1.1 什么样的问题可以用贪心解决?
贪心方法在问题具有贪心选择性质时奏效:每一步做出局部最优选择,最终得到全局最优解。
与 DP 的对比
📌 名词预告: 动态规划(Dynamic Programming,简称 DP)是本书第 6 部分才系统学习的通用算法思想——它「把所有子问题的答案都算一遍」,因此几乎总是正确但更慢。本节只需要知道这个名字;看不懂对比不影响理解贪心本身。
考虑用硬币凑出 11 分:
- 硬币:{1, 5, 6, 9}
- 贪心:9 + 1 + 1 = 3 枚
- 最优:6 + 5 = 2 枚
这里贪心失败了。贪心选择(每次选最大的硬币)没有达到全局最优。
但对于美国硬币 {1, 5, 10, 25, 50}:
- 41 分:贪心 → 25 + 10 + 5 + 1 = 4 枚 ✓(最优)
美国硬币有特殊结构使贪心可行。始终要验证!
完整演示:硬币找零——贪心的失败案例
让我们详细追踪硬币找零例子,看清楚贪心在哪里出错。
题目: 用硬币 {1, 5, 6, 9} 凑出 11 分,最少需要几枚?(枚举所有组合即可验证最优是 2 枚。)
贪心做法(每次选 ≤ 剩余金额的最大硬币):
剩余=11 → 选 9(≤11 最大)。剩余=2。已用:[9]
剩余=2  → 选 1(≤2 最大)。剩余=1。已用:[9, 1]
剩余=1  → 选 1(≤1 最大)。剩余=0。已用:[9, 1, 1]
结果:3 枚 ✗
最优做法(不贪心,跳过 9):
6 + 5 = 11。已用:[6, 5]
结果:2 枚 ✓
为什么贪心失败了? 贪心立即抓取最大的硬币(9),留下的余数(2)只能用 1 分硬币填满。它「看不出来」跳过 9 用 6+5 会更好。

现在对比用美国硬币 {1, 5, 10, 25} 凑 41 分:
剩余=41 → 选 25。剩余=16。已用:[25]
剩余=16 → 选 10。剩余=6。 已用:[25, 10]
剩余=6  → 选 5。 剩余=1。 已用:[25, 10, 5]
剩余=1  → 选 1。 剩余=0。 已用:[25, 10, 5, 1]
结果:4 枚 ✓(最优!)
美国硬币有效是因为每个面额至少是前一个的两倍——永远不需要「撤销」贪心选择。而 {1, 5, 6, 9} 中 5 和 6 太接近,会产生贪心选择阻碍更好组合的情况。
⚠️ 结论: 硬币找零是看起来可以用贪心但并非总是如此的经典例子。除非硬币面额有特殊结构(如美国硬币),否则得换用更通用的方法(如 DP,见第 6 部分)。有疑问时,试一个小反例!
💡 核心思路: 贪心在有「无悔」性质时奏效——一旦做出贪心选择,永远不需要撤销。如果总能用贪心选择替换任何非贪心选择而不使情况变差,贪心就是最优的。
贪心 vs DP 决策路径对比:

🔍 如何识别贪心问题
看到新题时,按以下清单检查:
📄 看到新题时,按以下清单检查:
1. 处理元素时有没有自然的「顺序」或「优先级」?
   (如:按截止时间、结束时间、比率、大小排序……)
        ↓ 有
2. 能证明局部最优选择在全局上是安全的吗?
   (交换论证:把贪心选择与任何其他选择互换,永远不会更好)
        ↓ 能
3. 能找到贪心失败的小反例吗?
        ↓ 找不到反例
   → 贪心很可能正确。实现并验证。
        ↓ 找到反例
   → 贪心失败。考虑 DP 或其他方法。
贪心可行的三个信号:
- ① 排序后,有明确的「按此顺序处理」规则
- ② 题目要求一遍扫描最大化/最小化计数或代价
- ③ 子问题独立——选择一个元素不影响剩余选择的「形状」
改用 DP 的三个信号:
- ① 选择之间有交互(选 A 会改变 B 的可用性)
- ② 需要考虑多个未来状态
- ③ 对你尝试的任何贪心规则都能找到反例
🧭 贪心证明与反例模板
在 USACO 中,写出贪心代码之前,建议先写 3 行「证据链」:
| 步骤 | 你要回答的问题 | 如果答不上来 |
|---|---|---|
| 1. 排序/选择规则 | 我为什么按这个量排序,或为什么每次选这个元素? | 说明贪心标准还不清楚 |
| 2. 安全性证明 | 任意最优解能否替换为我的选择,且答案不变差? | 需要交换论证或反例搜索 |
| 3. 失败场景 | 哪种小数据会让这个规则出错? | 若能构造,立刻改用 DP/搜索/堆 |
反例搜索技巧: 不要从大样例开始。先用 3–5 个元素构造极端情况:一个很大的早期收益、两个中等收益组合、一个边界相等的区间。大多数错误贪心都能在小数据里暴露。
候选贪心:每次选当前收益最大的元素
小反例模板:
- 选最大元素后,会不会阻止两个中等元素同时被选?
- 选结束最晚/开始最早的区间,会不会占掉大量空间?
- 选单价最高的资源,会不会让高产对象没有容量可用?
🏆 竞赛建议: 真正可靠的贪心题解通常同时具备「排序标准」「交换论证」「小反例排除」三件事。缺任何一个,都要谨慎。
USACO 贪心模式分类
理解一道题属于哪个模式通常是关键洞察(USACO 的贪心题很少让你「直接想出贪心」,而是考你识别出题面背后属于哪个已知模型):
| 模式 | 触发词/结构 | 排序依据 | 例子 |
|---|---|---|---|
| 活动选择 | 「最多不重叠区间」 | 右端点升序 | USACO Bronze 调度 |
| EDF 调度 | 「最小化最大延迟/截止时间」 | 截止时间升序 | Convention II(变体) |
| SJF / 完成时间 | 「最小化总等待/完成时间」 | 处理时间升序 | 奶牛排序(相邻交换) |
| 贪心 + 二分 | 「最小化最大值」或「最大化最小值」 | 二分答案 | USACO Convention、Haybales |
| 双指针匹配 | 两个有序数组,最大化匹配对数 | 两数组都排序 | Paired Up、分发饼干 |
| 扫描线/模拟 | 带时间戳的事件、容量约束 | 事件时间 | 奶牛信号、会议室 |
| 后悔贪心 | 「选 K 个元素且决策可取消」 | 最大堆 + 后悔节点 | USACO Gold 进阶题 |
| 自定义比较器 | 「按最优顺序排列 N 个元素」 | a+b vs b+a,w/t 比率 | 最大数,SJF |
⚠️ USACO 竞赛提示: Silver/Gold 级别的贪心题几乎总是需要正确性证明草稿——无论是交换论证还是二分搜索的单调性论证。若你无法用 2 句话草拟贪心的有效性,要更加谨慎。
4.1.2 交换论证法
交换论证是贪心算法的标准证明技术,回答「怎么证明贪心正确?」这个问题。几乎所有 USACO 的贪心正确性证明都用这个技术。
工作原理
证明模板分四步:
- 假设存在一个在某一步做出与我们的贪心算法不同选择的最优解 O。
- 找到 O 和贪心第一次不同的位置。
- 交换——把贪心的选择放入 O 在该位置的解中。证明结果至少同样好(代价不增,或数量不减)。
- 重复直到 O 完全变换成贪心解。由于每次交换维持或改善解,贪心解必然是最优的。
💡 核心思路: 不需要证明贪心是唯一最优的——只需证明没有交换可以改善它。即使多个解都达到相同最优,贪心也能找到其中一个。
📋 交换论证证明模板
给定: 贪心规则 G,最优解 O。
第一步——找差异: 设 i 是 O 和 G 第一个不同的下标。
第二步——交换: 构造 O',将位置 i 的 O 的选择替换为 G 的选择。
第三步——比较: 证明
cost(O') ≤ cost(O)(或count(O') ≥ count(O))。第四步——结论: 归纳地,反复交换把 O 变成 G 而不恶化解。因此 G 是最优的。
为什么「相邻交换」就够了
一个关键观察:若能证明交换任意两个顺序不对的相邻元素不会恶化解,那么通过标准的「冒泡排序」论证,可以将任意解重排为贪心顺序而不使情况变差。
这就是为什么交换论证几乎总是聚焦于只交换两个相邻元素——完整证明由归纳法得出。
具体示例:调度最小化加权和
题目: 有 N 个作业,作业 i 的处理时间为 t[i],权重为 w[i]。所有作业在一台机器上顺序运行。作业 i 的加权完成时间 = w[i] × (包含作业 i 在内的所有作业处理时间之和)。最小化总加权完成时间。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ t[i] ≤ 1000,1 ≤ w[i] ≤ 1000。总代价可达 10⁵ × 10⁶ × 10³ 量级,注意用 long long;O(N log N) 排序贪心是标准做法。
样例输入:
3
2 3
1 5
4 2
(格式:每行 t[i] w[i])
样例输出:
37
什么顺序最优? 用交换论证:
考虑两个相邻作业 A(处理时间 a,权重 w_A)和 B(处理时间 b,权重 w_B),设 S 是这两个作业之前所有作业的总处理时间:
| 顺序 | A 的加权代价 | B 的加权代价 | 这两个作业的总代价 |
|---|---|---|---|
| A → B | w_A × (S + a) | w_B × (S + a + b) | w_A·a + w_B·b + (w_A + w_B)·S + w_B·a |
| B → A | w_B × (S + b) | w_A × (S + b + a) | w_B·b + w_A·a + (w_A + w_B)·S + w_A·b |
A → B 更好当:w_B·a < w_A·b,即 w_A/t_A > w_B/t_B(权重/时间比更高的先做)。
贪心规则: 按 w[i]/t[i] 降序排序。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<pair<int,int>> jobs(n);  // {t, w}
    for (auto &[t, w] : jobs) cin >> t >> w;

    // 按 w/t 比值降序排序(比值更高的先做)
    sort(jobs.begin(), jobs.end(), [](const auto &a, const auto &b) {
        // a.second/a.first > b.second/b.first  →  a.second * b.first > b.second * a.first
        return (long long)a.second * b.first > (long long)b.second * a.first;
    });

    long long total = 0, curTime = 0;
    for (auto [t, w] : jobs) {
        curTime += t;
        total += (long long)w * curTime;
    }

    cout << total << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
图示:贪心交换论证

上图说明了交换论证:若两个相邻元素相对于贪心标准「顺序不对」,交换它们会产生至少同样好的解。通过反复交换,可以把任何解变换成贪心解而不损失价值。
交换论证失败的情况
有时找不到有效的交换——这说明贪心不适用:
- 0/1 背包: 无法用一件物品的一部分替换另一件物品,所以交换不保持约束。
- 任意面额的硬币找零: 交换硬币选择实际上可能在其他位置强制使用更多硬币。
- 一般加权区间调度: 选择一个高利润的短作业可能阻塞两个中等利润但合计超过它的作业。
在所有这些情况下,交换论证失败,需要用 DP。
4.1.3 活动选择问题
题目: 给定 N 个活动,每个活动有开始时间 s[i] 和结束时间 f[i]。每次只能进行一个活动。若两个活动有重叠(一个在另一个结束前开始),则它们冲突。选择最多数量的不重叠活动。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ s[i] < f[i] ≤ 10⁹。一场活动一结束下一场就能立刻开始(s ≥ lastEnd 即可)。O(N²) DP 会超时,需要 O(N log N) 贪心。
样例输入:
6
1 3
2 5
3 9
6 8
5 7
8 11
样例输出:
3
(最优选择是活动 (1,3)、(6,8)、(8,11)——或等价地 (1,3)、(5,7)、(8,11))
为什么可以用贪心解决
直觉上:在所有从上一个选定活动之后开始的活动中,接下来该选哪个?结束最早的那个——它「占用」最少的未来时间,为后续活动留下最大空间。
任何其他选择(选结束更晚的活动)只会有害:它阻塞的未来活动至少与结束最早的选择一样多,甚至更多。
这就是贪心选择性质: 局部最优选择(选结束最早的相容活动)导致全局最优解。
图示:活动选择甘特图

甘特图在时间轴上展示所有活动。选中的活动(绿色)不重叠且数量最多,被拒绝的活动(灰色)因与已选活动重叠而跳过。贪心规则是:始终选结束时间最早且不冲突的活动。
贪心算法:
- 按结束时间排序活动
- 每次选择与已选活动相容且结束时间最早的活动

💡 为什么按结束时间排序? 选择结束最早的活动为后续活动留下最多时间。按开始时间排序可能选到开始很早但结束很晚的活动,占用大量时间。
// 活动选择 — O(N log N)
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<pair<int,int>> activities(n);  // {结束时间, 开始时间}
    for (int i = 0; i < n; i++) {
        int s, f;
        cin >> s >> f;
        activities[i] = {f, s};  // 按结束时间排序
    }

    sort(activities.begin(), activities.end());  // ← 关键:按结束时间排序

    int count = 0;
    int lastEnd = -1;  // 最后一个选定活动的结束时间

    for (auto [f, s] : activities) {
        if (s >= lastEnd) {      // 该活动在上一个结束后才开始
            count++;
            lastEnd = f;         // 更新最后结束时间
        }
    }

    cout << count << "\n";
    return 0;
}
完整演示
活动: [(1,3), (2,5), (3,9), (6,8), (5,7), (8,11), (10,12)](格式:开始, 结束)
第一步——按结束时间排序:
活动:   A      B      C      D      E      F      G
(s,e):(1,3)  (2,5)  (5,7)  (6,8)  (3,9)  (8,11) (10,12)
排序后:A(1,3), B(2,5), C(5,7), D(6,8), E(3,9), F(8,11), G(10,12)
第二步——贪心选择(初始 lastEnd = -1):
活动 A (1,3):  start=1 ≥ lastEnd=-1 ✓ 选中。lastEnd=3。count=1
活动 B (2,5):  start=2 ≥ lastEnd=3?否(2 < 3)。跳过。
活动 C (5,7):  start=5 ≥ lastEnd=3 ✓ 选中。lastEnd=7。count=2
活动 D (6,8):  start=6 ≥ lastEnd=7?否(6 < 7)。跳过。
活动 E (3,9):  start=3 ≥ lastEnd=7?否(3 < 7)。跳过。
活动 F (8,11):start=8 ≥ lastEnd=7 ✓ 选中。lastEnd=11。count=3
活动 G (10,12):start=10 ≥ lastEnd=11?否(10 < 11)。跳过。
结果:选中 3 个活动——A(1,3), C(5,7), F(8,11)
时间轴(A~G 表示活动):
时间:  0  1  2  3  4  5  6  7  8  9  10 11 12
       |  |  |  |  |  |  |  |  |  |  |  |  |
A:       [===]                                   ✓ 选中
B:          [======]                             ✗ 与 A 重叠
C:                  [======]                     ✓ 选中
D:                     [======]                  ✗ 与 C 重叠
E:             [============]                    ✗ 与 A 和 C 重叠
F:                           [======]            ✓ 选中
G:                              [======]         ✗ 与 F 重叠
⚠️ 第 4.1 章常见错误
-
把贪心用在 DP 问题上: 贪心更简单不代表它正确。始终用小反例测试。任意面额的硬币找零是经典陷阱。
-
排序标准用错: 活动选择时按开始时间而非结束时间排序是经典 bug。为什么这样排序的论证(交换论证)才告诉你正确的标准。
-
重叠判断差一:
s >= lastEnd(允许相邻活动)vss > lastEnd(要求有间隔)。检查题目要求哪种。 -
不证明就假设贪心有效: 始终用小例子验证,或简短地交换论证一下。若找不到反例且能草拟贪心选择「安全」的理由,大概率是正确的。
-
忘记排序: 贪心算法几乎总是从排序开始。忘记排序意味着贪心「顺序」不存在。
-
比较器中整数溢出: 按比率
w/t排序时,避免浮点比较。用交叉乘法:w_A * t_B > w_B * t_A。乘法前始终强制转换为long long。 -
在错误的子问题上贪心: 有些问题看起来像「每次选最优元素」,但「最优」取决于未来上下文。若你在第 i 步的贪心选择改变了第 i+1 步的最优性,很可能需要 DP。
本章总结
📌 核心要点
| 题目类型 | 贪心策略 | 排序依据 | 时间 | 识别信号 |
|---|---|---|---|---|
| 最多不重叠区间 | 选结束最早的区间 | 右端点升序 | O(N log N) | 「最多活动/会议」 |
| 最少点刺穿所有区间 | 在每个未覆盖区间的右端放点 | 右端点升序 | O(N log N) | 「最少箭/传感器覆盖所有」 |
| 最少区间覆盖范围 | 每步选最远延伸的 | 左端点升序 | O(N log N) | 「最少线段覆盖 [L,R]」 |
| 区间合并 | 按左端点排序,扫描合并 | 左端点升序 | O(N log N) | 「合并重叠范围」 |
| 最小化最大延迟(EDF) | 最早截止日期优先 | 截止时间升序 | O(N log N) | 「最小化最大延迟」 |
| Huffman 编码 | 合并两个最小频率 | 最小堆 | O(N log N) | 「最小代价合并 N 堆」 |
| 最小化总完成时间(SJF) | 最短作业优先 | 处理时间升序 | O(N log N) | 「最小化加权完成时间总和」 |
| 最大数(拼接) | 比较器:a+b vs b+a | 自定义比较器 | O(N log N·L) | 「排列数字/字符串得最大数」 |
| 排列不等式 | 同向最大化,反向最小化 | 两数组都排序 | O(N log N) | 「最大/最小化两数组的点积」 |
| 双序列匹配 | 两数组排序后双指针匹配 | 两数组都排序 | O(N log N) | 「匹配 A[i] 和 B[j] 最大化满足对数」 |
| 删除 K 个数字(最小结果) | 单调栈——栈顶大于当前时弹出 | 不需要排序 | O(N) | 「删 K 个数字得最小数」 |
| 股票交易(无限次) | 累加每个正日差 | 不需要排序 | O(N) | 「无限买卖,最大利润」 |
| 后悔贪心 | 贪心选取 + 在堆中插入后悔节点 | 最大/最小堆 | O(N log N) | 「K 次操作,可隐式撤销」 |
| 多机调度(LPT) | 最长作业优先 + 最小堆分配 | 处理时间降序 | O(N log K) | 「N 个作业,K 台机器,最小完工时间」 |
| 对抗匹配(田忌赛马) | 最强打最强;否则最弱消耗最强 | 双端指针 | O(N log N) | 「双方各自最优分配,最大赢场数」 |
| 前缀/后缀双遍扫描 | 从两侧分别扫描,取最大合并 | 无/自定义 | O(N) | 「每个元素依赖左侧最小和右侧最大」 |
| 位运算贪心(字典树+逐位) | 在每层贪心选对立位 | 无 | O(N·MAXBIT) | 「数组中两个元素的最大异或值」 |
❓ 常见问题
Q1:怎么判断一个问题能不能用贪心解?
A:三个信号:① 排序后有清晰的处理顺序;② 可以用交换论证证明贪心选择永远不比其他选择差;③ 找不到反例。若找到了(如硬币找零 {1,5,6,9}),贪心失败——改用 DP。
Q2:贪心和 DP 的真正区别是什么?
A:贪心在每步做出局部最优选择且从不回头。DP 考虑所有可能的选择,从子问题解构建全局最优。贪心是 DP 的特例——当局部最优恰好等于全局最优时可以用贪心。
Q3:「二分答案 + 贪心检查」模式是什么?
A:当题目问「最小化最大值」或「最大化最小值」时,对答案 X 二分查找,用贪心的
check(X)验证可行性。参见第 4.4 章的真题 4:Convention。
Q4:活动选择为什么按结束时间而非开始时间排序?
A:按结束时间排序确保我们总是选择最早「释放资源」的活动,为后续活动留下最大空间。按开始时间排序可能选到开始很早但结束很晚的活动,阻挡后续所有活动。
Q5:什么时候用后悔贪心而不是普通贪心?
A:当:① 题目允许最多 K 次操作且 K 较小;② 每次操作可以用反向操作「撤销」;③ 普通贪心给出次优答案,因为早期选择阻碍了后来更好的选择。关键思路是在堆中插入
-x后悔节点,让你以 O(log N) 隐式撤销任何之前的选择。
练习题
| 题目 | 关键技术 | 难度 |
|---|---|---|
| 4.1.1 会议室 II | 活动选择变体 + 最小堆 | 🟡 中等 |
| 4.1.2 分数背包 | 交换论证(比率标准) | 🟢 简单 |
| 🏆 挑战题 | 区间刺穿(USACO Silver) | 🔴 困难 |
题目 4.1.1 — 会议室 II 🟡 中等
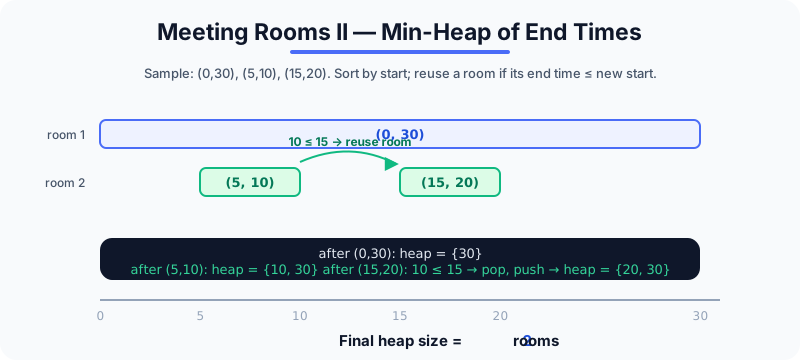
题目: N 场会议,各有开始时间 start[i] 和结束时间 end[i]。找最少需要多少间会议室使所有会议都能无重叠进行。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ start[i] < end[i] ≤ 10⁶。
输入:
3
0 30
5 10
15 20
输出: 2
💡 提示
最少会议室数 = 任意时刻最多重叠的会议数。用最小堆追踪结束时间(每间会议室何时空闲)。对每场新会议,检查最早空闲的会议室能否复用。
核心思路:
最少会议室数 = 任意时刻最多重叠的会议数。用最小堆追踪结束时间(每间会议室何时空闲)。对每场新会议,检查最早空闲的会议室能否复用。
核心思路:
按开始时间排序会议,最小堆存储每间会议室的结束时间。对每场新会议:
- 若堆顶(最早结束的会议室)≤ 新会议开始时间 → 复用该会议室
- 否则 → 开新会议室
堆的最终大小就是答案。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<pair<int,int>> meetings(n);
    for (int i = 0; i < n; i++)
        cin >> meetings[i].first >> meetings[i].second;

    sort(meetings.begin(), meetings.end());  // 按开始时间排序

    // 最小堆:存储每间使用中会议室的结束时间
    priority_queue<int, vector<int>, greater<int>> pq;

    for (auto [start, end] : meetings) {
        if (!pq.empty() && pq.top() <= start) {
            // 复用最早空闲的会议室
            pq.pop();
        }
        pq.push(end);  // 该会议室被占用到 'end' 时刻
    }

    cout << pq.size() << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
题目 4.1.2 — 分数背包 🟢 简单
题目: N 件物品,物品 i 重量 w[i]、价值 v[i],背包容量 W。可以取任意分量(物品可分割)。最大化总价值。
数据规模: 1 ≤ N ≤ 10⁵,1 ≤ W ≤ 2×10⁹,1 ≤ w[i], v[i] ≤ 10⁹。
示例:
N=3, W=50
物品:(w=10, v=60), (w=20, v=100), (w=30, v=120)
输出:240.0
💡 提示
贪心有效是因为允许取分量。按价值/重量比(单位价值)降序排序,尽可能多地取比率最高的物品直到背包装满。
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    double W;
    cin >> n >> W;

    vector<pair<double,double>> items(n);  // {价值, 重量}
    for (int i = 0; i < n; i++)
        cin >> items[i].second >> items[i].first;

    // 按单位价值(v/w)降序排序
    sort(items.begin(), items.end(), [](const auto &a, const auto &b) {
        return a.first / a.second > b.first / b.second;
    });

    double totalValue = 0.0;
    double remaining = W;

    for (auto [v, w] : items) {
        if (remaining <= 0) break;
        if (w <= remaining) {
            totalValue += v;
            remaining -= w;
        } else {
            totalValue += v * (remaining / w);
            remaining = 0;
        }
    }

    cout << fixed << setprecision(2) << totalValue << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
🏆 挑战题:USACO 2016 February Silver——区间刺穿
题目: FJ 有 N 段围栏,各定义为数轴上的 [L_i, R_i]。找最少的「锚点」数,使每段围栏都至少包含一个锚点(锚点在区间端点上也算包含)。
数据规模: 1 ≤ N ≤ 10⁵,0 ≤ L_i ≤ R_i ≤ 10⁹。
贪心策略: 按右端点升序排序。维护 lastPoint(最后一个锚点的位置,初始 −∞)。对每段:若 lastPoint 不在 [L_i, R_i] 内(即 lastPoint < L_i),在 R_i 放一个新锚点(尽量靠右以覆盖更多后续区间)。
样例输入:
5
1 4
3 6
7 9
2 5
8 10
样例输出:
2
(排序后 [1,4],[2,5],[3,6],[7,9],[8,10]:在 4 放锚点覆盖前 3 段,在 9 放锚点覆盖后 2 段)
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios_base::sync_with_stdio(false);
    cin.tie(NULL);

    int n;
    cin >> n;

    vector<pair<int,int>> segs(n);  // {右端点, 左端点}
    for (int i = 0; i < n; i++) {
        int l, r;
        cin >> l >> r;
        segs[i] = {r, l};
    }

    sort(segs.begin(), segs.end());  // 按右端点排序

    int count = 0;
    long long lastPoint = LLONG_MIN;

    for (auto [r, l] : segs) {
        if (lastPoint < l) {
            // 当前锚点不覆盖该段——放新锚点
            lastPoint = r;   // 放在右端以覆盖尽量多的后续区间
            count++;
        }
    }

    cout << count << "\n";
    return 0;
}
// 时间复杂度:O(N log N)
与活动选择的联系: 区间刺穿和最多不重叠区间是对偶问题:最少刺穿点数 = 最多不重叠区间数(区间调度的 König 定理)。两者都按右端点排序,代码结构几乎相同。